机器学习算法基础-Task1 Linear Regression

机器学习笔记二:线性回归与最小二乘法 这篇笔记会将几本的线性回归概念和最小二乘法。其他的会在下一篇扩展。 在机器学习中,一个重要而且常见的问题就是学习和预测特征变量(自变量)与响应的响应变量(应变量)之间的函数关系 这里主要讨论线性函数:在特征和响应之间学习线性关系。 这篇文章是入门基本概念的一片文章,会引导你关于一些模型的基本过程是怎样的。这里需要一些python和数学的基础知识。一.线性建模以奥运会男子100米金牌需要的时间数 阅读详情

学习来源:https://github.com/datawhalechina/team-learning/tree/master/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0%E7%AE%97%E6%B3%95%E5%9F%BA%E7%A1%80

https://github.com/datawhalechina/team-learning/blob/master/机器学习算法基础/Task1%20Linear_regression.ipynb
主要内容:

  • 模型建立:线性回归原理、线性回归模型
  • 学习策略:线性回归损失函数、代价函数、目标函数
  • 算法求解:梯度下降法、牛顿法、拟牛顿法等
  • 线性回归的评估指标
  • sklearn参数详解

练习部分

  • 基于线性回归的房价预测问题
  • 利用sklearn解决回归问题
  • sklearn.linear_model.LinearRegression
    线性回归的评价指标:
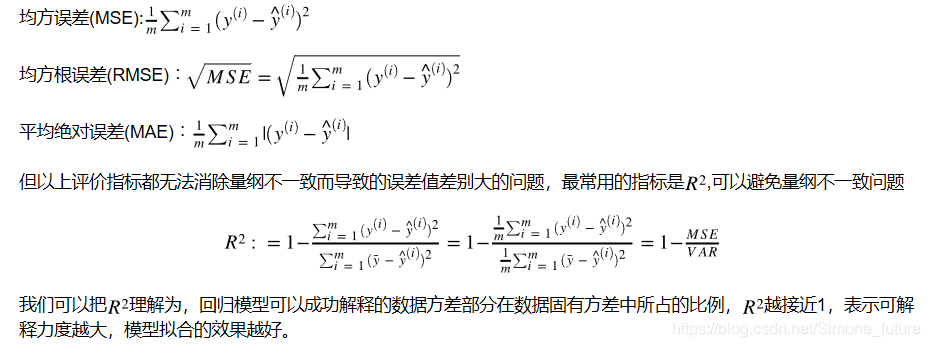
    在这里插入图片描述

sklearn.linear_model参数详解:
fit_intercept : 默认为True,是否计算该模型的截距。如果使用中心化的数据,可以考虑设置为False,不考虑截距。注意这里是考虑,一般还是要考虑截距
normalize: 默认为false. 当fit_intercept设置为false的时候,这个参数会被自动忽略。如果为True,回归器会标准化输入参数:减去平均值,并且除以相应的二范数。当然啦,在这里还是建议将标准化的工作放在训练模型之前。通过设置sklearn.preprocessing.StandardScaler来实现,而在此处设置为false
copy_X : 默认为True, 否则X会被改写、n_jobs: int 默认为1. 当-1时默认使用全部CPUs ??(这个参数有待尝试)
可用属性:
coef_:训练后的输入端模型系数,如果label有两个,即y值有两列。那么是一个2D的arrayintercept_: 截距
可用的methods:
fit(X,y,sample_weight=None): X: array, 稀疏矩阵 [n_samples,n_features] y: array [n_samples, n_targets] sample_weight: 权重 array [n_samples] 在版本0.17后添加了sample_weight
get_params(deep=True): 返回对regressor 的设置值
predict(X): 预测 基于 R^2值
score: 评估
参考https://blog.youkuaiyun.com/weixin_39175124/article/details/79465558

练习完成代码如下:

#生成数据
import numpy as np
#生成随机数
np.random.seed(1234)
x = np.random.rand(500,3)
#构建映射关系,模拟真实的数据待预测值,映射关系为y = 4.2 + 5.7*x1 + 10.8*x2,可自行设置值进行尝试
y = x.dot(np.array([4.2,5.7,10.8]))
#1、先尝试调用sklearn的线性回归模型训练数据
import numpy as np
from sklearn.linear_model import LinearRegression
import matplotlib.pyplot as plt
%matplotlib inline
# 调用模型
lr = LinearRegression(fit_intercept=True)
# 训练模型
lr.fit(x,y)
print("估计的参数值为:%s" %(lr.coef_))
# 计算R平方
print('R2:%s' %(lr.score(x,y)))
# 任意设定变量,预测目标值
x_test = np.array([2,4,5]).reshape(1,-1)
y_hat = lr.predict(x_test)
print("预测值为: %s" %(y_hat))
# 调用模型
lr = LinearRegression(fit_intercept=True)
# 训练模型
lr.fit(x,y)
print("估计的参数值为:%s" %(lr.coef_))
# 计算R平方
print('R2:%s' %(lr.score(x,y)))
# 任意设定变量,预测目标值
x_test = np.array([2,4,5]).reshape(1,-1)
y_hat = lr.predict(x_test)
print("预测值为: %s" %(y_hat))
#2、最小二乘法的矩阵求解
class LR_LS():
    def __init__(self):
        self.w = None      
    def fit(self, X, y):
        # 最小二乘法矩阵求解
        #============================= show me your code =======================
        self.w = np.linalg.inv(X.T.dot(X)).dot(X.T).dot(y)
        #============================= show me your code =======================
    def predict(self, X):
        # 用已经拟合的参数值预测新自变量
        #============================= show me your code =======================
        y_pred = X.dot(self.w)
        #============================= show me your code =======================
        return y_pred
 if __name__ == "__main__":
    lr_ls = LR_LS()
    lr_ls.fit(x,y)
    print("估计的参数值:%s" %(lr_ls.w))
    x_test = np.array([2,4,5]).reshape(1,-1)
    print("预测值为: %s" %(lr_ls.predict(x_test)))
#3、梯度下降法
class LR_GD():
    def __init__(self):
        self.w = None     
    def fit(self,X,y,alpha=0.02,loss = 1e-10): # 设定步长为0.002,判断是否收敛的条件为1e-10
        y = y.reshape(-1,1) #重塑y值的维度以便矩阵运算
        [m,d] = np.shape(X) #自变量的维度
        self.w = np.zeros((d)) #将参数的初始值定为0
        tol = 1e5
        #============================= show me your code =======================
        while tol > loss:
            h_f = X.dot(self.w).reshape(-1,1) 
            theta = self.w + alpha*np.mean(X*(y - h_f),axis=0) #计算迭代的参数值
            tol = np.sum(np.abs(theta - self.w))
            self.w = theta
        #============================= show me your code =======================
    def predict(self, X):
        # 用已经拟合的参数值预测新自变量
        y_pred = X.dot(self.w)
        return y_pred
 if __name__ == "__main__":
    lr_gd = LR_GD()
    lr_gd.fit(x,y)
    print("估计的参数值为:%s" %(lr_gd.w))
    x_test = np.array([2,4,5]).reshape(1,-1)
    print("预测值为:%s" %(lr_gd.predict(x_test)))

参考吴恩达 CS229课程
周志华 《机器学习》
李航 《统计学习方法》https://hangzhou.anjuke.com/
https://www.jianshu.com/p/e0eb4f4ccf3e
https://blog.youkuaiyun.com/qq_28448117/article/details/79199835https://blog.youkuaiyun.com/weixin_39175124/article/details/79465558

ML硕士申请实操指南:11个真·ML导向项目的选校与进阶路径 机器学习硕士(ML Masters)是通往工业界ML工程师、AI研究员或算法科学家的关键跳板。其本质不仅是学历提升,更是数学建模能力、工程落地习惯与产业资源网络的系统性锻造。理解课程代码背后的教学定位(如CMU 10-601 vs 10-701)、Capstone项目是否对接真实业务场景、地理位置如何影响实习转化率,远比QS排名或CSRankings论文数更能决定成长效率。本文基于200+项目深度调研与37位学员实操验证,聚焦‘课程结构’‘隐性资源’‘工程适配度’三大维度,拆解UCSD、CMU、伯克利MID 阅读详情

相关推荐

李宏毅_Machine Learning_2019 Task 3

李宏毅_Machine Learning_2019 Task 3 学习打卡内容 大作业 按照 Homework1_Introduction.txt 的要求完成本次作业 作业1:预测PM2.5的值 在这个作业中,我们将用梯度下降法 (Gradient Descent) 预测 PM2.5 的值 (Regression 回归问题) Homework1要求: 要求 python3.5+ 只能用 nu...

Crafts_Neo的博客 904

四、回归——LinearRegression

一、官方文档 class sklearn.linear_model.LinearRegression(fit_intercept=True, normalize=False, copy_X=True, n_jobs=1) 1.参数: Ordinary least squares Linear Regression.(普通最小二乘线性回归) Parameters: fit_in...

Nicole的博客 1251

Databricks上Spark ML线性回归实战:从手工作坊到工业级建模

线性回归作为最基础的预测建模方法,在海量数据场景下面临可扩展性、可复现性与工程化落地瓶颈。其核心原理是通过最小二乘法拟合特征与目标变量间的线性关系,但传统scikit-learn实现受限于单机内存与串行计算范式。Spark ML通过分布式DataFrame API重构训练流程,依托Catalyst优化器、Tungsten执行引擎及Delta Lake事务能力,显著提升大规模特征工程与模型训练效率。技术价值体现在端到端Pipeline可版本化、特征与模型强一致性、跨环境无缝迁移;典型应用于销售预测、IoT异常

chenzhuofei4155的博客 322

sklearn.linear_model之LinearRegression

sklearn.linear_model中线性回归LinearRegression模型

JingYi的专栏 1万+

超详细!思岚S2激光雷达hector_mapping建图

使用思岚S2激光雷达,在ros平台上利用hector_mapping功能包实现建图功能

m0_50965539的博客 5592

单细胞实战之数据净化三部曲:细胞周期校正、双胞体剔除与RNA污染清理——技术解析与实战指南

本文深入解析单细胞数据分析中至关重要的数据净化步骤,即细胞周期校正、双胞体剔除与RNA污染清理。通过实战代码演示与原理剖析,指导读者如何有效识别并去除技术噪音,从而获得更纯净、可靠的数据,为后续的细胞分群、差异表达等高级分析奠定坚实基础。

weixin_29274337的博客 206

LinearRegression、岭回归、Lasso回归和ElasticNet回归总结-附python3代码实战及回归检验

过拟合和欠拟合 开始我是很难弄懂什么是过拟合,什么是欠拟合以及造成两者的各自原因以及相应的解决办法,学习了一段时间机器学习和深度学习后,分享下自己的观点,方便初学者能很好很形象地理解上面的问题。 无论在机器学习还是深度学习建模当中都可能会遇到两种最常见结果,一种叫过拟合(over-fitting )另外一种叫欠拟合(under-fitting)。 首先谈谈什么是过拟合呢?什么又是欠拟合呢?网上很直接的图片理解如下: 所谓过拟合(over-fitting)其实就是所建的机器学习模型或者是深度学习模型在训练样

qq_30868737的博客 9520

第18届全国大学生智能汽车竞赛四轮车控制策略深度解析:从舵机PID到速度闭环

本文深度解析了第18届全国大学生智能汽车竞赛中四轮车的核心控制策略。从舵机PID方向控制的基础原理与机械校准入手,详细阐述了误差计算、PD控制等关键环节;进而深入探讨了基于编码器的速度闭环控制,包括增量式PI算法与速度决策逻辑。文章结合实战经验,提供了方向环与速度环的协同调参思路与避坑指南,旨在帮助参赛者构建稳定、高效的智能车控制系统。

potato的博客 465

Sklearn学习第一天:LinearRegression学习笔记

1.LinearRegression初始化参数解释 fit_intercept:截距:默认True,可选择False normalize:正则化:默认False,可选择True,如果fit_intercept为 False,则normalize被忽视。如果normalize为True,则将特征矩阵X 在进入回归之前将会被减去均值(中心化)并除以L2范式(缩 放)。 copy_X:是否在原矩阵上进行操作。默认True n_jobs:计算机CPU工作核数 属性: coef_:线性回归评估出的参数 interce

天天学习的博客 747

13-单片机模块化程序: 单片机AT指令配置模块程序模板(非阻塞版)

资料源码:https://gitee.com/yang456/OpenProgrammingModuleForMCU.git 点击加入群聊【单片机,物联网,上位机】: 说明1:知识从未如此性感。 烂程序员关心的是代码,好程序员关心的是数据结构和它们之间的关系! 说明2:学的是思想,而非程序!此代码思路适用于所有的单片机。 说明3:学会以后,下面的代码可能会跟你一辈子! 说明4:这一系列文章是为大幅度裁剪本人博客文章!使博客文章更有条理。便于推其它教程! 拷贝这两个文件到自己的工程 ..

杨奉武的博客 1281

【教程4>第2章>第19节】 GMSK解调系统的FPGA开发与matlab对比验证

MSK(Minimum Shift Keying,最小频移键控)和GMSK(Gaussian Minimum Shift Keying,高斯最小频移键控)都是数字调制技术,主要用于无线通信系统中将数字信号转换为模拟信号进行传输。它们都是连续相位移键控(Continuous Phase Shift Keying, CPK)的一种形式,意味着相邻码元之间没有相位跳变的突变,而是连续过渡,这有助于减少信号带宽和降低邻道干扰。GMSK的解调过程与MSK类似,我们这里还是采用和MSK解调一样的1bit解调方法。

FPGA/MATLAB学习教程/源码/项目合作开发 1222

Datawhale-机器学习算法-Task1 Linear_regression

一.学习目标 线性回归的原理 线性回归损失函数、代价函数、目标函数 优化方法(梯度下降法、牛顿法、拟牛顿法等) 线性回归的评估指标 sklearn参数详解 二.学习内容 2.1线性回归原理 线性回归是机器学习中最简单的回归算法,多元线性回归指的就是一个样本有多个特征的线性回归问题。对于一个有n个特征的样本而言,它的回归结果可以写作一个几乎人人熟悉的方程: y^i=w0+w1xi1+w2xi2+...

jhb1021821368的博客 443

Python爬虫经典案例第67篇:社交媒体平台爬取:Twitter数据采集实战

Twitter(现更名为X)是全球最具影响力的社交媒体平台之一,拥有超过3.3亿月度活跃用户。作为一个实时信息传播平台,Twitter上的数据涵盖了新闻、政治、娱乐、科技等各个领域,具有极高的研究价值:本文将深入探讨Twitter数据采集的技术方案,包括官方API调用、网页爬取和浏览器自动化三种方式。Twitter采用现代化的微服务架构,主要特点包括:Twitter作为全球最大的社交媒体平台,拥有完善的反爬机制:在开始爬取前,需要明确合法的数据采集方式:重要提示:未经授权爬取Twitter数据可能违反服务条

2201_76125261的博客 660

机器学习_task02_linear_regression

回归问题 线性回归,顾名思义,属于回归问题。既然是回归问题,那必然属于监督学习。 在这里简单再介绍一下什么是回归问题,回归用于预测输入变量和输出变量之间的关系,特别是当输入变量的值发生变化时,输出变量的值随之发生的变化。回归模型正是表示从输入变量到输出变量之间映射的函数,回归问题的学习等价于函数拟合:选择一条函数曲线使其很好地拟合已知数据且很好地预测未知数据。 线性回归模型 线性回归的定义是:目标...

Arrow7TT的博客 450

Mac 下 OpenClaw 安装全记录:从零到一的保姆级图文教程

本文主要介绍了Mac 下 OpenClaw 安装全记录:从零到一的保姆级图文教程,希望能对学习使用OpenClaw 的同学们有所帮助。 文章目录 1. 背景 2. 安装教程 2.1 安装OpenClaw 2.2 配置模型 2.3 对话 3. 后续使用步骤 4. 关闭程序

weixin_43178406的博客 11万+

YOLOv8改进有效系列目录 | 包含卷积、主干、检测头、注意力机制、Neck上百种创新机制

Hello,各位读者们好,本专栏自开设两个月以来已经更新改进教程120+余篇其中包含C2f、主干、检测头、注意力机制、Neck多种结构上创新,也有损失函数和一些细节点上的创新,订阅本专栏以后你不仅可以收获跟专栏的阅读权限,同时可以进Qq群,里面包含集成我所有创新的YOLO最新目录,和我本人录制的视频讲解教程,如果你想要在YOLOv8系列收获一篇论文,我相信订阅本专栏后你一定会有所收获~YOLOv8改进有效系列目录。

Snu77的博客 18万+

Stanford机器学习课程-week1-Introduction & Linear Regression

Stanford机器学习课程-week1-Introduction & Linear Regression Definition Arthur Samuel (1959). Machine Learning: Field of  study that gives computers the ability to learn  without being explicitly programme

chaiyiping的专栏 858

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Photon-ML 终极指南:LinkedIn开源的大规模机器学习库

Photon-ML 是由 LinkedIn 机器学习算法团队开发的基于 Apache Spark 的可扩展机器学习库,支持训练多种广义线性模型(GLMs)和广义线性混合模型(GLMMs/GLMix 模型),包括逻辑回归、线性回归和泊松回归,为大规模数据处理提供了强大的解决方案。 ## 🚀 核心功能亮点 ### 🌟 广义线性模型(GLMs) Photon-ML 支持三大基础模型,满足不同业务

gitblog_00503的博客 718

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

【Machine Learning, Coursera】机器学习Week1 Linear Regression with One Variable

本节内容:1.一元线性回归(univariate linear regression) 2.梯度下降法(gradient descent)

Aki-Z的博客 402

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

机器学习之线性回归(Linear regression)学习笔记-Datawhale Task01

Author Bryce230 e-mail 2540892461@qq.com Software win10,Pycharm2019.3.3,Python3.7.7 线性回归笔记-Datawhale Task01线性回归梯度下降特征缩放学习率梯度上升正规方程评估指标代码实现参考资料 线性回归 线性回归分为单变量线性回归和多变量线性回归,一般来说,多变量线性回归在实践中比较...

Bryce230的博客 503

如何快速入门 Photon-ML:5步搭建你的第一个Spark机器学习项目

Photon-ML 是一个基于 Apache Spark 的可扩展机器学习库,由 LinkedIn 机器学习算法团队开发,支持训练多种广义线性模型(GLMs)和广义线性混合模型(GLMMs/GLMix),包括逻辑回归、线性回归和泊松回归等。本指南将帮助你通过5个简单步骤快速上手,搭建并运行你的第一个 Photon-ML 项目。 ## 1️⃣ 环境准备:安装必要依赖 在开始之前,确保你的系统已安

gitblog_00125的博客 406

Karmada 仓库中的 go-json-experiment:Go encoding/json v2 实验库的设计、行为差异与源码剖析

本文聚焦于 Karmada 仓库中 vendored 的第三方模块 `go-json-experiment/json`(位于 `vendor/k8s.io/kube-openapi/pkg/internal/third_party/go-json-experiment/json`),它是由 Go 标准库维护者发起的 `encoding/json` v2 实验实现。通过本文,读者将理解该实验库的六大

gitblog_00159的博客 874

Homework_Week1_Coursera【Machine Learning】AndrewNg Stanford University、Introduction、Linear Regression

Coursera【Machine Learning】AndrewNg Stanford University_Week1_HomeworkHomeworkIntroductionLinear Regression with One VariableLinear Algebra Homework Introduction 1.A computer program is said to learn from experience E with respect to some task T

A793539835的博客 366

机器学习(二)——Multivation Linear Regression

根据所给数据,给出使用梯度下降算法的多元线性回归模型,并能够正确绘制出J(θ)的图像。 实验步骤与内容: 数据处理 使用J(θ)选择学习率 实验文件中给出了学习率的大致范围为0.0001<=α<=10,而更精确的学习率就需要自己去运行梯度下降、观察成本函数,并进行相应的调整了。 将成本函数变为可执行代码 其中 而我们在上一个实验中,已经在theta0和the...

南木的博客 537

【Machine Learning, Coursera】机器学习Week2 Linear Regression with Multiple Variables

本节内容:1.多元线性回归(multivariate linear regression) 2.梯度下降的应用:特征缩放(feature scaling)、学习率(learning rate)的选择

Aki-Z的博客 460

Databricks上用Spark ML做分布式线性回归的工程实践

线性回归作为最基础的机器学习算法,其核心价值不仅在于数学可解释性,更在于分布式框架下的稳定扩展能力。当数据规模突破GB级、特征维度超百、模型迭代需小时级响应时,单机Scikit-learn已无法满足MLOps生产要求。Spark ML凭借与Databricks深度集成的能力,将线性回归升维为支持Delta Lake事务读写、自动容错、特征工程流水线化和MLflow标准化部署的工业级方案。尤其在零售、金融等强时效性场景中,它支撑着TB级销售预测、用户GMV建模等关键任务。本文聚焦Databricks环境下的S

weixin_30787531的博客 353
上一篇: Task01:Pandas基础
下一篇: 机器学习基础-Task2 Bayes_plus
Simone_future
博客等级 码龄7年 0粉丝 21原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值