500亿美元!AI将颠覆生物科技行业;120个适合入门练习的Python项目;文案自动检查纠正工具;百万人脸图像数据集;前沿论文 | ShowMeAI资讯日报

理解 paraphrase-multilingual-MiniLM-L12-v2 模型 自然语言处理(NLP)领域中,高质量的句子嵌入模型扮演着至关重要的角色,它们能够将复杂语言概念转化为易于机器处理的向量形式。它是sentence-transformers库中的一员,擅长于多语言环境下的句子相似性检测和文本分析。 阅读详情

📢 人工智能何以颠覆生物科技行业?| 摩根士丹利观点

https://weibo.com/ttarticle/p/show?id=2309404826722167292124

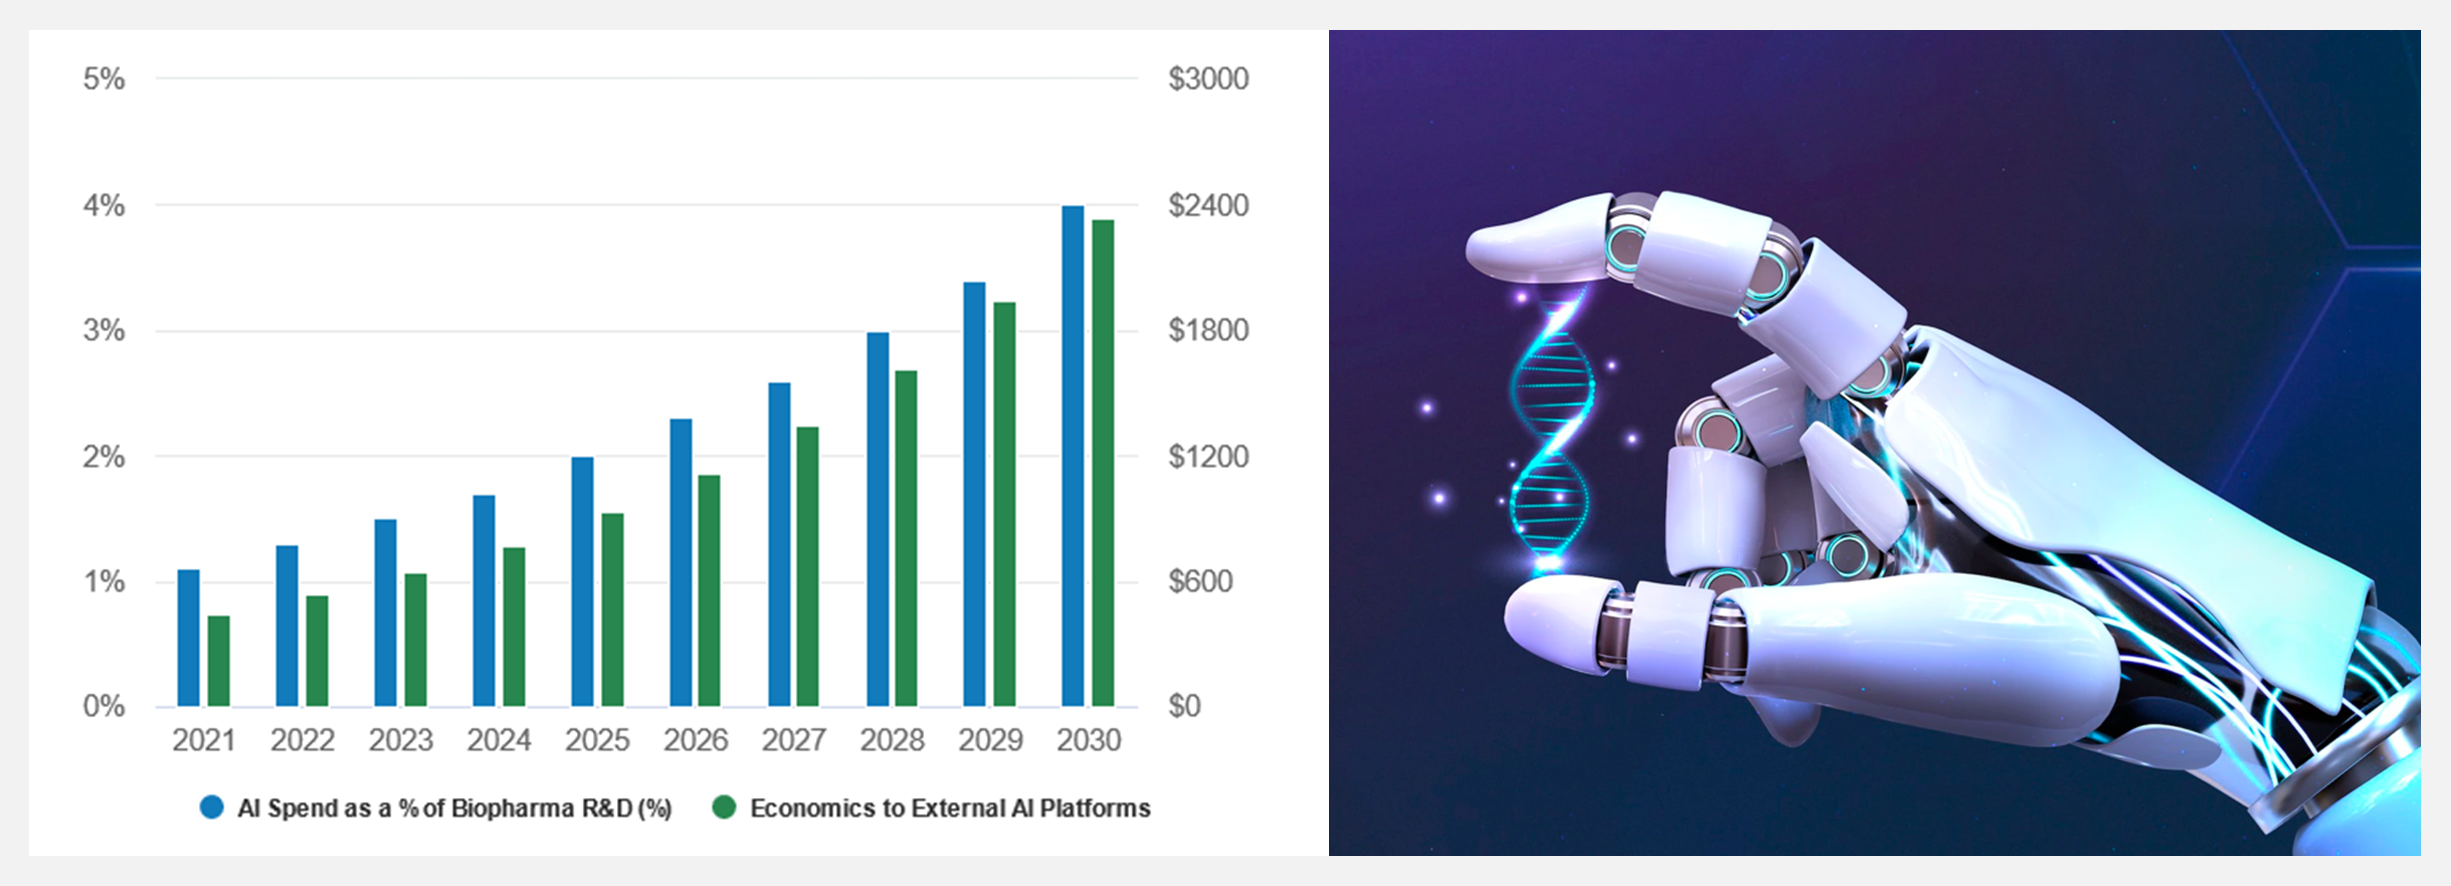
生物科技公司将人工智能和机器学习应用于药物开发,或将在未来10年研发出数十种款新药,开拓价值高达500亿美元的市场。

对生物科技公司而言,新药的传统研发过程就是不断的高成本试错。但在人工智能的帮助下,新一批药物研发平台帮助制药公司利用大量数据集来快速识别患者反应标志物,并以更经济实惠、且快速有效的方式研发针对性的药物靶标。

摩根士丹利研究部分析师预计,未来两年,人工智能药物试验数据驱动下,生物制药行业将迎来拐点。人工智能药物开发机构与大型生物制药公司之间加强合作,将为行业带来不小变化。假设在生物制药研发预算内每年适度增加人工智能投资,人工智能药物开发平台将通过合作带来显著的收入增长。(来源:公司数据、摩根士丹利研究部)
工具&框架

🚧 『AutoCorrect』文案自动纠正或检查建议工具

https://github.com/huacnlee/autocorrect

https://huacnlee.github.io/autocorrect/

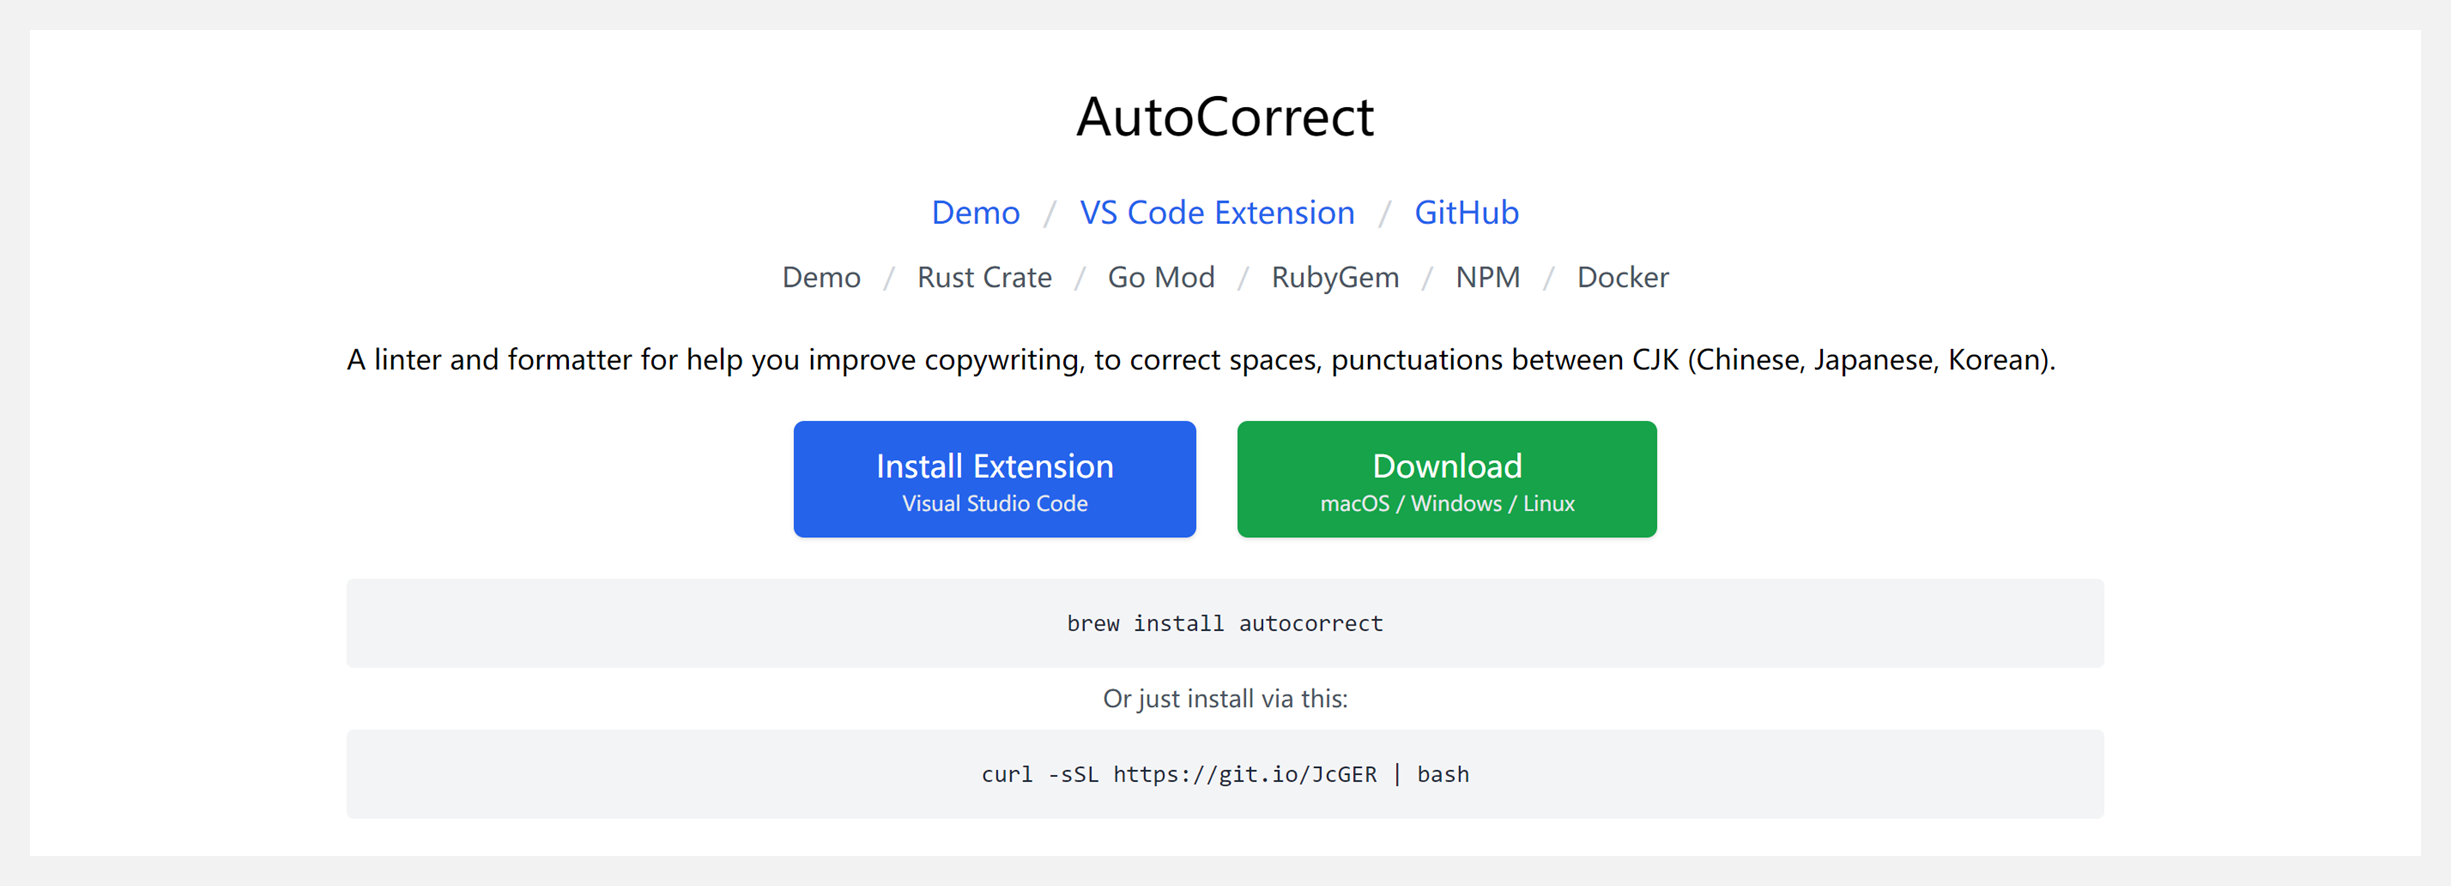
AutoCorrect是基于 Rust 编写的 CLI 工具,用于自动纠正或检查并建议文案,给 CJK(中文、日语、韩语)与英文混写的场景,补充正确的空格,纠正单词,同时尝试以安全的方式自动纠正标点符号等等。

类似 ESlint、Rubocop、Gofmt 等工具,AutoCorrect 可以用于 CI 环境,它提供 Lint 功能,能便捷的检测出项目中有问题的文案,起到统一规范的作用。AutoCorrect 支持各种类型源代码文件,能自动识别文件名,并准确找到字符串、注释做自动纠正。
🚧 『bert4vec』基于预训练的句向量生成工具(Python)

https://github.com/zejunwang1/bert4vec

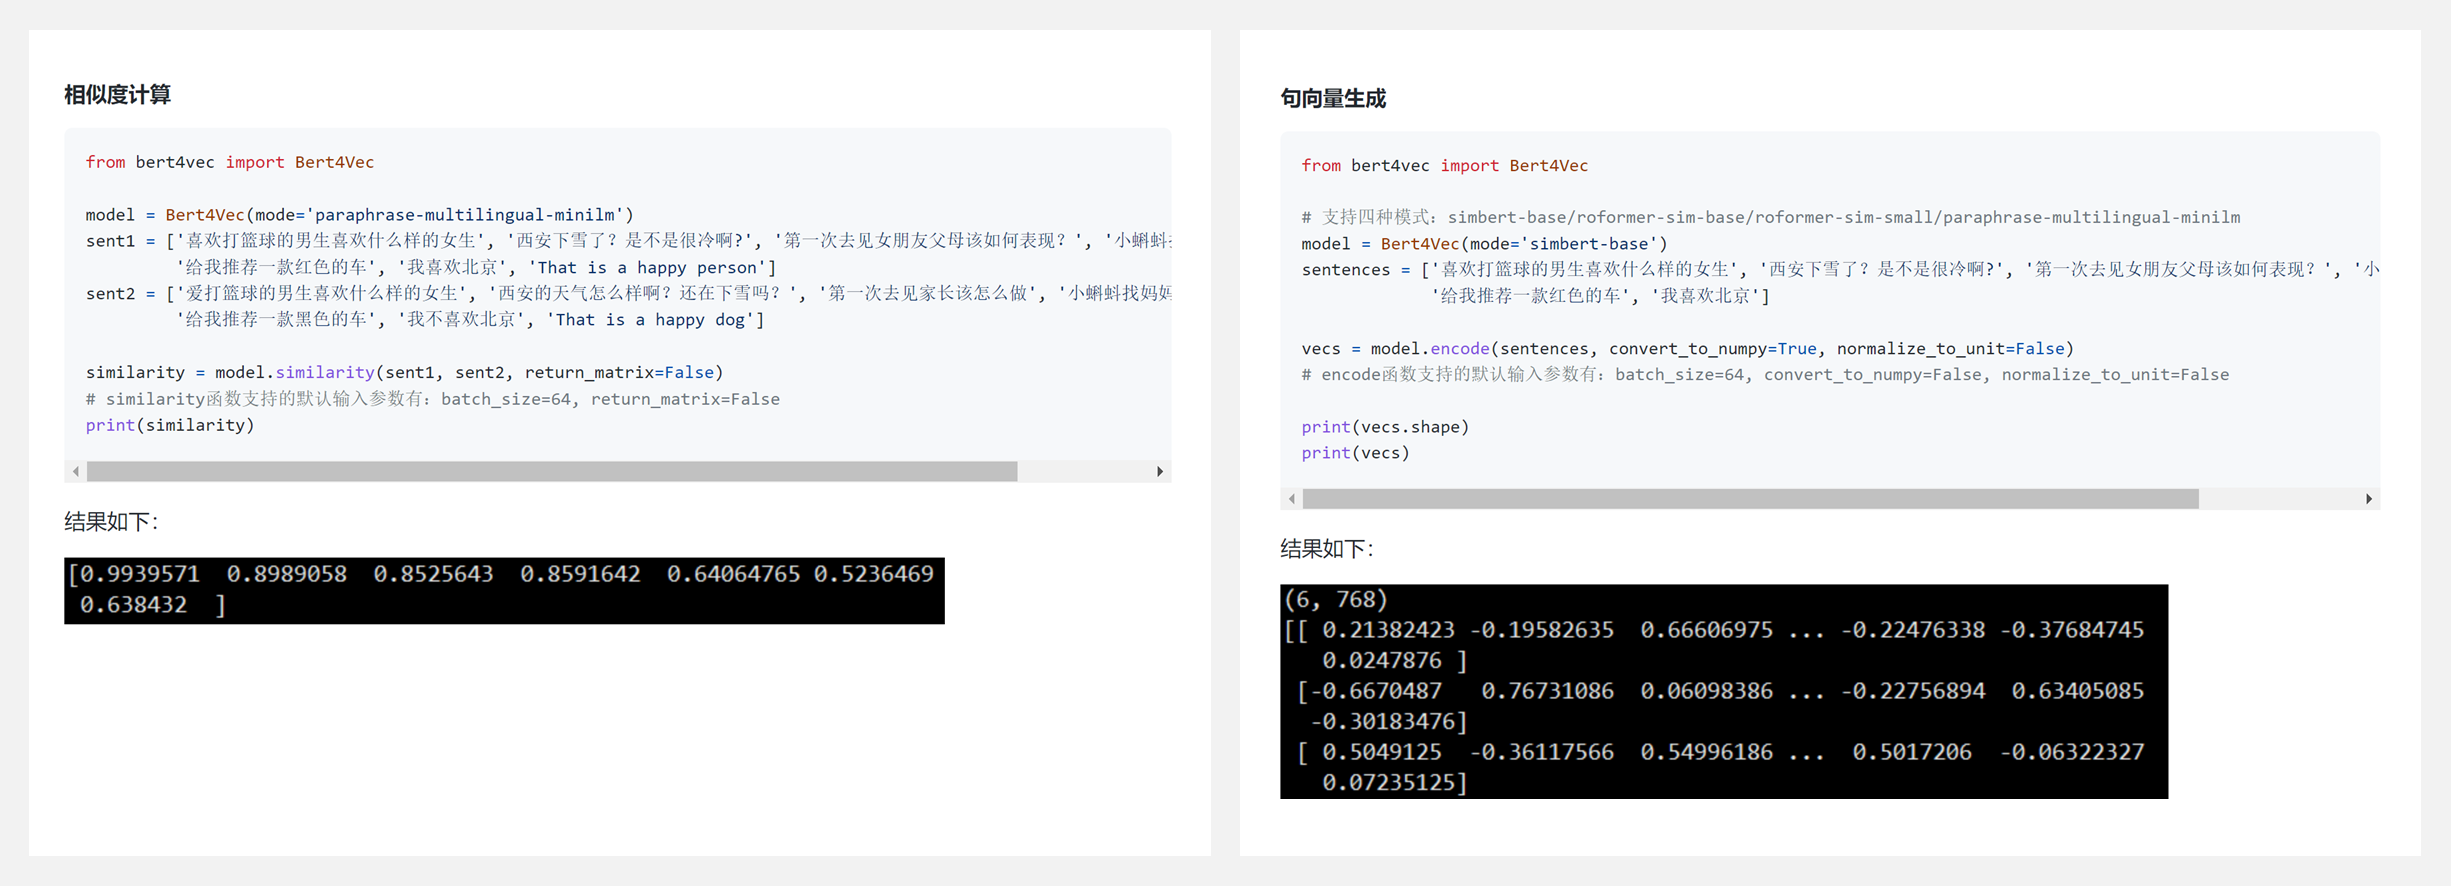
bert4vec 是一个基于预训练的句向量生成工具,目前支持加载的句向量预训练模型包括 SimBERT、RoFormer-Sim 和 paraphrase-multilingual-MiniLM-L12-v2。

其中,SimBERT 与 RoFormer-Sim 为苏剑林老师开源的中文句向量表示模型,paraphrase-multilingual-MiniLM-L12-v2 为 sentence-transformers 开放的多语言预训练模型,支持中文句向量生成。
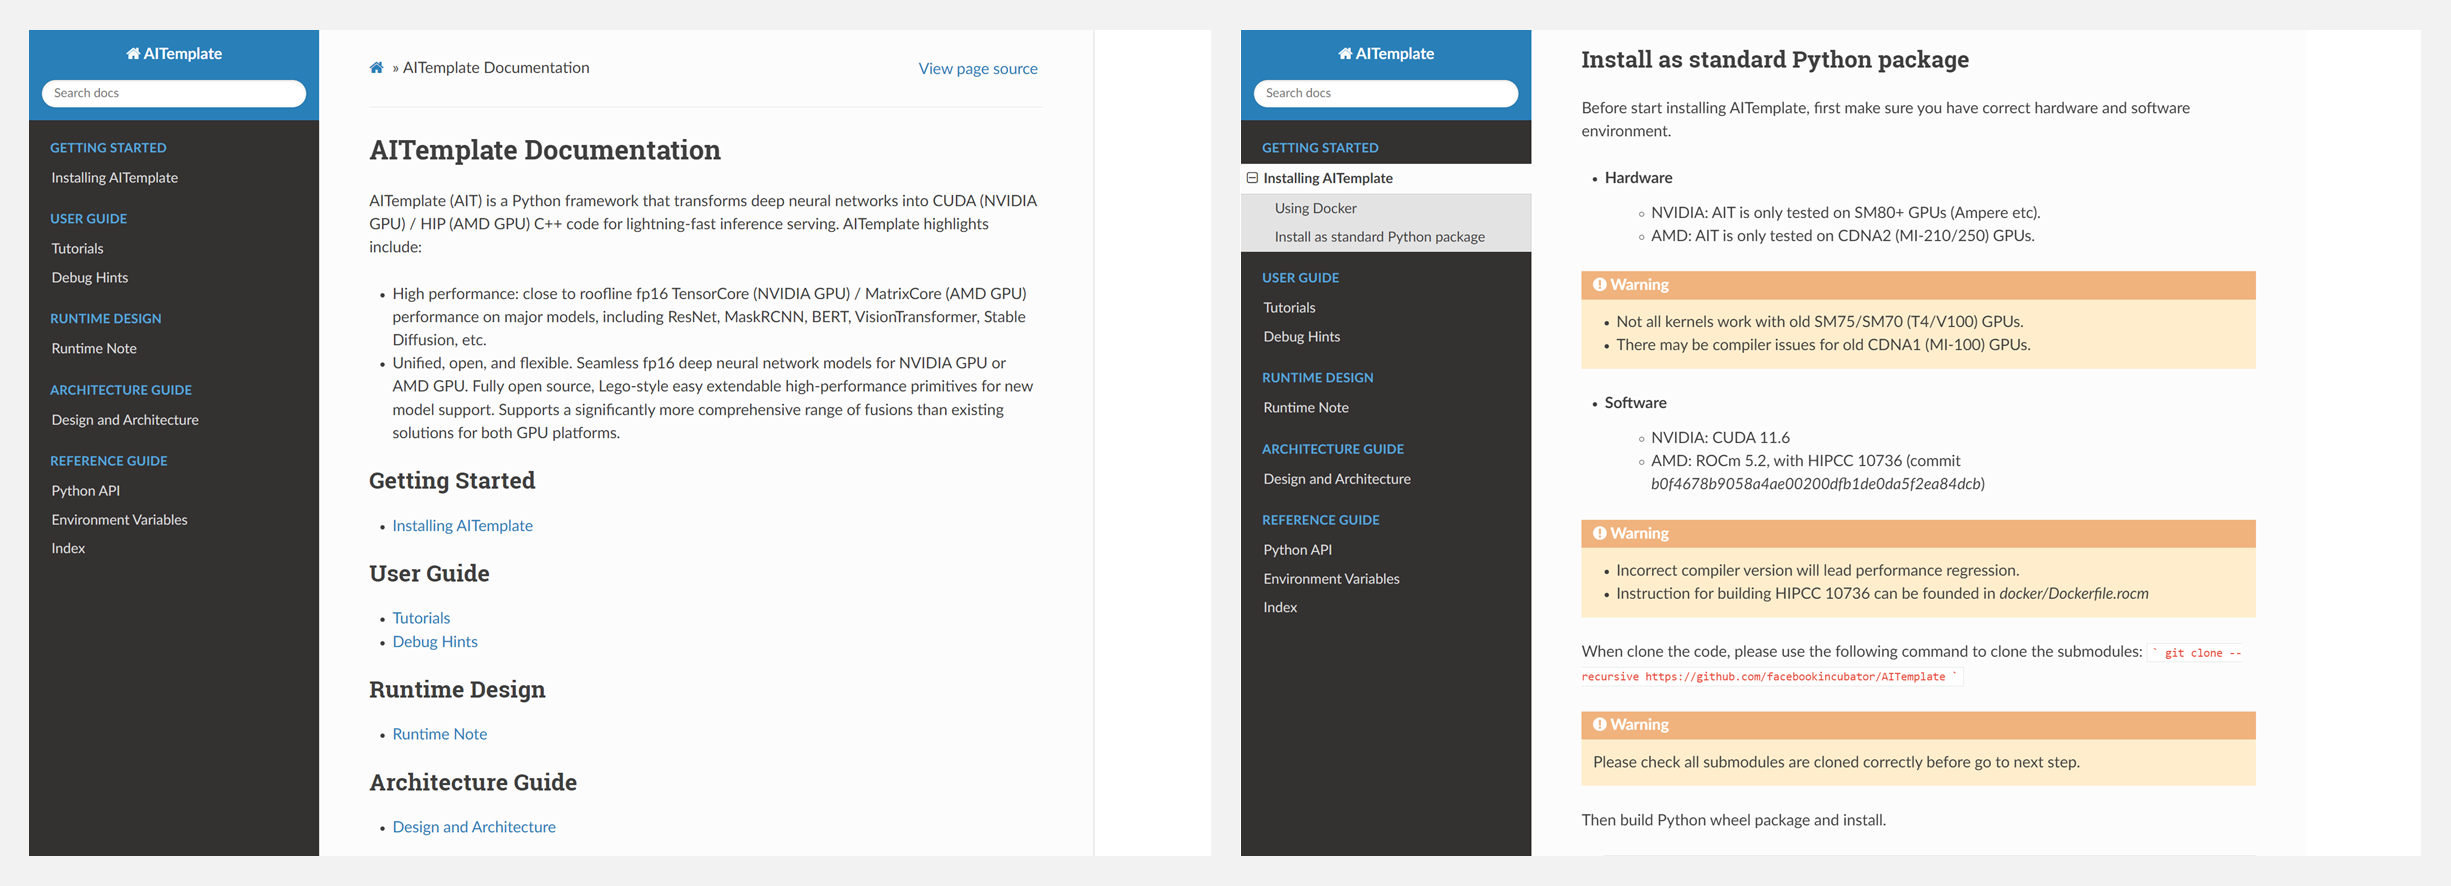
🚧 『AITemplate』将神经网络转换成高性能CUDA/HIP C++代码

https://github.com/facebookincubator/AITemplate

https://facebookincubator.github.io/AITemplate/

AITemplate(AIT)是一个 Python 框架,它将深度神经网络转化为 CUDA(NVIDIA GPU)/HIP(AMD GPU)C++ 代码,以实现极快的推理服务。

AITemplate 具备高性能、统一/开放/灵活的特点:接近 fp16 TensorCore(NVIDIA GPU)/MatrixCore(AMD GPU)在主要模型上的性能,源代码完全开放、乐高式的易扩展高性能基元,并支持新的模型。
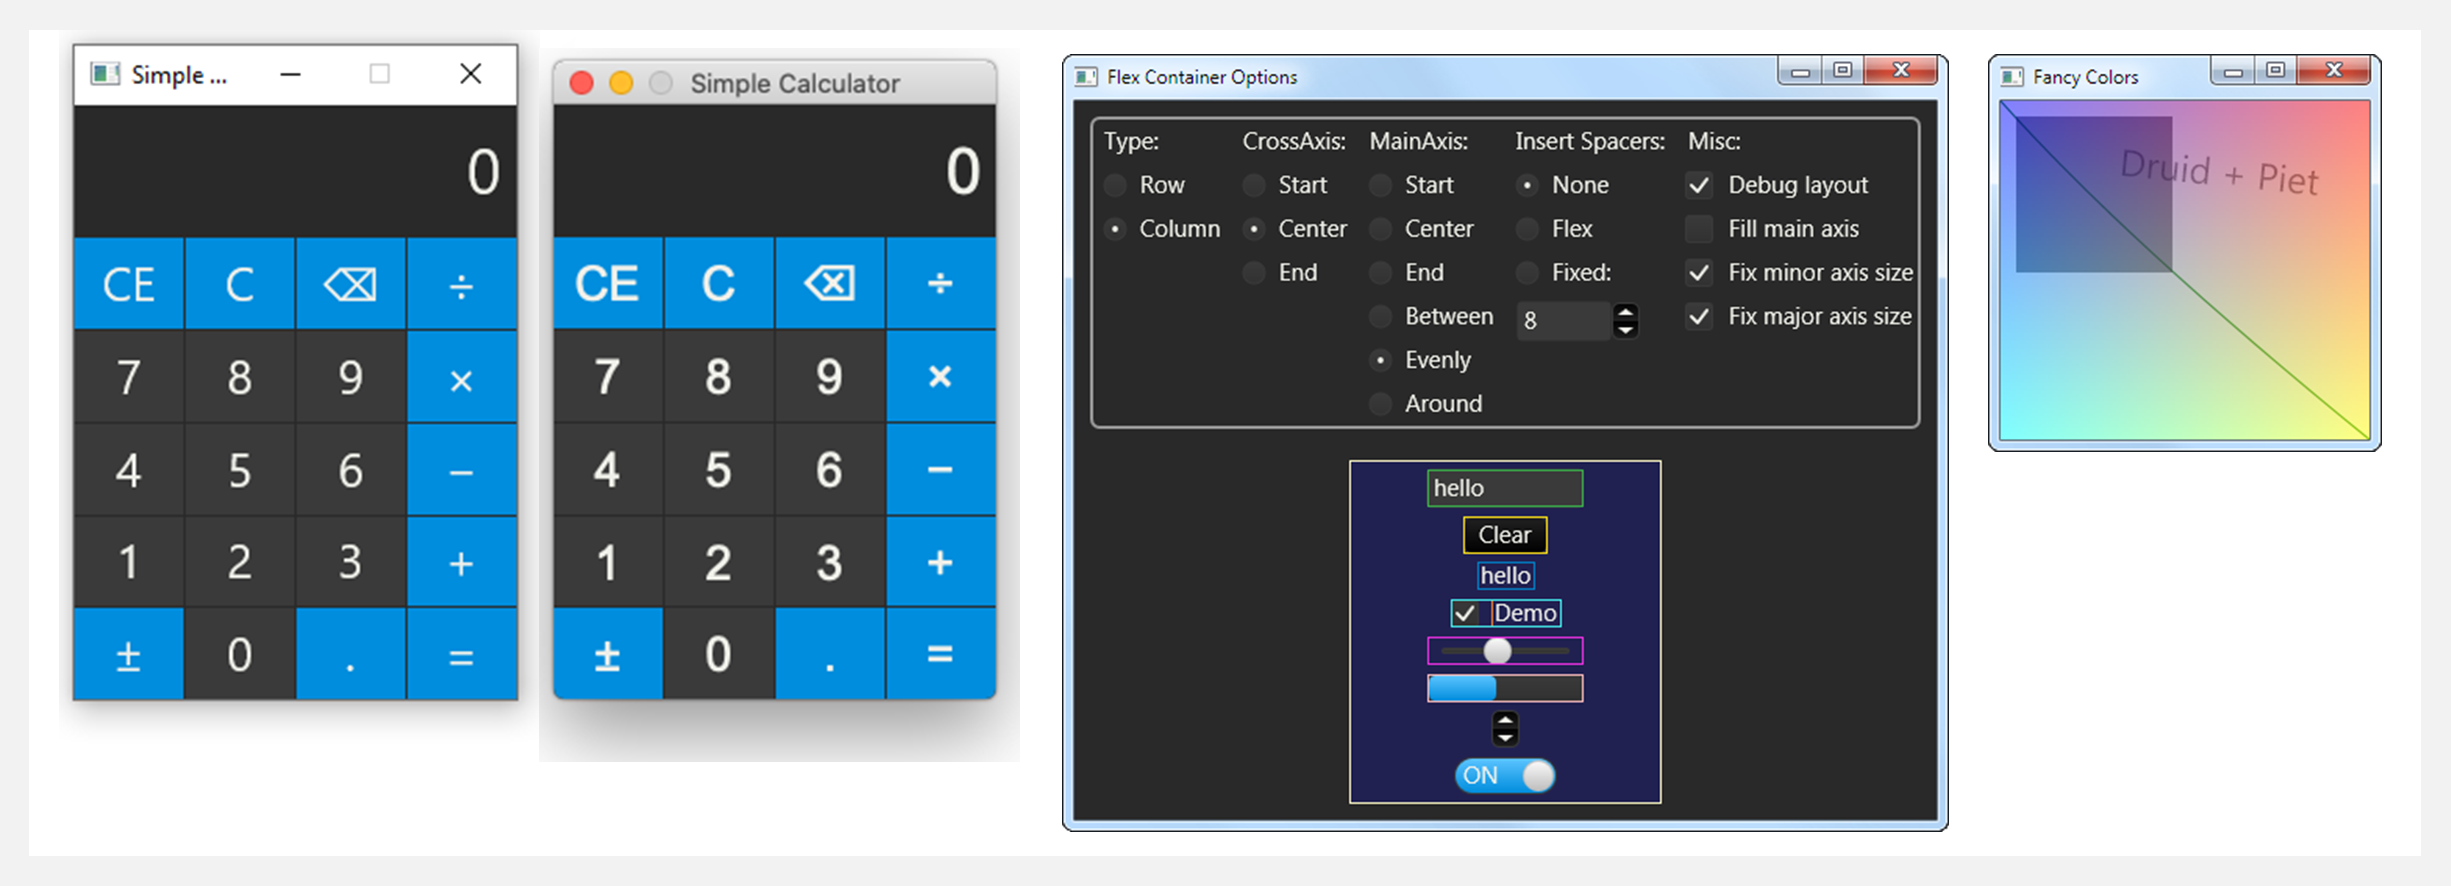
🚧 『druid』数据优先的 Rust 原生 UI 设计工具包

https://github.com/linebender/druid

https://linebender.org/druid/

Druid 是一个实验性的 Rust 原生 UI 工具包。它希望给用户提供完美的体验。因此它在性能、丰富的交互调色板、与本地平台的良好互动等部分都做了设计和优化。
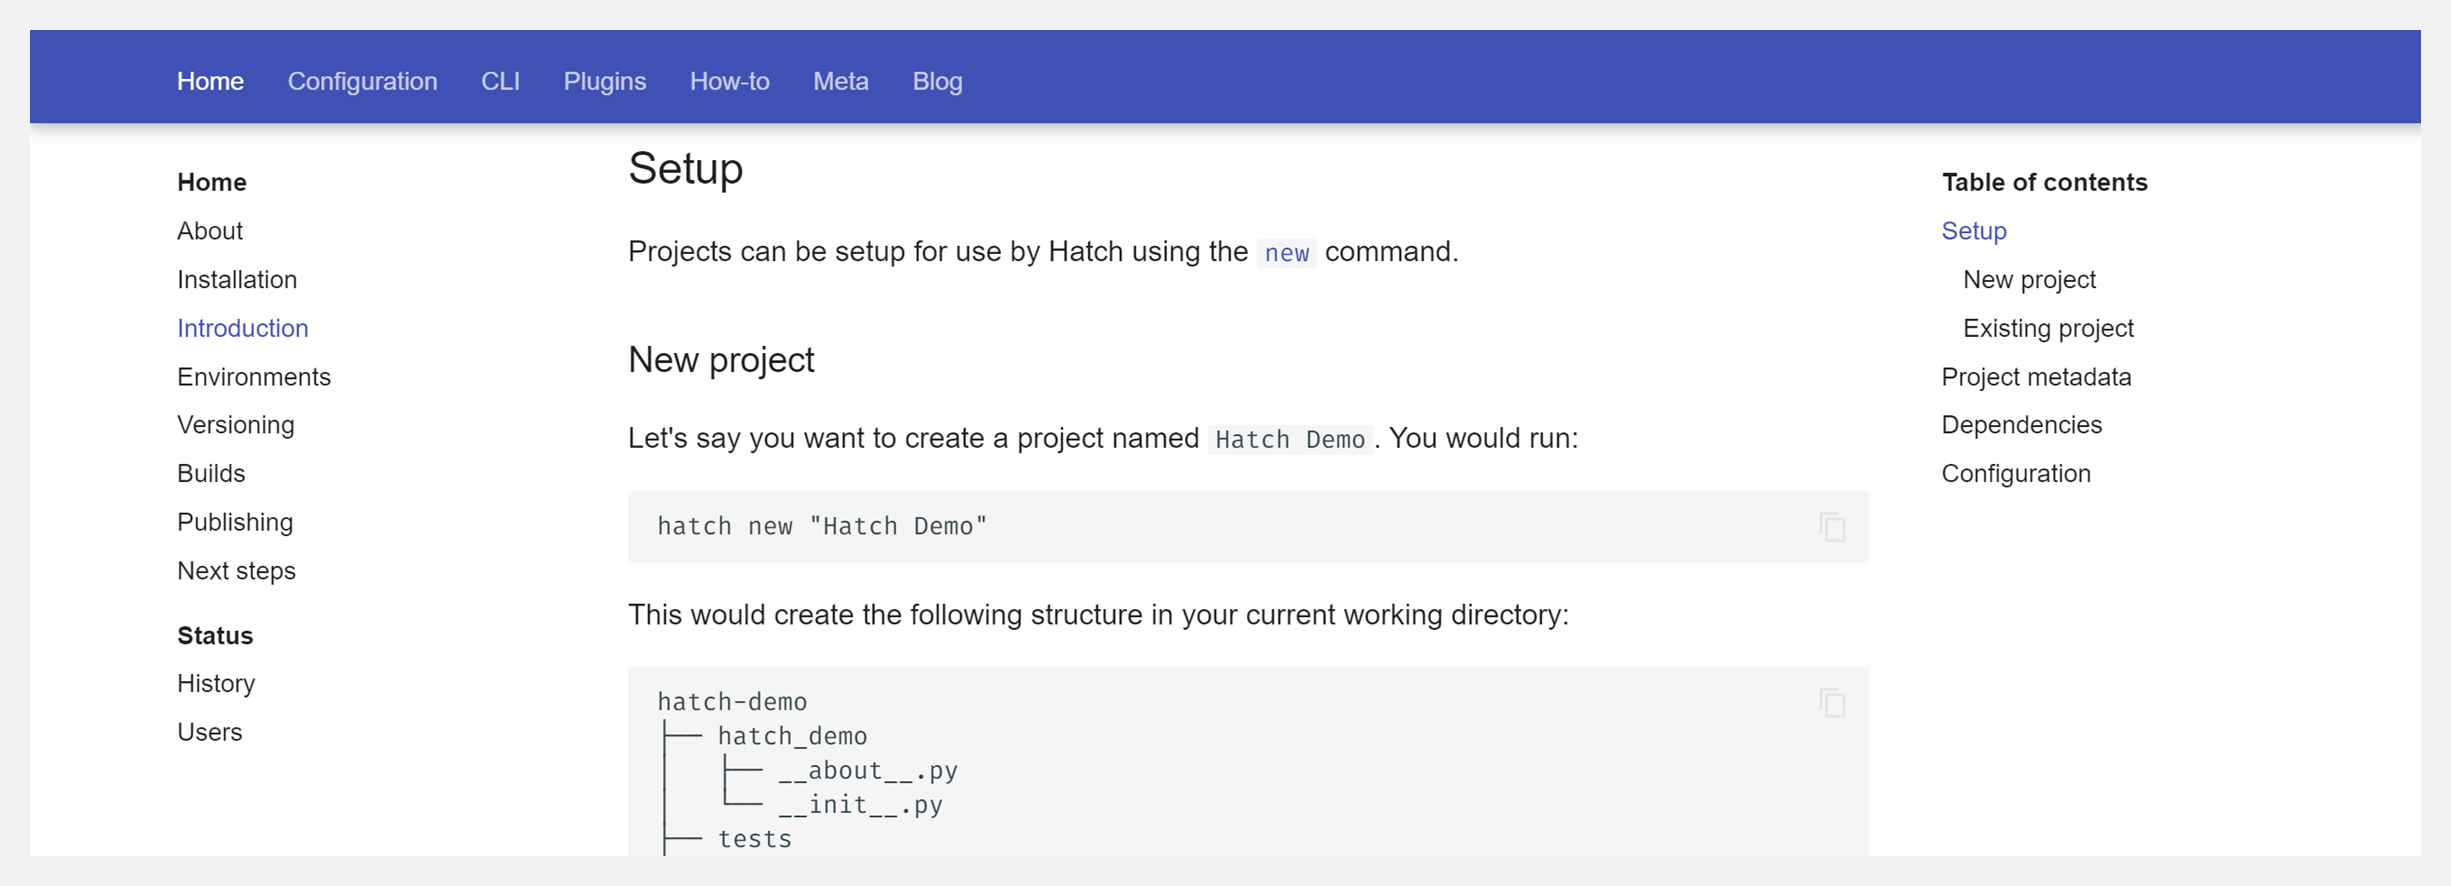
🚧 『Hatch』现代可扩展的 Python 项目管理器

https://github.com/pypa/hatch

https://hatch.pypa.io/latest/

Hatch是一个现代的、可扩展的Python项目管理器。它具备标准化的构建系统、强大的环境管理、轻松发布到PyPI或其他资源、可配置的项目生成、反应灵敏的 CLI 等。
博文&分享

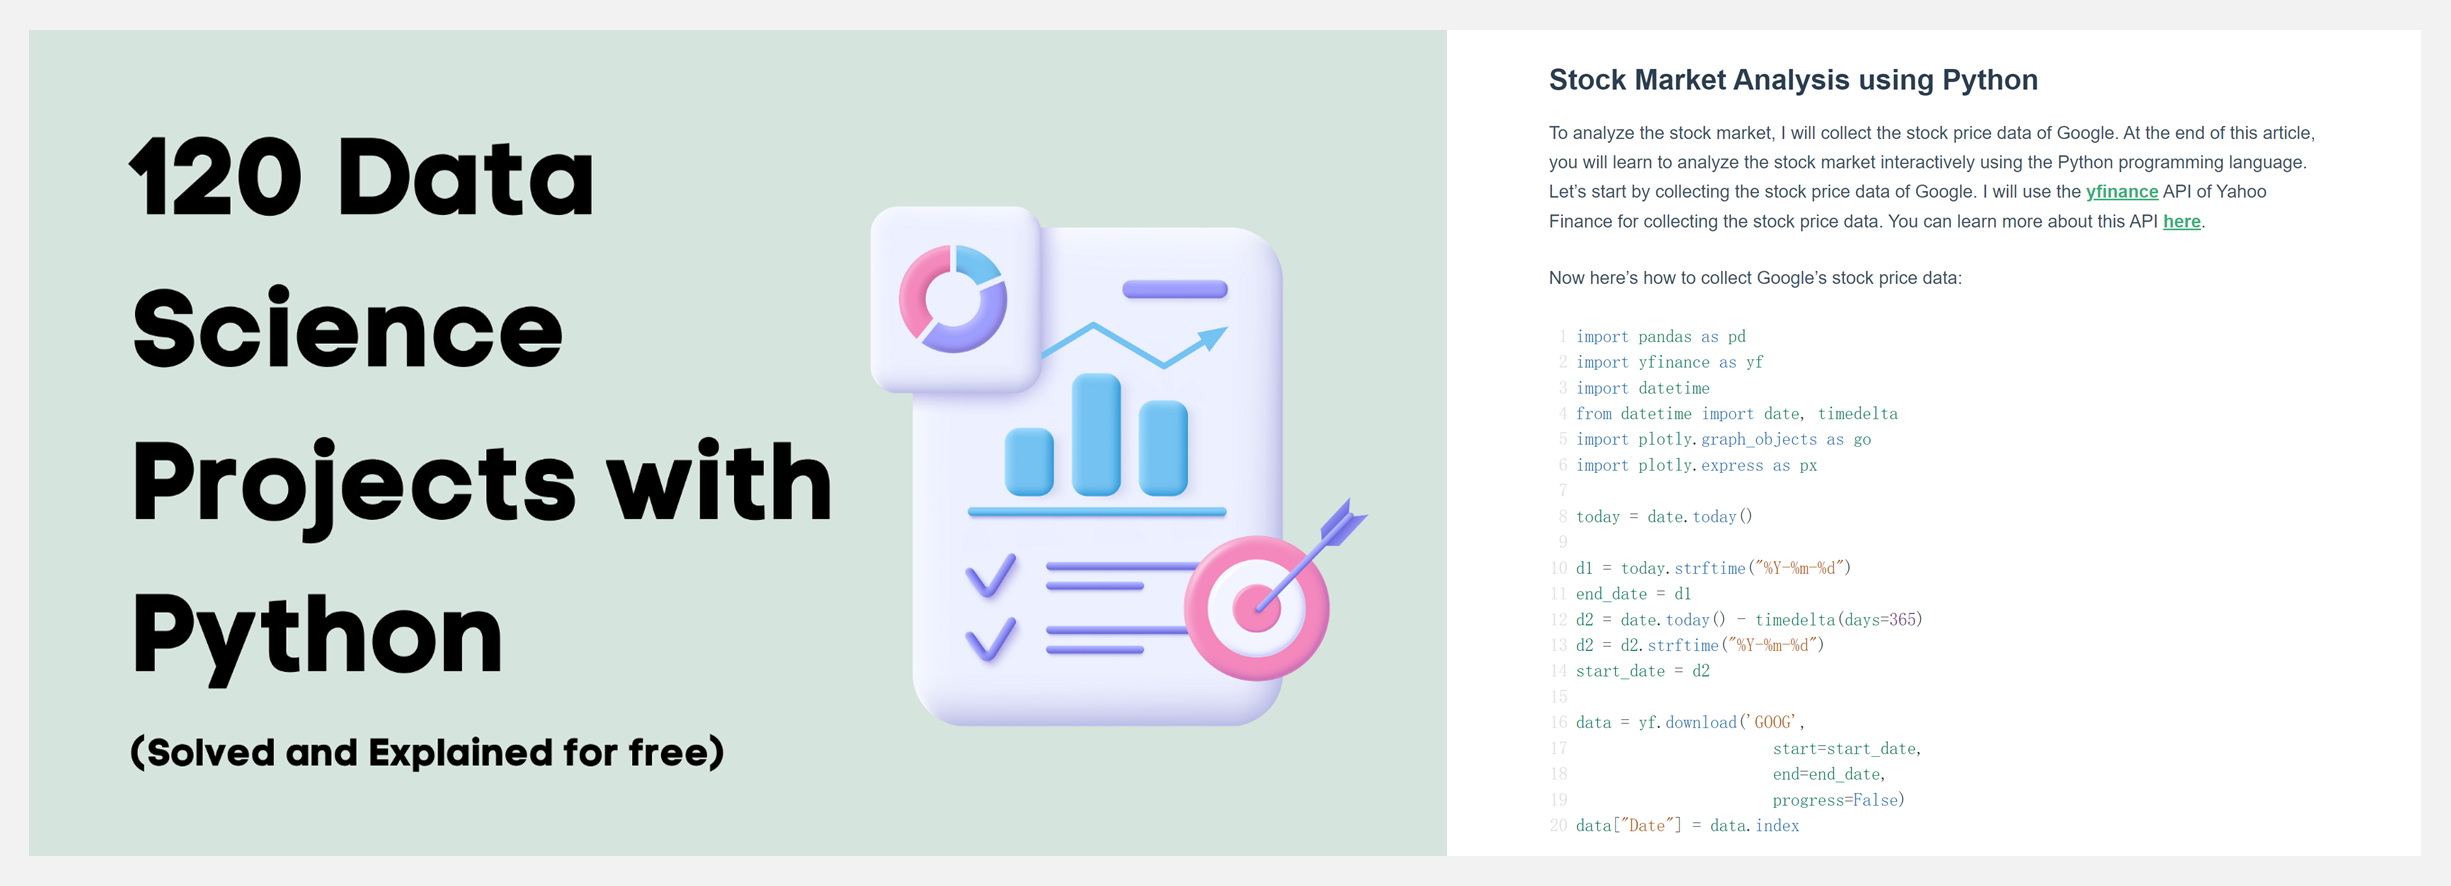
👍 『120 Data Science Projects You Can Try with Python』适合学习/练手的120个(Python)数据科学项目

https://python.plainenglish.io/85-data-science-projects-c03c8750599e

数据科学的初学者,如果不在数据集上实现一些案例,就很难完全理解所学到的内容。如果你正在困惑如何开启一些数据科学的实例项目,那么这篇文章刚好适合你!

作者在本文中整理了 120 个 Python 数据科学项目,用于练习 Python 编程以及实现数据科学的所有概念:分类、回归、情感分析、文本分析、推荐系统、数据分析、价格预测、神经网络、语言检测、自然语言处理NLP、计算机视觉等等。
👍 『A walk through latent space with Stable Diffusion』生成模型的隐空间速览探索

https://keras.io/examples/generative/random_walks_with_stable_diffusion/

生成图像的模型可以学习视觉世界的『latent manifold (隐空间)』——每个点映射到图像的低维向量空间。那么,映射后图像的隐空间就变成了连续与可插值的,即:

  • 在空间上移动一个点,相应的图像只会稍微改变(连续性)。
  • 对于空间中的任意两点A和B,划定一条空间内的路径,就可以将A移动到B,路径中的点就是插值点。
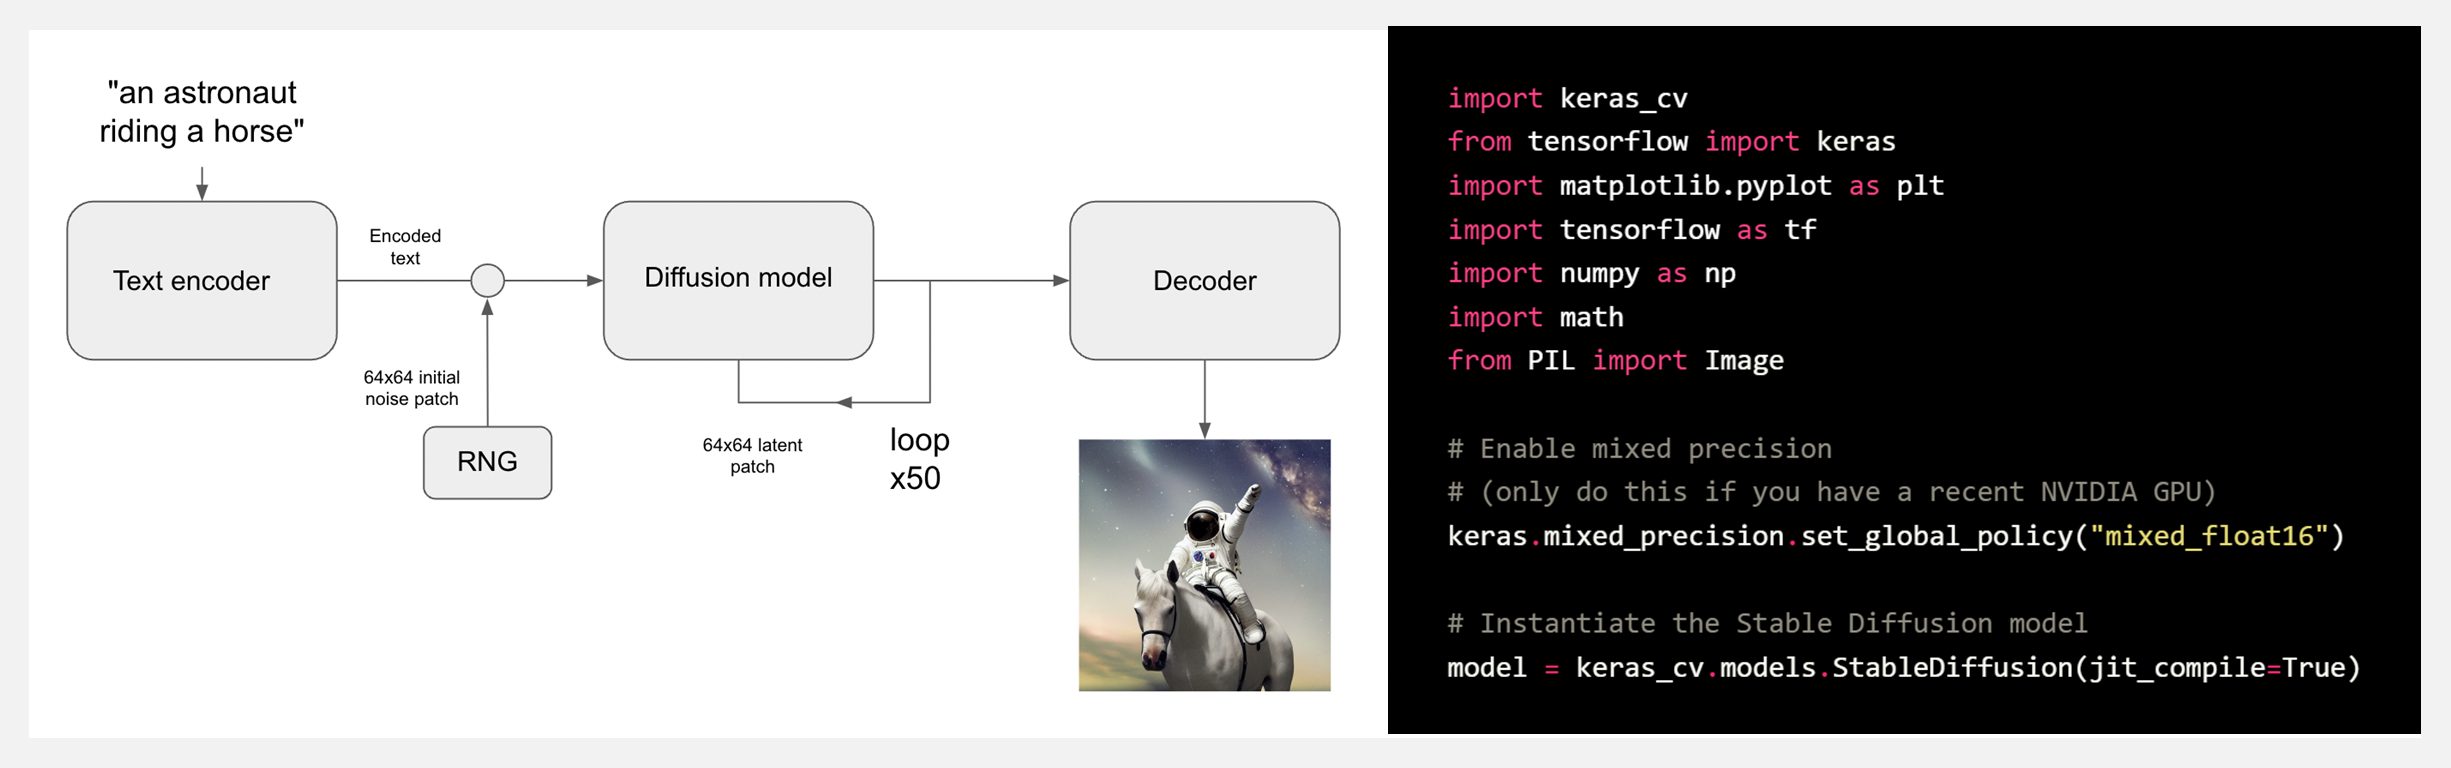
Latent space walking/latent space exploration(隐空间游走/隐空间探索)是对隐空间中的一个点进行采样并逐渐改变潜在表示的过程。它最常见的应用是生成动画。对于高质量的隐表示,就会产生连贯的动画。这些动画可以提供对隐空间特征图的洞察,并改进训练过程。
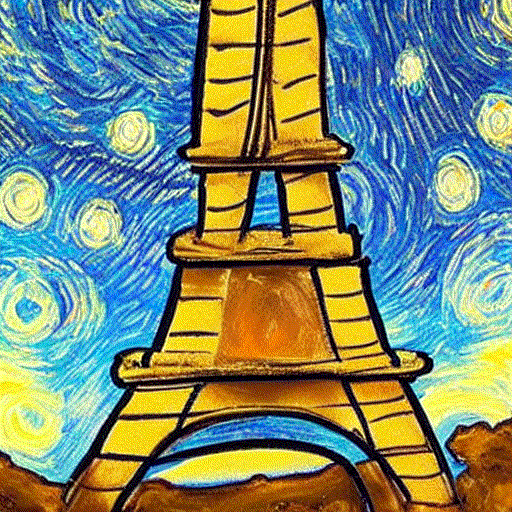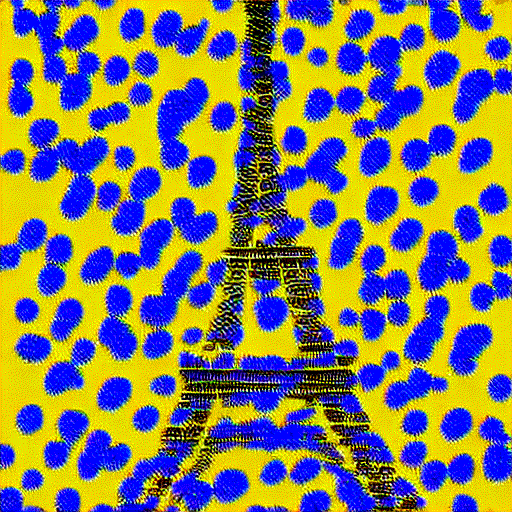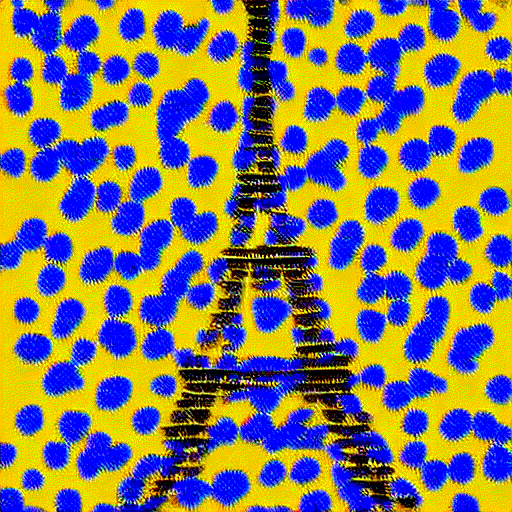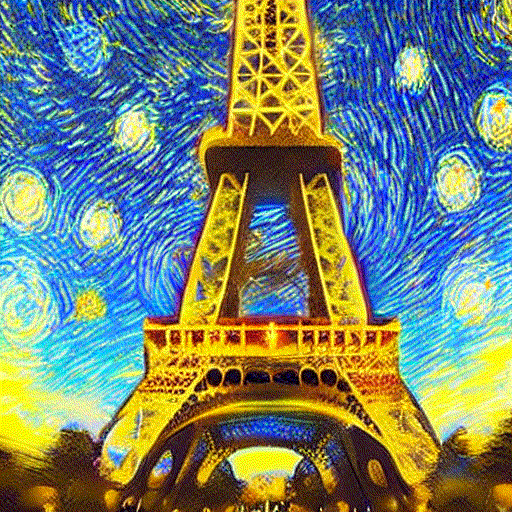
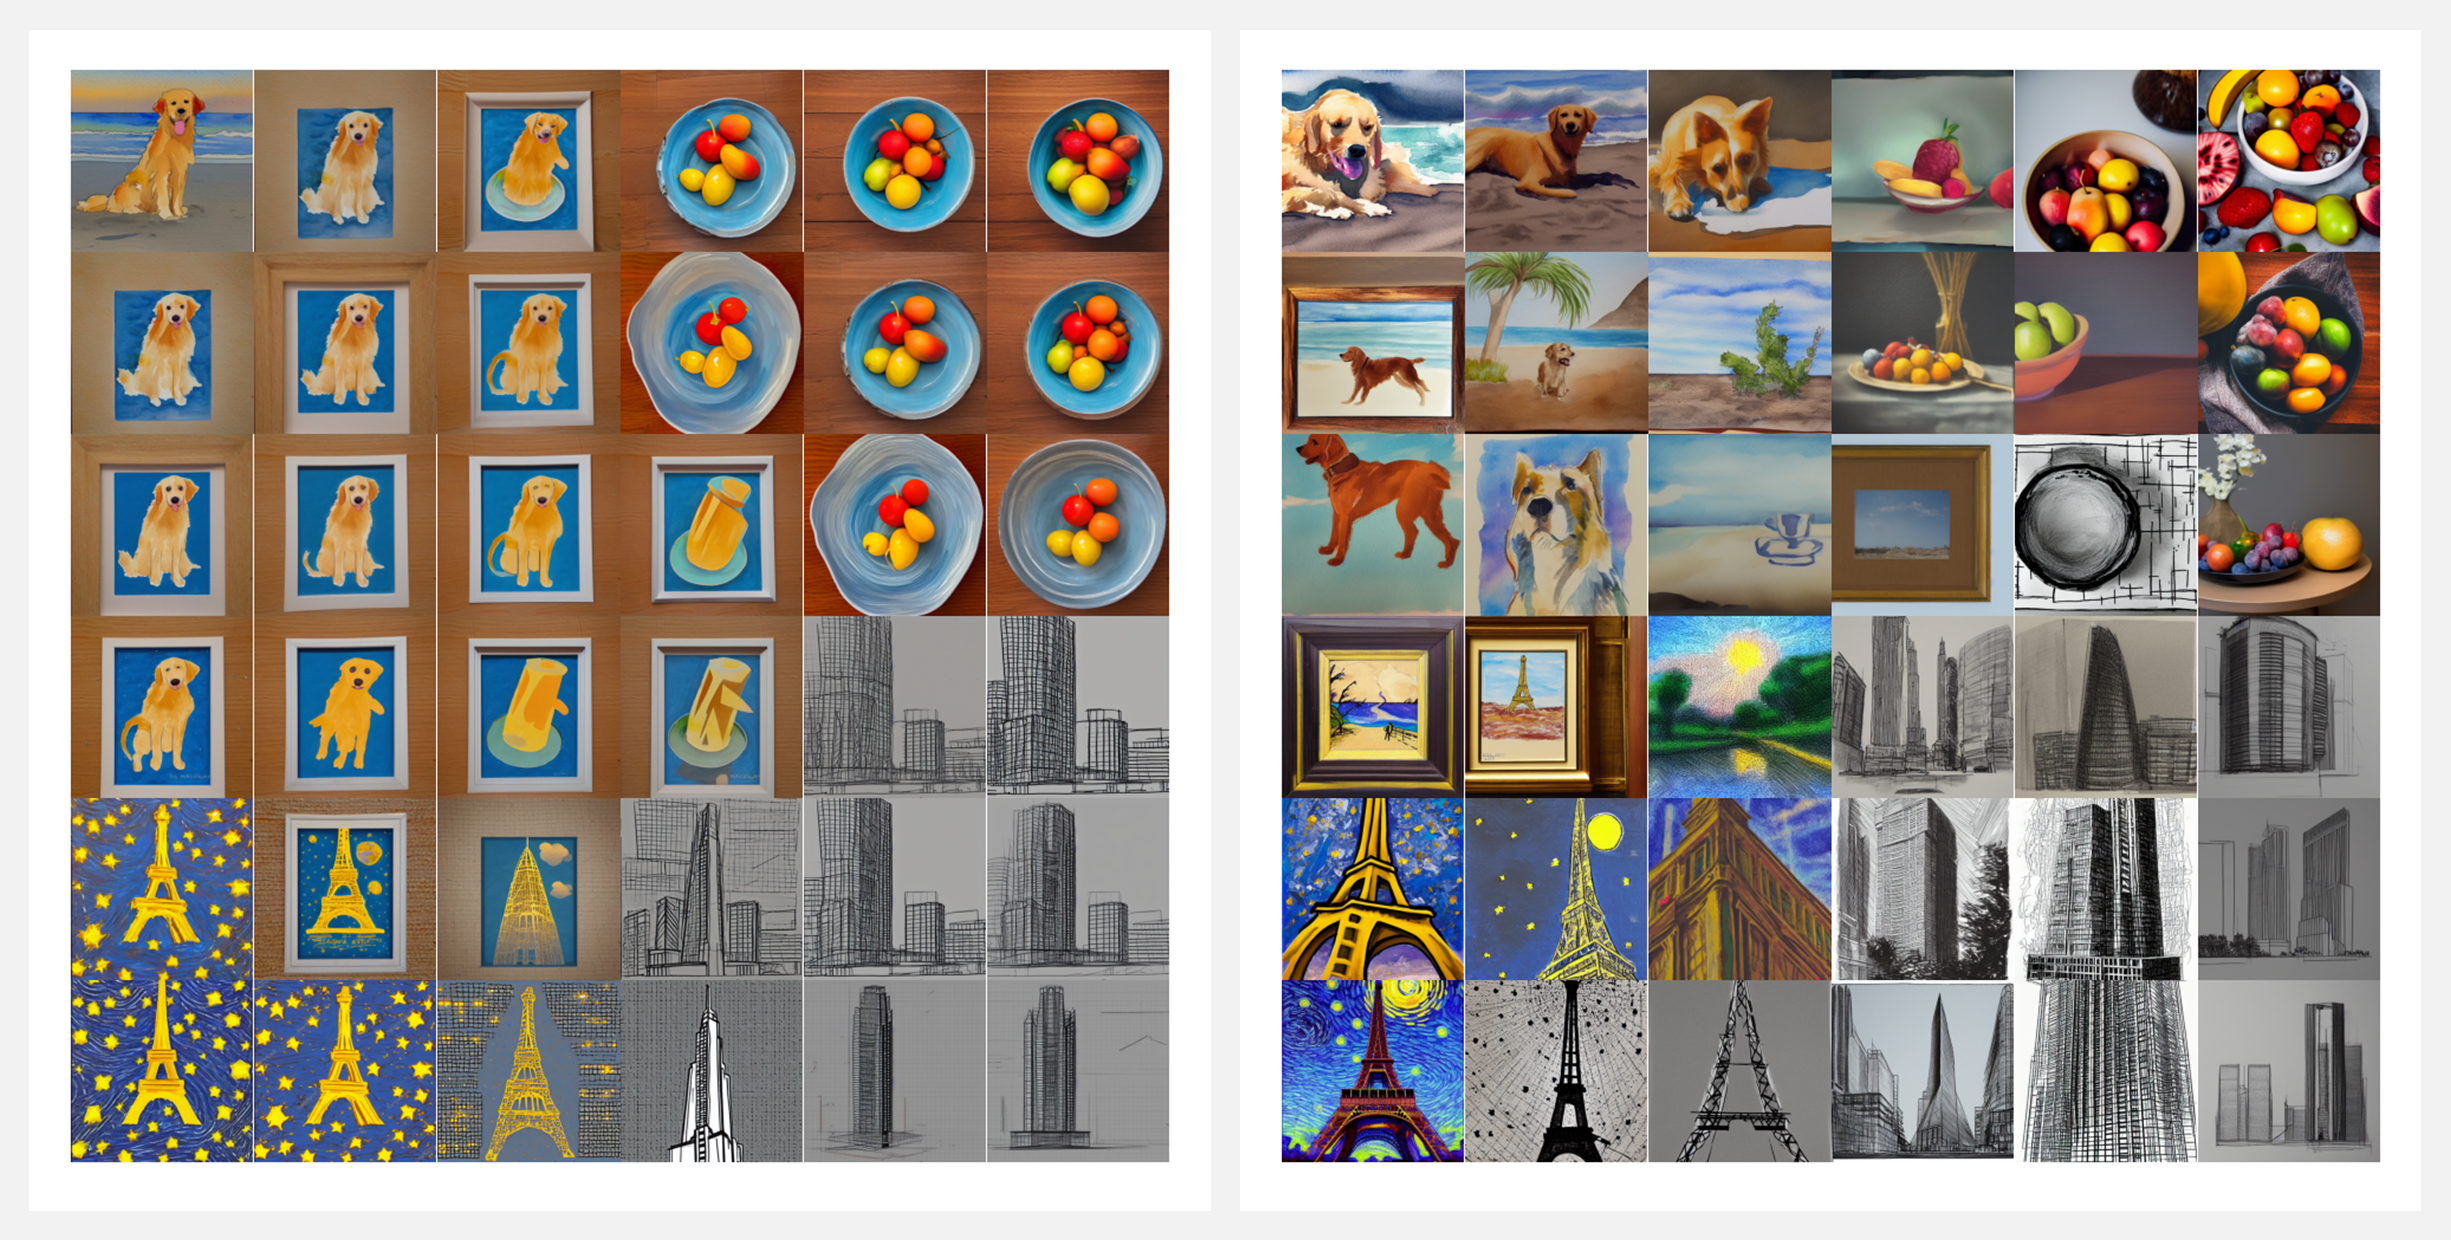
这份指南展示了如何利用 KerasCV 中的稳定扩散 API,在『稳定扩散的视觉隐空间』以及『文本编码器的隐空间』中,执行快速插值和循环遍历。
数据&资源

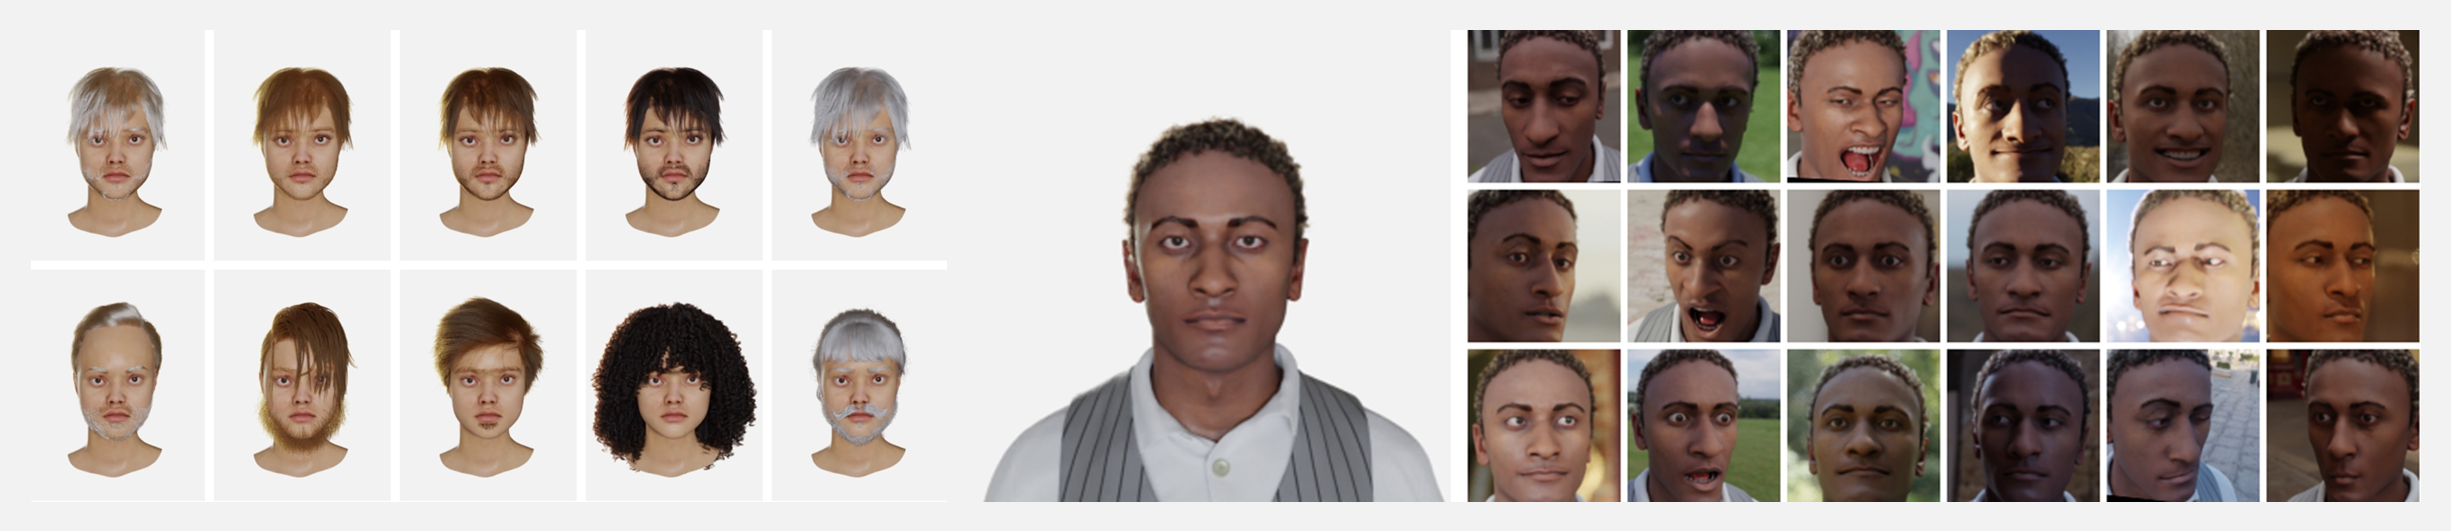
🔥 『DigiFace-1M Dataset』面向人脸识别的百万人脸图像数据集

https://github.com/microsoft/DigiFace1M

https://microsoft.github.io/DigiFace1M/
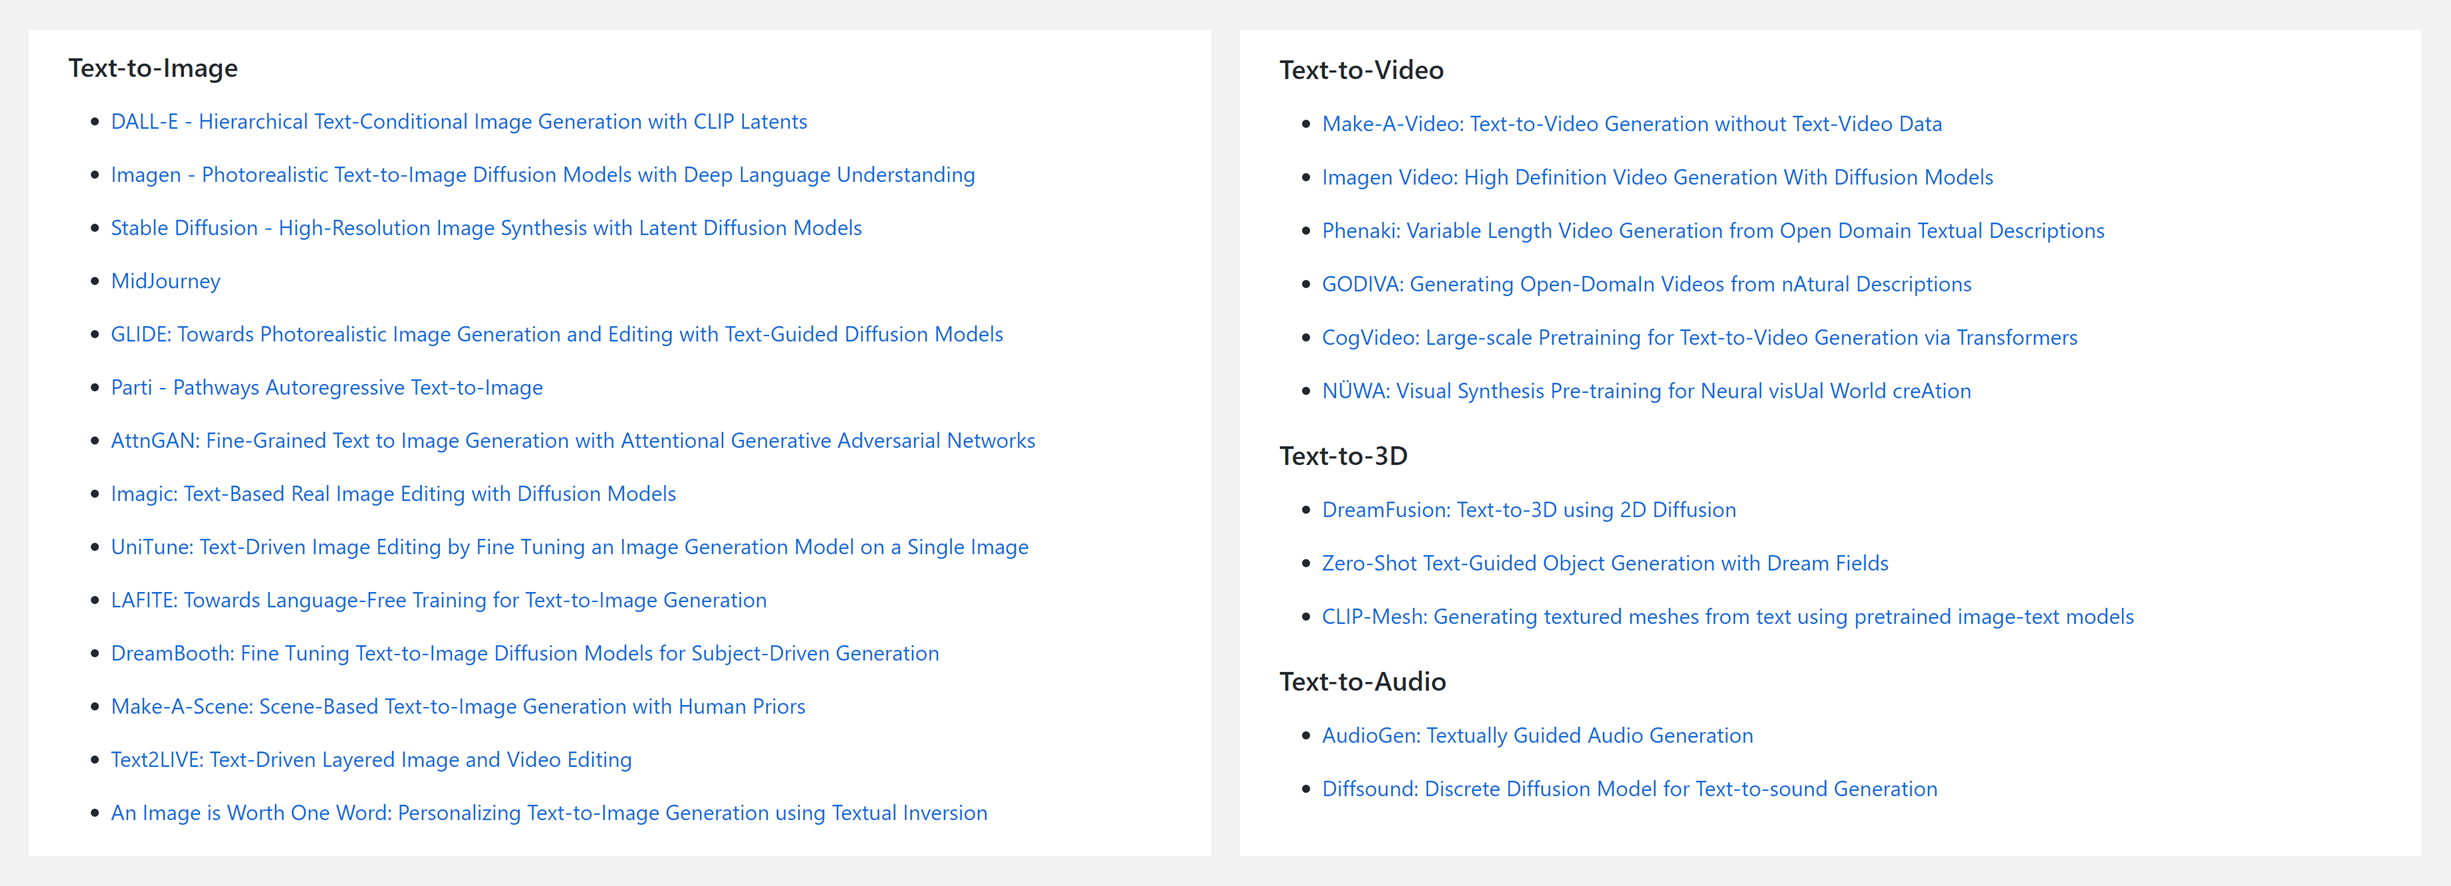
🔥 『Text2All』文本指导生成模型大列表

https://github.com/AvrahamRaviv/Text2All

资源列表包含以下内容:

  • Text-to-Image
  • Text-to-Video
  • Text-to-3D
  • Text-to-Audio
  • Text-to-Motion
  • Text-to-Style

研究&论文

科研进展

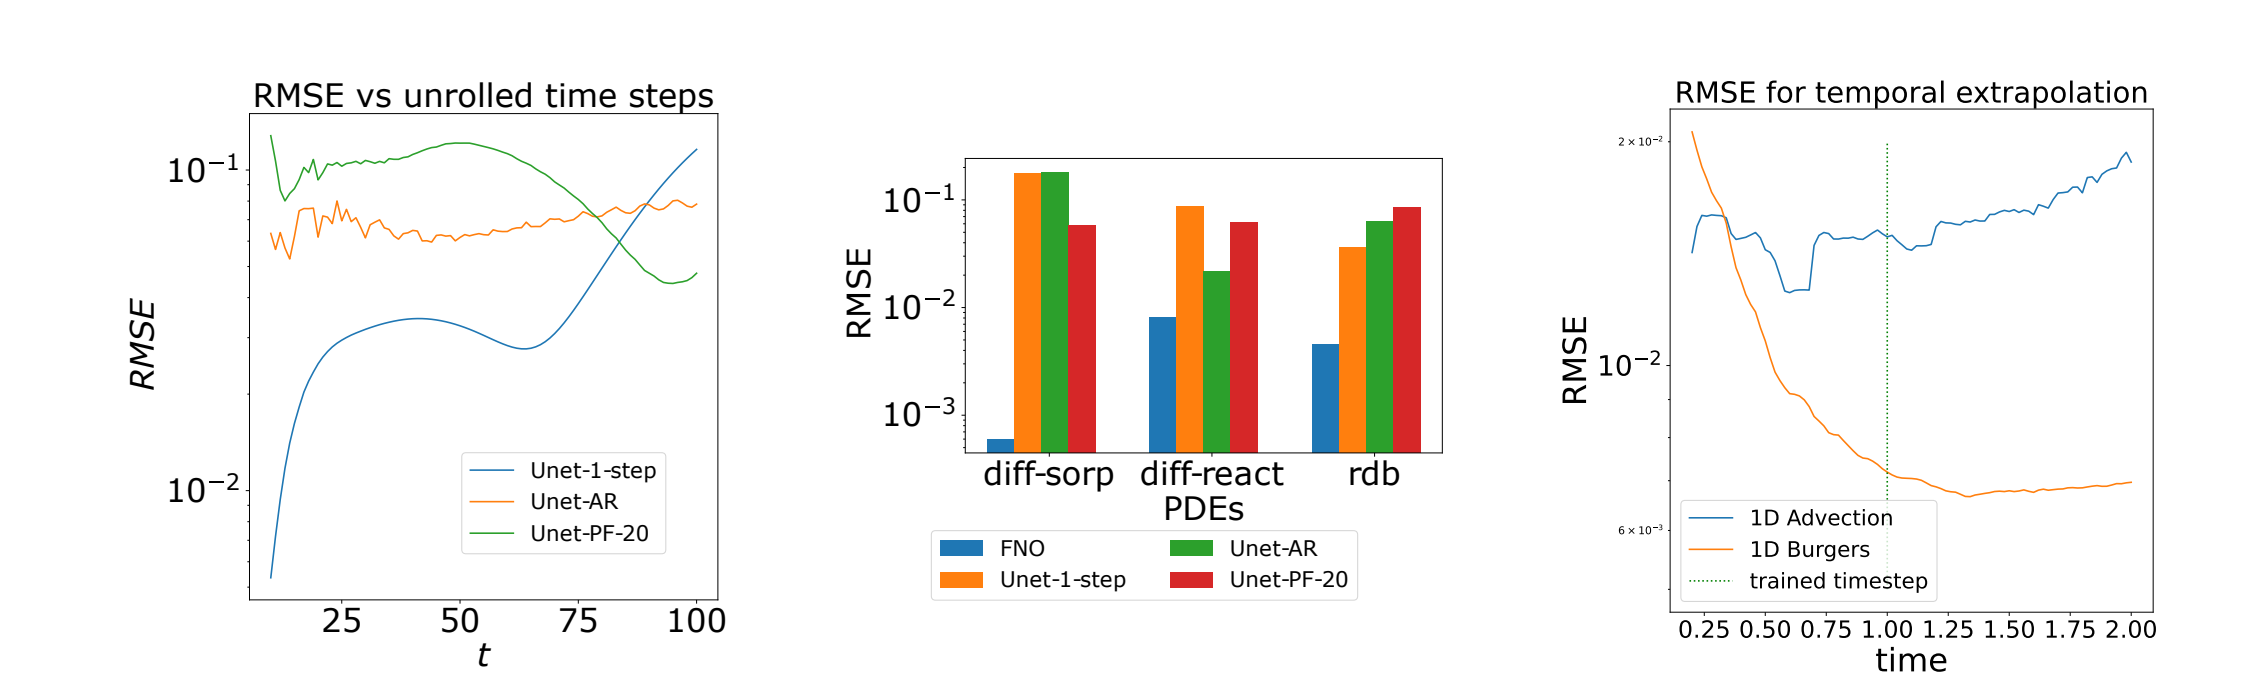
  • 2022.10.13 『机器学习』 PDEBENCH: An Extensive Benchmark for Scientific Machine Learning
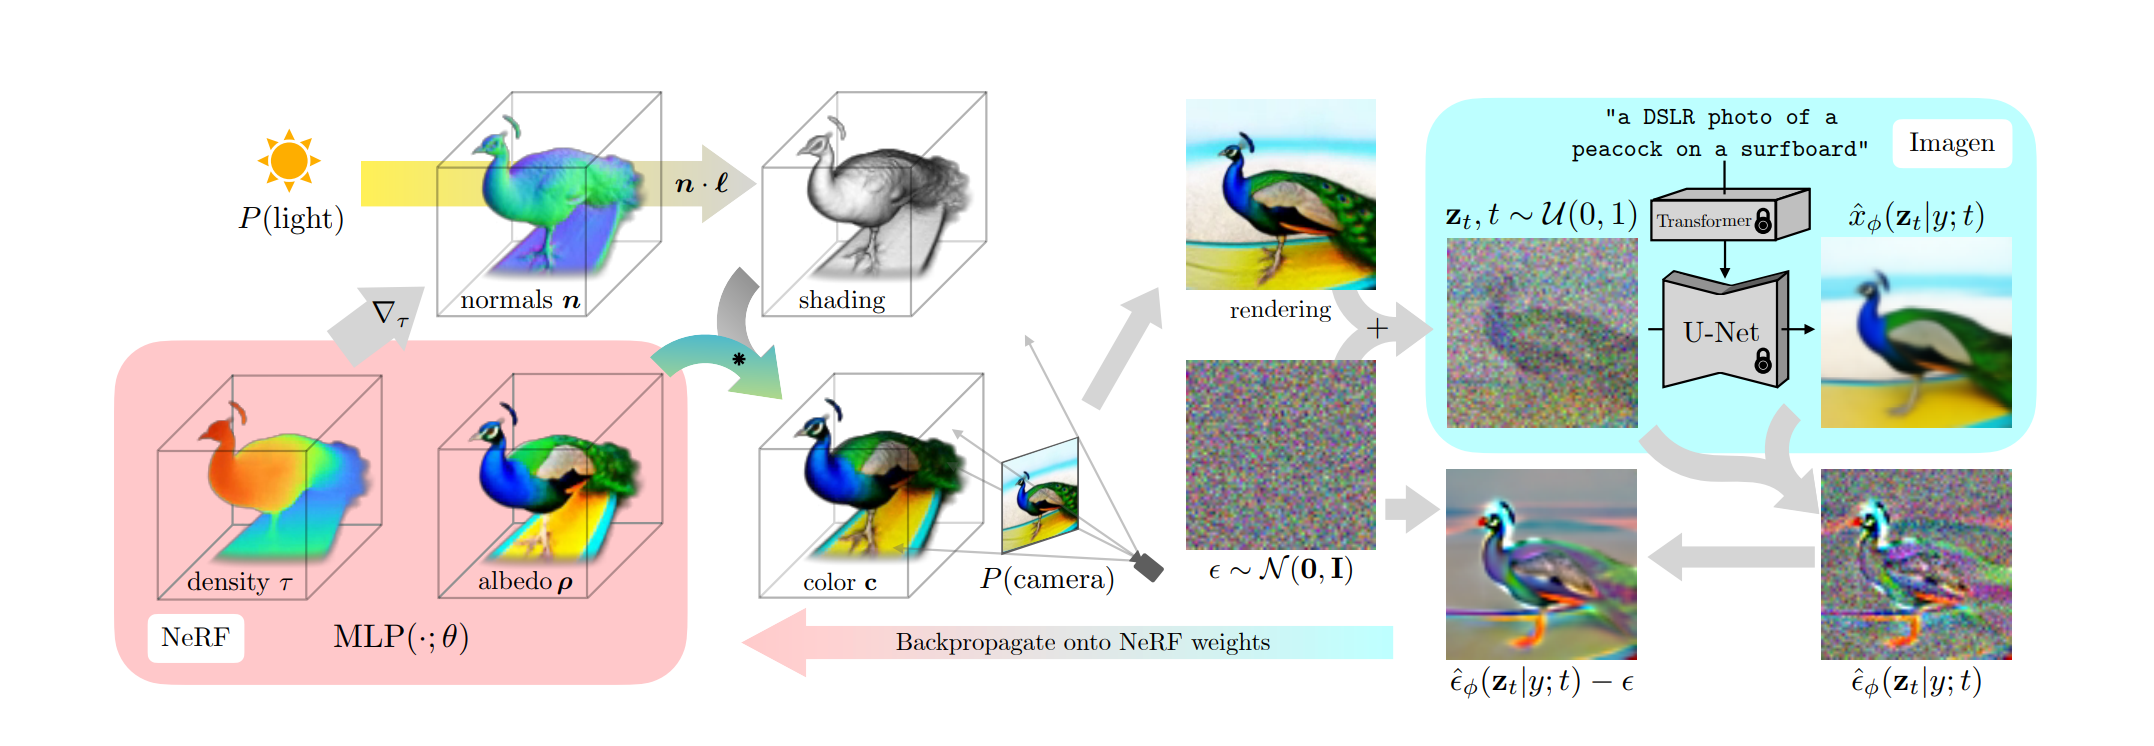
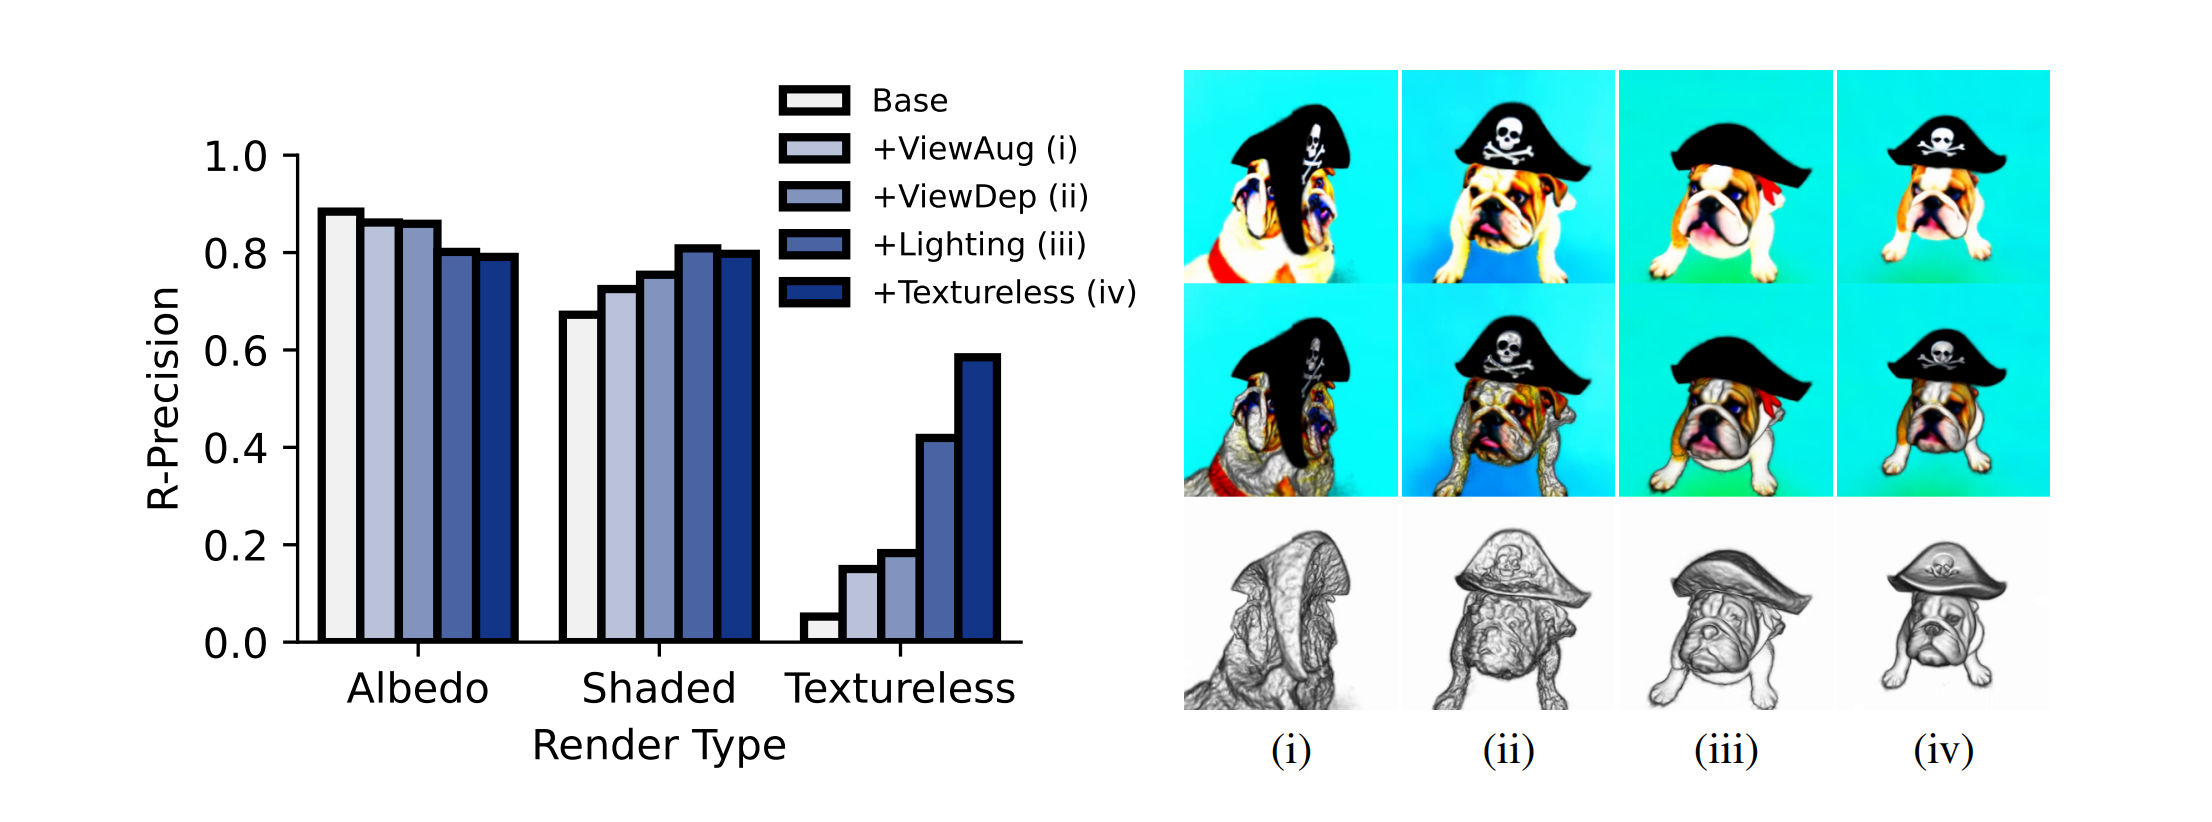
  • 2022.09.29 『图像生成』DreamFusion: Text-to-3D using 2D Diffusion
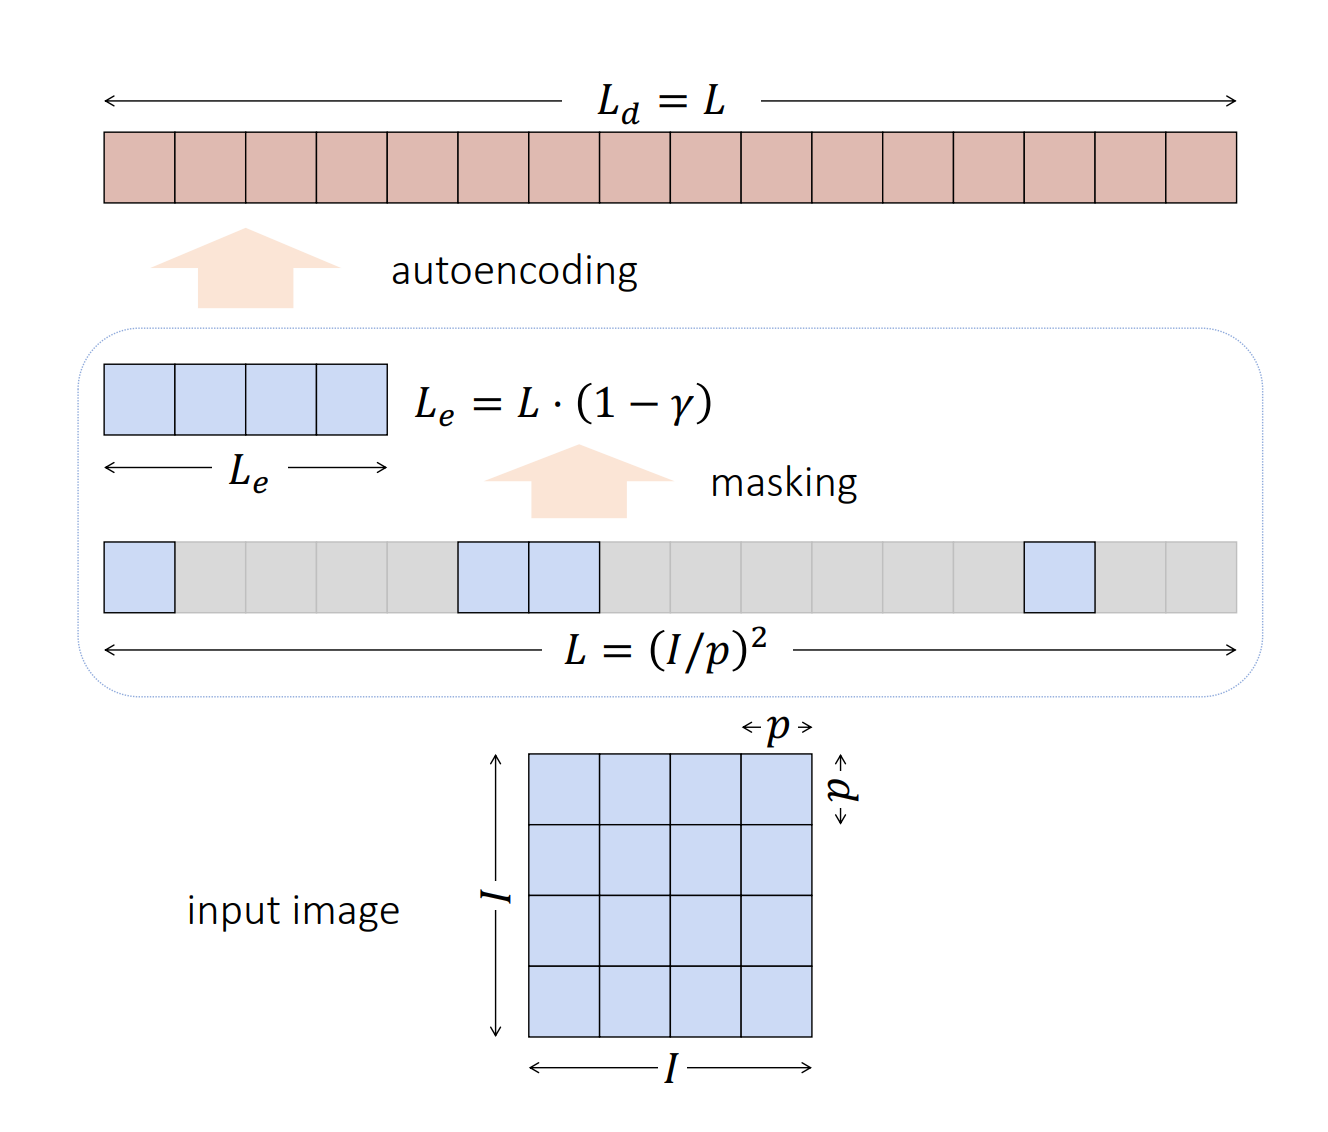
  • 2022.10.13 『目标检测』 Exploring Long-Sequence Masked Autoencoders

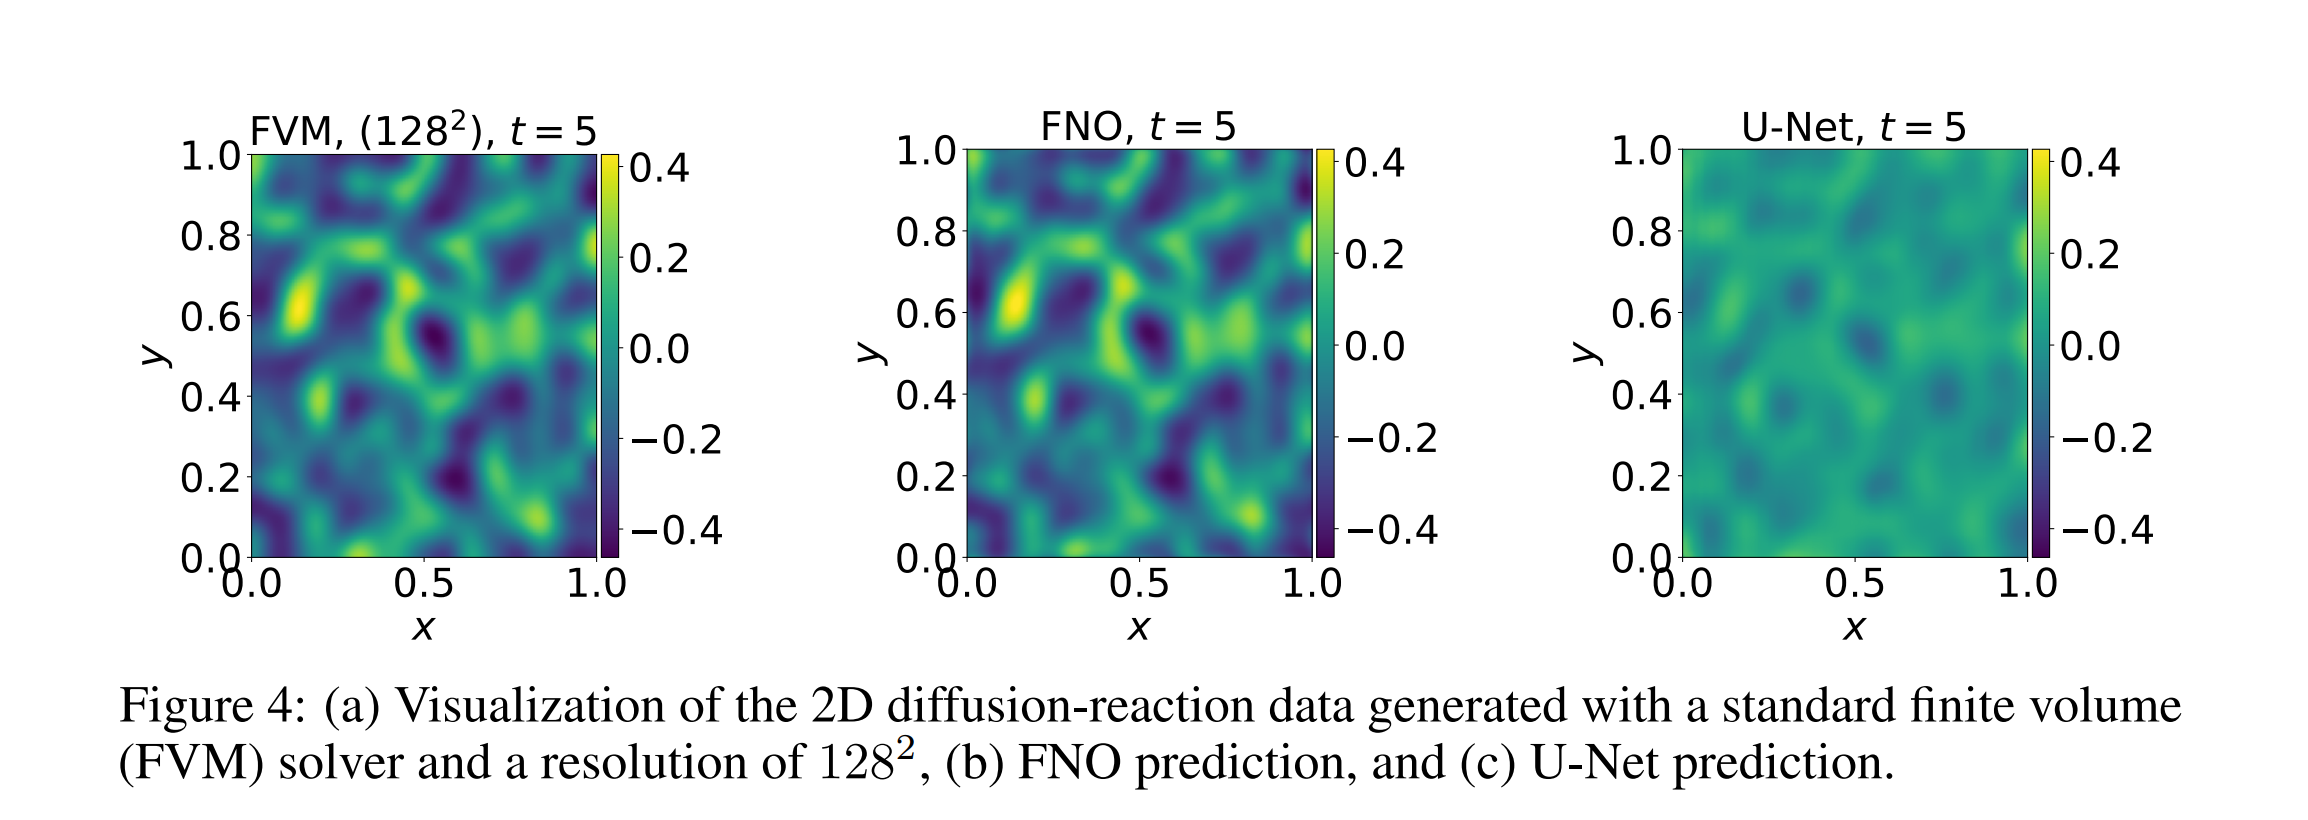
⚡ 论文:PDEBENCH: An Extensive Benchmark for Scientific Machine Learning

论文时间:13 Oct 2022

领域任务:Machine Learning, Computer Vision, 机器学习,计算机视觉

论文地址:https://arxiv.org/abs/2210.07182

代码实现:https://github.com/pdebench/pdebench

论文作者:Makoto Takamoto, Timothy Praditia, Raphael Leiteritz, Dan MacKinlay, Francesco Alesiani, Dirk Pflüger, Mathias Niepert

论文简介:With those metrics we identify tasks which are challenging for recent ML methods and propose these tasks as future challenges for the community./通过这些指标,我们确定了对最近的ML方法具有挑战性的任务,并提出这些任务作为社区的未来挑战。

论文摘要:近年来,基于机器学习的物理系统建模受到越来越多的关注。尽管取得了一些令人印象深刻的进展,但仍然缺乏易于使用但仍然具有挑战性和代表广泛问题的科学ML的基准。我们介绍了PDEBench,这是一个基于偏微分方程(PDE)的时间依赖性仿真任务的基准套件。PDEBench由代码和数据组成,以经典数值模拟和机器学习基线为基准来衡量新型机器学习模型的性能。我们提出的基准问题集有以下独特的特点。(1) 与现有基准相比,PDE的范围更广,从相对常见的例子到更现实和困难的问题;(2) 与先前的工作相比,有更大的现成数据集,包括在更多的初始和边界条件以及PDE参数下的多次模拟运行;(3) 具有用户友好的API的更可扩展的源代码,用于数据生成和流行机器学习模型(FNO, U-Net, PINN, 基于梯度的反演方法)的基线结果。PDEBench允许研究人员使用标准化的API为自己的目的自由扩展基准,并将新模型的性能与现有基线方法进行比较。我们还提出了新的评估指标,目的是在科学ML的背景下对学习方法有一个更全面的了解。通过这些指标,我们确定了对最近的ML方法具有挑战性的任务,并提出这些任务作为社区的未来挑战。该代码可在 https://github.com/pdebench/PDEBench
⚡ 论文:DreamFusion: Text-to-3D using 2D Diffusion

论文时间:29 Sep 2022

领域任务:Denoising, Image Generation, 去噪,图像生成

论文地址:https://arxiv.org/abs/2209.14988

代码实现:https://github.com/ashawkey/stable-dreamfusion

论文作者:Ben Poole, Ajay Jain, Jonathan T. Barron, Ben Mildenhall

论文简介:Using this loss in a DeepDream-like procedure, we optimize a randomly-initialized 3D model (a Neural Radiance Field, or NeRF) via gradient descent such that its 2D renderings from random angles achieve a low loss./在一个类似DeepDream的程序中使用这种损失,我们通过梯度下降来优化一个随机初始化的3D模型(一个神经辐射场,或NeRF),从而使其从随机角度的2D渲染达到一个低损失。

论文摘要:最近在文本到图像合成方面的突破是由在数十亿图像-文本对上训练的扩散模型驱动的。将这种方法应用于三维合成需要大规模的标记三维数据集和高效的三维数据去噪架构,而这两者目前都不存在。在这项工作中,我们通过使用预先训练好的二维文本到图像的扩散模型来执行文本到三维的合成,从而规避了这些限制。我们引入了一种基于概率密度蒸馏的损失,使得二维扩散模型可以作为优化参数化图像生成器的先验。在一个类似DeepDream的程序中使用这种损失,我们通过梯度下降法优化一个随机初始化的三维模型(一个神经辐射场,或NeRF),使其从随机角度的二维渲染达到低损失。由此产生的给定文本的三维模型可以从任何角度观看,通过任意的照明重新点亮,或者合成到任何三维环境中。我们的方法不需要3D训练数据,也不需要修改图像扩散模型,这证明了预训练的图像扩散模型作为先验因素的有效性。
⚡ 论文:Exploring Long-Sequence Masked Autoencoders

论文时间:13 Oct 2022

领域任务:Object Detection, 目标检测

论文地址:https://arxiv.org/abs/2210.07224

代码实现:https://github.com/facebookresearch/long_seq_mae

论文作者:Ronghang Hu, Shoubhik Debnath, Saining Xie, Xinlei Chen

论文简介:Masked Autoencoding (MAE) has emerged as an effective approach for pre-training representations across multiple domains./掩码自动编码(MAE)已成为跨领域预训练表征的有效方法。

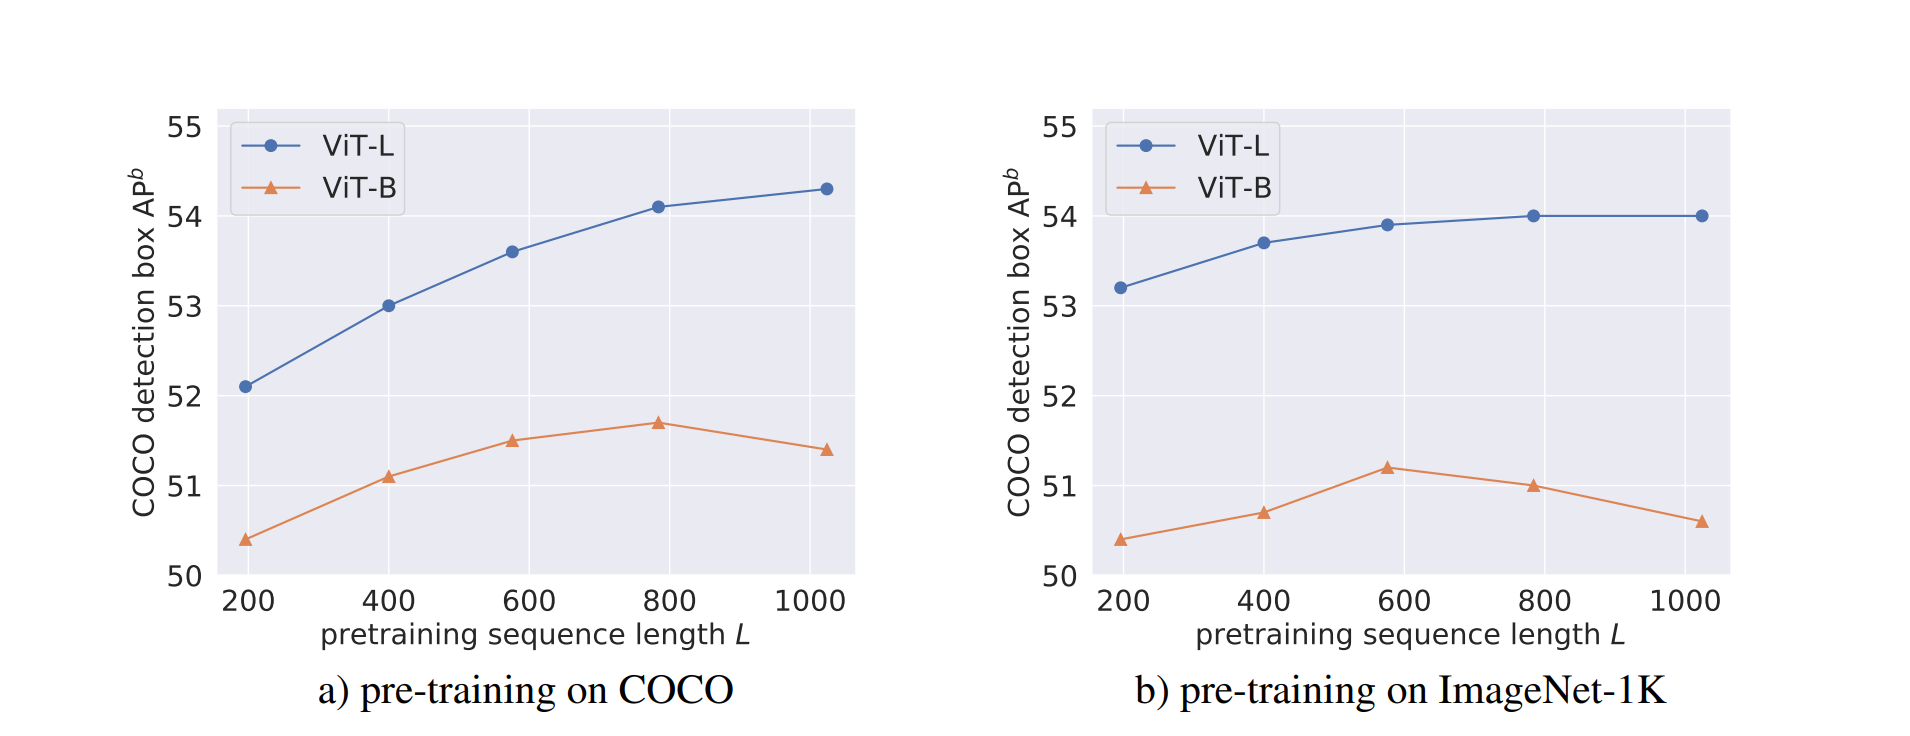
论文摘要:遮蔽自动编码(MAE)已经成为跨领域预训练表征的一种有效方法。与自然语言中的离散标记相比,图像自动编码的输入是连续的,并受制于其他规格。我们在预训练阶段系统地研究了每个输入规格,发现序列长度是进一步扩展MAE的一个关键轴。我们的研究导致了一个长序列版本的MAE,对原始配方的变化最小,只是将掩码大小与补丁大小解耦。对于物体检测和语义分割,我们的长序列MAE在所有的实验设置中都显示出一致的收益,在转移过程中没有额外的计算成本。虽然长序列的预训练被认为对检测和分割最有利,但我们也通过保持标准图像大小和只增加序列长度在ImageNet-1K分类上取得了强大的结果。我们希望我们的发现能够为计算机视觉的扩展提供新的见解和途径。
NLP实战学习(2):基于Bertopic的新闻主题建模 • 深度语义向量 + 传统聚类方法: (1)通过Bert计算得到语句的深度语义向量 (2)通过HDBSCAN进行聚簇处理 (3)通过c-tfidf进行调整聚簇的粒度并提取主题关键词链接: 阅读详情

相关推荐

sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2

huggingface下载速度慢,遇到sentence-transformers模型下载失败还是尽量使用进行本地下载改路径的方式。

[原创]python计算中文文本相似度神器

介绍 最近因为工作需要,需要使用一个功能,就是中文文本相似度的计算。属于nlp领域的一个应用吧,这里找到一个非常好的包和大家分享。这个包叫sentence-transformers。 这里给大家介绍,如何使用这个包对中文文本做相似度计算(这个包的其中一个小用途罢了) 这里使用的模型是paraphrase-multilingual-MiniLM-L12-v2模型,因为paraphrase-MiniLM-L6-v2模型已经非常好了,paraphrase-multilingual-MiniLM-L12-v2是

yuanzhoulvpi的博客 2万+

sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 模型

这是一个句子转换器模型,它将句子和段落映射到 384 维密集向量空间,可用于聚类或语义搜索等任务,是 sentence_transformers 库的模型之一,官网下载速度缓慢,容易被墙,下载解压后,可以参考此文章进行模型本地加载 https://blog.youkuaiyun.com/weixin_43721000/article/details/125507996

【免费下载】 提升文本相似度计算的精度与效率:应用paraphrase-multilingual-MiniLM-L12-v2模型

在当今信息爆炸的时代,文本数据的处理与分析变得日益重要。特别是在自然语言处理(NLP)领域,文本相似度计算是许多应用的核心,如语义搜索、文本聚类、信息检索等。本文将探讨如何利用paraphrase-multilingual-MiniLM-L12-v2模型来提升这些任务的效率与精度。 ## 引言 文本相似度计算的任务是评估两段文本在语义上的接近程度。传统的基于关键词或规则的方法往往忽略了文本的深...

gitblog_02919的博客 1751

第二十届全国大学生智能车竞赛-地瓜机器人智慧医疗挑战赛技术解析与实战指南

本文深入解析了第二十届全国大学生智能车竞赛-地瓜机器人智慧医疗挑战赛的核心技术。内容涵盖从零搭建数字孪生环境、实现AI视觉任务(二维码识别、引导线追踪、目标检测)、在边缘设备部署轻量化大模型进行图生文描述,到遥操作与自主控制的平滑切换,并提供了基于ROS2的系统集成与赛场实战指南,助力参赛者高效备赛。

weixin_29252171的博客 2778

HALCON基于描述符的模板匹配(未标定)

HALCON基于不标定描述符的模板匹配

king_linj的博客 892

人工智能学习与实训笔记(五):神经网络之NLP进阶—词向量模型及NLP实战

本文介绍词向量处理和预训练模型微调方法

weixin_45512098的博客 3119

生物信息学新手必看:MAFFT多序列比对从安装到实战(附参数优化技巧)

本文为生物信息学新手提供了MAFFT多序列比对工具的完整指南。从Linux环境下的安装部署,到核心算法策略(如FFT-NS-i、L-INS-i)的选择逻辑,再到空位罚分等关键参数的深度解析与优化技巧,手把手教你完成从原始序列到高质量比对结果的实战流程,为后续进化树构建等分析奠定坚实基础。

weixin_29230773的博客 486

【免费下载】 深入解析:理解 paraphrase-multilingual-MiniLM-L12-v2 模型

在当前的自然语言处理(NLP)领域中,高质量的句子嵌入模型扮演着至关重要的角色,它们能够将复杂语言概念转化为易于机器处理的向量形式。今天我们将深入探索一个特别受欢迎的模型:`paraphrase-multilingual-MiniLM-L12-v2`。它是`sentence-transformers`库中的一员,擅长于多语言环境下的句子相似性检测和文本分析。 ## 简介 `paraphrase...

gitblog_02851的博客 2564

TeXstudio完整安装配置教程(2025最新版)

至此,你已经完成了TeXstudio的完整安装和配置!现在你可以:✅ 使用TeXstudio编写LaTeX文档✅ 正确编译中英文混排的文档✅ 掌握基本的编辑和配置技巧LaTeX的学习曲线较陡,但一旦掌握,你会发现它在学术写作中的强大之处。建议从简单的文档开始练习,逐步掌握更高级的功能。祝你LaTeX写作顺利!如果有任何问题,欢迎在评论区留言交流。关键词:TeXstudio安装、LaTeX环境配置、中文LaTeX、TeX Live、学术论文写作更新日期:2025年10月。

weixin_51241407的博客 4505

Windows/Mac/Linux三系统保姆级教程:用llama.cpp将safetensors模型转gguf格式(附常见错误解决)

本文提供Windows、Mac和Linux系统下使用llama.cpp将safetensors模型转换为gguf格式的详细教程,涵盖环境配置、转换原理及常见错误解决方案。通过跨平台兼容性处理,帮助开发者高效完成模型格式转换,优化边缘计算性能。

weixin_29227425的博客 270

【亲测免费】 深度学习模型使用技巧:paraphrase-multilingual-MiniLM-L12-v2篇

在深度学习领域,积累使用技巧是提高工作效率和模型性能的关键。本文将针对paraphrase-multilingual-MiniLM-L12-v2模型,分享一系列实用的使用技巧,旨在帮助您更加高效地利用这一强大的句子嵌入模型。 ## 提高效率的技巧 ### 快捷操作方法 1. **快速安装**:使用pip命令快速安装sentence-transformers库,以便使用该模型: ```...

gitblog_02364的博客 1312

布尔可满足性问题(SAT)深度研究

布尔可满足性问题(Boolean Satisfiability Problem, SAT)是计算机科学和数理逻辑中的一个核心决策问题。其定义为:对于一个给定的布尔逻辑公式,判断是否存在一组对其变量的真值赋值(即,为每个变量指定真 (True) 或假 (False)),使得该公式的最终计算结果为真。如果存在这样的赋值,则称该布尔公式是可满足的 (satisfiable);否则,称其为不可满足的 (unsatisfiable)。

步子哥的博客 497

paraphrase-multilingual-MiniLM-L12-v2.zip 下载

链接:https://pan.baidu.com/s/1pvxq5g5yenubDDIzcwut7Q。1. 安装sentence-transformers。

gaizhongfeng的专栏 3673

【技术科普】破解政务跨系统数据壁垒!亘川一网统管平台多源数据同步技术解析

本文解析亘川一网统管平台多源数据同步技术,针对政务跨系统数据壁垒难题,介绍组件的数据采集、校验、审计留痕等核心能力,结合营商环境项目落地案例,对比传统开发模式差异,讲解开源组件的实践价值,为政务项目开发者提供落地参考。

weixin_67440240的博客 635

电子电器架构 -- 汽车零部件DV试验与PV试验的定义及关键差异

电子电器架构 -- 汽车零部件DV试验与PV试验的定义及关键差异

Soly_kun的博客 734

SwiftUI-Introspect 用户体验优化:提升开发效率的 IDE 集成

SwiftUI-Introspect 是一个强大的开发工具,它允许开发者访问 SwiftUI 视图底层的 UIKit 或 AppKit 元素。通过 IDE 集成,这个库能够显著提升 SwiftUI 开发体验,让开发者能够更深入地定制和优化界面组件。✨ ## 为什么选择 SwiftUI-Introspect? SwiftUI-Introspect 解决了 SwiftUI 开发中的一个关键痛点:无

gitblog_00490的博客 937

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

显存优化退散:paraphrase-multilingual-MiniLM-L12-v2量化优化全指南

你是否在部署多语言文本嵌入模型时遭遇过"显存不足"的警告?是否因GPU内存限制被迫降低 batch size 导致推理速度骤降?本文将从模型架构解析到量化落地实践,系统解决paraphrase-multilingual-MiniLM-L12-v2的显存占用问题,让你的嵌入式设备也能流畅运行多语言语义匹配任务。 读完本文你将获得: - 精确计算模型各组件显存占用的方法 - 3种量化方案的实测对比(...

gitblog_00184的博客 1152

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【免费下载】 深度解析 paraprase-multilingual-MiniLM-L12-v2 模型:跨越语言障碍的桥梁

在当今全球化的信息时代,语言之间的障碍常常限制了知识的传播和交流。为了打破这一壁垒,自然语言处理(NLP)技术应运而生。其中,sentence-transformers 提供的 paraprase-multilingual-MiniLM-L12-v2 模型以其强大的跨语言功能,成为连接不同语言的重要工具。本文旨在介绍该模型的基本概念、特点及其在 NLP 领域的应用价值。 ## 模型的背景 pa...

gitblog_02717的博客 3478

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

文本向量表征工具,实现了Word2Vec、RankBM25、Sentence-BERT、CoSENT,开箱即用

向AI转型的程序员都关注了这个号????????????文本向量表示模型Word2Vec:通过腾讯AI Lab开源的大规模高质量中文词向量数据(800万中文词轻量版)(文件名:light_Tencent_AILab_ChineseEmbedding.bin 密码: tawe)实现词向量检索,本项目实现了句子(词向量求平均)的word2vec向量表示SBERT(Sentence-BERT):权衡性能和效率的句向量表...

datayx的文章 2722

【亲测免费】 选择适合的模型:paraphrase-multilingual-MiniLM-L12-v2的比较

在当今的机器学习领域,选择合适的模型对于实现项目的成功至关重要。面对众多模型,如何做出明智的选择成为许多开发者和研究者的困惑。本文将对比分析paraphrase-multilingual-MiniLM-L12-v2模型与其他几种常见模型,帮助读者更好地理解并选择适合自己需求的模型。 ## 需求分析 在选择模型之前,首先需要明确项目目标和性能要求。假设我们的项目目标是实现跨语言句子相似度计算,性...

gitblog_02834的博客 1332

3大维度突破:paraphrase-multilingual-MiniLM-L12-v2性能调优实战指南

- 掌握3种性能瓶颈定位工具的使用方法与结果分析 - 获得5种计算效率优化技术的原理公式与实现代码 - 学会在PyTorch和TensorFlow框架中部署优化模型 - 建立动态任务调度系统解决高并发场景性能问题 - 设计完整的性能监控方案并设置关键指标告警阈值 ## 1. 性能瓶颈诊断方法论 ### 1.1 性能指标体系 在进行模型性能调优前,需要建立完整的性能指标体系: | 指标类别 |

gitblog_00643的博客 430

【亲测免费】 利用 paraprase-multilingual-MiniLM-L12-v2 模型进行跨语言句子相似度计算

在当今多语言信息交流日益频繁的背景下,跨语言句子相似度计算成为自然语言处理领域的一个重要任务。这项技术可以帮助我们理解不同语言之间的语义联系,为机器翻译、信息检索、跨语言问答等应用提供支持。本文将介绍如何使用 paraprase-multilingual-MiniLM-L12-v2 模型来完成这一任务,并展示其在实际应用中的优势。 ## 引言 跨语言句子相似度计算的核心是找到不同语言句子之间的...

gitblog_02108的博客 956

bert4vec:一个基于预训练的句向量生成工具 环境

bert4vec:一个基于预训练的句向量生成工具 环境 transformers>=4.6.0,<5.0.0 torch>=1.6.0 numpy huggingface-hub faiss (optional) 安装 方式一 pip install -i https://pypi.tuna.tsinghua.edu.cn/simple/ bert4vec 方式二 git clone https://github.com/zejunwang1/bert4vec cd bert4vec

思念可是反的博客 996
上一篇: 效率UP!机器学习从废品中分拣可回收材料;计算机科学自学计划▪中译版;Python入门指南;好用的代码自动补全工具;前沿论文 | ShowMeAI资讯日报
下一篇: 欧洲赢麻了!互联网巨头被迫拆围墙;git常用命令速查;Diffusion扩散模型实例教程集;高效C++机器学习库;前沿论文 | ShowMeAI资讯日报
ShowMeAI
博客等级 码龄5年 6514粉丝 672原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

ShowMeAI

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值