SelectDB 多计算集群核心设计要点揭秘与场景应用

DB(四):SELECT查询、查询条件、排序、分组、集合操作 包括SELECT语句、AS别名、WHILE子句;AND和OR关键字、LIKE条件、IN和NOT IN、BETWEEN...AND...操作符、IS NULL和IS NOT NULL、ANY和ALL条件、DISTINCT去重;使用ORDER BY子句排序;使用GROUP BY子句分组、HAVING子句、查询语句的执行顺序;集合操作UNION、UNION ALL、MINUS。 阅读详情

需求起源

SelectDB 设计多计算集群架构初衷主要源于两类典型的使用场景:

  • 写入与读取隔离:传统数仓架构中,数据的写入和读取在同一个计算集群,当遇到业务写入高峰期或突增的写入压力时,容易因资源相互抢占影响查询服务的性能和稳定性。如果能引入多个计算集群,通过独立的计算集群分别进行写入、读取操作,即使在写入压力非常高时,也可放心执行计算任务,无需担心影响到服务的稳定性。

  • 在线业务和离线业务隔离:大量数据分析场景会使用相同的数据支撑多个业务,比如某业务使用一份数据支持面向 C 端用户的数据查询,另一个业务需要使用相同数据支持企业内部用户的运营分析等,这两个业务对于服务的延时、可用性要求完全不同。传统架构通常会把数据冗余存储到不同系统中,用于满足不同业务的需求,但这会带来冗余数据的存储成本和多套系统的维护成本。如果支持多计算集群架构,可基于同一份数据拷贝,并使用独立隔离的计算资源分别满足在线和离线业务需求,便能为用户带来可观的成本节省和简单的运维体验。

SelectDB Cloud 是基于 Apache Doris 研发的全托管实时数据仓库服务,采用全新的云原生存算分离架构。当计算层与存储层进行了分离设计后,计算层由于没有了数据状态,可支持极其灵活快速的弹性伸缩;而存储层由于和计算解耦,可以极为方便的供多个计算资源进行共享访问。因此,我们在 SelectDB 中引入多计算集群能力,通过数据仓库架构上的创新来更好地满足用户需求。

初识 SelectDB 多集群

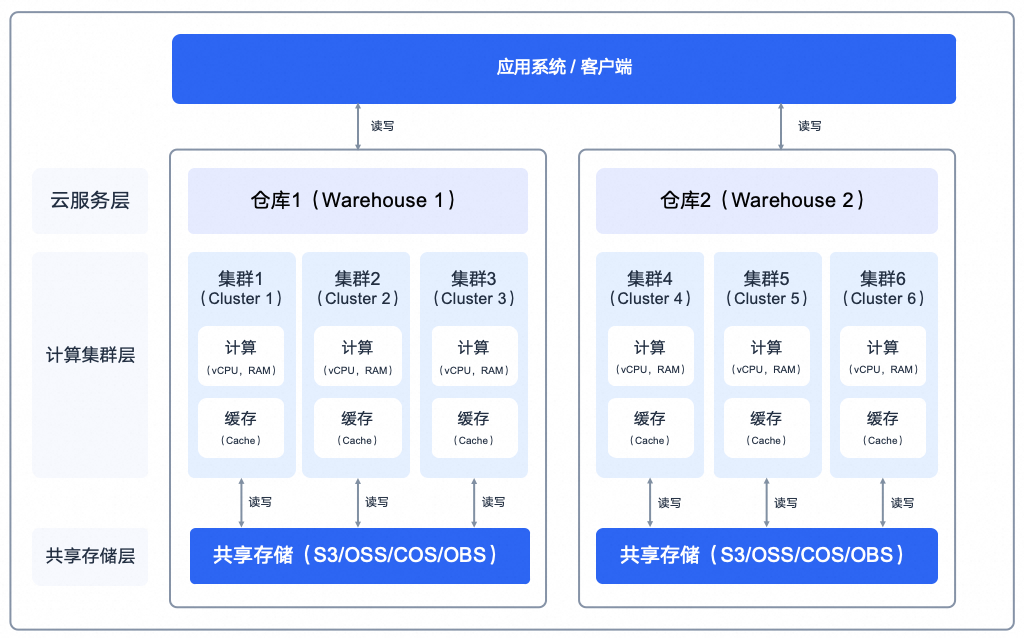
在 SelectDB 的架构设计中,一个仓库实例可包含多个集群,类似分布式系统中的计算队列和计算组。数据持久化在底层的共享存储中,多个集群均可共享访问。每个集群本身即为一套分布式系统,包含一个或多个 BE 节点。由于存算分离架构中远程存储访问速度较慢,我们在计算节点本地引入了缓存,以加速数据访问。

例如下面架构图中,仓库 1 中包含集群 1、集群 2、集群 3,它们均可访问存储在共享存储中的数据。
初识 SelectDB 多集群.png

对于多集群的使用方式,用户连接 SelectDB 仓库实例后,可通过命令切换使用不同的计算集群。一个使用多计算集群进行读写分离的样例如下:

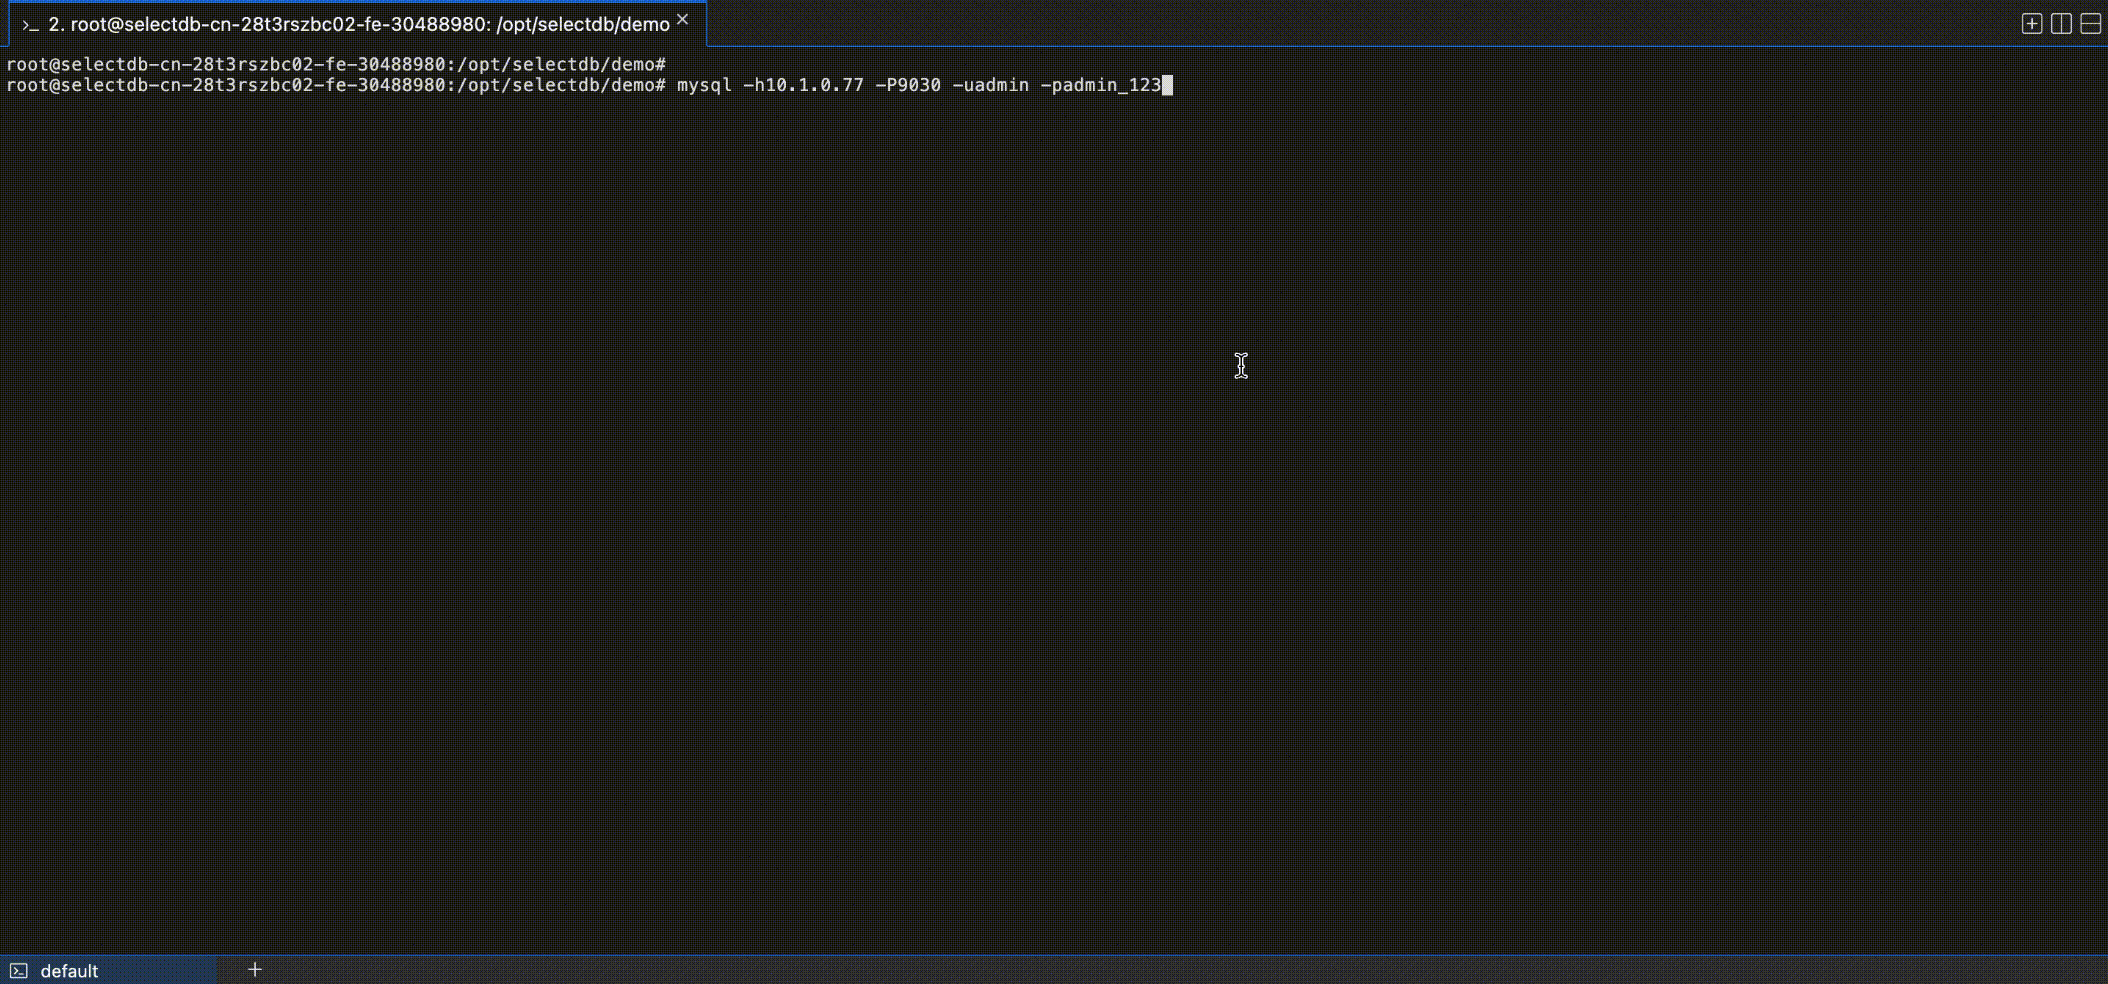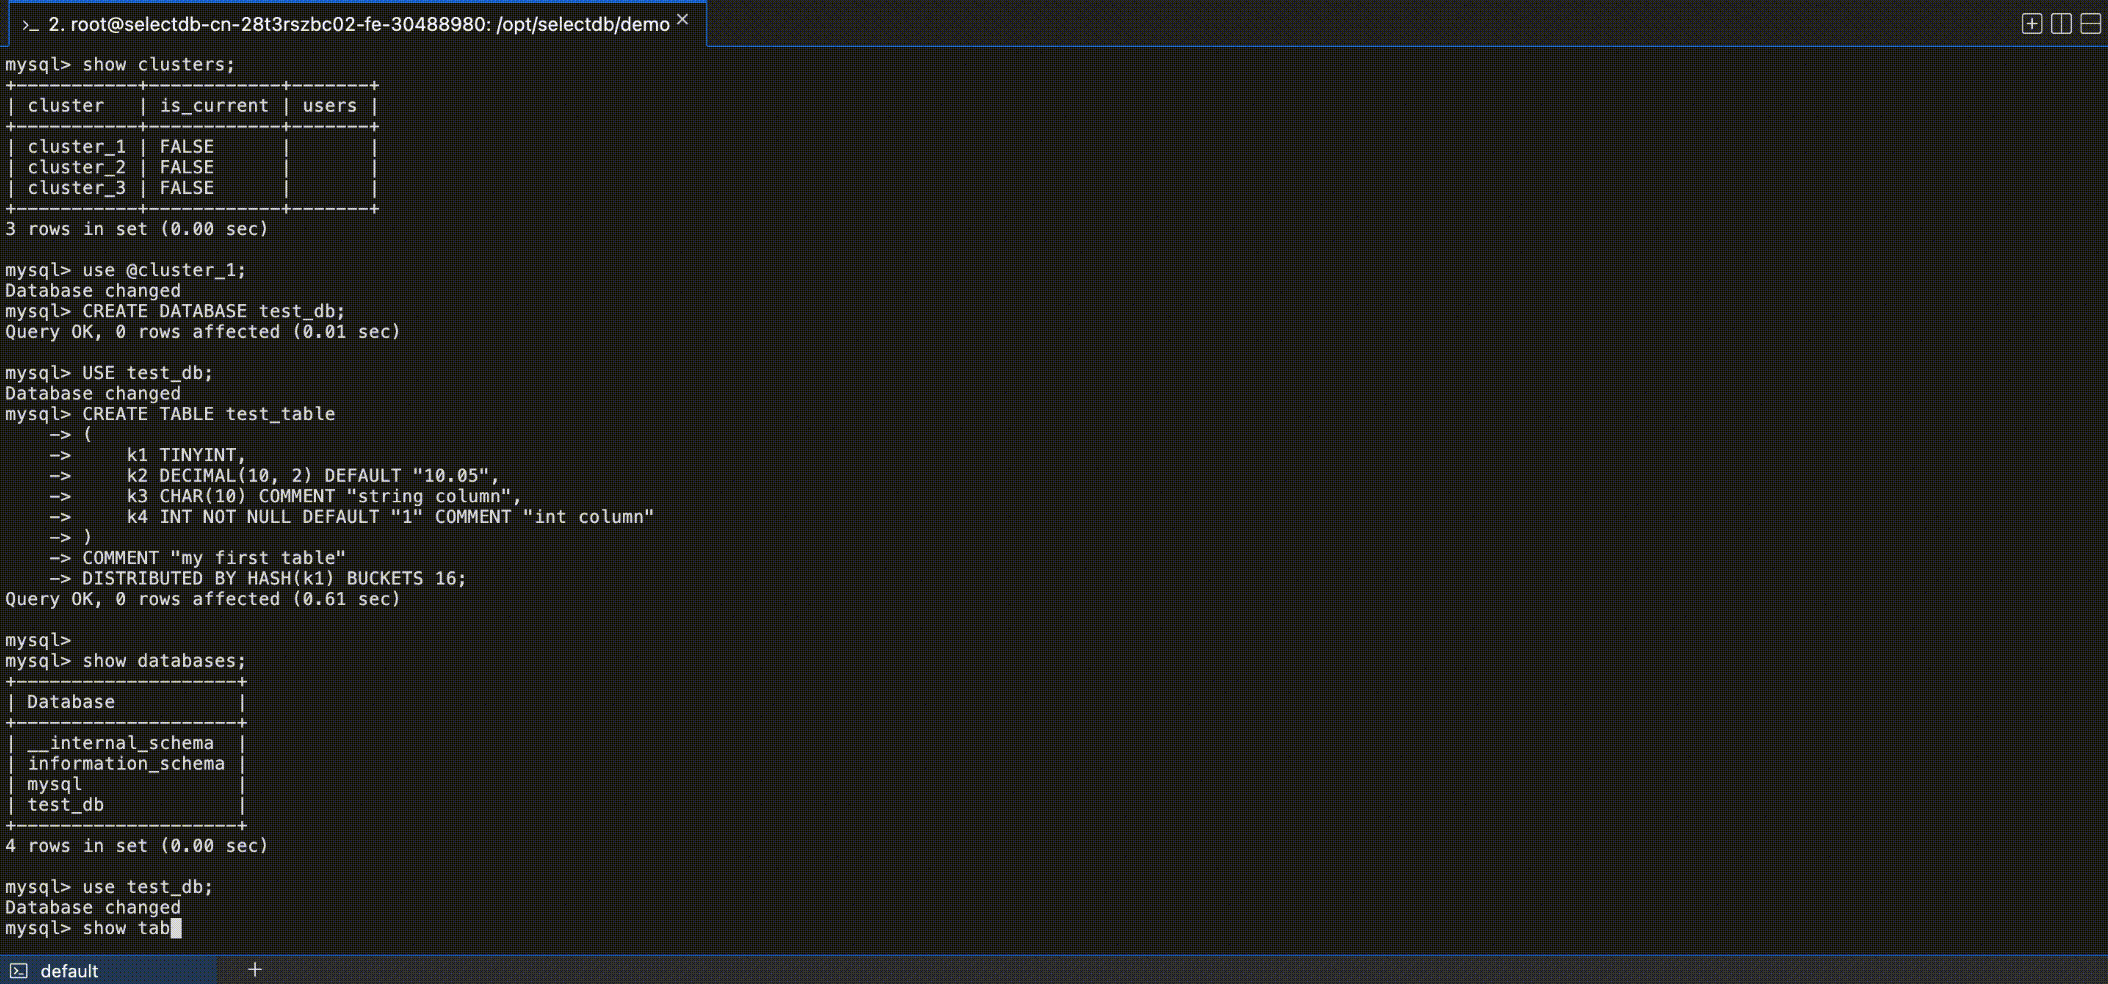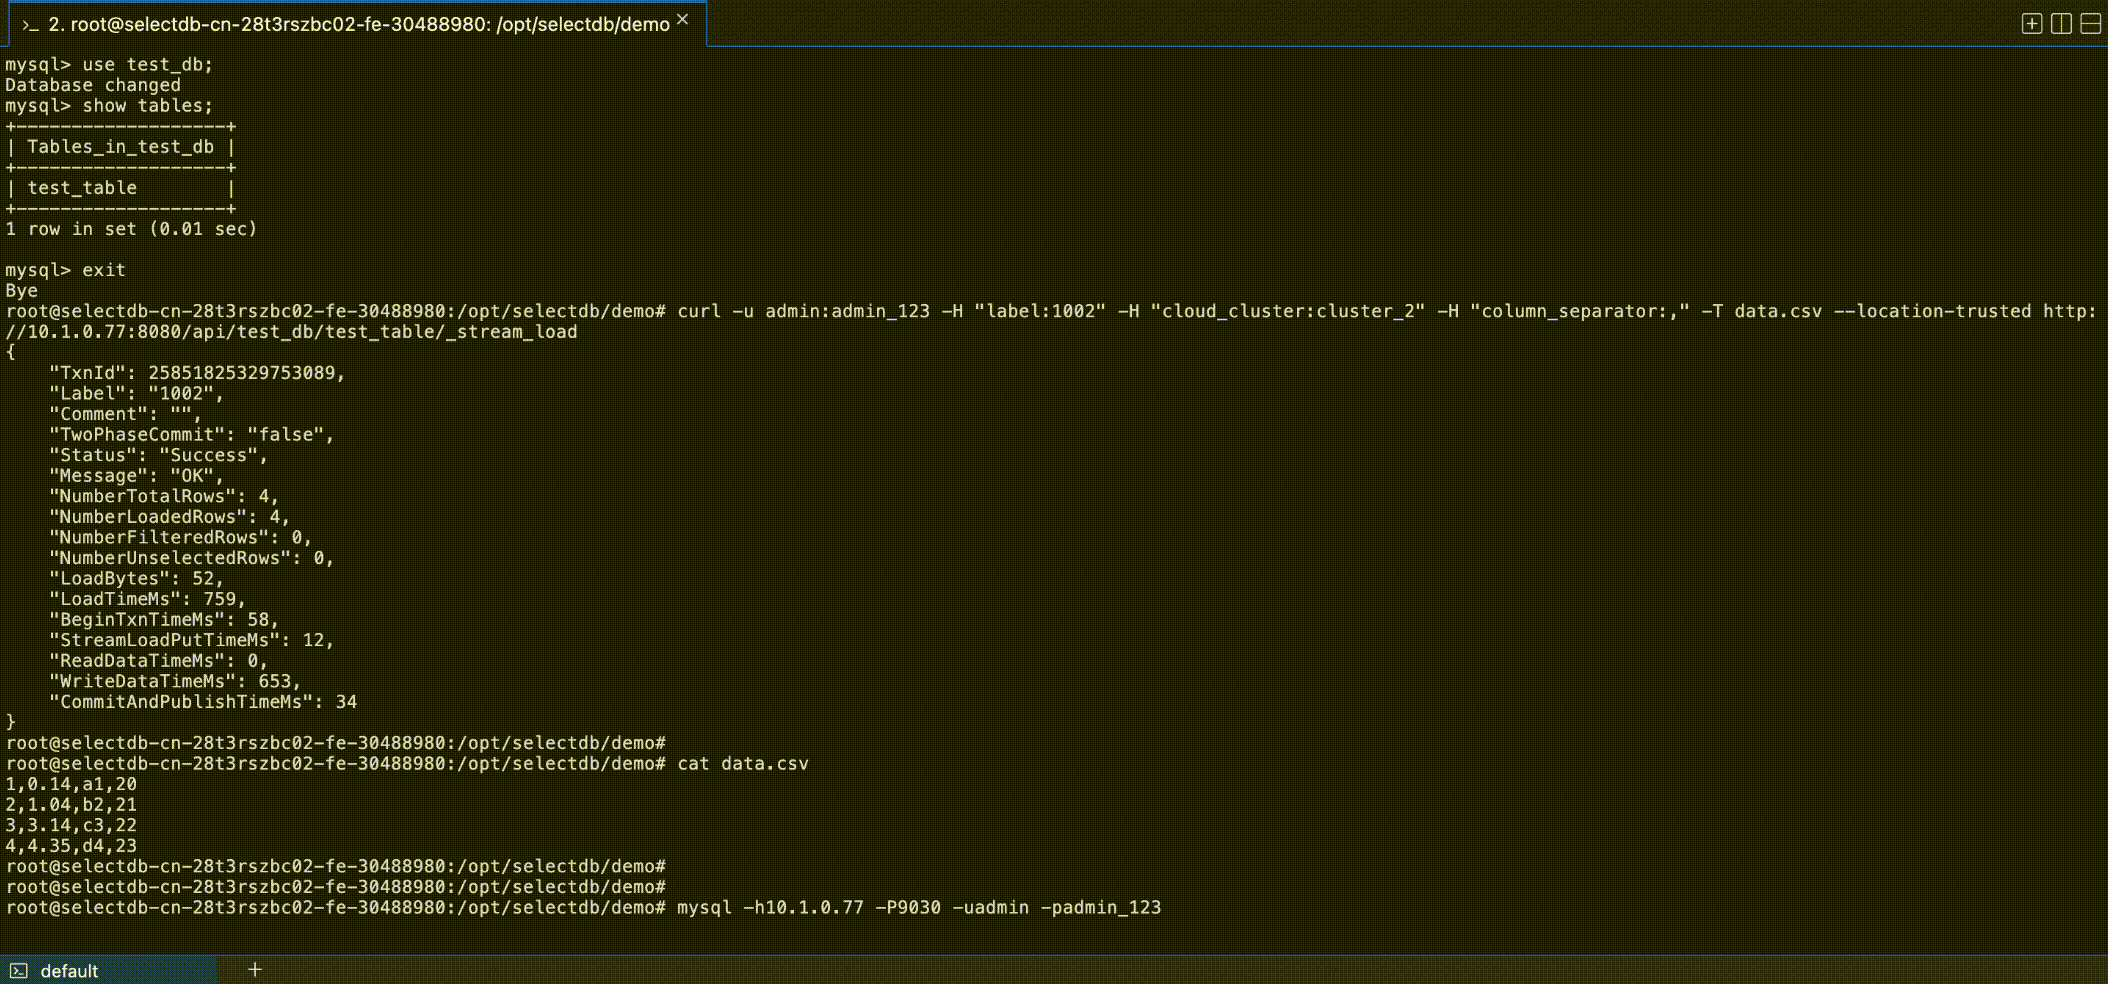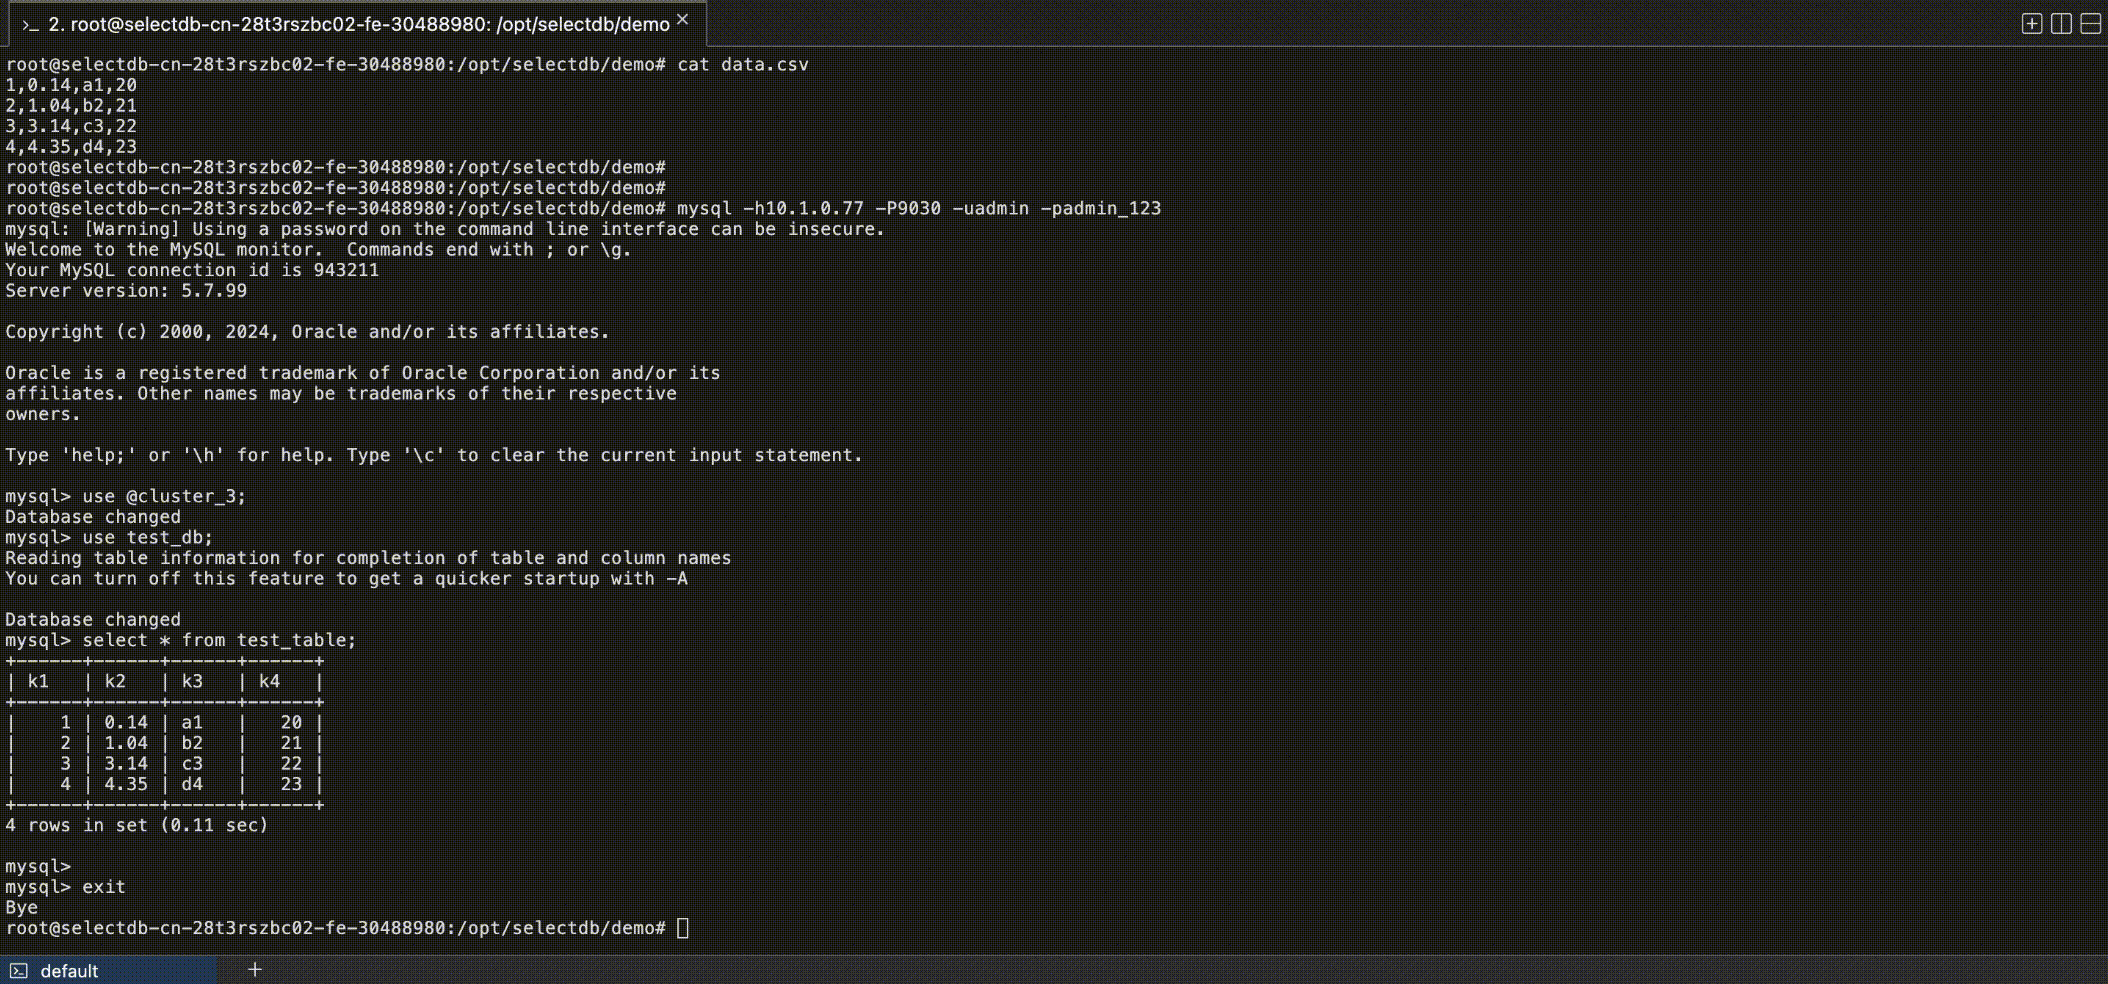
  • 通过 MySQL Client 连接 SelectDB,使用集群 cluster_1 进行数据库、表的建立。

    # 切换使用计算集群 cluster_1
    USE @cluster_1;
    
    # 创建 database、table
    CREATE DATABASE test_db;
    USE test_db;
    CREATE TABLE test_table
    (
        k1 TINYINT,
        k2 DECIMAL(10, 2) DEFAULT "10.05",
        k3 CHAR(10) COMMENT "string column",
        k4 INT NOT NULL DEFAULT "1" COMMENT "int column"
    )
    COMMENT "my first table"
    DISTRIBUTED BY HASH(k1) BUCKETS 16;
    
  • 通过 Stream Load 方式,使用集群 cluster_2 写入样例数据。

    curl --location-trusted -u admin:admin_123 -H "cloud_cluster:cluster_2" -H "label:123" -H "column_separator:," -T data.csv http://host:port/api/test_db/test_table/_stream_load
    

    其中 data.csv 中的样例数据如下:

    1,0.14,a1,20
    2,1.04,b2,21
    3,3.14,c3,22
    4,4.35,d4,23
    
  • 通过 MySQL Client 连接 SelectDB,使用集群 cluster_3 进行数据查询:

    # 切换使用计算集群 cluster_3
    USE @cluster_3;
    
    # 进行查询访问
    SELECT * FROM test_table;
    

    初识 SelectDB 多集群-2.gif

多集群的核心设计

在云原生存算分离架构下,多计算集群的实现从技术方案上看似乎并不存在过多难题。但从产品的角度而言,具备成熟易用的多计算集群能力且能运用于用户实际业务场景中,还有较多核心要点需要深度设计。 下面,我们对其中部分关键点进行介绍。

如何保证强一致的数据共享?

存算分离后,数据存储在共享存储中,可以供多个集群访问。在一个集群写入完成后,另一个集群是否能够立即访问到数据? 如果不能,将会存在一定的数据延迟,对很多实时性要求高的业务场景来说,这种方案难以接受。

为了达到数据的强一致访问,SelectDB 不仅实现了数据的共享化,也进行了深度重构,实现元数据的共享化:当数据通过其中一个集群写入共享存储后,会先更新共享的元数据,再返回数据写入结果。当其他集群进行数据访问时,可通过访问共享的元数据中心获取最新的数据信息,从而做到强一致的数据共享。这意味着通过任一个集群写入 SelectDB 中的数据,一旦写入成功,其他集群立即可见。

如何实现数据的多写多读?

基于共享存储,数据的多读是比较容易实现的,但写入是否只能由其中一个集群进行?如果只能通过其中一个集群写入,那该集群是事先人工确定、出问题时人工变更所有写入作业,还是引入分布式锁在多集群之间进行协调、以决定哪个集群来负责写入?

更麻烦的是,当原写入集群处于假死状态,可能出现多个集群尝试去写入的冲突情况,解决这些问题会导致数据仓库的架构复杂度大幅增加。因此关系型数据库在探索了很多年后,大量系统仍采用一写多读的架构。

SelectDB 结合数仓场景的特点,进行了深度思考设计,可实现数据的多写多读,以简化用户的运维过程、降低系统复杂度。具体而言,数仓场景通过采用小批量、多并发的写入方式,来达到写入的高吞吐,数据延迟达到秒级即可满足大多数用户的需求,可以看到数仓的写入事务并发不高,并无关系型数据库每秒数十万的事务并发需求。因此 SelectDB 可以基于数据的 MVCC 多版本机制,借助共享的元数据中心进行事务协调,数据先提交多个集群进行转化处理,然后在更新元数据阶段(生效数据过程)进行分布式协调,先获取到锁的集群写入成功,其他集群则进行重试。由于数据写入的开销主要在转化处理过程,基于这样的分布式协调机制和乐观锁设计,实现多读多写能力的同时,也可利用多集群进一步提升并发写入吞吐。

如何实现灵活可控的缓存能力?

存算分离架构通常采用对象存储或 HDFS 类系统作为远端共享存储,其单次 IO 请求的访问性能较差,相比本地存储性能下降数十倍。如何保障存算分离架构中计算集群的查询性能?进一步的,当采用多集群支持读写分离、在离线隔离场景时,如何保证多集群的查询性能呢?

SelectDB 通过提供精心设计的缓存管理机制,可自动化保障存算分离架构的查询性能,也可按需满足用户灵活多变的调优需求:

  • 对于单个计算集群,SelectDB 默认会根据 LRU 策略进行数据缓存,当缓存大小足够存储全部热数据时,即可保障存算分离类系统的性能追平存算一体类系统,由于本地缓存的单副本设计、远端存储的低廉价格,存算分离架构的存储成本要大幅低于存储一体架构。SelectDB 同时提供了手动的缓存控制策略,可通过手动策略保证某些表的数据优先存储于缓存中。此外,当集群进行弹性伸缩时,SelectDB 会自动基于统计信息,提前进行缓存的预热或迁移,以保障变更过程中查询服务平稳。

  • 对于多个计算集群,SelectDB 提供了提供了跨集群的缓存同步能力,可同步已有集群的缓存数据到其他集群,从而加速查询性能,并且支持分区粒度的缓存同步控制能力。每个计算集群的缓存是独立的,用户可根据需要按需控制缓存大小。

如何进行权限控制与资源隔离?

一个仓库中的多个计算集群之间,由于计算资源互相独立,因此计算集群间完全隔离。然而,当仓库下有多个计算集群可用时,如何避免用户误用集群,导致业务间的互相干扰?另外,由于存储资源共享,其带宽和 QPS 能力有限,如何保障一个集群对共享存储的访问不干扰其他的集群?

SelectDB 提供完整的权限控制与资源隔离的方案,来保障多计算集群架构有条不紊的运行:

  • 对于计算集群的使用,SelectDB 提供一套简单易用的权限机制,集群支持类似库表的权限分配机制,只有给用户分配了某集群的权限,用户才可以使用该集群,从而避免集群误用情况。

  • 对于存储资源的访问,SelectDB 支持按照集群规格,进行存储带宽和 IOPS 的限流控制,当超过限速后存储访问请求将进行排队,以避免多个集群之间互相干扰。

解锁更多使用场景

多计算集群架构的最初设计目标主要是为了满足读写隔离、在离线业务隔离等场景应用。SelectDB 的多计算集群方案上线后,有近半用户使用过多计算集群,我们意外发现多计算集群的应用潜力正在持续延伸:

  • 弹性临时集群:在实际使用过程中,考虑业务隔离性,用户经常需要一个集群用于临时性业务,例如管理员保留一个隔离的测试集群用于日常访问、新功能正式发布前建立完全仿真的集群进行测试验证、月底或临时性的数据处理任务通过独立的集群进行等。为更好的满足此类需求,SelectDB 也提供了一系列配套能力,如同一个仓库同时支持包月和按量集群的混合计费模式、按量集群支持通过停止闲置计算资源来降低成本等。

  • 跨可用区容灾:当前部署架构中,元数据中心、共享存储已支持跨可用区容灾,用户完全可以通过把多集群放置在不同可用区中,来完成全链路的跨可用区容灾。由于请求的处理过程主要在一个集群内部完成,跨可用区的访问仅在少量元数据获取过程,这种方案对查询性能也基本无影响。当某个可用区出现故障时,可通过一条命令,快速把业务切换到其他可用区。

  • 集群切换式变更:当用户需要对集群进行某些变更操作时,可通过双集群切换方式进行平滑变更。比如对集群缓存资源进行缩容场景,由于目前集群弹性功能不支持缓存缩容,用户可通过新建低缓存容量的集群替换老集群。另外,后续我们可支持双集群切换来进行 SelectDB 大版本的平滑升级,当升级过程中发现问题时可随时安全回滚,保障大版本升级的稳定性,这也是一个极为重要的应用场景。

设计自省

在线上运营过程中,我们也在持续收集用户使用反馈、观察用户使用卡点,其中有两点设计引起了我们的反思,并正在进行设计上的优化重构:

  • 集群命名设计:对于大量云上用户,已经建立实例和集群的专有概念,集群是用户购买在云控制台上购买的最小单元,在 MongoDB、Elasticsearch 等产品中,集群通常等价于实例。而在 SelectDB 的架构设计中,仓库或实例是购买的最小单元,集群是仓库内部的一组计算资源。这里概念设计上的不一致,给不少用户带来了理解上的麻烦。SelectDB 目前正在逐步调整系统架构中的概念,逐步把“计算集群”引导为“计算队列”、“计算组”等更贴切的概念。

  • 默认权限策略:为避免集群误用导致多集群之间互相干扰,SelectDB 提供了多集群的权限控制能力,默认普通用户没有集群使用权限,需分配权限后方可使用。此类设计给新用户快速上手带来了较大门槛,不少用户在刚开始使用时会发现无法查询,也增加了仅仅使用单集群时的使用成本。SelectDB 目前正在思考重新设计集群权限部分,默认情况下用户拥有所有集群的使用权限,而把多集群的权限控制作为高阶功能,交给用户按需开启使用。

NIDS——suricata(一) NIDS——suricata环境安装和规则编写 阅读详情

相关推荐

NVIDIA DGX Spark 深度应用解析:从大模型训练到边缘推理的完整实践指南

内存管理:充分利用统一内存架构,避免不必要的数据传输批处理大小:根据模型大小调整批处理大小以优化内存使用精度选择:在精度损失可接受范围内使用较低精度计算流水线优化:重叠计算和数据传输操作DGX Spark作为一个专门的AI计算平台,在大模型开发的各个阶段都能发挥重要作用。从数据预处理到模型训练,从微调到推理部署,其统一内存架构和强大的计算能力为AI开发者提供了前所未有的本地开发体验。需要注意的是,虽然DGX Spark性能强大,但合理的算法设计和系统优化仍然是获得最佳性能的关键。

time_days的博客 2869

MPP数据库之SelectDB

SelectDB 是一个高性能、云原生的 MPP(大规模并行处理)数据库,旨在为分析型数据处理场景提供快速、弹性和高效的解决方案。它专为处理大规模结构化和半结构化数据设计,常用于企业级业务分析、实时分析和决策支持。 SelectDB 是在 Apache Doris 的基础上发展而来的,继承了其在列式存储、向量化执行引擎和多维分析等方面的技术优势,同时在云原生架构上进行了优化,增强了弹性扩展和资源管理功能。

youziguo的专栏 2108

Linux 桌面虚拟化技术 KVM

Linux 桌面虚拟化技术 KVM

高飞的博客 36万+

从 MySQL 到 SelectDB 的无缝数据迁移(进阶篇)

本文深入探讨了从 MySQL 到 SelectDB 的无缝数据迁移,特别是在大数据分析、实时数据仓库、复杂多维分析和数据存储优化等场景下的需求。详细分析了传统同步方式的弊端,并重点介绍了 NineData 的创新同步方案及其卓越的特点,包括实时同步性能、简单配置操作、可靠的数据一致性、灵活的定制选项和可观测可干预性。同时,还阐述了 NineData 在操作使用方面的便捷性,如一分钟快速配置同步任务、管理同步任务、配置任务告警和修改同步对象等功能。

Aliyn的博客 1366

Tessent --- PDL

当关联的ICL模块是当前ICL顶部模块时,即当它与当前设计匹配时,只能iCall一个iTopProc。但是,可以在iTopProc内调用iCall iProc或iTopProc。为指定后续iProc命令引用的ICL模块,发出这个命令之后,随后定义的iProc都会对应的ICL模块进行定义。为后续iCall调用,当使用iCall命令调用该过程时,参数列表中的变量将被替换为iCall命令中指定的值。在调用iProc时,运行iProc内的命令。PDL是面向工程师的,工程师利用PDL语言,对ICL中的单元进行控制。

qiantianyiqian的博客 2780

线结构光三维重建(二):光平面标定与激光轮廓提取的实战优化

本文深入探讨了线结构光三维重建中的光平面标定与激光轮廓提取两大核心环节的实战优化。详细介绍了从棋盘格标定板法到自动化高鲁棒性标定的流程优化,并分享了针对复杂工业场景(如低对比度、高反光表面)的激光轮廓提取组合策略,旨在提升三维重建系统的整体精度与稳定性。

weixin_29057237的博客 326

玩转 Doris|SelectDB:单机安装指南助你快速起步

作者 | JiekeXu来源 |公众号 JiekeXu DBA之路(ID: JiekeXu_IT)如需转载请联系授权 |(个人微信 ID:JiekeXu_DBA)大家好,我是 JiekeXu,江湖人称“强哥”,青学会MOP技术社区联合创始人,荣获 Oracle ACE Pro 称号,墨天轮 MVP,墨天轮年度“墨力之星”,拥有 Oracle OCP/OCM 认证,MySQL 5.7/8.0 ...

JiekeXu的博客 2422

【脚本篇】---spyglass lint脚本

【代码】【脚本篇】---spyglass lint脚本。

冬瓜 6355

恭喜 SelectDB 三位开发者成为 Apache Doris 新晋 Committer!

初秋虽至,但开源社区的温度仍然热烈!最近,经过 Apache Doris 项目管理委员会的推荐与投票,Apache Doris 社区正式迎来了 7 位新晋 Committer 的加入,值得关注的是,这 7 位新晋 Committer 中有 3 位来自 SelectDB,分别是 李文强 (Github ID:Gabriel39)、张文歆 (GithubID:morrySnow)、文杰(GithubID: jackwener)。

SelectDB 1932

Agisoft Metashape 基于RTK技术的无人机航测免像控技术流程

利用无人机进行航空摄影测量,其使用方便、快速获得成果,已经是测绘行业外业生产的主要方式。RTK定位系统的出现,其厘米级的定位系统,使得航测无人机在作业时,能够准确获取拍照时的GPS位置,能够大量减少像控点,即使不使用像控点也能满足规范对精度的要求。可以有效解决特殊地形(如山川、峡谷、河流、沼泽、水库等)外业人员很难布设像控点的情况。

penglu366366的博客 2188

ABAP CDS 实体权限控制,从 DCL 到 PFCG 的完整运行逻辑

本文探讨了SAP S/4HANA开发中CDS View的权限控制机制。核心观点如下: CDS access control通过DCL语言实现数据实例级权限控制,而非替代传统PFCG权限体系,二者形成互补关系:PFCG控制功能入口权限,DCL控制数据可见性。 DDL定义数据结构,DCL定义访问规则。DCL通过角色映射将数据字段与PFCG授权对象关联,运行时自动将权限条件注入SQL查询,实现数据过滤。 访问控制行为特点: 无DCL role不会默认拒绝访问 权限检查通过减少结果集而非抛出错误实现 需配合@Acc

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 100

阿里云SelectDB:开启实时数仓新时代

阿里云 SelectDB 作为云原生实时数仓领域的佼佼者,凭借其基于 Apache Doris 内核的稳定基础和云原生改造的创新架构,展现出诸多核心优势。其存算分离架构实现了存储与计算资源的独立弹性伸缩,大幅降低成本的同时,还能保障负载隔离。在数据处理上,支持丰富数据源的快速导入与同步,提供灵活且高效的数据更新策略。查询性能更是卓越,无论是宽表分析、高并发点查还是复杂的多表关联查询,都能轻松应对,实现毫秒级到秒级的响应。

阿里云_腾讯云_华为云_优惠政策_技术支持 1254

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

从 Apache Doris 到 SelectDB,从开源数仓走向下一代云原生数仓的演进

数仓或大数据中面临的非结构化、半结构化数据越来越多,而 SelectDB 高效原生地支持了半结构化数据的高效存储和检索分析,在半结构化数据的灵活高效存储方面,支持了Array、JSONB、Map 等复合数据类型,支持灵活快速的 schame 变更,最重要的是支持动态 schema 表,可以自动识别数据的字段和类型、自动扩展新字段、动态扩展表结构。对于常见的各种数据源和数据集成工具,Doris 都提供了开箱即用的对接能力,包括 Flink、Spark、Kafka 等,进一步实现了对海量数据的存储与分析。

hzp666的博客 2120

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

实时数仓工具-SelectDB

Apache Doris 是一款采用 MPP 架构的实时分布式 OLAP 数据仓库,专注于高效的实时数据分析。Doris 项目于 2013 年内部开发,2017 年正式开源,目前在 GitHub 上获得了接近 13,000 星,全球已有超过 5,000 家企业采用,社区活跃度极高,累计贡献者超过 650 人,且曾连续数月在大数据开源项目中排名第一。Doris 广泛应用于金融、互联网、电信、交通、物流、零售、制造和游戏等多个领域。

清平乐的技术专栏 1624

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

阿里selectdb

4. 开放生态:SelectDB 100%兼容 Apache Doris,支持多种数据源(如 CSV、MySQL、SQLServer、Oracle 等)的导入。这使得 SelectDB 在数据引入、更新、分析能力、成本控制和弹性扩容等方面表现出色。1. 实时极速分析:SelectDB 支持大规模实时数据的极速查询分析,能够实现秒级数据导入与同步。总的来说,SelectDB 是一个基于 Apache Doris 的现代化、高性能、云原生实时数仓解决方案,适用于高并发实时报表、交互式分析及日志分析等场景。

leijmdas的专栏 532

SelectDB索引实战:从入门到精通,避开那些年我踩过的坑

SelectDB索引体系分为点查索引(精准定位)和跳数索引(批量过滤)两类。点查索引中,前缀索引适合排序键查询,倒排索引适合高基数字段;跳数索引如ZoneMap和BloomFilter则擅长范围过滤。实战经验表明:索引设计需遵循"按需创建、高频优先、持续优化"原则,避免过度设计(如全字段倒排索引)和误用(如BloomFilter高基数场景)。关键技巧包括:使用覆盖索引减少回表、利用索引下推优化查询、分区与索引配合提升效率。同时需警惕索引失效场景(函数操作、隐式转换等)和维护陷阱(碎片、统

safestar2012的博客 1108

SelectDB数据库,新一代实时数据仓库的全面解析与应用

SelectDB是一款基于Apache Doris的新一代实时数据仓库解决方案,具备实时极速、融合统一、弹性架构和开放生态四大核心特性。它采用云原生存算分离架构,支持秒级数据更新、毫秒级查询响应,在TPC-H等基准测试中性能超越传统系统3-5倍。SelectDB提供两款产品:SelectDB Cloud(全托管SaaS)和SelectDB Enterprise(私有化部署),支持多数据源接入、联邦查询和冷热数据分层存储,存储成本可降低90%。在日志分析、用户画像等场景中,SelectDB相比Elastics

小相探索IT世界 1万+

一文了解多云原生的现代化实时数仓 SelectDB Cloud

随着数字化转型的加速,云计算已成为现代企业运营中的关键组成部分。云的重要性体现在多个方面:首先,它提供更好的灵活性与可扩展性,可根据实际需求动态调整计算和存储资源,以快速适应市场变化并支持业务增长。其次,其采用按需计费的模式,使企业能够有效控制成本,避免高昂的硬件投资和维护费用。 飞轮科技作为 Apache Doris 的商业化公司,基于其内核自主研发了现代多云原生实时数据仓库 SelectDB Cloud,充分利用云原生能力,为客户提供极致性价比、融合统一、简单易用、安全稳定的云上数据分析服务。自推出至

SelectDB 1586

Apache Doris & SelectDB 技术能力全面解析

Doris & SelectDB 以其极速、实时、云原生、湖仓融合、高效多模数据分析的优秀能力,使得其成为实时数据分析、湖仓融合分析、可观测性与日志分析、数仓构建的最佳选择。安踏、长安汽车、顺丰科技、特步、中通快递、趣丸科技、MINISO、MiniMax、观测云、迅雷、新东方、星火保等众多客户基于 Doris & SelectDB 构建了高效的数据分析平台。未来,将持续提升其弹性的能力、批量处理能力、增量流式处理能力、面向大模型 GenAI 的混合检索能力。

SelectDB 1892

实时同步!从MySQL到SelectDB的无缝数据迁移

MySQL 数据同步到 SelectDB,可以通过 NineData 的数据复制控制台,仅需轻点鼠标,即可轻松完成 MySQL 到 SelectDB 的同步任务配置。NineData 数据迁移采用先进的数据同步技术,确保数据实时同步到 SelectDB,极大地降低了数据延迟,让您的决策基于最新数据。

云原生智能数据管理平台 2062

可观测性方案怎么选?SelectDB vs Elasticsearch vs ClickHouse

SelectDB 针对可观测性场景进行倒排索引、全文检索、写入性能、存储空间等多方面优化,助力企业构建高性能、低成本、开放的可观测性平台,相对于 Elasticsearch 和云上日志服务,性能提升的同时成本降低数倍。

SelectDB 1650

万字长文深入剖析SelectDB与MySQL的架构哲学与选型之道

本文深入对比了MySQL和SelectDB的核心差异。MySQL作为OLTP事务型数据库,采用行式存储和B+Tree索引,擅长高并发点查询和复杂事务处理,适合订单、支付等核心业务系统。SelectDB作为OLAP分析型数据库,采用列式存储和MPP架构,擅长海量数据复杂分析查询,适合数据仓库和报表分析场景。两者在存储模型、索引策略、执行引擎等方面存在本质区别:MySQL像精密钟表为事务优化,SelectDB则像工业挖掘机为批量分析设计。技术选型需根据业务场景决策,在实时交易场景选择MySQL,在大数据分析场景

safestar2012的博客 1201

如何将PostgreSQL的数据实时迁移到SelectDB?

其实像异构数据迁移这样的事,只要选对了工具,真的没那么难,属于有手就行。就好像本文的 PostgreSQL 迁移到 SelectDB 的场景,一顿操作下来,任务马上就起来了,数据也立刻就过去了,新的增量数据一眨眼功夫就可以在 SelectDB 端查询到了,回想一下好像自己什么也没干,但却发现数据分析的前置工作都已经完成了。实际的配置过程,远没有你看完这篇文章的时间长,也远没有你想象的复杂。看我说产品如何如何不如直接上手来得直观。

云原生智能数据管理平台 3310

恭喜! SelectDB 五位开发者成为 Apache Doris 新晋 PMC 成员和 Committer!

近期,通过 Apache Doris 项目管理委员会的推荐与投票,Apache Doris 社区正式迎来了 2 位新晋 PMC 成员 和 8 位新晋 Committer 的加入。值得关注的是,2 位新晋 PMC 成员均来自 SelectDB,分别是衣国垒(yiguolei)、杨勇强(dataroaring),8 位新晋 Committer 中有 3 位来自 SelectDB,分别是张晨(zhannngchen)、李驰(starocean999)、周明宏(englefly)。

SelectDB 1990

高高在上的数据库市场,新兵 SelectDB 如何脱颖而出?

数据仓库领域正发生着翻天覆地的变化,不管是市场维度,还是技术维度。市场层面,过去的主流数据仓库榜单被国外的几家所霸占:Redshift、Snowflake、Actian……如今,可以说百花齐放百家争鸣,国产数据库也纷纷踏入了大众的视野。信通院2022年6月发布的数据显示,全球数据库产品供应商有363家,其中中国数据库供应商达116家。如今,越来越多的行业、越来越多的场景都能看到国产数据仓库的身影。...

大数网 606

从 Apache Doris 到 SelectDB Cloud:云原生架构下的弹性能力揭秘

云原生实时数仓 SelectDB Cloud 面向云上基础设施进行深度适配,凭借出色的弹性能力,为企业提供了高效、灵活、经济的实时数据分析解决方案。无论是资源弹性伸缩、高效的缓存配置,还是按需存储、混合计费策略,都致力于帮助企业实现实时数据分析的最佳实践和成本优化。后续 SelectDB Cloud 将实现更加 Serverless 化的能力,达到秒级弹性伸缩,为客户带来更加极致性价比的操作体验,进一步提升平台的灵活性和效率,满足企业不断变化的业务需求。

SelectDB 1620
上一篇: 兼容Trino Connector,扩展Apache Doris数据源接入能力|Lakehouse 使用手册(四)
下一篇: Apache Doris Flink Connector 24.0.0 版本正式发布
SelectDB技术团队
博客等级 码龄4年 2119粉丝 483原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

SelectDB技术团队

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值