【机器学习】降维算法 PCA、LDA、LLE、Laplacian EigenmapsI、SOMAP 、 MDS、SNE、TSNE

《统计学习方法》笔记——PCA(未完待更) 16 主成分分析16.1 总体主成分分析16.1.1 基本想法16.1.2 定义和导出16.1.3 主要性质 16.1 总体主成分分析 16.1.1 基本想法 数据的变量之间可能存在相关性,以致增加了分析的难度。于是,考虑由少数不相关的变量来代替相关的变量,用来表示数据,并且要求能够保留数据中的大部分信息 主成分分析中, 首先对给定数据进行规范化,使得数据每一变量的平均值为0,方差为1 之后,对... 阅读详情

机器学习领域中所谓的降维就是指采用某种映射方法,将原高维空间中的数据点映射到低维度的空间中。降维的本质是学习一个映射函数 f : x->y,其中x是原始数据点的表达,目前最多使用向量表达形式。 y是数据点映射后的低维向量表达,通常y的维度小于x的维度(当然提高维度也是可以的)。f可能是显式的或隐式的、线性的或非线性的。

目前大部分降维算法处理向量表达的数据,也有一些降维算法处理高阶张量表达的数据。之所以使用降维后的数据表示是因为在原始的高维空间中,包含有冗余信息以及噪音信息,在实际应用例如图像识别中造成了误差,降低了准确率;而通过降维,我们希望减少冗余信息所造成的误差,提高识别(或其他应用)的精度。又或者希望通过降维算法来寻找数据内部的本质结构特征。

在很多算法中,降维算法成为了数据预处理的一部分,如PCA。事实上,有一些算法如果没有降维预处理,其实是很难得到很好的效果的。

主成分分析算法(PCA)

Principal Component Analysis(PCA)是最常用的线性降维方法,它的目标是通过某种线性投影,将高维的数据映射到低维的空间中表示,并期望在所投影的维度上数据的方差最大,以此使用较少的数据维度,同时保留住较多的原数据点的特性。

通俗的理解,如果把所有的点都映射到一起,那么几乎所有的信息(如点和点之间的距离关系)都丢失了,而如果映射后方差尽可能的大,那么数据点则会分散开来,以此来保留更多的信息。可以证明,PCA是丢失原始数据信息最少的一种线性降维方式。(实际上就是最接近原始数据,但是PCA并不试图去探索数据内在结构)

设n维向量w为目标子空间的一个坐标轴方向(称为映射向量),最大化数据映射后的方差,有:

其中m是数据实例的个数, xi是数据实例i的向量表达, x拔是所有数据实例的平均向量。定义W为包含所有映射向量为列向量的矩阵,经过线性代数变换,可以得到如下优化目标函数:

其中tr表示矩阵的迹,A是数据协方差矩阵。

容易得到最优的W是由数据协方差矩阵前k个最大的特征值对应的特征向量作为列向量构成的。这些特征向量形成一组正交基并且最好地保留了数据中的信息。

PCA的输出就是Y = W‘X,由X的原始维度降低到了k维。


PCA追求的是在降维之后能够最大化保持数据的内在信息,并通过衡量在投影方向上的数据方差的大小来衡量该方向的重要性。但是这样投影以后对数据的区分作用并不大,反而可能使得数据点揉杂在一起无法区分。这也是PCA存在的最大一个问题,这导致使用PCA在很多情况下的分类效果并不好。具体可以看下图所示,若使用PCA将数据点投影至一维空间上时,PCA会选择2轴,这使得原本很容易区分的两簇点被揉杂在一起变得无法区分;而这时若选择1轴将会得到很好的区分结果。


Discriminant Analysis所追求的目标与PCA不同,不是希望保持数据最多的信息,而是希望数据在降维后能够很容易地被区分开来。后面会介绍LDA的方法,是另一种常见的线性降维方法。另外一些非线性的降维方法利用数据点的局部性质,也可以做到比较好地区分结果,例如LLE,Laplacian Eigenmap等。以后会介绍。

LDA

Linear Discriminant Analysis (也有叫做Fisher Linear Discriminant)是一种有监督的(supervised)线性降维算法。与PCA保持数据信息不同,LDA是为了使得降维后的数据点尽可能地容易被区分!

假设原始数据表示为X,(m*n矩阵,m是维度,n是sample的数量)

既然是线性的,那么就是希望找到映射向量a, 使得 a‘X后的数据点能够保持以下两种性质:

1、同类的数据点尽可能的接近(within class)

2、不同类的数据点尽可能的分开(between class)

所以呢还是上次PCA用的这张图,如果图中两堆点是两类的话,那么我们就希望他们能够投影到轴1去(PCA结果为轴2),这样在一维空间中也是很容易区分的。

接下来是推导,因为这里写公式很不方便,我就引用Deng Cai老师的一个ppt中的一小段图片了:

思路还是非常清楚的,目标函数就是最后一行J(a),μ(一飘)就是映射后的中心用来评估类间距,s(一瓢)就是映射后的点与中心的距离之和用来评估类内距。J(a)正好就是从上述两个性质演化出来的。

因此两类情况下:

加上a’a=1的条件(类似于PCA)

可以拓展成多类:

以上公式推导可以具体参考pattern classification书中的相应章节,讲fisher discirminant的

OK,计算映射向量a就是求最大特征向量,也可以是前几个最大特征向量组成矩阵A=[a1,a2,….ak]之后,就可以对新来的点进行降维了:y = A’X(线性的一个好处就是计算方便!)

可以发现,LDA最后也是转化成为一个求矩阵特征向量的问题,和PCA很像,事实上很多其他的算法也是归结于这一类,一般称之为谱(spectral)方法。

线性降维算法我想最重要的就是PCA和LDA了,后面还会介绍一些非线性的方法。

LLE 局部线性嵌入

Locally linear embedding(LLE)[1] 是一种非线性降维算法,它能够使降维后的数据较好地保持原有流形结构。LLE可以说是流形学习方法最经典的工作之一。很多后续的流形学习、降维方法都与LLE有密切联系。

见图1,使用LLE将三维数据(b)映射到二维(c)之后,映射后的数据仍能保持原有的数据流形(红色的点互相接近,蓝色的也互相接近),说明LLE有效地保持了数据原有的流行结构。

但是LLE在有些情况下也并不适用,如果数据分布在整个封闭的球面上,LLE则不能将它映射到二维空间,且不能保持原有的数据流形。那么我们在处理数据中,首先假设数据不是分布在闭合的球面或者椭球面上。


图1 LLE降维算法使用实例

LLE算法认为每一个数据点都可以由其近邻点的线性加权组合构造得到。算法的主要步骤分为三步:(1)寻找每个样本点的k个近邻点;(2)由每个样本点的近邻点计算出该样本点的局部重建权值矩阵;(3)由该样本点的局部重建权值矩阵和其近邻点计算出该样本点的输出值。具体的算法流程如图2所示:

图 2 LLE算法步骤


Laplacian Eigenmaps 拉普拉斯特征映射

继续写一点经典的降维算法,前面介绍了PCA,LDA,LLE,这里讲一讲Laplacian Eigenmaps。其实不是说每一个算法都比前面的好,而是每一个算法都是从不同角度去看问题,因此解决问题的思路是不一样的。这些降维算法的思想都很简单,却在有些方面很有效。这些方法事实上是后面一些新的算法的思路来源。

Laplacian Eigenmaps[1] 看问题的角度和LLE有些相似,也是用局部的角度去构建数据之间的关系。

它的直观思想是希望相互间有关系的点(在图中相连的点)在降维后的空间中尽可能的靠近。Laplacian Eigenmaps可以反映出数据内在的流形结构。

QQ截图20150329220607

使用时算法具体步骤为:

步骤1:构建图

使用某一种方法来将所有的点构建成一个图,例如使用KNN算法,将每个点最近的K个点连上边。K是一个预先设定的值。

步骤2:确定权重

确定点与点之间的权重大小,例如选用热核函数来确定,如果点i和点j相连,那么它们关系的权重设定为:

QQ截图20150329220648

使用最小的m个非零特征值对应的特征向量作为降维后的结果输出。

前面提到过,Laplacian Eigenmap具有区分数据点的特性,可以从下面的例子看出:

clip_image038

图1 Laplacian Eigenmap实验结果

见图1所示,左边的图表示有两类数据点(数据是图片),中间图表示采用Laplacian Eigenmap降维后每个数据点在二维空间中的位置,右边的图表示采用PCA并取前两个主要方向投影后的结果,可以清楚地看到,在此分类问题上,Laplacian Eigenmap的结果明显优于PCA。
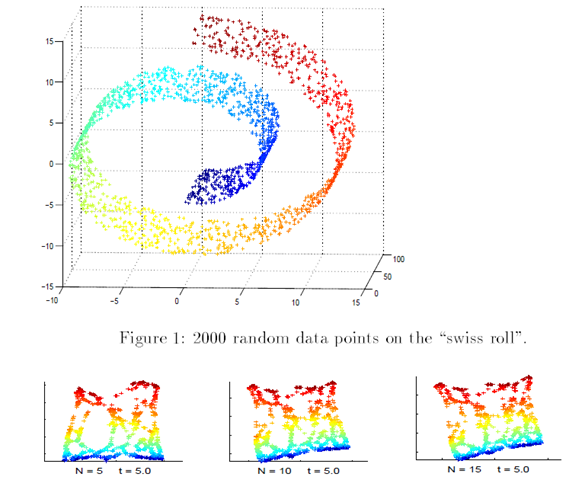
 

image

图2 roll数据的降维

图2说明的是,高维数据(图中3D)也有可能是具有低维的内在属性的(图中roll实际上是2D的),但是这个低维不是原来坐标表示,例如如果要保持局部关系,蓝色和下面黄色是完全不相关的,但是如果只用任何2D或者3D的距离来描述都是不准确的。

下面三个图是Laplacian Eigenmap在不同参数下的展开结果(降维到2D),可以看到,似乎是要把整个带子拉平了。于是蓝色和黄色差的比较远。


ISOMAP是‘流形学习’中的一个经典算法,流形学习贡献了很多降维算法,其中一些与很多机器学习算法也有结合,但上学的时候还看了蛮多的机器学习的书,从来没听说过流形学习的概念,还是在最新的周志华版的《机器学习》里才看到,很有意思,记录分享一下。

流形学习

流形学习应该算是个大课题了,它的基本思想就是在高维空间中发现低维结构。

比如这个图:

此处输入图片的描述 
这些点都处于一个三维空间里,但我们人一看就知道它像一块卷起来的布,图中圈出来的两个点更合理的距离是A中蓝色实线标注的距离,而不是两个点之间的欧式距离(A中蓝色虚线)。

此时如果你要用PCA降维的话,它根本无法发现这样卷曲的结构(因为PCA是典型的线性降维,而图示的结构显然是非线性的),最后的降维结果就会一团乱麻,没法很好的反映点之间的关系。而流形学习在这样的场景就会有很好的效果。

我对流形学习本身也不太熟悉,还是直接说算法吧。

ISOMAP

在降维算法中,一种方式是提供点的坐标进行降维,如PCA;另一种方式是提供点之间的距离矩阵,ISOMAP中用到的MDS(Multidimensional Scaling)就是这样。 
在计算距离的时候,最简单的方式自然是计算坐标之间的欧氏距离,但ISOMAP对此进行了改进,就像上面图示一样:

1.通过kNN(k-Nearest Neighbor)找到点的k个最近邻,将它们连接起来构造一张图。 
2.通过计算同中各点之间的最短路径,作为点之间的距离dijdij放入距离矩阵DD 
3.将DD传给经典的MDS算法,得到降维后的结果。

ISOMAP本身的核心就在构造点之间的距离,初看时不由得为其拍案叫绝,类似的思想在很多降维算法中都能看到,比如能将超高维数据进行降维可视化的t-SNE。 
ISOMAP效果,可以看到选取的最短路径比较好地还原了期望的蓝色实线,用这个数据进行降维会使流形得以保持: 
此处输入图片的描述
ISOMAP算法步骤可谓清晰明了,所以本文主要着重讲它中间用到的MDS算法,也是很有意思的。

经典MDS(Multidimensional Scaling)

如上文所述,MDS接收的输入是一个距离矩阵DD,我们把一些点画在坐标系里: 
此处输入图片的描述 
如果只告诉一个人这些点之间的距离(假设是欧氏距离),他会丢失那些信息呢? 
a.我们对点做平移,点之间的距离是不变的。 
b.我们对点做旋转、翻转,点之间的距离是不变的。

所以思路是:从D->B->X 
此时我们要对X加一些限制,前面说过我们平移所有点是不会对距离矩阵造成影响的,所以我们就把数据的中心点平移到原点,对X做如下限制(去中心化): 


如果选择p=q的话,此时得到的X∗X∗就是原数据去中心化并做了某种正交变换后的值了。

MDS的例子

举个例子:拿美国一些大城市之间的距离作为矩阵传进去,简单写一写代码: 
此处输入图片的描述

import numpy as np
import matplotlib.pyplot as plt

def mds(D,q):
    D = np.asarray(D)
    DSquare = D**2
    totalMean = np.mean(DSquare)
    columnMean = np.mean(DSquare, axis = 0)
    rowMean = np.mean(DSquare, axis = 1)
    B = np.zeros(DSquare.shape)
    for i in range(B.shape[0]):
        for j in range(B.shape[1]):
            B[i][j] = -0.5*(DSquare[i][j] - rowMean[i] - columnMean[j]+totalMean)
    eigVal,eigVec = np.linalg.eig(B)
    X = np.dot(eigVec[:,:q],np.sqrt(np.diag(eigVal[:q])))

    return X


D = [[0,587,1212,701,1936,604,748,2139,2182,543],
[587,0,920,940,1745,1188,713,1858,1737,597],
[1212,920,0,879,831,1726,1631,949,1021,1494],
[701,940,879,0,1374,968,1420,1645,1891,1220],
[1936,1745,831,1374,0,2339,2451,347,959,2300],
[604,1188,1726,968,2339,0,1092,2594,2734,923],
[748,713,1631,1420,2451,1092,0,2571,2408,205],
[2139,1858,949,1645,347,2594,2571,0,678,2442],
[2182,1737,1021,1891,959,2734,2408,678,0,2329],
[543,597,1494,1220,2300,923,205,2442,2329,0]]

label = ['Atlanta','Chicago','Denver','Houston','Los Angeles','Miami','New York','San Francisco','Seattle','Washington, DC']
X = mds(D,2)
plt.plot(X[:,0],X[:,1],'o')
for i in range(X.shape[0]):
    plt.text(X[i,0]+25,X[i,1]-15,label[i])
plt.show()

最后画出来的图中,各个城市的位置和真实世界中的相对位置都差不多: 
此处输入图片的描述
注意,这个例子中其实也有‘流形’在里面,因为我们的地球其实是一个三维,而城市间距离刻画的是在球面上的距离,所以最后如果你去看求出来的特征值,并不像前面说的那样只有q个非0的值。


SNE、TSNE

TSNE是由SNE衍生出的一种算法,SNE最早出现在2002年,它改变了MDS和ISOMAP中基于距离不变的思想,将高维映射到低维的同时,尽量保证相互之间的分布概率不变,SNE将高维和低维中的样本分布都看作高斯分布,而Tsne将低维中的坐标当做T分布,这样做的好处是为了让距离大的簇之间距离拉大,从而解决了拥挤问题。从SNE到TSNE之间,还有一个对称SNE,其对SNE有部分改进作用。

1、SNE

高维数据用X表示,Xi表示第i个样本,低维数据用Y表示,则高维中的分布概率矩阵P定义如下:

P(i,j)表示第i个样本分布在样本j周围的概率。delta是依据最大熵原理来决定,entropy=sum(pi*log(pi)),以每个样本点作为中心的delta都需要使得最后分布的熵较小,通常以log(k)为上限,k为你所决定的邻域点的个数。

低维中的分布概率矩阵计算如下:

这里我们把低维中的分布看作是均衡的,每个delta都是0.5,由此可以基本判断最后降维之后生成的分布也是一个相对均匀的分布。

随机给定一个初始化的Y,进行优化,使得Y的分布矩阵逼近X的分布矩阵。我们给定目的函数,用KL散度来定义两个不同分布之间的差距:

则可以计算梯度为:

每次梯度下降的步长可设定固定或者自适应、随机等,也可以加上一个动量的梯度,初始值一般设为1e-4的随机正态分布。


2、对称SNE

顾名思义,就是让高维和低维中的概率分布矩阵是对称的,能方便运算,但是对拥挤问题无改进。

同样采用KL散度作为两个分布之间的差异标准,只是梯度有一些改变:

3、TSNE

TSNE对高维中的分布采用对称SNE中的做法,低维中的分布则采用更一般的T分布,也是对称的,我们可以发现sum(P)=sum(Q)=1。

TSNE算法流程如下:

自TSNE极大改良了SNE,但它们都有一个非常通用的毛病,耗时耗力。样本较多时,构建网络及其困难,梯度下降太慢,TSNE的程序及可视化见下一篇,TSNE的改良Largevis见下下篇。


reference

  1. 一个MDS的例子,用于数据可视化,例子的数据来源于这里。http://www.benfrederickson.com/multidimensional-scaling/
  2. 周志华《机器学习》
机器学习——降维算法(MDS,PCA,LLE)推导 1.拉格朗日乘数法:对于前面定义中所设的一般目标函数和约束条件组, 应引入辅助函数称此函数为拉格朗日函数, 其中....称为拉格朗乘数。设上述条件极值问题中的函数与在在区域上有连续一阶偏导数.。若的内点是该条件极值问题的极值点, 且则对于m 个常数使得为拉格朗日函数的稳定点即它是如下个方程的解。2.矩阵求导法则:矩阵求导法则:设存在矩阵矩阵及维向量,我们有补充:(1)(2)(3)3.矩阵的2-范数:又名欧几里得范数,即向量元素绝对值的平方和再开方, 阅读详情

相关推荐

Laplacian Eigenmaps原理及推导过程

Laplacian Eigenmaps 原理、推导过程、代码实现及与LLE对比

scott198512的博客 1685

拉普拉斯特征映射(Laplacian-Eigenmaps)

拉普拉斯特征映射(Laplacian Eigenmaps) 是基于图的非线性数据降维算法, 其基本思想是从高维空间向低维空间映射过程中保持数据间原有的局部结构特性(相似性). 举例来说, 若原数据在高维空间中是邻近的, 则对应在低维空间中的表示也是邻近的. 拉普拉斯特征映射主要通过构建具有邻接矩阵(相似矩阵)的图来保证数据的局部结构特征, 本文介绍了具体的算法流程并给出一个简单的Demo.

yixon_oss的博客 2067

特征提取数据降维PCA、LDA、MDS、LLE、TSNE等降维算法的python实现.zip

特征提取数据降维PCA、LDA、MDS、LLE、TSNE等降维算法的python实现

【流行学习】拉普拉斯映射(Laplacian Eigenmaps)

一、前言 拉普拉斯特征映射是一种基于图的降维算法,它希望在原空间中相互间有相似关系的点,在降维后的空间中尽可能的靠近,从而在降维后仍能保持原有的数据结构信息。 二、主要步骤 拉普拉斯特征映射通过构建邻接矩阵为WWW(或叫相似矩阵)的图,来重构数据流形的局部结构特征。 主要思想是,如果两个数据样本 iii 和 jjj 很相似,那么 iii 和 jjj 在降维后子空间中应该与在原空间中一样,尽量接近。 假设数据实例的数目为 nnn,目标子空间的维数(即最终的降维目标的维度)为 mmm。定义 n×mn×mn×m

k的博客 4139

11个经典降维算法(AutoEncoder、ICA、ISOMAP、LDA、LLE、T-SNE等)

python实现

搭建适用于lammps中opls-aa力场的文件流程

现在我已经解决了以上问题,并且通过我的方法可以实现从空白文档到搭建完成以上全部内容,后期只要细心检查即可。需要的data文件最关键是获得相应阴阳离子的mmol文件,因此问题转化为构建一份mmol文件。主要用到的软件及程序:gaussian09,makemol程序(tranal),opls-aa的参数文件。二面角个数:成角原子序号及对应的参数(这里PF6的结构没有二面角,所以为0)参考文献个数:文献名(空够行数即可,这些是给自己的备忘))和自身体系对应的参考文献,修改或填入对应的参数即可。

baguette的博客 2886

非常见降维方法:Laplacian Eigenmaps 拉普拉斯特征映射

拉普拉斯矩阵Laplacian matrix 的定义谈到机器学习中的降维技术,可能大多数了解一点机器学习的朋友都知道PCA,今天为大家介绍一种新的降维方法——拉普拉斯特征映射 拉普拉斯矩阵(Laplacian matrix)),也称为基尔霍夫矩阵, 是表示图的一种矩阵。给定一个有n个顶点的图G=(V,E) ,其拉普拉斯矩阵被定义为:L=D-W 其中D为图的度矩阵,W为图的邻接矩阵。(不知道度

The palest ink is better than the best memory 1万+

3DMax高效建模与人工智能:一场颠覆传统创作的效率革命

AI与3DMax的结合,不仅是工具效率的升级,更是一场创作范式的革命。从“手动雕刻”到“智能共生”,设计师的角色正从执行者转向决策者。正如网友所言:“AI不是替代人类,而是赋予凡人以神笔。”在这场变革中,唯有拥抱技术、深耕创意,方能在数字艺术的浪潮中立于潮头。参考文献与工具推荐技术原理:火星时代资讯《人工智能和三维建模》工具实测:哔哩哔哩《tyDiffusion 3dsMax应用》9、Tripo AI官网教育案例:原创论文《人工智能技术介入三维动画课程建设》

m0_46478534的博客 3009

主成分分析|PCA算法大全

主成分分析|PCA算法大全 文章目录主成分分析|PCA算法大全1. PCA原理1.1 最大方差理论1.2 最小平方误差理论1.3 高维数据下的特征值分解2. CCIPCA增量主元分析算法[1]3. KPCA4. 2DPCA[2]5. 2D2DPCA6. BDPCA参考文献 主元分析提供了一种用低维数据来表示高维复杂数据最主要特征的途径。PCA的思想是将nnn维特征映射到kkk维空间上k&...

昔风不起,唯有努力生存! 5635

ROBOGUIDE教程:FANUC机器人X型焊枪气动点焊焊接

FANUC机器人X型焊枪气动点焊焊接虚拟仿真实现方法。

IndRobSim 4386

STM32G474串口调试避坑指南:从CubeMX配置到中断收发,手把手教你搞定USART1

本文详细解析了STM32G474串口调试中的常见问题,从CubeMX配置到中断收发,提供USART1的避坑指南。涵盖时钟树同步、GPIO模式选择、中断接收逻辑、波特率偏差修正等关键点,帮助开发者高效解决串口通讯难题,提升嵌入式开发效率。

weixin_29191081的博客 210

拉普拉斯特征映射(Laplacian Eigenmaps)

1、介绍拉普拉斯特征映射(Laplacian Eigenmaps)是一种不太常见的降维算法,它看问题的角度和常见的降维算法不太相同,是从局部的角度去构建数据之间的关系。也许这样讲有些抽象,具体来讲,拉普拉斯特征映射是一种基于图的降维算法,它希望相互间有关系的点(在图中相连的点)在降维后的空间中尽可能的靠近,从而在降维后仍能保持原有的数据结构。 本文参考http://blog.youkuaiyun.com/xb

qrlhl的博客 5万+

解决VM 与 Device/Credential Guard 不兼容。在禁用 Device/Credential Guard 后,可以运行 VM 的方法

在启用了Credential Guard或Device Guard的Windows 10主机上启动12.5版之前的VMware Workstation中的虚拟机时,将显示蓝色诊断屏幕(BSOD)。 会看到类似于以下内容的错误: VMware Workstation和Device / Credential Guard不兼容。禁用Device / Credential Guard后,可以运行VMwar...

Hern(宋兆恒) 39万+

图嵌入(拉普拉斯特征映射Laplacian Eigenmaps)

图嵌入(Graph embedding)的意义 Graph广泛存在于真实世界的多种场景中,即节点和边的集合。比如社交网络中人与人之间的联系,生物中蛋白质相互作用以及通信网络中的IP地址之间的通信等等。除此之外,我们最常见的一张图片、一个句子也可以抽象地看做是一个图模型的结构,图结构可以说是无处不在。通过对它们的分析,我们可以深入了解社会结构、语言和不同的交流模式,因此图一直是学界研究的热点。 图分析任务可以大致抽象为以下四类: ( a )节点分类:节点分类旨在基于其他标记的节点和网络拓扑来确定节点的标签(也

lxx333666的博客 6662

Android USB串口通信详解与实例

在Android开发中,USB串口通信是一个常见的需求,尤其是在与硬件设备进行交互时。通过USB串口,我们可以轻松地实现数据的发送与接收。本文将详细介绍如何使用库来实现Android设备与USB串口设备的通信。

m0_62153576的博客 677

Open3D 可视化(1)——简单可视化【2026最新版】

简单可视化,博客长期更新,本文最新更新时间为:2026年5月10日。

点云侠的博客 5685

机器学习系列(13)_PCA对图像数据集的降维_02

文章目录一、降维究竟是怎样实现的二维特征矩阵降维的一般过程PCA降维与特征选择的不同:重要参数n_components迷你案例:高维数据的可视化6、探索降维后的数据最大似然估计自选超参数按信息量占比选超参数1、 一、降维究竟是怎样实现的 【1】降维:减少特征,删除数据,模型受影响 【2】噪音: 【3】PCA使用样本方差 二维特征矩阵降维的一般过程 过程 二维特征矩阵 n维特征矩阵 1 输入原数据,结构为(2,3) 2 3 4 5 PCA降维与特征选择的不

4583

YOLOv11损失函数进阶:融合SmoothL1与FocalLoss,让检测精度再涨10%的实战教程

在YOLOv11的这里的beta参数控制“L1与L2的过渡阈值”,默认设为1.0即可兼容多数场景。同样在# 计算动态alpha(基于类别样本数,需提前统计self.class_counts)# 交叉熵基础# FocalLoss权重else:使用前需统计数据集的(每个类别的样本数),并传入的alpha参数。损失函数是YOLOv11精度的“灵魂”——SmoothL1让边界框回归“稳、准、狠”,改进FocalLoss让类别分类“雨露均沾”。从代码改造到实战落地,本教程已为你搭建了一条精度跃升的路径。

m0_64661770的博客 213

ML-降维:PCA、SVD、LDA、MDS、LLE、LE算法总结

1.PCA主成分分析 PCA是不考虑样本类别输出的无监督降维技术,实现的是高维数据映射到低维的降维。 PCA原理这个介绍的不错:https://www.cnblogs.com/pinard/p/6239403.html 线性代数矩阵性质背景:特征值表示的是矩阵在特征值对应的特征向量方向上的伸缩大小;线性代数的本质这个课有不错介绍:https://www.bilibili.com/video/...

千寻的博客 9338

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

PCA;MDS;TSNE

缺点:如果用户对观测对象有一定的先验知识,掌握了数据的一些特征,却无法通过参数化等方法对处理过程进行干预,可能会得不到预期的效果。SNE构建一个高维对象之间的概率分布,使得相似的对象有更高的概率被选择,而不相似的对象有较低的概率被选择。优点:改变了MDS中基于距离不变的思想,将高维映射到低维的同时,尽量保证相互之间的分布概率不变,,这k维是全新的正交特征也被称为主成分,是在原有n维特征的基础上重新构造出来的k维特征。MDS的基本原理是根据数据集的相似程度,计算各数据点在K维空间中的位置。

XUYH6904的博客 794

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【机器学习】--6.PCA主成分分析(降维)

设有m条n维数据。m*n矩阵。

我是个好人呀,O(∩_∩)O 7617

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【机器学习chp10】降维——(核化)PCA + MDS + lsomap + 拉普拉斯特征映射 + t-NSE + UMAP

数据映射给定原始数据集我们引入非线性映射将数据映射到高维(或无限维)的特征空间。核函数定义核函数为映射后的内积例如,对于径向基函数(RBF)核有数据映射:利用非线性函数将原始数据映射到高维特征空间。构造核矩阵:通过核函数构造。中心化:利用公式​, 对核矩阵进行中心化处理。特征值分解:求解,获得特征向量和特征值。数据投影:利用特征向量,将新数据点通过核函数投影到低维空间,实现降维表示。

m0_56997192的博客 1728

python主题建模可视化LDA和T-SNE交互式可视化

我尝试使用Latent Dirichlet分配LDA来提取一些主题。最近我们被客户要求撰写关于主题建模的研究报告,包括一些图形和统计输出。本教程以自然语言处理流程为特色,从原始数据开始,准备,建模,可视化论文。我们将涉及以下几点使用LDA进行主题建模使用pyLDAvis可视化主题模型使用t-SNE可视化LDA结果文本挖掘:主题模型(LDA)及R语言实现分析游记数据时长12:59。

拓端研究室TRL 961

SNE、TSNE

TSNE是由SNE衍生出的一种算法,SNE最早出现在2002年,它改变了MDS和ISOMAP中基于距离不变的思想,将高维映射到低维的同时,尽量保证相互之间的分布概率不变,SNE将高维和低维中的样本分布都看作高斯分布,而Tsne将低维中的坐标当做T分布,这样做的好处是为了让距离大的簇之间距离拉大,从而解决了拥挤问题。从SNE到TSNE之间,还有一个对称SNE,其对SNE有部分改进作用。 S

zhangweiguo_717的博客 1万+

python主题LDA建模和t-SNE可视化

主题模型是一套算法/统计模型,可以揭示文档集中的隐藏主题。文档通常涉及不同比例的多个主题,特别是在跨学科文档中(例如,60%关于生物学,25%关于统计学,15%关于计算机科学的生物信息学文章)。主题模型在数学框架中检查和发现主题可能是什么以及每个文档的主题可能性。热门话题建模算法包括潜在语义分析(LSA),分层Dirichlet过程(HDP)和潜在Dirichlet分配(LDA),其中LDA在实践中已经显示出很好的结果,因此被广泛采用。这篇文章将使用LDA进行主题建模。

拓端研究室TRL 875

python用tsne降维_PCA、LDA、MDS、LLE、TSNE等降维算法的Python实现

整理 | 夕颜出品 | AI科技大本营(ID:rgznai100)【导读】网上关于各种降维算法的资料参差不齐,但大部分不提供源代码。近日,有人在 GitHub 上整理了一些经典降维算法的 Demo(Python)集合,同时给出了参考资料的链接。PCA资料链接:https://blog.youkuaiyun.com/u013719780/article/details/78352262https://blog....

weixin_30615531的博客 834
上一篇: 【机器学习】线性回归,多元线性回归、自回归及衡量指标
下一篇: java OOP面向对象三大特性五大原则 + 低耦合高内聚
CWS_chen
博客等级 码龄11年 220粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
