模型泛化:偏差、方差、噪声

机器学习 泛化误差和偏差-方差 偏差(bias)衡量了模型的预测值与真实值之间的偏离关系。方差(variance)描述的是训练数据在不同迭代阶段的训练模型中,预测值的变化波动情况。简单来说是预测值之间的离散程度,预测值之间的距离越大,数据越散,方差越大。 阅读详情


在得到模型之后,对模型进行分析~

1. 泛化性能分析

在一个项目中,我们通过设计和训练得到了一个model,该model的泛化可能很好,也可能不尽如人意,其背后的决定因素是什么呢?或者说我们可以从哪些方面去改进从而使下次得到的model更加令人满意呢?

1.1 概论

  • 泛化误差/预测误差
    学习算法的预测误差, 或者说泛化误差(generalization error)可以分解为三个部分: 偏差(bias), 方差(variance) 和噪声(noise). 在估计学习算法性能的过程中, 我们主要关注偏差与方差. 因为噪声属于不可约减的误差 (irreducible error).

  • 偏差:描述模型输出结果的期望与样本真实结果的差距。
    (“偏”——偏离,偏离真实的标签。)

  • 方差:描述模型对于给定值的输出稳定性。
    (在统计学中,方差描述的是这个随机变量的离散程度,也就是该随机变量在其期望值附近的波动程度。)
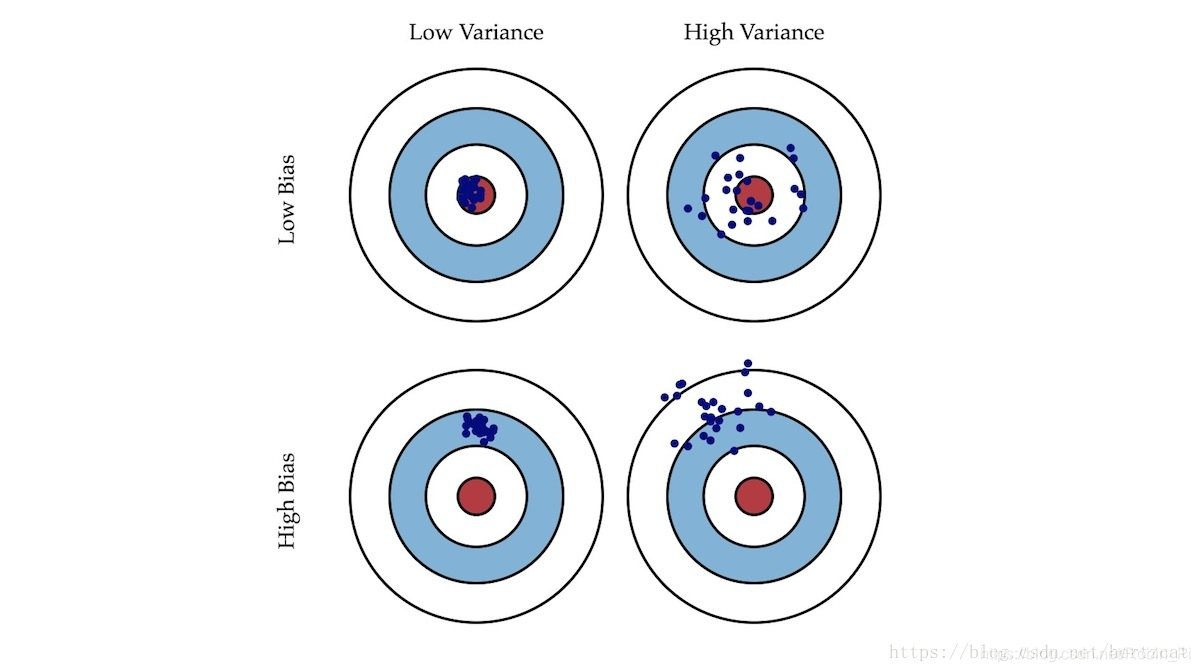
    在这里插入图片描述
    就像打靶一样,偏差描述了我们的射击总体是否偏离了我们的目标,而方差描述了射击准不准。

1.2 解释工具:”偏差-方差分解“

泛化误差 = 偏差 + 方差 + 噪声

算法的预测误差, 或者说泛化误差(generalization error)可以分解为三个部分: 偏差(bias), 方差(variance) 和噪声(noise)。
在估计学习算法性能的过程中, 我们主要关注偏差与方差. 因为噪声属于不可约减的误差 (irreducible error)。

假设:

  • 测试样本:X

  • 训练集:D

  • 标记:yd(
    有可能出现噪声使得 yd != y,即所谓的打标样本不纯)

  • x 的真实标记:y

  • 在训练集 D 上训练得到的模型 :f

  • 模型 f 对 x 的预测输出:f(x;D)

  • 模型 f 对 x 的 期望预测 输出: f ‾ \overline{f} f​(x)

    以回归任务为例,学习算法的期望预测为:
    在这里插入图片描述
    (再次验证,线性回归的本质就是均值预测)


注: f ‾ \overline{f} f​(x) 可以理解为通过世间所有(无限)样本训练得来的期望模型对x的预测输出;f(x;D)t通过数据集 D 产生的期望模型对x的预测输出!


对算法的期望泛化误差进行分解:

在这里插入图片描述
整理得:
在这里插入图片描述

即,泛化误差可分解为:偏差、方差、噪声之和。

泛化误差 = 偏差 + 方差 + 噪声

如何直观理解?

三个对象:① 我们期望通过训练所有样本得到的模型(期望风险模型)的结果输出、②我们期望根据所拥有的样本集D训练得到的(经验风险模型)的结果输出、③模型实际产生输出的结果
注:①、②之所以叫“期望”是因为都跟现实—③有差距!

拿着最理想的期望结果①,与较为实际的期望结果②、以及实际的结果③,分别作比较,得到的两个差值(variance 和 bias)的和,再加上一个不可约减的噪声误差(noise),三者之和即为总共的误差和(模型泛化误差Err(x))。

在这里插入图片描述
注:为什么①是最理想状态?——因为我们的数据总是匮乏的,不可能达到“无限”的状态,所以对应的误差叫做期望风险,根据现实的数据集D建立起来的模型和真实结果的误差,被叫做经验误差。更多,可以参考关键点1。

噪声:错误标记

噪声为真实标记与数据集中的实际标记间的偏差:
在这里插入图片描述
模型在当前任务能达到的期望泛化误差的下届 - 数据决定算法的上界,算法只是在逼近这个上界。

方差: 数据扰动对模型的影响

在一个训练集 D 上模型 f 对测试样本 x 的预测输出为 f(x;D), 那么学习算法 f 对测试样本 x 的 期望预测 为:

在这里插入图片描述
使用样本数相同的不同训练集产生的方差为:
在这里插入图片描述

偏差:考察模型本身拟合能力

预测与真实标记的误差称为偏差(bias), 即:
在这里插入图片描述
它体现了模型的拟合能力,这其实也就是经验风险的计算公式。

小结

在这里插入图片描述

  • 偏差

偏差度量了学习算法的期望预测与真实结果的偏离程序, 即 刻画了学习算法本身的拟合能力 .

  • 方差

方差度量了同样大小的训练集的变动所导致的学习性能的变化, 即 刻画了数据扰动所造成的影响 .

  • 噪声

噪声表达了在当前任务上任何学习算法所能达到的期望泛化误差的下界, 即 刻画了学习问题本身的难度 .

偏差-方差囧境(bias-variance dilemma)

偏差-方差分解说明,泛化性能是由学习算法的能力、数据的充分性以及学习任务本身的难度共同决定的。给定一个学习任务,为了取得好的泛化性能,则需使偏差较小,即能够充分拟合数据,并且使方差较小,即使得数据扰动产生的影响小。

一般来说,偏差与方差是有冲突的,这称为”偏差-方差窘境“,下图中,给定学习任务,假定我们能控制学习算法的训练程度,则在不同训练程度下,偏差-方差的取值曲线如下:

在这里插入图片描述

在训练不足时,学习器的拟合能力不够强,训练数据的扰动不足以使学习器产生显著变化,此时偏差主导了泛化错误率;

随着训练程度的加深,学习器的拟合能力逐渐增强,训练数据发生的扰动渐渐能被学习器学到,方差逐渐主导了泛化错误率;

在训练程度充足后,学习器的拟合能力已非常强,训练数据发生的轻微扰动都会导致学习器发生显著变化,若训练数据自身的、非全局的普遍特性被学习器学到了,则将发生过拟合。

经验误差与泛化能力之间的矛盾

其实说白了,还是因为真实数据无法达到无限的水平造成的过拟合问题:

如果完全依赖手里的数据集 D ,则训练出来的模型则会对训练数据表现得非常好(偏差小),但是对数据集 D 之外的数据集,即新数据,表现得不好(方差大);

若限制模型对数据集 D 的依赖,添加惩罚(正则项),则模型会增加了模型对数据扰动的抵抗能力(模型稳定性),但反过来又限制了模型自身的稳定性(偏差变大)。

2. 分析:泛化误差评估方法

通常,我们通过实验测试来对学习器的泛化误差进行评估并进而做出选择。为此,需要一个和训练集互斥的数据集来测试学习器对新样本的判别能力,然后我们以测试集上的”测试误差(testing error)“作为泛化误差的近似。

有几种方法得到测试集:

  • 留出法(hold-out)
  • 交叉验证法(cross validation)
  • 自助法(bootstrapping)

不管我们采取了什么测试集划分方法,在评估结束后,模型参数选定后,我们需要采用全集D进行训练,将数据集D训练得到的模型交付给业务方,这才是我们最终的模型。

2.1 模型复杂程度的影响

在这里插入图片描述
以多项式回归,

  • 次数
    在这里插入图片描述
  • 正则化参数
    在这里插入图片描述

2.2 训练程度的影响:使用学习曲线分析

无论你是要检查你的学习算法是否正常工作或是要改进算法的表现,学习曲线 都是一个十分直观有效的工具。学习曲线 的横轴是样本数,纵轴为 训练集 和 交叉验证集 的 误差。

  • 合理:Jcv(θ) 因为训练数据增加而拟合得更好不断下降,接近Jtrain(θ) ,且误差 很小
    在这里插入图片描述
  • 高偏差:Jtrain(θ) 与 Jcv(θ) 已经十分接近,但是 误差 很大
    在这里插入图片描述
  • 高方差:Jtrain(θ) 的 误差 较小,Jcv(θ) 比较大
    在这里插入图片描述

3. 解决办法

[高方差] 采集更多的样本数据
[高方差] 减少特征数量,去除非主要的特征
[高偏差] 引入更多的相关特征
[高偏差] 采用多项式特征
[高偏差] 减小正则化参数 λ
[高方差] 增加正则化参数 λ

参考

  1. 机器学习中模型泛化能力和过拟合现象(overfitting)的矛盾、以及其主要缓解方法正则化技术原理初探
  2. 理解机器学习中的偏差与方差
  3. 吴恩达机器学习:方差与偏差
谈谈对泛化误差的理解 个人对泛化误差的看法泛化误差与交叉验证误差这个词我们经常会遇到,在机器学习中,我们最终想要的结果实际上就是减小学习后的估计值和真实值的误差。比如在回归中,我们的 loss function 就表示一个误差。而我们需要做的,就是最小化这个误差,也就是对 object function 的处理。那么什么是泛化误差呢?刚刚说我们最小化了 loss function, 那是不是就一定说明我训练了一些样本后, 阅读详情

相关推荐

方差-偏差-噪声的理解

预测误差, 或者说泛化误差(generalization error)可以分解为三个部分: 偏差(bias) 方差(variance) 噪声(noise) 在估计学习算法性能的过程中, 我们主要关注偏差与方差. 因为噪声属于不可约减的误差 (irreducible error). 首先抛开机器学习的范畴, 从字面上来看待这两个词: 偏差 这里的偏指的是 偏离 , 那么它偏离了什么导...

~星空任我游~ 1万+

经验误差与泛化误差、偏差与方差、欠拟合与过拟合、交叉验证

经验误差与泛化误差、偏差与方差、欠拟合与过拟合、交叉验证 主要内容 经验误差与泛化误差 偏差与方差 欠拟合与过拟合 交叉验证 一、经验误差(训练误差)与泛化误差   经验误差(训练误差):模型在训练集上的误差称为“经验误差”(empirical error)或者“训练误差”“training error”。   泛化误差:模型在新样本集(测试集)上的误差称为“泛化误差”(generalizat

zhihua_oba的博客 1万+

机器学习之经验误差和泛化误差

经验误差是指模型在训练数据集上的平均误差。它衡量的是模型对已知数据的拟合能力。泛化误差是指模型在未知数据或测试数据上的平均误差,反映了模型的推广能力。好的模型应具有较低的泛化误差。

JustinMars的博客 932

训练误差与泛化误差的说明

深度学习中的泛化误差与训练误差说明

使者大牙ℂypher的博客 5215

eICU数据库没有ventilation_event表

各位学友大家好,我是环湖医院神经外科的飞时过,很多外院的老师和我问,ventilation_event表的问题,哪怕用ChatGPT也无法正确生成,今天我给大家用SQL做一个拿来就能用的。

环湖数据科学知识共享平台 936

全桥LLC谐振变换器变频控制工作原理与仿真

全桥LLC谐振变换器以其效率高、全范围软开关、器件电应力小等优点,越来越多地应用于大功率场合。电力电子技术的发展日益追求高频化,所带来的问题是半导体开关器件高频运行时的开关损耗急剧增加。各种软开关电路随之出现。可以有效减小开关损耗,使进一步提高开关频率成为可能。谐振式开关因其可在电流自然过零点开通半导体器件,实现零电压开关,特别适合采用MOSFET作开关的装置。最简单的谐振电路有串联谐振(SRC)和并联谐振(PRC)。SRC只能工作于降压状态,应用受限;

晞子的技术札记 3073

【模型泛化:偏差、方差、噪声】

转载 https://blog.youkuaiyun.com/Robin_Pi/article/details/104539998 模型泛化1. 泛化性能分析1.1 概论1.

图挖掘领域,新晋砖家 ☞ 未来可期,欢迎和静静一起学习交流吖 2568

2026年全国青少年信息素养大赛复赛真题(算法应用主题赛C++小学组:带解析)(7月4日试卷一)【文末附答案和解析】

2026年全国青少年信息素养大赛复赛真题(算法应用主题赛C++小学组:带解析)(7月4日试卷一)【文末附答案和解析】

王老师青少年编程 1737

模型泛化失败的三大根源:偏差、方差与噪声诊断指南

在机器学习实践中,模型泛化能力不足并非偶然,而是由偏差(Bias)、方差(Variance)和噪声(Noise)三类根本性因素共同决定。偏差反映模型假设空间与真实规律的系统性偏离,导致训练误差与验证误差同步偏高;方差体现模型对训练数据扰动的敏感程度,常表现为训练/验证性能显著分化;噪声则源于标注错误、测量失真或世界固有随机性,构成不可约简的误差下限。理解这三者的数学本质、诊断信号与协同关系,是构建鲁棒AI系统的前提——尤其在真实业务场景中,90%以上的线上效果衰减可归因于其中至少一类问题。本文聚焦工程落地视

weixin_29191669的博客 244

使用STM32H7点亮RGB屏幕

希望本文能对你有所帮助!RGB屏幕是一种具有红、绿、蓝三种颜色通道的显示设备,通过控制每个通道的亮度,可以显示出丰富多彩的图像和动画。要使用STM32H7控制RGB屏幕,我们需要连接适当的引脚,并编写适当的代码来控制每个颜色通道的亮度。在主循环中,我们先点亮红色通道,然后延迟一段时间,接着点亮绿色通道,再延迟一段时间,最后点亮蓝色通道,并再次延迟。需要注意的是,示例代码中的延迟循环使用了一个简单的计数器实现,但实际应用中可能需要更精确的延迟方式,例如使用定时器中断或操作系统提供的延迟函数。

QoyOle的博客 923

从泛光成像到可寻址扫描:Flash激光雷达的车规级优势与技术演进

Flash激光雷达凭借固态架构优势成为自动驾驶感知技术的重要发展方向。该方案无机械部件,具备抗振动、长寿命等特点,同时CMOS工艺带来显著成本优势。但传统泛光式存在能量弥散问题,难以兼顾大视场和远距离探测。可寻址扫描技术通过分区点亮VCSEL阵列,有效提升局部能量密度,在保持固态可靠性的同时突破性能瓶颈。这种"电子扫描+分区点亮"的混合架构,使Flash激光雷达有望实现大视场、远距离、高可靠和低成本的多重突破,推动自动驾驶技术发展。

致力于lidar应用开发 233

泛化误差、偏差、方差与噪声:从数学推导到模型诊断实战

机器学习模型在训练集上表现优异却在测试集上原形毕露,这种困境的根源在于泛化误差。泛化误差由偏差、方差与噪声三部分构成:偏差反映模型平均预测与真实规律的偏离,方差体现模型对训练样本波动的敏感度,而噪声是数据固有的不可约随机性。理解偏差-方差权衡是诊断欠拟合与过拟合、选择模型复杂度、应用正则化与集成方法的关键。文章从数学推导出发,结合打靶比喻、多项式拟合实验与工程案例,系统讲解如何通过训练/验证误差对比、学习曲线等方法定位模型问题,并给出噪声数据下的建模策略与一套实战诊断流程。读完你将能清晰回答:模型为什么不准

weixin_33836874的博客 306

下载和运行GitHub上的代码教程总结

从昨天开始就想着从GitHub上下载一个开源的Vue的实战项目,希望能从中学习更多的Vue的实用内容,结果搞了半天好不容易下载了,不知道怎么弄。然而,今天终于成功了,激动地我赶紧来记录一下。 如何从GitHub上下载自己需要的项目: 1.首先,你要有一个自己的GitHub(https://github.com/)的账号。关于如何注册GitHub的账号以及如何获取你的SSH密钥这个问题,请大家参...

不怕万人阻挡,只怕自己投降 29万+

深度解析偏差方差与噪声:从泛化误差分解到模型调优

机器学习模型效果不佳时,如何定位问题根源?泛化误差是衡量模型真实能力的核心指标,其可分解为偏差、方差与噪声三个部分。偏差反映模型拟合能力不足,方差体现对数据波动的敏感度,噪声则是数据本身的不可约误差。理解这三者对模型调优至关重要:高偏差需增强模型复杂度,高方差则依赖正则化与更多数据,而噪声只能通过数据清洗部分缓解。学习曲线与交叉验证是诊断误差来源的实用工具,配合偏差-方差分解的数学推导,能帮助开发者精准制定调优策略,避免盲目调参。本文以实际案例和代码演示,系统梳理从误差分解到模型诊断的完整路径,助力机器学习

weixin_34275734的博客 304

华为OD机试真题2025双机位C卷 Java&Go 实现【卡牌游戏】

小明正在尝试一种新的牌游戏。游戏规则只如下:首先,小明拿到一张写有数字m的牌。 然后,他会拿到另外n张牌,上面分别写有不同的数字,牌排成一排。小明的目标是从这排牌中找到一串连续的牌,这些牌上数字的总和可以被 m整除。你的任务是判断小明是否可以完成这个目标。

MISAYAONE的博客 392

工业4.0必备:C#上位机+数字孪生 生产线实时监控与智能预警系统(工业级实战)

数据割裂:PLC、传感器、工业相机的数据散落在不同系统,想看全局生产状态要切换N个软件,“数据孤岛”导致决策滞后;故障难预判:设备突发故障时,只能停机排查,平均故障响应时间超30分钟,一条生产线停工1小时损失超10万;可视化差:传统监控只有冰冷的数字和2D图表,设备运行状态、生产流程、物料流转无法直观感知,新人上手需3个月才能熟悉产线。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 659

偏差-方差-噪声三要素:模型泛化能力的工程诊断框架

泛化误差是机器学习落地的核心瓶颈,其本质由偏差、方差和噪声三部分构成。偏差反映模型对真实规律的系统性偏离,方差体现模型对训练数据扰动的敏感程度,噪声则代表任务固有的不可预测性。三者共同决定模型在未知数据上的稳定性和上限。理解这一三角结构,是开展有效正则化、数据增强、架构选型与不确定性建模的前提。尤其在图像分类、时序预测和NLP微调等实际场景中,仅看验证集准确率极易误判问题根源——高偏差需提升表达能力,高方差需增强鲁棒性,而噪声主导时则应转向置信度管理与业务兜底。本文聚焦工程可操作的诊断逻辑与治理路径。

weixin_34194829的博客 317

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

机器学习模型误差深度解读:从三类来源到偏差-方差权衡

本文从第一性原理出发,系统剖析了机器学习模型误差的三大来源:数据固有噪声(不可消除)、模型结构偏差(系统性误差)和数据不足导致的方差(过拟合根源)。通过数学公式和直观图示,阐释了偏差-方差权衡这一核心矛盾,即模型复杂度对误差的双重影响。最后提供了诊断流程和优化策略对照表,指导实践者通过调整模型复杂度、数据量和正则化等方法,在偏差和方差之间找到最佳平衡点,从而提升模型泛化能力。理解这些误差本质是成为优秀机器学习实践者的关键第一步。

Dfreedom.的博客 1597

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

模型的偏差、方

上图是《统计学习方法》中关于误差的相关整理。

Forlogenの解忧杂货铺 2064

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

进化的学习曲线:方差与泛化误差

在未知数据上的准确率的指标,叫做泛化误差。

学习记录,厚积薄发 707

52-机器学习与大模型开发数学教程-4-14 偏差-方差分解

本文系统阐述了机器学习中的偏差-方差分解原理。通过飞镖靶类比,直观解释了偏差(模型预测偏离真实规律的程度)和方差(预测结果对训练数据的敏感性)的概念。文章给出了泛化误差的数学分解公式,分析了导致高偏差或高方差的原因,并通过kNN和多项式回归等实例说明模型复杂度的影响。此外,提供了降低偏差和方差的具体方法,包括模型选择、正则化、数据增强和集成学习等策略。最后,文章指出了常见误区,并强调在实际应用中应区分问题类型(偏差主导或方差主导)以采取针对性措施。

yuanmomoya的博客 1717

机器学习中的方差、偏差和噪声

  机器学习算法一般都会有训练和测试的过程,而且算法在不同训练集(训练集来自同一个分布)上学得的模型,测试的结果也很可能不同。   一般来说,算法的方差衡量了训练集的变动导致的模型性能的变化,即多次训练的模型之间的性能差异性。偏差则是度量算法的期望输出与真实标记的区别,表达了学习算法对数据的拟合能力。而噪声则表示数据的真实标记与数据在数据集上标记的区别,表明算法在当前任务上能达到的测试误差的下界...

keep forward, go, go, go 2598

泛化误差分解:理解偏差、方差与噪声的调参实战指南

机器学习模型的真正考验在于对未知数据的预测能力,即泛化能力。理解泛化误差的构成是诊断模型问题的关键。泛化误差可分解为偏差、方差与噪声三部分:偏差反映模型系统性的偏离,方差刻画模型对数据波动的敏感程度,噪声则是数据本身的天花板。偏差与方差的此消彼长构成权衡,过拟合与欠拟合本质上就是方差或偏差主导的表现。通过交叉验证、学习曲线等工具,可以定位模型当前处于哪类误差主导状态,并针对性地选择增加数据、调整正则化或提升模型复杂度。掌握泛化误差分解,能将盲目的调参过程转化为精准的工程诊断,从而有效提升模型的鲁棒性与实用性

weixin_34354945的博客 668

手算偏差-方差分解:定位模型泛化失败的根因

偏差-方差分解是理解机器学习模型泛化误差的核心框架,其本质是将总误差解耦为偏差(模型系统性偏离)、方差(预测不稳定性)与不可约噪声三部分。该原理源于统计学习理论,但工程价值在于提供可归因、可干预的诊断坐标系——而非抽象推导。通过在固定测试点上对多组独立训练数据重复建模,可量化各误差成分的空间分布,从而区分‘学不会’(高偏差)与‘学太细’(高方差)两类典型失效。这一技术直接支撑模型选型、正则化策略、特征工程及数据质量治理等关键决策,在金融风控、推荐系统和IoT故障预测等工业场景中已成为模型可观测性的基础设施。

weixin_31887307的博客 315

机器学习中偏差方差残差的表示

关于机器学习中常见的方差,偏差,和残差,以前一直没搞懂,画个图,解释一下,错别字忍一下。 所谓的泛化误差就是方差、偏差、和噪声的和,与均方误差不同。均方误差类似对残差平方的期望。 ...

李路吉的博客 2165

2.5偏差与方差

-偏差: 描述模型输出结果的期望与样本真实结果的差距。 -方差: 描述模型对于给定值的输出稳定性。 -噪声:真实标记与数据集中的实际标记间的偏差 泛化误差=偏差+方差+噪声 参考文献: 1.https://blog.youkuaiyun.com/hertzcat/article/details/80035330 ...

ytt1202的博客 263
上一篇: 机器学习模型/算法—— 阶段性总结(2):关键概念/技术
下一篇: 数学知识——线性代数速查手册
Robin_Pi
博客等级 码龄9年 2万+粉丝 632原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值