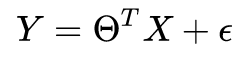机器学习模型/算法—— 阶段性总结(2):关键概念/技术

线性回归概念 神经网络基础 阅读详情

1. 正则项/惩罚项、过拟合

机器学习的终极目标:期望风险最小

损失函数:期望风险在实际中的定义

风险这个词比较模糊,在实际风险定义中会依赖一个所谓的损失函数

期望风险:分类器真实风险最好的表达

期望风险是全局的,可以看做是真实风险的合理表示。它基于所有样本损失的最小化,期望风险是全局最优,是理想化的不可求的, 从式子可以看出期望风险依赖于数据的联合分布p(x,y)以及损失函数L的定义(依赖于数据y和f(x))

样本无限:
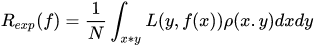
在这里插入图片描述

经验风险:期望风险在样本有限情况下的退化

经验风险是局部的,基于训练样本的损失函数最小化,经验风险的优化问题是现实的可求的, 从式子可以看出经验风险仅依赖于数据(x,y)及损失函数L的定义(依赖于数据y和f(x))。

样本有限:
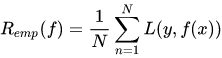
在这里插入图片描述

结构风险:期望风险和经验风险的一种平衡

当样本空间很小时,单纯考虑经验风险最小化学习的效果就未必很好,会产生“过拟合(over-fitting)”现象。
主要是因为在样本集个数n小于break point时, 即总能找到一个假设使得分类器将所有训练样本正确分类。换句话说,分类器复杂度高(性能太好),导致了过拟合。那么既然分类器复杂程度高会导致学习性能下降, 我们就可以把度量分类器复杂程度的一个量(惩罚),加到经验风险损失上。

在经验风险上加上表示模型复杂度的正则项(regularizer)或者罚项(penalty term) 就构成了所谓结构风险。在假设空间F、损失函数以及训练数据集确定的情况下,结构风险的定义为:
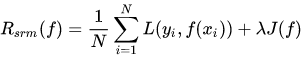
在这里插入图片描述
其中,J(f)表示模型的复杂度,λ表示其权重。将分类器复杂度与经验风险一起考虑的优化问题,被定义为结构风险最小化。

如何解决机器中模型泛化能力和过拟合现象的矛盾可以参考 机器学习算法/模型——模型泛化:偏差、方差、噪声

2. 偏置、假设

2.1 偏置的现实来源?

假设函数的偏置 = 误差项 = 噪声 = 偶然性 = 波动

我们最终需要的模型要用来表征实际的情况。但模型不可能百分百正确地反映真实情况,总有误差,因此我们可以给这个模型加上个误差项 ϵ \epsilon ϵ(或者说噪音)。例如,
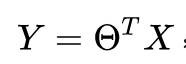
在这里插入图片描述
重新写成:
在这里插入图片描述
注意:区分偏置和正则项。


“归纳偏置” 百度百科:

机器学习试图去建造一个可以学习的算法,用来预测某个目标的结果。要达到此目的,要给于学习算法一些训练样本,样本说明输入与输出之间的预期关系。然后假设学习器在预测中逼近正确的结果,其中包括在训练中未出现的样本。既然未知状况可以是任意的结果,若没有其它额外的假设,这任务就无法解决。 这种关于目标函数的必要假设就称为归纳偏置(Mitchell, 1980; desJardins and Gordon, 1995)。

一个典型的归纳偏置例子是奥卡姆剃刀,它假设 最简单而又一致的假设是最佳的。 这里的一致是指学习器的假设会对所有样本产生正确的结果。

以下是机器学习中常见的归纳偏置列表:

  • 最大条件独立性(conditional independence):如果假说能转成贝叶斯模型架构,则试着使用最大化条件独立性。这是用于朴素贝叶斯分类器(Naive Bayes classifier)的偏置。
  • 最小交叉验证误差:当试图在假说中做选择时,挑选那个具有最低交叉验证误差的假说,虽然交叉验证看起来可能无关偏置,但天下没有免费的午餐理论显示交叉验证已是偏置的。
  • 最大边界:当要在两个类别间画一道分界线时,试图去最大化边界的宽度。这是用于支持向量机的偏置,它假设不同的类别是由宽界线来区分。
  • 最小描述长度(Minimum description length):当构成一个假设时,试图去最小化其假设的描述长度。假设越简单,越可能为真的。见奥卡姆剃刀。
  • 最少特征数(Minimum features):除非有充分的证据显示一个特征是有效用的,否则它应当被删除。这是特征选择(feature selection)算法背后所使用的假设。
  • 最近邻居:假设在特征空间(feature space)中一小区域内大部分的样本是同属一类。给一个未知类别的样本,猜测它与它最紧接的大部分邻居是同属一类。这是用于最近邻居法的偏置。这个假设是相近的样本应倾向同属于一类别。

奥卡姆剃刀

“切勿浪费较多东西,去做‘用较少的东西,同样可以做好的事情’‘
我们将对现象的最简单解释称为好的规律。
如无必要勿增实体。
“我们需要承认,自然事物各种现象的真实而有效的原因,除了它自身以外再无须其他,所以,对于同样的自然现象,我们必须尽可能地归于同一原因。”
“如果可能,用已知实体组成的结构,来替换未知实体的推断。”
预测基于一串已知符号的下一个符号会是什么。它唯一的假设就是环境遵从某种未知的但是可计算的概率分布。这个理论是奥卡姆剃刀的数学公理化。

2.2 模型中偏置的意义

没有偏置项 = 分类器模型(决策面)只能经过原点 = 模型无法很好的上下“移动”获得更好的分割效果

3. 线性模型

线性模型本质上是均值预测

线性模型试图学得一个通过属性(特征)的线性组合来进行预测的函数。
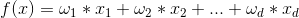
在这里插入图片描述
线性模型本质上是均值预测。

线性模型中 f(x) 可以是各种“尺度”上的函数,例如:
f(x)为离散的值:线性多分类模型
f(x)为实数域上实值函数:线性回归模型
f(x)为对数:对数线性模式
f(x)进行sigmoid非线性变换:对数几率回归
…

实际上 ,f(x)可以施加任何形式的变换,需要理解的是,不同的变换之间没有本质的区别,也没有好坏优劣之分,不同的变换带来不同的性质,而不同的性质可以用于不同的场景。

线性模型参数求解的本质 - 线性方程组求解

线性模型蕴含了“原子可叠加性”和“可解释性“的思想

  1. 原子可叠加性:许多功能更为强大的非线性模型(nonlinear model)可在线性模型的基础上通过引入层级结构或高维映射而得到;
  2. 可解释性(comprehensibility):权重向量 w 直观表达了各个属性在预测中的重要性(主要矛盾和次要矛盾),而误差偏置 b 则表达了从物理世界到数据表达中存在的不确定性,即数据不能完整映射物理世界中的所有隐状态,一定存在某些噪声无法通过数据表征出来;

补:回归分析

相关变量的关系有两种,一种是相关关系,一种是依存关系。

一个变量变化受另一个变量的影响——依存关系,回归分析是研究呈依存关系的相关变量之间的关系

变量之间的关系可分为两类:

  1. 存在完全确定的关系——称为函数
  2. 关系不存在完全确定的关系——虽然变量间有着十分密切的关系,但是不能由一个或多各变量值精确地求出另一个变量的值,称为相关关系,存在相关关系的变量称为相关变量

相关变量的关系也可分为两种:

  1. 两个及以上变量间相互影响——平行关系
  2. 一个变量变化受另一个变量的影响——依存关系

它们对应的分析方法:
相关分析是研究呈平行关系的相关变量之间的关系
回归分析是研究呈依存关系的相关变量之间的关系


线性回归 - 基于线性模型的一种回归预测模型

线性回归(linear regression)试图学得一个线性模型,以尽可能准确地预测实值输出标记。

对数几率回归 - 基于线性回归的一种概率函数

线性判别分析( LDA) - 基于线性模型的线性投影判别算法

线性判别分析(linear discriminant analysis LDA)是一种经典的线性学习方法,在二分类问题上最早由Fisher提出,因此亦称为“Fisher判别分析”(Fisher linear discriminant analysis)。

LDA的思想非常朴素:

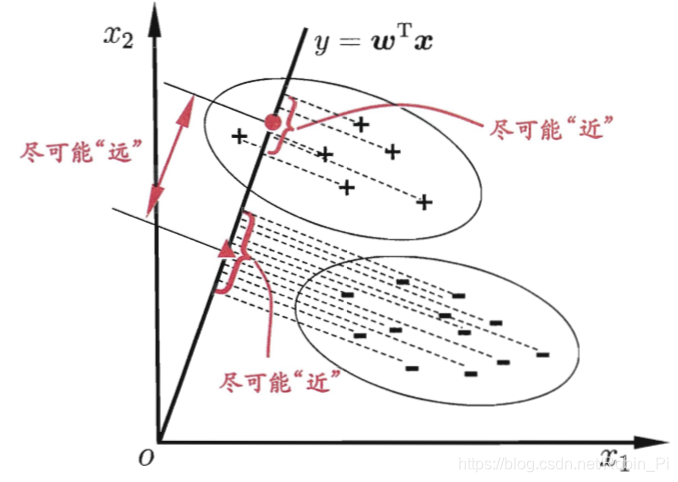
  1. 给定训练样例集,设法将样例投影到一条直线上,使得同类样例的投影点尽可能接近、异类样例的投影点尽可能远离;
  2. 在对新样本进行分类时,将其投影到同样的这条直线上,再根据投影点的位置来确定新样本的类别;

下图给出了一个二维示意图:
在这里插入图片描述- LDA 和 PCA
在machine learning领域,PCA和LDA都可以看成是数据降维的一种方式。但是PCA是unsupervised,而LDA是supervised。

所以PCA和LDA虽然都用到数据降维的思想,但是监督方式不一样,目的也不一样。

PCA是为了去除原始数据集中冗余的维度,让投影子空间的各个维度的方差尽可能大,也就是熵尽可能大;LDA是通过数据降维找到那些具有discriminative的维度,使得原始数据在这些维度上的投影,不同类别尽可能区分开来,而同类别之间尽量相近。

显然,这2种算法内核都借助方差矩阵实现最优化算法,从而实现数据降维压缩的目的。

4. 数据

类别不平衡问题(class-imbalance)

5.距离

机器学习中相似性的度量/距离方法

“距离”真是个好东西。距离于聚类算法的重要性不言而喻,但是仔细想想,机器学习最重要的任务——分类,其本质任务不就是通过距离度量对数据进行划分类别?——距离越近则越相似,越有可能是同类。
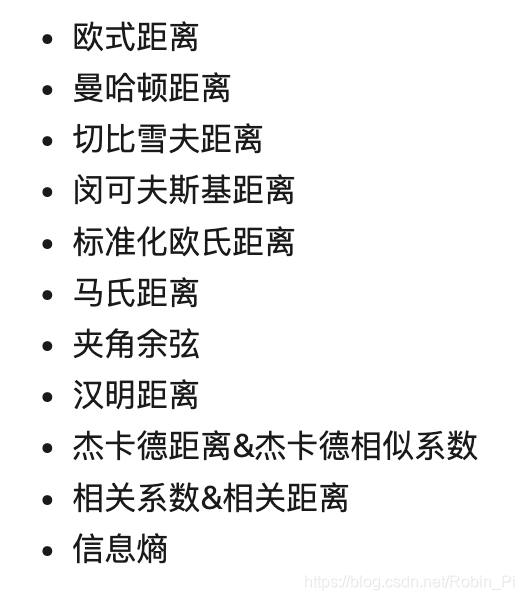
机器学习中的相似性度量

在这里插入图片描述
损失函数其实就是单个之间差异/距离的度量啊!

损失函数、经验风险、期望风险、结构风险?

目标函数 = 结构风险函数 = 经验风险函数 + 正则项

  • 经验风险和期望风险

    经验风险是局部的,基于训练集所有样本点损失函数最小化的。

    期望风险是全局的,是基于所有样本点的损失函数最小化的。

    经验风险函数是现实的,可求的;

    期望风险函数是理想化的,不可求的;

  • 结构风险
    只考虑经验风险的话,会出现过拟合的现象,这个时候就引出了结构风险。
    结构风险是对经验风险和期望风险的折中。在经验风险函数后面加一个正则化项(惩罚项)便是结构风险了。

6. 判别模型和生成模型

由生成模型与判别模型引发出的思考

参考

  1. 统计学习理论

  2. 归纳偏置

  3. 线性回归

  4. 线性模型

  5. 什么是“线性”?

  6. 线性回归:描述变量间预测关系最简单的回归模型

  7. 简单相关性分析(两个连续型变量)

  8. 机器学习–>期望风险、经验风险与结构风险之间的关系

  9. 浅谈「正定矩阵」和「半正定矩阵」

机器学习高效入门:7步实战路线与避坑指南 机器学习作为人工智能的核心技术,通过算法让计算机从数据中学习规律。其核心原理涉及特征工程、模型训练和评估优化三大环节,在金融风控、医疗诊断等领域具有广泛应用价值。对于初学者而言,掌握Python编程和基础数学概念后,可通过scikit-learn工具链快速实现MNIST手写识别等经典项目。本文基于实战经验提炼出高效学习路径,重点涵盖监督学习算法、Jupyter Notebook环境配置等关键技术要点,并针对Kaggle竞赛和模型部署等实际场景提供工具推荐。特别强调要避免过早研究Transformer架构等常 阅读详情

相关推荐

【机器学习】浅谈 归纳偏置 (Inductive Bias)

是自然科学中常用的两大方法之一 (归纳与演绎,Induction & Deduction),指从一些例子中寻找共性、泛化,形成一个较通用的规则的过程。显然,加了一定正则的偏置的实线 A 比虚线 B 更为简单而通用 (模型复杂度受到惩罚而更低,恰当拟合数据点,泛化性能更好)。对于上图中的 6 个离散实心点,可由很多不同的曲线拟合之。在机器学习中,很多学习算法经常会对学习的问题做一些关于目标函数的必要假设,称为。归纳偏置的意义或作用是使得学习器具有了泛化的能力。则是指对模型的偏好,以下展示了。

u013250861的博客 675

深度学习笔记

初学深度学习的笔记

LiQiang1024_的博客 492

认知发展的阶段性路径模型

认知发展、阶段性模型、人工智能、机器学习、深度学习、神经网络、知识图谱、推理、决策 1. 背景介绍 认知发展是人工智能领域的核心议题之一。从早期基于规则的专家系统到如今的深度学习模型,人工智能的发展历程始终伴随着对认知能力的探索和模拟。然而,人类的认知能力是极其复杂的,它涉及感知、记

AI架构师小马 703

开发者必看:超全机器学习术语词汇表!

A 准确率(accuracy) 分类模型预测准确的比例。在多类别分类中,准确率定义如下: 在二分类中,准确率定义为: 激活函数(Activation function) 一种函数(例如 ReLU 或 Sigmoid),将前一层所有神经元激活值的加权和输入到一个非线性函数中,然后向下一层传递该函数的输出值(典型的非线性)。 AdaGrad 一种复杂的梯度下降

Lunaqi的博客 2552

逆向选择启示录:一个失败高频策略如何意外跑赢市场

本文探讨了高频交易中的逆向选择现象,揭示了一个失败的高频策略如何通过简化意外跑赢市场。通过加密货币市场的实证分析和蒙特卡洛模拟,研究发现低预测性的简单策略反而更具鲁棒性,有效规避了逆向选择风险。文章还提供了小币种做市策略的优化框架和实践建议,为量化交易者提供了宝贵洞见。

weixin_29191669的博客 401

Microchip Studio 7.0 从下载到项目调试:AVR开发者的完整入门指南(附常见问题解决)

本文为AVR开发者提供了Microchip Studio 7.0从下载安装到项目调试的完整入门指南。详细介绍了如何获取安装包、创建第一个AVR工程项目,并配置编译与调试环境。同时,文章重点解决了开发过程中常见的编译错误和仿真问题,帮助开发者快速上手并高效使用这一官方集成开发环境。

joy55的博客 333

《机器学习》周志华第三章课后习题

3.1 试析在什么情形下式(3.2) 中不必考虑偏置项 b.

huzimu_的博客 7749

基于PLC的全自动洗衣机控制系统+控制程序

本设计使用PLC控制系统替换了传统的继电器控制系统,实现了全自动洗衣机在硬件方面的提升,丰富了全自动洗衣机在软件方面的功能,提高了全自动洗衣机的洗衣效率,基本可以满足用户的洗衣需求。

zzzz114231的博客 8955

机器学习算法/模型——总章

目录1. 机器学习介绍2. 机器学习模型介绍线性回归 1. 机器学习介绍 机器学习介绍 2. 机器学习模型介绍 线性回归

Robin_Pi的博客 791

双参数威布尔分布(Weibull分布)参数计算(根据故障数据,求双参数威布尔分布的参数详细步骤)

根据故障数据求威布尔分布参数步骤 根据众多文献研究,设备故障数据大多服从指数分布、威布尔分布或对数正态分布。其中威布尔分布较为常用,本文主要介绍威布尔分布的简单应用,并根据某设备故障数据为例简单介绍威布尔分布参数的计算方法。 参考文献11参考文献22 1.双参数威布尔分布的概率密度函数、概率分布函数、可靠度函数: 2.预处理故障数据 将故障数据按时间排序,假设设备分别在以下时间点失效:11.1 、23.5、58.4……则将此时间从小到大排序。并计算中位秩。中位秩的计算公式如下: 其中i表示第几个数据,n

biaochengxiaobai的博客 4万+

ios开发拒绝“玄学”Crash:从循环引用到脏内存,构建你的系统性排查思维模型

你申请了内存,写了数据,这块内存就是脏的。系统无法直接回收它,除非你显式释放,或者系统把它 swap 出去(但在 iOS 上,Compressed Memory 机制虽然能压缩,但不会像桌面系统那样频繁 swap 到磁盘,一旦压缩内存也撑不住,你也得挂)。所以,排查 OOM 的核心心法只有一条:不要问“哪里漏了”,要问“每一刻,留在这个页面上的内存,凭什么必须在这里?一旦内存水位线逼近阈值(不同机型不同,老机器可能 600MB 就危,新机器能抗 1.5GB),系统发个警告。

大模型大数据攻城狮的专栏 724

机器学习算法/模型——阶段性总结(4)更高层次

关于模型套路 损失函数的本质是物理世界和数学公式之间的桥梁,选择何种损失函数取决于我们如何看待我们的问题场景,以及我们希望得到什么样的解释。 偶然性-波动-偏置 我们最终需要的模型要用来表征实际的情况。但模型不可能百分百正确地反映真实情况,总有误差,因此我们可以给这个模型加上个误差项 ϵ\epsilonϵ(或者说噪音)。例如, 重新写成: 注意:偏置不是正则项! 关于模型函数 为什么需要假设?因...

Robin_Pi的博客 435

华为OD 面试手撕代码真题【岛屿的周长】

0代表水,1代表陆地,岛由陆地组成且岛内不允许有湖,让你求岛的周长。

MISAYAONE的博客 8417

机器学习阶段性总结[机器学习]

分类阶段性测试 机器学习三要素是? A B C A.模型 B.策略 C.算法 D.样本 感知器算法的损失函数是误分类点的总数。 错 sklearn 提供的感知器类是 Perceptron,该类实例化的时候一个重要的参数是 eta0请 问该参数表示什么?学习率 下述指标常用来评价分类模型的有哪些? A B C D A.准确率(accuracy) ==B.精确率(precision) == C.召回率(recall) D.F1-值(F1-score) E.均方误差 段落说明 现有 10 个

weixin_44972997的博客 1244

SAP UI5 和 Fiori 的一些小技巧合集 - 持续更新中

本文介绍笔者从事 SAP UI5 和 Fiori 开发多年以来,积累的一些经验和小技巧。会保持更新。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 911

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

机器学习概论——阶段性总结1

提到机器学习,你会想到哪些关键词?你可能会想到算法、模型、分类、回归、有监督、无监督、深度学习、神经网络、自然语言处理、图像识别、迁移学习、模糊学习...... 其实对待问题,不用一开始就深入到该问题的某一个part中去,站在外围,站在高处,才能对这个问题有一个宏观性的、基础性的把握。而且在后续深入研究过程中,要始终以宏观性、全局性思维来思考问题,把握住最本质的东西,才能起到提纲挈领的作用。 其实最开始看书,我对概览性章节的内容不是很重视,反而重视的是后续...

weixin_42418170的博客 1455

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

【Azure 架构师学习笔记 】- Azure AI(9)-阶段性小结

本文属于。本文属于。接上文。

MVP黄钊吉(發糞塗牆) 719

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

机器学习阶段性总结:对深度学习本质的回顾 20250813

深度学习是数据时代的强大工具,但其本质决定了它无法替代人类的逻辑推理与创造性思维。理解它的原理、尊重它的局限、善用它的优势,才能在技术实践中真正发挥其价值。未来,随着理论研究的深入,或许 “炼丹” 将逐渐被更精准的工程方法取代,但在此之前,保持对技术的敬畏与好奇,仍是每个从业者的必修课。(注:文档核心观念和经验都是我的,但 AI 帮我做了润色和整理,不得不服AI有时写得又快又好。

极客BIM工作室 1673

2023年人工智能和机器学习的六大趋势

人工智能和机器学习的六大趋势和建议

weixin_39915649的博客 208

数据科学赛道夺冠关键:Python+Pandas+机器学习模型调优实战

掌握数据科学赛道夺冠关键,从Python+Pandas到机器学习模型调优全覆盖。本篇作为「编程挑战赛备战指南:各赛道技术栈与获奖技巧解析」核心章节,详解特征工程、交叉验证与模型融合等实战技巧,提升算法效率与得分稳定性,助力竞赛脱颖而出,值得收藏。

GatherLume的博客 1019

数据科学学习里程碑:如何设定阶段性成就达成指南 [特殊字符]

想要自学数据科学却不知从何开始?gh_mirrors/da/data-science项目为你提供了完整的免费学习路径!这个开源项目汇集了世界顶尖大学的优质课程,帮助你系统性地掌握数据科学核心技能。 ## 📊 为什么需要学习里程碑? 数据科学是一个庞大的领域,包含编程、数学、统计学、机器学习等多个方面。如果没有明确的阶段性目标,很容易在漫长的学习过程中迷失方向或半途而废。设定合理的学习里程碑能

gitblog_00364的博客 624

终极机器学习课程笔记完整指南:从零基础到实战精通

机器学习课程笔记是每个AI学习者必备的学习资源,能够帮助你系统化地掌握从基础概念到前沿技术的完整知识体系。这个开源项目汇集了全球顶尖大学的机器学习课程笔记,包括斯坦福、MIT、CMU等知名院校的深度学习、自然语言处理、计算机视觉等核心课程内容。无论你是机器学习初学者还是希望深入研究的开发者,这些精心整理的笔记都能为你提供宝贵的学习参考和实践指导。 ## 📚 为什么需要机器学习课程笔记? **

gitblog_00384的博客 781

解密AI黑盒:5大实用技巧让机器学习模型完全透明化

在人工智能深度渗透金融风控、医疗诊断和自动驾驶等关键决策领域的今天,模型的黑盒特性已成为制约AI规模化应用的最大障碍。可解释AI技术通过模型透明化,为机器学习可解释性提供了系统性的解决方案,让复杂算法从"知其然"到"知其所以然",真正建立人机信任的技术桥梁。 ## 模型透明度诊断方法:识别黑盒风险的关键路径 面对日益复杂的深度学习模型,技术团队首先需要建立系统性的透明度评估框架。传统的准确率指

gitblog_01181的博客 1068

深度学习阶段性回顾

深度学习的关键组成部分是神经网络,而神经网络具有深层次的网络结构,是一种依靠大量数据样本,通过正向传播、逆向传播算法对数据进行训练与学习,进而提取复杂数据特征与模式,从而完成指定任务的计算模型。正如小孩子通过体察世界、阅读书籍等方式认知世界,机器的学习也需要借助学习原料,这些原料就是大量的样本数据。

m0_72579201的博客 923
上一篇: 机器学习算法/模型——阶段总结(3)——面试篇
下一篇: 模型泛化:偏差、方差、噪声
Robin_Pi
博客等级 码龄9年 2万+粉丝 632原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值