机器学习算法/模型——有监督到无监督(聚类):由 KNN 到 K-menas

KNN 聚类算法介绍 KNN 聚类算法是一种简单而有效的无监督学习算法,它可以用于处理各种类型的数据。它的优点包括简单易懂、易于实现、不需要预先假设数据的分布等,但它也存在一些缺点,例如对数据点的距离计算量大、K值的选取对聚类结果有很大影响等。 阅读详情
AI摘要

本文深入探讨了KNN和K-means两种经典算法,KNN用于有监督学习,通过计算距离找到最近邻居进行分类或回归;K-means则为无监督学习,通过迭代寻找最优簇中心完成聚类。文章详细解析了算法原理、步骤及应用场景。


有监督学习和无监督学习,是机器学习两个大的类别。

聚类算法属于无监督学习:训练数据只有输入变量 x 而没有输出变量 y 。

无监督学习的目的是将这些训练数据潜在的结构或者分布找出来,以便于我们对这些数据有更多的了解。

1. KNN(K-Nearest Neighbor)

1.1 基本思想

  • 训练数据包括样本的特征向量(x)和标签(y);
  • k 是一个常数,由用户来定义;
  • 一个没有标签的样本进入算法后,首先找到与它距离最近的 k 个样本,然后用它这 k 个最近邻居的标签来确定它的标签。

在这里插入图片描述

1.2 算法步骤

  • 算距离
    给定未知对象,计算它与训练集中的每个样本的距离——特征变量是连续的情况下,将欧氏距离作为距离度量;若特征是离散的,也可以用重叠度量或者其他指标作为距离,这要结合具体情况分析。
  • 找近邻
    找到与未知对象距离最近的 k 个训练样本。
  • 做分类/回归
    在这 k 个近邻中出现次数最多的类别作为未知对象的预测类别(多数表决法),或者是取 k 个近邻的目标值平均数,作为未知对象的预测结果。

注:超参数 —— k 的取值大小,直接影响着KNN 算法的结果。
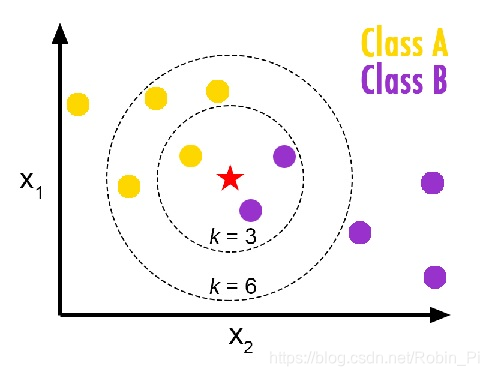
在这里插入图片描述
当取 k=3 时,根据多数选举法,预测结果为 B;但当 k=6 时,依然是根据多数选举法,预测结果就成为了 A。

k 是 KNN 算法唯一的超参数,因此,它对于 KNN 尤其重要。这一点和 KMeans 的 k 参数之于 KMeans,颇为神似。

2. 聚类(Clustering)

聚类技术,一句话概括:聚类就是通过对样本静态特征的分析,把相似的对象分到同一个子集,属于一种无监督式学习算法。

所以这在本质上回到了不同样本之间的相似性度量(Similarity Measurement)。这时通常采用的方法就是计算样本间的 “距离”(distance)。

可参考之前的文章:距离度量和范数
或者 机器学习中的相似性度量

3. K-means

3.1 本质和概要

本质

核心:把样本分配到离它最近的类中心所属的类,类中心由属于这个类的所有样本确定
本质:K代表的是K类,means代表的是中心。K-means的本质就是确定K类的中心点,当找到了这些中心点也就完成了聚类。

K-means 是通过迭代的方式寻找K个簇(Cluster)的一种划分方案,使得聚类结果对应的代价函数最小。

前提

K-Means算法实施需要满足两个前提:

  • 根据分布的先验概率,求得K

  • 种子点的选取要cunning,尽量地远一点

算法思路

  • 设置 K 个种子点;
  • 遍历每个点,将其归属为与之距离最近的种子点,这就是它所属的簇;
  • 遍历结束后,重新计算 K 个种子点的位置(簇中心点);
  • 重复 Steps 2 and 3,直到 K个种子点的位置不再改变。

3.2 损失/目标函数

代价函数可以定义为各个样本距离所属簇中心点的误差平方和:
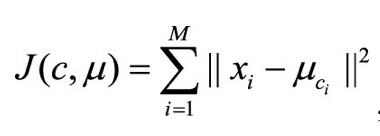
在这里插入图片描述
其中xi代表第i个样本,ci是xi所属于的簇,μci代表簇对应的中心点,M 是样本总数。

3.3 优化算法:期望最大化(EM)

  • EM 算法
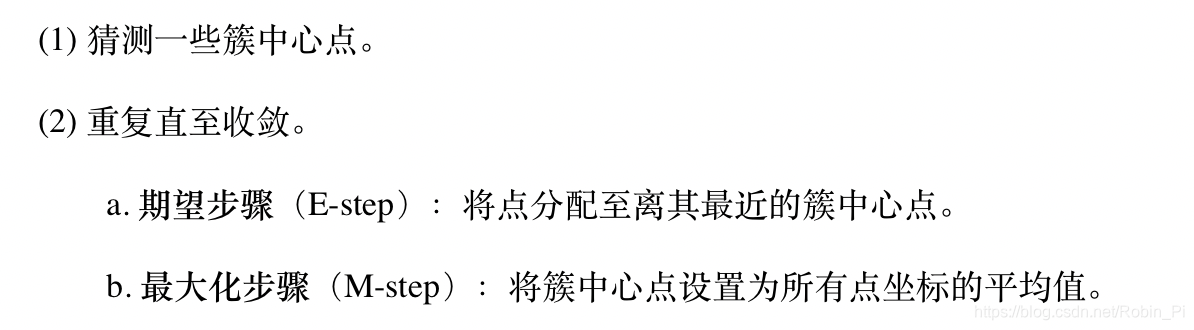
    期望最大化(expectation-maximization,E-M)是一种非常强大的算法,应用于数据科学的很多场景中。k-means 是该算法的一个非常简单并且易于理解的应用。

  • EM 步骤
    在这里插入图片描述

4. 缺点

  • EM 可能不会达到全局最优结果
    解决:用不同的初始值尝试很多遍

    在 Scikit-Learn 中通过 n_init 参数(默认值是 10)设置执行次数。

  • 必须提前告诉算法簇的数量(K 值)

    解决:合理选择 K 值—— 手肘法(暴力求解)
    在这里插入图片描述
    手肘法认为拐点就是 K 的最佳值。

  • k-means 算法只能确定线性聚类边界
    k-means 聚类的边界总是线性的,这就意味着当边界很复杂时,算法会失效。

  • 当数据量较大时,k-means 会很慢
    由于 k-means 的每次迭代都必须获取数据集所有的点,因此随着数据量的增加,算法会变得缓慢。

    解决:每一步仅使用数据集的一个子集来更新簇中心点。这恰恰就是批处理(batch-based) k-means 算法的核心思想。

5. 代码

  • 导入模块
import numpy as np 
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()

from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
  • 准备数据

设置 centers=5

X, y = make_blobs(n_samples=500, n_features=2,
                  centers=5, cluster_std=1.0, random_state=0)

plt.scatter(X[:, 0], X[:, 1], cmap='viridis', s=20)

在这里插入图片描述

  • 设置K,并进行训练
# 人为选择 n_clusters=4

km_model = KMeans(n_clusters=4)
km_model.fit(X) 

获取信息:簇中心坐标、数据标签

y_pred = km_model.predict(X) 
centers = km_model.cluster_centers_
# print(y_pred)
# print(centers)

用带彩色标签的数据来展示聚类结果。同时,画出簇中心点

  • 聚类可视化

plt.scatter(centers[:, 0], centers[:,1], 
            c='black', cmap='viridis', s=500, alpha=1) 
plt.scatter(X[:, 0], X[:, 1], c=y_pred, cmap='viridis', s=10) 

在这里插入图片描述

  • 手动实现K-means
# 手动实现K-means (K-means:EM算法的应用)

from sklearn.metrics import pairwise_distances_argmin

def find_clusters(X, n_clusters, rseed=2):
    # 随机选取 clusters 
    rng = np.random.RandomState(rseed)
    i = rng.permutation(X.shape[0])[:n_clusters]
    centers = X[i]
    
    while True:
        # 2a.基于最近的中心指定标签
        labels = pairwise_distances_argmin(X, centers)
        
        # 2b. 根据点的平均值找到新的中心
        new_centers = np.array([X[labels == i].mean(0)
                                for i in range(n_clusters)])
        
        # 2c. 确认收敛
        if np.all(centers == new_centers):
            break
        centers = new_centers
    
    return centers, labels

centers, labels = find_clusters(X, 4)
plt.scatter(X[:, 0], X[:, 1], c=labels,
            s=30, cmap='viridis');

在这里插入图片描述

DBSCAN

DBSCAN是一个比较有代表性的基于密度的聚类算法。与划分和层次聚类方法不同,它将簇定义为密度相连的点的最大集合,能够把具有足够高密度的区域划分为簇,并可在噪声的空间数据库中发现任意形状的聚类。具体算法描述如下: (1)检测数据库中尚未检查过的对象p,如果p未被处理(归为某个簇或者标记为噪声),则检查其邻域,若包含的对象数不小于minPts,建立新簇C,将其中的所有点加入候选集N; (2)对候选集N 中所有尚未被处理的对象q,检查其邻域,若至少包含minPts个对象,则将这些对象加入N;如果q 未归入任何一个簇,则将q 加入C; (3)重复步骤2),继续检查N 中未处理的对象,当前候选集N为空; (4)重复步骤1)~3),直到所有对象都归入了某个簇或标记为噪声。

KNN聚类的原理和实现 目录 1.认识KNN算法 2.算法原理 3.实战应用 1.认识KNN算法 KNN算法通俗说是寻找最近的k个数据,推测新数据的分类,其核心思想是如果一个样本在特征空间中的k个最相邻的样本中的大多数属于某一个类别,则该样本也属于这个类别,并具有这个类别上样本的特性。就像视频https://blog.youkuaiyun.com/haluoluo211/article/details/78177510?locationNum=2&fps=1&utm_medium=distribute.pc_rele 阅读详情

相关推荐

24、无监督KNN算法:探索数据中的隐秘模式

本文详细介绍了无监督KNN算法的基本概念、实现步骤及其在聚类、异常检测等领域的应用。同时探讨了其与深度学习结合的方式,并分析了算法的挑战及优化方法,展望了未来的发展方向。

k8s6orchestrator的博客 92

统计学习方法|K近邻原理剖析及实现

欢迎直接到我的博客查看最近文章:www.pkudodo.com。更新会比较快,评论回复我也能比较快看见,排版也会更好一点。 原始blog链接:http://www.pkudodo.com/2018/11/19/1-2/ 前言 《统计学习方法》一书在前几天正式看完,由于这本书在一定程度上对于初学者是有一些难度的,趁着热乎劲把自己走过的弯路都写出来,后人也能走得更顺畅一点。 以下是我的...

Dodo 537

测站坐标系统 -- 东北天(ENU)坐标系、站心坐标系

测站坐标系统以观测站(或地面上某一个观测点为中心建立坐标系统,将这类坐标系称为测站坐标系统。测站坐标系通常以用户所在的位置点P为坐标原点三个坐标轴分别是相互垂直的东向北向和天向,因而测站坐标系又称为东北天(ENU)坐标系。由于测站坐标系以站心为坐标原点,因此也称为站心坐标系。如图所示,测站坐标系的天向与大地坐标系(LLA经纬度坐标系)在此点的高程方向一致。测站坐标系固定在地球上,本质上是一种地固坐标系。(1)以站心为坐标原点。(2)Z轴与站心点的椭球法线重合,向上为正。

qq_43381998的博客 1万+

knn聚类还是分类_从KNN谈到聚类(以Kmens为例)

K近邻算法(KNN)是一种基本分类和回归的算法。对于新数据点,在训练集中找到k个最近邻数据点的类别,通过例如多数表决的方法来判断新数据点的类别。k值的选择、距离度量和分类决策规则是k近邻算法的三个要素。当三要素确定时,新的数据点经过KNN算法处理得到的类别也是唯一确定的。KNN常用算法除了暴力遍历外,还有基于树结构的kd tree算法(不适合维度高的数据)、乘积量化算法、基于哈希的LSH算法(适合...

weixin_42314420的博客 5712

千兆以太网PHY设计:PCB原理图完整示例

深入解析千兆以太网PHY电路设计要点,提供完整的PCB原理图设计实例,帮助工程师掌握高速信号布局与电源去耦等关键技术,提升设计稳定性与信号完整性。

weixin_30633869的博客 630

S32K144 ADC硬件触发实战:PDB与TRGMUX配置避坑指南

本文深入解析了S32K144微控制器中ADC硬件触发的两种核心方案:PDB与TRGMUX。通过对比其架构差异、详细配置流程及常见问题排查,提供了从寄存器操作到DMA联动的完整优化指南,旨在帮助开发者解决多通道采样时序不稳、CPU负载过高等实际难题,实现高效稳定的数据采集。

weixin_29168153的博客 442

kmeans算法_【白话机器学习】算法理论+实战之KMeans聚类算法

1. 写在前面如果想从事数据挖掘或者机器学习的工作,掌握常用的机器学习算法是非常有必要的,常见的机器学习算法:监督学习算法:逻辑回归,线性回归,决策树,朴素贝叶斯,K近邻,支持向量机,集成算法Adaboost等无监督算法:聚类,降维,关联规则, PageRank等为了详细的理解这些原理,曾经看过西瓜书,统计学习方法,机器学习实战等书,也听过一些机器学习的课程,但总感觉话语里比较深奥,读起...

weixin_39593469的博客 549

告别Qt Creator!VSCode + QMake + MinGW:从零搭建高效Qt开发环境

本文详细介绍了如何使用VSCode替代Qt Creator搭建高效的Qt开发环境,涵盖VSCode配置、QMake与MinGW集成、智能提示优化及构建调试技巧。通过实战案例展示如何提升开发效率30%以上,特别适合中大型Qt项目开发。

weixin_30466039的博客 243

IRONSIGHT实时OSINT仪表盘轮询与缓存设计全解:15秒警报刷新背后的真相

IRONSIGHT实时OSINT仪表盘的15秒警报刷新不是魔法,扒开源码,它的实时轮询与缓存设计只有三个关键:请求超时控制、粘性缓存和有界内存缓存。 IRONSIGHT 是一个免费开源的实时 OSINT(开源情报)指挥中心:把新闻、Telegram、军机、舰船、金融行情等 50+ 个公开数据源聚合到一个仪表盘里,全程不需要任何 API Key。本文面向新手,拆解它如何让数据"常新",同时又不被

gitblog_00144的博客 442

USB 基础学习:USB 电气信号介绍

USB电气信号技术解析 USB通信的核心是差分信号传输技术,通过D+和D-两根线传输相位相反的电压信号实现数据通信。USB信号系统包含三类关键信号:差分数据信号(抗干扰性强)、单端状态信号(用于设备识别)和电源信号(提供5V供电)。USB2.0采用400mV电压摆幅和NRZI编码,支持低速(1.5Mbps)至高速(480Mbps)传输;USB3.0则新增专用差分对,数据速率可达20Gbps。物理层通过上拉/下拉电阻检测设备连接,高速模式需特殊握手协议。抗干扰设计的关键在于保持差分线等长、阻抗匹配和使用共模扼

浩瀚之水的专栏 1782

Python实现商品价格监控与波动分析爬虫项目

本文通过完整的代码示例和详细的技术讲解,展示了如何实现商品价格的自动监控和波动分析。该项目不仅适用于个人购物助手,还可以扩展为商家的竞品监控工具。通过结合数据抓取、存储、分析与可视化,能够帮助我们更好地理解市场趋势并做出优化决策。

2201_76125261的博客 1742

机器学习-KNN聚类算法原理及Python代码实现

K-近邻算法(KNN)算法实现简单、高效。在分类、回归、模式识别等方面有着广泛的应用。该方法的思路是:在特征空间中,如果一个样本附近的k个最近(即特征空间中最邻近)样本的大多数属于某一个类别,则该样本也属于这个类别。就比如经常和我一块玩的人有10个人,他们中有6个人是好人,有1个人是比较坏的,有3个人又好又坏的,那么大家就认为我也是个好人,通过我接触某个类型的多少以此来给我定性。对应中国的古话:“近朱则赤,近墨者黑”。所以这个K的取值是很重要的,

回忆式~过去.的博客 2626

京东运维面试题及参考答案

cgroup(Control Group)是 Linux 内核提供的一种可以限制、控制与分离一个进程组群的资源(如 CPU、内存、磁盘 I/O 等)的机制。通过 cgroup,可以为不同的进程或进程组分配特定的资源配额,实现资源的隔离和管理。比如,在一个服务器上运行多个容器时,可以使用 cgroup 来限制每个容器对 CPU 和内存的使用,防止某个容器占用过多资源而影响其他容器的运行。cgroup 还可以对进程进行优先级设置,确保关键进程能够优先获得资源。

大模型大数据攻城狮的专栏 1236

浅谈监督聚类算法—KNN最近邻分类算法基础

KNN模型,是最简单的机器学习算法之一,其作用是以全部训练样本作为代表点,通过计算未知样本与所有训练样本的距离,并以最近邻者的类别作为决策未知样本类别的依据

qq_50086023的博客 2105

杰理可视化SDK开发-杰理AC1123N芯片SDK开发笔记合集

该文档主要描述 AC112N开发相关的使用说明和注意事项,收集并持续更新开发调试过程中的相关疑问和解答,对SDK介绍文档做一个补充说明。写作人:李永奉,参考项目MD-026H; AC112N-SDK项目帮助文档在杰理开发者平台(JL DP)'帮助'处进入,如本文档有与后续帮助文档或工具注释说明冲突,以后者为标准。

李永奉的博客 181

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

机器学习理论之(14):聚类算法的有监督(supervised)评估方式:purity v.s. entropy

文章目录纯度 Purity熵 Entropy 聚类算法是一类典型的无监督算法,那么为什么还有有监督的评估方式呢? 所谓的 “无监督” 算法指的是模型对于数据的训练和划分不依靠数据的标签,但是我们可以用标签来判断这个模型划分的是不是符合我们的要求。 纯度 Purity 假设对包含 NNN 个样本的数据集,用 kmeans 划分成 kkk 个聚类簇 Ci,...CkC_i,...C_kCi​,...Ck​,∣Ci∣|C_i|∣Ci​∣ 表示的是这个簇中的样本个数,Pi(j)P_i(j)Pi​(j) 代表在

qq_42902997的博客 3707

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

K近邻算法(KNN)&&K-means聚类算法

1.思想: 初始随机给定K(超参数)个簇中心,这K个簇中心是在样本点中随机选择。 按照最邻近原则把待分类的样本点分到各个簇。 划分完成后按平均法重新计算各个簇的质心,从而在确定新的簇心。 一直迭代,直到簇心的移动距离小于某个给定的值。 2.k-means算法评价准则:误差平方和准则,误差平方和达到最优(小)时,可以使类内尽可能紧凑,聚类之间尽可能分开。 loss损失:是一个非凸函数,所以有许多最小值,不一定每次都能落到全局最优,有可能落到局部最优。 k:簇的个数 Ci:某个簇

h2728677716的博客 5054

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

机器学习笔记(四)——聚类算法KNN、Kmeans、Dbscan

KNN算法的步骤可以概括如下:1、计算距离:计算待分类样本与训练集中每个样本的距离。2、选择k个最近邻样本。3、投票或取平均:对于分类问题,K 个最近邻中出现次数最多的类别即为待分类样本的类别;对于回归问题,K 个最近邻的值的平均值即为待分类样本的值。

qq_65078669的博客 2170

(学习笔记)KNN算法

作业笔记

yukihi47的博客 1503

KNN算法(有监督学习算法)

一、KNN算法简介   KNN算法又称k近邻分类(k-nearest neighbor classification)算法。它是根据不同特征值之间的距离来进行分类的一种简单的机器学习方法,它是一种简单但是懒惰的算法。他的训练数据都是有标签的数据,即训练的数据都有自己的类别。KNN算法主要应用领域是对未知事物进行分类,即判断未知事物属于哪一类,判断思想是,基于欧几里得定理,判断未知事物的特征和哪一类

奋斗才是年轻该有的状态 1万+

机器学习-无监督学习-KNN算法

机器学习—无监督学习-KNN算法 1.KNN算法是什么? KNN算法是一种监督式学习算法,核心思想是用距离最近的k个样本数据的分类来代表目标数据的分类。从原理上来说, 存在一个训练样本集,这个数据训练样本的数据集合中的每个样本都包含数据的特征和目标变量(即分类值),输入新的不含目标变量的数据,将该数据的特征与训练样本集中每一个样本进行比较,找到最相似的k个数据,这k个数据出席那次数最多的分类,即输...

allowancedebug的博客 1万+

机器学习之KNN(K近邻)算法

KNN算法又叫做K近邻算法,是众多机器学习算法里面最基础入门的算法。KNN算法是最简单的分类算法之一,同时,它也是最常用的分类算法之一。KNN算法是有监督学习中的分类算法,它看起来和Kmeans相似(Kmeans是无监督学习算法),但却是有本质区别的。KNN算法基于实例之间的相似性进行分类或回归预测。在KNN算法中,要解决的问题是将新的数据点分配给已知类别中的某一类。该算法的核心思想是通过比较距离来确定最近邻的数据点,然后利用这些邻居的类别信息来决定待分类数据点的类别。其核心思想为:“近朱者赤近墨者黑”

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 1万+

聚类 监督聚类 k-means聚类

Wikipedia上的 KNN词条 中有一个比较经典的图如下:KNN的算法过程是是这样的:从上图中我们可以看到,图中的数据集是良好的数据,即都打好了label,一类是蓝色的正方形,一类是红色的三角形,那个绿色的圆形是我们待分类的数据。如果K=3,那么离绿色点最近的有2个红色三角形和1个蓝色的正方形,这3个点投票,于是绿色的这个待分类点属于红色的三角形。如果K=5,那么离绿色点最近的有2个红色三角形和3个蓝色的正方形,这5个点投票,于是绿色的这个待分类点属于蓝色的正方形。

生信小博士的博客 2063

9种有监督与3种无监督机器学习算法

9种有监督与3种无监督机器学习算法

weixin_44906759的博客 1万+

分类(有监督学习)和聚类(无监督学习)有什么区别呢?

分类(有监督学习)和聚类(无监督学习)有什么区别呢?

qq_44591229的博客 2008

聚类分简单来讲:有监督 -> 分类(…

简单来讲: 有监督 -> 分类(回归) -> 识别; 无监督 -> 聚类 -> 分割; ' -> ' 表示对应关系 (ps:这个说法来自于《学习Opencv》这样讲不知道有没有问题,目前我是这样理解的) 一、分类和聚类 简单地说,分类(Categorization or Classification)就是按照某种标准给对象贴标签(label),再根据标签来区分归类。 简单地说,聚类是指事先没有“标

bluewater的专栏 1万+
上一篇: 机器学习模型/算法—— 阶段性总结(1)模型框架:假设函数、目标函数和优化算法
下一篇: 机器学习代码实践——数据——如何快速获取所需的实验数据
Robin_Pi
博客等级 码龄9年 2万+粉丝 632原创
评论 7
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值