“距离”、“范数”和范数正则化

L1和L2范数 L1、L2范数详解 阅读详情

1. 范数

先思考 机器学习中的行向量和列向量?

1.1 概念

向量的范数可以简单形象的理解为向量到零点的距离,或者相应的两个点之间的距离、或者向量的长度。

(如果对象是一个单独的向量,那么默认是指与原点进行比较,这情况下,范数代表的是向量到原点的距离,也就是向量的向量的长度;如果定义了两个向量,则范数可以表示这两个向量之间的距离)

1.2 定义

向量的范数定义:向量的范数是一个函数||x||,满足
非负性 ||x|| >= 0,
齐次性 ||cx|| = |c| ||x|| ,
三角不等式 ||x+y|| <= ||x|| + ||y||。

1.3 常见的向量范数

  • L1范数: ||x||1 为x向量各个元素绝对值之和。

  • L2范数: ||x||2为x向量各个元素平方和的1/2次方,L2范数又称Euclidean范数或者Frobenius范数

  • Lp范数: ||x||p为x向量各个元素绝对值p次方和的1/p次幂

  • L∞范数: ||x||∞为x所有向量元素中的最大值(向量各个元素绝对值最大那个元素的绝对值),如下:
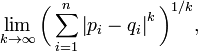
    在这里插入图片描述

  • 椭球向量范数: ||x||A = sqrt[T(x)Ax], T(x)代表x的转置。定义矩阵C 为M个模式向量的协方差矩阵, 设C’是其逆矩阵,则Mahalanobis距离定义为||x||C’ = sqrt[T(x)C’x], 这是一个关于C’的椭球向量范数。

2. 距离

闵可夫斯基距离(对应 Lp 范数)

闵氏距离不是一种距离,而是一组 距离的定义。对应Lp范数,p为参数。

闵氏距离的定义:两个n维变量(或者两个n维空间点)X = (x1, x2, …, xn) 与 Y = (y1, y2, …, yn) 间的闵可夫斯基距离定义为:
在这里插入图片描述

其中p是一个变参数。

当p=1时,就是曼哈顿距离,

当p=2时,就是**欧氏距离**,

当p→∞时,就是切比雪夫距离,       

根据变参数的不同,闵氏距离可以表示一类的距离。 
  • 欧氏距离(对应 L2 范数)
  • 曼哈顿距离(对应 L1 范数)
  • 切比雪夫距离(对应 L∞范数)

汉明距离

分类特征的度量方式,比如比较字符串中相同字符的个数

Mahalanobis距离

Mahalanobis距离:也称作马氏距离。在近邻分类法中,常采用欧式距离和马氏距离。

3. 范数正则化

3.1 正则化的作用

  • 防止模型过分拟合训练数据 <- 降低模型复杂度
  • 约束我们的模型的特性 ->这样就可以将人对这个模型的先验知识融入到模型的学习当中,强行地让学习到的模型具有人想要的特性,例如稀疏、低秩、平滑等等。(人:大牛 ;模型:小白)

其它的角度看待正则化:

  • 规则化符合奥卡姆剃刀(Occam’s razor)原理:在所有可能选择的模型中,我们应该选择能够很好地解释已知数据并且十分简单的模型
  • 贝叶斯估计的角度:规则化项对应于模型的先验概率。
  • 规则化是结构风险最小化策略的实现
    规则化风险 = 经验风险 + 正则化项/惩罚项

3.2 目标函数与正则化项

在这里插入图片描述
其实,线性回归应用L1正则项即为 Lasso 回归,应用L2正则项即为岭回归(Ridge Regression)。可以参考:点击

L0范数与L1范数

概念:

  • L0范数是指向量中非0的元素的个数。
    如果我们用L0范数来规则化一个参数矩阵W的话,就是希望W的大部分元素都是0。换句话说,让参数W是稀疏的。
  • L1范数是指向量中各个元素绝对值之和,也有个美称叫“稀疏规则算子”(Lasso regularization)。
    …
    L1范数和L0范数可以实现稀疏,L1因具有比L0更好的优化求解特性而被广泛应用。

补:

  1. 为什么要稀疏?让我们的参数稀疏有什么好处呢?
  • 特征选择(Feature Selection)

使用稀疏的一个关键原因在于它能实现特征的自动选择。它会学习地去掉没有信息的特征,也就是把这些特征对应的权重置为0。

  • 可解释性(Interpretability)
    另一个青睐于稀疏的理由是,模型更容易解释。
  1. L1是如何做到稀疏参数的?
    在这里插入图片描述
    在这里插入图片描述
    参考知乎上的两个回答:点击1、点击2

简单来说,如上面第一张图所示,明白下面几个点:
〇 横纵坐标是两个参数(以两个参数w1和w2来进行可视化举例)
① 蓝色圆圈部分为 不带正则项的情况,越靠里损失越小,越是最优解;
② 添加正则项相当于对参数进行了一个限制(将参数框定在黄色阴影部分),在图中体现是最优解必须是蓝色圆圈和下面黄色图形相切之处
③L1正则化和L2的差别是,使用L1正则项(右)会使得参数x1=0(看第二张图),这就是“稀疏”的意思——两个参数x1和x2最后只剩下了x2,n元参数同理。。。

更多可参考:点击
在这里插入图片描述

L2范数

除了L1范数,还有一种更受宠幸的规则化范数是L2范数: ||W||2。它也不逊于L1范数,它有两个美称,在回归里面,有人把有它的回归叫**“岭回归”(Ridge Regression)**,有人也叫它“权值衰减weight decay”。

概念:
L2范数是指向量各元素的平方和然后求平方根。
原理:
我们让L2范数的规则项||W||2最小,可以使得W的每个元素都很小,都接近于0,但与L1范数不同,它不会让它等于0,而是接近于0,这里是有很大的区别。(使用L1可以得到稀疏的权值,使用L2可以得到平滑的权值)
越小的参数说明模型越简单,所以通过L2范数,我们可以实现了对模型空间的限制,从而在一定程度上避免了过拟合。

好处:

  • 学习理论的角度
    从学习理论的角度来说,L2范数可以防止过拟合,提升模型的泛化能力。
  • 优化计算的角度
    从优化或者数值计算的角度来说,L2范数有助于处理 condition number 不好的情况下矩阵求逆很困难的问题。
    在这里插入图片描述
    其他参考:
    L1在江湖上人称Lasso,L2人称Ridge。

一句话小结:L2范数不但可以防止过拟合,还可以让我们的优化求解变得稳定和快速。

一句话总结:

L1会趋向于产生少量的特征,而其他的特征都是0,而L2会选择更多的特征,这些特征都会接近于0。
L1正则化产生稀疏模型,L2正则防止过拟合

更多参考 点击,值得好好理解学习!

机器学习中常用范数与距离 机器学习中常用范数与距离前言范数向量范数矩阵范数距离曼哈顿距离欧氏距离切比雪夫距离闵可夫斯基距离标准化欧氏距离马氏距离余弦距离 前言 在机器学习中经常会涉及到范数和距离的概念,有时候优化的目标函数就是常用范数和距离的变化。关于范数和距离其实已经有很多人写过文章了,我之所以还要再写一遍,是因为读别人的文章我老是记不住,干脆好记性不如烂键盘,自己敲一遍吧。 范数 向量范数 向量范数表示向量空间中向量的... 阅读详情

相关推荐

【深度学习】梳理范数与正则化(二)

【深度学习】梳理范数与正则化(二) 今天要梳理的知识是范数与正则化。文章完全根据个人理解写,如有不对,欢迎指出!! 正则化 正则化是一种对学习算法的约束,主要是为了防止过拟合(下一次会梳理这个知识点),从而增强模型的泛化能力。泛化能力 是指模型对位置数据的预测能力,是一种用于评估机器学习算法的能力的指标。泛化误差可以反映模型的泛化能力,误差越小,模型越稳定。泛化误差(generalizatio...

florrie 3043

范数的简介

目录什么是范数?范数的类型常用的向量范数常用的矩阵范数向量求范数的具体操作矩阵求范数的具体操作范数的一种具体应用 什么是范数? 范数(norm)是数学中的一种基本概念。在泛函分析中,它定义在赋范线性空间中,并满足一定的条件,即①非负性;②齐次性;③三角不等式。它常常被用来度量某个向量空间(或矩阵)中的每个向量的长度或大小。 范数的类型 常用的向量范数 0范数(L0范数)-向量中非0元素的个数。 1范数(L1范数)-向量中各个元素绝对值之和。 2范数(L2范数)-向量的模长。 无穷范数(最大范数)-向量中各个

daijingxin的博客 2万+

什么是范数(Norm),其具有哪些性质

文章目录直观的感受一下范数范数的定义直观的感受下范数的边界图像范数的性质参考资料 直观的感受一下范数 先直观的感受一下二维空间的范数,假设在二维空间的向量为 v=(x,y)\bold{v} =(x,y)v=(x,y) 则v的1范数为: ∣∣v∣∣1=∣∣(x,y)∣∣1=∣x∣+∣y∣=(∣x∣1+∣y∣1)11 ||\bold{v}||_1 =||(x,y)||_1 = |x| + |y| = (|x|^1+|y|^1)^\frac{1}{1} ∣∣v∣∣1​=∣∣(x,y)∣∣1​=∣x∣+∣y∣=(∣

iioSnail的博客 3万+

秒懂范数Norm

范数(Norm)是数学中用于度量向量或矩阵大小的一种函数,通常用于描述一个向量或矩阵的“长度”或“大小”。

qq_45934590的博客 5885

范数的意义与计算方法

范数可以简单的理解为“距离”。由于向量是既有大小又有方向的量,所以向量是不能直接比较大小的,但是范数提供了一种方法,可以将所有的向量转化为一个实数,然后就可以比较向量的大小了。(注:本文我们只讨论向量范数,向量范数表征向量空间中向量的大小,另一种叫矩阵范数,表征矩阵引起变化的大小。范数并不是一个数,而是一组数,我们先了解一下最常用的L-2范数范数,它的计算方法是:将向量的每一个分量平方后再求和,然后对和开平方,得到的就是这个向量的L-2范数范数了

Laurence的技术博客 1万+

微信聊天记录丢失原因与恢复方案详解

SQLite数据库作为移动应用常见的本地存储方案,其加密机制和存储结构直接影响数据安全性。以微信为例,聊天记录存储在EnMicroMsg.db等SQLite文件中,采用AES加密保护。当手机清理工具误删这些文件时,会导致特定时间段记录丢失。理解数据恢复原理需要掌握文件系统删除机制和闪存特性,其中关键点包括TRIM指令的影响和数据块覆盖风险。通过专业工具如DiskDigger或iMyFone D-Back,配合ADB调试和SQLite数据重组技术,可在黄金时间窗口内恢复记录。日常维护建议结合自动化备份方案和存

weixin_32612263的博客 386

欧氏距离,l2范数,l2-loss,l2正则化

欧式距离,l2范数,l2-loss,l2正则化1.欧氏距离L2范数范数计算公式L1范数L2范数在机器学习方面的区别为什么L2范数可以防止过拟合?3. L2-Loss4. L2正则化正则化L2正则化参考文献 1.欧氏距离 距离度量(Distance)用于衡量个体在空间上存在的距离,距离越远说明个体间的差异越大。欧氏距离是最常见的距离度量,衡量的是多维空间中各个点之间的绝对距离。欧氏距离又称欧几里得距离或欧几里得度量,它是欧几里得空间中两点间“普通”(即直线)距离。使用这个距离,欧氏空间成为度量空间。相关联的范

Accelerating的博客 2万+

从临床试验到互联网AB测试:边缘结构模型(MSM)如何解决‘时依性混杂’这个老大难问题

本文探讨边缘结构模型(MSM)如何解决时依性混杂问题,适用于临床试验和互联网AB测试。通过逆概率加权(IPTW)等方法,MSM能有效剥离混杂效应,准确评估长期干预效果。文章结合跨领域案例,详细解析MSM的核心原理、实施步骤及在推荐算法效果评估中的实战应用,帮助读者掌握这一先进因果推断工具。

weixin_28725949的博客 207

范数(简单的理解)、范数的用途、什么是范数

没学好矩阵代数的估计范数也不是太清楚,当然学好的人也不是太多。 范数主要是对矩阵和向量的一种描述,有了描述那么“大小就可以比较了”,从字面理解一种比较构成规范的数。有了统一的规范,就可以比较了。 例如:1比2小我们一目了然,可是(3,5,3)和(6,1,2)哪个大?不太好比吧 2范数比:根号(43)比根号(41)大,因此2范数对比中(3,5,3)大 无穷范数比:5比6小,因此无穷范数对比中(6,1...

三眼二郎 7万+

STM32 SYSTICK定时器及延时函数详解

STM32 SYSTICK及延时函数详解 SysTick定时器 SysTick定时器被捆绑在NVIC中,用于产生SYSTICK异常(异常号:15)。在以前,大多操作系统需要一个硬件定时器来产生操作系统需要的滴答中断,作为整个系统的时基。例如,为多个任务许以不同数目的时间片,确保没有一个任务能霸占系统;或者把每个定时器周期的某个时间范围赐予特定的任务等,还有操作系统提供的各种定时功能,都与这个滴答定时器有关。因此,需要一个定时器来产生周期性的中断,而且最好还让用户程序不能随意访问它的寄存器,以维持操作系统“心

w1050321758的博客 2366

Hive数据迁移

【迁移背景】 本次需要将老集群的hive数据(共30多张表)迁移至新集群中。 老集群版本为CDH5.13,未启用kerberos; 新集群版本为CDH5.14,启用了kerberos。 由于cloudera官方文档说明,在5.x的版本不支持从未启用kerberos的集群与启用了kerberos的集群之间的数据复制。因此无法通过bdr方式进行数据同步。于是采用手工方式进行测试验证。 第一步...

wangkuangood3200的专栏 469

正则化 LP、L1、L2范数

正则化的本质很简单,就是对某一问题加以先验的限制或约束以达到某种特定目的的一种手段或操作。在算法中使用正则化的目的是防止模型出现过拟合。

分享学习期间的笔记心得 3196

从零到一:DAMASK与ABAQUS联合仿真的环境配置艺术

本文详细介绍了在Ubuntu 16.04系统中配置DAMASK与ABAQUS2017联合仿真环境的完整流程,涵盖系统基础环境搭建、Python科学计算环境构建、DAMASK核心安装与配置,以及ABAQUS集成与联合调试。通过实战案例和高级调试技巧,帮助用户快速掌握有限元分析中的晶体塑性模拟技术。

weixin_29253711的博客 857

正则化——参数范数惩罚

L1和L2正则化

qq_42757191的博客 4136

【通俗易懂】Windows系统安装TensorRT

NVIDIA TensorRT是一个由NVIDIA公司开发的用于深度学习推理的高性能SDK。它专门设计用于在NVIDIA GPU上进行高效的神经网络推理,能够大幅度提升深度学习模型的推理速度和效率。TensorRT的主要特点包括:模型优化:TensorRT通过层融合、精度校准、动态形状等技术优化模型,减少推理时的计算量和内存占用。多精度推理:支持多种精度推理,包括FP32、FP16、INT8等,以平衡性能和精度。

王尼莫的博客 1587

Python开发MCP Client

全部例子只是MCP Client访问MCP Server的过程,那么这样其实就失去了MCP协议的创建的初衷,和大模型集成后才能发挥MCP最大的作用。

Criss@陈磊 2973

机器学习中的正则化——L1范数和L2范数

机器学习中的正则化——L1范数和L2范数正则化是什么?为什么要正则化?LP范数L0范数(补充了解)L1范数L2范数L1范数和L2范数的区别以深度学习的角度看待L1范数和L2范数 正则化是什么?为什么要正则化? 在数学与计算机科学中,尤其是在机器学习和逆问题领域中,正则化是指为解决适定性问题或过拟合而加入额外信息的过程。 在机器学习和逆问题的优化过程中,正则项往往被加在目标函数当中。——维基百科 正则化的本质是对某一问题加以先验的限制或约束(如L1范数和L2范数),以达到某种特定目的的一种手段或操作(函数的稀

weixin_42926076的博客 6654

企业如何开展BI建设--指标体系建设

很多企业的数字化转型工作都是从做BI项目开始的,很多企业认为,BI就是做指标大屏,所以做了很多的驾驶舱,也做了很多指标,有从系统取的,有手工填报的,甚至手工填报的比例占到了70%,最终BI沦为了填报系统,业务认为BI就是把从线下的微信沟通转到了线上录入展示,并没有给业务代来任何提升,久而久之,BI大屏就没人关心,公司高层也认为数据都是填报的,都经过了加工处理,这种数据不可信,不能反映业务开展的实际。其实在BI系统建设之前,我们首先要做的就是要梳理企业的指标,到底我们要展示哪些指标?

263

L0范数、L1范数和L2范数的区别

我的个人微信公众号:Microstrong 微信公众号ID:MicrostrongAI 公众号介绍:Microstrong(小强)同学主要研究机器学习、深度学习、计算机视觉、智能对话系统相关内容,分享在学习过程中的读书笔记!期待您的关注,欢迎一起学习交流进步! 知乎专栏:https://zhuanlan.zhihu.com/Microstrong Github:https://githu...

Microstrong 5万+

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

范数(norm) 几种范数的简单介绍

什么是范数? 我们知道距离的定义是一个宽泛的概念,只要满足非负、自反、三角不等式就可以称之为距离。范数是一种强化了的距离概念,它在定义上比距离多了一条数乘的运算法则。有时候为了便于理解,我们可以把范数当作距离来理解。 在数学上,范数包括向量范数和矩阵范数,向量范数表征向量空间中向量的大小,矩阵范数表征矩阵引起变化的大小。一种非严密的解释就是,对应向量范数,向量空间中的向量都是有大小的,这个大小...

Keep Fighting! 1万+

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

范数与正则化

范数 比较1、2两个数字的大小,其结果显而易见。但我们如何比较(3,6)、(4,5)两个向量的大小呢?此时就用到了范数。 范数是衡量某个向量空间(或矩阵)中的每个向量的长度或大小。范数的一般化定义:对实数p>=1, 范数定义如下: L1范数 当p=1时,是L1范数,其表示某个向量中所有元素绝对值的和。 L2范数 当p=2时,是L2范数, 表示某个向量中所有元素平方和再开根...

贾路飞的博客 1918

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

L0 范数、L1 范数和 L2 范数详解(归一化+正则化)

L1和L2范数是机器学习中常用的两种正则化方法,主要区别在于:L1范数(曼哈顿距离)能产生稀疏解,适用于特征选择和压缩感知;L2范数(欧几里得距离)使参数分布更均匀,有助于防止过拟合。L1对异常值更鲁棒但不可导,L2可导但对异常值敏感。实践中,L2常用于权重衰减和Ridge回归,而L1用于Lasso回归和特征选择。深度学习框架中L2是默认选择,因其计算高效且易于优化,而L1需要手动实现。根据任务需求可选择单一方法或结合使用(如ElasticNet)。

weixin_64659655的博客 3671

核范数和l1范数_L1和L2 详解(范数、损失函数、正则化)

一、易混概念对于一些常见的距离先做一个简单的说明1.欧式距离假设X和Y都是一个n维的向量,即 则欧氏距离: 2.L2范数假设X是n维的特征 L2范数: 3.闵可夫斯基距离这里的p值是一个变量,当p=2的时候就得到了欧氏距离。 4.曼哈顿距离来源于美国纽约市曼哈顿区,因为曼哈顿是方方正正的。 二、损失函数L1和L2都可以做损失函数使用。1. L2损失函数L2范数损失函数,也被称为最小平方误...

weixin_39779928的博客 1287

【基础知识】范数和正则化

目录1.范数1)向量范数L-P范数①L0范数②L1范数③L2范数④L∞\infty∞2)矩阵范数2.正则化1)L1正则2)L2正则参考文章 1.范数 范数通俗理解就是一个函数,用来度量向量的大小和方向。 根据维度,范数可分为向量范数(二维)和矩阵范数(多维)。 1)向量范数 L-P范数 L-P范数不是一个范数,而是一组范数,其定义如下: Lp=∥x∥p=∑i=1nxipp,x=(x1,x2,...,xn)(1)L_p=\begin{Vmatrix}\bold{x}\end{Vmatrix}_p=\sqrt[

weixin_42780429的博客 1362

L1正则化,L2正则化与范数的关系?

目录深度学习基础:L1正则化,L2正则化与范数的关系?范数的概念范数如何与正则联系起来?为什么最小化权重的范数就可以实现正则化?L1L1L1 范数和 L2L2L2 **范数** 有什么区别?参考:上文本人随手翻译笔记,表述不足或错误之处欢迎批评指正 深度学习基础:L1正则化,L2正则化与范数的关系? L1L1L1 正则和L2L2L2 正则本质上用到的是范数这块的数学知识,向量的L1L1L1 范数和L2L2L2 范数。所以先看一下范数的概念: 范数的概念 通常我们用范数 (norm) 来衡量向量,向量的 Lp

liudaohui11的博客 2069

范数(norm) :L-P,L0,L1,L2范数的简单介绍

我们知道距离的定义是一个宽泛的概念,只要满足非负、自反、三角不等式就可以称之为距离。范数是一种强化了的距离概念,它在定义上比距离多了一条数乘的运算法则。有时候为了便于理解,我们可以把范数当作距离来理解。在数学上,范数包括向量范数和矩阵范数,向量范数表征向量空间中向量的大小,矩阵范数表征矩阵引起变化的大小。一种非严密的解释就是,对应向量范数,向量空间中的向量都是有大小的,这个大小如何度量,就是用范数来度量的,不同的范数都可以来度量这个大小,就好比米和尺都可以来度量远近一样;

weixin_58045467的博客 9846
上一篇: 机器学习常见的数学符号表
下一篇: 值得反复思考的博客(机器学习篇)
Robin_Pi
博客等级 码龄9年 2万+粉丝 632原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值