如何通过RL真正提升大模型的推理能力?NVIDIA提出长期强化学习训练框架ProRL

利用dddd_trainer训练通用验证码识别模型 博文介绍了使用dddd_trainer工具训练自定义验证码识别模型的过程,详细展示了从环境搭建、数据集准备到模型训练的全流程。 阅读详情

原文:https://mp.weixin.qq.com/s/QLFKvb8Ol3CX9uWKBXSrow

论文:ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models
Abs:https://arxiv.org/abs/2505.24864
权重下载:https://huggingface.co/nvidia/Nemotron-Research-Reasoning-Qwen-1.5B

最近LLM + RL的研究越来越火,但关于“RL是否真的能提升模型的推理能力”这一问题,社区仍存在不少争议。一些研究指出,RL只是在让模型变得更会“猜答案”,而非真正学会新能力。

我们认为这些质疑可能来自两个“隐藏问题”:

  • 太多研究只在数学领域做实验,而这类任务基础模型早就见过,根本没有探索新能力的空间;
  • RL训练都太短了——几百步就停止,模型还没开始“发掘潜能”就被叫停了。

因此,我们认为应该在更加多样的任务上做更加长期的强化学习训练。然而,让模型在强化学习中实现长期且稳定的训练并不容易。传统方法常常面临梯度爆炸或训练坍塌等问题。为此,我们将 模型的 entropy(熵) 作为衡量训练健康程度的关键指标。Entropy 反映了模型在探索与利用之间的平衡能力,也代表了模型对问题理解的深度。

训练过程中,我们力求保持 entropy 在一个合理且稳定的区间:过高的 entropy 意味着模型在做出决策时过于随机,缺乏有效判断;过低的 entropy 则表明模型可能陷入某个解法,失去了进一步探索的能力。

通过持续监控并调控 entropy,我们有效促进了 RL 训练的稳定性和推理能力的提升。在此基础上,我们提出了ProRL(Prolonged Reinforcement Learning),一个长期强化学习训练框架,核心包括:

  • KL控制(保持模型不跑偏)
  • 参考策略重置(防止陷入局部最优)
  • 多样化任务集合(激发模型学习不同推理策略)

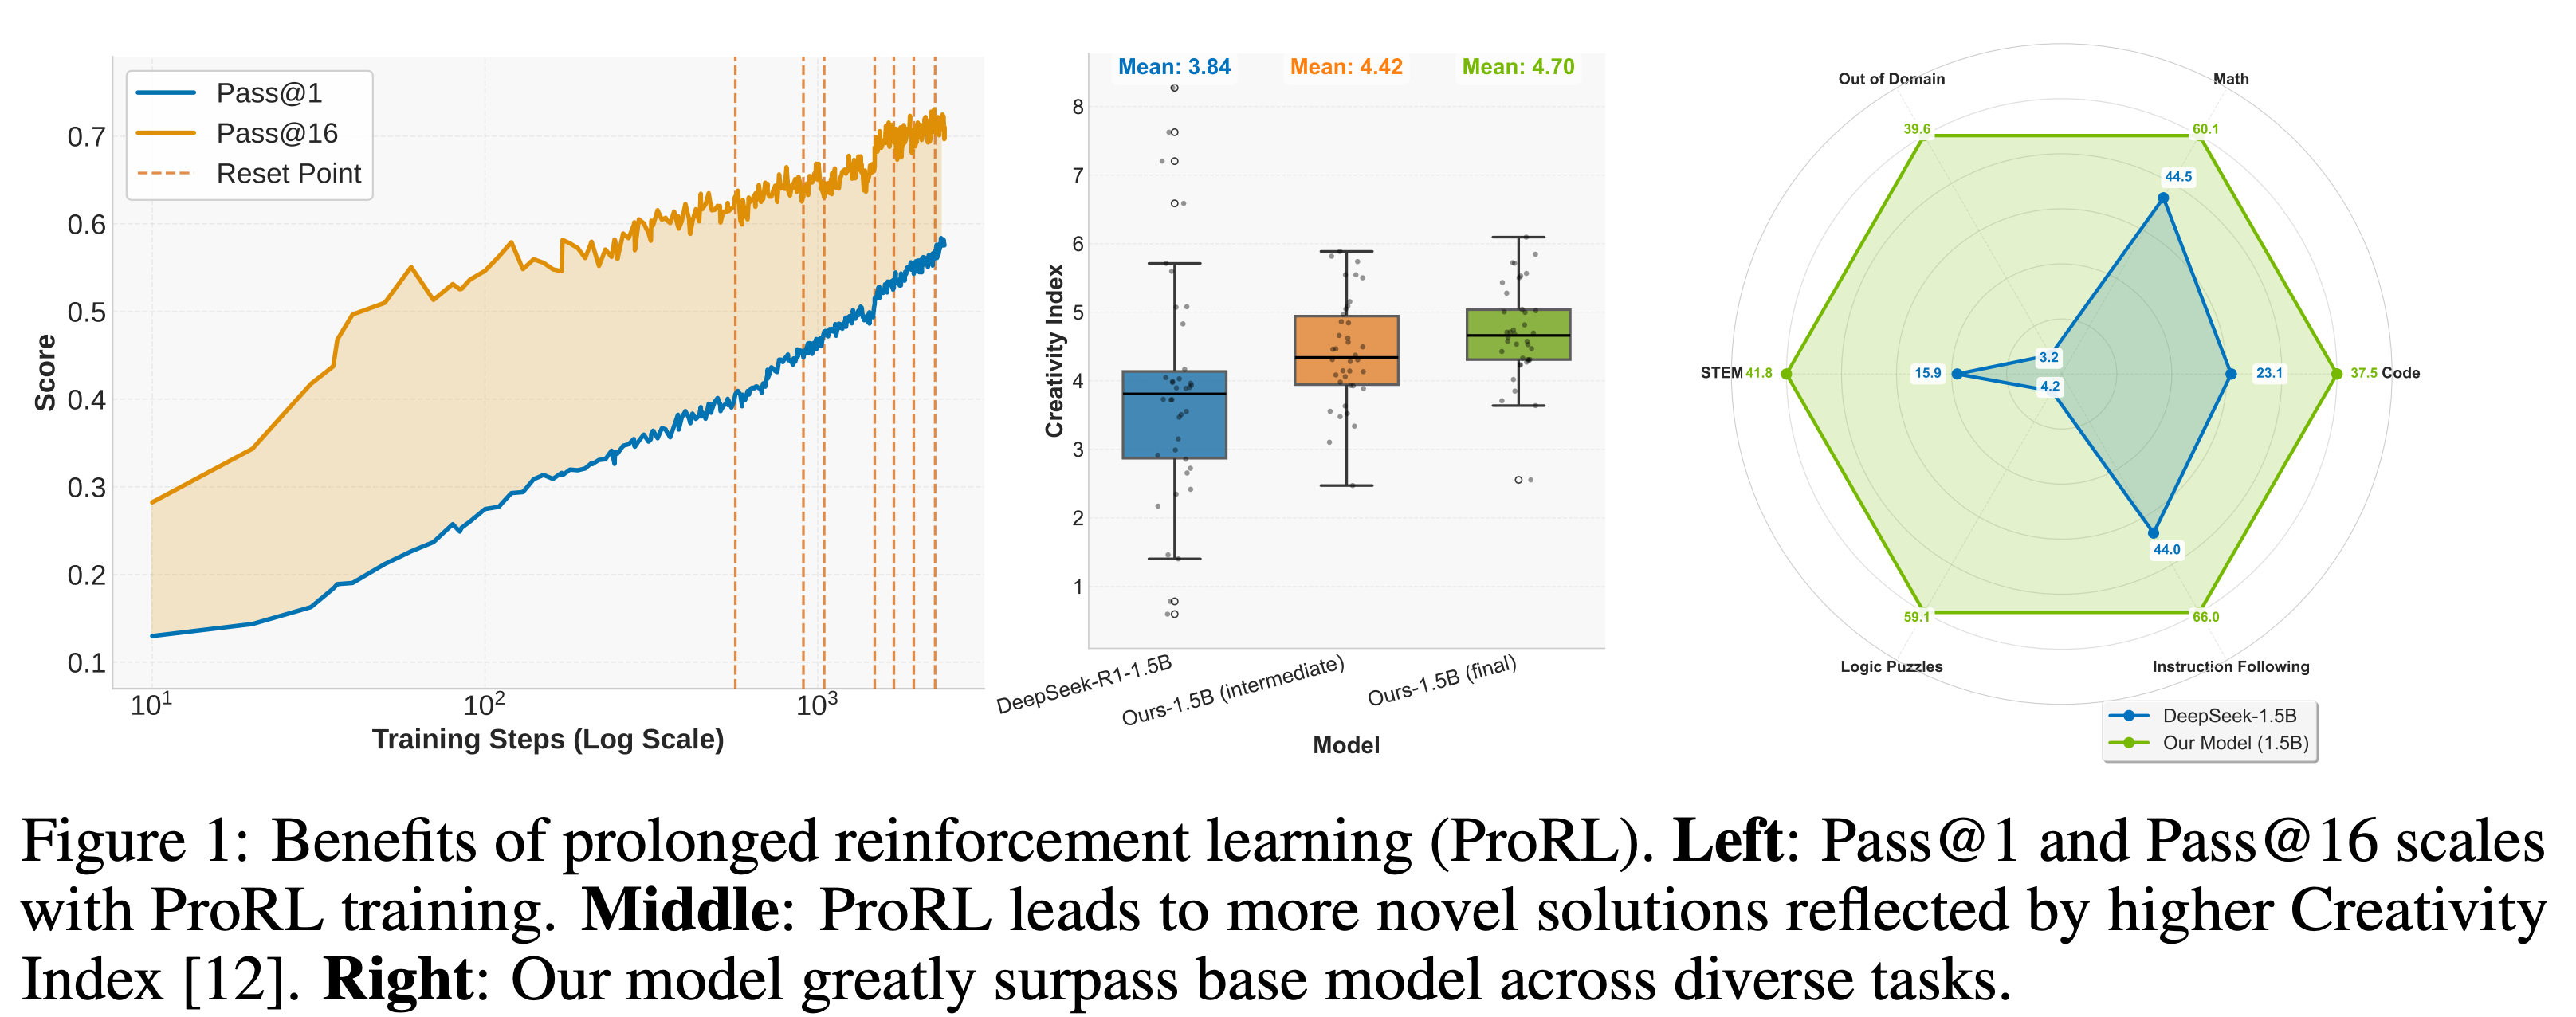
我们基于 DeepSeek-Distilled-Qwen-1.5B,训练了一个专注于推理能力的模型 —— Nemotron-Research-Reasoning-Qwen-1.5B,在数学/编程/逻辑题/STEM推理/任务指令理解等多个领域展现出显著提升。
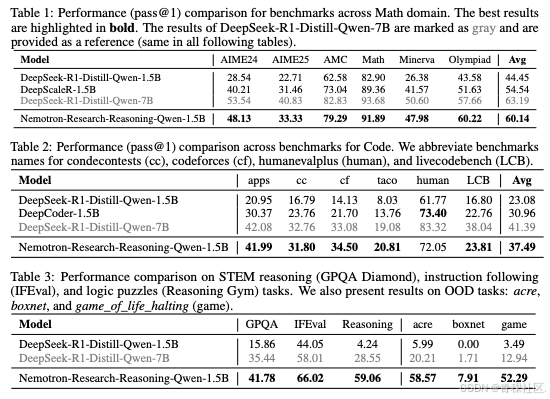
在这里插入图片描述

更关键的是:

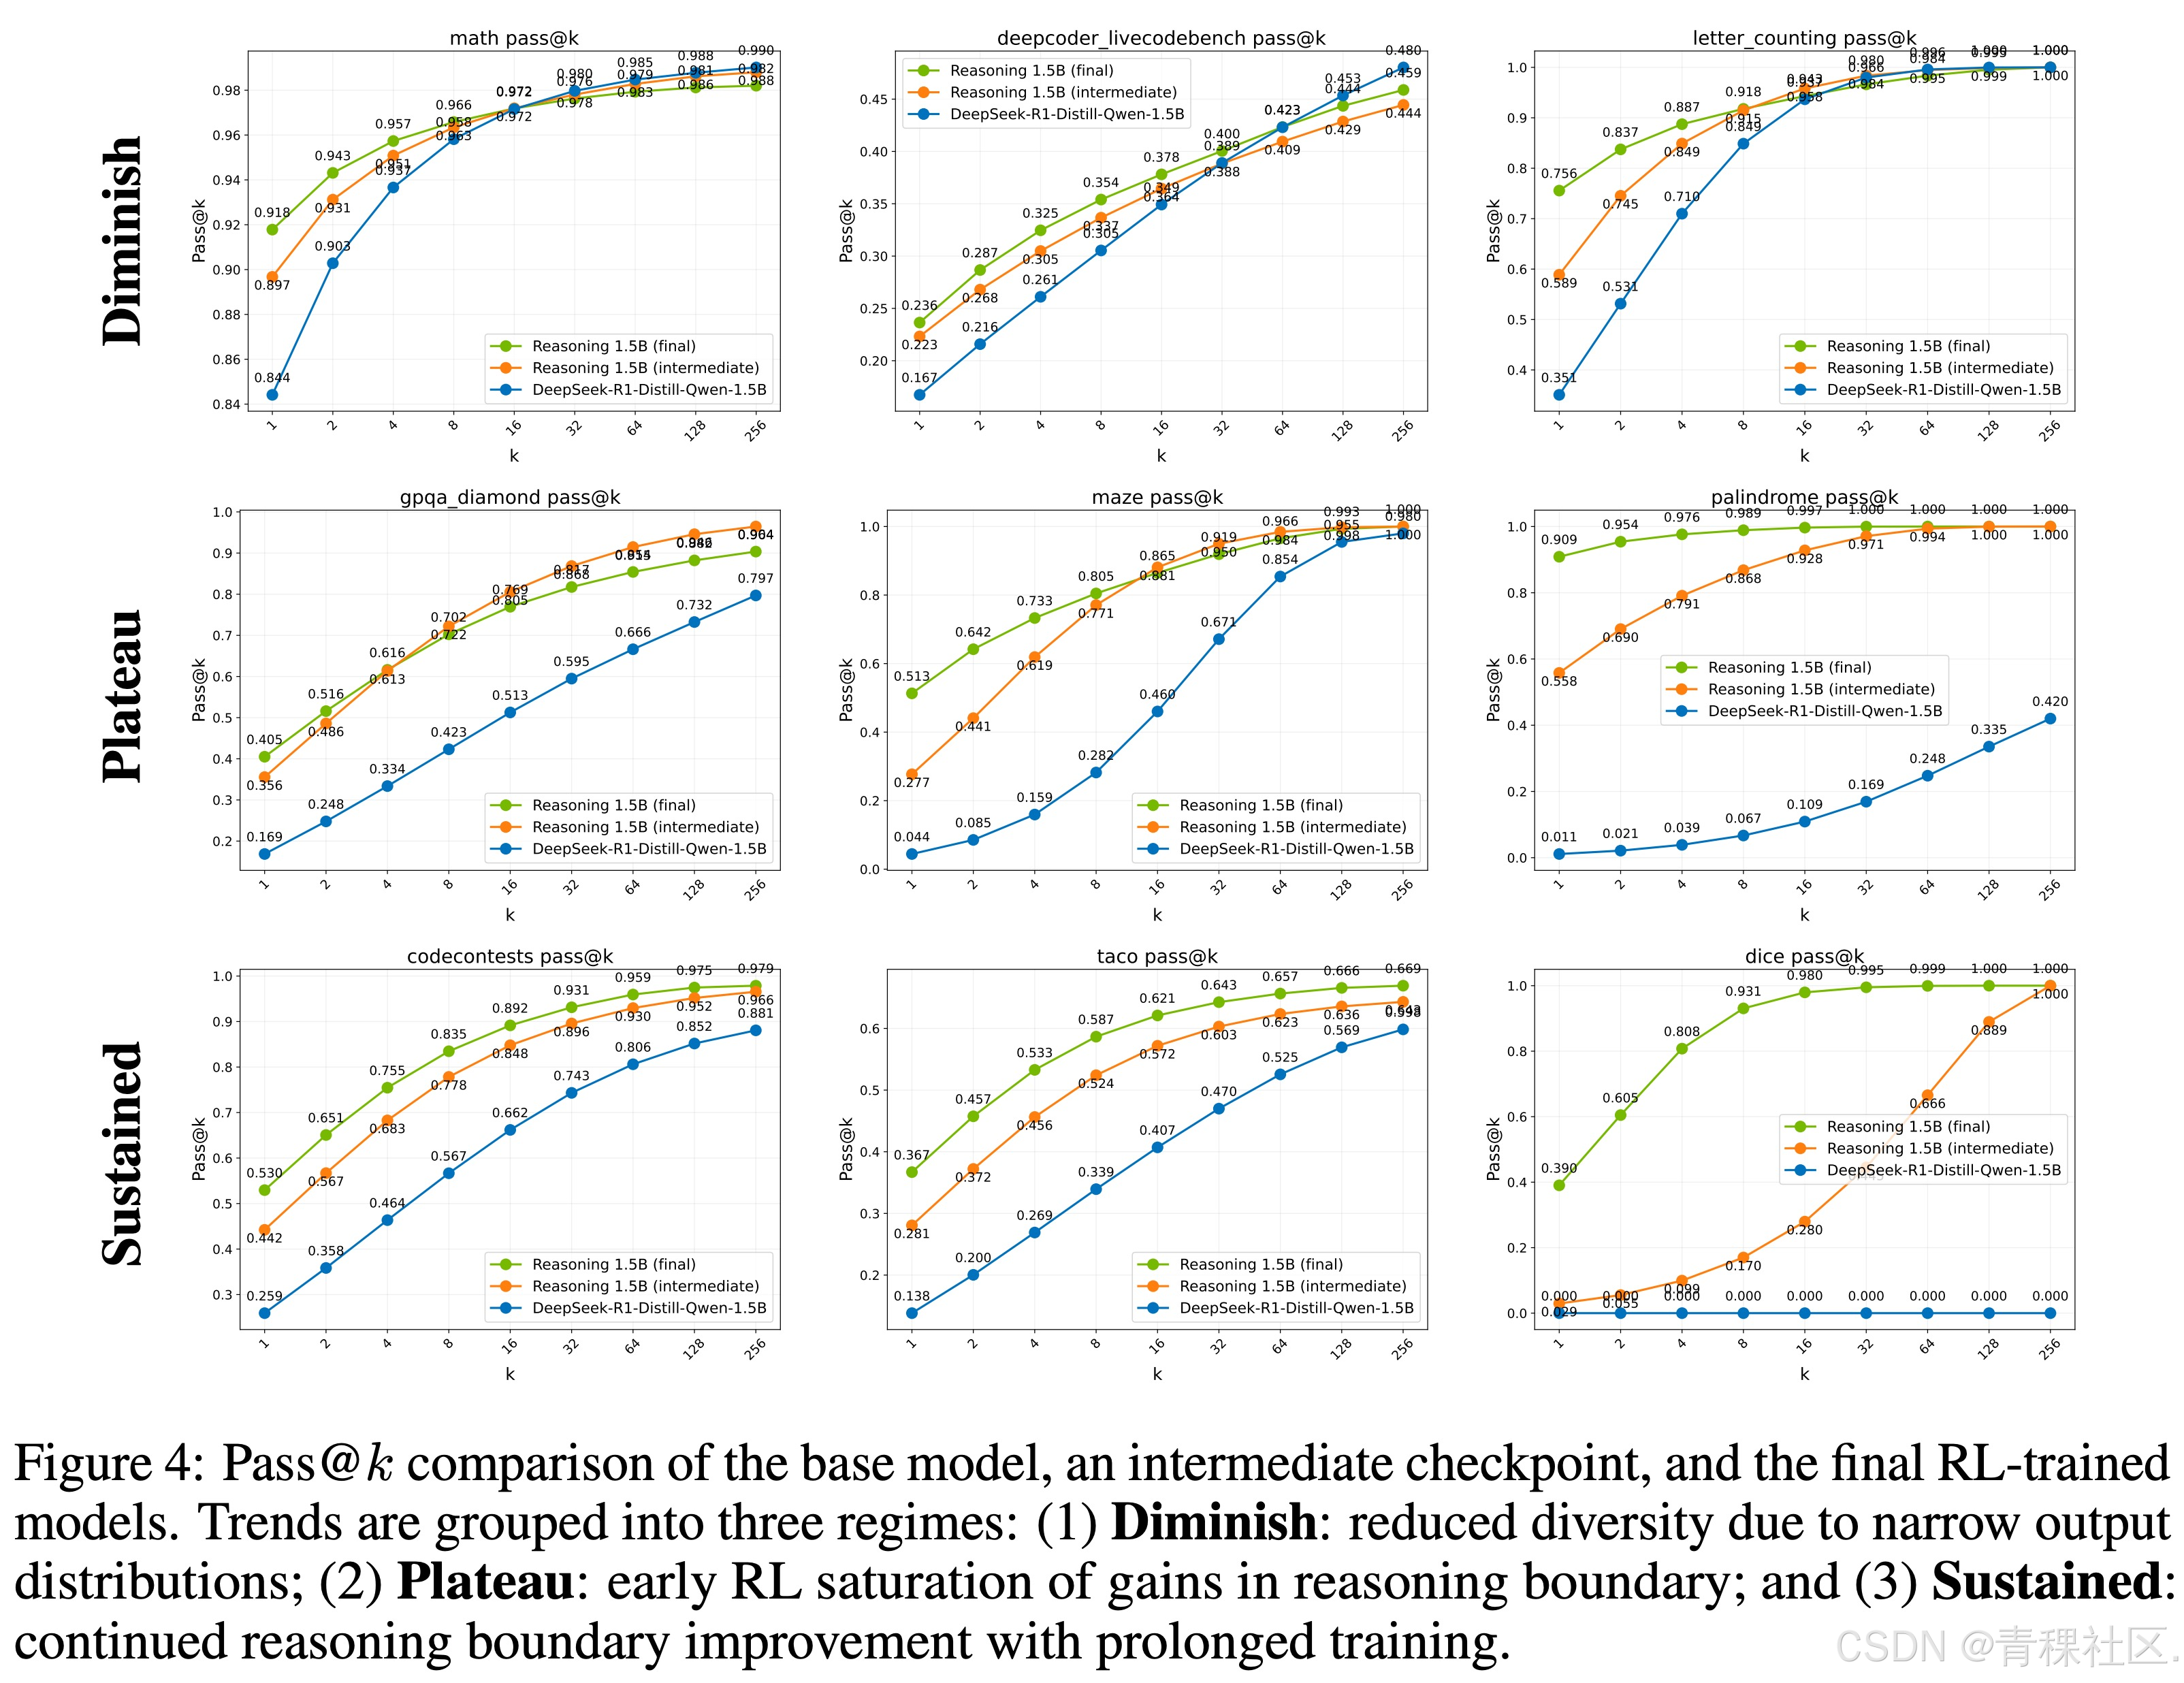
我们发现 RL 模型能解出 base model 无论怎么 sampling 都完全答不出的题,甚至做到 pass rate 100%。这不是随机波动,而是新能力的诞生。

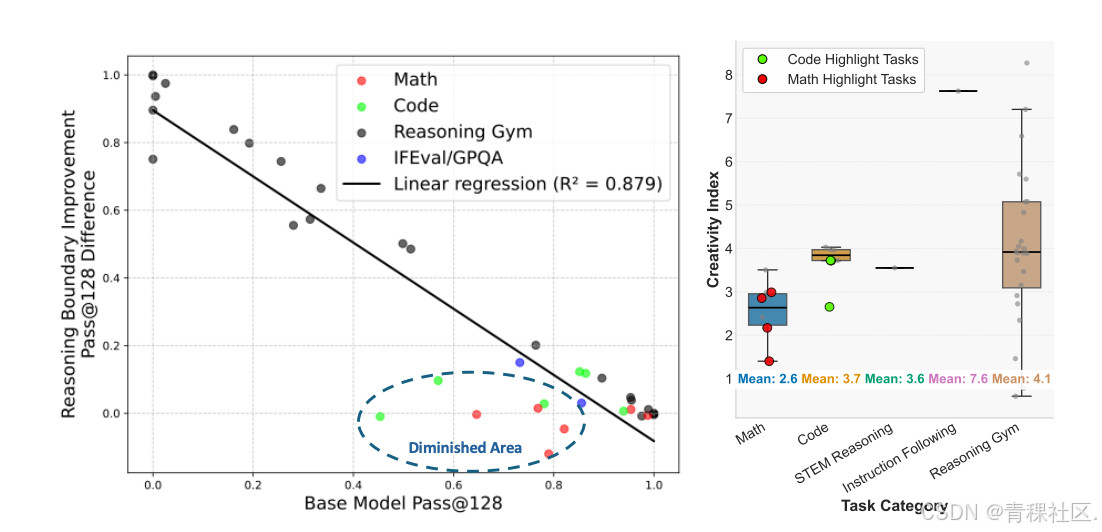
我们还用 Creativity Index 量化了“新解法”的创意程度,发现训练越久,模型“跳出预训练语料”的能力越强,推理路径越来越有创造性。
在这里插入图片描述

此外,强化学习的效果与基础模型的初始表现呈负相关关系:初始 pass@k 较低的任务,在推理边界扩展方面的提升最大;而在诸如数学和代码等高表现领域(其创造力指数较低),推理边界的扩展则较为有限。对于改善幅度较小的任务(即图中显示为“Diminished Area”的部分),基础模型通常具有较低的创造力指数,这表明这些任务可能已在预训练数据中得到了充分覆盖,因此在推理边界上的扩展潜力有限。
在这里插入图片描述

我们希望这项工作为“如何通过RL真正提升大模型的推理能力”提供一个新的思考方向,欢迎大家交流!

java零基础从入门到精通(全) 目录前言1. 入门知识1.1 java体系1.2 JDK/JRE/JVM区别1.3 编译与运行理解1.4 类体函数细节2. 标识符 前言 java优势 健壮性(JVM(C++语言写的一个虚拟的计算机)、GC(垃圾回收机制)) 多线程并发 可移植性/跨平台 1. 入门知识 1.1 java体系 JavaSE:标准版 JavaEE:企业版 JavaME:微型版 1.2 JDK/JRE/JVM区别 JVM是不能独立安装的。 JRE和JDK都是可以独立安装的 层层嵌套,jvm包括jdk,jdk包括jre 阅读详情

相关推荐

CMMI AIM 人工智能成熟度框架:31个过程域的157项AI实践集成

CMMI AIM人工智能成熟度框架为企业提供了系统化管理AI项目全生命周期的解决方案,包含31个过程域的157项AI实践。该框架通过四个演进阶段(混沌与风险、结构与凝聚、验证与信任、价值与增长),帮助组织建立可持续的AI能力成长路径,降低项目失败率并提升商业价值。

weixin_42613501的博客 353

【AI论文】ProRL:延长的强化学习扩展了大型语言模型的推理边界

摘要:本研究挑战了强化学习(RL)仅放大语言模型已有能力的观点,提出通过Prolonged RL(ProRL)训练可发现全新推理策略。ProRL方法整合KL散度控制、策略重置和多样化任务,在16,000 GPU小时的训练后,模型在数学、代码等任务上pass@1准确率提升14.7%-54.8%,特别解决了基础模型完全失败的场景。研究表明RL能持续扩展推理边界,其效果取决于基础模型能力和训练时长。虽然存在计算成本高等局限,但研究证明了RL对语言模型推理能力的有意义提升,为后续研究奠定基础。模型权重已开源。

m0_66899341的博客 1084

电子结构设计(EMD)十年知识总结

客官,你的面相是做结构设计的奇才~1. 材料选择【一出手的0.1s就败了】2. 钣金件设计【折来折去有啥难】3. 塑胶件设计【看着好复杂】4. 型材件设计【凭啥不让我设计】5. 电子结构(PCBA)设计【静电肿么要我背锅】6. 包装设计【要的就是金玉其外,败絮其中】7. 外观(工业)设计【好不好看,谁说了算】8. 标签设计【】9. 标准件选择【一个螺丝难倒英雄汉/提起螺丝,英雄气短】10. 计算仿...

wfeng86的博客 1569

OpenAI突然推出ChatGPT代理:AI正式转向level 3

来源:AI寒武纪OpenAI 今日宣布推出一项名为 "Tasks" 的全新代理功能(目前处于 Beta 测试阶段),它将彻底改变你与 ChatGPT 的互动方式,让 AI 真正成为你的未来助手"Tasks" 功能允许用户安排 ChatGPT 在未来特定时间执行任务,无论是单次提醒还是重复性操作,你只需告诉 ChatGPT 你需要做什么以及何时执行,它便会自动帮你完成想象一下这样的场景:• 你想每...

人工智能学家 689

Keysight ADS新手必看:3分钟搞定TDR模拟的保姆级教程(附差分信号设置技巧)

本文为Keysight ADS新手提供TDR模拟的保姆级教程,详细介绍了从基础环境准备到差分信号设置的全流程。通过内置模板调用、待测器件连接和仿真结果解读,帮助用户快速掌握TDR模拟技术,特别包含差分信号配置技巧,提升信号完整性分析效率。

weixin_30872157的博客 197

IEEE 754浮点数与十六进制转换:从原理到实战避坑指南

在计算机系统中,数据的二进制表示与内存布局是底层开发的核心基础。IEEE 754标准定义了浮点数在内存中的精确格式,包括符号位、指数位和尾数位的分工,以及零、无穷大和NaN等特殊值的编码。理解这一原理对于处理原始字节流至关重要,尤其是在涉及跨平台或跨设备通信时。其技术价值在于,它能帮助开发者从根本上解决数据解析错误、通信协议不一致以及程序调试中的“灵异”问题。在嵌入式开发、网络通信(如Modbus协议)和固件解析等应用场景中,浮点数与十六进制的转换是高频操作。然而,字节序(大端/小端)是转换过程中最常见的“

weixin_33835103的博客 430

RL并非万能药:CMU 新论文揭秘大模型推理能力的真正来源

这种分歧的根源在于,现代大模型的预训练数据(数万亿 token)是一个巨大的“黑盒”,我们根本不知道模型在预训练阶段到底见过什么,因此无法判断 RL 后的表现是“回忆”还是“创新”。实验极其精彩:研究者在预训练中放入了 99.9% 的“情境 A”(如动物园),通过控制“情境 B”(如学校)的混入比例(0%, 0.1%, 1%, 10%),观察 RL 后的效果。可以看到,深蓝色的线(Light RL)在左侧图(边界任务)表现最好,而棕色的线(Heavy RL)在右侧图(极难任务)表现最优。

zenRRan的博客 906

SimpleFOC STM32实战:基于F103与HAL库,剖析速度环与电流环的协同控制

本文详细介绍了基于STM32F103与HAL库的SimpleFOC实战应用,重点剖析速度闭环控制与电流环的协同工作原理。通过开发环境搭建、参数调试技巧及性能优化方案,帮助开发者高效实现无刷电机精准控制,适用于机器人、无人机等高精度应用场景。

weixin_29170327的博客 476

【文献整理】基于深度强化学习的知识图谱推理研究

目录DeepPath背景core贡献 文献整理基于综述论文:基于深度强化学习的知识推理研究进展综述_宋浩楠,赵刚,孙若莹 文中对知识图谱推理进行如下分类: 基于逻辑的推理方法[23-31]主要是通过一阶谓词逻辑(first order logic)、描述逻辑(description logic)以及规则等推理出新的知识。该类方法的规则获取难度大,推理能力受限; 基于表示学习的推理方法[32-42]主要是利用知识表示学习模型,将知识图谱中的实体和关系映射到低维向量空间,并对知识图谱的低维向量表示进行计算来实

锵锵锵锵蒋的博客 2408

瑞芯微rv1126 rtsp+mpp+rga取流

瑞芯微rv1109 rtsp+mpp+rga取流

ZuoSeDiao的博客 6339

基于STM32L4XX、HAL库的ICM-42607-P姿态传感器驱动程序设计

/ 转换为dps(±1000dps量程)float accel_x = sensor_data.accel_x * (8.0f / 32768.0f);// 转换为g值(±8g量程)#define ICM42607_I2C_ADDR 0x68 << 1 // I2C地址(SA0=0)= 0x40) { // ICM-42607的WHO_AM_I值为0x40。// 读取传感器数据。

zhusl6688的博客 835

涉及AI-Agent、大模型过度思考、多模态后训练、测试时扩展等热门研究

紧跟技术发展趋势,快速了解大模型最新动态。、金融CoT推理基准、、图推理归因分析、长文本推理能力提升、、大模型**「表格问答能力提升」**等热门研究。大型语言模型(LLMs)在众多任务上表现接近人类且能进行通用对话,但AI Agent系统多是让语言模型重复执行少量特定任务,变化较少。本文作者提出,并且在需要通用对话能力时,异构代理系统(调用多种不同模型的代理)是自然选择,还讨论了SLMs在代理型系统采用的潜在障碍并概述了从LLM到SLM代理的通用转换算法。

z551646的博客 941

4、文化遗产数字记录的伦理框架构建

本文探讨了在数字技术快速发展的背景下,如何构建一个伦理框架以指导文化遗产的数字记录工作。文章分析了遗产保护的重要性以及当前面临的挑战,包括气候变化、全球化和技术变革等。同时,结合国际古迹遗址理事会(ICOMOS)的伦理原则和加拿大遗产专业人员协会(CAHP)的行为准则,提出了六个核心伦理类别,并讨论了其在实践中的应用。文章强调,伦理框架不仅有助于提高数字记录的质量和可持续性,还能促进专家合作、保护社区利益并确保数字遗产的长期可访问性。未来需要持续完善这一框架,以应对不断变化的技术和社会环境带来的新挑战。

7h6j5k4l3的博客 96

一起来聊聊:强化学习是否真的能提升大模型的推理能力?

摘要: 7月12日10点,英伟达研究员刁诗哲将在青稞Talk第62期直播分享其团队提出的ProRL框架,探讨如何通过长期强化学习提升大模型的推理能力。研究提出多样化奖励任务、改进算法组合(GRPO+DAPO)及KL正则化等策略,突破传统RL训练的局限性。刁诗哲在NVIDIA从事大模型与强化学习研究,发表多篇顶会论文。直播将解析ProRL的理论框架与实验效果,详情可访问青稞Talk主页或论文arXiv链接。

青年AI研究员idea加油站,AI开发者的新能源充电桩。 349

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

Nemotron-Research-Reasoning-Qwen-1.5B论文速读:长期强化学习拓展了大型语言模型的推理边界

长期强化学习拓展了大型语言模型的推理边界

直达开源前线,冲冲冲! 1294

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

自进化智能体:智能体优化器与智能体强化学习落地架构 | 专题报告

NVIDIA Research张少坤围绕自进化智能体展开分享,指出其具备递归自我优化、自主环境交互学习两大核心特质。报告介绍两项核心工作:一是Agent Optimizer,无需微调基础模型,让智能体自主迭代优化工具、提示词等运行框架(Harness),低成本实现性能提升,但存在数据依赖外部数据集的局限;二是ProRL Agent V2(Polar)解耦式强化学习架构,采用异步流水线调度CPU/GPU资源,通过轨迹合并、梯度掩码处理交互数据,在SWE-Bench数据集验证效果显著。

m0_59012280的博客 362

【论文速递】2025年第23周(Jun-01-07)(Robotics/Embodied AI/LLM)

我们探讨了一种通过自我反思和强化学习来改善大语言模型的性能的方法。通过激励模型在错误地回答时产生更好的自我反射,我们证明了模型解决复杂的能力,即使生成合成数据是不可行的,并且只有二进制反馈,也可以增强可验证的任务。我们的框架分为两个阶段:首先,在未完成一项任务后,该模型会产生自我反射的评论,以分析其先前的尝试;其次,该模型在上下文中以自我反射为任务进行了另一次尝试。如果随后的尝试成功,则会奖励在自我反思阶段产生的令牌。

淋曦的进击手记 1492

Claude Code Game Studios 原型隔离指南:/prototype 与 /playtest-report 如何让抛弃式代码远离生产环境

Claude Code Game Studios 是一个把 Claude Code 变成"完整游戏开发工作室"的开源项目,内置 49 个 AI 智能体和 72 个工作流技能。本文重点讲解其中两个关键技能:`/prototype` 抛弃式原型工作流与 `/playtest-report` 结构化试玩报告——它们通过目录隔离、强制文件头、规则引擎三重机制,确保原型代码永远不会污染正式代码库。 ##

gitblog_07904的博客 400

ProRL:基于长期强化学习让1.5B小模型推理能力超越7B大模型

这个研究挑战了强化学习仅能放大现有模型输出能力的传统观点,通过实验证明长期强化学习训练(ProRL)能够使基础模型发现全新的推理策略。

deephub 4985

RL训练像点外卖?ProRL底层逻辑拆解(非常详细),从入门到精通看这篇!

一句话讲清楚👉🏻** NVIDIA提出ProRL Agent,把多轮LLM Agent的RL训练中「轨迹生成(Rollout)」这一步从训练框架中彻底剥离出来,变成一个独立的HTTP服务,训练侧只需发HTTP请求就能拿到轨迹和奖励信号,不再需要自己管理沙箱、工具调用和评测——SWE-Bench Verified上8B模型性能相比SkyRL-v0提升近2倍。

Python_cocola的博客 364

【干货】RL强化学习如何打造超强推理大模型?

本文是一篇由清华大学与上海人工智能实验室发布的综述,探讨强化学习(RL)如何提升大模型推理能力。研究表明SFT仅使模型"记忆",而RL(特别是RLVR技术)才能实现"泛化"。文章详细分析了LRM推理能力的三大核心要素:可验证奖励、无Critic优化和动态采样,并探讨了RL是在"锐化"还是"发现"能力的学术争议。最后提出了九大未来研究方向,为RL在大型推理模型中的应用指明路径。

m0_74942241的博客 1066

强化学习(RL)原理以及数学模型

强化学习简介 1强化学习与机器学习的关系 2强化学习的一些小案例 强化学习的原理 强化学习的数学原理 1建模的思路 2 马尔可夫过程 3 马尔可夫决策过程MDP 1.强化学习简介 1.1强化学习与机器学习的关系 强化学习是机器学习的一个分支,强调如何基于环境行动,以取得最大化的预期利益,其灵感来源于心理学中的行为主义理论,即有机体如何在环境的奖励或惩罚刺激下,逐步形成对刺

多元思考力 3万+

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 228

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 402

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 248

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 503
上一篇: 一作解读「模型链」新范式:引入因果建模,全新的大模型 Scaling 结构
下一篇: BAGEL一作解读:MoT架构+交错数据+生成理解联合预训练
青稞AI
博客等级 码龄2年 599粉丝 190原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值