Python爬虫实战:爬取微博数据

Python 爬虫实战:微博用户数据爬取 微博作为国内最大的社交媒体平台之一,蕴含着大量有价值的公开数据。本文将详细介绍如何使用 Python 爬取微博数据,包括环境搭建、登录模拟、数据抓取、反爬应对、数据存储等完整流程。 阅读详情

包含编程籽料、学习路线图、爬虫代码、安装包等!【点击领取 100%免费!】

在这里插入图片描述

引言
微博作为中国最大的社交媒体平台之一,拥有海量的用户生成内容。这些数据对于舆情分析、用户行为研究等领域具有重要价值。本文将详细介绍如何使用Python编写爬虫,从微博上抓取数据,并进行简单的数据处理和存储。

1. 环境准备
在开始之前,我们需要确保已经安装了必要的Python库。常用的爬虫库包括:

Requests:用于发送HTTP请求。

BeautifulSoup 或 lxml:用于解析HTML。

Selenium:用于处理动态加载的内容。

Pandas:用于数据处理和存储。

你可以通过以下命令安装这些库:

在这里插入图片描述

2. 分析微博页面结构
在编写爬虫之前,我们需要先分析微博页面的结构。打开微博并查看你想要抓取的内容(如微博正文、发布时间、点赞数等),使用浏览器的开发者工具(F12)查看这些内容的HTML标签和属性。

2.1 静态页面分析
微博的部分内容是通过静态HTML加载的,我们可以直接通过Requests库获取页面内容,并使用BeautifulSoup或lxml解析。

2.2 动态页面分析
微博的许多内容(如评论、点赞数)是通过JavaScript动态加载的。对于这些内容,我们需要使用Selenium来模拟浏览器行为。

3. 编写爬虫
3.1 抓取静态内容
首先,我们尝试抓取微博的静态内容,如微博正文和发布时间。
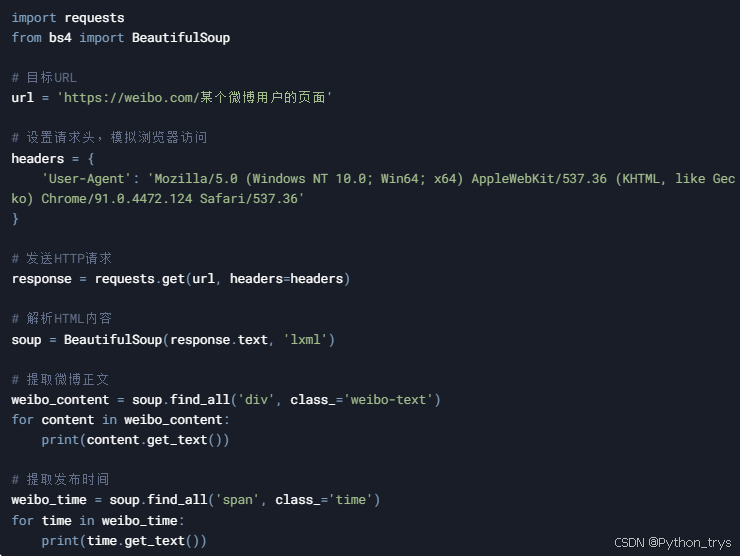
在这里插入图片描述

3.2 抓取动态内容
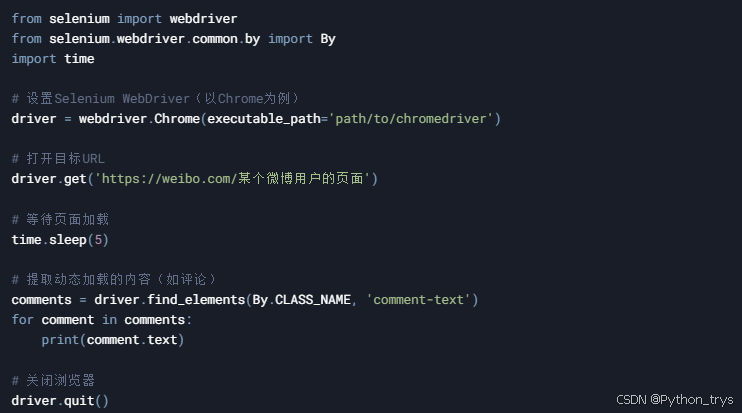
对于动态加载的内容,我们需要使用Selenium。

在这里插入图片描述

4. 数据处理与存储
抓取到的数据通常需要进行清洗和存储。我们可以使用Pandas来处理和存储数据。

4.1 数据清洗
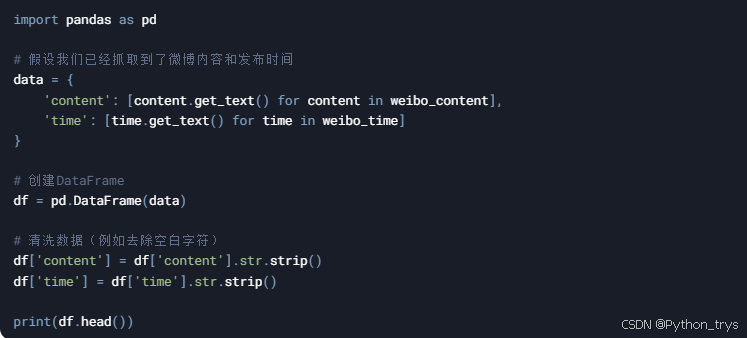
在这里插入图片描述

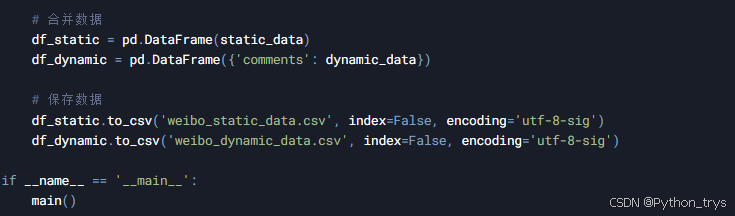
4.2 数据存储

在这里插入图片描述

5. 反爬虫策略
微博和其他网站通常会采取反爬虫措施,如IP封禁、验证码等。为了应对这些措施,我们可以采取以下策略:

设置请求头:模拟浏览器访问。

使用代理IP:避免IP被封禁。

限制请求频率:避免频繁访问导致封禁。

处理验证码:可以使用第三方验证码识别服务。

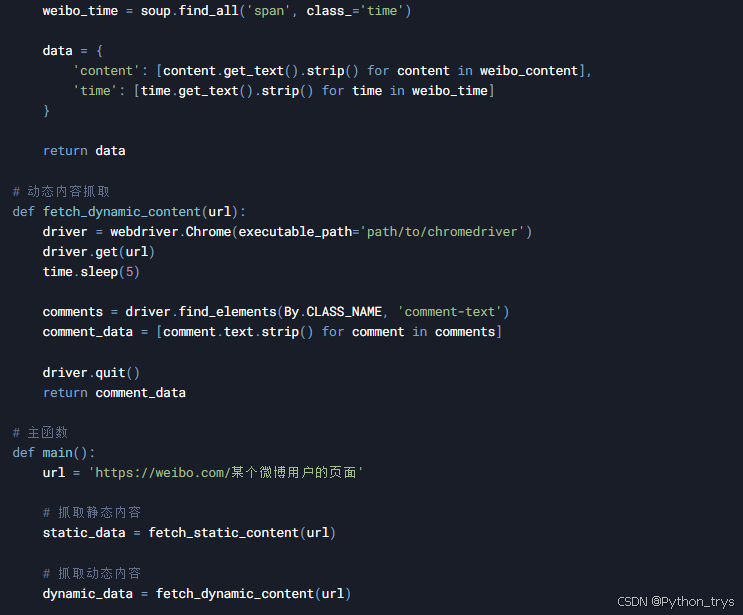
6. 完整代码示例
以下是一个完整的代码示例,结合了静态和动态内容的抓取,以及数据清洗和存储。
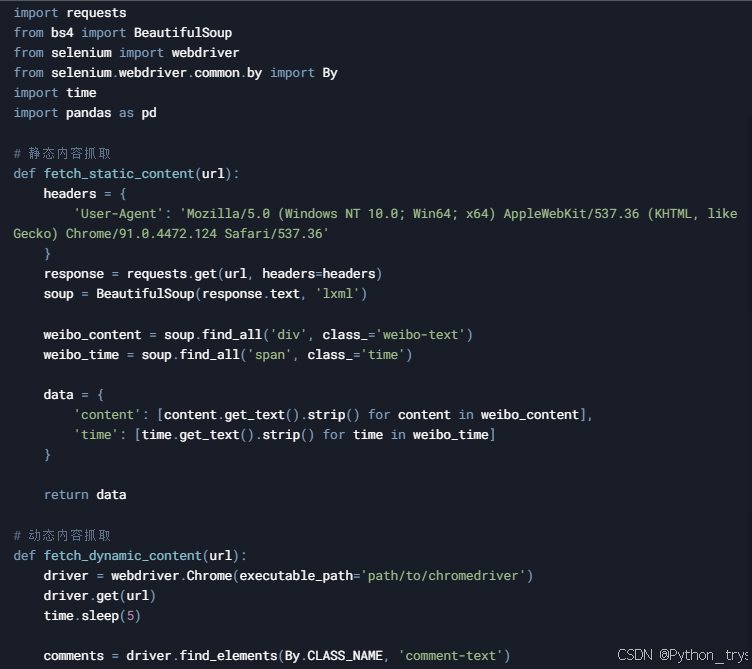
在这里插入图片描述

在这里插入图片描述

在这里插入图片描述

7. 结论
通过本文的介绍,你应该已经掌握了如何使用Python编写爬虫,从微博上抓取静态和动态内容,并进行数据清洗和存储。需要注意的是,爬虫行为应遵守相关法律法规和网站的使用条款,避免对目标网站造成不必要的负担。

最后:
希望你编程学习上不急不躁,按照计划有条不紊推进,把任何一件事做到极致,都是不容易的,加油,努力!相信自己!

文末福利
最后这里免费分享给大家一份Python全套学习资料,希望能帮到那些不满现状,想提升自己却又没有方向的朋友,也可以和我一起来学习交流呀。

包含编程资料、学习路线图、源代码、软件安装包等!【点击这里领取!】
① Python所有方向的学习路线图,清楚各个方向要学什么东西
② 100多节Python课程视频,涵盖必备基础、爬虫和数据分析
③ 100多个Python实战案例,学习不再是只会理论
④ 华为出品独家Python漫画教程,手机也能学习

在这里插入图片描述

Python 爬虫实战:如何爬取微博数据并进行分析 爬虫(Crawler)是指一种自动化程序,它通过网络抓取网页数据。爬虫的应用场景非常广泛,比如搜索引擎、社交媒体数据分析、电商平台数据抓取等。通过爬虫,能够高效地从互联网上收集海量数据并进行分析。微博的开放平台允许开发者通过 API 获取到微博的部分数据。要调用微博的 API,我们需要注册微博开发者账号并创建一个应用。通过应用,我们能够获得App Key和App Secret,用于调用 API 获取数据。通过本篇博客,我们学习了如何使用 Python 编写爬虫爬取微博数据,包括获取用户信息、微博内容和评论。 阅读详情

相关推荐

Python 爬虫实战:爬取微博超话帖子与互动数据

摘要:本文详细介绍基于Python的微博超话数据爬取与分析实战方案。通过Requests+正则表达式技术组合,突破微博Token验证、动态接口加密等反爬机制,实现帖子内容及互动数据的高效抓取。文章包含完整爬虫代码实现,涵盖数据清洗、结构化处理和可视化分析流程,并构建互动热度指标量化传播效果。分析结果显示,微博超话互动呈现长尾分布,学习类内容更易引发用户互动。所有代码可直接运行,输出标准化分析报告,为舆情监测和市场研究提供技术支撑。文中强调合规爬取原则,控制请求频率以避免对平台造成压力。

2503_91057718的博客 2407

微博爬虫一(Selenium)

背景 一般企业做舆情分析,新浪微博是必不可少需要关注的。看看有没有负面消息尽早介入处理。人工查找筛选这些信息显然效率不够高,不够智能; 毕业以后,很少主动去关注母校的一些情况。借学习爬虫的机会,看看母校最近发生了什么。 目标 如下图,准备爬取母校微博账号【南京师范大学】近期发布的内容与互动情况。 爬取的数据包括: 微博发布的时间; 微博的文字内容; 图片信息(URL); 转发数量 ; 评论数量,评论人ID与评论内容; 点赞数量 探索 下拉网页,可以看到微博内容是Ajax动态加载的,细心探

weixin_45042620的博客 1759

Python爬虫实战:基于 Scrapy 框架的微博数据爬取研究

通过采用异常处理、代理池、并发处理和去重操作等策略,有效应对微博平台的反爬机制和爬取过程中可能出现的各种问题,确保数据的完整性和准确性。在学术领域,微博数据可以为社会学、心理学、传播学等学科的研究提供丰富的实证数据。根据不同的错误类型,如 HTTP 错误、DNS 解析错误、超时错误等,记录相应的错误信息,方便开发者了解请求失败的原因,以便进行后续的调试和优化。结合自然语言处理和机器学习技术,对爬取到的微博数据进行更深入的分析和挖掘,如情感分析、主题建模、热点发现等,为用户提供更有价值的信息和决策支持。

ylfhpy的博客 1024

六个步骤学会使用Python爬虫爬取数据(爬虫爬取微博实战)

用python的爬虫爬取数据真的很简单,只要掌握这六步就好,也不复杂。以前还以为爬虫很难,结果一上手,从初学到把东西爬下来,一个小时都不到就解决了。

大模型工程师老蓝的博客 1万+

Python 爬虫实战:爬取微博热搜与用户评论数据

本文系统讲解微博热搜榜单与用户评论数据的爬取技术方案。针对微博热搜榜采用Requests+BeautifulSoup解析静态HTML结构,实现高效爬取;对于动态加载的评论数据,使用Selenium模拟浏览器行为规避反爬机制。详细阐述技术选型、反爬策略、数据清洗及存储方法,提供完整代码实现和输出示例。同时强调合规要求,提示开发者需在遵守平台规则的前提下进行数据采集。该方案为舆情分析和热点研究提供了可落地的技术实现路径。

2503_91057718的博客 1716

《Python爬虫实战:使用异步技术高效爬取微博热搜榜单及热度数据》

本文将详细介绍如何使用Python最新异步技术高效爬取微博热搜榜单及热度数据。我们将从微博热搜页面分析开始,逐步讲解如何构建一个完整的爬虫系统,包括请求模拟、数据解析、反爬应对、数据存储等关键环节。文章将重点介绍aiohttp、BeautifulSoup4、Pyppeteer等现代爬虫技术的应用,并提供完整的代码实现和性能优化建议。通过本文,读者将掌握构建高效微博数据爬虫的核心技术。关键词:Python爬虫、微博热搜、异步爬虫、aiohttp、Pyppeteer、数据采集。

2201_76125261的博客 1095

Python爬虫 | 爬取微博和哔哩哔哩数据

利用python爬取b站和微博的一些数据并进行可视化

天下弈星~的博客 2万+

Python爬虫实战:利用Selenium与API高效爬取微博热搜数据

本文将详细介绍如何使用Python爬取微博热搜数据,涵盖从基础到高级的多种技术方案。我们将首先分析微博热搜的数据结构,然后探讨传统爬虫与API接口两种获取方式,重点介绍Selenium自动化工具的使用,最后讲解数据处理与存储方案。本文提供完整的代码示例,适合不同水平的Python开发者学习和实践。关键词:Python爬虫、微博热搜、Selenium、API、数据处理。

2201_76125261的博客 428

微博数据爬取+分析实战:做点小分析完全OK

从数据爬取、清洗、分析到可视化的全流程都跑了一遍,希望大家享用愉快!使用Selenium自动化爬取目标微博账号的所有微博内容和互动数据数据分析:从多个维度对微博数据进行分析,并生成可视化图表和HTML报告。

多栋花园 5416

Python 爬虫实战:爬取微博热搜榜单实时数据

本文介绍了一个微博热搜监控爬虫的实现方案,主要包含以下内容: 目标分析:微博热搜接口为无需登录的JSON接口,包含热搜关键词、热度值、标签等信息,并分析了反爬机制及应对策略。 环境准备:使用requests、pandas等库实现数据采集和处理,项目结构包含主爬虫脚本、定时监控脚本和数据存储目录。 核心实现: 基础配置:设置日志、请求头等参数 接口请求:实现带重试机制的JSON数据获取 数据解析:提取热搜排名、关键词、热度等关键信息 持久化存储:支持CSV和SQLite两种存储方式 该方案可实现定时采集微博热

u014481728的博客 260

Python爬虫经典案例020:社交媒体爬取——微博热搜数据爬取实战

微博作为中国最大的社交媒体平台之一,每天产生海量的热点话题和用户讨论。微博热搜榜是反映当下社会热点的重要窗口,包含了娱乐、体育、科技、社会等各个领域的热门话题。本文将深入探讨微博热搜数据的爬取方法,包括:微博热搜榜URL: 页面结构特点:微博话题页URL: 页面结构特点:微博详情页URL: 页面结构特点: 四、微博话题详情爬取 五、微博评论爬取 六、微博用户信息爬取 七、完整爬虫系统 八、数据存储与分析 九、反爬策略应对 十、总结 本文详细介绍了微博数据的爬取方法,包括:微博爬虫需

2201_76125261的博客 50

语法最简单的微博通用爬虫weibo_crawler

weibo_crawle可以做轻度的微博数据采集。一、支持爬虫用户信息抓取用户微博抓取(全量/指定时间段)用户社交关系抓取(粉丝/关注)微博评论抓取基于关键词和时间段(粒度到小时)的微博抓...

大邓和他的Python 4374

基于Python的微博热搜榜单爬取与分析:爬虫技术与数据挖掘的实战应用

本文介绍了如何使用Python爬虫技术爬取微博热搜榜单,并对爬取到的数据进行清洗、分析和可视化。通过本文,你不仅可以掌握如何使用爬虫技术获取社交媒体数据,还能学习如何进行情感分析、话题分析等高级数据分析技术。希望通过这些技术,你能够在实际项目中灵活应用,抓取并分析社交媒体中的热门话题,帮助企业进行品牌监控、舆情分析等多种应用。

2201_76125261的博客 825

爬虫实战: Python爬取微博评论数据

在数据科学和网络爬虫的领域中,采集社交媒体的数据是非常普遍且重要的一环。今天,我们以微博为例,介绍如何使用Python爬取评论数据,并将其存储到文件中。本文将从爬取目标、所涉及知识点、步骤分析、爬取结果和完整代码五个模块来详细阐述。通过本文的介绍,我们了解了如何使用Python爬取微博的评论数据,并将数据有效存储到Excel中。在实际应用中,爬虫技术能够为我们的数据分析提供丰富的信息。希望读者能够根据本文的示例,进一步探索和扩展自己的数据爬取项目!如果您有任何问题或心得,欢迎在评论区分享。

2301_78150559的博客 4813

Python爬虫实战:用requests+lxml爬取新浪微博数据

网络爬虫是一种自动化获取网页数据的程序,其核心原理是模拟HTTP请求并解析响应内容。在数据采集领域,Python凭借requests和lxml等库成为主流技术选择,能够高效抓取公开数据并结构化存储。对于社交网络研究、舆情分析等场景,批量获取微博正文、发布时间、互动数等字段具有重要价值。本文以新浪微博为例,详细讲解如何用Python编写爬虫脚本,涵盖请求构造、字段解析、翻页去重及常见问题排查,帮助开发者快速掌握微博数据采集的工程实践。

weixin_33393017的博客 207

Windows系统的Mamba环境配置详细教程(状态空间模型)

causal_conv1d也是安装mamba的依赖必须库。安装完成后,通过pip list可以查看到安装的库。Triton是安装mamba的依赖,需要先安装。上述工作准备好后,按下面步骤安装。直接根据离线文件安装即可。是自己的虚拟环境名字。

2301_77831163的博客 3677

python微博爬虫实战_Python爬虫实战演练:爬取微博大V的评论数据

本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,如有问题请及时联系我们以作处理。以下文章来源于IT共享之家 ,作者: IT共享者理论篇试想一个问题,如果我们要抓取某个微博大V微博的评论数据,应该怎么实现呢?最简单的做法就是找到微博评论数据接口,然后通过改变参数来获取最新数据并保存。首先从微博api寻找抓取评论的接口,如下图所示。但是很不幸,该接口频率受限,抓不了几次就被禁了,还...

weixin_39923806的博客 380

SECS/GSM 测试工具 SecsExpress 的配置与实战应用

本文详细介绍了半导体设备通讯测试工具SecsExpress的配置与实战应用。作为专业的SECS/GSM协议调试工具,它能模拟Host与设备端进行双向测试,帮助工程师快速部署、验证通讯链路,并高效排查与RMS系统或真实设备间的联调问题,是提升半导体工厂设备集成与维护效率的利器。

yhn456789的博客 298

Python爬虫实战演练:爬取微博大V的评论数据

本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,如有问题请及时联系我们以作处理。 以下文章来源于IT共享之家 ,作者: IT共享者 理论篇 试想一个问题,如果我们要抓取某个微博大V微博的评论数据,应该怎么实现呢?最简单的做法就是找到微博评论数据接口,然后通过改变参数来获取最新数据并保存。首先从微博api寻找抓取评论的接口,如下图所示。 但是很不幸,该接口频率受限,抓不了几次就被禁了,还没有开始起飞,就凉凉了。 接下来小编又选择微博的移动端...

Python案例分享,B站视频教程:https://space.bilibili.com/523606542 771

嘉立创EDA vs Altium Designer:新手如何选择?从界面到实战全对比

本文全面对比了嘉立创EDA与Altium Designer(AD)两大PCB设计工具,从设计哲学、界面交互、封装库管理、设计规则引擎、协作功能到成本生态六大维度进行深入分析。嘉立创EDA以极简设计和云端协作为特色,适合学生和创客快速上手;而AD则凭借专业级精准控制,成为高端电子设计的行业标准。通过实战案例和详细对比表格,帮助新手根据项目需求选择合适的EDA工具。

weixin_30296405的博客 721

五段式S型算法笔记

又因为有 v-v0= 0.5jt通式: 所以有 vm-v0= 0.5jtm 所以有4vm-4v0= 2jtm。算法1: v=2vm-v0-0.5*jt+2jt*tm-2jtm*tm。加加速度j 自己设置 已知,vmax自己设置已知;所以有4vm-4v0= 2jtm带入算法1。

qq_36658033的博客 681

python爬取微博评论破亿_Python爬虫实战演练:爬取微博大V的评论数据

本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,如有问题请及时联系我们以作处理。以下文章来源于IT共享之家 ,作者: IT共享者 理论篇 试想一个问题,如果我们要抓取某个微博大V微博的评论数据,应该怎么实现呢?最简单的做法就是找到微博评论数据接口,然后通过改变参数来获取最新数据并保存。首先从微博api寻找抓取评论的接口,如下图所示。 但是很不幸,该接口频率受限,抓不了几次就被禁...

weixin_39836876的博客 230

量化交易零基础入门教程

特点 从零开始教编程。靠谱的量化交易学习资源稀少,且具有不讲编程、代码较难、过多等不适合新手等问题,本教程中则会从零开始教编程,解决量化入门过难过编程门槛这一问题。 量化与编程相结合。本教程不仅会教编程,而且会尽量结合量化情景,减少“我要做量化交易为什么要看这些用来培训程序员的东西”的愤懑。 简易精炼,快速入门。尽量只讲最核心最常用的知识,助你快速摆脱想学习量化却处处陌生不知所措的茫然的新手阶段。 读前说明 文后会有自测与自学,包括一些额外的延伸自学内容以及稍有难度的自测题目。 最最最基础的股票.

JanLEE 2886
上一篇: Python数据分析入门:从数据清洗到可视化!
下一篇: Python自然语言处理常用库汇总:从入门到精通
Python_trys
博客等级 码龄2年 4370粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值