


包含编程籽料、学习路线图、爬虫代码、安装包等!【点击领取】
1. 引言
在当今大数据时代,网络数据采集(Web Scraping)成为数据分析、机器学习、市场研究等领域的重要技术手段。Python凭借其丰富的库和简洁的语法,成为爬虫开发的首选语言。本文将详细介绍Python爬虫的原理、常用库,并通过实战案例帮助读者快速掌握爬虫技术。
2. 爬虫的基本原理
2.1 什么是爬虫?
网络爬虫(Web Crawler),又称网络蜘蛛(Web Spider),是一种自动化程序,用于从互联网上抓取数据。爬虫的核心任务是:
发送HTTP请求 获取网页内容(HTML/JSON)。
解析网页 提取所需数据(XPath、CSS选择器、正则表达式)。
存储数据(CSV、MySQL、MongoDB等)。
2.2 爬虫的工作流程
目标URL:确定要爬取的网站入口(如首页、API接口)。
发送请求:使用HTTP库(如requests)获取网页内容。
解析数据:使用解析库(如BeautifulSoup、lxml)提取结构化数据。
存储数据:存入数据库或文件(如pandas、sqlite3)。
反爬策略:处理验证码、IP封禁等问题(如代理IP、User-Agent轮换)。
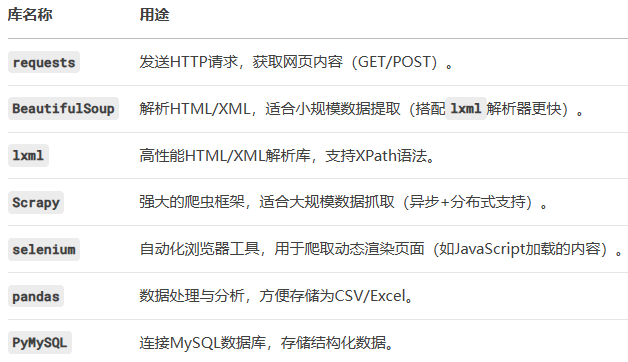
3. Python爬虫常用库
4. 爬虫实战案例
4.1 案例1:爬取豆瓣电影Top250
目标:获取电影名称、评分、评价人数,并存储为CSV。
import requests
from bs4 import BeautifulSoup
import pandas as pd

def scrape_douban_top250():
    headers = {"User-Agent": "Mozilla/5.0"}
    base_url = "https://movie.douban.com/top250"
    movies = []

    for page in range(0, 250, 25):  # 每页25条,共10页
        url = f"{base_url}?start={page}"
        response = requests.get(url, headers=headers)
        soup = BeautifulSoup(response.text, "lxml")

        for item in soup.find_all("div", class_="item"):
            title = item.find("span", class_="title").text
            rating = item.find("span", class_="rating_num").text
            votes = item.find("div", class_="star").find_all("span")[-1].text[:-3]
            movies.append({"title": title, "rating": rating, "votes": votes})

    df = pd.DataFrame(movies)
    df.to_csv("douban_top250.csv", index=False)

scrape_douban_top250()
关键点:
User-Agent 模拟浏览器访问,避免被封。
BeautifulSoup 解析HTML,提取电影信息。
pandas 存储为CSV文件。
4.2 案例2:使用Scrapy爬取新闻网站
目标:爬取新浪新闻标题和链接,并存入MySQL。
安装Scrapy:
pip install scrapy pymysql
创建Scrapy项目:
scrapy startproject news_crawler
cd news_crawler
scrapy genspider sina_news news.sina.com.cn
编写爬虫代码:
# sina_news.py
import scrapy
import pymysql

class SinaNewsSpider(scrapy.Spider):
    name = "sina_news"
    start_urls = ["https://news.sina.com.cn/"]

    def parse(self, response):
        for news in response.css("ul.news-list li"):
            title = news.css("a::text").get()
            link = news.css("a::attr(href)").get()
            if title and link:
                yield {"title": title, "link": link}

    def close(self, reason):
        # 存入MySQL
        conn = pymysql.connect(host="localhost", user="root", password="123456", db="news")
        cursor = conn.cursor()
        for item in self.crawler.stats.get("item_scraped_count", []):
            cursor.execute("INSERT INTO news (title, url) VALUES (%s, %s)", (item["title"], item["link"]))
        conn.commit()
        conn.close()
运行爬虫:
scrapy crawl sina_news -o news.json
关键点:
Scrapy框架:高效异步爬取,适合大规模数据。
MySQL存储:使用PyMySQL持久化数据。
5. 总结
入门爬虫:requests + BeautifulSoup 适合小规模数据抓取。
高级爬虫:Scrapy框架 + 代理IP + 数据库存储,适合企业级应用。
动态页面:selenium 模拟浏览器操作,解决JavaScript渲染问题。
最后:
希望你编程学习上不急不躁,按照计划有条不紊推进,把任何一件事做到极致,都是不容易的,加油,努力!相信自己!
文末福利
最后这里免费分享给大家一份Python全套学习资料,希望能帮到那些不满现状,想提升自己却又没有方向的朋友,也可以和我一起来学习交流呀。
包含编程资料、学习路线图、源代码、软件安装包等!【点击这里】领取!
① Python所有方向的学习路线图,清楚各个方向要学什么东西
② 100多节Python课程视频,涵盖必备基础、爬虫和数据分析
③ 100多个Python实战案例,学习不再是只会理论
④ 华为出品独家Python漫画教程,手机也能学习

 3148


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


