


python爬取微博评论(无重复数据)
- 前言
- 一、整体思路
- 二、获取微博地址
- 1、获取ajax地址2、解析页面中的微博地址3、获取指定用户微博地址
- 三、获取主评论
- 四、获取子评论
- 1、解析子评论2、获取子评论
- 五、主函数调用
- 1、导入相关库2、主函数执行3、结果
- 写在最后
很多人学习python,不知道从何学起。
很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手。
很多已经做案例的人,却不知道如何去学习更加高深的知识。
那么针对这三类人,我给大家提供一个好的学习平台,免费领取视频教程,电子书籍,以及课程的源代码!
QQ群:961562169
Tip:本文仅供学习与交流,切勿用于非法用途!!!
前言
前段时间微博上关于某日记的评论出现了严重的两极分化,出于好奇的我想对其中的评论以及相关用户做一个简单的分析,于是我在网上找了相关的代码,简单的修改了cookies等参数就Run起来了。
既然没报错!! 我很震惊,从未若此畅快过~
随后便分析起来,过了一会就发现:事情并不简单,数据是重复的!!
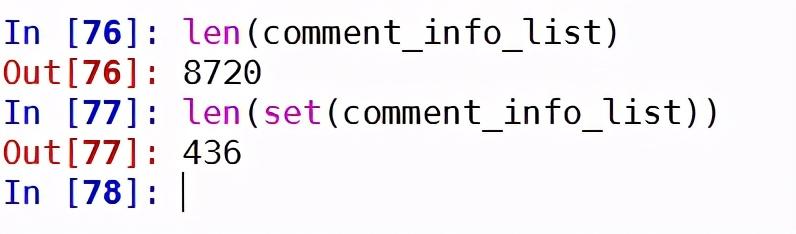
没错,重复率如此之高,令人发指。于是,我开始了我的探索之路~
说明:整体代码还是借鉴了之前大佬的,主要是解决了数据重复的问题,如有侵权还请联系!
一、整体思路
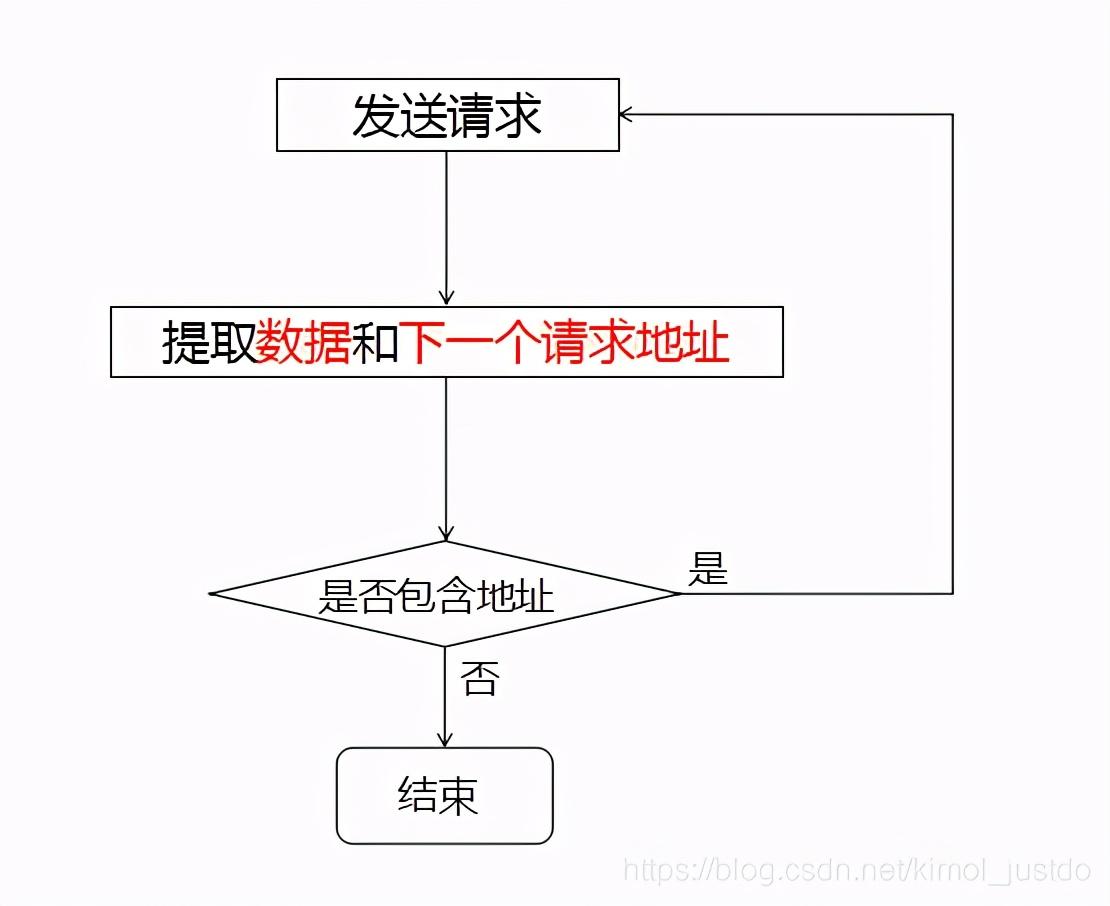
思路也比较清楚,我画了一个极其简单的流程图:
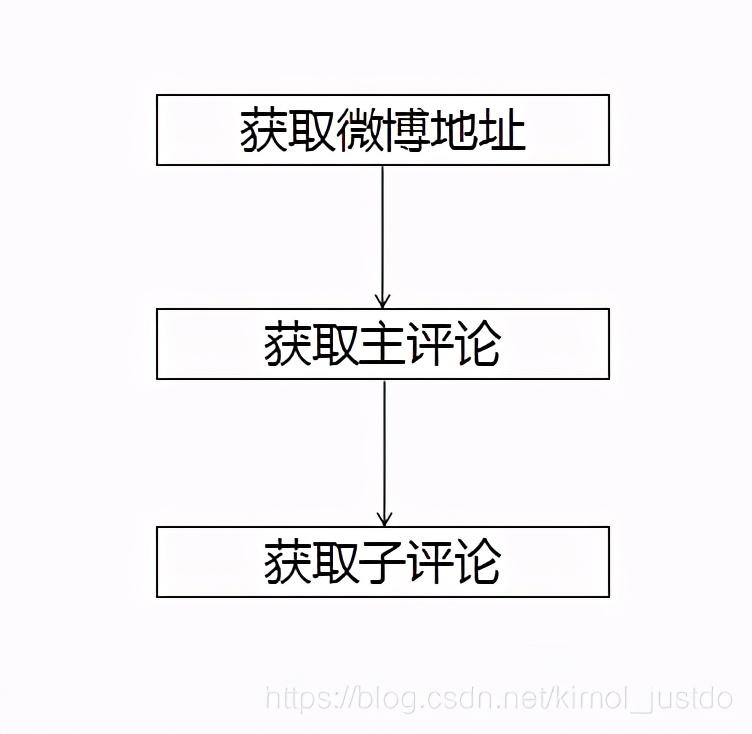
至于这里为什么主评论和子评论要分开获取,这也是解决重复问题的关键,通过测试可以知道直接按照规律修改页面参数或者通过.cn的页面爬取,在到达一定的数量后(大概是几百)就无法得到数据或是出现数据重复。
二、获取微博地址
访问微博用户页面时的请求URL为:
https://weibo.com/xxxxxxxxx?is_search=0&visible=0&is_all=1&is_tag=0&profile_ftype=1&page=1
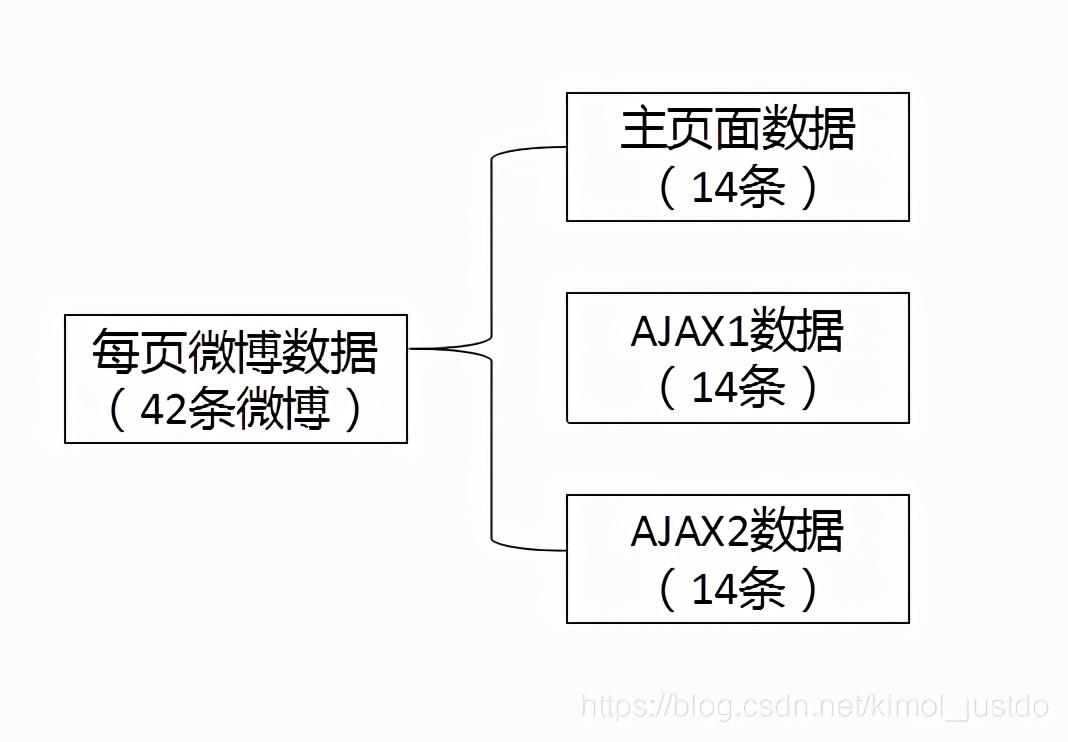
其中通过修改page参数,即可控制页码,但是细心的小伙伴应该发现了,一页的数据除了直接加载的HTML之外,还有两次是通过ajax动态获取的:
start_ajax_url1 = 'https://weibo.com/p/aj/v6/mblog/mbloglist?ajwvr=6&domain=%s&is_all=1&page={0}&pagebar=0&pl_name=Pl_Official_MyProfileFeed__20&id=%s&script_uri=/%s&pre_page={0}'%(domain,page_id,user)
start_ajax_url2 = 'https://weibo.com/p/aj/v6/mblog/mbloglist?ajwvr=6&domain=%s&is_all=1&page={0}&pagebar=1&pl_name=Pl_Official_MyProfileFeed__20&id=%s&script_uri=/%s&pre_page={0}'%(domain,page_id,user)
也就是说,每页数据有三部分组成:
1、获取ajax地址
通过主界面,获取相应的ajax请求地址:
def get_ajax_url(user):
    url = 'https://weibo.com/%s?page=1&is_all=1'%user
    res = requests.get(url, headers=headers,cookies=cookies)
    html  = res.text
    page_id = re.findall("CONFIG\['page_id'\]='(.*?)'",html)[0]
    domain = re.findall("CONFIG\['domain'\]='(.*?)'",html)[0]
    start_ajax_url1 = 'https://weibo.com/p/aj/v6/mblog/mbloglist?ajwvr=6&domain=%s&is_all=1&page={0}&pagebar=0&pl_name=Pl_Official_MyProfileFeed__20&id=%s&script_uri=/%s&pre_page={0}'%(domain,page_id,user)
    start_ajax_url2 = 'https://weibo.com/p/aj/v6/mblog/mbloglist?ajwvr=6&domain=%s&is_all=1&page={0}&pagebar=1&pl_name=Pl_Official_MyProfileFeed__20&id=%s&script_uri=/%s&pre_page={0}'%(domain,page_id,user)
    return start_ajax_url1,start_ajax_url2
123456789
2、解析页面中的微博地址
发送请求后,解析页面中的微博地址(主页面请求或AJAX请求相同):
def parse_home_url(url):
    res = requests.get(url, headers=headers,cookies=cookies)
    response = res.content.decode().replace("\\", "")
    every_id = re.compile('name=(\d+)', re.S).findall(response) # 获取次级页面需要的id
    home_url = []
    for id in every_id:
        base_url = 'https://weibo.com/aj/v6/comment/big?ajwvr=6&id={}&from=singleWeiBo'
        url = base_url.format(id)
        home_url.append(url)
    return home_url
3、获取指定用户微博地址
将上面两个函数整合,得到:
def get_home_url(user,page):
    start_url = 'https://weibo.com/%s?page={}&is_all=1'%user
    start_ajax_url1,start_ajax_url2 = get_ajax_url(user)
    for i in range(page):
        home_url = parse_home_url(start_url.format(i + 1)) # 获取每一页的微博
        ajax_url1 = parse_home_url(start_ajax_url1.format(i + 1)) # ajax加载页面的微博
        ajax_url2 = parse_home_url(start_ajax_url2.format(i + 1)) # ajax第二页加载页面的微博
        all_url = home_url + ajax_url1 + ajax_url2
        print('第%d页解析完成'%(i+1))
    return all_url
参数为用户的ID,以及爬取的页数,返回结果则为每条微博的地址。
三、获取主评论
简单分析请求数据可以知道,获取微博评论的接口为:
https://weibo.com/aj/v6/comment/big?ajwvr=6&id=4498052401861557&root_comment_max_id=185022621492535&root_comment_max_id_type=0&root_comment_ext_param=&page=1&from=singleWeiBo
一个很耀眼的page参数映入眼帘,而且似乎其他参数去掉之后请求也正常,也许你第一反应是写个循环直接获取不就OK了,emmmm,然后你就将陷入数据重复的恐怖原点。似乎root_comment_max_id这个参数也很重要,得想法获得。通过进一步分析可以发现,其实在请求返回的数据中,已经包含了下一步请求的地址,只需要提取出来再继续往下即可:
代码如下:
def parse_comment_info(data_json):
    html = etree.HTML(data_json['data']['html'])
    name = html.xpath("//div[@class='list_li S_line1 clearfix']/div[@class='WB_face W_fl']/a/img/@alt")
    info = html.xpath("//div[@node-type='replywrap']/div[@class='WB_text']/text()")
    info = "".join(info).replace(" ", "").split("\n")
    info.pop(0)
    comment_time = html.xpath("//div[@class='WB_from S_txt2']/text()") # 评论时间
    name_url = html.xpath("//div[@class='WB_face W_fl']/a/@href")
    name_url = ["https:" + i for i in name_url]
    ids = html.xpath("//div[@node-type='root_comment']/@comment_id")
    try:
        next_url = 'https://weibo.com/aj/v6/comment/big?ajwvr=6&from=singleWeiBo&'+html.xpath('/html/body/div/div/div[%d]/@action-data'%(len(name)+1))[0]+'&__rnd='+str(int(time.time()*1000))
    except:
        try:
            next_url = 'https://weibo.com/aj/v6/comment/big?ajwvr=6&from=singleWeiBo&'+html.xpath('/html/body/div/div/a/@action-data')[0]+'&__rnd='+str(int(time.time()*1000))
        except:
            next_url = ''
    comment_info_list = []
    for i in range(len(name)):
        item = {}
        item["id"] = ids[i]
        item["name"] = name[i] # 存储评论人的网名
        item["comment_info"] = info[i][1:] # 存储评论的信息
        item["comment_time"] = comment_time[i] # 存储评论时间
        item["comment_url"] = name_url[i] # 存储评论人的相关主页
        try:
            action_data = html.xpath("/html/body/div/div/div[%d]//a[@action-type='click_more_child_comment_big']/@action-data"%(i+1))[0]
            child_url = 'https://weibo.com/aj/v6/comment/big?ajwvr=6&from=singleWeiBo&' + action_data
            item["child_url"] = child_url
        except:
            item["child_url"] = ''
        comment_info_list.append(item)
    return comment_info_list,next_url
参数为请求的json数据,返回解析后的数据,以及下一个地址,数据格式如下:
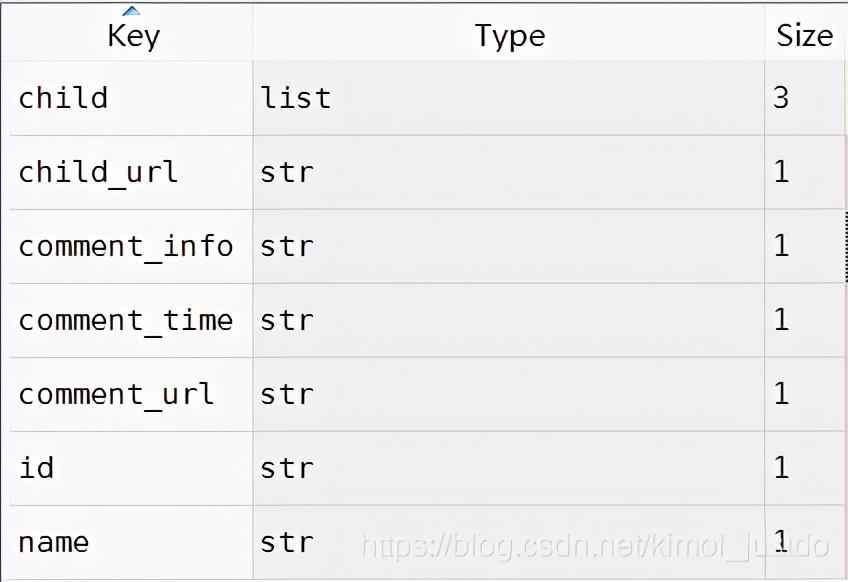
其中child_url即为相对应子评论地址,进一步获取子评论。
四、获取子评论
获取子评论的思路和获取主评论的思路是一致的,当我们获取完所有主评论之后,便遍历结果,当child_url不为空时(即有子评论),则进行请求获取子评论。
1、解析子评论
def parse_comment_info_child(data_json):
    html = etree.HTML(data_json['data']['html'])
    name = html.xpath("//div[@class='list_li S_line1 clearfix']/div/div[1]/a[1]/text()")
    info=html.xpath("//div[@class='list_li S_line1 clearfix']/div/div[1]/text()")
    info = "".join(info).replace(" ", "").split("\n")
    info.pop(0)
    comment_time = html.xpath("//div[@class='WB_from S_txt2']/text()") # 评论时间
    name_url = html.xpath("//div[@class='list_li S_line1 clearfix']/div/div[1]/a[1]/@href")
    name_url = ["https:" + i for i in name_url]
    ids = html.xpath("//div[@class='list_li S_line1 clearfix']/@comment_id")
    try:
        next_url = 'https://weibo.com/aj/v6/comment/big?ajwvr=6&from=singleWeiBo&'+html.xpath('/html/body/div[%d]/div/a/@action-data'%(len(name)+1))[0]+'&__rnd='+str(int(time.time()*1000))
    except:
        next_url = ''
    comment_info_list = []
    for i in range(len(name)):
        item = {}
        item["id"] = ids[i]
        item["name"] = name[i] # 存储评论人的网名
        item["comment_info"] = info[i][1:] # 存储评论的信息
        item["comment_time"] = comment_time[i] # 存储评论时间
        item["comment_url"] = name_url[i] # 存储评论人的相关主页
        comment_info_list.append(item)
    return comment_info_list,next_url
2、获取子评论
整合调用上一个函数,获得相应的子评论:
def get_childcomment(url_child):
    print('开始获取子评论...')
    comment_info_list = []
    res = requests.get(url_child, headers=headers, cookies=cookies)
    data_json = res.json()
    count = data_json['data']['count']
    comment_info,next_url = parse_comment_info_child(data_json)
    comment_info_list.extend(comment_info)
    print('已经获取%d条'%len(comment_info_list))
    while len(comment_info_list) < count:
        if next_url == '':
            break
        res = requests.get(next_url,headers=headers,cookies=cookies)
        data_json = res.json()
        comment_info,next_url = parse_comment_info_child(data_json)
        comment_info_list.extend(comment_info)
        print('已经获取%d条'%len(comment_info_list))
    return comment_info_list
参数为child_url,返回为对应的子评论。
五、主函数调用
1、导入相关库
import re
import time
import json
import urllib
import requests
from lxml import etree
123456
2、主函数执行
if "__main__" == __name__:
    # 设置相应参数
    headers = {
            'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; Win64; x64; rv:75.0) Gecko/20100101 Firefox/75.0',
            'Accept': '*/*',
            'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2',
            'Content-Type': 'application/x-www-form-urlencoded',
            'X-Requested-With': 'XMLHttpRequest',
            'Connection': 'keep-alive',
    }
    cookies = {} # 微博cookies(需要自己获取请求得到)
    userid = ''  # 需要爬取的微博用户ID
    page = 1     # 爬取的页数
    # 开始爬取
    all_urls = get_home_url(userid,page)
    for index in range(len(all_urls)):
        url = all_urls[index]
        print('开始获取第%d个微博主评论...'%(index+1))
        comment_info_list = []
        res = requests.get(url, headers=headers, cookies=cookies)
        data_json = res.json()
        count = data_json['data']['count']
        comment_info,next_url = parse_comment_info(data_json)
        comment_info_list.extend(comment_info)
        print('已经获取%d条'%len(comment_info_list))
        while True:
            if next_url == '':
                break
            res = requests.get(next_url,headers=headers,cookies=cookies)
            data_json = res.json()
            comment_info,next_url = parse_comment_info(data_json)
            comment_info_list.extend(comment_info)
            print('已经获取%d条'%len(comment_info_list))
        for i in range(len(comment_info_list)):
            child_url = comment_info_list[i]['child_url']
            if child_url != '':
                comment_info_list[i]['child'] = get_childcomment(child_url)
            else:
                comment_info_list[i]['child'] = []
        with open('第%d条微博评论.txt'%(index+1),'w') as f:
            f.write(json.dumps(comment_info_list))
3、结果
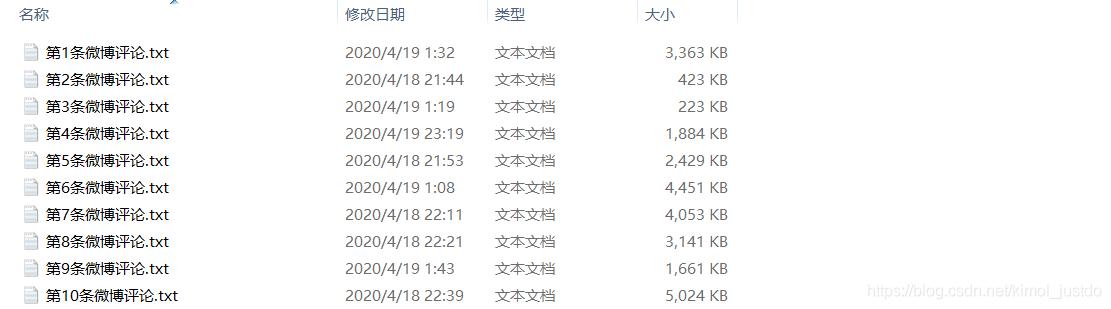
获取了10条微博数据,如下:
写在最后
当然,还有很多不足之处,比如速度不太理想,结构比较混乱。考虑过加入多线程等办法加快速度,不过由于需要登陆,所以有封号风险哦,大家慎重~
最后,感谢各位大大的耐心阅读~
 956


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


