掌握Transformer之注意力为什么有效,零基础入门到精通,收藏这一篇就够了

图解Transformer工作原理(非常详细)零基础入门到精通,收藏这一篇就够了 Transformer 已经成为了前沿人 AI 技术的代名词,尤其是在自然语言处理(NLP)这一领域。那么,是什么使得 Transformer 能够如此高效准确地掌握语言的复杂性呢?让我们一起深入探索 Transformer 架构的核心原理。但在此之前,不妨先看看它的应用场景。谷歌翻译:这个被广泛使用的工具在很大程度上依靠 Transformer 技术,实现了对超过 100 种语言的快速准确翻译。它能够考虑到整个句子的上下文,而非仅仅是单个词语,使得翻译结果更加自然流畅。 阅读详情

01

引言

在过去的几年里,Transformer在 NLP 领域掀起了一场风暴。现在,它们在 NLP 之外的应用中也取得了成功。Transformer结构之所以有如此大的能量,是因为注意力模块。这是因为它能捕捉到序列中每个单词与其他单词之间的关系。

但最重要的问题是,它究竟是如何做到这一点的?在本文中,我们将尝试回答这个问题,并了解它为什么要进行这样的计算。

闲话少说,我们直接开始吧!

02

输入序列如何送入Attention模块

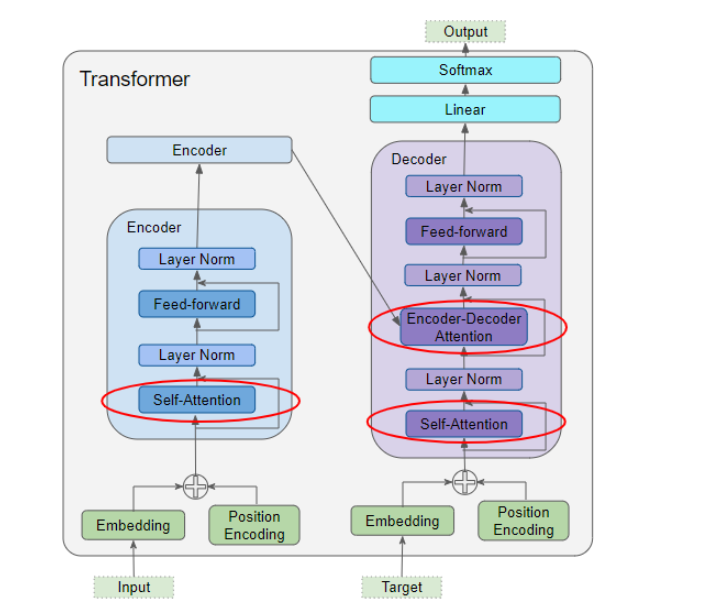
注意力模块存在于编码器stack中的每个编码器以及解码器stack中的每个解码器中。我们先来观察编码器中的Attention模块。
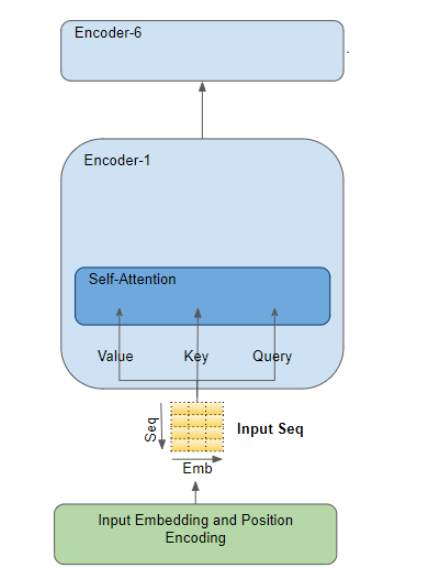
编码器中的Attention

举个例子,假设我们正在处理一个英语到西班牙语的翻译问题,其中一个样本源序列是 “The ball is blue”。目标语序列是 “La bola es azul”。

源序列首先经过嵌入层和位置编码层,该层为序列中的每个单词生成嵌入向量。嵌入向量被传递到编码器,首先到达Attention模块。在Attention模块中,嵌入序列会经过三个线性层,产生三个独立的矩阵–即Query、Key和Value。这三个矩阵用于计算注意力得分。需要牢记的是,这些矩阵的每一行对应源序列中的一个单词。
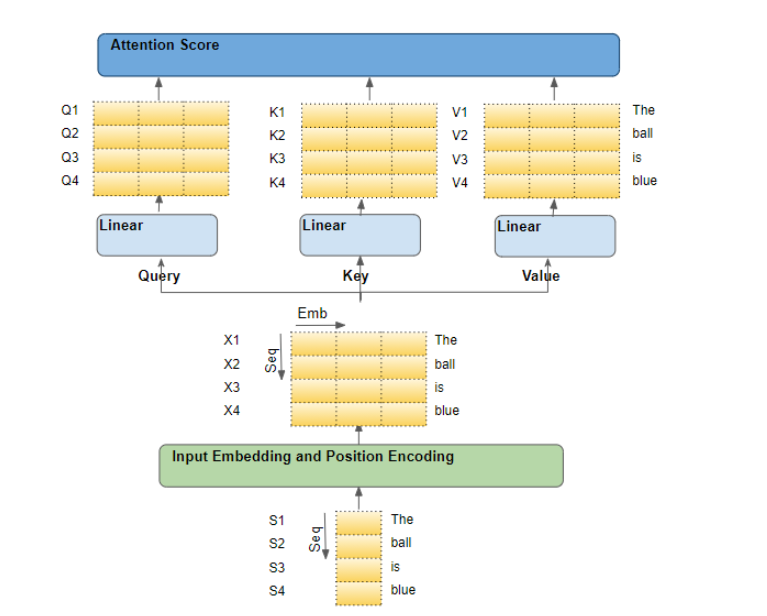
源序列的流程

03

每行都是序列中的一个单词

为了帮助大家理解Attention模块,我们首先从源序列中的单个单词开始,然后沿着它们的路径通过Transformer,我们尤其需要关注Attention模块内部的处理情况。这将有助于我们清楚地看到源序列和目标序列中的每个单词是如何与源序列和目标序列中的其他单词相互作用的。

因此,在我们进行解释时,请将注意力集中在对每个单词进行了哪些运算,以及每个向量是如何映射到原始输入单词的。一般诸如矩阵形状、算术计算的具体细节、多头注意力等许多其他细节与每个单词的走向没有直接关系,我们就不必担心。

因此,为了简化解释和可视化,让我们忽略嵌入向量的维度,只跟踪每个单词的走向。
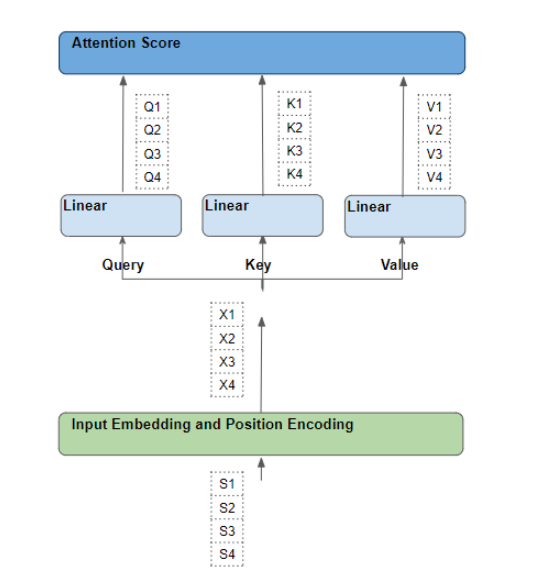
The flow of each word in the source sequence

04

每个单词都经过一系列可学习的变换

观察上图,每一行都是通过一系列转换–嵌入层、位置编码层和线性层–从相应的源序列生成的。所有这些转换操作都是可训练学习的。这意味着,这些操作中使用的权重不是预先确定的,而是通过模型学习的方式产生的。
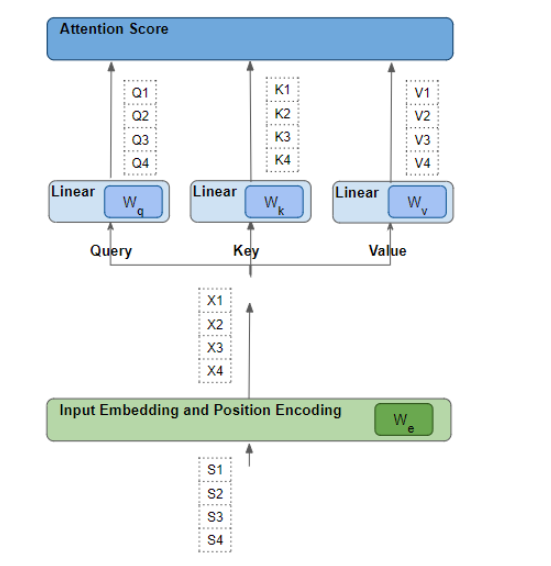
Linear and Embedding weights are learned

关键问题是,Transformer如何确定哪组权重能达到最佳的效果?请记住这一点,因为我们稍后会再讨论这个问题的。

05

注意力得分之Q和K之间的点积

Attention的计算需要经过多个步骤,但在这里,我们只关注线性层和注意力分数。
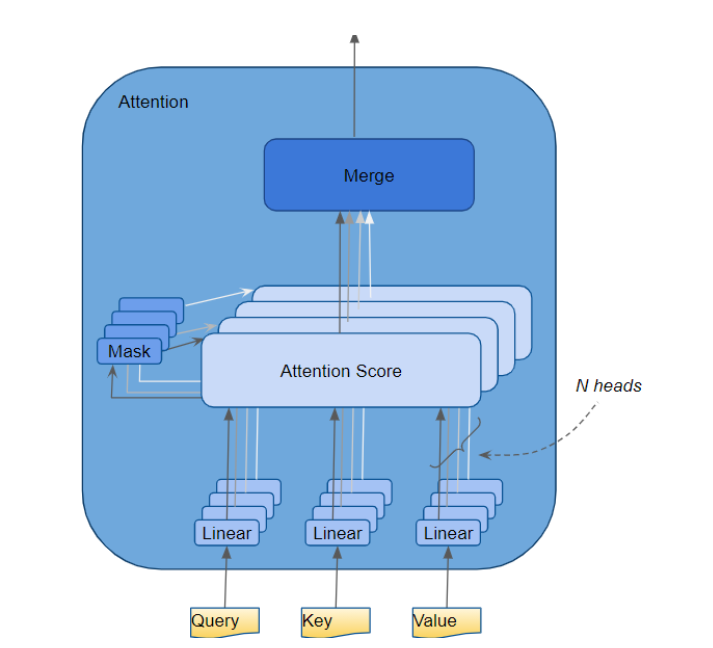
Multi-head attention
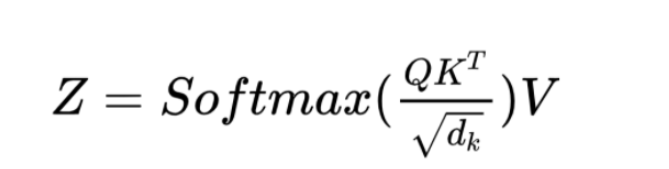
Attention Score calculation

从上述公式中我们可以看到,Attention 的第一步是在Query矩阵和Key矩阵的转置之间进行矩阵乘法(即点积)。看看每个单词会发生什么变化。我们生成一个中间矩阵,其中每个单元格都是两个词之间的矩阵乘法。
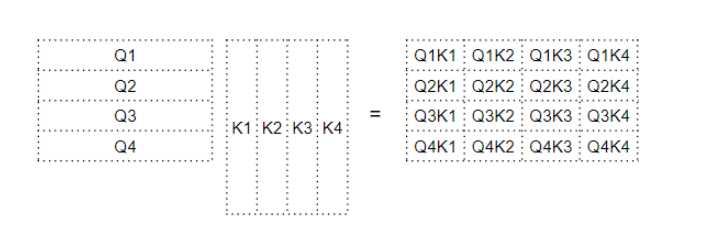
Query矩阵和Key矩阵之间的点积

例如,第四行的每一列都对应于第四个Query与每个Key之间的点积。
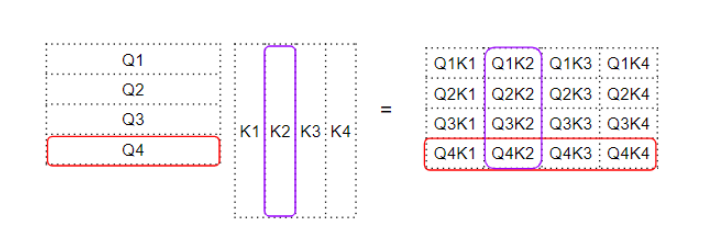
Query矩阵和Key矩阵之间的点积

06

注意力得分之Q-K和V之间的点积

下一步是将上一步中得到的中间矩阵与Value矩阵相乘,得出注意力模块中的注意力分数。
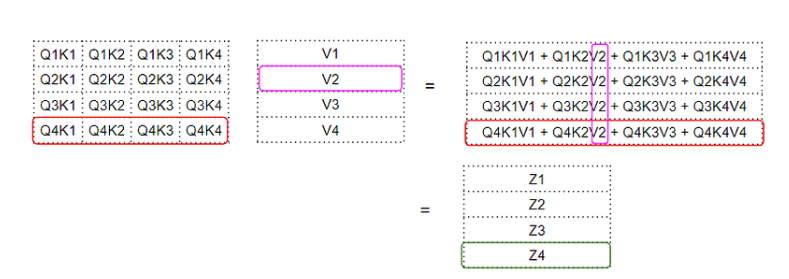
Dot Product between Query-Key and Value matrices

在这里,我们可以看到第四行对应的是第四个Query矩阵与所有其他Key和Value的乘积。这就产生了注意力模块输出的注意力分数向量 Z。

我们可以这样来理解输出注意力得分:对于每个单词来说,它都是Value矩阵中每个词的编码值,并由中间矩阵加权。中间矩阵是该特定词的Query值与所有词的Value值的点积。
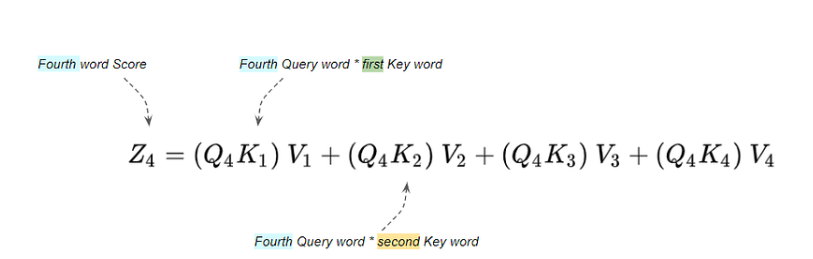
Attention Score is a weighted sum of the Value words

07

Query,Key,Value的作用是什么?

Query可以解释为我们当前需要计算注意力得分的词。Key和Value是我们需要关注的词,即该词与Query的相关程度。
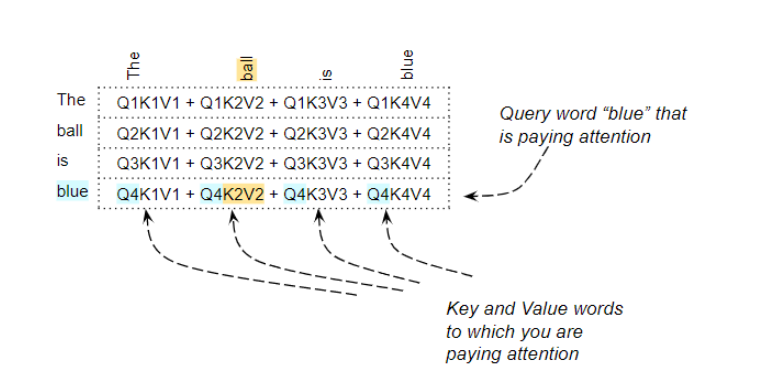
Attention Score for the word “blue” pays attention to every other word

例如,对于 "The ball is blue"这句话来说,"blue"这一行将包含单词"blue"与其他每个单词的Attention得分。这里,"blue "是Query,其他单词是 “Key/Value”。

还有其他一些操作需要执行,如除法和softmax,但在本文中我们可以忽略它们。它们只是改变矩阵中的数值,但不会影响矩阵中每个单词行的位置。

08

点积衡量单词之间的相似度

因此,我们可以看到,注意力分数是通过点积,然后将它们相加,来捕捉特定单词与句子中其他单词之间的一些互动关系。但是矩阵乘法如何帮助Transformer来确定两个词之间的相关性呢?

要理解这一点,请记住Query、Key和Value实际上是具有嵌入维度的向量。让我们来看看这些向量之间的矩阵乘法是如何计算的。
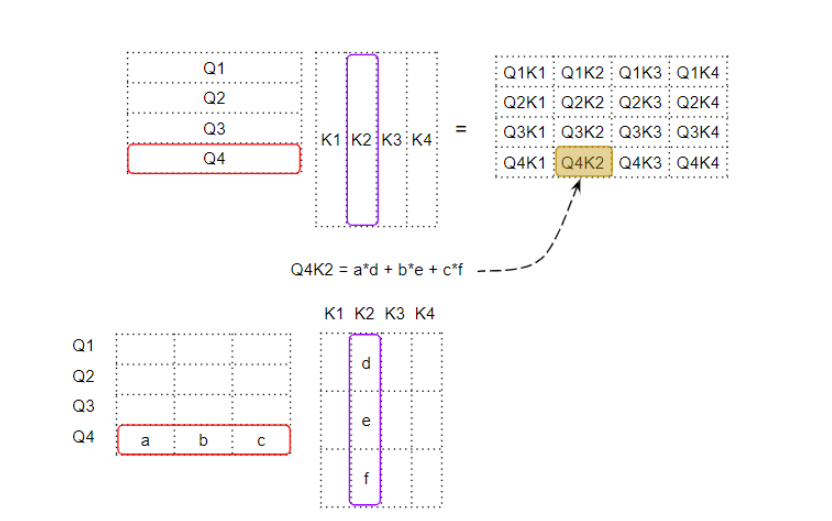
每个单元都是两个词向量的点积

当我们在两个向量之间进行点积操作时,我们是将对应位置上的一对数字相乘,然后求和。

  • 如果两个配对的元素(如上面的 "a "和 “d”)都是正数或都是负数,那么乘积将是正数。乘积将增加最终的求和结果。

  • 如果一个数是正数,另一个数是负数,那么乘积就是负数。乘积将减少最终的求和结果。

  • 如果乘积是正数,则两个数字越大,它们对最终求和的贡献就越大。

这意味着,如果两个向量中相应数字的符号一致,最终的和会更大。

09

Transformer如何学习词语间的相关性

点积的概念同样适用于注意力得分。如果两个词的向量更加一致,那么注意力得分就会更高。那么,我们希望Transformer有什么样的行为呢?

我们希望句子中相互关联的两个词的注意力得分高。而对于两个互不相关的词语,我们则希望其得分较低。

例如,在 "The black cat drank the milk"这个句子中,"milk"与 "drank"非常相关,与 "cat"的相关性可能略低,而与 "black"则无关。我们希望 "milk"和 "drank"产生较高的Attention得分,"milk"和 "cat"产生稍低的分值,而 "milk"和 "black"产生的分值可以忽略不计。

这是我们希望模型通过训练学习产生的输出结果。为此,milk和drank的词向量必须对齐。milk和cat的词向量会有些偏离。而 milk和 black的词向量则会大不相同。

让我们回到我们一直萦绕在脑海中的问题–Transformer是如何计算出哪组权重能达到最佳效果的?

词向量是根据词嵌入和线性层的权重生成的。因此,Transformer可以学习这些嵌入层和线性层权重,从而生成上述所需的词向量。换句话说,它将以这样一种方式学习这些层的权重:如果句子中的两个词彼此相关,那么它们的词向量就会对齐。从而产生更高的注意力得分。而对于互不相关的单词,单词向量将不会对齐,并产生较低的注意力得分。

因此,milk和drank的嵌入会非常一致,并产生较高的注意力得分。在milk和cat的嵌入中,它们会有一些偏离,从而产生稍低的分数,而在milk和black的嵌入中,它们会有很大的不同,从而产生较低的分数。

这就是注意力模块的原理。

10

Transformer中的Attention

Query和Key之间的点积计算出每对词之间的相关性。然后,将该相关性作为一个 “因子”,计算出所有Value的加权总和。加权总和将作为注意力得分的输出。

Transformer结构中有三处使用了Attention:

  • 编码器中的自注意力 --关注源序列自身

  • 解码器中的自注意力 --关注目标序列自身

  • 解码器中的交叉注意力 – 目标序列关注源序列

Attention in the Transformer

在编码器自注意力中,我们计算源句子中每个单词与源句子中其他单词的相关性。这发生在编码器stack中的所有编码器中。

11

解码器中的自注意力

我们刚才在编码器的自我注意力中看到的大部分内容也适用于解码器中的自注意力的计算,只是存在一些微小但重要的区别。
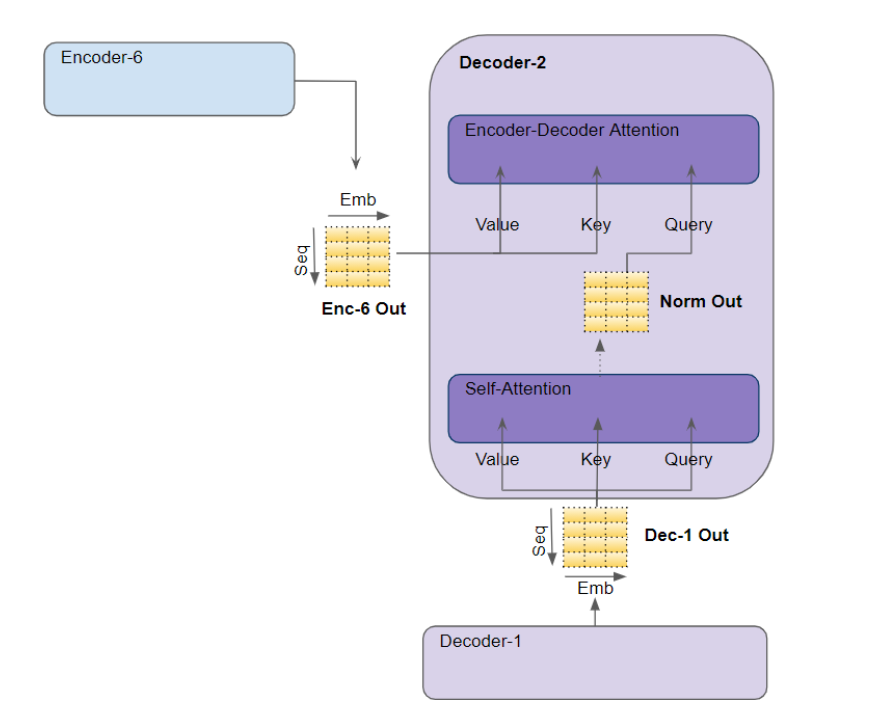
Attention in the Decoder

在解码器自注意力计算过程中,我们计算目标句中每个单词与目标句中其他单词的相关性。
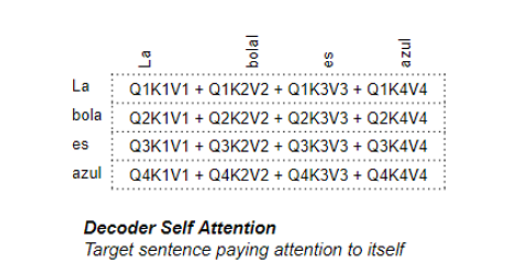
Decoder Self Attention

12

解码器中的交叉注意力

在解码器的交叉注意力的计算过程中,Query来自目标语句,而Key/Value来自源输入语句。这样,它就能计算出目标语句中每个词与源输入语句中每个词的相关性。
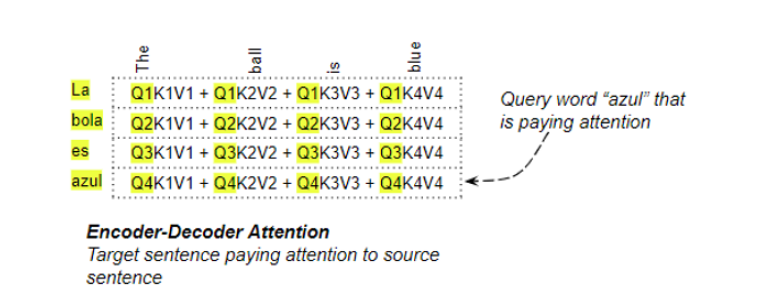
Encoder-Decoder Attention

13

总结

希望这能让大家充分感受到 Transformer设计的优雅。请阅读我的系列文章中的其他 Transformer 文章,深入了解为什么 Transformer 如今已成为众多深度学习应用的首选架构。

AI大模型学习福利

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

四、AI大模型商业化落地方案

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

小白看得懂的 Transformer (图解)超详细,从入门到精通,看这一篇就够了 它们都是有助于计算和理解注意力机制的抽象概念。请继续阅读下文的内容,你就会知道每个向量在计算注意力机制中到底扮演什么样的角色。计算自注意力的第二步是计算得分。假设我们在为这个例子中的第一个词“Thinking”计算自注意力向量,我们需要拿输入句子中的每个单词对“Thinking”打分。这些分数决定了在编码单词“Thinking”的过程中有多重视句子的其它部分。这些分数是通过打分单词(所有输入句子的单词)的键向量与“Thinking”的查询向量相点积来计算的。 阅读详情

相关推荐

汇川PLC和PLC之间ModebusTCP通讯

然后在全局变量中创建相应的变量关联IW和QW的寄存器创建全部变量//AM402作为主站——读H3U(D12-D21)//AM402作为主站——写给H3U(D200-D209)或者使用数组的方式。

panjinliang066333的博客 3万+

注意力就是你所需的一切 - Transformer 最全详细解读

Transformer 模型自2017年由Vaswani等人在论文《Attention is All You Need》中提出以来,已经彻底改变了序列处理任务,尤其是在自然语言处理(NLP)领域。这个模型背后的核心思想是“自注意力机制”,它允许模型在处理序列数据时,同时关注序列中的所有位置,这与以往的循环神经网络(RNN)和卷积神经网络(CNN)形成对比,后者通常会按顺序或局部地处理信息。本文详细介绍了Transformer的全部流程,并对关键问题进行解读。

晨的博客 2782

Zigbee智能开关和单火取电技术

ZigBee智能开关(单火线)是在ZigBee协议基础上开发由单火线供电的开关,它可以控制各种类型负载的开关,如LED灯,白炽灯,荧光灯和钨丝灯等。配合相应的主机用户可以使用手机远程控制它,进而达到控制灯光开关的目的。它具有自组网功能,使用简单方便,给你的居家生活带来无线享受。可应用于家庭,办公,医院和酒店等场合。

danhuoxian的博客 1万+

【大模型】图文详解Transformer为什么如此强大

比如,在句子 “The black cat drank the milk” 中,单词 “milk” 与 “drank” 非常相关,与 “cat” 稍微不那么相关,而与 “black” 无关。我们希望 “milk” 和 “drank” 之间产生高分数,“milk” 和 “cat” 之间产生略低的分数,而 “milk” 和 “black” 之间的分数则接近于零。换句话说,它会以这样的方式学习这些嵌入和权重:如果句子中的两个单词彼此相关,那么它们的向量就会对齐,从而产生较高的注意力分数。

qq_41466440的博客 1360

Hermes Agent Windows安装教程:本地智能体离线部署实战

本地智能体(Local Agent)是一种运行在用户设备端、无需云端依赖即可响应自然语言指令并自动化执行任务的轻量级AI运行时框架。其核心原理基于配置驱动的任务监听与脚本调用机制,通过服务化驻留实现持续响应能力,技术价值在于保障数据隐私、规避API调用限制、适配内网及老旧系统环境。典型应用场景包括财务报表自动整理、科研仪器数据归档、IT资产变更通知等Windows桌面自动化需求。本文聚焦Hermes Agent这一主流开源实现,围绕Windows平台特有的服务注册、权限模型、杀软拦截、中文路径与YAML编码

weixin_34411563的博客 433

爬取国家统计局最近10年年度数据

一、编码流程 1.目标网址:https://data.stats.gov.cn/easyquery.htm?cn=C01 2.编码思路: (1) 解析左侧指标树,实现4级标签定位 (难点:层层嵌套,下一级指标的xpath路径以上一级指标为基础;不是所有二级指标都含有三和四级指标,需要进行判断) (2) 使用selenium webdriver 点选指标,加载出右侧表格数据 (难点:当指标无法在全局页面显示时,需向下拖动滚动条) (3) 解析右侧数据,实现数据存储 3.使用模块: (1) selenium:解

weixin_39645690的博客 4560

掌握Transformer之注意力为什么有效

希望这能让大家充分感受到 Transformer设计的优雅。请阅读我的系列文章中的其他 Transformer 文章,深入了解为什么 Transformer 如今已成为众多深度学习应用的首选架构。

2401_85379281的博客 1101

使用 Simulink + Simscape Electrical 对锂电池储能系统的充放电管理策略进行建模与仿真

摘要:本文详细介绍了基于Simulink的锂电池储能系统充放电管理策略建模与仿真方法。重点阐述了系统结构设计、建模过程(包括锂电池模型、充放电控制器、热管理系统等模块搭建)以及仿真设置。通过分析荷电状态管理、温度控制和功率限制等核心要素,展示了如何实现安全高效的充放电策略。仿真结果可验证系统性能,为优化管理策略提供依据。该方法为新能源存储和智能电网应用提供了实用的仿真分析工具。

amy_mhd的博客 158

Transformers 直观解释——不仅是如何工作,而且为什么工作得这么好

查询Q和键K之间的点积计算每对单词之间的相关性。然后将该相关性用作“因子”来计算所有值V的加权和。该加权和作为注意力分数输出。Transformer 学习嵌入等,从而使彼此相关的单词更加对齐。这是引入三个线性层并为查询、键和值创建三个版本的输入序列的原因之一。这为注意力模块提供了更多参数,它可以学习这些参数来调整词向量的创建。

大鹏的专栏 1081

最大面积验证码通用解法

最大面积验证码、面积验证通用解法

九月镇灵将的博客 1044

STM32F103 -- LIN从机通讯 -- 程序代码 -- 详细讲解版(2万字长文)

主要代码分为3个文件,usart文件是对GPIO端口和串口Lin模式的初始化,lin_buffer文件是对串口环形缓冲区的编写,lin_driver文件是Lin从机模式驱动代码。通过这三个文件的代码便可实现STM32F103的LIN从机通讯。

晴朗luo的博客 1万+

再度拆解Transformer(图解),深挖自注意力、编码器-解码器注意力、注意力分数以及内部结构

Transformer的大脑 多头注意力是Transformer的大脑,请先记住这句话并耐心看完本篇文章,希望看完后你会理解这句话。 Transformer 中如何使用 Attention 注意力机制在 Transformer 中的三个地方发挥作用: 编码器中的自注意力——输入序列关注自身 解码器中的自注意力——目标序列关注自身 Decoder中的Encoder-Decoder-attention——目标序列关注输入序列 注意力输入参数 查询、键和值 注意力层以三个参数的形式获取输入

sinat_19559525的博客 2365

C#【通用方法】字节数组添加、移除、获取的方法类(妙用List<byte>,开发中常用)

C#【通用方法】添加移除字节的方法类(妙用List,开发中常用)

星Yeah 的博客 3358

Transformer原理拆解(非常详细)零基础入门到精通,收藏这一篇就够了

it” 指代的是 “The Animal”,然而,如果改变句子中的一个词,将 “tired” 替换为 “narrow” ,得到的新句子是 “The Animal didn’t cross the street because it was too narrow”,译为:由于街道太窄,动物没有过马路。1. 输入的数据会被送入注意力机制进行处理,注意力机制会给数据里的每一个元素分配不一样的权重,以决定哪些数据更重要,在"注意力机制"(Attention)这个步骤之后,会有一些新的数据生成。

leah126的博客 1673

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Transformer,一个神奇的算法模型 (非常详细)零基础入门到精通,收藏这一篇就够了

Transformer 模型的核心在于其自注意力机制和多头注意力机制,通过这些机制,模型能够有效地理解并处理序列数据中的复杂关系。虽然其公式和实现细节可能略显复杂,但 Transformer 提供了一种强大而灵活的框架来处理各种自然语言处理任务。

Javachichi的博客 1370

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

大模型入门指南(非常详细)零基础入门到精通,收藏这一篇就够了

Part of speech: 词性标注Named entity recognition: 命名实体的识别Co-reference: 共指向性(代指)Basic dependencies: 依存句法–句法理论Sentiment Analysis: 情感分类Opinion Mining:意向挖掘。

Everly_的博客 1254

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

【100个AI核心概念】Transformer模型,零基础入门到精通,收藏这一篇就够 了

Transformer模型由于其独特的架构和强大的性能,在自然语言处理和其他许多领域都产生了深远的影响。它不仅改变了我们处理和理解大规模数据的方式,也推动了人工智能技术的发展和应用。尽管存在一些挑战,但Transformer模型的前景仍然被广泛看好,预计将继续在科技领域发挥重要作用。

leah126的博客 1194

终于把 Transformer 算法搞懂了(非常详细),零基础入门到精通,看这一篇就够了

终于把 Transformer 算法搞懂了(非常详细),零基础入门到精通,看这一篇就够了

Python单行客的博客 1876

【大模型学习】Transformer架构(非常详细)零基础入门到精通,收藏这一篇就够了

目前占主导地位的序列转换模型都是基于包含编码器和解码器的复杂递归或卷积神经网络。表现最好的模型通过注意力机制连接了编码器和解码器。我们提出了一种新的简单网络架构,Transformer,它完全基于自注意机制,不使用任何递归或卷积。在两个机器翻译任务上的实验证明了这些模型具有更高的质量,并且可以并行化,训练时间也显著缩短。我们的模型在WMT 2014英语到德语翻译任务上达到了28.4 BLEU,超过了包括集成方法在内的现有最佳结果,提高了超过2 BLEU。

leah126的博客 2619

100个Transformer面试题,附答案!收藏这一篇就够了!

Transformer是一种用于自然语言处理(NLP)和其他序列到序列(sequence-to-sequence)任务的深度学习模型架构,它在2017年由Vaswani等人首次提出。Transformer架构引入了自注意力机制(self-attention mechanism),这是一个关键的创新,使其在处理序列数据时表现出色。

2401_85373898的博客 2752

一文彻底搞懂Transformer - 总体架构,零基础入门到精通,收藏这一篇就够了

*********:******编码器:**********c****Transformer起源:******Google Brain 翻译团队通过论文《Attention is all you need》提出了一种全新的简单网络架构——****************注意力机制:**************注意力计算Q、K、V:******而设计的。************Transformer总体架构:**********************Transformer核心组件:******

Python_paipai的博客 1605

【非常详细】大模型入门宝典:零基础到精通,收藏我这一篇就够了!

本文系统介绍了自然语言处理(NLP)基础知识与神经网络原理。NLP部分涵盖词性标注、依存句法等基础任务,以及词表示方法(如Word2Vec)和语言模型;神经网络部分详解神经元结构、多层网络设计、激活函数作用及不同输出层配置(如Sigmoid二分类、Softmax多分类)。特别强调了大模型的发展趋势,指出预训练语言模型通过迁移学习实现高效任务适配。最后建议搭建GPU计算环境以支撑深度学习实践,为NLP与神经网络学习提供完整框架。

2401_84495872的博客 1171

理解Transformer的整体架构与关键技术(非常详细),零基础入门到精通,看这一篇就够了

理解Transformer的整体架构与关键技术(非常详细),零基础入门到精通,看这一篇就够了

Java癫疯的博客 1358

掌握Transformer之注意力为什么有效?看完这一篇你就懂了!!

在过去的几年里,Transformer在 NLP 领域掀起了一场风暴。现在,它们在 NLP 之外的应用中也取得了成功。Transformer结构之所以有如此大的能量,是因为注意力模块。这是因为它能捕捉到序列中每个单词与其他单词之间的关系。 但最重要的问题是,它究竟是如何做到这一点的?在本文中,我们将尝试回答这个问题,并了解它为什么要进行这样的计算。

bugyinyin的博客 816
上一篇: 立志投身大模型领域?AI产品经理必读:转行攻略指南,零基础入门到精通,收藏这篇就够了
下一篇: 15 款优秀的终端工具推荐,零基础入门到精通,收藏这篇就够了
网络安全大白
博客等级 码龄5年 7305粉丝 698原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值