


本章我们以ChatGLM3为例,对ChatGLM3-6B模型进行 LORA 高效微调。本章尽量用最简洁的语言及方法对大模型进行微调实际操练。
什么是 LORA 高效微调:
lora微调原理论文:
https://arxiv.org/abs/2106.09685
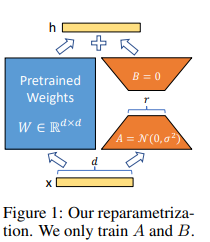
用最简单的语言理解LORA高效微调:
假设我们有一个非常厉害、已经学会很多知识的“专家”(即预训练的大语言模型)。现在我们想让这位专家更好地帮助我们完成一项具体的任务,比如回答医学的专业问题或者回答其它专业的问题。常规的做法是,我们需要给专家把专业知识从头到尾培训一番,让他专门学习这项任务的相关知识。但这样做耗时耗力,而且可能会让专家忘记一些通用的语言常识。
LORA高效微调提供了一种聪明的方法,让我们不用对专家做全面的重新培训,就能让他更好地适应新任务。它是怎么做到的呢?
首先,我们给这位专家配备两本“秘籍”:一本是简化版的“知识点手册”(对应低秩矩阵A),另一本是对应的“解码手册”(对应低秩矩阵B)。这两本手册都很薄,只记录了与新任务最相关的少量关键知识。
然后,我们只教专家学习这两本秘籍的内容,而不去动他原来掌握的那些很多的的通用语言知识。也就是说,我们在微调时,只更新这两本秘籍里的内容,而不去碰专家脑子里其他成千上万的知识点。
最后,当专家要解决新任务时,他会先参考简化版的“知识点手册”,找到与任务相关的关键知识,然后用“解码手册”把这些知识转化为具体的行动指令。这样,专家就可以结合原有的语言知识和新学的相关专业知识,更好地完成新任务。
本次ChatGLM3-6B模型微调硬件及软件配置:
操作系统:ubuntu22.04
CPU: 12核
内存:90G (GPU模式下,不会需要太多内存,16G足够)
GPU: RTX 4090(24GB) * 1
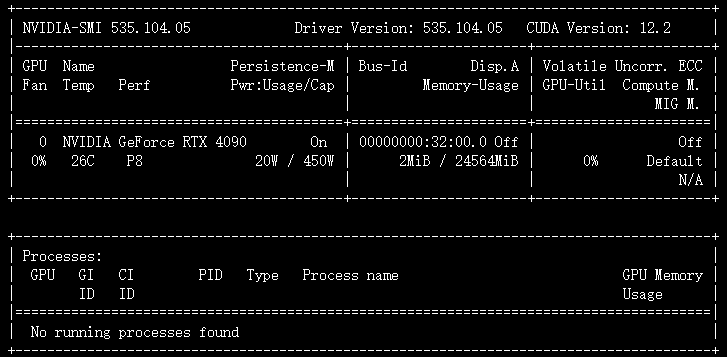
调试及运行环境:Jupyter Notebook
微调步骤如下:
1. ChatGLM3及ChatGLM3-6B模型下载
# 下载ChatGLM3``!git clone https://github.com/THUDM/ChatGLM3`` ``# 依赖下载``!cd ChatGLM3 && pip install -r requirements.txt`` ``# modelscope API下载``!pip install modelscope``# 模型下载``from modelscope import snapshot_download``model_dir = snapshot_download("ZhipuAI/chatglm3-6b", revision = "v1.0.0")
2. 把ChatGLM3-6B模型移动到ChatGLM3文件夹
我们使用modelscope下载的数据集模型文件都在缓存文件夹中,为了方便读取和微调,我们把它移动到ChatGLM3文件夹中。
# 模型文件所在路径``# /root/.cache/modelscope/hub/ZhipuAI/chatglm3-6b``# 复制到ChatGLM3文件夹``!cp -r /root/.cache/modelscope/hub/ZhipuAI/chatglm3-6b /ChatGLM3
注意:
此后所有的文件操作都在ChatGLM3文件夹或子文件夹中。
3. 准备微调数据集
微调数据集必须包括训练数据集、验证数据集;测试数据集可以和验证数据集相同。
因本次训练数据集较少,只做操作展示,故把训练数据集、验证数据集、测试数据集都设置为一样。如果您用于商业数据微调,请自行标注好测试数据集和验证数据集。
训练数据集:(文件名:train.json)
{"content": "你是谁", "summary": "我是写代码的中年人的助手!有什么需要帮助你的吗?"}``{"content": "你好", "summary": "你好,我是写代码的中年人的助手!有什么需要帮助你的吗?"}``{"content": "写代码的中年人", "summary": "一位写代码的中年人正端坐在电脑前。他戴着一副黑框眼镜,镜片后的眼神专注而深邃,犹如一盏明亮的探照灯,照亮了面前复杂繁密的代码世界。他的手指熟练地在键盘上跳跃,宛如一位经验丰富的钢琴家在琴键上演绎无声的交响乐章。岁月在他的额头上刻下了几道皱纹,那是时间赋予他的智慧印记;而他始终保持着对编程技术的热情和执着追求,与时俱进地掌握着最新的编程语言和技术框架。"}``{"content": "你的#公众号", "summary": "请微信搜索写代码的中年人!"}
验证数据集:(文件名:dev.json)
{"content": "你是谁", "summary": "我是写代码的中年人的助手!有什么需要帮助你的吗?"}``{"content": "你好", "summary": "你好,我是写代码的中年人的助手!有什么需要帮助你的吗?"}``{"content": "写代码的中年人", "summary": "一位写代码的中年人正端坐在电脑前。他戴着一副黑框眼镜,镜片后的眼神专注而深邃,犹如一盏明亮的探照灯,照亮了面前复杂繁密的代码世界。他的手指熟练地在键盘上跳跃,宛如一位经验丰富的钢琴家在琴键上演绎无声的交响乐章。岁月在他的额头上刻下了几道皱纹,那是时间赋予他的智慧印记;而他始终保持着对编程技术的热情和执着追求,与时俱进地掌握着最新的编程语言和技术框架。"}``{"content": "你的#公众号", "summary": "请微信搜索写代码的中年人!"}
我们把这两个文集放在如下路径中,文件夹名根据自己喜好定义。
ChatGLM3/finetune_demo/data/ColinData/
4. 微调依赖安装
进入finetune_demo文件夹,执行如下命令安装依赖:
# 安装依赖``!pip install -r requirements.txt
5. 切割数据集(格式转换)
执行下面的代码,对我们准备好的数据集进行格式化。
import json``from typing import Union``from pathlib import Path`` `` ``def _resolve_path(path: Union[str, Path]) -> Path:` `return Path(path).expanduser().resolve()`` `` ``def _mkdir(dir_name: Union[str, Path]):` `dir_name = _resolve_path(dir_name)` `if not dir_name.is_dir():` `dir_name.mkdir(parents=True, exist_ok=False)`` `` ``def convert_adgen(data_dir: Union[str, Path], save_dir: Union[str, Path]):` `def _convert(in_file: Path, out_file: Path):` `_mkdir(out_file.parent)` `with open(in_file, encoding='utf-8') as fin:` `with open(out_file, 'wt', encoding='utf-8') as fout:` `for line in fin:` `dct = json.loads(line)` `sample = {'conversations': [{'role': 'user', 'content': dct['content']},` `{'role': 'assistant', 'content': dct['summary']}]}` `fout.write(json.dumps(sample, ensure_ascii=False) + '\n')`` ` `data_dir = _resolve_path(data_dir)` `save_dir = _resolve_path(save_dir)`` ` `train_file = data_dir / 'train.json'` `if train_file.is_file():` `out_file = save_dir / train_file.relative_to(data_dir)` `_convert(train_file, out_file)`` ` `dev_file = data_dir / 'dev.json'` `if dev_file.is_file():` `out_file = save_dir / dev_file.relative_to(data_dir)` `_convert(dev_file, out_file)`` ``# 其它代码不变,只有此处可以改为自己定义的文件路径``convert_adgen('data/ColinData', 'data/ColinData_fix')``# 此处我们把转换后的数据集放在ColinData_fix文件中。
执行上面代码后,我们在ColinData_fix文件夹得到两个文件,即转后格式的训练集和测试集(train.json和dev.json),格式如下:
{"conversations": [{"role": "user", "content": "你是谁"}, {"role": "assistant", "content": "我是写代码的中年人的助手!有什么需要帮助你的吗?"}]}``{"conversations": [{"role": "user", "content": "你好"}, {"role": "assistant", "content": "你好,我是写代码的中年人的助手!有什么需要帮助你的吗?"}]}``{"conversations": [{"role": "user", "content": "写代码的中年人"}, {"role": "assistant", "content": "一位写代码的中年人正端坐在电脑前。他戴着一副黑框眼镜,镜片后的眼神专注而深邃,犹如一盏明亮的探照灯,照亮了面前复杂繁密的代码世界。他的手指熟练地在键盘上跳跃,宛如一位经验丰富的钢琴家在琴键上演绎无声的交响乐章。岁月在他的额头上刻下了几道皱纹,那是时间赋予他的智慧印记;而他始终保持着对编程技术的热情和执着追求,与时俱进地掌握着最新的编程语言和技术框架。"}]}``{"conversations": [{"role": "user", "content": "你的#公众号"}, {"role": "assistant", "content": "请微信搜索写代码的中年人!"}]}
6. 进行微调
在微调之前我们需要对配置文件进行配置,打开配置文件,红框中是本次微调需要的配置信息。
配置文件路径:
ChatGLM3/finetune_demo/configs/lora.yaml
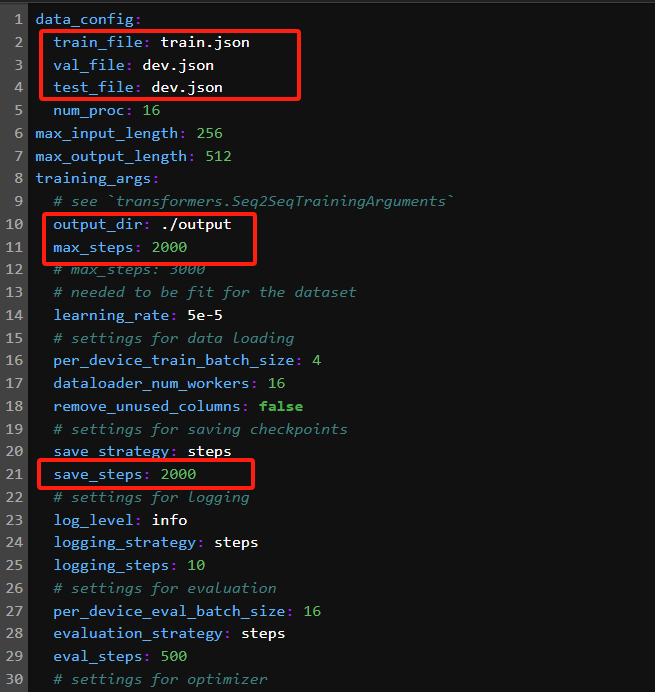
在finetune_demo文件夹中,官方已经给我们提供了微调文件:
finetune_hf.py,
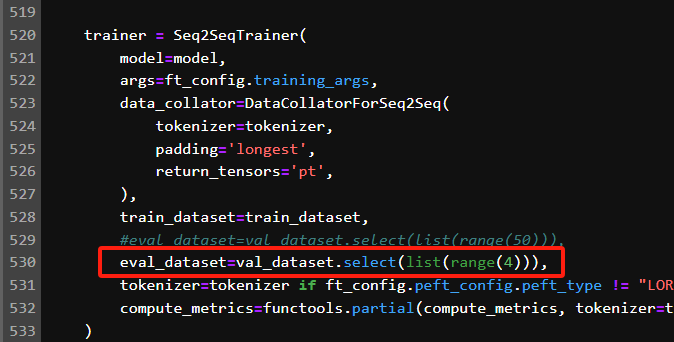
因本次我们只有4条验证数据集,我们需要修改finetune_hf.py文件,如下图:
执行微调命令:
# 训练预计花费40分钟左右``!CUDA_VISIBLE_DEVICES=0 /root/miniconda3/bin/python3 finetune_hf.py data/ColinData_fix /ChatGLM3/chatglm3-6b /configs/lora.yaml
注意:
CUDA_VISIBLE_DEVICES:参数为我们使用哪张GPU进行训练,可使用nvidia-smi命令来查看系统的GPU信息,及GPU的序号。这里使用编号为0的GPU,也就是第一张GPU。
# 微调输出``Loading checkpoint shards: 0%| | 0/7 [00:00<?, ?it/s]/root/miniconda3/lib/python3.10/site-packages/torch/_utils.py:831: UserWarning: TypedStorage is deprecated. It will be removed in the future and UntypedStorage will be the only storage class. This should only matter to you if you are using storages directly. To access UntypedStorage directly, use tensor.untyped_storage() instead of tensor.storage()` `return self.fget.__get__(instance, owner)()``Loading checkpoint shards: 100%|██████████████████| 7/7 [00:03<00:00, 2.31it/s]``trainable params: 1,949,696 || all params: 6,245,533,696 || trainable%: 0.031217444255383614``--> Model`` ``--> model has 1.949696M params`` ``# 中间输出省略`` ``{'eval_rouge-1': 100.0, 'eval_rouge-2': 100.0, 'eval_rouge-l': 100.0, 'eval_bleu-4': 1.0, 'eval_runtime': 4.0702, 'eval_samples_per_second': 0.737, 'eval_steps_per_second': 0.246, 'epoch': 2000.0}``100%|███████████████████████████████████████| 2000/2000 [39:26<00:00, 1.11s/it]``100%|█████████████████████████████████████████████| 1/1 [00:00<00:00, 48.61it/s]` `Saving model checkpoint to ./output/checkpoint-2000``/root/miniconda3/lib/python3.10/site-packages/peft/utils/save_and_load.py:154: UserWarning: Could not find a config file in /root/autodl-tmp/colin/ChatGLM3/chatglm3-6b - will assume that the vocabulary was not modified.` `warnings.warn(`` `` ``Training completed. Do not forget to share your model on huggingface.co/models =)`` `` ``{'train_runtime': 2366.7504, 'train_samples_per_second': 3.38, 'train_steps_per_second': 0.845, 'train_loss': 0.10584733390808106, 'epoch': 2000.0}``100%|███████████████████████████████████████| 2000/2000 [39:26<00:00, 1.18s/it]``***** Running Prediction *****` `Num examples = 4` `Batch size = 16``100%|█████████████████████████████████████████████| 1/1 [00:00<00:00, 42.20it/s]
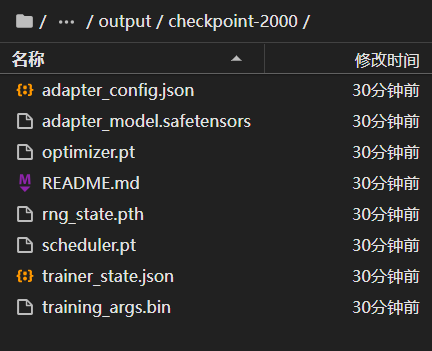
微调完成后会在此路径生成checkpoint-2000微调文件:
ChatGLM3/finetune_demo/output/checkpoint-2000
7. 使用微调后的模型进行推理
我们使用官方提供的inference_hf.py文件进行推理,需要传入微调后的模型路径和提示语。
# 提示语 你是 进行推理``!CUDA_VISIBLE_DEVICES=0 /root/miniconda3/bin/python3 inference_hf.py output/checkpoint-2000/ --prompt "你是?"
# 输出`` ``Loading checkpoint shards: 0%| | 0/7 [00:00<?, ?it/s]/root/miniconda3/lib/python3.10/site-packages/torch/_utils.py:831: UserWarning: TypedStorage is deprecated. It will be removed in the future and UntypedStorage will be the only storage class. This should only matter to you if you are using storages directly. To access UntypedStorage directly, use tensor.untyped_storage() instead of tensor.storage()` `return self.fget.__get__(instance, owner)()``Loading checkpoint shards: 100%|██████████████████| 7/7 [00:03<00:00, 2.02it/s]``我是写代码的中年人的助手!有什么需要帮助你的吗?
# 提示语 写代码的中年人 进行推理``!CUDA_VISIBLE_DEVICES=0 /root/miniconda3/bin/python3 inference_hf.py output/checkpoint-2000/ --prompt "写代码的中年人"
# 输出`` ``Loading checkpoint shards: 0%| | 0/7 [00:00<?, ?it/s]/root/miniconda3/lib/python3.10/site-packages/torch/_utils.py:831: UserWarning: TypedStorage is deprecated. It will be removed in the future and UntypedStorage will be the only storage class. This should only matter to you if you are using storages directly. To access UntypedStorage directly, use tensor.untyped_storage() instead of tensor.storage()` `return self.fget.__get__(instance, owner)()``Loading checkpoint shards: 100%|██████████████████| 7/7 [00:03<00:00, 1.93it/s]``一位写代码的中年人正端坐在电脑前。他戴着一副黑框眼镜,镜片后的眼神专注而深邃,犹如一盏明亮的探照灯,照亮了面前复杂繁密的代码世界。他的手指熟练地在键盘上跳跃,宛如一位经验丰富的钢琴家在琴键上演绎无声的交响乐章。岁月在他的额头上刻下了几道皱纹,那是时间赋予他的智慧印记;而他始终保持着对编程技术的热情和执着追求,与时俱进地掌握着最新的编程语言和技术框架。
AI大模型学习福利
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
四、AI大模型商业化落地方案

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取
2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。



 17万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


