68-基于深度学习的水稻虫害检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版

YOLOV3林业病虫害数据集和数据预处理-paddle教程 林业病虫害数据集和数据预处理方法介绍 在本课程中,将使用百度与林业大学合作开发的林业病虫害防治项目中用到昆虫数据集。 读取AI识虫数据集标注信息 AI识虫数据集结构如下: 提供了2183张图片,其中训练集1693张,验证集245,测试集245张。 包含7种昆虫,分别是Boerner、Leconte、Linnaeus、acuminatus、armandi、coleoptera和linnaeus。 包含了图片和标注,请读者先将数据解压,并存放在insects目录下。 !conda list # packa 阅读详情


项目介绍

本项目基于 PyQt5 构建了简洁易用的图形用户界面,支持用户选择本地图片或视频进行目标检测。系统界面美观,交互流畅,具备良好的用户体验。

项目附带完整的 Python 源码和详细的使用说明,适合学生进行学习或有一定 Python 基础的开发者,参考与二次开发。您可以在文末获取完整的代码资源文件。


✨ 项目亮点

  • 🔧 完整系统级项目: 包括pyqt5界面、后台检测逻辑、模型加载等模块

  • 🧠 支持深度学习模型扩展: 源代码,支持个人添加改进、模型修改等

  • 🚀 可用于毕(she)/课(she)/个人项目展示: 结构清晰,逻辑完整,便于演示


在这里插入图片描述

🎯 功能展示

本系统具备多个核心功能,支持图像、视频、摄像头等多种输入源的目标检测需求:

  • 🎴功能1:支持单张图片识别
    加载本地图片进行目标识别,支持多种图片格式(如 .jpg、.png 等)。

  • 📁功能2:支持遍历文件夹识别
    可批量读取指定文件夹中的所有图像,并依次完成目标检测任务。

  • 🎫功能3:支持识别视频文件
    支持导入本地视频文件,逐帧分析,实时显示检测效果。

  • 📷功能4:支持摄像头识别
    直接调用笔记本/外接USB摄像头进行实时目标检测。(此功能识别不准,仅仅是为了有这个功能。)

  • 📤功能5:支持结果文件导出(.xls 格式)
    自动保存检测结果为表格文件,包含类别、位置、置信度等信息,方便后续统计与分析。

  • 🔄功能6:支持切换检测目标进行查看
    可自定义选择或切换需要检测的目标种类,仅显示感兴趣的目标。

🎥 更多功能细节、代码演示效果获取请参考下方视频演示。此视频是必看的,里面的信息比文章要丰富,很多内容无法通过博客文字表达出来。

68-基于深度学习的水稻虫害检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)

68-基于深度学习的水稻虫害检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)


🌟 一、环境安装

🎆 环境配置说明

本项目已准备好 完整的环境安装资源包,包含:

  • Python、PyCharm
  • CUDA、PyTorch
  • 其他依赖库(版本已适配)

所有依赖版本均已过验证,确保彼此兼容,可直接参考配套文档或视频教程一步步安装,无需手动调试。


📘 安装指南说明

本项目附带的环境配置文档及配套视频,文档是我在辅导上千名同学安装环境过程中,持续整理总结而成的经验合集,内容覆盖:

  • GPU 与 CPU 两种版本的详细安装流程
  • 安装过程中常见问题汇总
  • 每个问题对应的解决方案
  • 实测可行的安装顺序建议与注意事项

🧩 无论你是新手还是有经验的开发者,相信这份文档都能为你省下大量踩坑时间!

🎥 环境安装教学视频

环境安装-03GPU版


🌟 二、数据集介绍

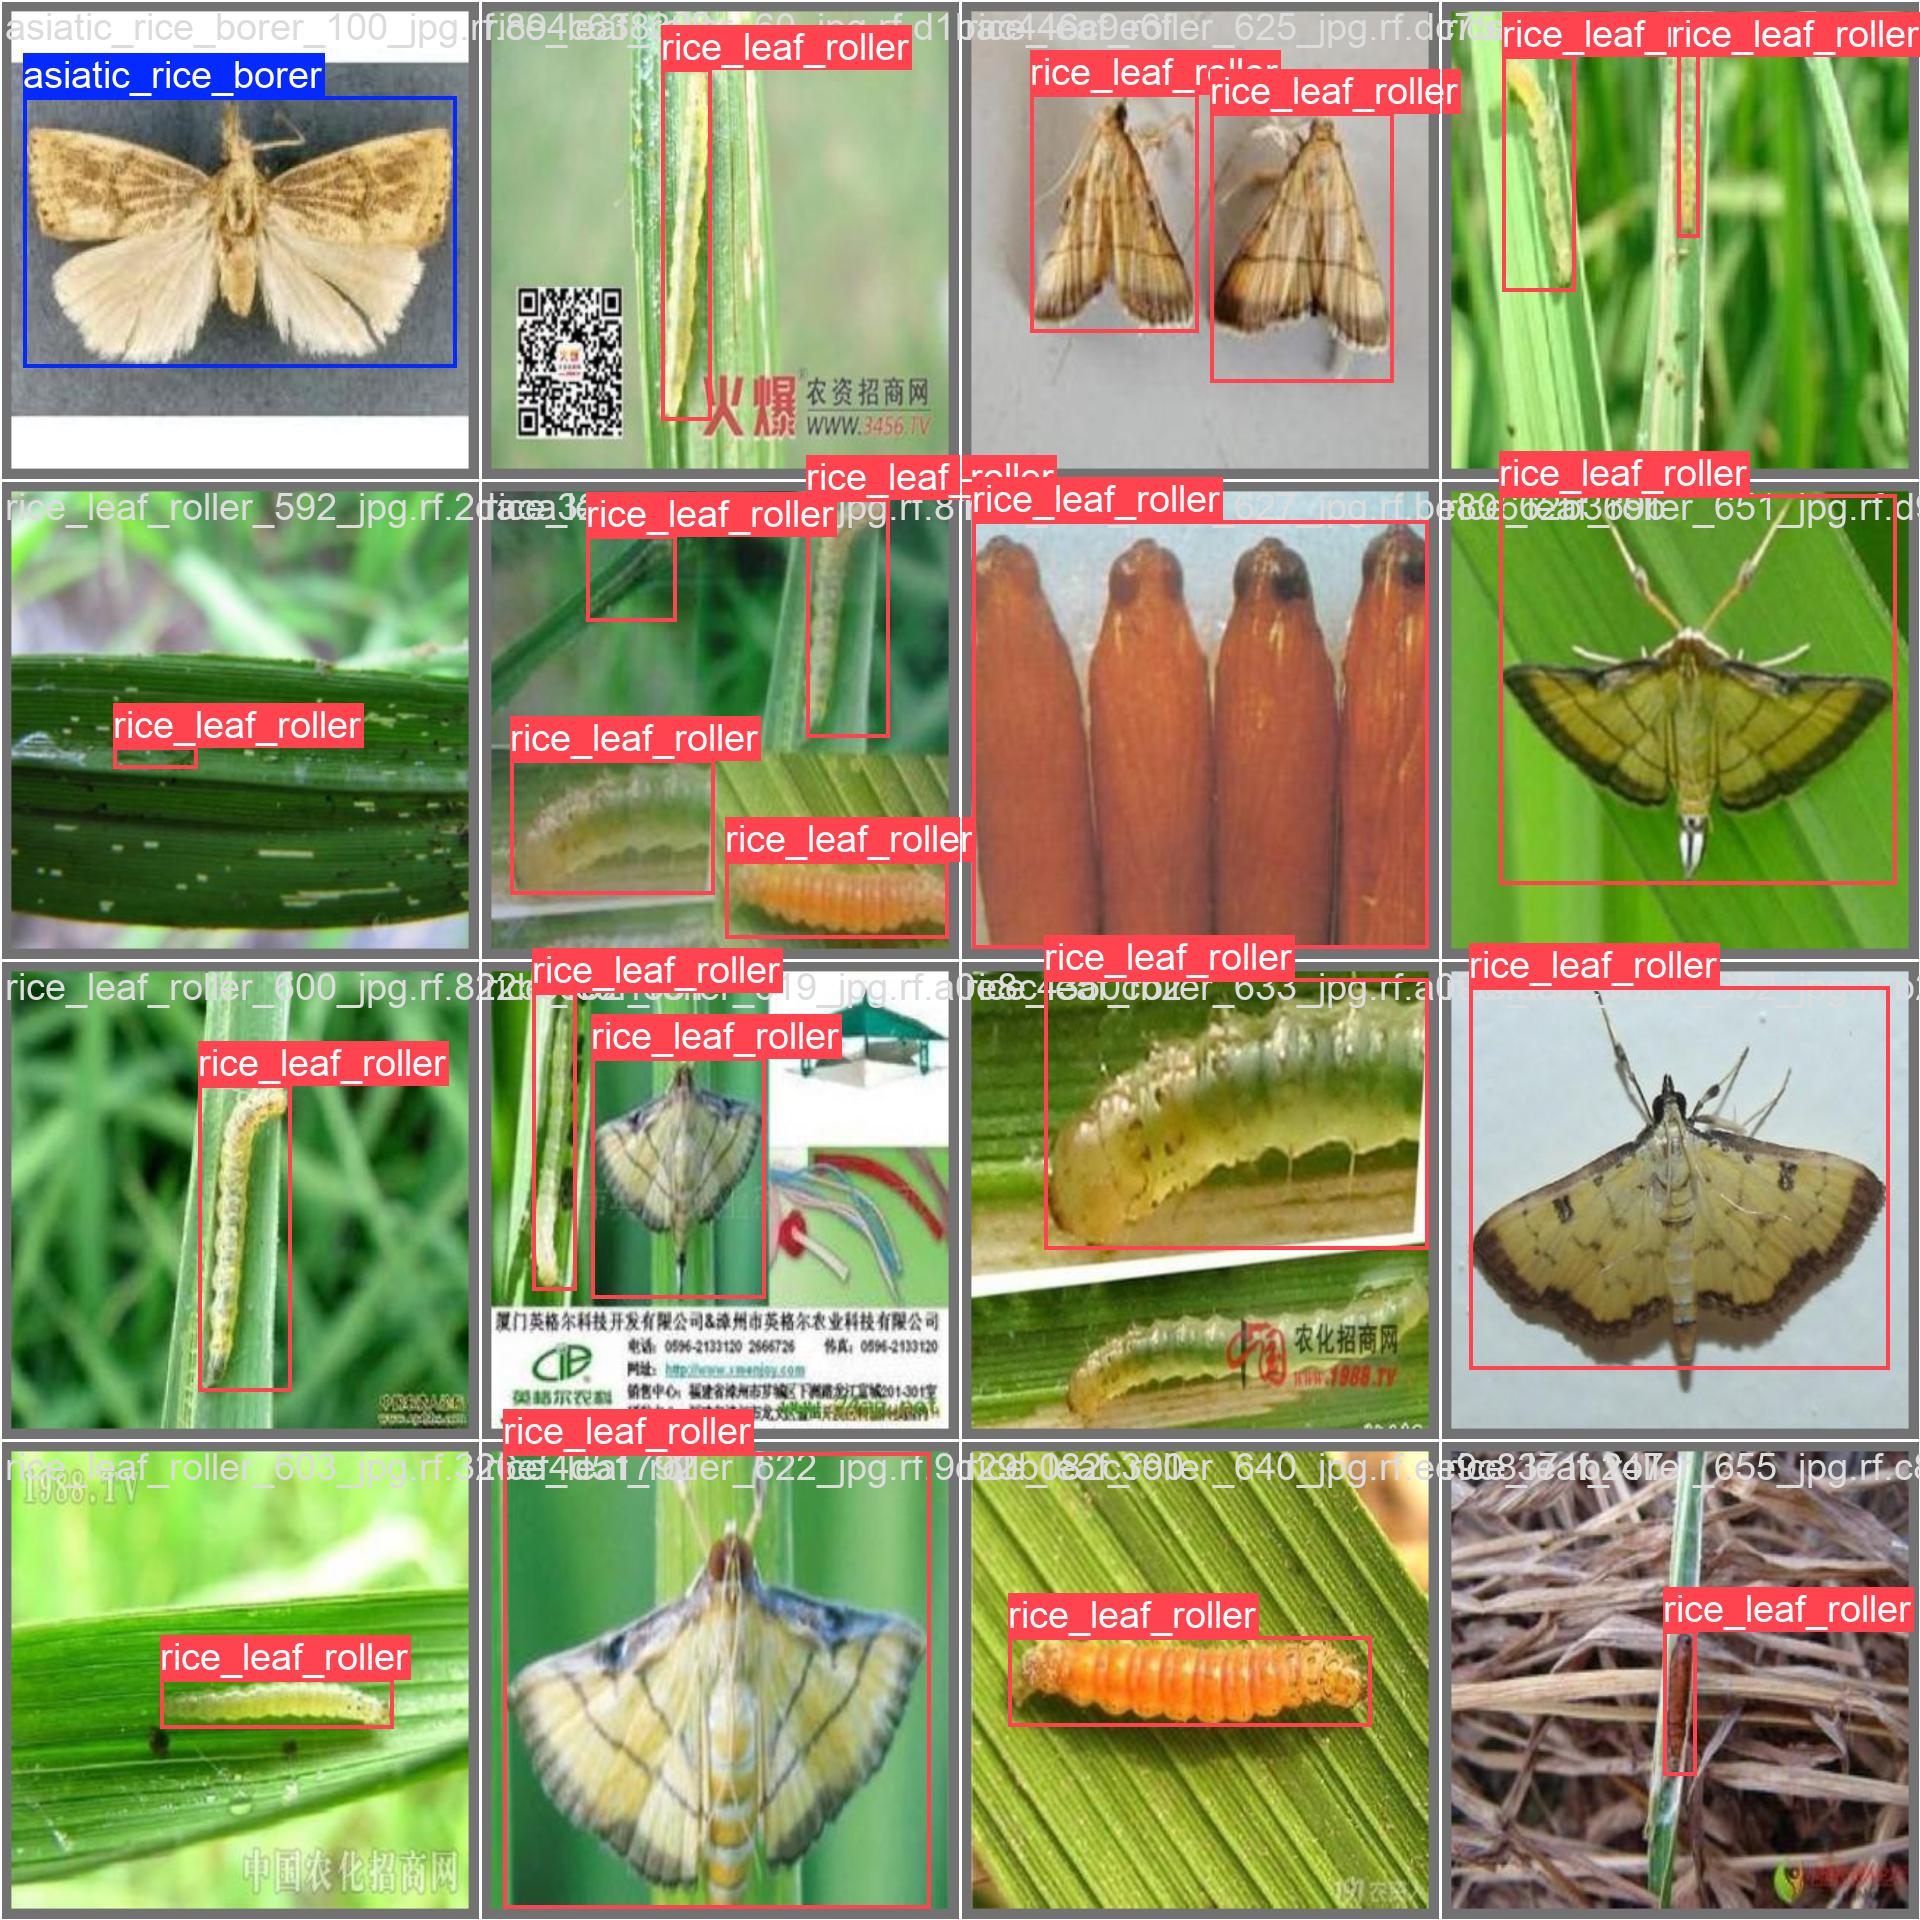
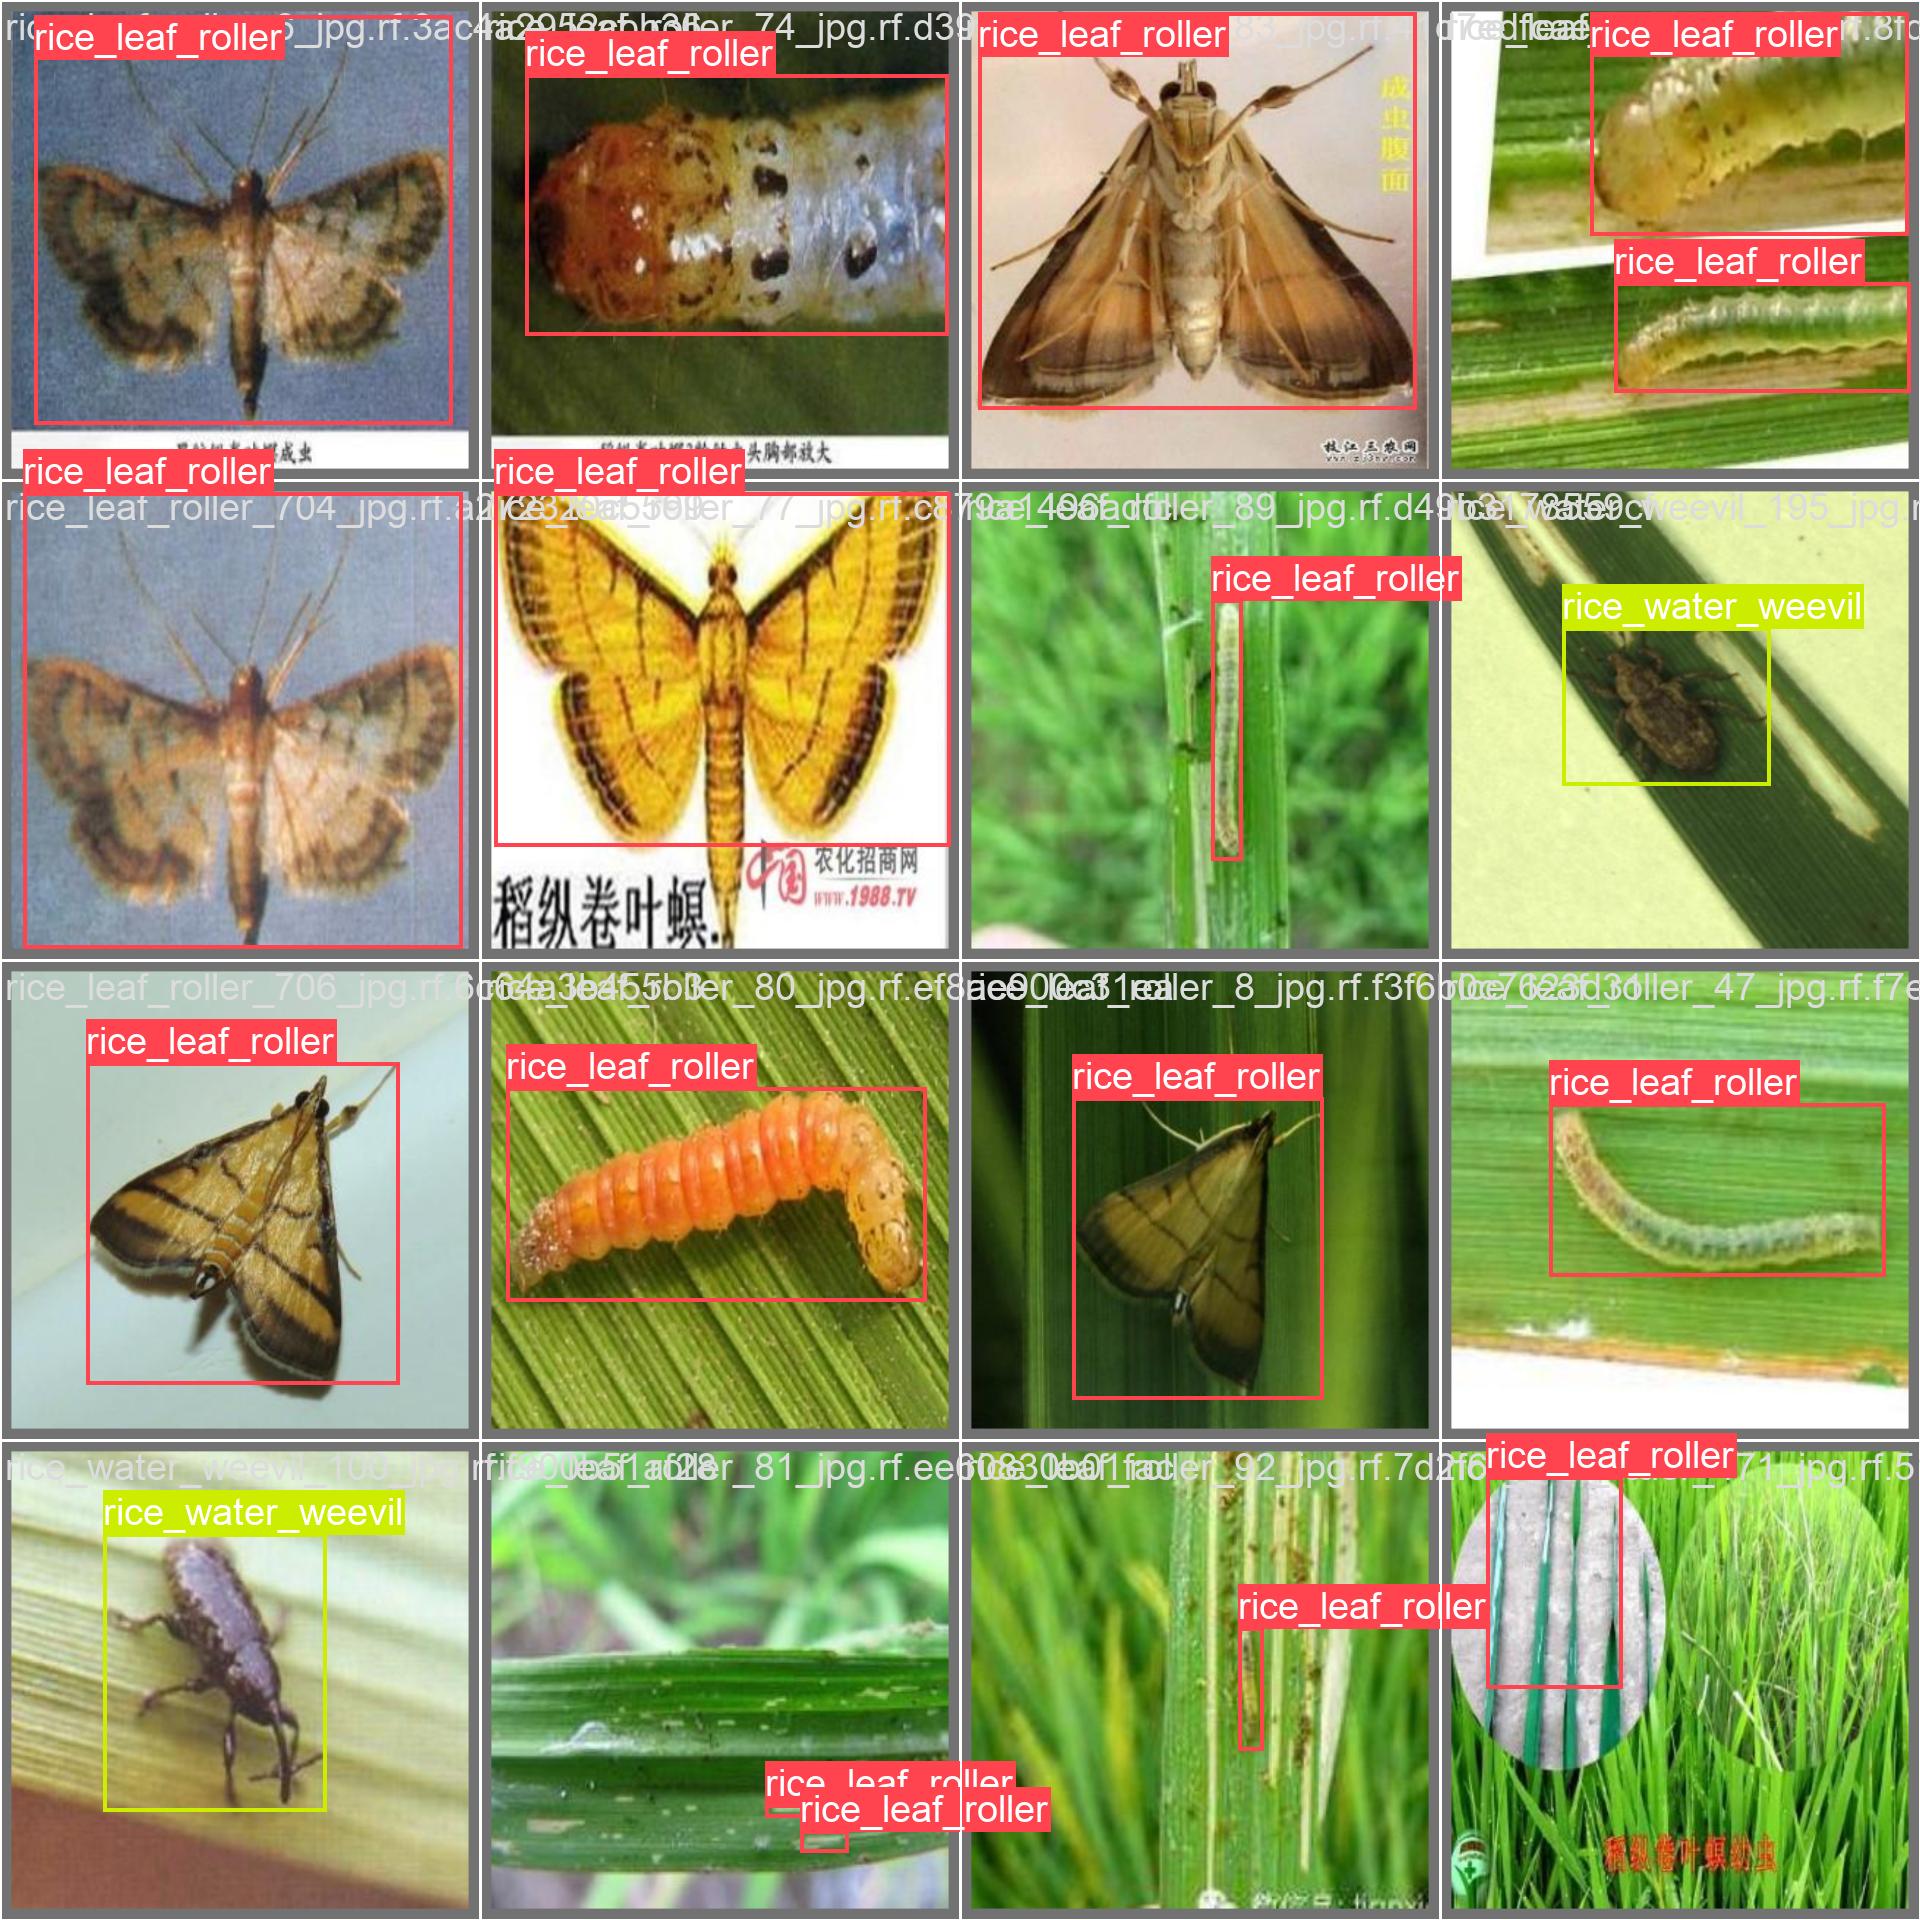
使用数据集一部分个人标注,一部分来源网络,已统一标注格式并完成预处理,可直接用于训练与测试。
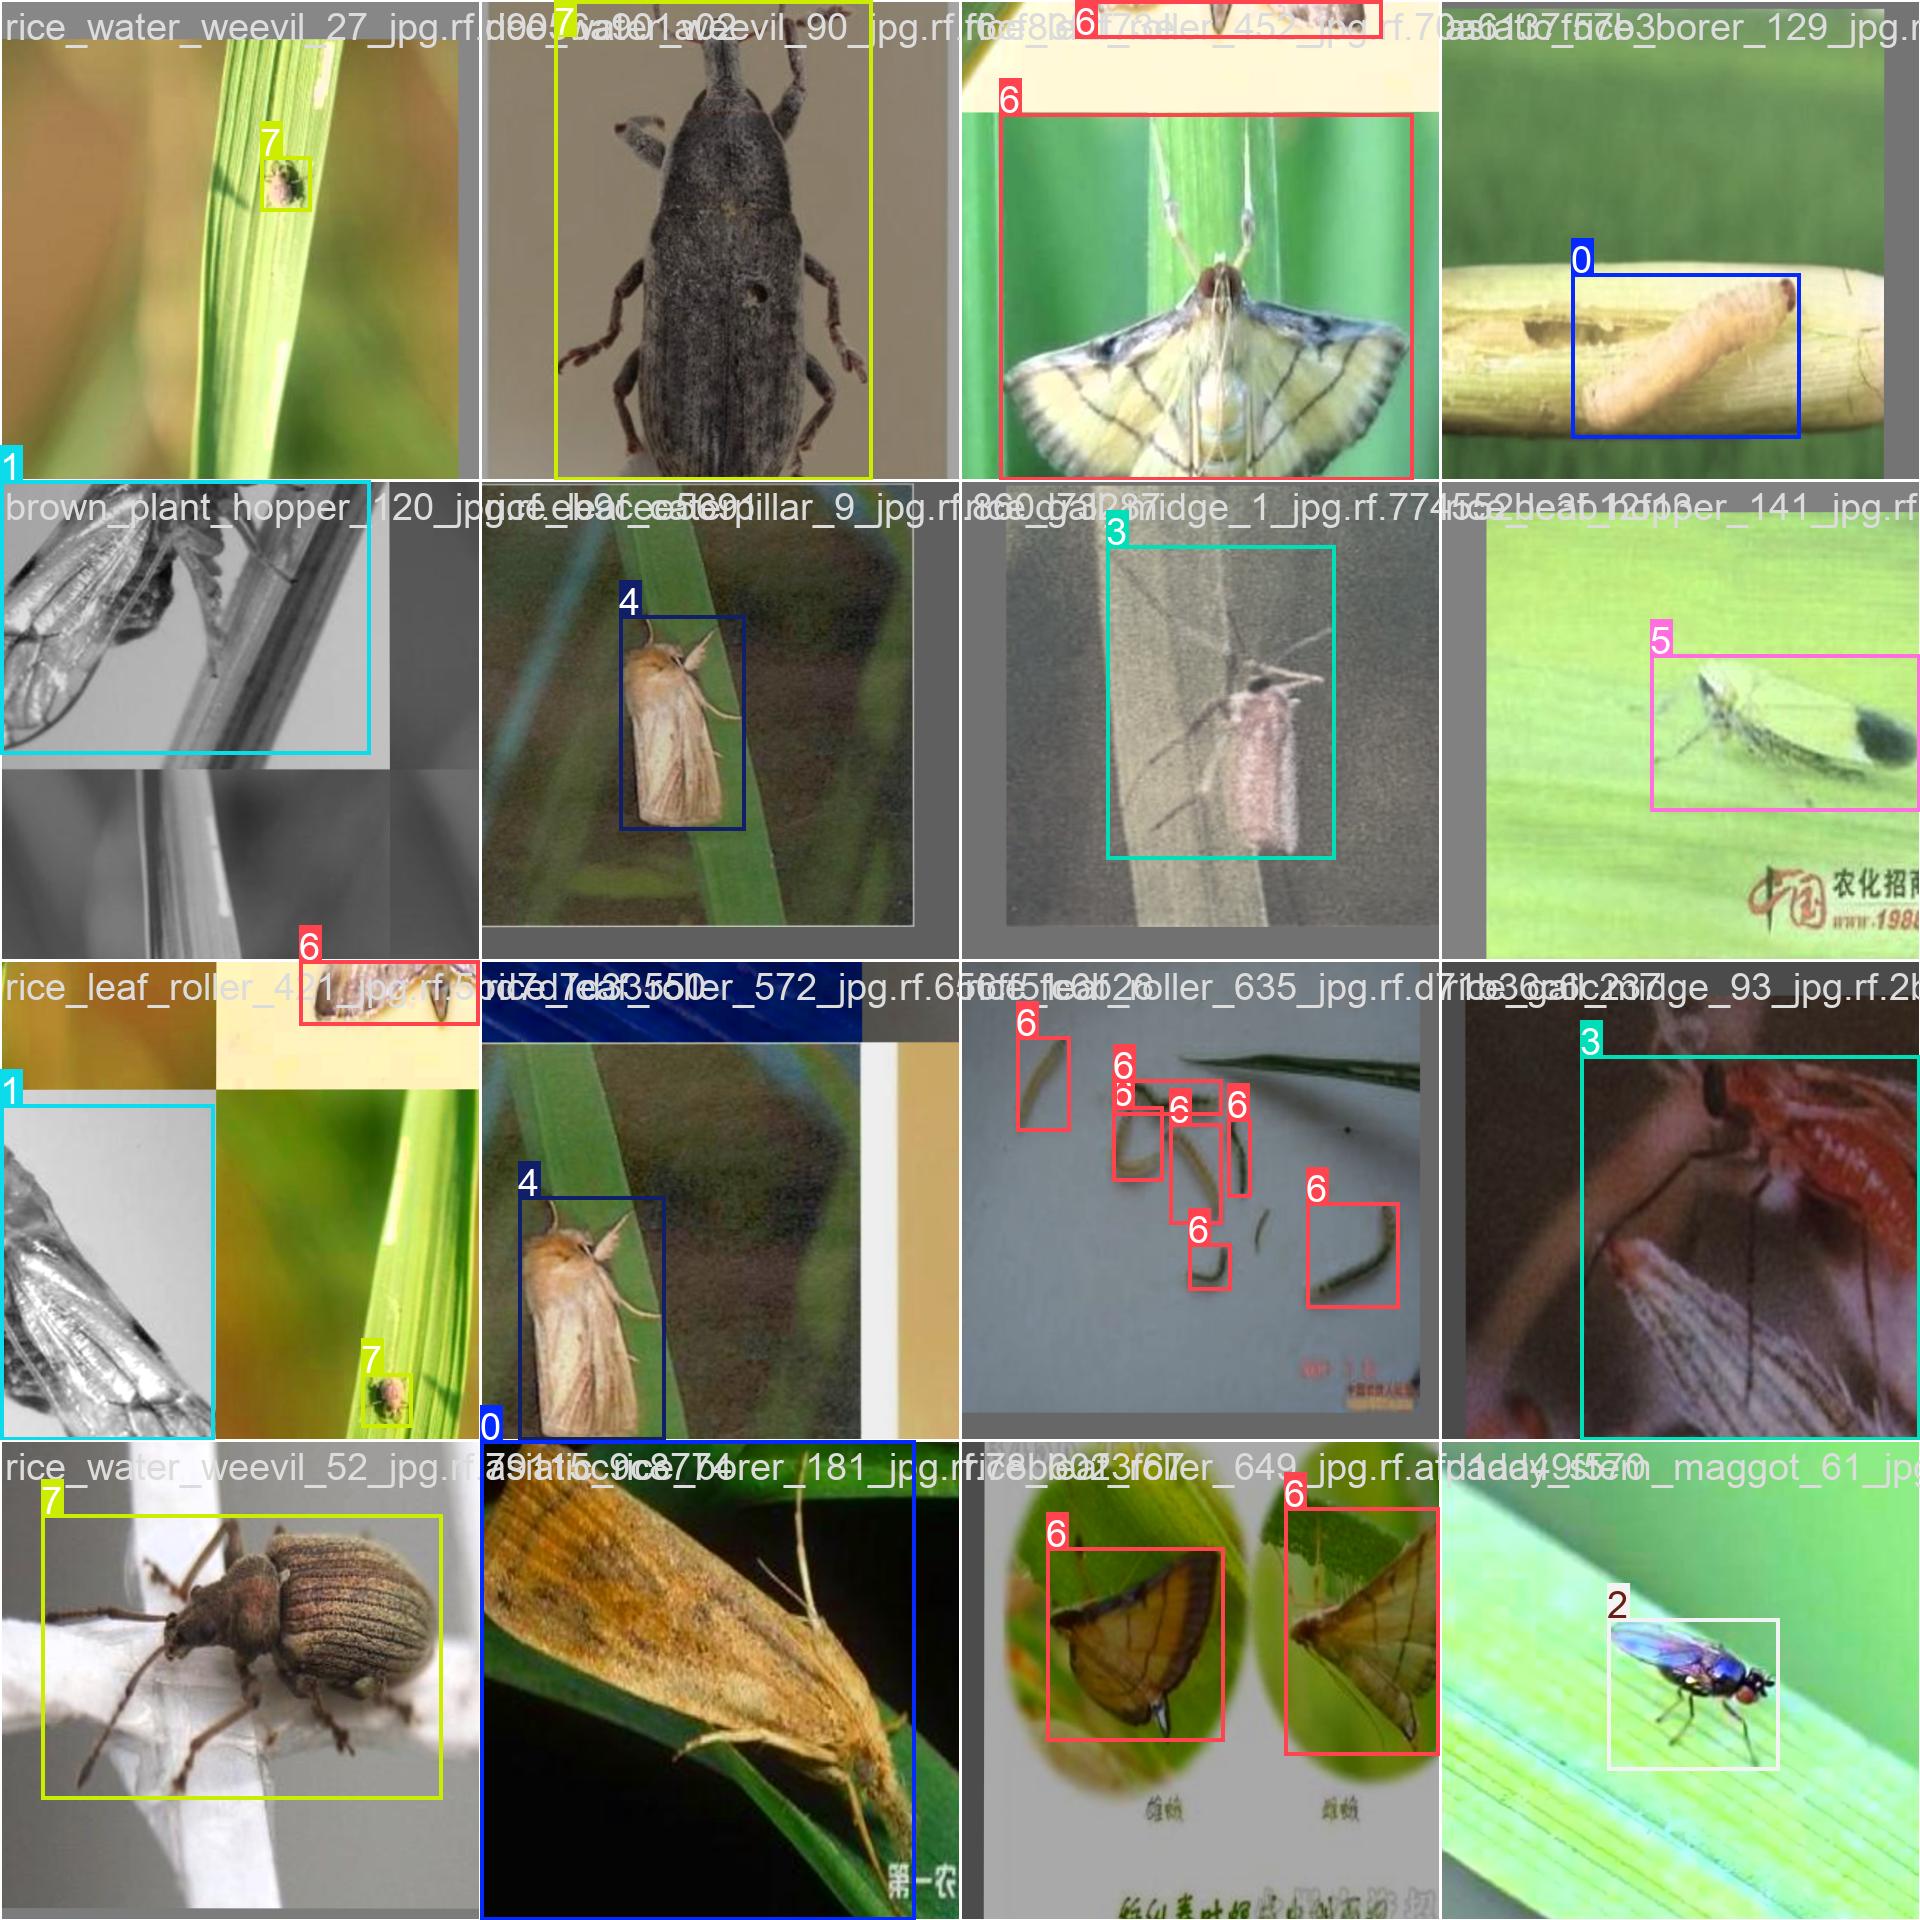
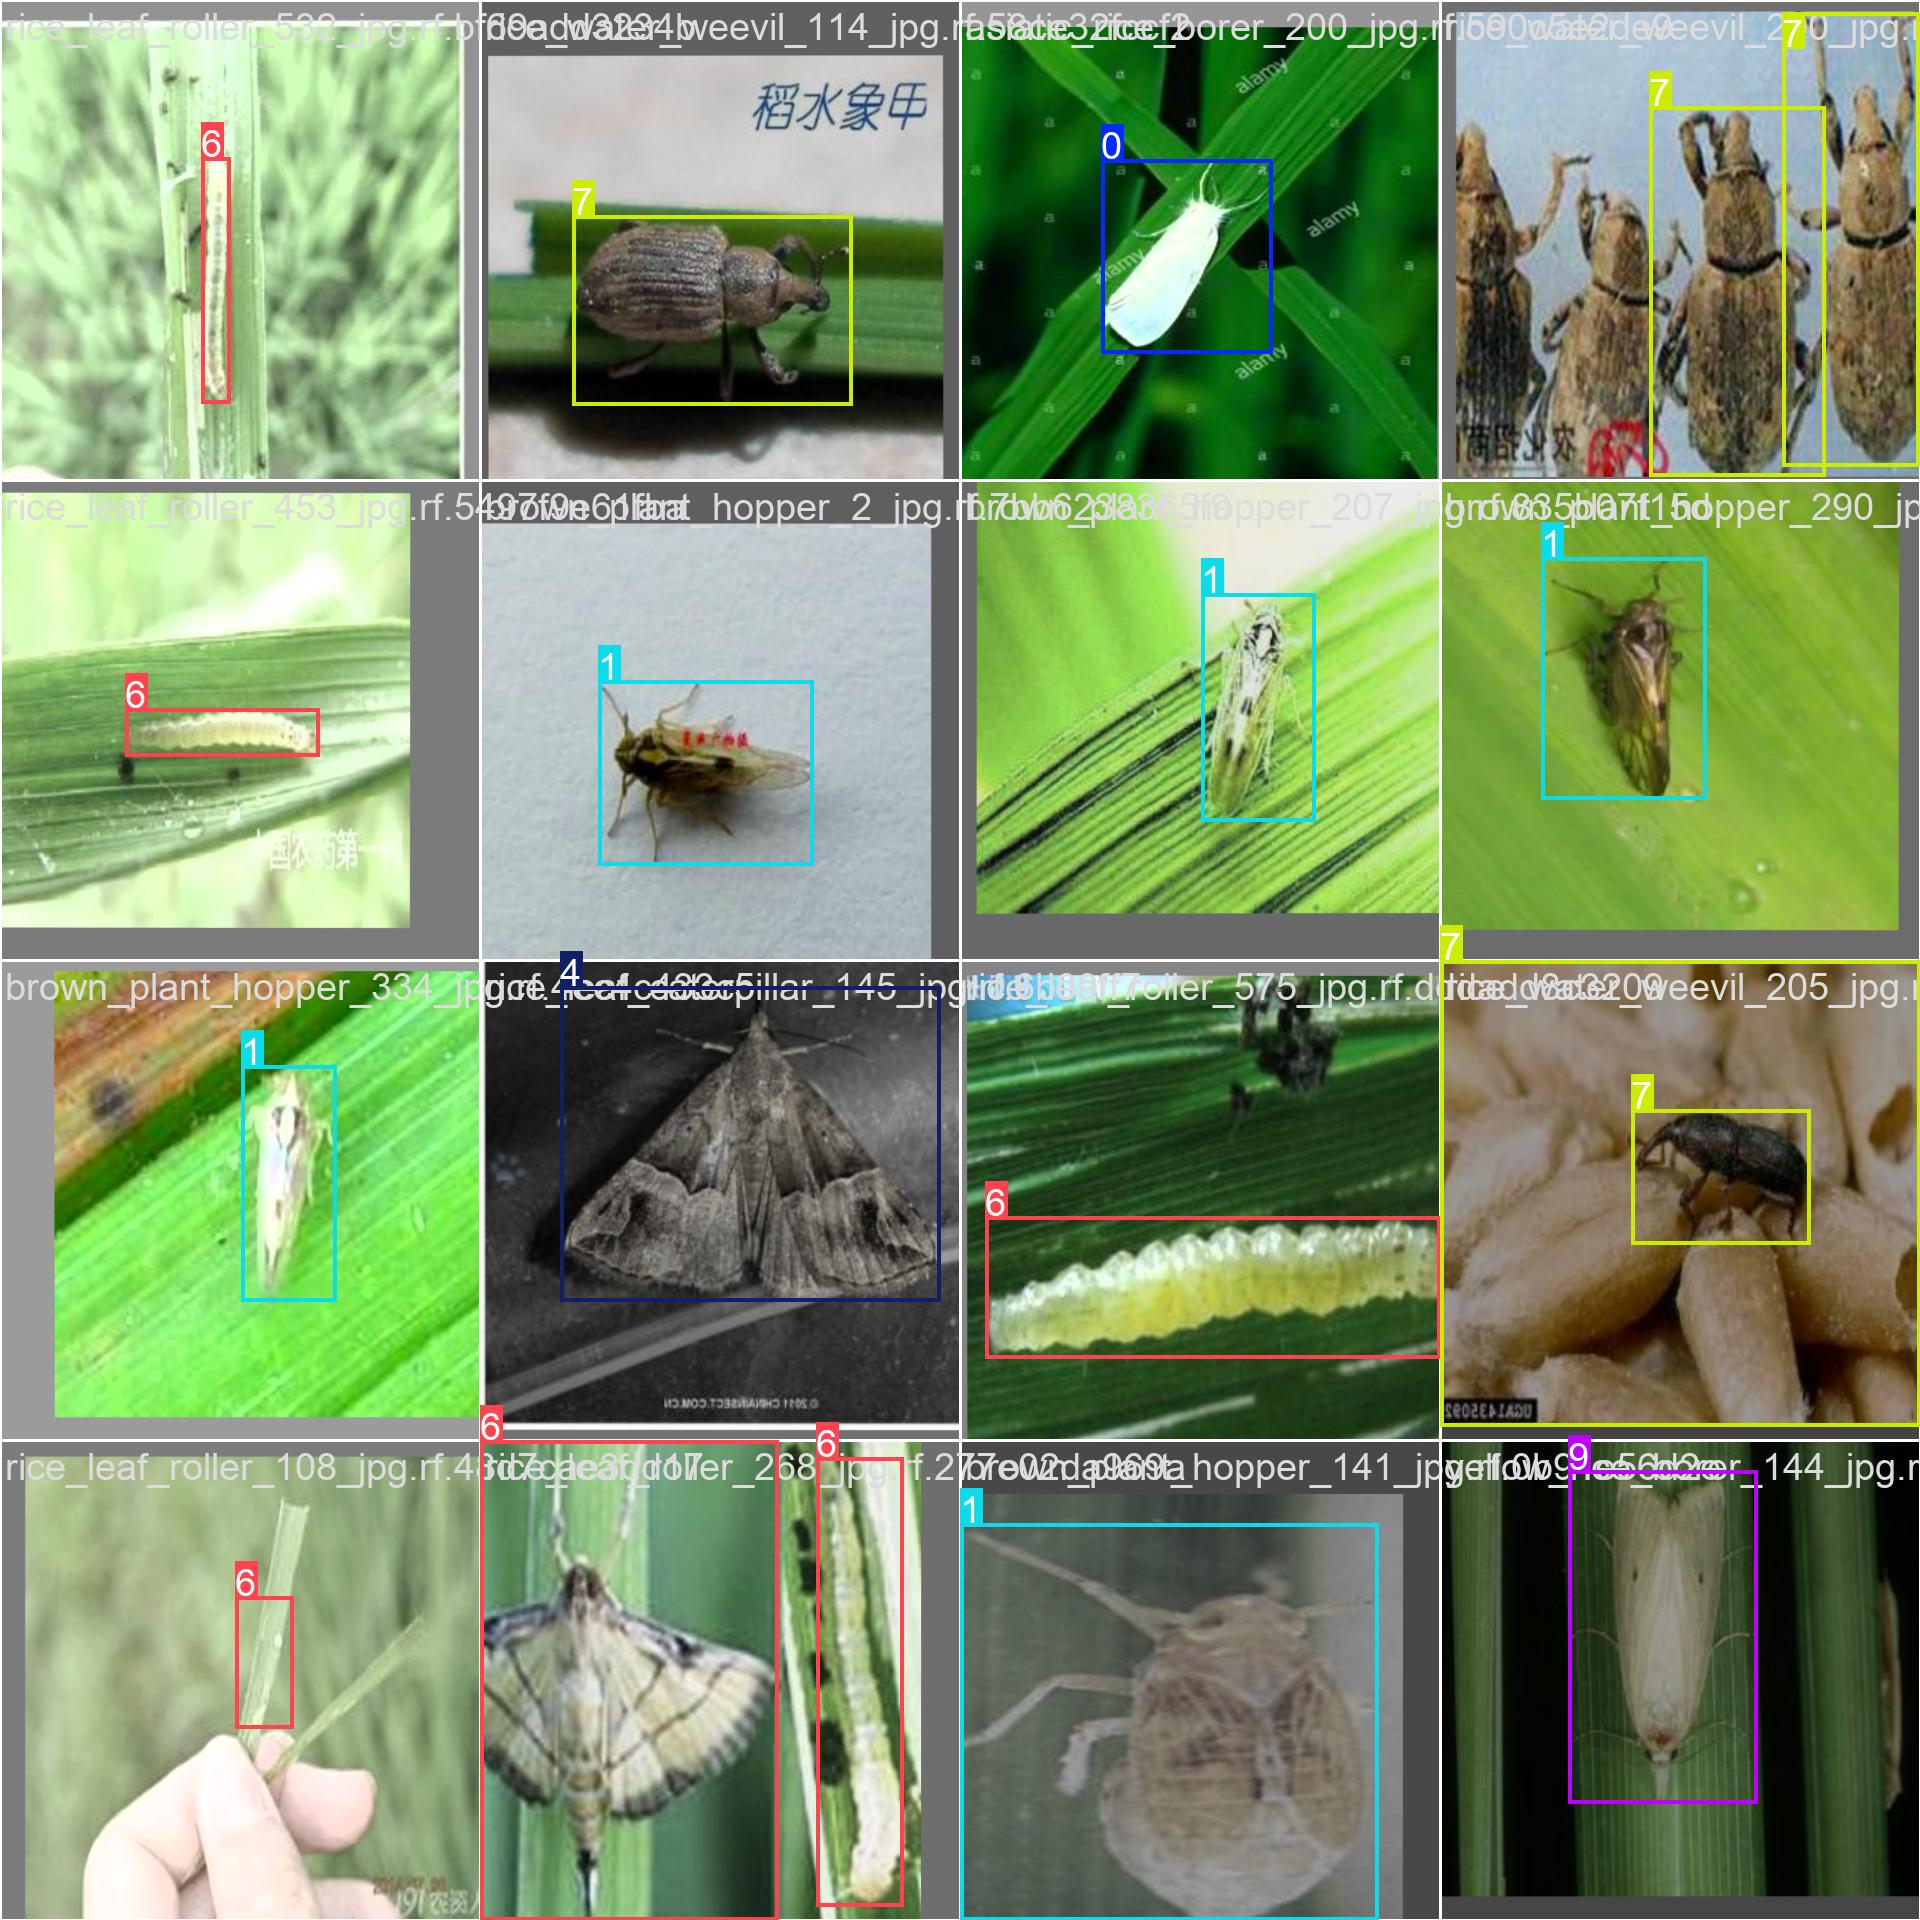
数据集样式如下:

训练样例1训练样例2
train_batch0.jpgtrain_batch1.jpg

数据集制作流程
标注数据: 使用标注工具(LabelImg)对图像中的目标进行标注。每个目标需要标出边界框,并且标注类别。

转换格式: 将标注的数据转换为YOLO格式。YOLO标注格式为每行: <x_center> <y_center> ,这些坐标是相对于图像尺寸的比例。

分割数据集: 将数据集分为训练集、验证集和测试集,通常的比例是80%训练集、10%验证集和10%测试集。

准备标签文件: 为每张图片生成一个对应的标签文件,确保标签文件与图片的命名一致。

调整图像尺寸: 根据YOLO网络要求,统一调整所有图像的尺寸(如416x416或608x608)。

这里只是简单大概介绍,我实际的文档里,内容更要比这里丰富很多,保姆级的教程。这里放太多链接,大家容易看不到😂😂😂。


🌟 三、系统环境(框架/依赖库)说明

以下内容是简单的介绍,方便大家写文章,可直接套用。

🧱 系统环境与依赖配置说明

本项目采用 Python 3.8.10 作为开发语言,整个后台逻辑均由 Python 编写,主要依赖环境如下:

🎡 图形界面框架:

  • PyQt5 5.15.9:用于搭建系统图形用户界面,实现窗口交互与组件布局。

🧠 深度学习框架:

  • torch 1.9.0+cu111:PyTorch 深度学习框架,支持 CUDA 11.1 加速,用于模型构建与推理。
  • torchvision 0.10.0+cu111:用于图像处理、数据增强及模型组件辅助。

⚡ CUDA 与 cuDNN(GPU 加速支持):

  • CUDA 11.1.1(版本号:cuda_11.1.1_456.81):用于 GPU 加速深度学习运算。
  • cuDNN 8.0.5.39(适用于 CUDA 11.1):NVIDIA 深度神经网络库,用于加速模型训练与推理过程。

🧪 图像处理与科学计算:

  • opencv-python 4.7.0.72:实现图像读取、显示、处理等功能。
  • numpy 1.24.4:用于高效数组计算及矩阵操作。
  • PIL (pillow) 9.5.0:图像文件读写与基本图像处理库。
  • matplotlib 3.7.1(可选):用于结果图形化展示与可视化调试。

📈 模型训练参数说明

本项目中提供了两个训练好的模型,均基于如下参数完成训练。具体训练时的设置需根据您自己的硬件配置灵活调整:

🎯 基本训练参数

  • batch size:16
  • epoch:200
  • imgsz(输入尺寸):640
  • 优化器:SGD
  • 学习率:初始学习率 0.01,最终学习率 0.0001
  • 学习率衰减策略:余弦退火(Cosine Annealing)
  • 激活函数:SiLU
  • 损失函数:CIOU(Complete IOU)

🔁 实时数据增强策略

训练过程中使用了多种 在线增强 方法,包括:

  • HSV 色域变换
  • 上下翻转、左右翻转
  • 图像旋转
  • Mosaic 图像拼接增强

⚠️ 特别说明:
以上所有增强操作均为 实时数据增强,只在训练过程中动态生成,用作模型输入,不会将增强后的图像保存到本地。

这种策略具有以下优势:

  • 节省磁盘空间
  • 提高训练样本的多样性
  • 增强模型的泛化能力

若需要可视化增强效果,可自行编写脚本或借助工具(如 Photoshop、美图秀秀等)生成示例图像进行展示。


🌟 四、YOLO相关介绍

🎀 yolov5相关介绍

YOLOV5有YOLOv5n,YOLOv5s,YOLOv5m,YOLOV5l、YOLO5x五个版本。这个模型的结构基本一样,不同的是deth_multiole模型深度和width_multiole模型宽度这两个参数。就和我们买衣服的尺码大小排序一样,YOLOV5n网络是YOLOV5系列中深度最小,特征图的宽度最小的网络。其他的三种都是在此基础上不断加深,不断加宽。不过最常用的一般都是yolov5s模型。
在这里插入图片描述

  本系统采用了基于深度学习的目标检测算法YOLOv5,该算法是YOLO系列算法的较新版本,相比于YOLOv3和YOLOv4,YOLOv5在检测精度和速度上都有很大的提升。YOLOv5算法的核心思想是将目标检测问题转化为一个回归问题。此外,YOLOv5还引入了一种称为SPP(Spatial Pyramid Pooling)的特征提取方法,这种方法可以在不增加计算量的情况下,有效地提取多尺度特征,提高检测性能。

  在YOLOv5中,首先将输入图像通过骨干网络进行特征提取,得到一系列特征图。然后,通过对这些特征图进行处理,将其转化为一组检测框和相应的类别概率分数,即每个检测框所属的物体类别以及该物体的置信度。YOLOv5中的特征提取网络使用CSPNet(Cross Stage Partial Network)结构,它将输入特征图分为两部分,一部分通过一系列卷积层进行处理,另一部分直接进行下采样,最后将这两部分特征图进行融合。这种设计使得网络具有更强的非线性表达能力,可以更好地处理目标检测任务中的复杂背景和多样化物体。

在这里插入图片描述

  在YOLOv5中,每个检测框由其左上角坐标(x,y)、宽度(w)、高度(h)和置信度(confidence)组成。同时,每个检测框还会预测C个类别的概率得分,即分类得分(ci),每个类别的得分之和等于1。因此,每个检测框最终被表示为一个(C+5)维的向量。在训练阶段,YOLOv5使用交叉熵损失函数来优化模型。损失函数由定位损失、置信度损失和分类损失三部分组成,其中定位损失和置信度损失采用了Focal Loss和IoU Loss等优化方法,能够有效地缓解正负样本不平衡和目标尺寸变化等问题。

  YOLOv5网络结构是由Input、Backbone、Neck、Prediction组成。Yolov5的Input部分是网络的输入端,采用Mosaic数据增强方式,对输入数据随机裁剪,然后进行拼接。Backbone是Yolov5提取特征的网络部分,特征提取能力直接影响整个网络性能。YOLOv5的Backbone相比于之前Yolov4提出了新的Focus结构。Focus结构是将图片进行切片操作,将W(宽)、H(高)信息转移到了通道空间中,使得在没有丢失任何信息的情况下,进行了2倍下采样操作。

🎑 yolov8相关介绍

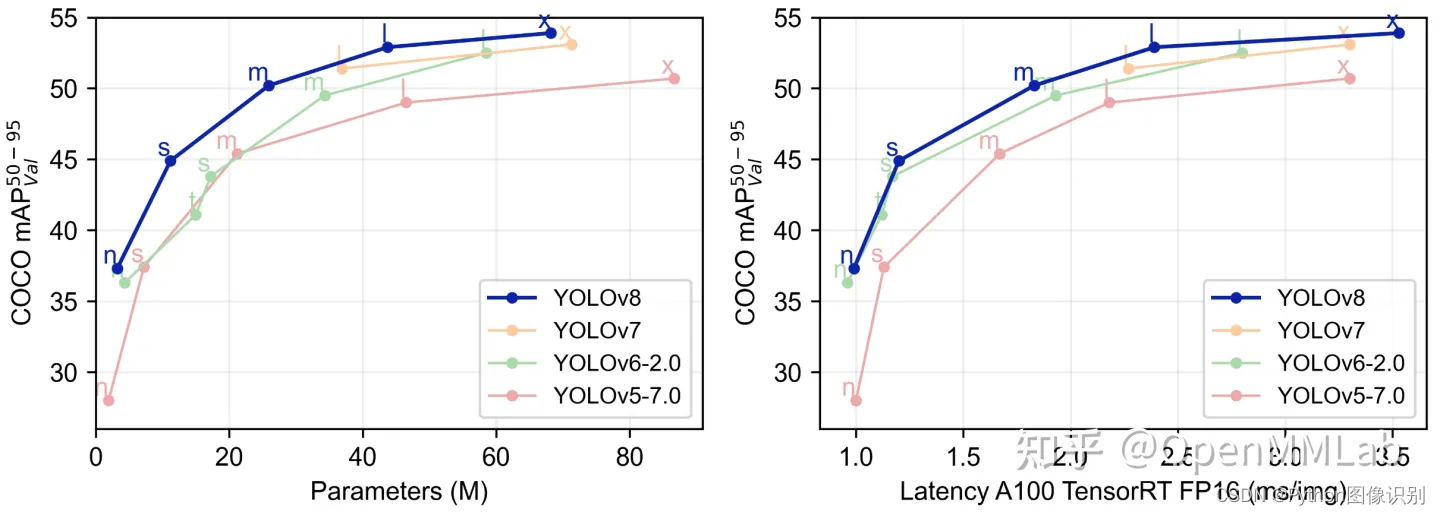
YOLOv8 是一个 SOTA 模型,它建立在以前 YOLO 版本的成功基础上,并引入了新的功能和改进,以进一步提升性能和灵活性。具体创新包括一个新的骨干网络、一个新的 Ancher-Free 检测头和一个新的损失函数,可以在从 CPU 到 GPU 的各种硬件平台上运行。

不过 ultralytics 并没有直接将开源库命名为 YOLOv8,而是直接使用 ultralytics 这个词,原因是 ultralytics 将这个库定位为算法框架,而非某一个特定算法,一个主要特点是可扩展性。其希望这个库不仅仅能够用于 YOLO 系列模型,而是能够支持非 YOLO 模型以及分类分割姿态估计等各类任务。
总而言之,ultralytics 开源库的两个主要优点是:

  • 融合众多当前 SOTA 技术于一体

  • 未来将支持其他 YOLO 系列以及 YOLO 之外的更多算法

在这里插入图片描述

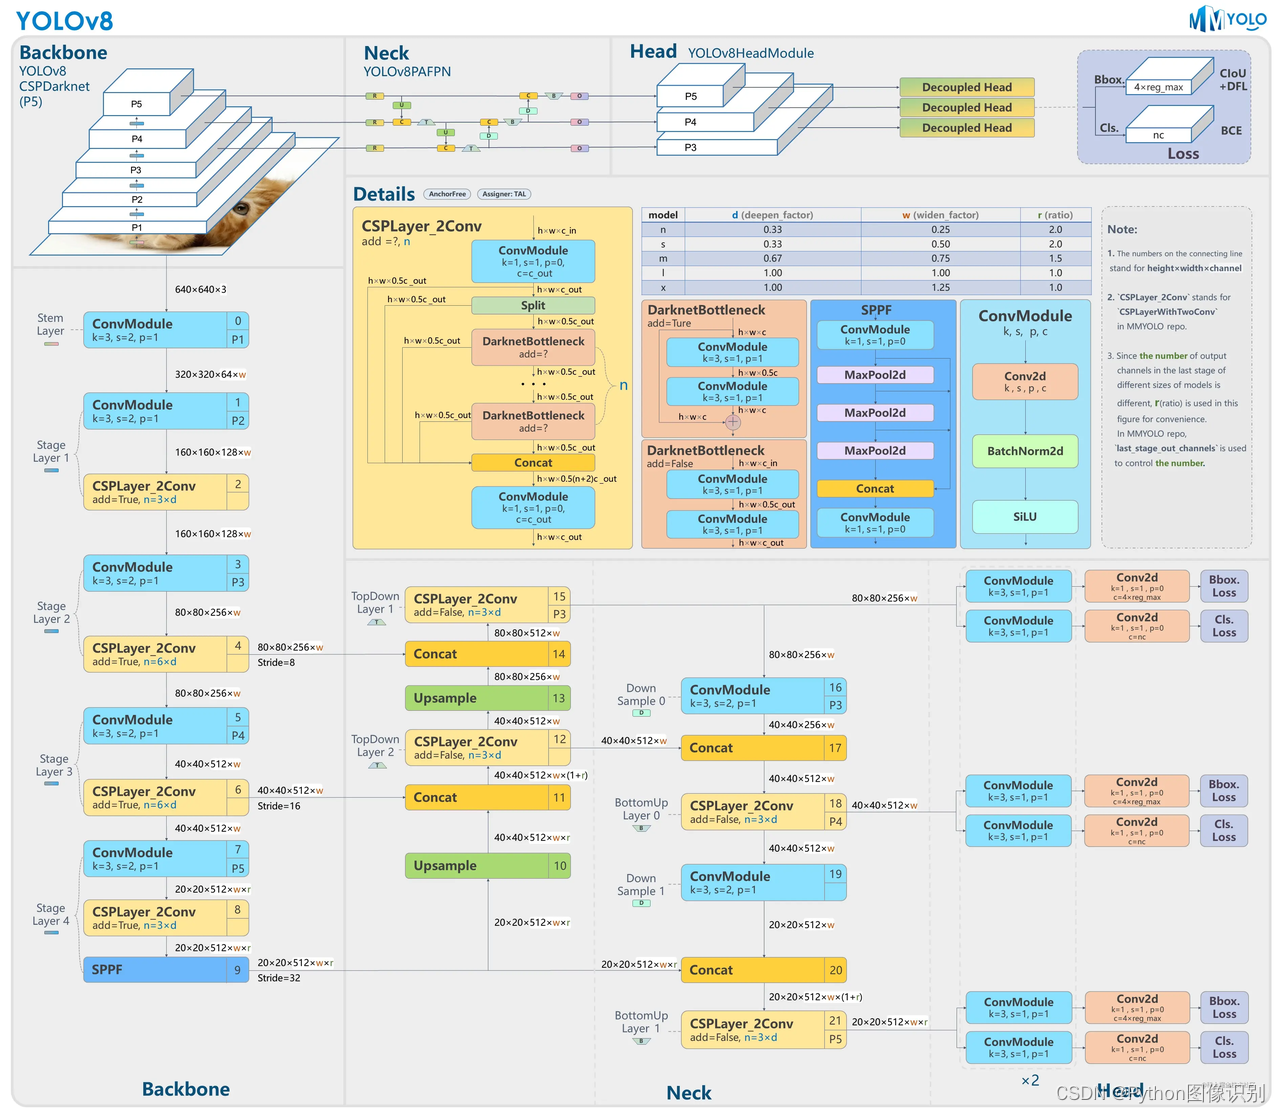
网络结构如下:
在这里插入图片描述

🎐 yolo11相关介绍

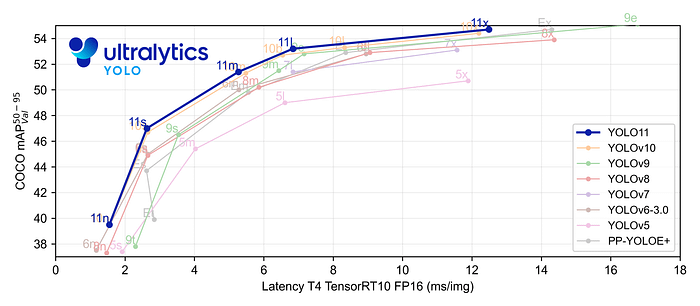
YOLO11 是Ultralytics YOLO 系列实时物体检测器的最新版本,以尖端的精度、速度和效率重新定义了可能性。基于先前 YOLO 版本的令人印象深刻的进步,YOLO11 在架构和训练方法方面引入了重大改进,使其成为各种计算机视觉任务的多功能选择。
在这里插入图片描述

Key Features 主要特点:

  • 增强的特征提取:YOLO11采用改进的主干和颈部架构,增强了特征提取能力,以实现更精确的目标检测和复杂任务性能。
  • 针对效率和速度进行优化:YOLO11 引入了精致的架构设计和优化的训练管道,提供更快的处理速度并保持准确性和性能之间的最佳平衡。
  • 使用更少的参数获得更高的精度:随着模型设计的进步,YOLO11m 在 COCO 数据集上实现了更高的平均精度(mAP),同时使用的参数比 YOLOv8m 少 22%,从而在不影响精度的情况下提高计算效率。
  • 跨环境适应性:YOLO11可以无缝部署在各种环境中,包括边缘设备、云平台以及支持NVIDIA GPU的系统,确保最大的灵活性。
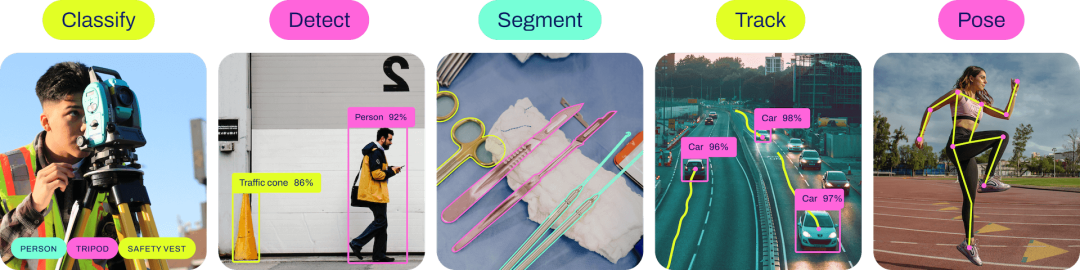
  • 支持的任务范围广泛:无论是对象检测、实例分割、图像分类、姿态估计还是定向对象检测 (OBB),YOLO11 旨在应对各种计算机视觉挑战。
    在这里插入图片描述

🌟 五、模型训练步骤

以下操作步骤,每年我都会更新,所以下方操作步骤可跳过,可以去我文档里查看最新的操作步骤。

  1. 使用pycharm打开代码,找到train.py打开,示例截图如下:
    在这里插入图片描述

  2. 修改 model_yaml 的值,根据自己的实际情况修改,想要训练 yolov5s模型 就 修改为 model_yaml = yaml_yolov5s, 训练 添加SE注意力机制的模型就修改为 model_yaml = yaml_yolov5_SE

  3. 修改data_path 数据集路径,我这里默认指定的是traindata.yaml 文件,如果训练我提供的数据,可以不用改

  4. 修改 model.train()中的参数,按照自己的需求和电脑硬件的情况更改

    # 文档中对参数有详细的说明
    model.train(data=data_path,             # 数据集
                imgsz=640,                  # 训练图片大小
                epochs=200,                 # 训练的轮次
                batch=2,                    # 训练batch
                workers=0,                  # 加载数据线程数
                device='0',                 # 使用显卡
                optimizer='SGD',            # 优化器
                project='runs/train',       # 模型保存路径
                name=name,                  # 模型保存命名
                )
    
  5. 修改traindata.yaml文件, 打开 traindata.yaml 文件,如下所示:
    在这里插入图片描述
    在这里,只需修改 path 的值,其他的都不用改动(仔细看上面的黄色字体),我提供的数据集默认都是到 yolo 文件夹,设置到 yolo 这一级即可,修改完后,返回 train.py 中,执行train.py。

  6. 打开 train.py ,右键执行。
    在这里插入图片描述

  7. 出现如下类似的界面代表开始训练了
    在这里插入图片描述

  8. 训练完后的模型保存在runs/train文件夹下
    在这里插入图片描述


🌟 六、模型评估步骤

以下操作步骤,每年我都会更新,,所以下方操作步骤可跳过,可以去我文档里查看最新的操作步骤。

  1. 打开val.py文件,如下图所示:
    在这里插入图片描述

  2. 修改 model_pt 的值,是自己想要评估的模型路径

  3. 修改 data_path ,根据自己的实际情况修改,具体如何修改,查看上方模型训练中的修改步骤

  4. 修改 model.val()中的参数,按照自己的需求和电脑硬件的情况更改

    model.val(data=data_path,           # 数据集路径
              imgsz=300,                # 图片大小,要和训练时一样
              batch=4,                  # batch
              workers=0,                # 加载数据线程数
              conf=0.001,               # 设置检测的最小置信度阈值。置信度低于此阈值的检测将被丢弃。
              iou=0.6,                  # 设置非最大抑制 (NMS) 的交叉重叠 (IoU) 阈值。有助于减少重复检测。
              device='0',               # 使用显卡
              project='runs/val',       # 保存路径
              name='exp',               # 保存命名
              )
    
  5. 修改完后,即可执行程序,出现如下截图,代表成功(下图是示例,具体输出结果以自己的实际项目为准。)
    在这里插入图片描述

  6. 评估后的文件全部保存在在 runs/val/exp... 文件夹下
    在这里插入图片描述


🌟 七、训练结果

模型训练完成后,所有相关文件(包括权重文件、训练日志、评估结果等)均统一保存在代码工程的weights文件夹下,便于后续模型部署与复用。文件夹内包含训练过程中生成的所有最优权重(best.pt)及最终权重(last.pt),整体结构清晰,可直接用于推理或二次训练。
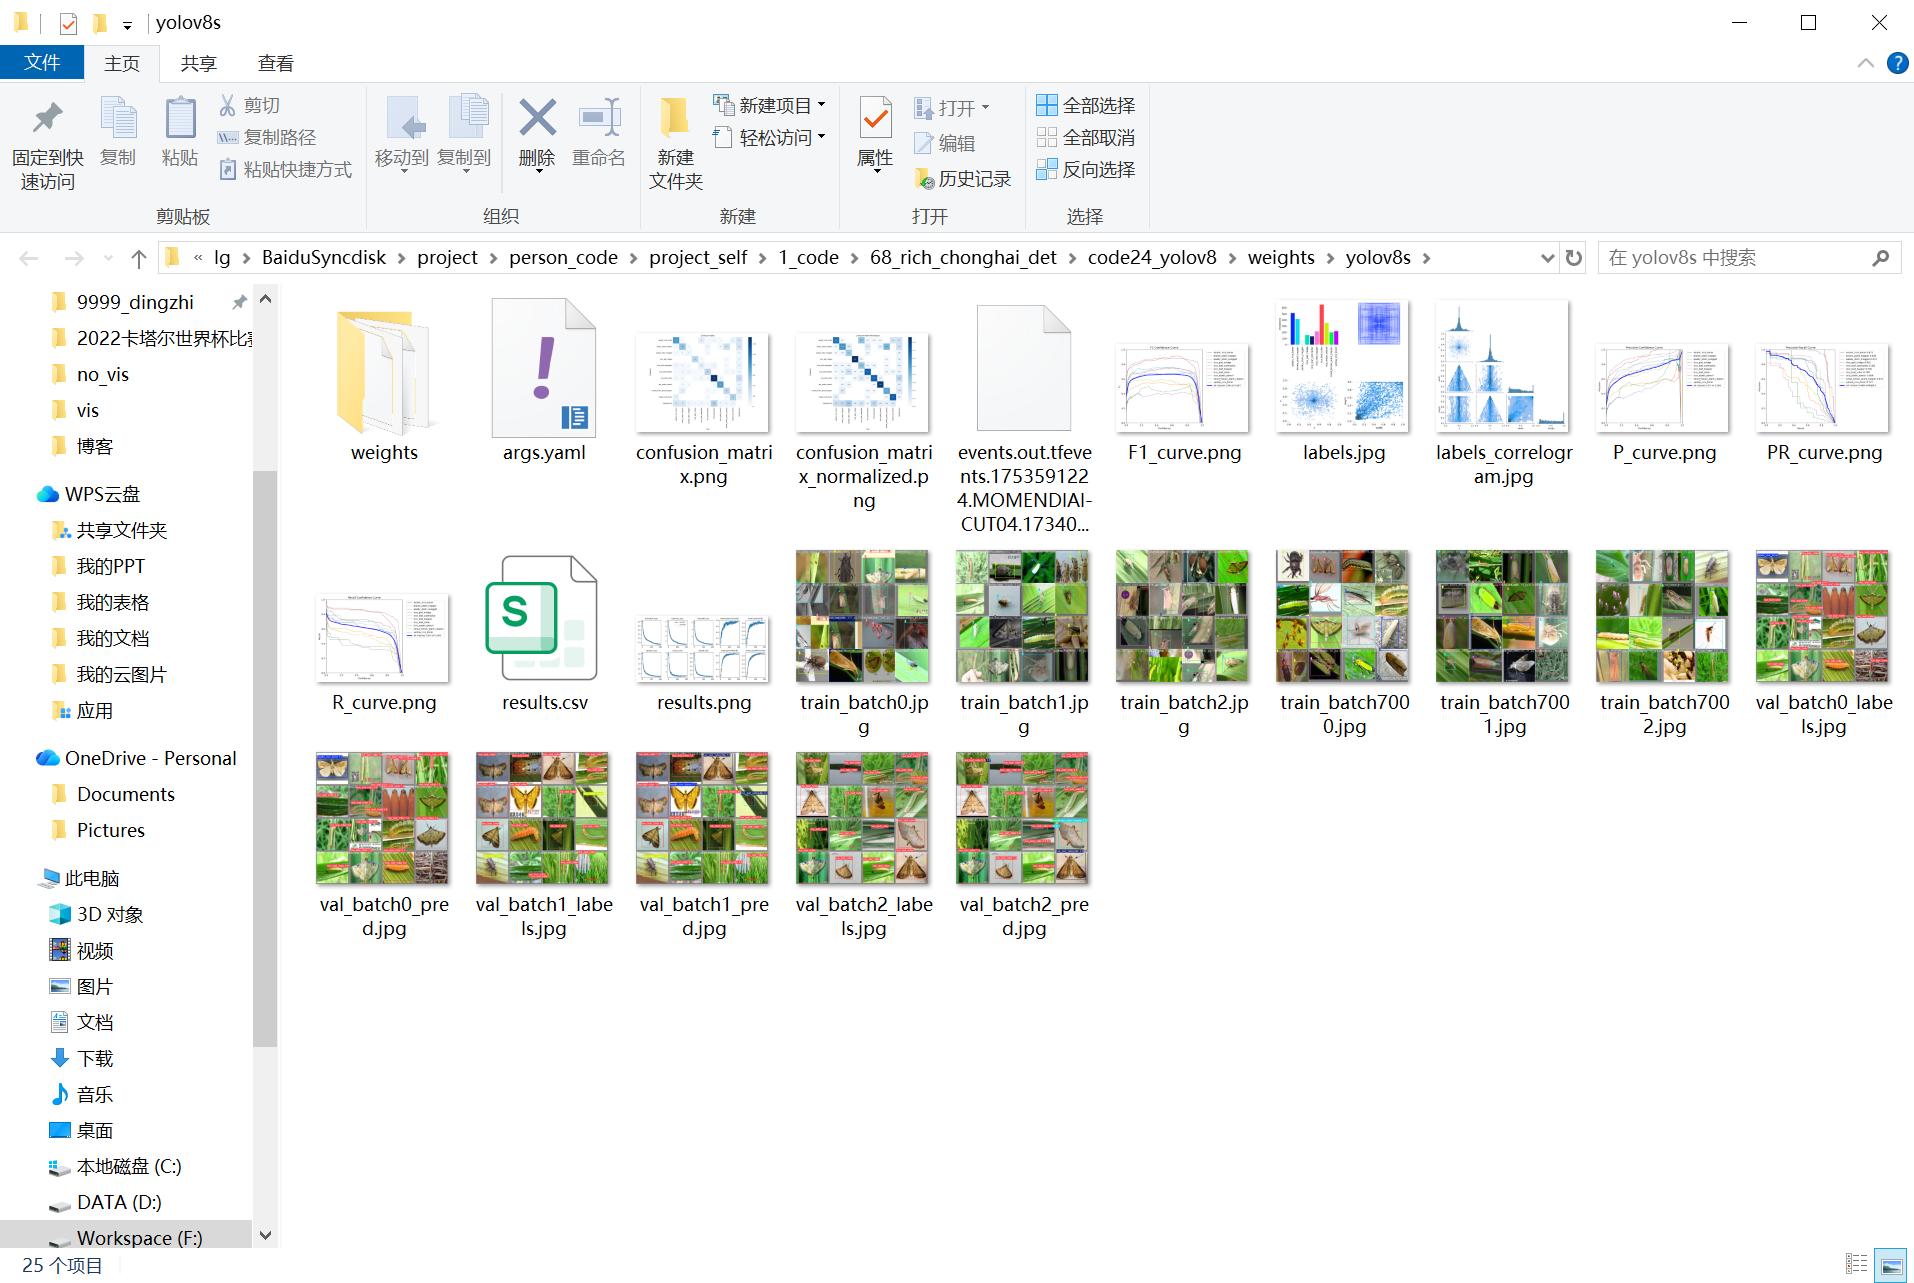
训练结果截图.jpg

训练的曲线图:
训练过程中,模型的关键指标(如损失值、精度、召回率等)变化曲线已自动记录并可视化。从曲线中可以清晰观察到:

  • 训练集与验证集的损失值(Loss)随迭代次数增加逐步下降并趋于稳定,表明模型有效学习到数据特征;
  • 核心评估指标(如 mAP@0.5、准确率)在训练后期逐步收敛,验证集性能与训练集保持一致,无明显过拟合现象;
  • 通过对比不同阶段的指标变化,可直观判断模型收敛速度与稳定性,为参数调优提供参考。
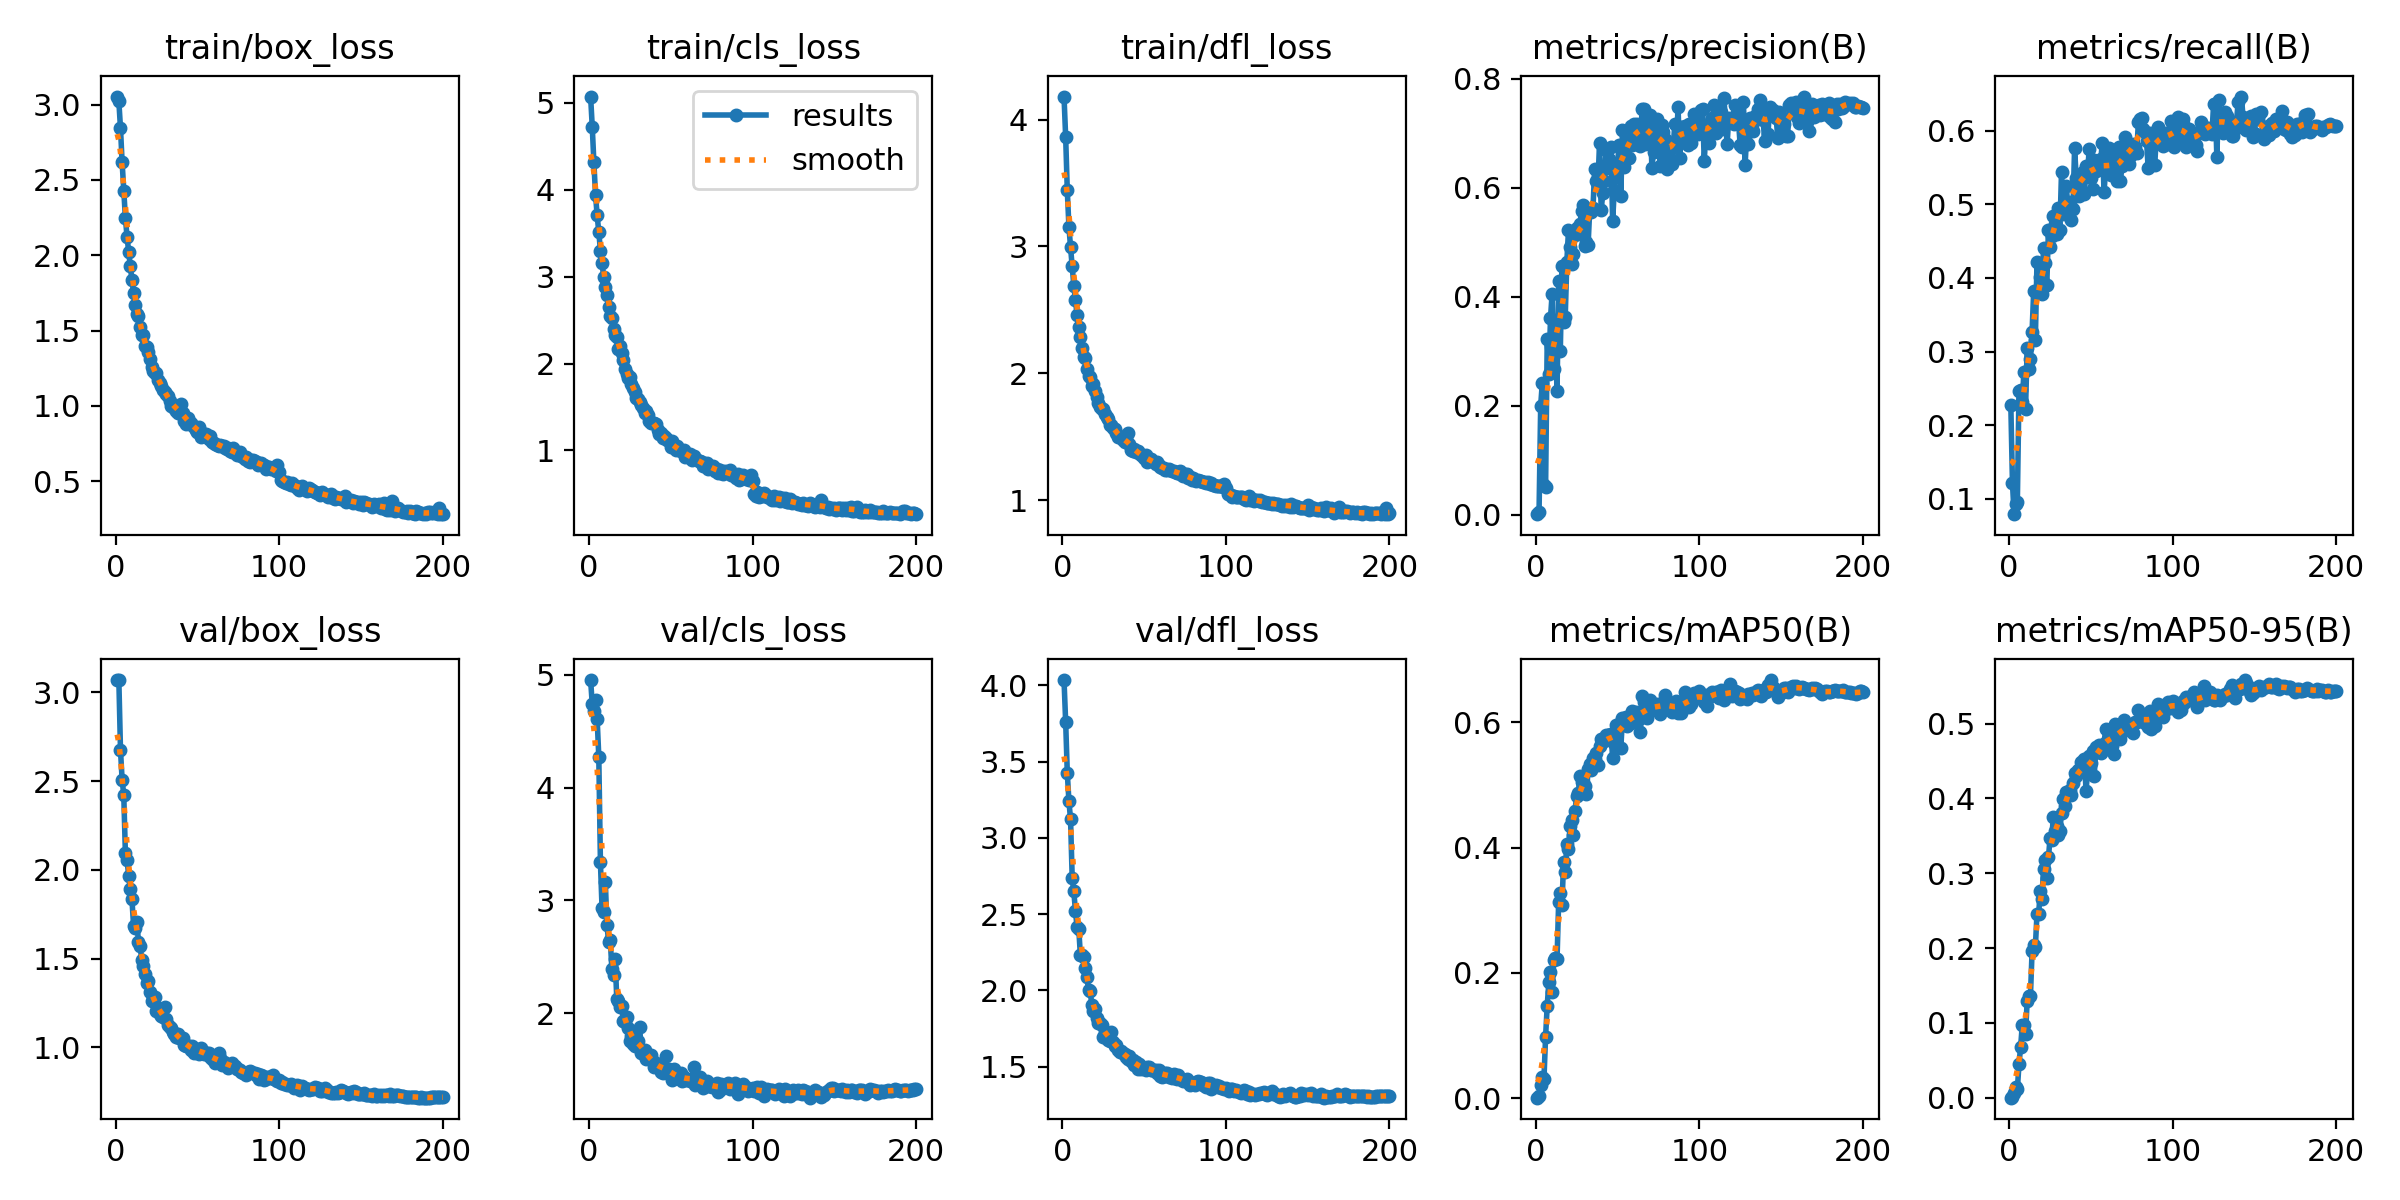
results.png

评估的结果示例图:
为更直观展示模型性能,选取val中具有代表性的样本进行可视化评估,涵盖不同场景、不同目标密度及复杂背景下的检测 / 分类效果:

评估示例图1评估示例图2
val_batch0_labels.jpgval_batch1_labels.jpg

🌟 获取方式说明

这是一套完整的资源,经过往届学长学姐检验过,是OK的项目,我这里就不做过多的介绍了,说的太多了,大家容易看不到。如果想要获取源码进行学习,可观看一下前面 功能展示 章节的视频演示。如有疑问,也可通过下方的名片或者留言进行交流,一起学习、进步。

💡 温馨提示:资源仅用于学习交流,请勿用于商业用途,感谢理解与支持!

基于web的亚热带常见自然林病虫害识别系统——数据集与数据集划分 根据油茶树的生长规律,病虫害的常见性选取炭疽病,炭疽病采集 462 张图像数据,油茶健康采集 149 张图像数据。为了系统能够准确识别出自然生长的树木病虫害的情况,训练模型所采集的数据样本一定要具有代表性,所以树叶的采集对于模型的生成至关重要。本篇文章先为病虫害识别进行数据的分类,划分训练集,划分为三个数据集,病虫害的数据集我已经放在我的资源里面,有需要的小伙伴可以自己下载。在图片采集完成后,过滤掉不清晰的叶片图像,对采集的图片依次进行编号,把叶片进行归类,以便神经网络的训练。 阅读详情

相关推荐

各种病虫害的高清数据集

病虫害高清数据集含有五个类别。jpg格式图片

病虫害检测图像数据集介绍

深度学习——病虫害检测图像数据库

LOLUN9的博客 3997

虫害数据集,包含7种害虫数据集

虫害数据集,包含7种害虫数据集

【数据集+完整源码】【YOLO】病虫害数据集,目标检测病虫害识别数据集 4809 张,YOLO病虫害识别系统实战教程

【数据集】【YOLO】【目标检测】病虫害识别数据集 4809 张,YOLO病虫害识别系统实战训练教程,yolo病虫害识别,包含YOLO/VOC格式标注。 数据集中包含4种分类:names:['Healthy Leaf', 'Leaf Mold', 'Septoria leaf spot', 'Tomato leaf bacterial spot'],表示"健康、霉菌、叶斑、细菌班"。 数据集图片来自国内外网站、网络爬虫、监控采集等; 基于QT的yolo可视化界面详细教程。

CV 小涵的博客,计算机本硕211毕业,研究计算机视觉、模型微调、RAG等方向,收藏有国内外优质数据集,解决视觉相关项目方案,欢迎交流讨论。 1万+

大型虫害图像识别数据集【已标注,约75000张数据】

大型虫害图像识别数据集【已标注,约75000张数据】 分类个数【102】:大米叶毛虫、只水稻茎蛆、亚洲玉米螟、黄米螟、稻瘿蚊、水稻茎蝇等等【具体查看json文件】 划分了训练集、验证集、测试集。存放各自的同一类数据图片。如果想可视化数据集,可以运行资源中的show脚本。 CNN分类网络项目:https://blog.youkuaiyun.com/qq_44886601/category_12056269.html 基于yolov5的分类:https://blog.youkuaiyun.com/qq_44886601/article/details/137408637

农业害虫与植物病害目标检测数据集.zip

数据集介绍:农业害虫与植物病害目标检测数据集 一、基础信息 数据集名称:农业害虫与植物病害目标检测数据集 图片数量: - 训练集:906张 - 验证集:261张 - 测试集:127张 分类类别: - 非洲化蜜蜂、蚜虫、行军虫、褐斑臭虫、菜青虫、柑橘溃疡病、科罗拉多马铃薯甲虫、玉米螟、玉米穗虫、蚂蚁、蜜蜂、甲虫、毛毛虫等13类病虫害 标注格式: YOLO格式,包含边界框和类别标签,支持多目标检测任务 数据来源: 农业场景实地采集的病虫害图像,涵盖作物叶片、茎秆、果实等多部位 二、适用场景 智能农业监测系统: 支持开发田间病虫害实时检测系统,实现无人机/摄像头等设备采集图像的自动分析 病虫害防治应用开发: 用于构建移动端农作物健康监测工具,辅助农民快速识别病虫害并获取防治建议 农业科研创新: 为植物保护算法研究提供高质量数据支撑,推动精准农业技术发展 农业教育培训: 可作为农业院校教学资源,帮助学生学习病虫害识别与分类方法 三、数据集优势 专业场景覆盖: 包含13类高发性农业病虫害,覆盖鳞翅目幼虫(菜青虫/玉米螟)、鞘翅目害虫(甲虫)、同翅目害虫(蚜虫)等主要农业害虫类别 多目标检测特性: 单张图片可包含多个不同类别目标,如同时存在蜜蜂与蚂蚁的生态场景,增强模型实际应用能力 真实农业环境数据: 图像采集自真实农田环境,包含复杂背景、光照变化和虫体多角度姿态 任务适配性强: YOLO标注格式兼容主流检测框架,支持YOLOv5/v7/v8等系列模型直接训练 农业价值显著: 特别包含柑橘溃疡病等植物病害样本,支持作物病害早期发现与防治决策

【叶片病虫害数据集】果树叶片病变识别 机器视觉 Python (含数据集)

叶片病虫害检测数据集是一个专为植物保护研究而设计的重要资源,涵盖了多种植物病害和虫害类型。该数据集包括以下分类:角叶斑病、角斑病、炭疽果腐病、豆锈病、花腐病、灰霉病、叶斑病、果粉病、叶粉病、叶霉病)以及蜘蛛螨。通过这一数据集,可以利用深度学习模型进行病虫害的自动识别与分类,旨在提高农业生产效率和作物健康管理。数据集中包含的丰富样本和多样化特征,能够帮助模型学习有效的特征表示,从而实现准确的病虫害检测。叶片病虫害检测数据集为农业监测、决策支持和精准施药提供了坚实的数据基础,促进了可持续农业的发展。

机器学习,深度学习,计算机视觉爱好者,整理分享技术资料与项目案例。 2260

图像分类数据集:森林中有害昆虫、害虫图像分类数据集(已做数据集划分)

数据包含:森林中有害昆虫、害虫图像分类数据集(已做数据集划分),数据保存按照文件夹保存,经测试,可直接作为图像分类数据集,用ImageFolder打开,无需额外处理。 【数据集介绍】有害生物图像分类,99类别:寒蝉、甲壳虫等等99类别 【数据总大小】105MB 【数据集详情】data目录下分为两个目录,train为训练集、test为测试集,存放各自的同一类数据图片。train数据总数1537,test数据总数344。可以用作yolov5的分类数据集 【json文件】99种林业有害害虫分类的字典文件 为了方便查看数据,提供了可视化py文件,随机传入4张图片即可展示,并且保存在当前目录。脚本无需更改,可以直接运行!

【数据集+完整源码】【YOLO】害虫数据集,目标检测害虫分类识别数据集 3472 张,YOLO农业害虫识别系统实战教程

【数据集】【YOLO】【目标检测】害虫分类识别数据集 3472 张,YOLO农业害虫识别系统实战训练教程,yolo农作物害虫分类识别。 数据集中包含 8 种分类。 数据集图片来自国内外网站、网络爬虫等; 可用于农作物害虫检测。  该数据集含有 3472 张图片,包含Pascal VOC XML格式和YOLO TXT格式,用于训练和测试农田环境、食品工厂环境等场景进行害虫分类识别。 基于QT的yolo可视化界面实战详细步骤。

CV 小涵的博客,计算机本硕211毕业,研究计算机视觉、模型微调、RAG等方向,收藏有国内外优质数据集,解决视觉相关项目方案,欢迎交流讨论。 2814

Unity UI适配实战:从Canvas Scaler到主流游戏适配方案解析

本文深入解析Unity UI适配的核心技术,重点介绍Canvas Scaler组件的关键参数如Reference Resolution和Screen Match Mode,并提供主流游戏适配方案实战分析。通过九宫格拉伸、动态调整等技巧,帮助开发者解决多设备适配难题,提升游戏UI在不同分辨率下的表现。

weixin_29001419的博客 972

EtherCAT APWR报文实战:从站地址配置(0x0010)的初始化流程与报文解析

本文详细解析了EtherCAT APWR报文在从站地址配置(0x0010寄存器)中的初始化流程与实战应用。通过类比物业分配门牌号,生动解释了APWR报文如何高效批量配置从站地址,并深入探讨了0x0010寄存器的特殊作用、初始化步骤及常见问题排查方法。文章结合IgH主站的三从站配置案例,提供了报文解析技巧和调试建议,帮助工程师快速掌握EtherCAT网络配置的核心技术。

weixin_28744423的博客 412

农业病虫害数据集与算法——调研整理

通过博客和文献调研整理的一些农业病虫害数据集与算法。

qq_40481602的博客 2万+

基于STM32的RS485土壤氮磷钾与PH传感器数据采集与OLED显示实战(附完整代码)

本文详细介绍了基于STM32单片机通过RS485协议采集土壤氮磷钾与PH传感器数据的实战项目。涵盖硬件选型、连接方法、Modbus-RTU通信协议解析、STM32程序实现及OLED显示,提供完整代码和调试技巧,适用于农业物联网环境监测系统。

kotlin6android的博客 336

【免费下载】 虫害数据集下载仓库

虫害数据集下载仓库 【下载地址】虫害数据集下载仓库 本仓库提供了一个虫害数据集的下载资源,该数据集包含了7种常见的害虫数据。这些数据对于农业研究、害虫防治以及相关领域的科研工作具有重要价值 项目地址: https://gitcod...

gitblog_09772的博客 1326

2025统计建模大赛完整论文

参赛队号:(参赛队无须填写,参赛队号由大赛官网自动生成)2025年(第十一届)全国大学生统计建模大赛参 赛 作 品参赛学校:XXXXXX大学论文题目:海洋叶绿素含量影响因素与预测——基于机器学习与大数据分析预测参赛队员:指导老师:国家知识产权局 统计分析成果 知识产权统计数据公开查询指引(2024版)随着全球气候变化的加剧,海洋碳汇的作用愈发受到重视,尤其是海洋生物通过光合作用吸收二氧化碳的过程,对于全球碳循环和温室气体减排具有重要意义。

2301_79579117的博客 9318

杰理外挂flash使用教程(四):制作fat32文件系统格式的资源文件

本文档提供了FAT文件系统镜像生成与资源打包的完整指南,包含两种实现方案:推荐的WSL/Ubuntu环境方案和Windows原生方案。详细说明了从创建空白镜像、格式化、资源文件复制到最终打包为设备可用的res.bin文件的完整流程,并对比了FAT32与FAT16的特性差异。文档还包含关键文件说明、使用注意事项和典型应用场景,适用于嵌入式系统开发、固件升级等场景。

qq_42014563的博客 1339

如何使用Yolov8训练使用 农业类虫害害虫目标检测数据集 虫害数据集 并实现可视化及评估 训练集6201张图片,验证集770张图片 15类昆虫和害虫

如何使用Yolov8训练使用 农业类虫害害虫目标检测数据集 虫害数据集 并实现可视化及评估 训练集6201张图片,验证集770张图片 15类昆虫和害虫

QQ_1309399183的博客 1106

汽车标定技术(五)--基于模型开发如何生成完整的A2L文件(1)

A2L文件的生成分为两章讲解:本文主要是讲模型开发,讲解如何把标定量、观测量放到链接文件中的指定位置。下一篇讲解如何使用matlab生成完整的A2L文件

认真搞搞汽车MCU 4618

智慧农业27类害虫识别数据集 智慧林业害虫数据集 农业虫情分析系统 林业害虫智能识别系统 害虫目标检测数据集 作物病虫害早期预警与精准防治第10377期

智慧农业27类害虫识别数据集 智慧林业害虫数据集 农业虫情分析系统 林业害虫智能识别系统 害虫目标检测数据集 作物病虫害早期预警与精准防治第10377期

qq1309399183的博客 282

【仿真技巧】Smart Eye Probe在ADS信号仿真中的应用

Smart_Eye_Probe是一个眼探头,允许灵活数量的输入通道,输入通道支持单端或差分信号的混合,并且,可以使用一个共同的时钟信号触发通道的眼图。目前,仅支持瞬态(Transient)和通道(Channel Sim)逐位模式(Bit by bit)模拟,不支持信道统计(Statistical)模式和DDR总线(DDRSim)仿真。

一只豌豆象的博客 1270

Qwen2.5-VL多模态微调超参数深度解析(上):训练流程与优化策略的量化机制分析

上篇文章通过系统化的对比实验,回答了多模态微调中的三个基础问题:“选什么方法”(LoRA/Full/Freeze/OFT对比)、“用什么配置”(60+组超参数组合)、“达到什么效果”(ROUGE-L/BLEU-4指标)。这些结果为后续工作奠定了实验基线,但也留下了更深层的疑问:为何相同方法在不同数据集上表现迥异?为何某些超参数的微小调整会引发性能剧变?如何在未见过的任务上快速找到最优配置?本文是对前文实验数据的二次挖掘与机理解析。我们将关注点从"做了什么实验"转移到"实验揭示了什么规律",实验视角从"结果对

羊城迷鹿的博客 1005

YOLO水稻虫害识别数据集(16类,近一万张图像)

YOLO水稻虫害识别数据集,包含稻秆蝇、二化螟、褐飞虱、蓟马、蛴螬、蝼蛄等常见害虫,共16个水稻害虫类别,9700多张图像,yolo标注完整,全部原始数据,未应用增强。

m0_73878864的博客 2555

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

第77期 大规模昆虫病害数据集

引言 亲爱的读者们,您是否在寻找某个特定的数据集,用于研究或项目实践?欢迎您在评论区留言,或者通过公众号私信告诉我,您想要的数据集的类型主题。小编会竭尽全力为您寻找,并在找到后第一时间与您分享。 一、重要性及意义 昆虫病虫害识别在农业生产和生态环境保护中具有重要的意义和深远的影响。以下是关于昆虫病虫害识别的重要性及意义的详...

weixin_40848780的博客 229

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

水稻虫害分类数据集使用PyTorch框架进行分类任务,并提供完整的代码示例 分类水稻虫害分类数据集,包含14个类别共8417张图像

水稻虫害分类数据集使用PyTorch框架进行分类任务,并提供完整的代码示例 分类水稻虫害分类数据集,包含14个类别共8417张图像

2401_88440984的博客 1100
上一篇: 67-基于深度学习的大棚黄瓜检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版
下一篇: 69-基于深度学习的轴承缺陷检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版
Python图像识别-1
博客等级 码龄2年 1010粉丝 199原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值