Meta-Harness实战入门基础教程(非常详细),彻底搞懂整套Harness自动进化,收藏这篇就够了!

OpenViking上下文数据库Golang集成实践 技术创新文件系统范式:将AI Agent的上下文管理从扁平向量存储提升为结构化文件系统分层检索策略:L0/L1/L2三层加载机制,减少62.1%的Token消耗记忆自迭代:会话提交触发Agent经验沉淀,实现越用越智能工程实践完整Golang实现:提供生产级可用的OpenViking客户端库企业级集成方案:涵盖文档摄入、检索、会话管理等全流程性能优化成果:检索准确率提升24.1%,响应时间减少53.3%可观测性提升可视化检索轨迹:实现检索过程的白盒化,调试效率提升77.1%全面监控指标。 阅读详情

一句话先看懂

这篇工作要解决的问题很直接:在 LLM 系统里,真正决定效果的往往不只是模型权重,还包括外围的 harness(记什么、检什么、怎么喂给模型的代码)。作者提出的 Meta-Harness,不再依赖手工改规则,而是让 coding agent 在完整历史日志上自动搜索更优的 harness 实现,最终在文本分类、数学推理、Agent 编程三个场景都取得了显著收益。


1. 论文在解决什么核心痛点?

过去大家做 harness engineering,常见流程是:

  1. 人工查看失败样例
  2. 判断可能的改动点
  3. 小幅修改 prompt / memory / retrieval 逻辑
  4. 重新运行评测

问题在于,这种流程既慢又依赖经验,而且失败原因通常跨多个步骤才显现,单看最终分数很难定位问题。

作者指出,现有 text optimizer(如 OPRO、TextGrad、GEPA、OpenEvolve、TTT-Discover)在这个场景下经常不够用,关键原因是反馈被压缩得过于严重:

  • • 只看标量分数
  • • 只看短摘要
  • • 只看当前候选,不看全历史

而 harness 是一个长链条行为系统,诊断必须结合 代码 + 执行轨迹 + 历史候选关系 才能有效完成。

2. 方法核心:Meta-Harness 到底怎么工作?

2.1 目标形式化

作者把 harness 优化写成:

其中:

  • • :固定不变的 base model
  • • :待优化 harness(代码实现)
  • • :任务样本
  • • :rollout 轨迹
  • • :任务奖励(准确率、通过率等)

核心是:在固定模型下,直接寻找系统表现最好的 harness 程序。

2.2 外循环(outer loop)

Meta-Harness 的循环非常“朴素但关键”:

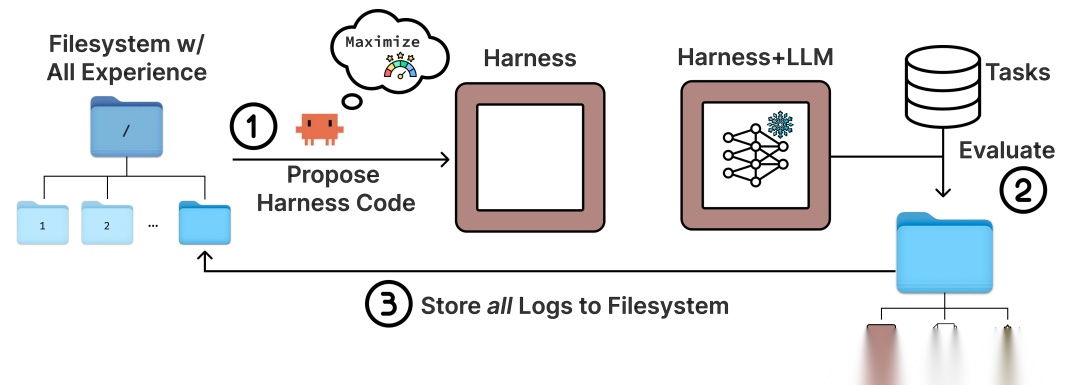
  1. proposer(coding agent)读取历史文件系统
  2. 提出新的 harness 代码
  3. 运行评测并记录代码、分数、执行轨迹
  4. 持续迭代,最终在 Pareto frontier 上选解

它的关键设计不是复杂的进化算子,而是 全历史可检索文件系统。proposer 可以用 grep/cat 等操作按需取证,而不是把所有历史一次性塞进 prompt。

2.3 为什么这比“摘要反馈”更强?

作者给出一个有说服力的量级对比:

  • • 先前方法每步反馈通常在 100~30,000 tokens 级别
  • • 本文某些评测单次可产生约 10,000,000 tokens 的诊断信息

这意味着 Meta-Harness 把优化对象从“短文本提示”升级成了“可执行系统 + 可追溯历史”。

3. 方法图解

图解:这张图展示了 Meta-Harness 的三步闭环:左侧是 proposer 在文件系统中读取历史候选的代码、分数与 traces;中间是生成新 harness 并执行评测;右侧把新一轮 artifacts 写回文件系统。横向是迭代时间,纵向可理解为“经验累积深度”。核心不是一次性大上下文,而是可反复检索的外部记忆。
4. 实验结果:三个场景都赢了什么?

4.1 在线文本分类:更准且更省上下文

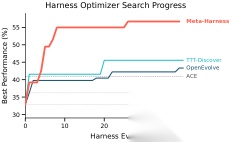
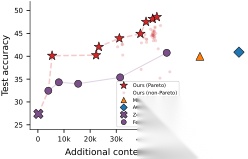
  • • 相比 ACE,Meta-Harness 测试准确率提升 +7.7 points(48.6% vs 40.9%)
  • • 上下文成本显著下降(11.4K vs 50.8K tokens)
  • • 与 OpenEvolve / TTT-Discover 相比,约在 1/10 评测量 就达到对方最终水平,并最终再高 10+ points

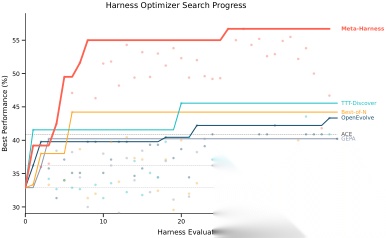
图解:左图是学习曲线。横轴是评测次数(evaluation count),纵轴是准确率。Meta-Harness 曲线前期爬升更快,约 4 次评测就接近对比方法后期水平,说明它不是“多试出来”,而是“每次提案质量更高”。
图解:这张 Pareto 图横轴是上下文 token 成本(越左越省),纵轴是准确率(越高越好)。Meta-Harness 前沿整体位于其他方法“左上方”,表示同等成本下更准,或同等准确率下更省。
4.2 IMO 级数学推理(检索增强):跨模型迁移有效

单次搜索得到的 retrieval harness,在 5 个 hold-out 模型上相对“无检索”平均提升 +4.7 points。
它甚至整体优于固定 BM25 基线(平均再高 1.3 points),并避免了 dense retrieval 在部分模型上的退化。

4.3 TerminalBench-2(Agent 编程):自动超过强手工基线

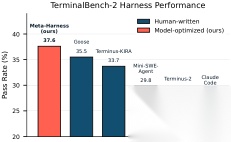
  • • Opus 4.6:76.4%,超过 Terminus-KIRA(74.7%)
  • • Haiku 4.5:37.6%,超过已报道的 next-best(35.5%)

图解:右图是 TerminalBench-2 排行。纵轴可理解为 pass rate,横向是不同 agent/harness。Meta-Harness 在 Haiku 4.5 组达到榜首,在 Opus 4.6 组也进入最前列,说明自动搜索已经具备“挑战顶级手工工程”的能力。
5. 消融结论

作者做了一个非常关键的 interface ablation(在线文本分类):

  • • Scores Only:中位 34.6,最好 41.3
  • • Scores + Summary:中位 34.9,最好 38.7
  • • Full Meta-Harness(含原始 traces):中位 50.0,最好 56.7

结论很明确: execution traces 是决定性信息源。只给分数或摘要,会丢失“为什么失败”的因果线索。

6. 行为证据:它真的在做因果诊断

论文在 TerminalBench-2 的搜索轨迹里展示了 proposer 的行为演化:

  1. 早期把“结构修复 + prompt 改写”同时改动,结果连续退化
  2. 第 3 轮明确识别混杂因素:真正有害的是 prompt cleanup 改写
  3. 随后通过隔离变量进行验证
  4. 最终转向“更安全的增量改动”(环境快照注入),拿到最好结果

这说明 Meta-Harness 不是随机 mutation,而是在历史证据上进行“可解释的错误归因 + 策略转向”。

图解:这张完整学习曲线横轴仍是评测次数,纵轴是搜索集准确率,并按数据集显示 best-so-far 轨迹。Meta-Harness 早期就跨过基线区间,后续持续抬升而非震荡,体现了“利用历史经验进行稳定改进”的特征。
7. 三个已发现的 harness 模板

7.1 文本分类 harness

  • • Draft Verification:先给草稿标签,再检索支持/反例做二次验证(低成本)
  • • Label-Primed Query:先显式暴露标签空间,再构造覆盖样本 + 对比样本(高精度)

7.2 数学检索 harness

按题型路由到 combinatorics / geometry / number theory / default 四条检索策略,不同路由采用不同 rerank 与去重策略,而不是“一套检索打天下”。

7.3 TerminalBench harness

最有效改动之一是“环境快照 bootstrap”:在第一轮推理前就告知 agent 可用语言、包管理器、目录结构、内存等,减少前几轮盲探测。

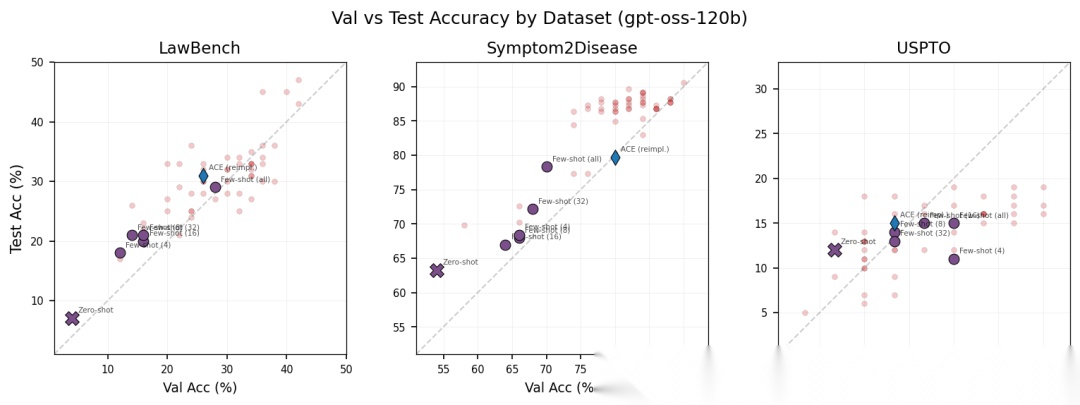
图解:这张图横轴是 search-set 表现,纵轴是 test-set 表现,虚线为 。散点整体贴近对角线,表示搜索指标与最终泛化高度一致,说明发现的策略不是单纯“刷搜索集”。
8. 结论与方法论判断

  • • 这篇论文真正的创新点不是“又一个优化器”,而是把优化接口升级为 可检索的全历史经验库。
  • • 它把“调 Prompt”问题提升为“调程序策略”问题,更符合 Agent 系统的真实工程形态。
  • • 在当前阶段,这类方法对 proposer 能力依赖较强(文中主要使用强 coding agent),但随着 coding agent 能力提升,收益很可能继续放大。
  • • 从实践角度,作者给出的建议非常实用:先写好 skill、构建困难 search set、日志结构化、先做轻量验证再跑重评测。

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

用AI学习graphify Graphify是一个AI驱动的知识图谱构建工具,能够将代码、文档、论文、图像和视频等多模态数据转换为结构化知识图谱。其核心技术特点包括: 多模态处理能力: 支持25+编程语言的AST解析 处理PDF、Markdown等文档 集成Whisper进行音视频转录 高效知识提取: 采用确定性AST解析与LLM语义提取结合 相比直接读取源文件,查询token消耗最多减少71.5倍 增量更新机制仅处理变更文件 智能分析功能: 自动识别高中心性的"上帝节点" 发现跨领域的"意外连接&quo 阅读详情

相关推荐

到底什么是Harness工程?一篇文章从入门到企业落地全解析

随着OpenClaw爆火,Harness Engineering(驾驭工程)成为AI编程时代的热门概念,很多小白对其感到陌生。本文用通俗类比和真实案例,避开复杂术语,从基础定义入手,讲清Harness Engineering的核心逻辑——人类工程师设计“约束系统”(马具),让AI模型(烈马)安全高效地完成代码工作,同时拆解其核心组件、企业落地场景和实战成果,帮小白快速入门,读懂这项能解放人力、提升效率的新技术,轻松掌握它的核心价值和落地思路。

program哲学 3269

基于RAG的企业智能客服项目,已拿70万offer!

基于 RAG 构建一套企业智能客服系统📖。

m0_59164520的博客 1445

别再只盯着CXL协议了,聊聊CXL.mem里那个能动态调优内存性能的‘QoS遥测’到底怎么用

本文深入解析CXL.mem协议中的QoS遥测功能,探讨如何通过DevLoad指标动态调优内存性能。文章详细介绍了QoS遥测的核心机制、多QoS类别设备的实战配置,以及AI训练、金融交易和视频处理场景中的优化案例,帮助数据中心实现高效内存资源管理。

weixin_33725722的博客 436

从Vibe Coding到可控生产力:Harness Engineering的实践启示

摘要:OpenAI提出的Harness Engineering(工程化治理)理念为AI Agent时代的软件工程提供了关键方法论,旨在解决代码高产出下的质量闭环、上下文管理等核心矛盾。其三大目标包括重构工程师角色、将AI纳入可控体系、实现低成本纠错,通过六大举措(如角色重构、机械化约束、反熵机制等)重构工程流程。该理念与vibe coding高度互补,既保留灵感驱动的敏捷性,又通过工程化体系保障稳定性,最终推动工程师从"代码生产者"升级为"工程体系设计者"。

小程故事多的博客 4400

燧原科技云燧ESL64-O超节点:国产AI芯片与OEX光互联架构解析

分布式AI训练通过将计算任务拆分到多个节点并行执行来加速模型训练,其核心原理涉及数据并行和模型并行等策略。在技术价值层面,分布式训练能显著提升大规模深度学习任务的效率,但传统GPU集群常因网络通信瓶颈导致性能受限。OEX光互联架构作为解决通信瓶颈的关键创新,采用硅光技术实现高带宽、低延迟的节点内互联,优化了AI训练中的集合操作。这种硬件级优化特别适用于千亿参数大模型训练和科学计算等场景,能有效降低AI集群的总体拥有成本(TCO)。云燧ESL64-O超节点正是基于国产自研AI芯片与OEX架构的集成方案,为大规

weixin_29071809的博客 371

MTK metadata中AF模块的移除与配置调整

本文详细介绍了在MTK平台Camera开发中如何移除metadata中的AF(自动对焦)模块。通过系统清理MTK_CONTROL_AF_REGIONS、MTK_CONTROL_MAX_REGIONS等关键配置项,并调整对焦模式及硬件特性声明,确保定制化设备在禁用自动对焦功能后的稳定运行。

q1w3e5r7t9y的博客 570

Meta-Harness实战入门基础教程(非常详细):用TaoToken统一Key打通Harness自动进化链路,收藏这篇就够了!

Meta-Harness 让 coding agent 自动搜索更优 harness 实现,核心是全历史可检索文件系统与原始执行轨迹。本文用 TaoToken 统一 Key 接入 LLM,从 config.toml、settings.json 到 run_harness.py 逐步搭起可运行骨架,跑通提案、评测、写回闭环。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42515842的博客 143

SAP ABAP CO核心扩展-ZCKMLQS 多物料工厂的评估数量结构报表(CKMLQS)

CKMLQS 只能查看单一物料工厂的评估数量结构,SAP 没有提供多物料工厂的评估数量结构报表。这篇文章将实现 CO核心扩展-ZCKMLQS 多物料工厂的评估数量结构报表。

SAP李斌,本人承诺所有原创文章均不使用任何AI生成技术,请大家放心阅读。 1089

MetaCaster:用Agent元学习自动编排少样本时序预测管线

时序预测是机器学习中极具挑战的任务,尤其在样本量稀缺时,深度模型难以发挥优势,而传统统计方法又无法充分捕捉数据模式。元学习为这类少样本问题提供了新思路,通过让模型学会“如何学习”,从而在有限数据上快速适应新任务。与此同时,Agent机制在自动化决策与管线编排中展现出强大潜力,将元学习与Agent结合,即可对数据预处理、特征工程、模型选择及后处理等整个预测流程进行端到端优化。这种自动化机器学习策略能够在冷启动、边缘计算等场景中帮助轻量级预测器快速落地,降低对人工调参经验的依赖。MetaCaster正是这一方向

weixin_34205826的博客 348

cherry使用MCP协议Streamable HTTP实践

摘要:Streamable HTTP协议是针对传统HTTP+SSE传输方式的改进方案,解决了连接恢复、服务器资源占用和单向通信等问题。该协议基于普通HTTP实现,支持无状态服务器、纯HTTP服务和多轮对话,同时兼容现有基础设施。通过演示展示了服务端和客户端的配置方法,体现了其灵活性和实用性。MCP(多轮对话协议)作为扩展LLM能力的关键技术,代表着未来交互式AI的发展趋势。

全网120W+关注AI拉呱,专注人工智能以及科技前沿! 563

【AI智能体】QClaw 对接GitHub处理自动化任务实战操作详解

QClaw 对接GitHub处理自动化任务实战操作详解

congge 4869

大模型工程化:从Prompt到Harness,驾驭AI生产力新时代

大模型工程化三大范式:提示词工程、上下文工程与驾驭工程 摘要:随着大模型技术的成熟,行业焦点转向如何实现能力稳定落地。文章系统阐述大模型工程化的三大范式:提示词工程(Prompt Engineering)作为基础,通过标准化指令引导模型输出;上下文工程(Context Engineering)通过信息注入解决知识边界与幻觉问题;驾驭工程(Harness Engineering)构建全链路管控体系。三者呈递进互补关系,共同支撑生产级应用。当前趋势呈现三大特点:自动化Prompt优化、多模态场景融合、体系化管控

m0_63171455的博客 1852

手把手教你学Simulink——基于自动驾驶辅助系统的场景实例:车道保持辅助系统(LKA)的仿真与实现

本文通过Simulink实例讲解车道保持辅助系统(LKA)的实现方法。首先介绍LKA从预警到主动控制的技术演进,阐述其系统架构、核心组件和工作原理。重点演示基于自行车模型的车辆横向动力学建模过程,以及使用线性二次调节器(LQR)设计横向控制器的详细步骤。教程包含四个仿真场景测试,分析关键指标如控制精度、舒适性和响应性。最后探讨LKA技术的发展方向,强调人机协同的安全理念。该实例为自动驾驶辅助系统开发提供了完整的Simulink实践方案。

MHD0815的博客 182

graphify构建代码知识库,一行代码搭建属于自己的知识图谱

graphify 是一个将任意文件夹(代码、文档、图片、视频等)转化为可查询知识图谱的工具。它的核心理念是:与其让 AI 逐文件读取,不如先把所有内容构建成一张图,让 AI 按图索骥。 你可以把它理解为一个"代码库地图生成器"。输入一个项目目录,它会分析所有文件,提取概念、关系、调用链,然后用可视化的方式呈现给你。更重要的是,这张图是可以查询的——你可以问"认证模块和数据库之间有什么关系",而不需要自己去 grep 几十个文件。

努力前行,总会成为自己心中的那道光 8539

OpenCV-Python实战(11)——OpenCV轮廓检测相关应用

在计算机视觉领域,轮廓通常指图像中对象边界的一系列点。因此,轮廓通常描述了对象边界的关键信息,包含了有关对象形状的主要信息,该信息可用于形状分析与对象检测和识别。在本文中,我们将学习如何利用获取到的轮廓,进行形状分析以及对象检测和识别。

盼小辉丶的博客 1万+

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

GitNexus 核心引擎深度解析

GitNexus 核心引擎深度解析:GitNexus 是一个将代码库转换为可查询知识图谱的系统,由索引流水线、社区检测和混合搜索三大子系统组成。索引流水线通过9个阶段将代码转换为知识图谱,支持多语言解析和并行处理。社区检测采用Leiden算法进行功能聚类,流程追踪则通过BFS算法从入口点生成执行流程。混合搜索结合关键词和语义搜索,使用RRF算法融合结果。系统优化包括Worker池并行解析、语言感知导入解析、调用关系置信度计算等,实现了高效的代码分析与搜索能力。

2841

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Harness Engineering:2026年最被低估的工程革命

2026年2月,OpenAI的工程师Ryan Lopopolo在官方博客发布了一篇看似平淡的技术文章。文章描述了一个内部实验:一个3人小组,用5个月时间,构建并上线了一个拥有百万行代码的生产级产品。

xx_nm98的博客 1089

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Harness Engineering(驾驭工程)核心解析

Harness Engineering(国内常译“驾驭工程/管控工程”)是2026年Agent开发领域爆火的新一代工程化范式,是AI工程化从“提示工程→上下文工程”之后的第三次范式跃迁,核心解决Agent在生产环境中长期可靠运行的核心痛点。

weixin_58753619的博客 1401

Graphify从入门到精通(非常详细),彻底搞懂下一代AI知识库,看这一篇就够了!

Graphify是一款开源命令行工具,由开发者captainkink07在Andrej Karpathy发文后连夜构建。它能将任意文件夹一键转化为持久化知识图谱,支持19种编程语言,与Claude Code深度集成,实现每次查询减少71.5倍token消耗。上线48小时内获得逾6000个GitHub星标,零遥测、无厂商锁定,数据永不离机。

m0_59164520的博客 7445

驾驭未来:零基础读懂“驾驭工程”(Harness Engineering)

在混乱中建立秩序,在复杂中寻找路径。

举世誉之而不加劝,举世非之而不加沮,定乎内外之分,辩乎荣辱之境,斯已矣。 2520

OpenViking 深度解析:字节跳动为 AI Agent 设计的上下文数据库

OpenViking 是字节跳动火山引擎 Viking 团队于 2026 年 1 月开源的上下文数据库(Context Database),专为 AI Agent 设计。。把 Agent 所需的一切——记忆、资源文档、技能说明——统一抽象为"文件",组织在一个虚拟文件系统中,通过专属协议viking://进行寻址和访问。OpenViking 解决的是真实存在的问题,技术思路也有其创新之处——用文件系统范式统一管理 Agent 上下文,L0/L1/L2 分层加载在 token 效率上确实能做到显著优化。

潇汀 2381

一文分清用法Dify-Plugin与SkillS

很多人会把插件(Plugin)和Skill(技能)混为一谈,二者看似都是为应用拓展能力、实现更多功能,核心定位、适用范围、使用方式却有着明确差异。

legend24and8的博客 1850

dify查询接口响应到默认的图表渲染

之后走两条线,一条线流式响应返回数据分析的回复,另一条线走图表生成线,负责生成合适的图表。由于ECharts图表生成插件,支持生成的图表有柱状图,线形图,饼图,那么我们可以设置一个问题分类,然后对于数据分类的结果再做模型数据的抽取。在工作流中新建接收http请求的节点,用以接收http请求体数据。实现的效果:可以根据请求体自定义生成合适的图表数据。数据输入:来自于http请求体的数据。插件:ECharts图表生成插件。

qq_43781332的博客 812

AI(四): 工具 (GitNexus、CLI-Anything、 OMO: Oh-My-Openagent, OMO: oh-my-codex、 OpenSpec、 Superpowers)

GitNexus 是一款能够将代码库转化为可查询知识图谱的智能工具。它的核心能力可以概括为三点:解析 —— 基于 Tree-sitter 深度解析代码,提取函数、类、变量之间的调用与依赖关系建图 —— 将代码结构存入 KuzuDB 图数据库,构建完整的代码知识图谱适配 —— 通过 MCP 协议与 Claude 等 AI 智能体无缝对接,提供结构化代码上下文。

Men-DD 2853

Harness Engineering深度指南(非常详细),软件工程转型控制系统设计,从入门到精通,收藏这一篇就够了!

George 提到 **Harness engineering** 这种模式已经出现了三次: * 第一次是在 18 世纪 80 年代,詹姆斯·瓦特(James Watt)发明了离心调速器(Centrifugal governor)。 * 第二次是在 Kubernetes 出现。 * 第三次是 OpenAI 提出的 Harness engineering。

m0_59235945的博客 1034

MCP和Skill的区别

MCP与Skill是智能系统的两个关键维度:MCP(多通道平台/处理器)作为底层架构,负责整合多模态交互渠道(如语音、文本)和计算能力;Skill则是基于MCP的具体功能模块(如"查天气""设闹钟")。核心区别在于:MCP关注系统级资源调度与跨渠道协同,为Skill提供运行环境;Skill聚焦单一任务的精准执行,依赖MCP的底层能力。二者的关系如同"舞台与演员",MCP提供基础设施,Skill实现具体功能,共同构建完整的智能交互体系。

m0_53830442的博客 2219
上一篇: 20260403_151844_字节大模型二面:Agent的记忆覆盖问题如何解决?
下一篇: Harness工程搭建入门到精通:手把手教你搞定Claude Code智能体,看这篇就够了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值