别再让AI“自由发挥”了!手把手教你配置LLM输出,让AI回答精准可控,这篇干货太顶了!

Prompt工程本质:7种可复现的AI指令设计策略 大语言模型并非黑箱,而是依赖统计规律响应的思维引擎;Prompt的本质不是自然语言提问,而是融合角色定义、长度控制、结构约束与输出协议的工程化指令集。理解其背后对注意力机制、token分配策略和解码偏好的影响,是提升AI输出质量的核心。本文聚焦真实业务场景中验证有效的7类Prompt干预方法——从角色锚定激活语域权重,到禁止项清单实现logits层面抑制,再到上下文锚定构建领域知识坐标系,覆盖教育、法律、医疗、政务等多行业落地需求,为技术实践者提供即插即用、原理清晰、参数可控的AI人机协作工作流。 阅读详情

提示词工程中的 LLM 输出配置

输出参数决定了 LLM 的“边界与风格”,工程化配置是高质量 AI 产出的关键。

在大语言模型(LLM, Large Language Model)应用中,输出行为并非仅由模型本身决定,而是由一组可调参数共同塑造。提示词(Prompt)定义任务意图,输出参数则决定生成边界。工程系统中,输出参数与提示词同等重要,直接影响稳定性、可控性、性能与成本。本章以体系化视角对输出控制进行建模,避免碎片化解释,建立一套可复用的参数选择框架。

下方结构图展示了 LLM 在一次生成过程中,各类输出参数的应用顺序与层次。
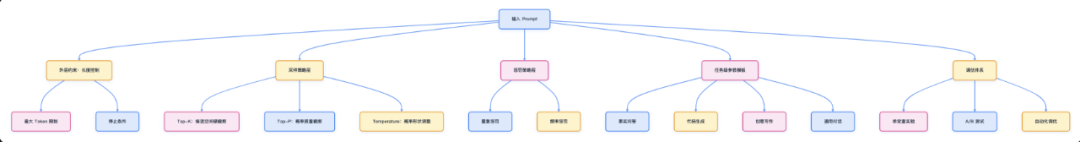
LLM 输出参数应用流程

一、 输出长度控制:生成边界的外层约束

输出长度控制是 LLM 生成内容的最硬边界,决定了模型可使用的 token 上限和生成终止条件。

最大 Token(Maximum Tokens)

最大 Token 限制模型生成的最大长度,是成本、速度和内容完整性的直接约束。

下表总结了不同任务类型的推荐 Token 范围及风险说明:

任务类型推荐 Token风险说明
问答50–200过短可能造成关键句缺失
代码生成200–1000增大延迟,易触发截断
长文写作500–2000成本上升,注意分段生成

表 1: 最大 Token 推荐值与风险说明

最大 Token 的关键作用是保证任务不会因模型的“自由展开”导致成本不可控。工程环境中通常将其作为服务级别策略(SLO, Service Level Objective)的一部分,而不是用户可随意配置的选项。

停止条件(Stop Sequences)

停止条件用于指定特定 token 或字符串,当模型生成到该内容时立即停止。

应用价值包括:

  • 强制结构化输出(如 JSON 对象末尾)
  • 避免模型继续冗余描述
  • 规避生成循环或模板化重复

停止条件是面向生产环境的工具,在构建 Agent、API、函数调用模式时尤其关键。

二、采样参数:从概率分布中选择输出的策略层

采样参数决定模型如何在下一 token 的概率分布中选择实际输出,直接影响回答的确定性、可控性与创造性。

采样策略由三个核心变量组成:

  • Temperature
  • Top-K
  • Top-P (Nucleus Sampling)

Temperature:概率分布尖锐度

Temperature 用于调整概率分布,使分布更集中或更平坦。

下表总结了不同 Temperature 范围的行为模式与应用场景:

Temperature 范围行为模式应用场景
0.0–0.3高确定性、强一致性事实问答、代码生成
0.3–0.7平衡模式通用对话
0.7–1.0+高随机性创意写作、头脑风暴

表 2: Temperature 配置与应用场景

Temperature 是最常用的采样控制项,也是最容易误调的参数。过高会导致语义漂移,过低会导致重复或僵硬。

Top-K:候选空间的硬截断

Top-K 限定仅在概率最高的前 K 个候选词元中采样。

  • K 小 → 输出稳定、变化小
  • K 大 → 多样性增加,但可能引入噪声

下表总结了不同任务类型的推荐 K 值:

任务类型推荐 K
事实类1–10
代码10–30
创意写作40–100

表 3: Top-K 推荐值

Top-P:动态截断概率质量

Top-P 按概率累积分布截断候选集合,是比 Top-K 更柔性的采样策略。

下表总结了不同任务类型的典型 Top-P 配置:

任务类型Top-P
精确任务0.1–0.3
平衡任务0.7–0.9
多样性任务0.9–1.0

表 4: Top-P 推荐值

Top-P 和 Top-K 可以单独使用,也可混合,以 Top-P 为主导。

三、参数组合:构建任务级输出模式

实际工程中不会单独依赖单个参数,而是构成一组任务模板。

下表总结了多数 LLM 服务的默认策略基准:

任务类型TemperatureTop-KTop-P目标特性
事实问答0.1–0.21–50.1–0.3稳定、无偏差、确定性输出
代码生成0.2–0.510–300.5–0.8语法一致性、少量探索
创意写作0.7–1.040–600.8–0.95生成性、多样性强
通用对话0.3–0.710–400.6–0.9平衡性最佳

表 5: 任务类型参数组合推荐

组合策略的核心思想是:Temperature 决定行为风格;Top-P 与 Top-K 决定搜索空间规模。

四、惩罚机制:减少重复、防止模式化输出

模型在长文、对话、摘要任务中容易出现重复,惩罚机制用于修正这种行为。

Repetition Penalty

Repetition Penalty 用于降低模型重复出现的词元概率。

推荐区间:1.1–1.3

主要用途:

  • 长文生成
  • 避免段落重复
  • 避免“无限循环式回答”

Frequency Penalty

Frequency Penalty 用于惩罚高频词,使输出语义分布更均衡。

推荐区间:0.1–0.3

主要用途:

  • 内容多样化
  • 头脑风暴
  • 避免简单复述输入

五、调优方法:从默认值走向稳定产线配置

输出参数调优不应依赖直觉,而应采用工程化流程。

单变量调优(One-Variable-at-a-Time)

每次只调整一个参数,观察输出变化。适合初始探索与小模型调优。

A/B 对比

两套参数在同一输入上跑对比,判断准确性、完整性、格式稳定度。适用于构建 API、插件、企业场景。

自动化调优(Parameter Tuning Pipeline)

通过脚本对多组参数组合进行网格搜索或随机搜索,形成自动化调优流程。

典型步骤如下:

  1. 构造样本输入集
  2. 批量运行参数矩阵
  3. 记录指标(准确、相关、差异度)
  4. 固化最优组合为默认策略

这是生产级 RAG(Retrieval-Augmented Generation)与 Agent 系统中最重要的调优步骤。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

文心智能体平台实战指南:从零代码到业务闭环的智能体开发 智能体(Agent)是大模型落地企业服务的核心形态,其本质是将自然语言理解、结构化知识、确定性逻辑与外部系统深度协同的可执行单元。原理上依赖意图识别、知识检索增强(RAG)与工作流编排三重能力,技术价值在于提升业务确定性、降低AI幻觉风险、实现人机协同增效。典型应用场景覆盖客服自动化、合规问答、产线质量预警、教育辅导等需强业务嵌入的领域。本文基于百度文心智能体平台真实项目经验,深入解析零代码配置、低代码干预与工作流编排三层架构,并聚焦中文语义理解、知识库治理、百度生态分发等关键实践难点。 阅读详情

相关推荐

用本地化大语言模型打造专业播客工作流

播客制作正经历从人工主导到人机协同的范式迁移。大语言模型(LLM)作为新一代内容生产力引擎,其核心价值不在于替代创作,而在于承担信息压缩、结构转述、合规初筛等可验证、可审计的中间层任务。依托Qwen2.5-7B等轻量化开源模型,在消费级显卡上实现端到端本地推理,兼顾语义精度与输出稳定性;结合结构化Prompt工程、语音友好度评分(VFS)与三层合规预审机制,显著提升脚本一次通过率与听众收听完成率。该方案已成功支撑37期中文科技播客《技术褶皱》稳定产出,单期制作耗时压缩至6.2小时,适用于独立创作者、知识IP

weixin_34248023的博客 446

MVU框架详解

Model-View-Update(简称MVU)是一种函数式响应式架构模式,最初由Elm语言引入并推广,也被称为"The Elm Architecture"(TEA)。MVU提供了一种简洁、可预测且高效的方式来构建用户界面应用程序,特别是前端Web应用。本文将深入探讨MVU架构的核心概念、工作原理、优势以及在各种编程语言和框架中的实现。MVU架构的核心思想非常简单:将应用程序的状态(Model)、展示逻辑(View)和状态转换逻辑(Update)严格分离。

冰茶的博客 2991

大语言模型与搜索引擎的本质差异:信息检索原理与实操边界

信息检索是计算机科学的基础能力,其核心在于理解用户意图、匹配知识源并验证结果可信度。传统搜索引擎基于倒排索引与网页权威性排序,强调可追溯的链接证据链和实时索引更新;而大语言模型依赖统计语言建模与上下文推理,擅长语义重构与多步任务处理,但存在幻觉控制难、时间感知弱、验证路径缺失等固有局限。二者并非替代关系,而是互补工具:前者适配事实核查、权威静态型与即时动态型查询,后者在长尾问题诊断、自然语言处理与个性化上下文推理中具备不可替代价值。本文结合47天真实交叉查询日志,揭示LLM与搜索引擎在技术原理、响应机制与验

weixin_34318326的博客 342

如何让大模型的输出长度可控?Meta AI开源新方法

文章通过提出LIFT方法,目标是减少模型评估中的“长度偏差”,提高模型遵循用户指令的生成长度约束的能力,使得大模型在实际应用中提供更多的可控性。PS:给公众号添加【星标⭐️】不迷路!您的。

具身机器人和通用AI 4186

OpenChat 7B开源模型深度解析:轻量级对话模型的工程实践与本地部署

语言模型(LLM)作为当前AI应用的核心组件,其选型需兼顾性能、成本与可控性。7B参数规模的模型正成为边缘部署、私有化场景与低延迟服务的关键折中方案——它既规避了13B以上模型对高端GPU的依赖,又显著优于传统小模型在指令遵循与逻辑推理上的能力边界。OpenChat-3.5-1210作为基于Mistral-7B的开源对话模型,通过条件式RLFT训练范式与专家数据+次优数据协同学习策略,在AGI-Eval等结构化评测中超越ChatGPT-3.5,尤其适用于代码生成、知识问答、日志解析等确定性任务。本文聚焦其技

weixin_30855099的博客 402

信号完整性基础04:串扰(1)

我们理解了“单个”传输线(传输线是信号路径+回流路径,切记~),但大多数情况下单独“传输线”的情况并不多见(理想情况下的同轴线缆可以算一个),大多数我们PCB板上有成百上千条走线,它们组成了一个“大社会”,就如当年的TVB神剧《创世纪》一样,到处充满着恩怨情仇;稍处理不慎,单板这个“社会”就会崩溃。那么我们要从哪里入手去理解它呢?最基本的就是从两条PCB走线(传输线)之间的串扰开始。好,年前倒数第二章:《为什么会有串扰》。 ps:我们了解了x射线是啥,那么今天开始讲“放射线”,这两种东西是否就是同一种呢~

WKEZHENG的博客 6034

4种控制LLM大模型输出JSON的方法

JSON 是全球使用最广泛的数据交换格式之一,支持我们的所有需求。在构建人工智能驱动的应用程序时,工程师不可避免地需要将大型语言模型(LLM)的输出集成到他们的代码库中。通过指示 LLM 使用特定的语法或模式,然后输出应用程序所需的生成结果,我们可以使应用程序的行为更加可预测。简而言之,JSON 的互操作性使其成为数据交换的首选。

新缸中之脑 2万+

LeGO-LOAM运行kitti数据集

文章目录1. kitti-lego-loam2. 改动3. 实验结果4. evo轨迹测评 1. kitti-lego-loam 链接:kitti-lego-loam kitti-lego-loam提供了将kitti序列转化成rosbag的代码,在kittibag中. 需要注意下数据文件的存放顺序,以00序列为例: datafolder          |____results          &

Zlp19970106的博客 8704

『深度长文』4种有效提高LLM输出质量的方法!

微调的首要步骤是数据的收集和标注。成功的微调依赖于一个。

2401_85378759的博客 1348

DPABINet保姆级教程:零代码完成脑网络分析与图论计算

本文提供DPABINet的零代码脑网络分析全流程指南。该工具通过图形化界面集成时间序列提取、连接矩阵构建、图论指标计算及统计分析,大幅降低技术门槛。重点解析了阈值选择、二值化与小世界属性计算等关键步骤,帮助研究者快速掌握脑网络分析与图论计算,提升科研效率与可重复性。

j2k3l4的博客 668

伪距单点定位算法原理以及利用最小二乘法计算实例

即该公式:建立下列代价函数满足最佳估值的条件为:即:可解得未知参数 X 的最佳估值由于每个可见卫星观测量的精度可能不一样,这时,需要对不同观测量赋予一个权重系数,称为加权。

qq_43381998的博客 1万+

对过往四年大模型的使用体验以及思考

本文作者回顾了四年AI工具使用历程,从搜索引擎式应用到构建多模型协同系统的演进。文章详细记录了四次AI能力断层的体验差异,揭示了提示词工程、上下文管理等技术细节。作者提出核心观点:AI幻觉是概率系统的固有特性,应通过工程化手段管理而非消除;提示词工程应从系统架构层面理解;行业竞争正从技术实现转向需求理解。文章总结了"在不确定中探索确定"的方法论,强调通过输入控制、输出校验使AI行为收敛到期望区间,为AI应用开发提供了实践框架。

2401_84804288的博客 551

ARINC429协议分析

如下表所示,ARINC429在发送一帧过程中,首先发送以START开始,以END结束,共发送32bits数据,其中0~7bits为Lable数据,9~8bits为SDI数据,10~28bits为数据,29~30bits为SSM,31bit为校验位End30292827262524校验位SSM2322212019181716DATA15141312111098SDI7654321Start。

5223

LLM评估体系设计:质量、任务、安全、体验四维框架

大语言模型(LLM)评估已从简单指标计算升级为系统性工程实践。其核心在于超越BLEU、ROUGE等传统文本相似度指标,转向以业务目标为锚点的多维评估范式——涵盖文本基础质量、任务目标达成度、安全与合规、用户体验四大不可妥协维度。这一框架强调‘先定义靶心再选工具’,通过模型评估器保障稳定高效、LLM评估器处理复杂语义、规则引擎守住安全底线,并以动态权重、置信度机制和人工校准实现可解释、可归因、可迭代。尤其在金融、医疗、政务等高敏场景中,事实准确性与合规风险必须前置为一票否决项,而非事后补救。

weixin_34006468的博客 544

【深度学习基础】一篇弄懂训练集、验证集和测试集(呕心沥血版)

在深度学习中,训练集、验证集和测试集是构建和评估模型的核心组成部分。训练集用于模型的学习和参数优化,验证集帮助调整超参数和防止过拟合,而测试集则用于最终评估模型的泛化性能。正确划分和使用这三类数据集,对于开发高效、可靠的深度学习模型至关重要。本文将深入解析它们的作用、划分方法以及在实际应用中的注意事项,帮助你全面理解并掌握数据集的科学使用方法,从而提升模型的实际表现。

十二月的猫 3792

DPABISurf使用教材

严老师的官方教程:http://rfmri.org/Course DPABISurf版本:dpabi50docker.tar.gz MATLAB版本:2018b 一、数据准备 (1)如果是数据的DICOM格式,整理成以下格式(注意文件夹的命名方式): 如果觉得不是很清楚,可以在官网下载Demo数据(http://rfmri.org/DemoData),参照里面的文件格式进行整理即可。 (2)如果数据是nii格式,整理成以下格式: 这里没有使用官网的demo数据进行学习,而是..

从事脑科学核磁共振方法学研究,在Nature communications等权威期刊发表研究论文,熟练掌握磁共振处理方法和统计学方法,欢迎大家和我交流。 8520

测试工程师也能做的 AI Agent:Skill 开发 + MCP 封装实战

以Web服务形式部署,支持公网/内网多设备、多Agent远程调用,可配置权限、鉴权、日志监控,适配团队共享、线上正式使用,唯一缺点是需要处理HTTPS、CORS、权限校验等工程化问题。MCP只管接口调用、鉴权、重试、异常处理。:日常功能测试、UI测试、线上问题复盘,支持多张截图批量解析、批量生成Bug草稿,可一键同步Jira、TAPD、禅道、飞书项目及自研缺陷平台。行业通用标准结构,包含头部元数据、角色定义、强制执行SOP、固定输出模板、约束禁令、工具调用规则,结构统一、可读性强、方便导入各类AI客户端。

qq_44936442的博客 351

猿创征文|SfM(Structure from Motion)学习之路

SfM全称Structure from Motion,译为运动恢复结构,是三维重建pipeline的一部分,又称稀疏重建,在摄影测量领域则称为空三(空中三角测量)。SfM的任务是,给定一系列具有一定重叠度的图像,去同时估计出拍摄每张图像时相机的的位姿(位置t和姿态R)和被拍摄物体或场景的稀疏点云。...............

zeeq的博客 1万+

ReACT框架:让大模型从‘会说话’走向‘能干活’的推理-行动范式

ReACT(Reasoning + Acting)是一种面向实际任务的AI智能体架构范式,核心在于将大语言模型的推理能力与外部工具调用能力闭环耦合,突破传统模型仅依赖静态知识、无法实时交互与执行的局限。其原理基于‘思考→行动→观察→再思考’的迭代认知循环,通过结构化意图锚定、工具签名约束和状态感知驱动,保障逻辑可验证、执行可追溯、结果可落地。技术价值体现在显著降低AI工程化门槛,使非程序员也能用自然语言定义业务流程;典型应用场景包括库存预警、智能客服、金融风控、政务咨询等需多步骤决策与系统联动的领域。本文深

weixin_30567225的博客 421

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

AI内容分发操作系统:Newsletter最小闭环实战指南

Newsletter作为一种轻量级、高可控性的内容分发载体,正成为AI技术传播的关键基础设施。其核心原理在于构建用户注意力、行为数据与转化路径完全自主的闭环系统,规避平台算法与流量不确定性带来的损耗。相比多平台分发,单点深耕可显著提升工程师用户的打开率、代码复制率与信任留存,技术价值体现在极低的启动成本、可验证的执行结果和实时反馈驱动的内容迭代。典型应用场景包括独立开发者建立技术影响力、小团队验证AI产品MVP、以及内容创业者突破‘有干货无渠道’瓶颈。本文聚焦AI生成内容如何通过Newsletter实现从‘

dianan0938的博客 467

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

RAGAs评估框架:量化检索增强生成系统健康度的四大指标

检索增强生成(RAG)是一种将外部知识检索与大语言模型生成能力结合的关键技术范式,其核心挑战在于评估不依赖标准答案、可归因、可工程闭环。RAGAs(Retrieval-Augmented Generation Assessment)通过Faithfulness(忠实度)、Answer Relevance(答案相关性)、Context Relevance(上下文相关性)和Context Precision(上下文精准度)四个正交维度,实现对RAG pipeline推理过程的细粒度诊断。它摒弃传统BLEU/RO

weixin_30325487的博客 354

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

确定性多代理招聘系统:可解释、可复现的雇佣决策框架

在技术外包与自由职业协作场景中,'谁该被雇佣'本质上是一个多目标权衡问题——涉及成本、时效、质量与风险的结构化评估。传统AI招聘工具常依赖黑箱模型,导致决策不可追溯、结果不可调试;而TaskBounty DAO提出一种新范式:以确定性规则引擎为底层核心,将价格归一化、工期约束、质量代理值、风险量化等业务逻辑显式建模,再通过LLM作为可信翻译层生成自然语言解释。这种‘逻辑可审计+表达可理解’的混合架构,既规避了数据饥渴与幻觉风险,又支撑起真实工程团队对责任归属、过程回放与权重实验的刚性需求,为中小技术组织提供

cuiji1279的博客 409

大模型选型避坑指南:GPT-4 Turbo、Claude 3与Llama 3实测对比

大语言模型(LLM)作为当前AI应用的核心底座,其选型直接决定系统成本、响应速度与业务可靠性。理解模型代际演进原理(如上下文扩展、多模态支持、推理优化),有助于识别虚假版本宣传;技术价值体现在token效率、任务成功率与工作流适配度的平衡,而非单纯参数升级;典型应用场景涵盖编程辅助、长文档处理、私有知识增强等,需结合API稳定性、本地部署可行性与合规要求综合决策。本文基于GPT-4 Turbo、Claude 3 Sonnet及Llama 3-70B三类真实可用模型,提供可复现的压测数据与工程落地路径,聚焦‘

weixin_33937778的博客 516

GPT-5.5 Pro 实战指南:从提问者到任务发起人的工作流重构

大语言模型已从‘问答工具’演进为具备意图理解、插件调度与过程校验能力的智能协作者。其核心原理在于动态剪枝推理、意图预判式插件调用和双通道输出验证,技术价值体现在显著压缩端到端任务交付周期,降低人工串联成本。典型应用场景覆盖代码即服务、研究即报告、文档即系统、会议即行动等高生产力闭环。GPT-5.5 Pro 不仅提升响应效率,更重塑人机协作契约——用户角色由提问者升级为任务发起人,模型则承担轻量级项目管理职能。本文聚焦真实工作流中的行为模式、高价值场景链路与关键避坑策略。

weixin_34268753的博客 444

用IPO偏好优化实现高精度语义标签生成

语义标签是文本理解与下游应用(如BI分析、工单路由、聚类搜索)的关键中间表示,其本质是将非结构化文本压缩为可读、可区分、保真度高的语义单元。传统方法依赖人工标注或规则引擎,面临一致性差、泛化弱、难以维护等瓶颈;大模型直接Prompt生成则存在格式失控、语义漂移、结果不可解释等问题。Identity Preference Optimization(IPO)通过构建‘优质vs劣质’标签对,让模型内化质量判据,兼顾格式规范性与语义准确性。该技术无需海量标注,支持轻量微调与4-bit量化部署,已在电商评论、SaaS

weixin_30731305的博客 367

从0到1掌握 .NET Comet:MVU架构下的跨平台UI开发新范式

你是否还在为Xamarin.Forms的繁琐绑定而烦恼?是否厌倦了MVVM模式中大量的INotifyPropertyChanged样板代码?Comet框架——这款基于.NET MAUI构建的MVU(Model-View-Update)架构UI工具包,正以革命性的声明式语法和自动数据绑定能力,重新定义C#跨平台开发体验。本文将带你全面掌握Comet的核心原理与实战技巧,从环境搭建到高级组件开发,让你

gitblog_00865的博客 797
上一篇: 给AI“考题”换个计分方式,谷歌SigLIP让多模态模型学得又快又好!
下一篇: AI“内卷”太严重?谷歌级框架COCOM出手,让AI团队学会高效沟通,告别“摸鱼”!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值