


一、RAG 基本概念
RAG 即 Retrieval-Augmented Generation(检索增强生成)的缩写。
- Retrieval 检索
- Augmented 增强
- Generation 生成
它的概念是:利用检索的技术,来增强整个 LLM大语言模型 的回复质量。
- 检索什么:检索和我们问题相关的专业领域知识。
1.1 为什么要有 RAG,它是用于解决什么问题
首先要了解 LLM大语言模型的缺点。
- 专业领域知识不足。LLM大语言模型背后涉及了预训练,后训练,强化学习。但这些训练的数据集通常来说是通用的世界知识,对于某一个专业领域的知识其实是不足的。
- 信息过时。大语言模型以前还存在 “信息过时” 的问题,例如大语言模型不知道今天发生的事情。但现在各大模型已经通过 “联网搜索” 解决。
- 幻觉问题。幻觉即大语言模型一本正经的胡说八道,一本正经源于LLM训练数据集的 “自信”,胡说八道意味着LLM确实不知道问题的答案。但现在各大模型也通过 “允许LLM回答不知道” 和 “联网搜索” 解决。
- 安全性问题。这包括了数据安全(企业的机密信息不能上传LLM),输出安全(敏感/违法/歧视性内容 或者 违反企业合规或审计要求)等。
RAG 主要针对 “专业领域知识不足” 这个点。当询问 LLM 的时候,除了自己问题,使用 RAG 检索相关的 “专业领域知识”,再把相关的 “专业领域知识” 发送给 LLM,这样 LLM 就能根据 “专业领域” 知识回答得更准确。
1.2 为什么不能把整个专业领域知识给 LLM,而需要先检索一下?
原因一:Token 长度有限
整个专业领域知识是很长很多的。给到LLM的时候,这些专业领域知识需要转成 token,才能让 LLM 进行 “预测”。这个 token 长度是有限的,不是无限的。
一般来说,1个中文约等于1个token。例如现在知名度较高的模型:GPT-5 支持 27万的输入token;Gemini 100 万 token;Claude Sonnet 4 支持 50万 token;DeepSeek 支持 12万多的 token。
原因二:成本问题
token 意味着成本,意味着钱。如下是各个模型的价格:
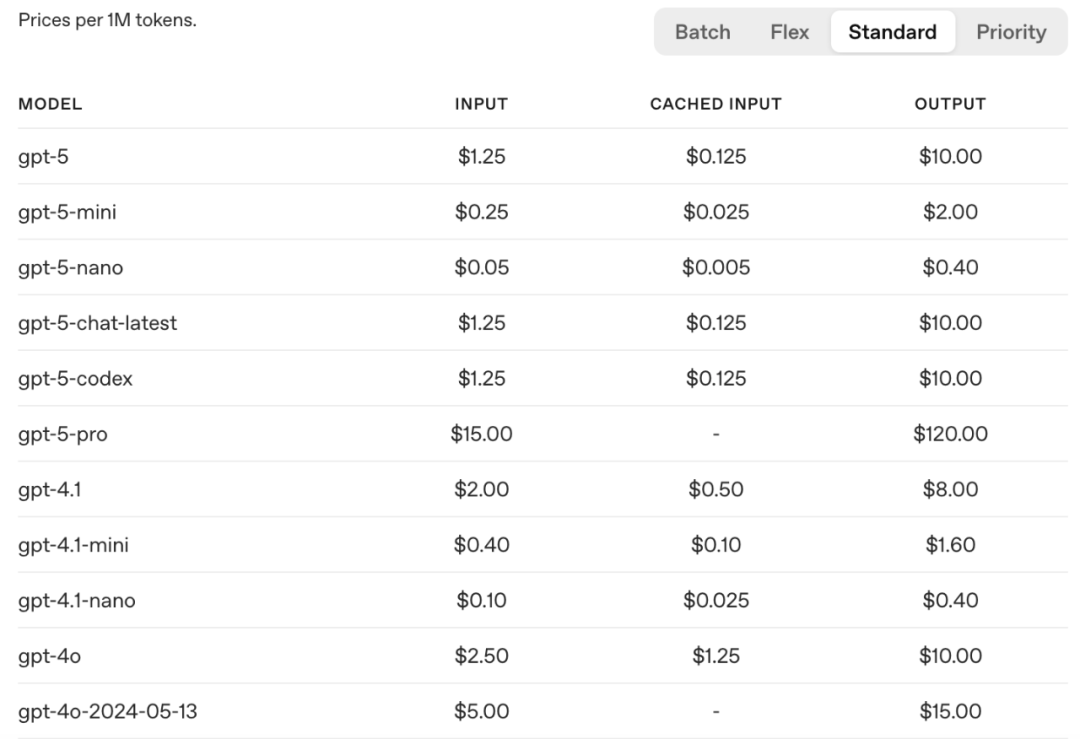
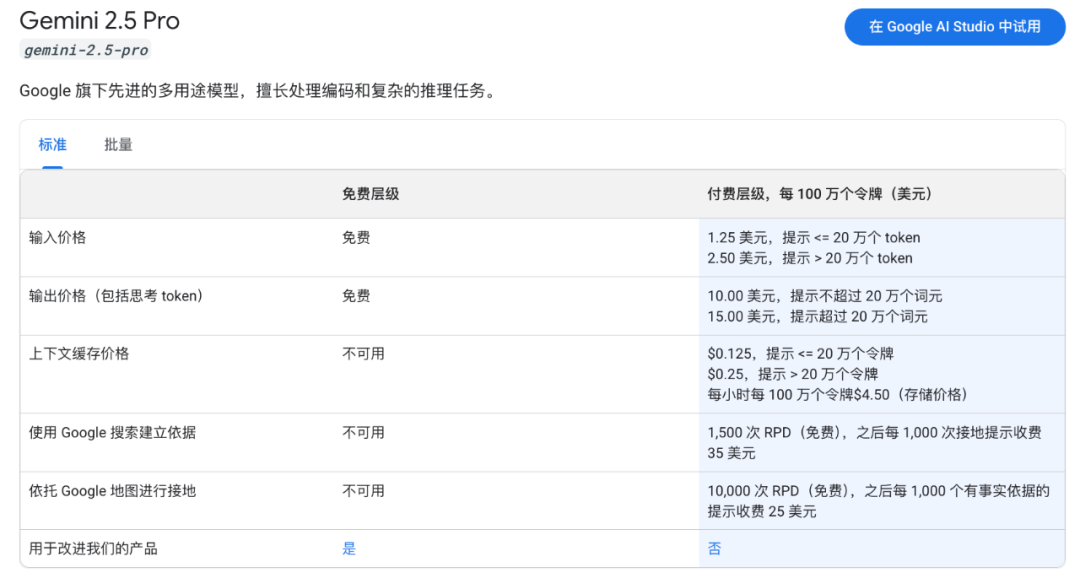
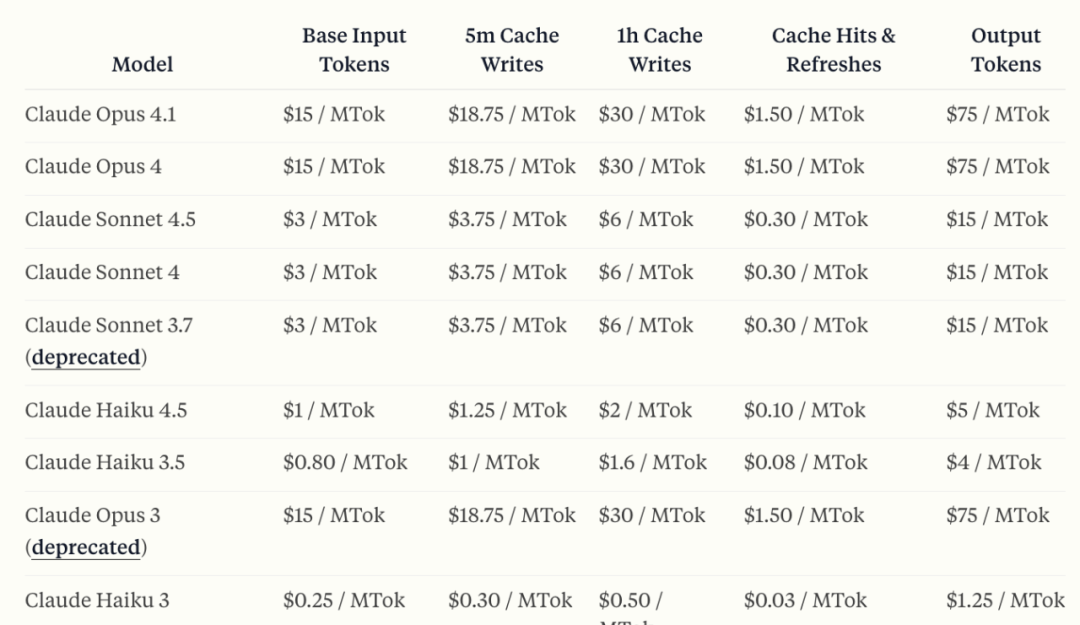
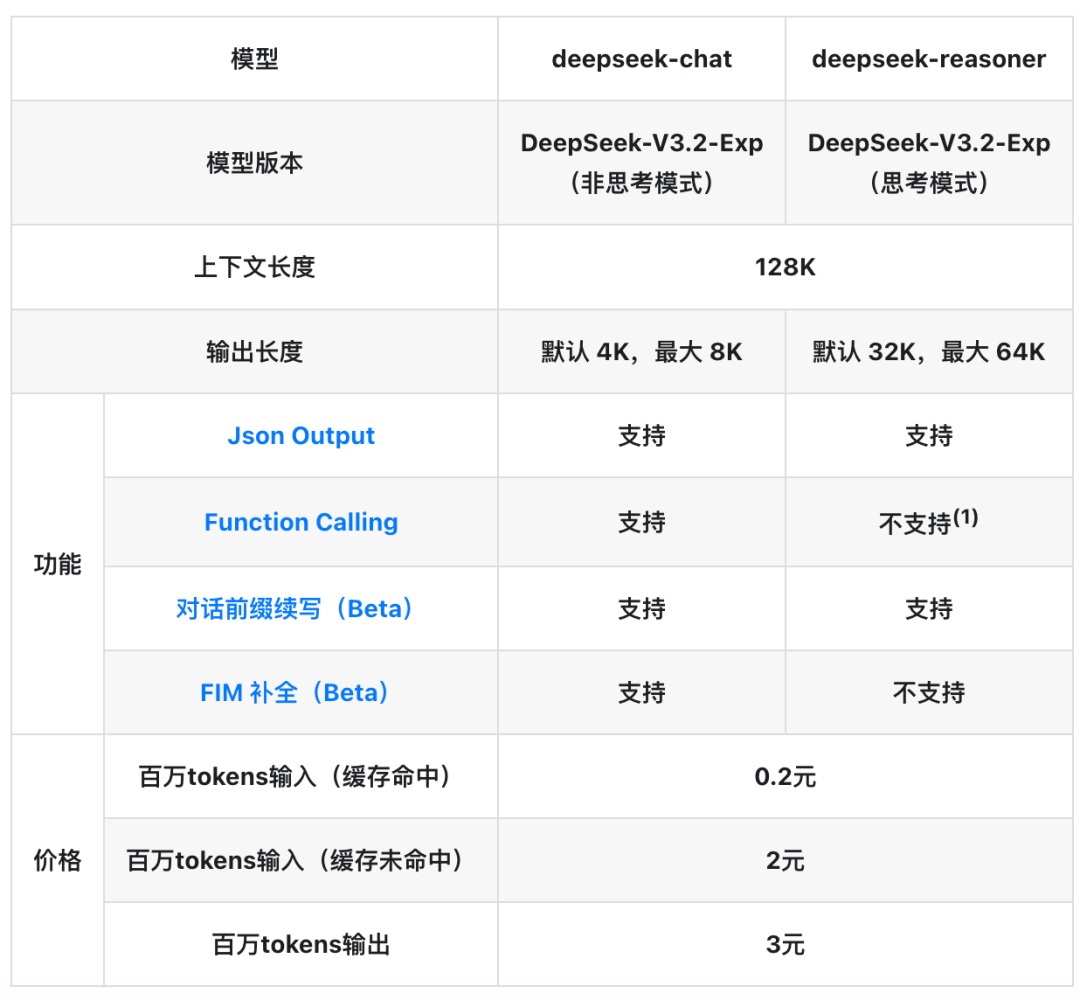
原因三:效果不好。参考 Dify 指定分段模式 :
即便部分大模型已支持上传完整的文档文件,但实验表明,检索效率依然弱于检索单个内容分段。
1.3 RAG 整体流程
参考 《极客时间》的《RAG 快速开发实战》的一张图:
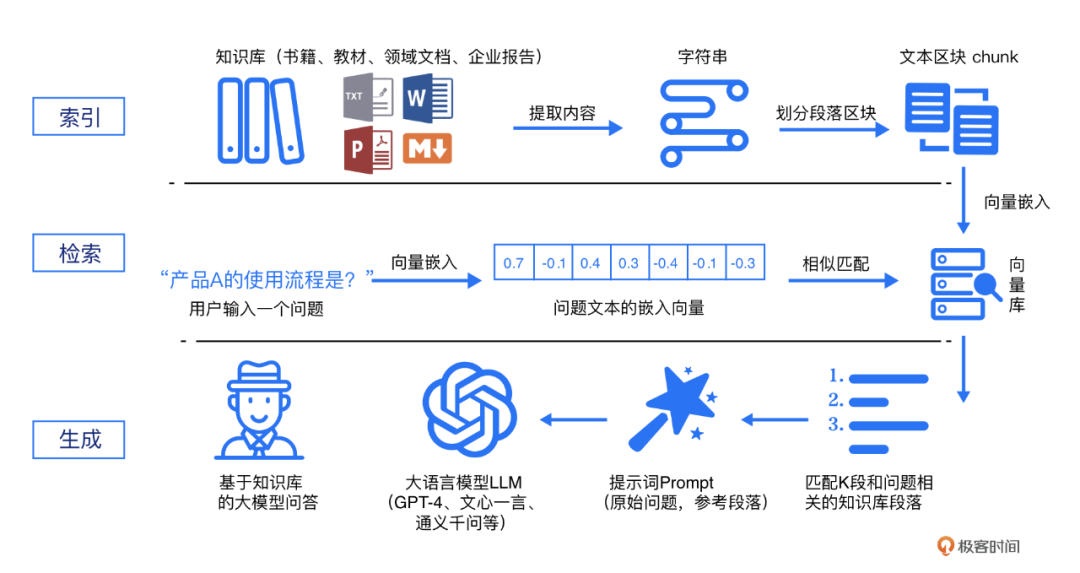
完整流程包括了:
- 数据清洗:上传 “专业领域知识” 文档,预处理内容(去除无意义的字符或者空行等)(这涉及到 ETL 的技术)。
- chunk 分块:把文档 “分块”(也成分段),切分成 chunk。
- Embedding 嵌入:把切分成chunk的内容 嵌入到向量数据库中(即)。
- 检索:根据用户提出的问题,检索向量数据库,查询出相关的专业领域知识。
- 生成:把用户提问的问题 和 专业领域知识 结合发送 给 LLM 大语言模型。
二、数据清洗
数据清洗的主要目的是:让原始知识文档变成 “干净可用” 的数据。这里会涉及到 ETL 的概念。
2.1 ETL
ETL 即 Extract(抽取),Transform(转换),Load(加载)。
- Extract 抽取:负责从不同的数据源系统中“拉”数据。
- Transform 转换:负责将原始数据转化为干净数据。
- 提取正文,去除 HTML 标签,脚注、目录页。
- 去除空行、控制字符、广告类文本。
- 规范化时间、单位。
- …… 等等。
- Load 加载:负责将处理好的数据导入目标系统。
在 LangChain 中,有各类 Loader,这些 Loader 则承担了 ETL 的职责。
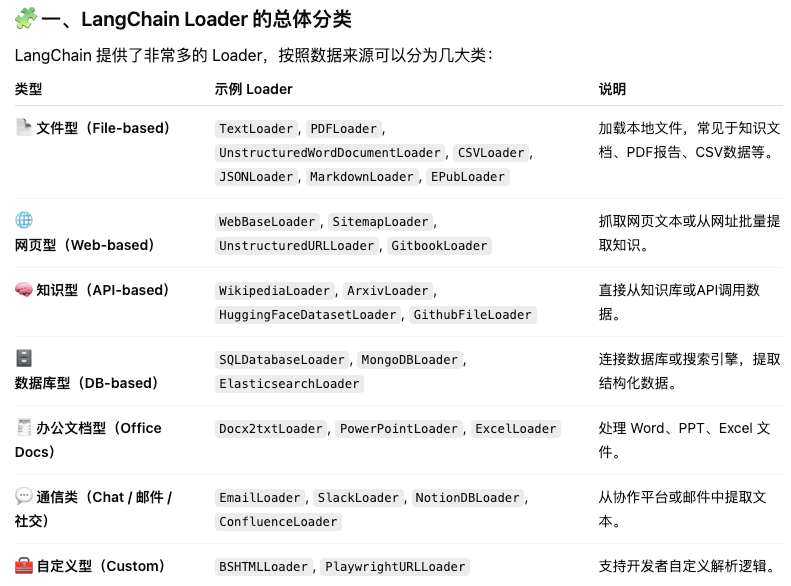
在 Dify 知识库中,上传文件,参考 Dify 指定分段模式:
为了保证文本召回的效果,通常需要在将数据录入知识库之前便对其进行清理。例如,文本内容中存在无意义的字符或者空行可能会影响问题回复的质量,需要对其清洗。Dify 已内置的自动清洗策略。
三、chunk 分块
分块意味着如何把整个 “专业领域知识” 文档切分为一小个一小个的块(chunk)。
如何切分,chunk 的大小 等等都是需要讨论的关键话题。
3.1 chunk 的大小
把原始文档进行分块chunk的时候,第一个问题就是,chunk 的大小应该是多少。太大会导致检索不准,太小语义被切断,上下文丢失导致不准。并没有一个唯一的正确的标准。只能是根据各个场景的经验取值:
- 小 chunk(200 - 400 token,即 200-400个字):适合精确检索,FAQ,代码片段。
- 中 chunk(400 - 800 token):最常用,平衡了上下文和精确度。
- 大 chunk(800 - 1500 token):适合需要更多上下文的场景。
3.2 重叠部分的大小
重叠的设置可以有效的 防止信息被截断,保留上下文。一般建议是 chunk_size 的 10% - 20%,这些都是经验值。
3.3 文档拆分方式
例如通过段落边界、分隔符、标记,或语义边界来确定块边界的位置。
3.4 分块策略
3.4.1 固定大小策略
按照固定的字符数或 token 数,把文本均匀地切成若干块。每个块的长度几乎相等,不考虑句子或语义边界(这也是一个重要缺点)。某些场景下这种方式还是很有用的,比如:日志数据。
参考 LangChain 的定义:
from langchain.text_splitter import TokenTextSplitter
text_splitter = TokenTextSplitter(
chunk_size = 500,     # 每块最多 500 token
chunk_overlap = 50
)
chunks = text_splitter.split_text(long_text)
3.4.2 递归策略
递归即使用了一个分隔符优先级列表,(例如 ["\\n\\n", "\\n", ".", " ", ""]),
- 从第一个分隔符开始尝试(比如
"\\n\\n"),根据这个分隔符把文档切分成片段。 - 如果片段太大(超过 chunk_size),则递归地使用下一个分隔符(例如 “\n”)。
- 如果所有分隔符都尝试过,仍有片段太长,就直接按字符强制切割。
- 每个 chunk 之间可以保留一定的重叠部分(chunk_overlap),防止语义断裂。
参考 LangChain 的定义:
from langchain.text_splitter import RecursiveCharacterTextSplitter
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=500,        # 每块最大字符数
chunk_overlap=100,     # 块与块之间的重叠部分
length_function=len,   # 长度计算函数(默认 len)
separators=["\n\n", "\n", ".", " ", ""],  # 分隔符优先级
)
3.4.3 固定大小策略 vs 递归策略 对比:
原始文本:
LangChain 是一个用于构建基于大语言模型的应用的框架。
它提供了丰富的模块,用于实现对话、检索、工具调用等功能。
在 RAG 应用中,LangChain 可以帮助开发者轻松地实现文档检索与生成问答。
通过向量数据库(如 FAISS 或 Chroma),我们可以高效地管理知识库。
固定大小的分割:
chunk 1: LangChain 是一个用于构建基于大语言模型的应用的框架。
chunk 2: 应用的框架。它提供了丰富的模块,用于实现对话、检索、
chunk 3: 检索、工具调用等功能。RAG 模型是 LangChain 的一个重要
chunk 4: 一个重要应用方向。
递归的分割:
chunk 1: LangChain 是一个用于构建基于大语言模型的应用的框架。
chunk 2: 它提供了丰富的模块,用于实现对话、检索、工具调用等功能。
chunk 3: 在 RAG 应用中,LangChain 可以帮助开发者轻松地实现文档检索与生成问答。
chunk 4: 通过向量数据库(如 FAISS 或 Chroma),我们可以高效地管理知识库。
PS:为什么没有 overlap:
- 固定分块是 严格按长度切割 的,所以 overlap 一定会出现。
- 递归分块它是 按语义边界优先切割的。只有当文本 太长(超过 chunk_size)时,它才会进一步递归拆分,并在需要时才启用 overlap。换句话说:overlap 只会出现在「需要被硬切」的长 chunk 里,而不是每个 chunk 都会强制加。
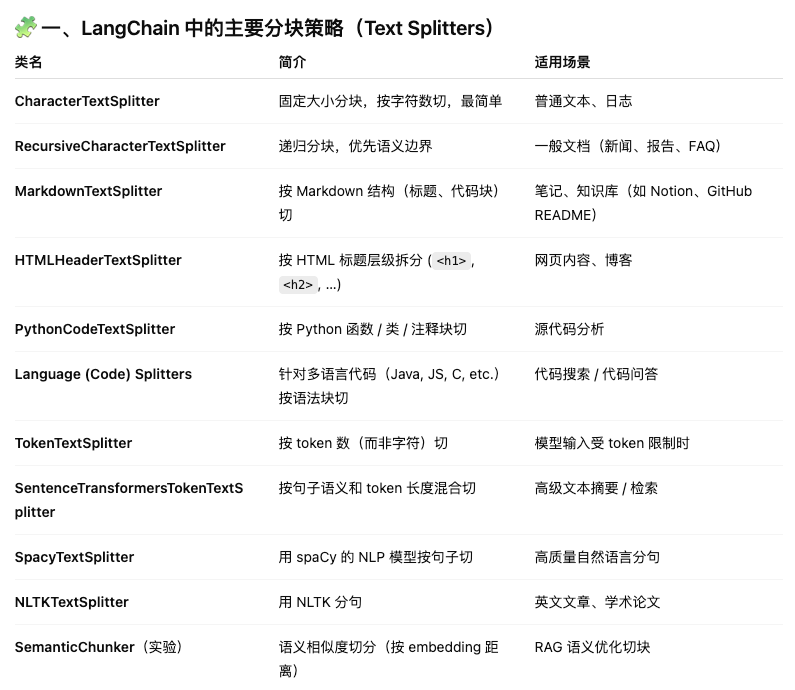
3.4.4 其他的分块策略:
3.4.5 Dify 中的分块策略
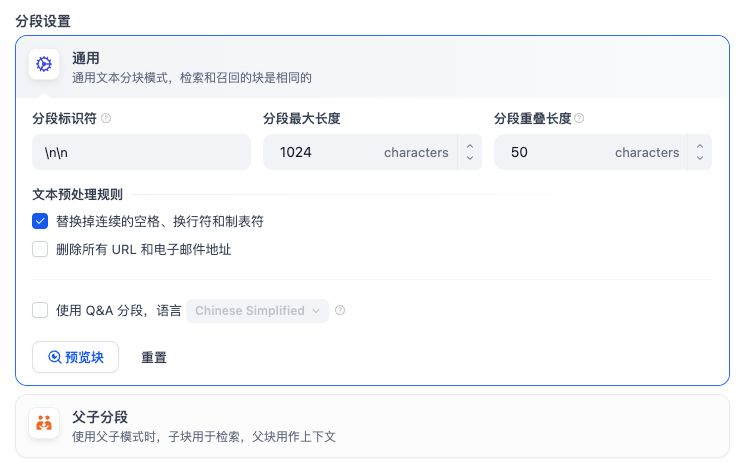
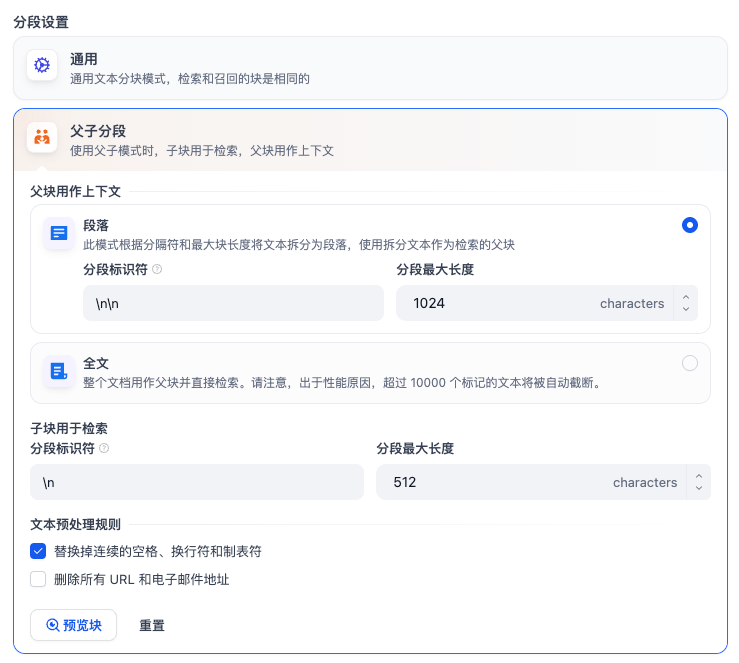
这里参考官方文档:指定分段模式。
- 通用分段:
- 将「问+答」作为一个完整单位切分(即 chunk)而非仅“按照段落”或“固定长度”切。
- 这里可以看到,分段标识符, 分段最大长度, 分段重叠长度 分别对应了之前的概念。
- 使用 Q&A 分段:当你的文档本身是“问题(Question)”-“回答(Answer)”对形式(例如 FAQ、知识库 Q&A 表格、客服常见问答)时,Dify 支持一个专门的分段方式,将每条“问 + 答”作为一个完整的 chunk。
- 父子分段:
- 父区块:保持较大的文本单位(如段落),提供丰富的上下文信息。
- 子区块:较小的文本单位(如句子),用于精确检索。
- 系统首先通过子区块进行精确检索以确保相关性,然后获取对应的父区块来补充上下文信息,从而在生成响应时既保证准确性又能提供完整的背景信息。
四、Embedding 嵌入
这里为什么叫 “嵌入到” 向量数据库中,不就是存入到数据库中吗?是为了显得更高级吗?
- 不是的。像保存到 MySQL,一般是把原始数据直接保存了。但是 RAG 这里的 Embedding 嵌入,强调了:Embedding(嵌入)= 把文本(符号信息)转换为向量(数值信息)的过程。 这样的一个转换过程。
另外对于 向量数据库,选择哪个,这里可以直接参考:
- 向量数据库 ranking。
- MTEB(Massive Text Embedding Benchmark)榜单。
五、检索
检索这里涉及到几个重要的概念:
- 全文检索。
- 向量检索。
- 混合检索。
- 重排序。
5.1 全文检索
全文索引是针对文本内容建立的索引,用于加速文本搜索。全文索引 = 对文本做分词 + 倒排索引 + 权重排序。举例:
有3个文档:
Doc1: 我喜欢猫
Doc2: 我喜欢狗
Doc3: 猫和狗都可爱
- 对文本做分词:
- Doc1 → [我, 喜欢, 猫]
- Doc2 → [我, 喜欢, 狗]
- Doc3 → [猫, 和, 狗, 都, 可爱]
- 建立倒排索引(倒排索引 = 从“词到文档”的映射):
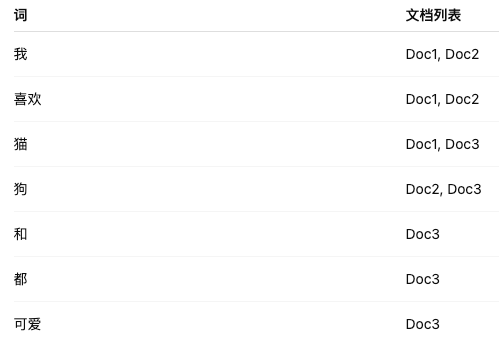
- 当用户搜索“猫” → 直接查表 → 找到 Doc1, Doc3
- 当搜索“猫 AND 狗” → 查 “猫” 得 Doc1, Doc3,查 “狗” 得 Doc2, Doc3 → 交集 Doc3
5.2 向量检索
向量检索 = 基于向量相似度查找最相关文档的过程。
- 核心:把文本、图片、音频等数据通过 Embedding 模型 转换为向量。
- 用户查询也转换成向量。
- 根据向量之间的 距离或相似度 找到最相关的数据。
5.3 混合检索
混合检索即 全文检索 + 向量检索。
核心思想:
- 全文检索:快速找到包含关键词的候选文档
- 向量检索:在候选文档中按语义相似度排序,找最相关的文档
这种方式的好处是:先用全文检索快速过滤大量文档 → 再用向量检索挑选最相关的文档。
流程:以用户提问为例:
-
用户查询 → “如何安装软件?”
-
全文检索:
-
检索出包含关键词 “安装” 或 “软件” 的文档集合
-
假设得到 100 条候选文档
-
向量检索 / 重排序:
-
把 100 条候选文档向量化
-
把用户问题向量化
-
计算相似度 → 排序 → 取 top-k 最相关文档
多路召回的概念
核心思想:用多个不同的策略同时召回候选文档,然后再进行排序。
混合检索 = 一种典型的多路召回实现(关键词 + 向量)
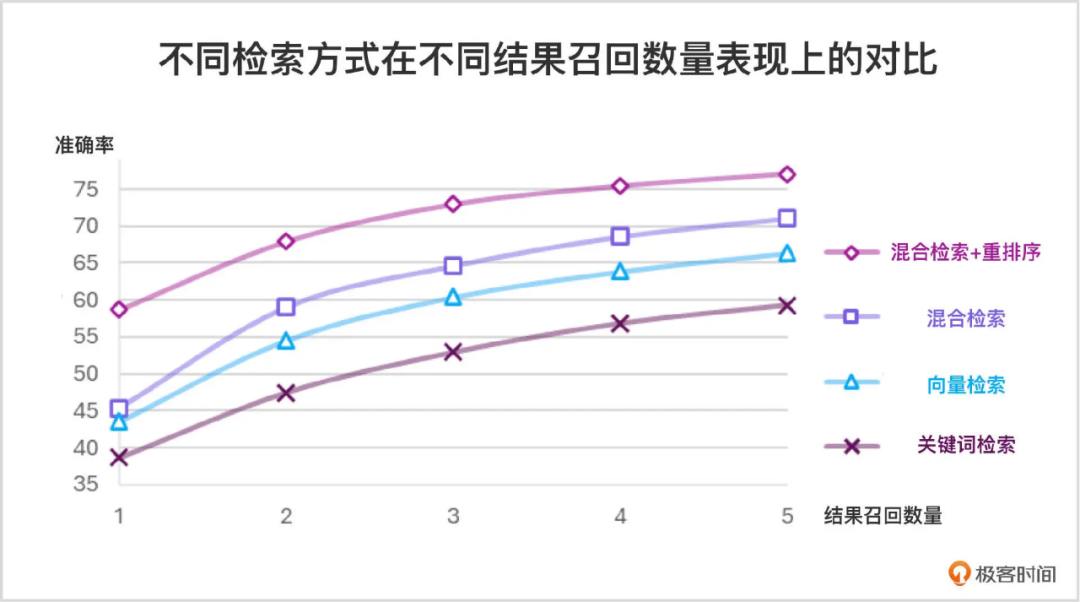
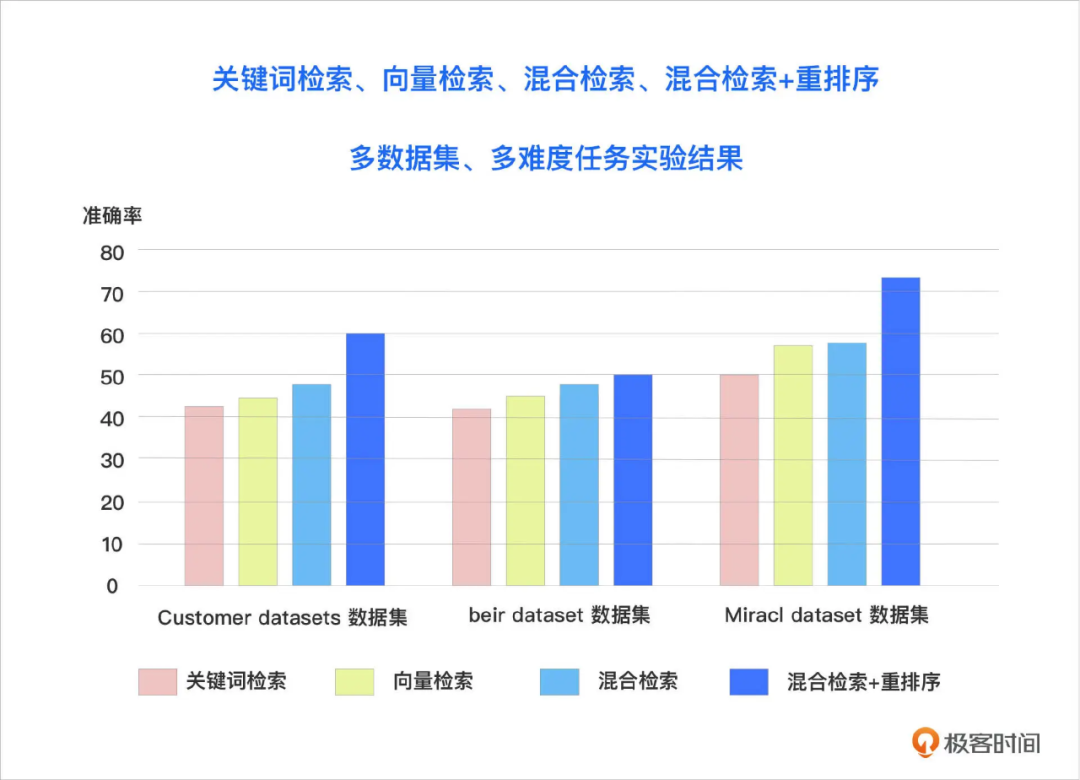
5.4 重排序
当从向量数据库中查询的时候,已经有了初步排序,为什么还需要重排序?
当在向量数据库里做检索时:
- 文本 → embedding → 向量
- 查询向量 → 计算相似度
- 返回 top-k 文档,按向量相似度排序
这样的排序:
- 向量相似度是单一指标:意味着 只考虑向量空间的语义距离,不考虑文本长度、完整性、关键词匹配度、文档权重、上下文匹配等。
- 语义相似度不完美:查询与文档虽然向量相似,但内容不完全匹配用户意图。
重排序的价值:就是在 向量数据库返回的 top-k 候选文档基础上,进一步优化排序,考虑更多信息。(例如结合多个信号:向量相似度 + 关键词匹配度 + 文档权重 + 文本长度等)
总结
- RAG 要解决的问题:LLM大语言模型专业领域知识不足。
- RAG 的整体流程: 数据清洗 → 分段 → Embedding 嵌入 → 检索 → 生成。
如何高效转型Al大模型领域?
作为一名在一线互联网行业奋斗多年的老兵,我深知持续学习和进步的重要性,尤其是在复杂且深入的Al大模型开发领域。为什么精准学习如此关键?
- 系统的技术路线图:帮助你从入门到精通,明确所需掌握的知识点。
- 高效有序的学习路径:避免无效学习,节省时间,提升效率。
- 完整的知识体系:建立系统的知识框架,为职业发展打下坚实基础。
AI大模型从业者的核心竞争力
- 持续学习能力:Al技术日新月异,保持学习是关键。
- 跨领域思维:Al大模型需要结合业务场景,具备跨领域思考能力的从业者更受欢迎。
- 解决问题的能力:AI大模型的应用需要解决实际问题,你的编程经验将大放异彩。
以前总有人问我说:老师能不能帮我预测预测将来的风口在哪里?
现在没什么可说了,一定是Al;我们国家已经提出来:算力即国力!
未来已来,大模型在未来必然走向人类的生活中,无论你是前端,后端还是数据分析,都可以在这个领域上来,我还是那句话,在大语言AI模型时代,只要你有想法,你就有结果!只要你愿意去学习,你就能卷动的过别人!
现在,你需要的只是一份清晰的转型计划和一群志同道合的伙伴。作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 852


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


