构建大语言模型,从入门到精通!核心第一步:构建大规模数据集,看这篇就够了!

A类功率放大器 在A类放大器中,导通角是完整的360°或100%的输入信号,而在其他类别的放大器中,晶体管在一个较小的导通角内导通。通过在输出级使用两个互补的晶体管,其中一个晶体管是NPN或N通道类型,而另一个晶体管是PNP或P通道(互补)类型,以所谓的 "推挽 "配置连接,可以获得比A类放大器更大的功率输出和效率。这种类型的电路效率很低(低于30%),而且对直流电源的消耗很大,输出的功率却很小。由于我们感兴趣的是向负载提供最大的交流功率,同时从电源中消耗尽可能少的直流电,所以我们主要关注的是放大器的 "转换效率"。 阅读详情

大语言模型通过在海量无标注文本数据**上进行训练,实现****“量变引起质变”,**让模型学习人类语言的内在规律和世界知识。当模型的参数规模(通常达到千亿级别)和训练数据量突破某个临界点时,会产生一种名为 “涌现” 的能力,即模型可以完成一些它未被明确训练过的复杂任务,如逻辑推理、代码生成等。
如何构建大语言模型?有了完整的知识体系,每个人可以结合自身情况和具体业务场景选择适合自己的方式开发和应用大语言模型。

一、数据获取与收集

大型语言模型的有效性与其训练所用的文本数据的规模和质量直接相关。获取足够大的数据集(通常以TB甚至PB为单位)是构建大语言模型的一个基础步骤。

主要数据来源有哪些?

  • (1)网络文本:Common Crawl等公开网络存档,提供海量但质量不一的网页内容

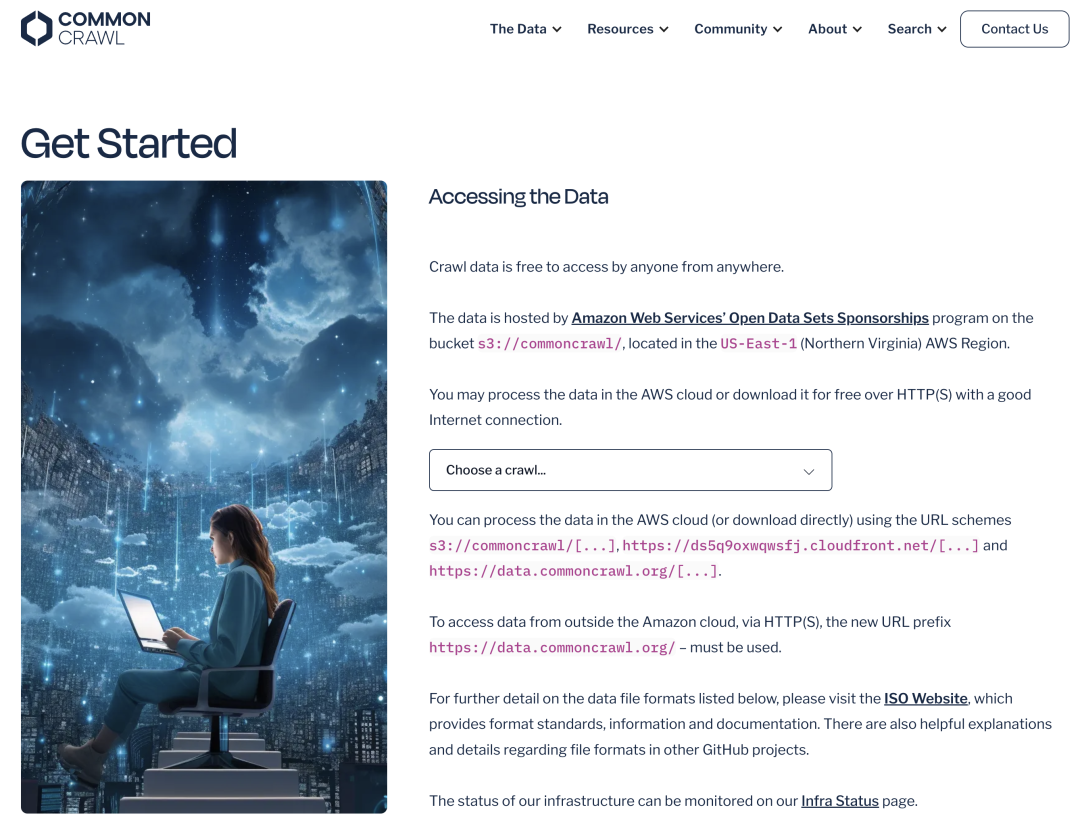
  • Common Crawl (CC) 语料库是最大且常用的资源之一。它通过大规模网络爬取操作收集,代表了公共网络很大一部分的快照。Common Crawl 公开提供数PB的原始网页数据、元数据和提取的文本,通常每隔一两个月发布新的爬取数据集。

  • Common Crawl 提供的原始网页数据、元数据和提取的文本价值是什么?

  • Common Crawl数据为大语言模型训练提供了不可替代的真实语言环境。其核心价值在于完整保留了人类语言的真实样貌——不仅包含规范的新闻和学术文本,更涵盖了日常对话、社交媒体、地方方言等鲜活的语言使用场景。这种真实性帮助模型超越教科书式的语言学习,真正理解语言在实际生活中的运用方式。

    与经过人工整理的维基百科或专业书籍相比,Common Crawl呈现出语言的“原生态”,包括口语化表达、新兴词汇和语言演变痕迹。虽然数据噪声较多,但通过严格的质量过滤和分层处理,我们能够从中提取出最具训练价值的精华内容,使模型获得对真实语言世界的深刻理解能力。

(2)知识库:维基百科等结构化知识资源,提供高质量且经过审核的文本内容

维基百科作为全球最大的多语言百科全书,它提供了系统化、结构化的知识体系。与Common Crawl的自然语言素材形成鲜明对比,维基百科内容经过严格的编辑审核和社区验证,具有高度的事实准确性和逻辑严谨性。
  • 维基百科提供的结构化、高质量和经过审核的文本内容价值是什么?

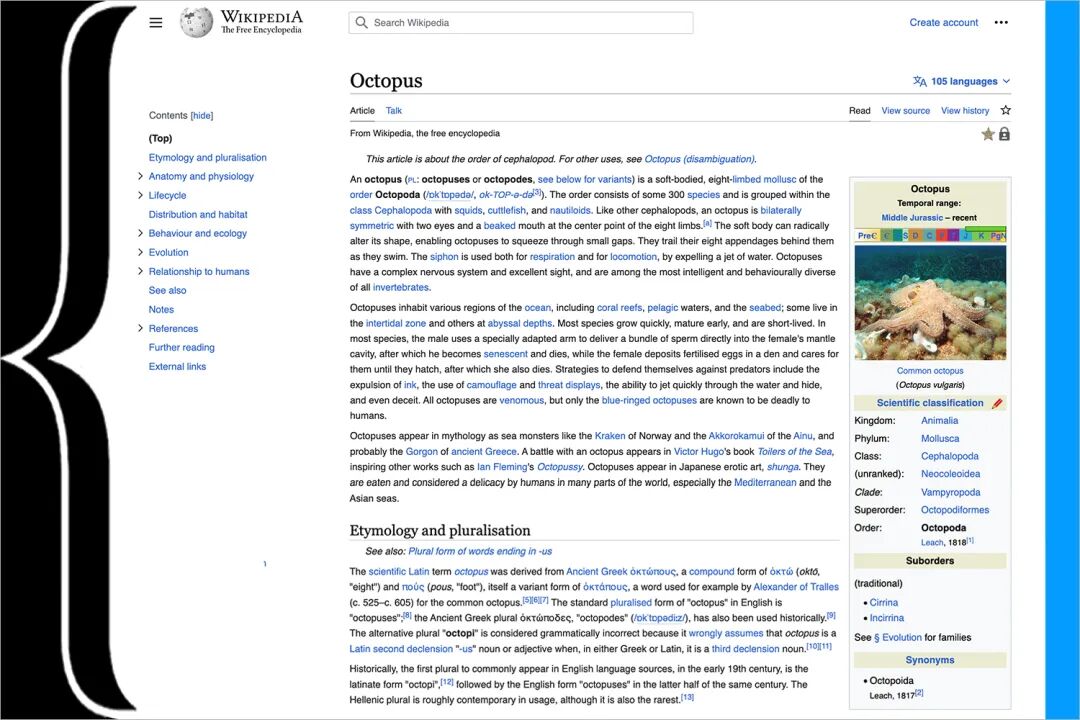
维基百科的独特价值体现在其清晰的知识组织结构——每个条目都采用统一的百科文体,包含明确的概念定义、分类体系和内在逻辑关系。这种结构化为模型提供了理想的知识学习框架,帮助其建立准确的概念理解和推理能力。同时,维基百科强大的内部链接网络构建了完整的知识图谱,使模型能够学习不同概念间的关联关系。

尽管在语言多样性方面不如网络文本,但维基百科在知识准确性和结构性方面的优势无可替代。通过与Common Crawl等资源配合使用,既能保证模型获得准确的知识基础,又能保持对真实语言环境的适应能力。
二、构建数据集

原始文本数据,特别是来自网络爬取这样的大型数据源,在有效用于训练大型语言模型之前,需要大幅整理。通过过滤低质量内容、规范化文本表示、移除不必要内容、识别和处理重复文档等方法,将原始文本数据转换为高质量数据集。

数据清洗与预处理的流程是什么?

原始数据 → 质量筛选 → 文本标准化 → 去重处理 → 语种过滤 → 高质量数据

第一步:质量筛选

质量筛选是整个流程的基石。首先通过规则方法快速过滤明显低质内容,如过短文本和乱码字符;随后运用机器学习分类器深入评估文本的可读性和信息密度。这一步骤确保了后续处理环节能够在高质量数据基础上进行,为整个流程打下坚实基础。

第二步:文本标准化

在质量筛选的基础上,文本标准化着力解决格式不一致问题。通过统一字符编码、规范标点使用、标准化数字日期表示等操作,建立一致的文本表示规范。这一步有效消除了数据中的格式噪声,使得后续的去重和语种识别能够更加准确。

第三步:去重处理

完成标准化后,去重处理进一步提升数据质量。采用MinHash等算法检测不同粒度的重复内容,结合语义相似度计算识别近似重复文本。这一环节显著提升了数据集的信息密度,为模型训练提供了更优质的学习素材。

第四步:语种过滤

作为流程的最后关卡,语种过滤确保数据的语言纯净度。使用FastText等高精度工具识别语种,精准过滤非目标语言内容。这一步既保证了单语言模型的训练效果,也为多语言模型的语种比例控制提供了重要保障。
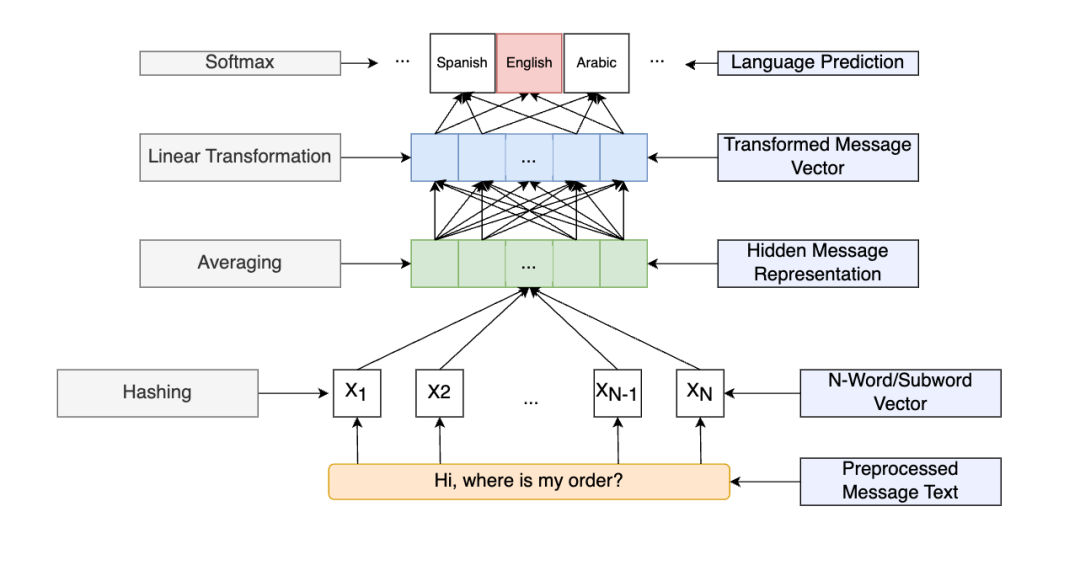
如何构建数据集?从原始文本到结构化数据

数据集构建的核心是将收集来的海量原始文本,系统性地整理成适合大模型学习的标准化格式。这个过程需要经过两个关键阶段的精心处理,才能将杂乱的文本转化为有效的学习资源。

第一步:设计数据结构 - 为模型准备"学习材料"

首先,我们需要根据不同的训练目标,设计合适的数据结构。这就好比为不同的课程准备相应的教材,每种格式都服务于特定的学习目的。

(1)文档格式(Document Format):适用于基础语言能力训练

  • 将完整的文章、书籍章节或长段落作为一个独立的数据单元
  • 帮助模型学习语言的基本规律和长文本理解
  • 典型应用:维基百科条目、新闻长文、书籍内容

(2)问答格式(Q&A Format):专注于指令遵循能力

  • 每个数据单元包含清晰的指令和对应的标准回答
  • 训练模型理解问题并给出准确答案的能力
  • 典型应用:翻译任务、知识问答、指令执行

(3)对话格式(Dialogue Format):培养交互沟通能力

  • 记录完整的对话流程,保持上下文的连贯性
  • 训练模型进行多轮对话和上下文理解
  • 典型应用:客服对话、开放域聊天、任务型对话

在确定基本格式后,我们还需要为每个数据单元添加重要的元数据信息,包括文本来源、内容分类和质量评分等。这些信息就像给每份材料贴上了详细的标签,为后续的数据筛选和训练策略提供了重要依据。

第二步:生成标准化文件 - 创建系统的"学习课程"

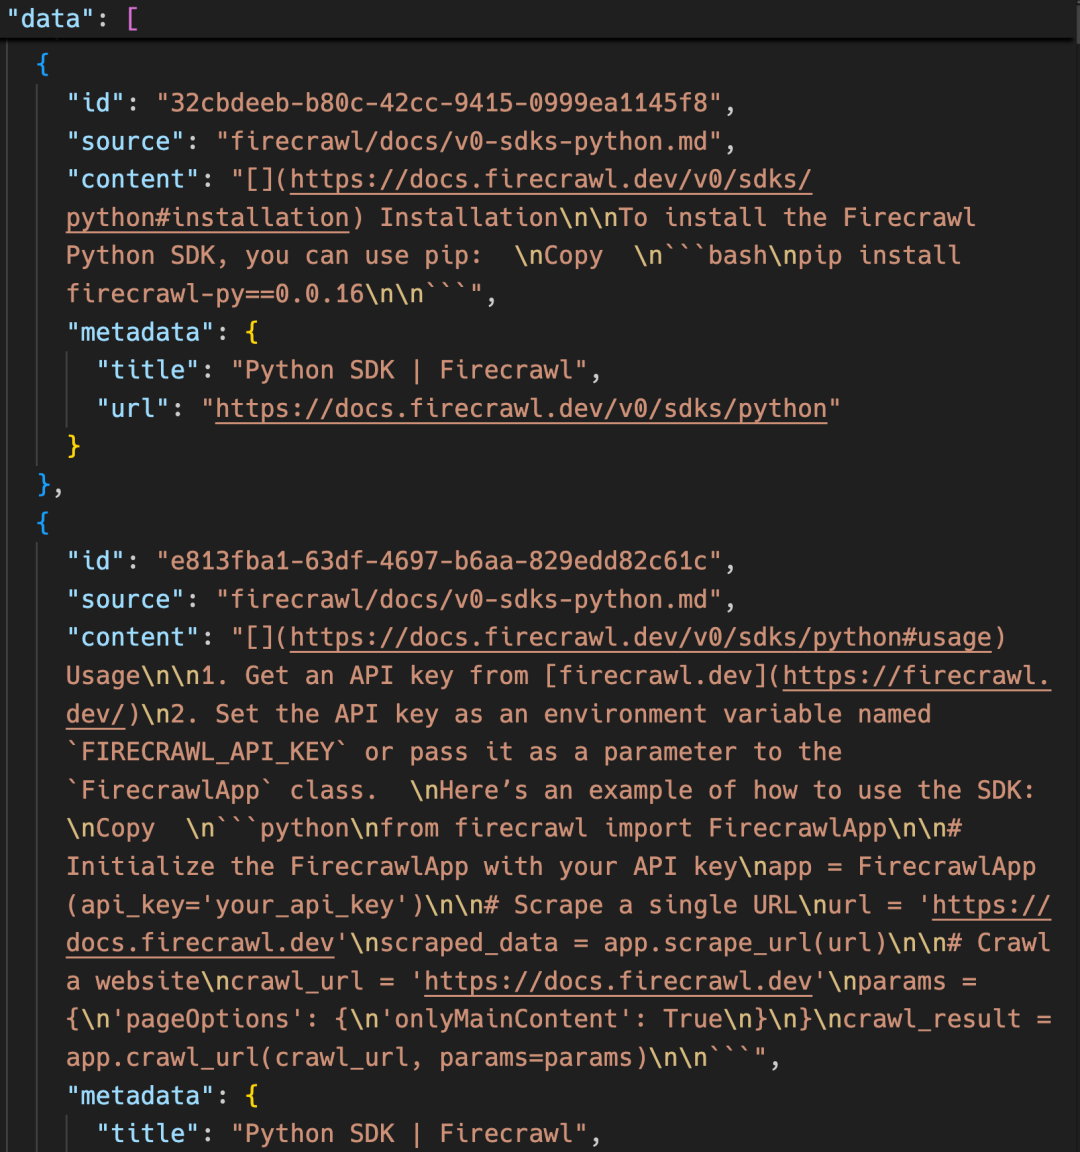
当所有数据都按照统一的结构整理完成后,我们需要将其保存为标准化的文件格式。最常用的是JSONL格式,即每行存储一个完整的数据样本。这种格式既保证了数据的完整性,又便于模型的读取和处理。

(1)每行包含一个独立的数据样本,确保训练时的独立性

(2)样本内部字段结构统一,方便模型解析学习

(3)支持大规模数据的流式读取,提升训练效率

例如,一个完整的数据集文件可能包含这样的内容:

{“text”: “深度学习是机器学习的一个重要分支…”, “source”: “textbook”, “category”: “AI”}

{“instruction”: “翻译成中文”, “input”: “Good morning”, “output”: “早上好”, “source”: “translation”}

{“conversation”: [{“role”: “user”, “content”: “你好”}, {“role”: “assistant”, “content”: “你好!有什么可以帮您的?”}]}
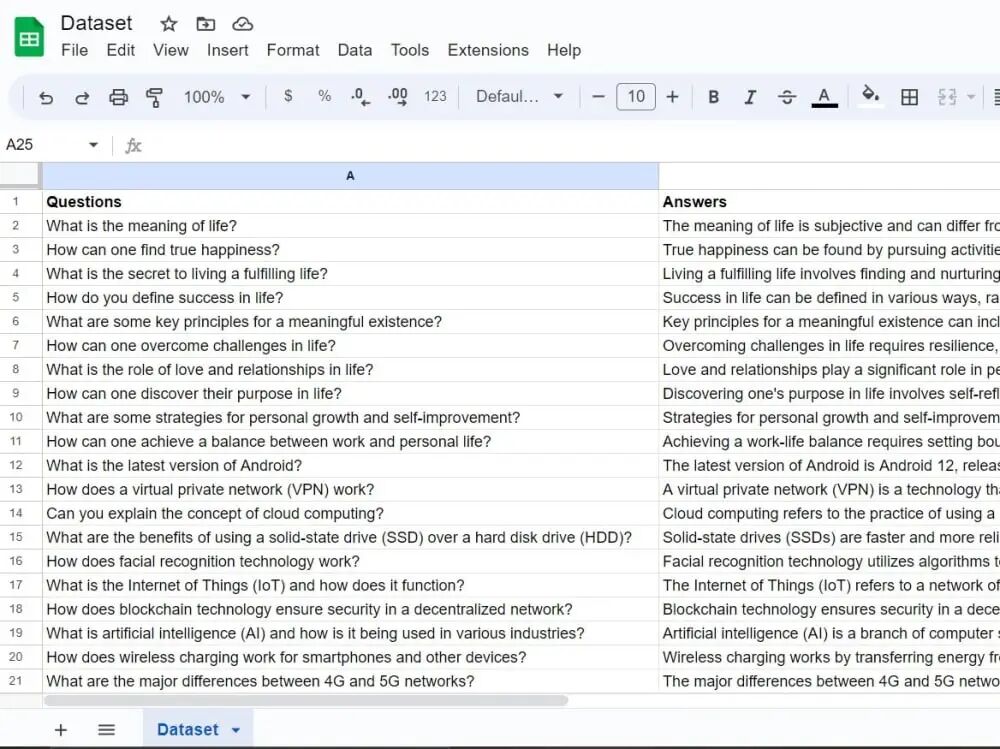
通过这种系统化的整理,原始文本实现了三个重要转变:

(1)数据变得标准化。统一的结构使模型能够以一致的方式处理所有学习材料,大大提高了学习效率。

(2)数据变得可筛选。借助详细的元数据,我们可以根据具体需求选择特定类型或质量的数据进行训练,实现更精准的教学目标。

(3)数据变得易使用。良好的组织结构让模型能够高效读取和处理数据,确保训练过程的稳定性和可靠性。

这种精心构建的数据集为大模型提供了优质的学习基础,一个好的数据集不仅包含高质量的内容,更需要有清晰合理的结构设计,这才是成功训练大模型的关键所在。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

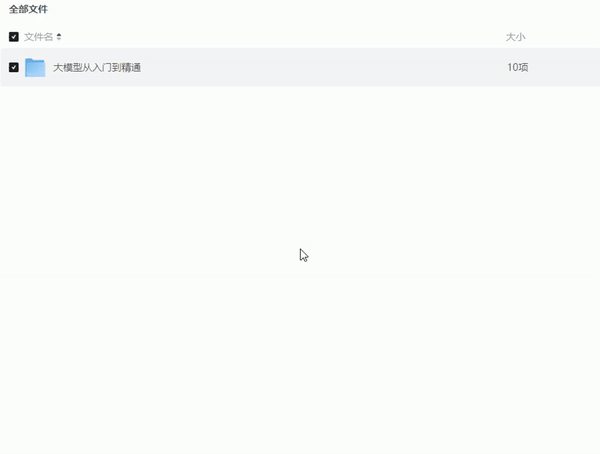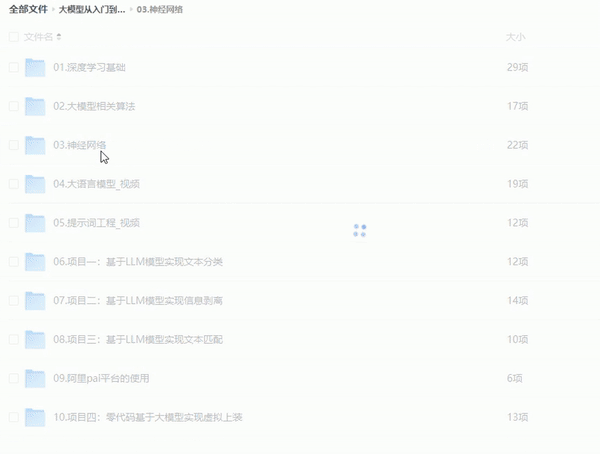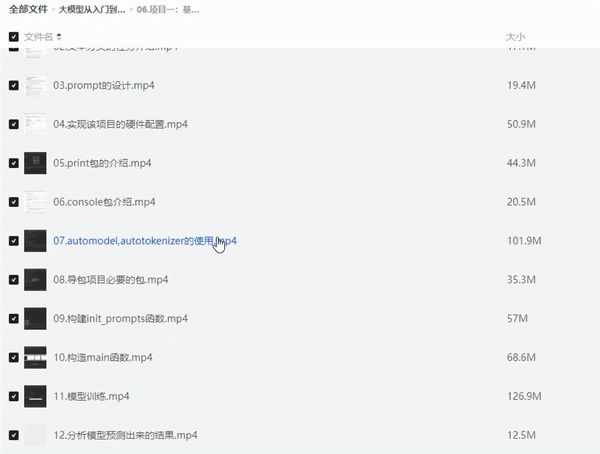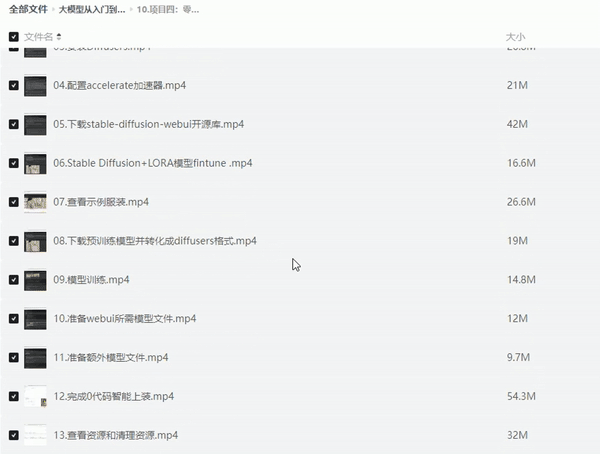
针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

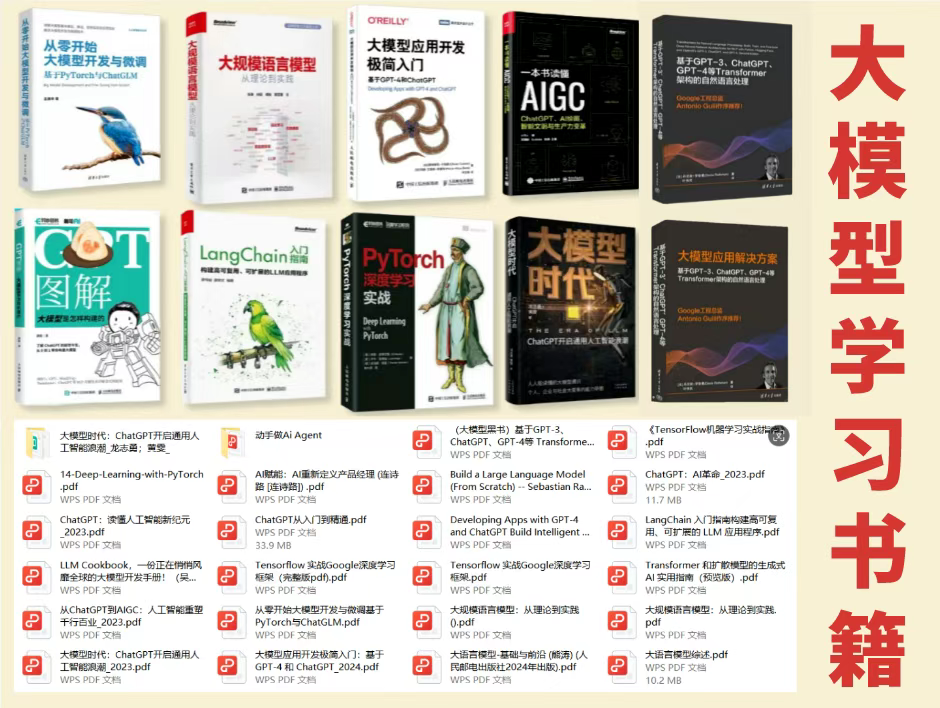
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

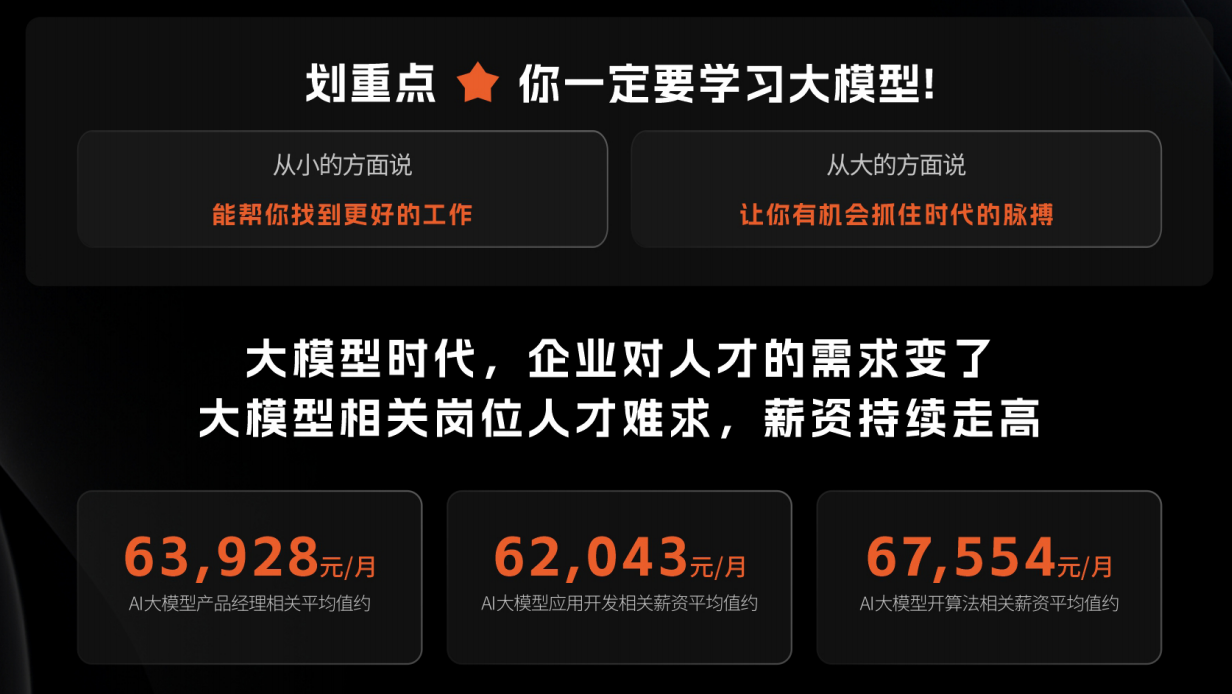
为什么要学习大模型?

2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

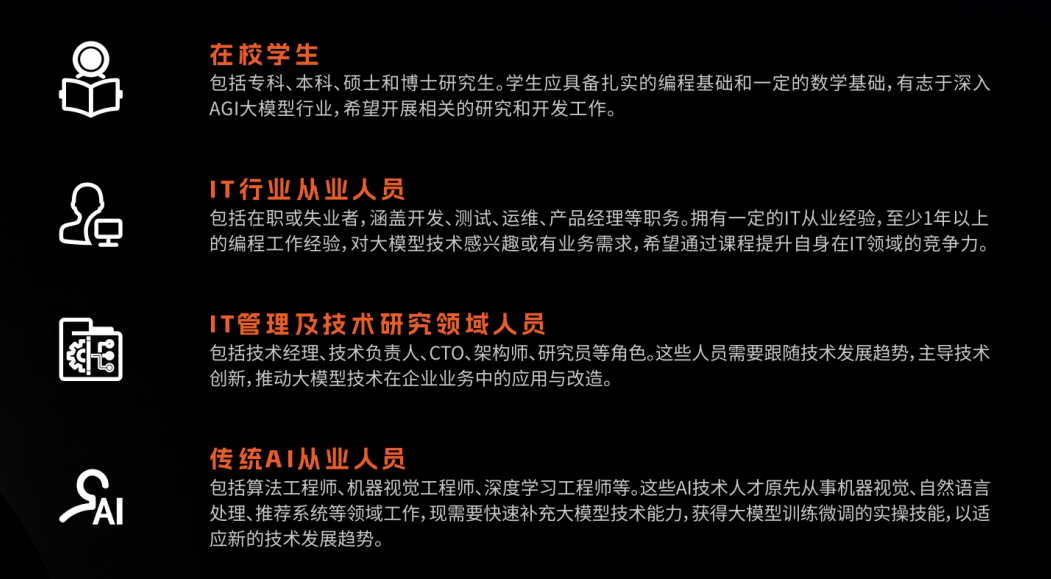
适合人群

  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

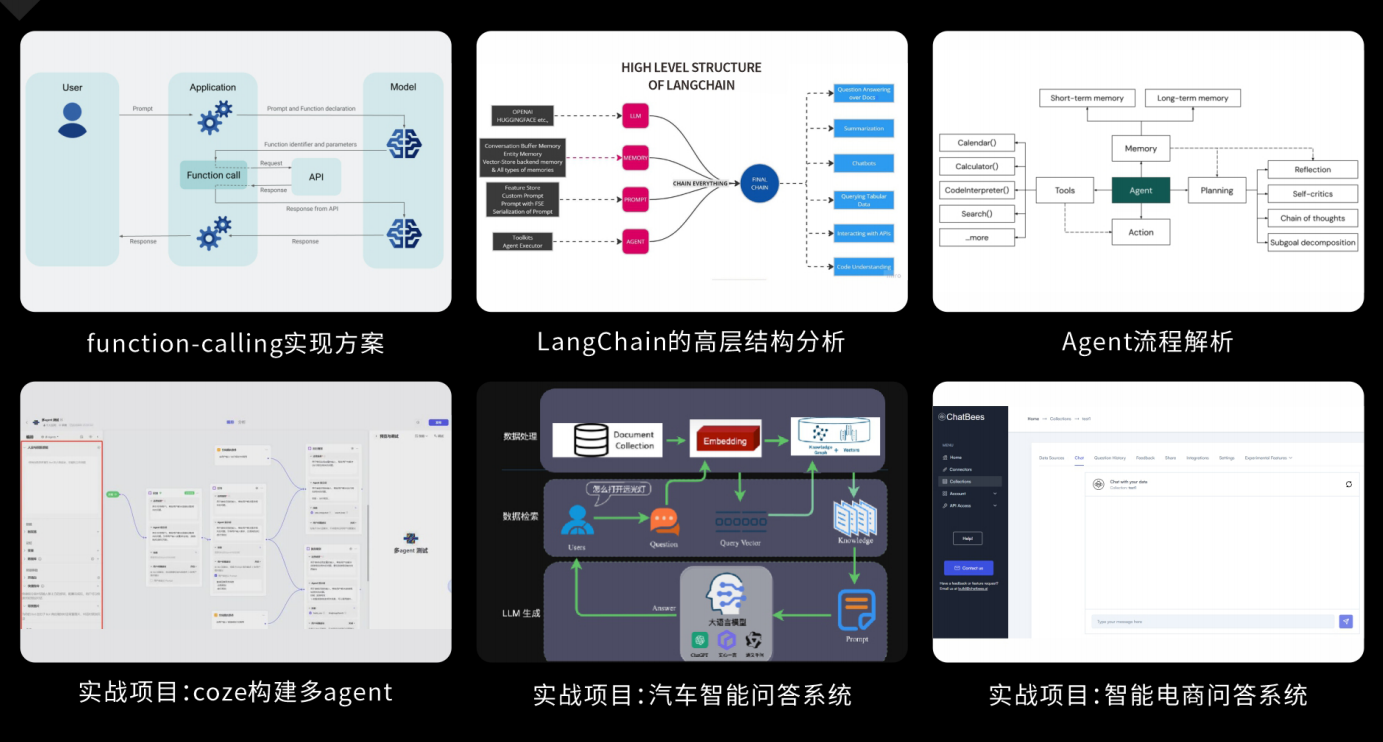
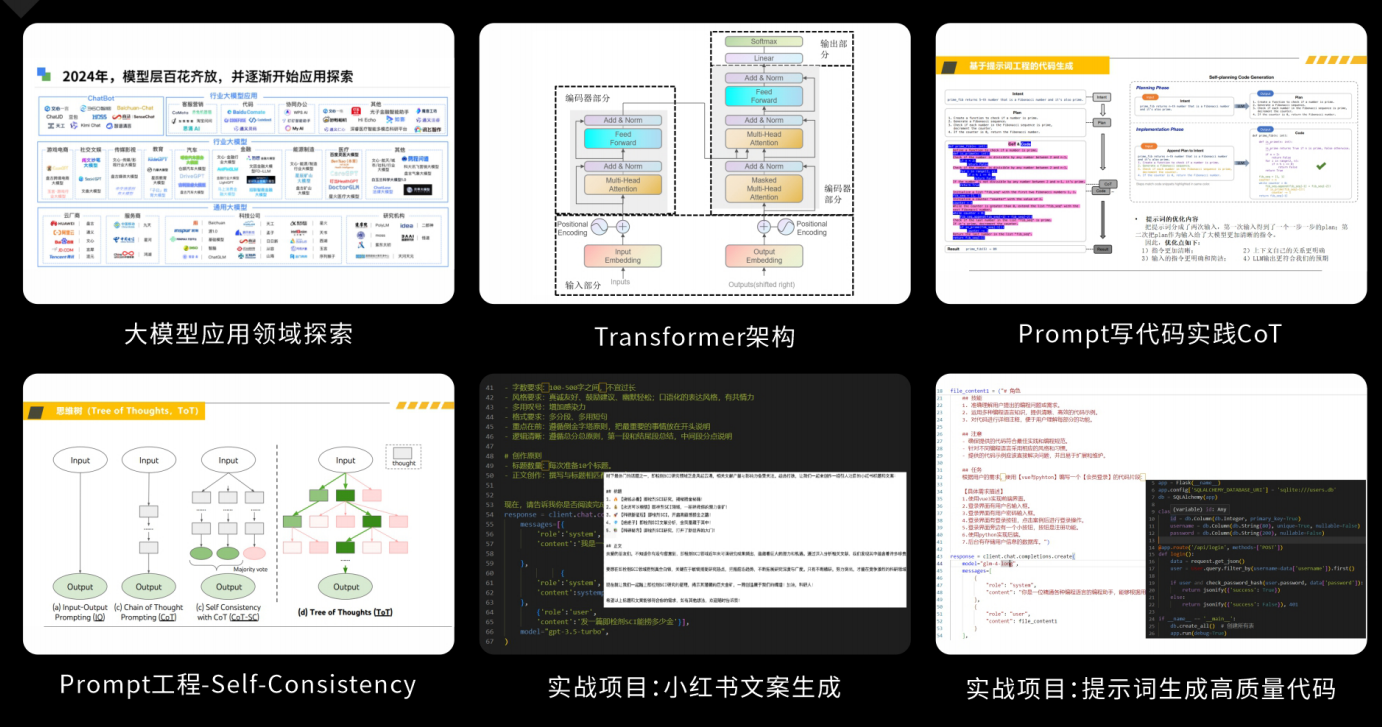
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

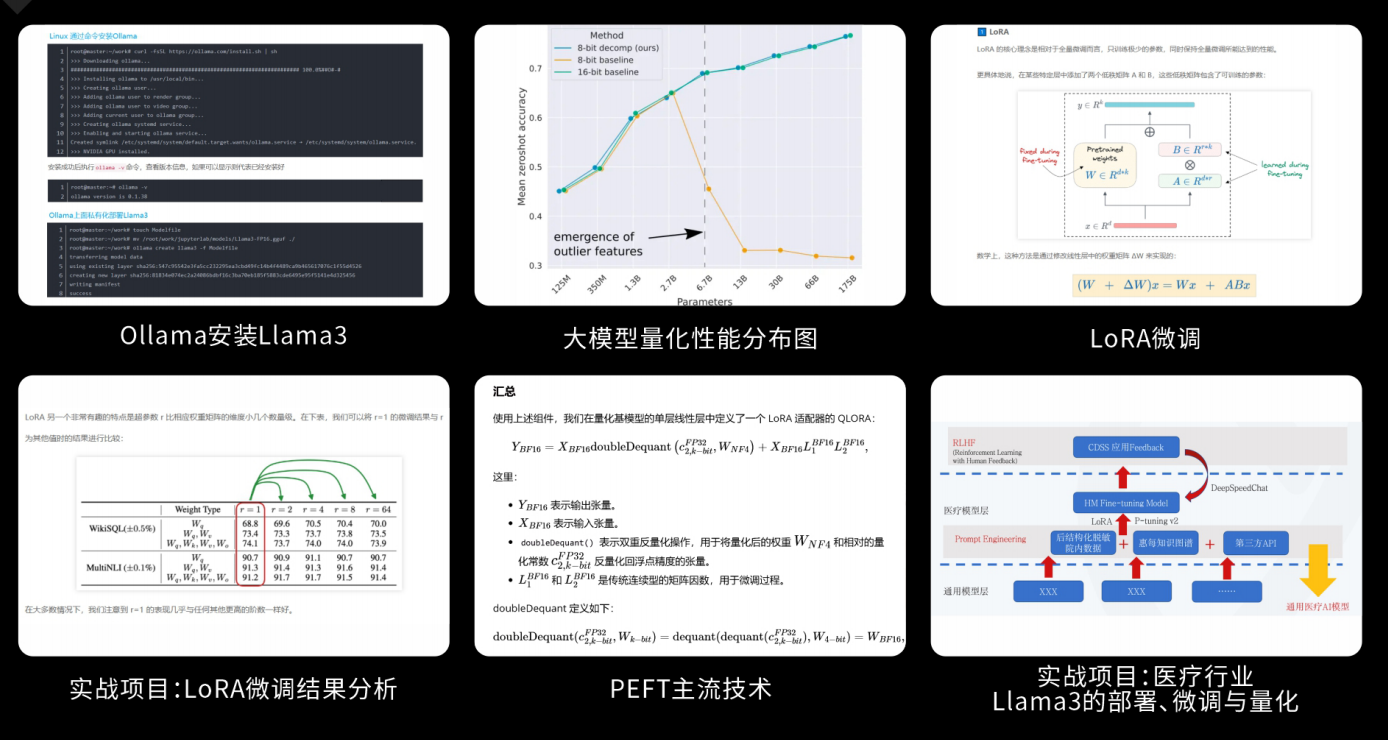
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
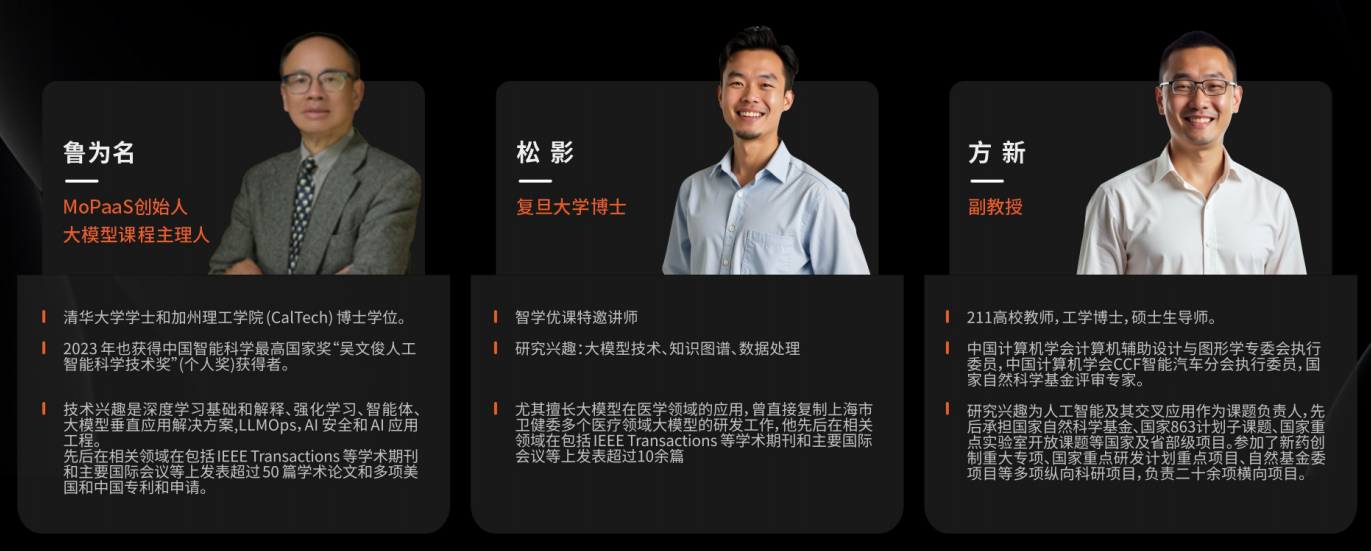
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

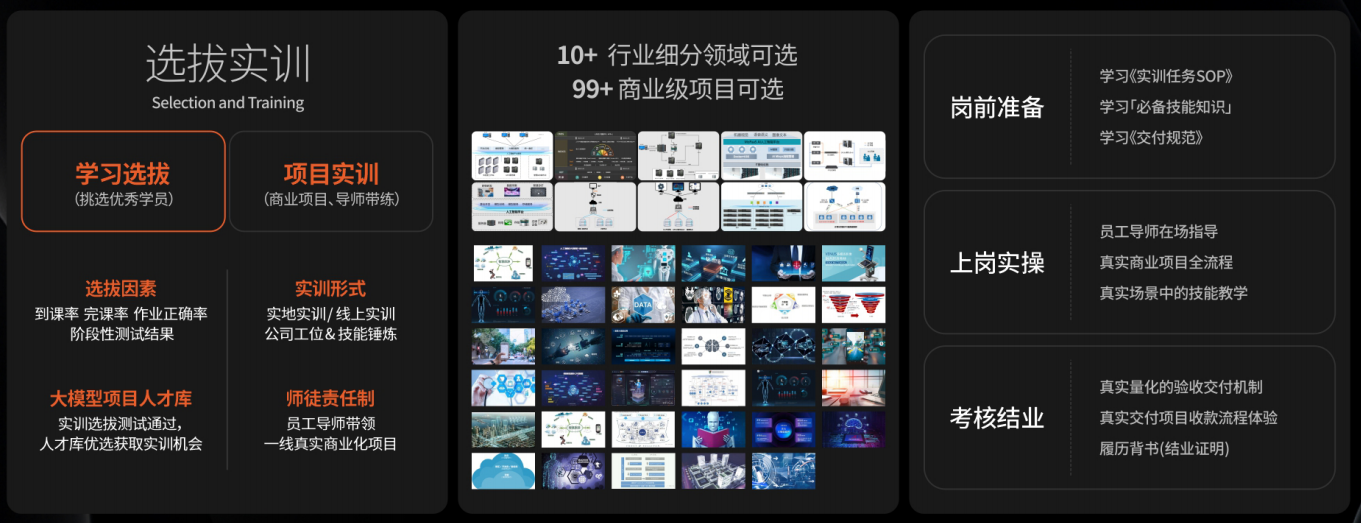
一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

iOS应用突然无法从App Store获取到内购(IAP)产品列表的解决 问题现象 Apple开发中,在应用中嵌入内购(IAP)功能的小伙伴们可能会发现,吃着火锅唱着歌,突然App就无法获取到产品列表了,而且产品请求操作并不会返回任何错误。 此时检查发现,并没有对App的内购逻辑做任何改动。 那么,这是什么原因导致的呢? Let’s find out!???? 问题分析 1. 排除其它原因 首先,你先得排除不是你IAP内购逻辑变更或其他原因导致的。 在SKProductsRequestDelegat代理实现的productsRequest方法里下断点: func produc 阅读详情

相关推荐

NVIDIA B300 vs B200:详细解析与性能对决

详细解析 NVIDIA B300 整机)的性能,并与前代的 B200 进行对比。它不仅在核心计算能力(FP8)上实现了飞跃,更重要的是通过革命性的第二代 Transformer Engine 和第五代 NVLink 技术,彻底重塑了大规模 AI 模型训练和推理的效率与规模上限。其显存容量和带宽的巨大提升也为处理超大型模型和数据提供了坚实基础。与 B200 相比,B300 是一次全面的、代际性的性能跃升,特别适合那些需要处理最前沿、最复杂 AI 和科学计算任务的用户和组织。

2401_89353317的博客 3057

利用大模型构造数据集,并微调大模型

目前大模型的微调方法有很多,而且大多可以在消费级显卡上进行,每个人都可以在自己的电脑上微调自己的大模型。但是在微调时我们时常面对一个问题,就是数据集问题。网络上有许多开源数据集,但是很多时候我们并不想用这些数据集微调模型,我们更希望使用某本书、某个作者的作品、我们自己的聊天记录、某个角色的对话来微调模型。用于微调的数据通常是成千上万的问答对,如果手工搜集,需要花费大量时间。文本将介绍一种方式,利用大模型来构造自己的数据集,并使用我们构造的数据集来微调大模型。

m0_63171455的博客 1万+

【物理模拟】PBD算法详解

参考MatthiaMuller的十分钟物理(他就是PBD算法的发明者)

beidou111的博客 9499

微调篇「数据集构建」保姆级教程来了!

第三步:开展人工终审,通过随机抽查的方式,对经过前两级处理的数据进行最终审核,确保数据的完整性和可靠性。这是本系列的第一篇,中间还有很多需要完善的地方,我们非常期待各位小伙伴的宝贵建议和指正,让我们共同进步,一起在AI学习的道路上探索更多乐趣!此处数据集构建的时候也需要考虑到所构建的模型是哪家的~比如,通义千问系列的模型更适合找通义千文帮忙构建数据集,会更有利于模型微调训练哦~:在一些特定的任务中,如图像生成或语音识别,添加噪声数据可以帮助模型学习到更复杂的模式和特征,从而提升模型在实际应用中的表现。

Datawhale 3247

泛微OA与金蝶云星空深度集成实战:审批与表单双场景解析

本文深入解析泛微OA与金蝶云星空的深度集成实战,聚焦审批流程与表单对接两大核心场景。通过具体案例,详细阐述了如何实现业务数据与审批流程的自动联动,打破数据孤岛,提升企业运营效率与数据一致性,并分享了接口设计、安全策略及实战避坑指南。

4k5l6j7h8的博客 466

ros2 gazebo仿真阿克曼小车搭载livox mid360雷达流程

流程简介:仿真环境的搭建需要安装ROS2和Gazebo。使用的是Humble版本,需要确认是否已经正确安装。然后是阿克曼小车模型的URDF,需要包括底盘、转向机构、驱动轮等,需要参考现有的阿克曼模型,比如ClearPath的Husky,但需要调整参数。Livox Mid360雷达在Gazebo中的仿真可能没有现成的插件,需要使用通用3D LiDAR插件来模拟。IMU的仿真相对简单,但需要注意噪声模型,以接近真实数据。

weixin_43802726的博客 3211

大模型是如何训练的?六个关键步骤

大模型(Large Models)的训练是近年来人工智能领域的核心技术之一,尤其是在自然语言处理、计算机视觉等任务中,如 GPT、BERT 等模型的成功背后,离不开复杂的训练过程。本文将为你介绍大模型是如何训练的,包括数据准备、模型架构、训练方法和硬件支持等方面。大模型的训练需要大量的数据,因为它们需要从海量信息中学习模式和规律。

2401_85373691的博客 4611

AUTOSAR&UDS 理论要点及isolar实战-DEM模块

从这节开始,将讲解UDS诊断中非常重要的知识点:故障事件触发、故障信息上报、故障信息处理、故障信息存储和故障系统降级,后续会陆续更新。

cqaa11的博客 552

如何准备大模型调优训练的数据集?

根据已有的预训练大模型,精调出自己的私有大模型,是通用大模型走向企业应用和个人应用的重要方向。目前,大部分的通用大模型已经向大众开放,用于在其基础上调优训练出专有的AI模型。例如:百度千帆大模型平台,该平台目前提供20多个基于大量的无标注数据,结合不同的训练方式训练出定制的预训练模型。在这些预训练模式的基础,借助千帆大模型平台,我们可以通过四个步骤,调优训练出专业大模型:数据准备、大模型训练、大模型管理、大模型服务。其中,第一个步骤就是数据准备,而数据准备的开始就是建立自己的数据集。

2301_76161259的博客 3177

在 SAP GUI Editor 中使用 OpenAI 自动生成 ABAP 代码 —— 技术实践与思考

在传统 SAP GUI Editor 场景下融入OpenAI开发者表达意图,模型负责实现。随着的持续演进,以及Joule等官方 Copilot 的加入,未来 ABAP 开发形态必将更加专注业务逻辑与架构设计,而把样板式编码交给 AI 自动完成。现在就动手试试,让你的下一段 ABAP 由 AI 来书写吧!

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 709

OpenClaw 生成测试用例

OpenClaw 只是躯干,Skills 才是灵魂。很多同学觉得 OpenClaw 没用,就像是买了一台顶级电脑却没装操作系统。通过这四步走,不仅可以学会如何让 AI 干活,更重要的是,可以学会如何管理 AI 的能力。

十二测试录 737

大语言模型从入门到精通,看这一篇就够了!

②虚假信息:大语言模型可能会生产一些具有极强迷惑性的信息,甚至可能被用于传播虚假信息或进行舆论操纵:当前社交机器人更多停留在一级传播,如果大语言模型和社交机器人相结合,就可能会形成类人的交流能力,带来社交机器人的多级传播,从而强化社交机器人传播虚假信息的负面影响。①算法垄断:大语言模型的训练需要消耗巨大的算力资源,更高的门槛在很大程度上限制了学界对大模型的持续探索,未来可能只有少量大型企业和机构能够参与到前沿大语言模型的研发当中。大语言模型与普通语言模型相比,大语言模型的一个显著区别在于其规模。

xiangxueerfei的博客 1773

LVGL 实战:倒计时翻页钟

环境:LVGL 9.x + PC 模拟器。每个数字做成上下两半的卡片,秒变时用绕中缝翻页:上半旧页折叠下去、下半新页展开上来,配合阴影遮罩做出立体感。从 02:00 倒计时到 0,闪一下再重置。界面文案用英文(默认字体无中文)。

摸鱼专家 213

大语言模型从入门到精通,看这一篇就够了

②虚假信息:大语言模型可能会生产一些具有极强迷惑性的信息,甚至可能被用于传播虚假信息或进行舆论操纵:当前社交机器人更多停留在一级传播,如果大语言模型和社交机器人相结合,就可能会形成类人的交流能力,带来社交机器人的多级传播,从而强化社交机器人传播虚假信息的负面影响。①算法垄断:大语言模型的训练需要消耗巨大的算力资源,更高的门槛在很大程度上限制了学界对大模型的持续探索,未来可能只有少量大型企业和机构能够参与到前沿大语言模型的研发当中。大语言模型与普通语言模型相比,大语言模型的一个显著区别在于其规模。

程序员鑫港的博客 1309

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

RAG入门到精通,从核心概念到亲手搭建,收藏这篇就够了!

RAG即检索增强生成(Retrieval-Augmented Generation),是一种将外部知识检索与大型语言模型(LLM)生成能力相结合的技术。传统的大语言模型虽然具备丰富的知识,但这些知识往往受限于其训练数据的截止时间,并且对于一些特定领域、最新的信息可能并不了解。而RAG通过在生成文本之前,先从外部知识库(如文档、网页等)中检索与查询相关的信息,然后将这些检索到的信息作为额外的上下文提供给大语言模型,帮助模型生成更准确、更有针对性、更符合实时需求的回答。

Python_cocola的博客 672

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

2025版最新初学者怎么入门大语言模型开发?(非常详细)零基础入门到精通,收藏这篇就够了

Prompt Engineering 涉及为大型语言模型设计有效的输入(Prompts),以引导模型生成所需的输出。这个过程不仅需要精确表达问题或需求,而且要格式化输出以适应特定应用。

leah126的博客 1617

大语言模型 (LLM)是什么? 大语言模型从入门到精通,看这一篇就够了

大语言模型 (LLM)是什么? 大语言模型从入门到精通,看这一篇就够了

Python单行客的博客 3232

大语言模型是什么? LLM从入门到精通,看这一篇就够了

②虚假信息:大语言模型可能会生产一些具有极强迷惑性的信息,甚至可能被用于传播虚假信息或进行舆论操纵:当前社交机器人更多停留在一级传播,如果大语言模型和社交机器人相结合,就可能会形成类人的交流能力,带来社交机器人的多级传播,从而强化社交机器人传播虚假信息的负面影响。①算法垄断:大语言模型的训练需要消耗巨大的算力资源,更高的门槛在很大程度上限制了学界对大模型的持续探索,未来可能只有少量大型企业和机构能够参与到前沿大语言模型的研发当中。大语言模型与普通语言模型相比,大语言模型的一个显著区别在于其规模。

xiangxueerfei的博客 1168

新手入门:大语言模型训练指南,零基础入门到精通,收藏这一篇就够了

在这个信息爆炸的时代,人工智能技术正以前所未有的速度渗透到我们生活的方方面面。从智能手机上的语音助手到自动驾驶汽车,AI的应用无处不在。而在这些令人惊叹的技术背后,大语言模型(LLM)扮演着至关重要的角色。它们不仅能够理解和生成自然语言,还能在多种场景下提供智能决策支持。然而,对于许多对AI感兴趣的新手来说,大语言模型的训练和应用似乎是一件高不可攀的事情。复杂的技术术语、晦涩的理论知识,以及高昂的硬件要求,往往让人望而却步。但其实,只要掌握正确的方法和工具,每个人都能成为AI领域的探索者和实践者。本文将带你

资深程序员,曾自学JAVA,C#,如今从业于网安行业 1205

2025版最新大模型入门书籍推荐(非常详细)大模型零基础入门到精通,收藏这篇就够了

不少小伙伴都想要学习大模型技术,转战AI领域,以适应未来的大趋势,寻求更有前景的发展~~然而,在学习大模型技术这条道路上,却不知道如何进行系统的学习,所以本期书单就为大家奉献一场,从大模型理论基础到大模型工具应用,构建自己的LLM应用程序……应有尽有,如果你是AI小白,想要从入门开始学起,或者想要了解AI未来的发展趋势,也有相应的图书哦~~**▊《**张奇,桂韬,郑锐,黄萱菁 著。

Everly_的博客 2983

大语言模型有什么用途?(非常详细)从零基础入门到精通,收藏这篇就够了

简直是AI界的“变形金刚”!如今,AI应用遍地开花,像什么文章总结、故事创作、还有那些跟你唠嗑没完的智能对话,背后都有大语言模型在默默Carry。简单来说,大语言模型(LLM)就是一种超牛的深度学习算法,它通过。

Python_0011的博客 975

初学者怎么入门大语言模型开发?(非常详细)零基础入门到精通,收藏这篇就够了

Prompt Engineering 涉及为大型语言模型设计有效的输入(Prompts),以引导模型生成所需的输出。这个过程不仅需要精确表达问题或需求,而且要格式化输出以适应特定应用。

Python_0011的博客 935

复旦最新《大规模语言模型·从理论到实践》,大模型中文新书发布,理论+代码,大模型入门到精通,收藏这篇就足够了!

复旦大学自然语言处理实验室张奇教授、桂韬研究员、郑锐博士生以及黄萱菁教授结合之前在自然语言处理领域研究经验,以及分布式系统和并行计算的教学经验,通过在大语言模型实践和理论研究的过程中,历时 8 个月完成本书《大规模语言模型·从理论到实践》不可错过!

2301_81888214的博客 966
上一篇: (深度好文)一文讲透RAG在金融的挑战:面试官想听的,不只是“数据安全”这么简单!
下一篇: RAG的另一种思路(超详细)!基于文档树的推理检索,看这篇就彻底懂了!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值