万字长文,彻底讲透智能体化搜索!强化学习基础、角色、优化全拆解,不收藏亏大了!

GraphRAG-Router:基于强化学习与多智能体的知识图谱智能路由框架 检索增强生成(RAG)是提升大模型知识准确性和时效性的关键技术,其核心原理是通过外部知识检索来补充模型的内部知识。传统RAG在处理复杂、多跳的推理问题时,常因信息碎片化而面临瓶颈。GraphRAG通过构建知识图谱,将信息以实体和关系的形式结构化连接,为复杂查询提供了更优的语义理解基础。然而,如何在海量图谱中高效、精准地规划探索路径,成为新的技术挑战。本文探讨的GraphRAG-Router框架,创新性地引入多智能体(Multi-Agent)系统与强化学习(Reinforcement Learning)技术, 阅读详情

大型语言模型(Large Language Models, LLMs)的出现,通过开放式自然语言交互,彻底变革了信息获取与推理方式。然而,LLMs 仍受限于静态知识、事实幻觉(factual hallucination)以及无法检索实时或特定领域信息等问题。检索增强生成(Retrieval-Augmented Generation, RAG)通过将模型输出与外部证据对齐,有效缓解了这些局限,但传统的 RAG 流水线往往是单轮且启发式的,缺乏对检索与推理过程的自适应控制。

近年来,智能体化搜索(agentic search) 的兴起通过让 LLMs 能够在搜索环境中进行多步交互式的规划(plan)、检索(retrieve)与反思(reflect),突破了这一限制。在这一新范式下,强化学习(Reinforcement Learning, RL) 提供了一种强大的机制,用于实现自适应与自我改进的搜索行为。

本综述首次系统梳理了基于强化学习的智能体化搜索(RL-based agentic search)研究进展,从三个互补维度组织这一新兴领域:(i)RL 的功能角色(what RL is for),(ii)RL 的使用方式(how RL is used,即优化策略),以及(iii)RL 的应用范围(where RL is applied,即优化作用域)。我们总结了具有代表性的研究方法、评估协议与应用实例,并探讨了构建可靠且可扩展的 RL 驱动智能体化搜索系统面临的开放挑战与未来方向。

1 引言

大型语言模型(Large Language Models, LLMs)[137, 189, 242] 在自然语言理解、推理与生成方面展现出前所未有的能力,从根本上重塑了用户获取与交互信息的方式。尽管如此,LLMs 仍存在若干局限:它们受限于静态知识截止点(static knowledge cutoffs)[32],易产生事实幻觉(factual hallucinations)[157],并且无法访问实时或特定领域的信息。为应对这些挑战,检索增强生成(Retrieval-Augmented Generation, RAG) [57, 92] 范式应运而生,成为一种流行的解决方案。RAG 将 LLM 的推理能力与经典信息检索(Information Retrieval, IR)技术(如 TF–IDF [2, 172]、BM25 [154, 155] 以及基于链接分析的 PageRank 模型 [13, 18, 138])的精确性相结合。通过从外部知识库中检索证据并基于该上下文生成回答,RAG 能够使 LLM 生成更准确且事实依据更充分的输出,尤其适用于知识密集型任务 [9, 16, 49]。

然而,传统的 RAG 系统 [23] 通常是单轮(single-turn)且启发式驱动(heuristic-driven)的:只进行一次检索与一次生成,缺乏根据中间反馈动态调整检索策略或逐步优化查询的能力。被检索到的文档可能包含无关或噪声信息,从而阻碍下游推理 [20, 82–84]。此外,LLMs 往往难以充分利用检索到的证据,限制了整个流水线的有效性。这些局限促使研究者探索更具智能体特征的搜索系统(agentic search systems),其中 LLM 可作为自主决策者(autonomous decision-maker),在多步过程中动态地进行规划(plan)、检索(retrieve)、推理(reason)与反思(reflect)。

为此,研究者提出了搜索智能体(search agents)——即基于 LLM 的系统,能够与搜索环境进行多步交互 [78, 247]。不同于传统 RAG,搜索智能体可以迭代地生成与优化查询,评估检索结果的质量,并动态调整策略以解决复杂的多跳任务(multi-hop tasks)。这种从被动检索(passive retrieval)到主动智能体化(active agency)的转变,标志着信息检索范式的根本性变革。然而,早期的搜索智能体往往严重依赖手工提示(handcrafted prompting) [105] 或监督微调(supervised fine-tuning) [8, 148],限制了其自主发现最优策略的能力。

近年来,强化学习(Reinforcement Learning, RL) [178] 崭露头角,成为开发自适应(adaptive)与自主(autonomous)搜索智能体的有前景范式 [84, 202]。我们将**基于强化学习的智能体化搜索(RL-based agentic search)**定义为:通过训练一个 LLM 作为决策智能体,使其能够与搜索环境交互、接收外部反馈,并通过迭代改进策略来最大化奖励。这一形式化定义突出了三个核心特征:
(i) 自主性(autonomy)——智能体可自主决定搜索行为;
(ii) 学习性(learning)——策略通过强化学习获得,而非人工设计;
(iii) 交互性(interaction)——智能体通过与搜索环境的多轮交互不断改进推理与检索能力。

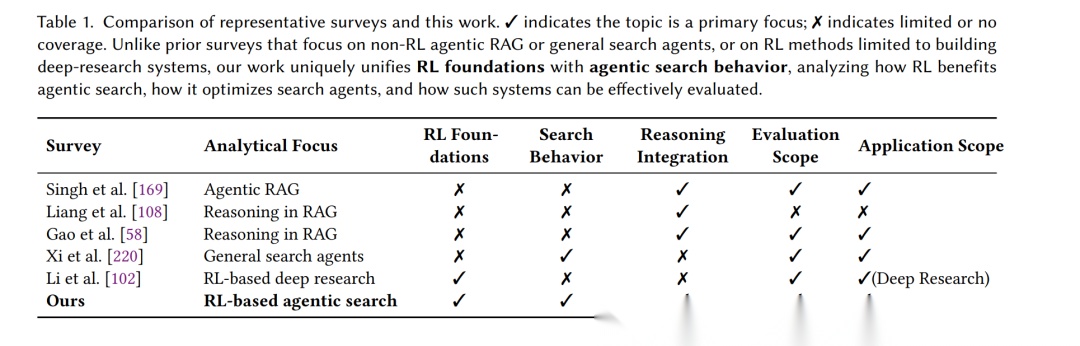
尽管该领域发展迅速,但目前对 RL 驱动的智能体化搜索 仍缺乏系统性理解。如表 1 所示,现有综述 [58, 102, 220] 从不同角度探讨了智能体化搜索,但要么对 RL 的关注不足 [220],要么局限于特定子领域,如 Deep Research [102] 或 RAG [58]。关于 RL 在促进自适应与自主搜索行为中的作用,尚缺乏深入研究。

相比之下,本文是首个专门针对 基于强化学习的智能体化搜索 的全面综述。我们旨在阐明 RL 如何在三个互补维度上促进智能体化搜索的发展:
(i) RL 的功能角色(What RL is for)——探讨其在引导检索、推理与决策中的作用;
(ii) RL 的使用方式(How RL is used)——涵盖奖励设计、策略学习与高级训练方法等优化策略;
(iii) RL 的应用范围(Where RL is applied)——考察 RL 干预的层级范围,从智能体级到步骤级与模块级。

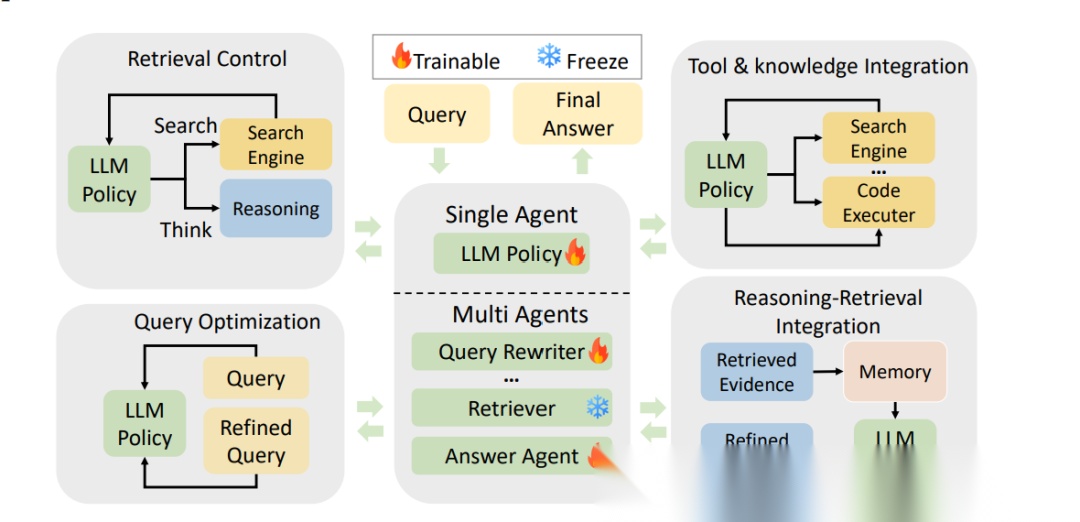
针对每个维度,我们回顾了具有代表性的研究方法,并总结了新兴趋势。论文整体结构如图 1 所示:

  • 第 2 节介绍智能体化搜索与强化学习的基础;
  • 第 3 至第 5 节从上述三个视角系统探讨 RL 在智能体化搜索中的作用;
  • 第 6 节综述评估指标与典型应用;
  • 第 7 节总结开放挑战与未来研究方向。

如何学习大模型 AI ?

我国在AI大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着Al技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国Al产业的创新步伐。加强人才培养,优化教育体系,国际合作并进,是破解困局、推动AI发展的关键。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

2025最新大模型学习路线

明确的学习路线至关重要。它能指引新人起点、规划学习顺序、明确核心知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

对于从来没有接触过AI大模型的同学,我帮大家准备了从零基础到精通学习成长路线图以及学习规划。可以说是最科学最系统的学习路线。

在这里插入图片描述

针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

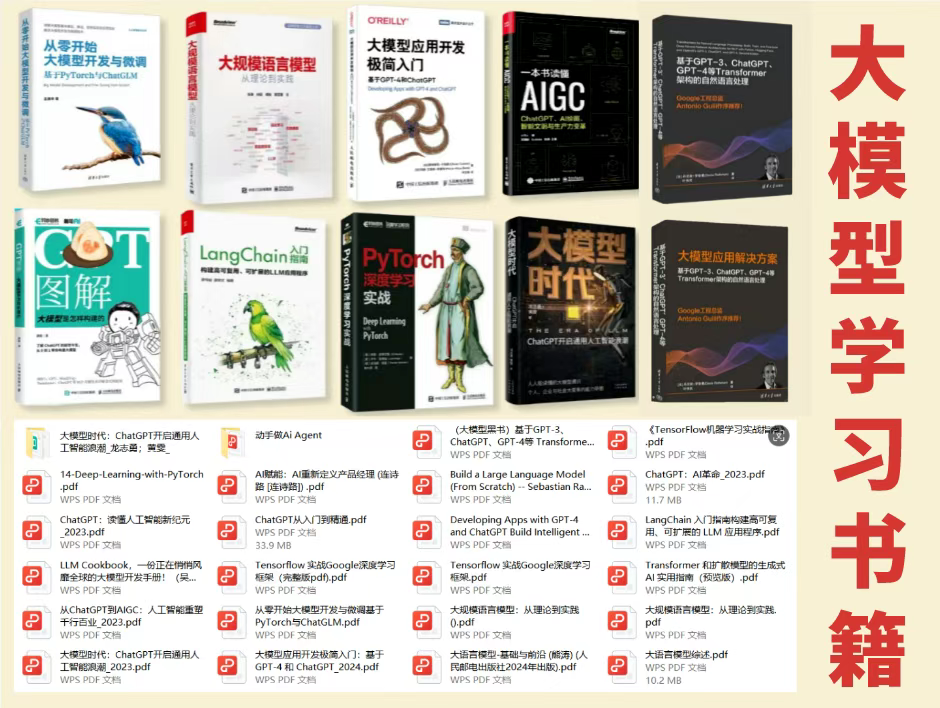
大模型经典PDF书籍

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路!
在这里插入图片描述

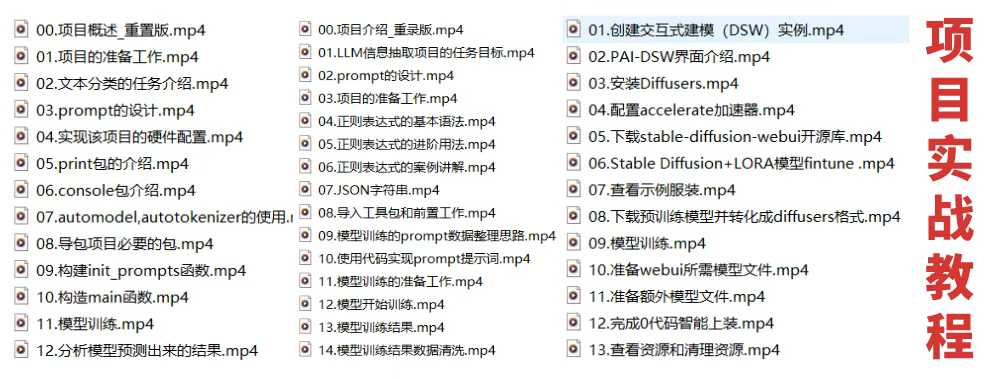
配套大模型项目实战

所有视频教程所涉及的实战项目和项目源码等
在这里插入图片描述

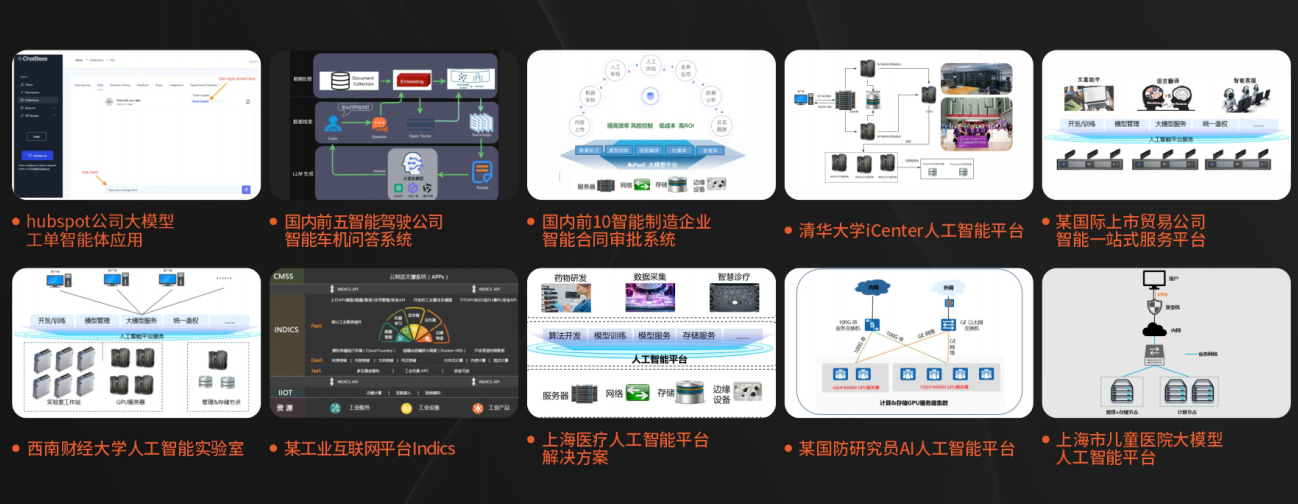
博主介绍+AI项目案例集锦

MoPaaS专注于Al技术能力建设与应用场景开发,与智学优课联合孵化,培养适合未来发展需求的技术性人才和应用型领袖。
在这里插入图片描述

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

为什么要学习大模型?

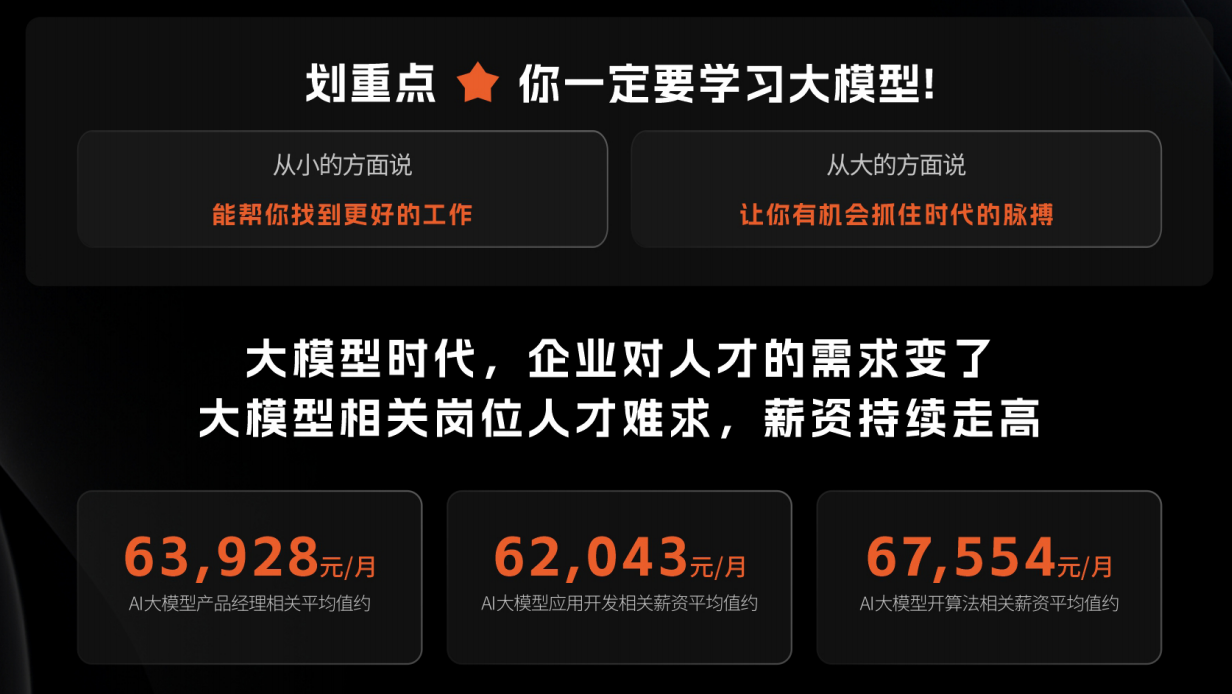
2025人工智能大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
在这里插入图片描述

适合人群

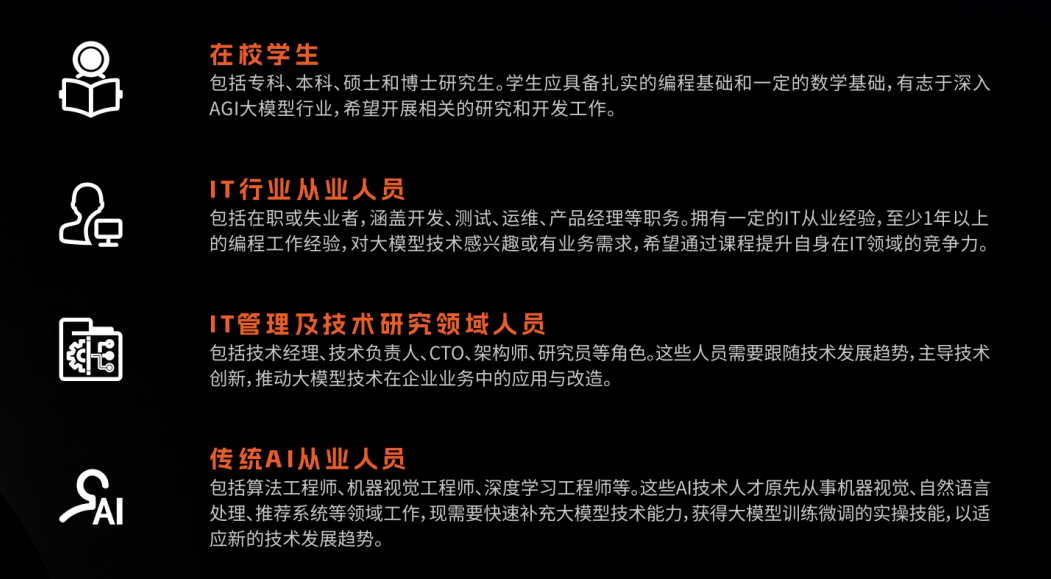
  • 在校学生:包括专科、本科、硕士和博士研究生。学生应具备扎实的编程基础和一定的数学基础,有志于深入AGI大模型行业,希望开展相关的研究和开发工作。
  • IT行业从业人员:包括在职或失业者,涵盖开发、测试、运维、产品经理等职务。拥有一定的IT从业经验,至少1年以上的编程工作经验,对大模型技术感兴趣或有业务需求,希望通过课程提升自身在IT领域的竞争力。
  • IT管理及技术研究领域人员:包括技术经理、技术负责人、CTO、架构师、研究员等角色。这些人员需要跟随技术发展趋势,主导技术创新,推动大模型技术在企业业务中的应用与改造。
  • 传统AI从业人员:包括算法工程师、机器视觉工程师、深度学习工程师等。这些AI技术人才原先从事机器视觉、自然语言处理、推荐系统等领域工作,现需要快速补充大模型技术能力,获得大模型训练微调的实操技能,以适应新的技术发展趋势。
    在这里插入图片描述

课程精彩瞬间

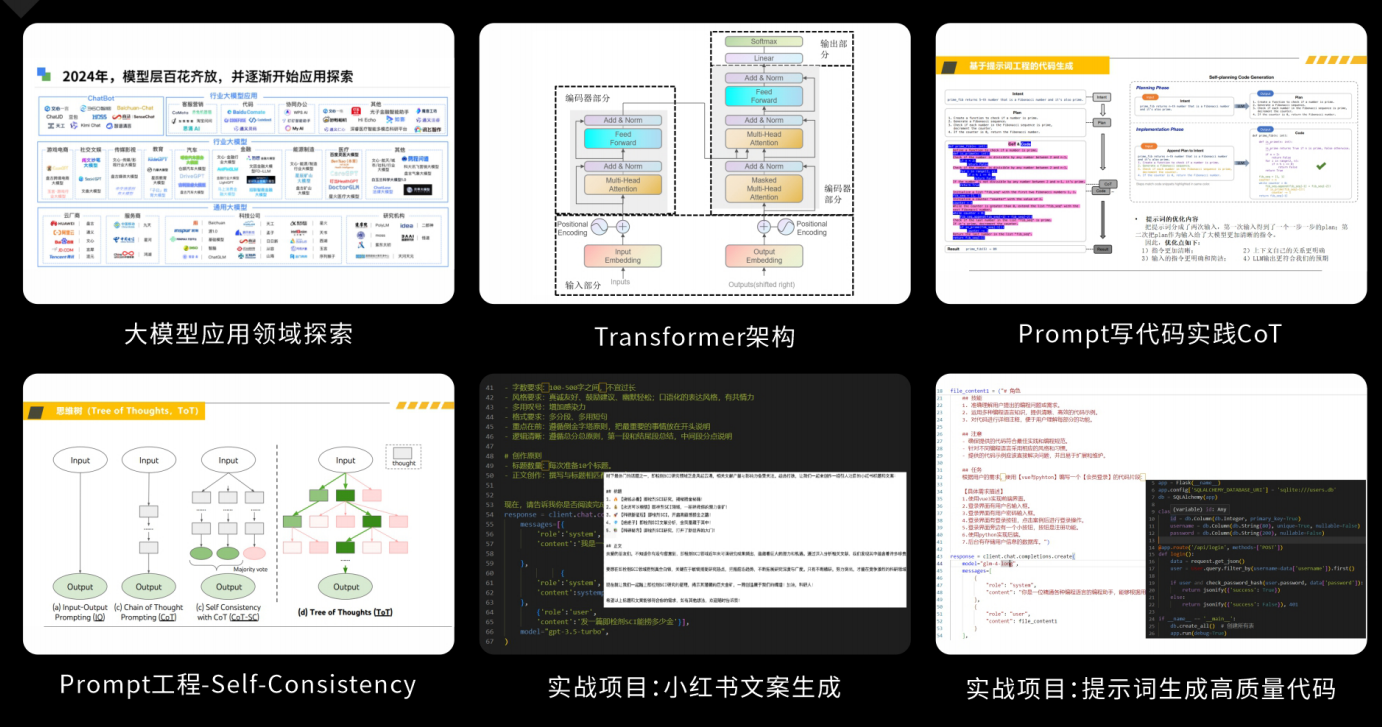
大模型核心原理与Prompt:掌握大语言模型的核心知识,了解行业应用与趋势;熟练Python编程,提升提示工程技能,为Al应用开发打下坚实基础。

在这里插入图片描述

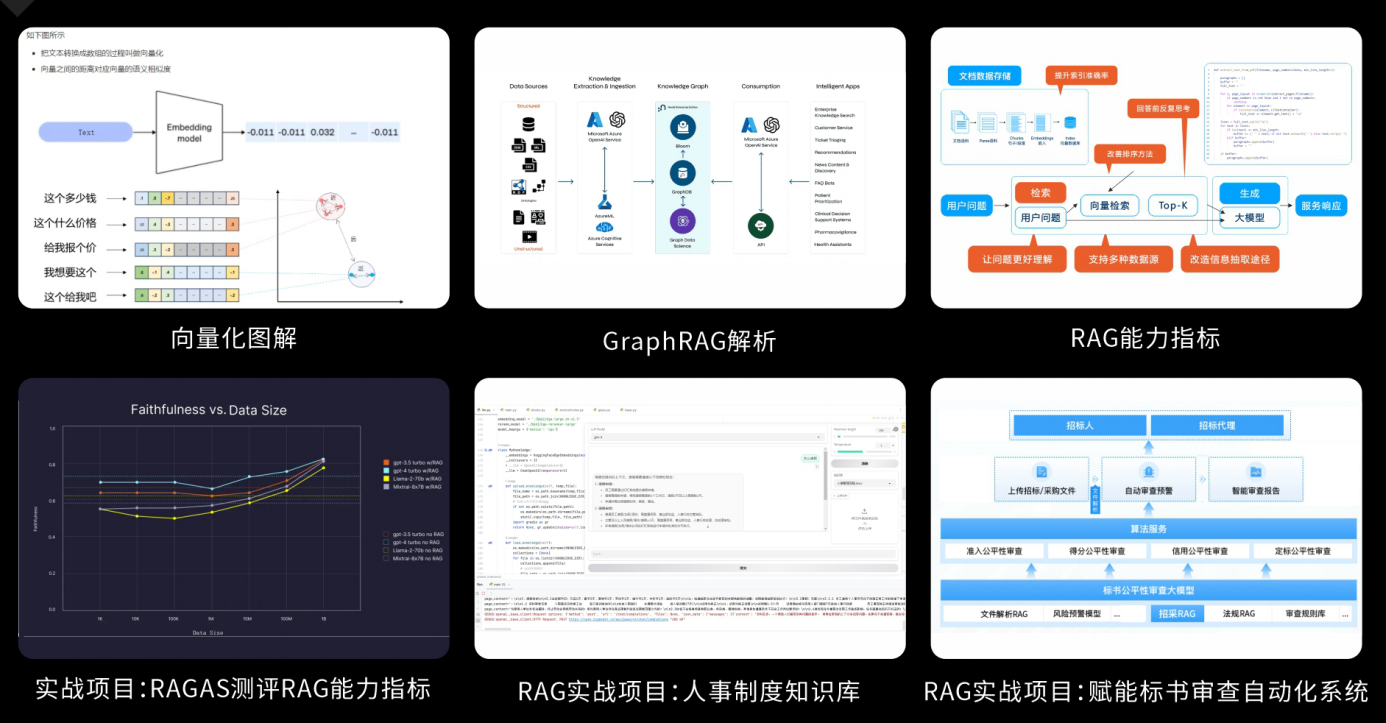
RAG应用开发工程:掌握RAG应用开发全流程,理解前沿技术,提升商业化分析与优化能力,通过实战项目加深理解与应用。 在这里插入图片描述

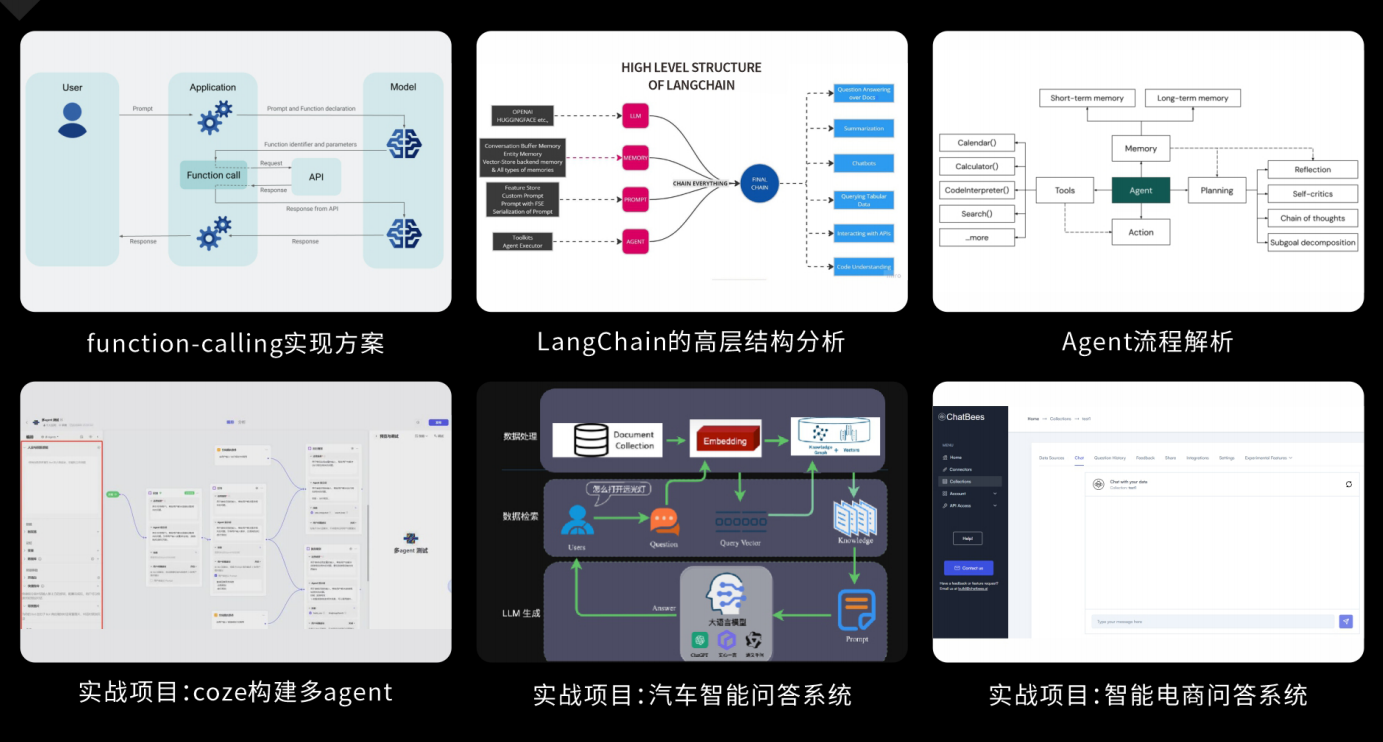
Agent应用架构进阶实践:掌握大模型Agent技术的核心原理与实践应用,能够独立完成Agent系统的设计与开发,提升多智能体协同与复杂任务处理的能力,为AI产品的创新与优化提供有力支持。
在这里插入图片描述

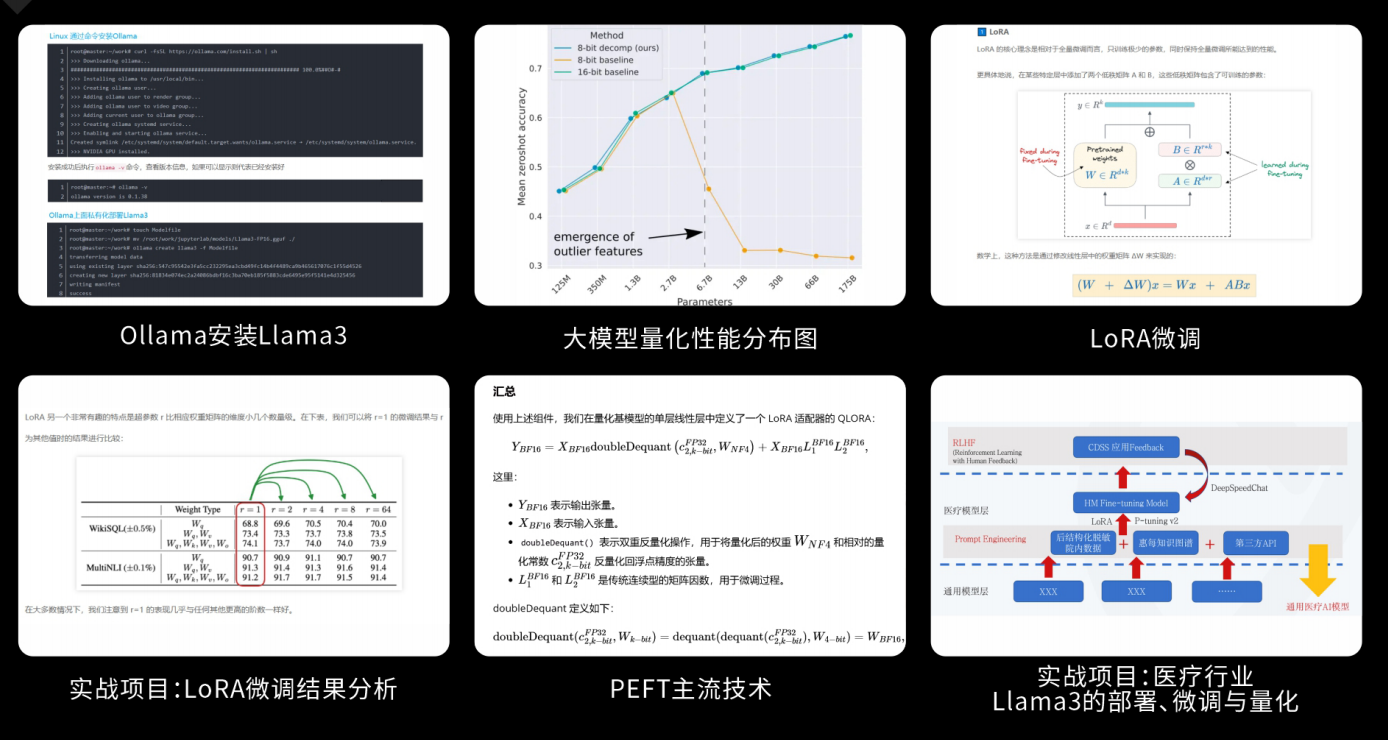
模型微调与私有化大模型:掌握大模型微调与私有化部署技能,提升模型优化与部署能力,为大模型项目落地打下坚实基础。 在这里插入图片描述
顶尖师资,深耕AI大模型前沿技术

实战专家亲授,让你少走弯路
在这里插入图片描述

一对一学习规划,职业生涯指导

  • 真实商业项目实训
  • 大厂绿色直通车

人才库优秀学员参与真实商业项目实训

以商业交付标准作为学习标准,具备真实大模型项目实践操作经验可写入简历,支持项目背调

在这里插入图片描述
大厂绿色直通车,冲击行业高薪岗位
在这里插入图片描述

文中涉及到的完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

GLM-5技术解析:DSA稀疏注意力与Muon Split优化的智能体工程实践 大模型智能体(Agentic AI)正从概念走向工程落地,其核心挑战在于长上下文推理效率、MoE架构训练稳定性与工具调用可靠性。DSA(DeepSeek Sparse Attention)通过任务自适应的动态稀疏机制,在200K上下文下实现接近稠密注意力的精度,同时降低1.7倍计算开销;Muon Split则针对多头注意力中各head角色差异,实施head-level正交化优化,显著提升logits稳定性与代码生成确定性。二者共同支撑了GLM-5在ARC基准、BrowseComp与SWE-bench等真实A 阅读详情

相关推荐

GLM-5:从氛围编程到智能体工程的范式跃迁

智能体(Agent)是大模型走向自主决策与闭环执行的核心范式,其本质在于目标分解、工具调用、规划推理与自我修正的能力。不同于传统指令跟随模型,智能体系统需依托稀疏注意力(如DSA)、MoE专家路由、强化学习(RL)驱动的后训练及多工具协同工作台等关键技术,实现从‘响应式输出’到‘主动性工程’的升级。GLM-5正是这一范式的典型代表——它通过7440亿参数支撑256专家协同,以400亿激活参数保障高保真推理,并在SWE-bench、BrowseComp等真实任务中验证了端到端软件交付与跨网页信息整合能力。对开

weixin_29988907的博客 293

万字长文深度剖析:DR系统如何让LLM变身“科研大神“,小白也能轻松上手

《Deep Research: A Systematic Survey》是一篇由多所顶尖高校学者联合发表的万字长文综述,介绍了"深度研究(DR)"这一新范式。DR结合了大型语言模型(LLM)的推理能力与外部工具,使LLM能够作为"研究智能体"完成复杂开放式任务。文章系统梳理了DR的发展路线图、四大核心组件、实践技术、评估方法及未来挑战,为AI驱动的研究提供了全面而系统的概览,是一份宝贵的"武功秘籍"。

Androiddddd的博客 981

Kimi K2.5原生智能体集群:多智能体协作的范式革命

多智能体系统(MAS)正从外部框架编排走向模型原生内化,其核心原理是将复杂任务分解为可并行、可验证、可调度的子单元,并通过长上下文实现全局状态协同。技术价值在于突破单模型推理瓶颈,以‘分工即能力’重构AI生产力——不追求更深的思考链,而追求更优的关键路径延迟(Critical Steps)。典型应用场景包括市场竞品分析、自动化代码生成、跨源合规尽调等强并行、多模态、需结果溯源的现实工作流。Kimi K2.5的Native Agent Swarm正是这一演进的标志性实践,依托PARL强化学习、超稀疏MoE架构

weixin_33980459的博客 354

程序员必看!万字长文详解大模型“深度研究“新范式,小白也能入门AI智能体开发!

这篇万字长文综述系统介绍了"深度研究(Deep Research, DR)"这一新范式,旨在将LLM的推理能力与外部工具结合,使其成为能完成复杂任务的研究智能体。文章详细阐述了DR的三阶段发展路线图、四大核心组件(查询规划、信息获取、记忆管理、答案生成)、实践技术(提示工程、监督微调、强化学习)、评估方法和未来挑战,为AI驱动的自主研究提供了全面而系统的技术框架。

m0_56255097的博客 1181

LSTM模型 轨迹经纬度预测

原始时间序列数据如下所示,我们只取前两列纬度和经度作为输入数据 我们设定用前六个位置信息预测下一个位置,则两个样本的输入输出数据如下所示: 创建LSTM网络训练模型: import numpy as np from keras.layers.core import Dense, Activation, Dropout from keras.layers import LS...

Muzi_Water的博客 2万+

Cursor概述及环境配置

Cursor 是一款基于 AI 的代码编辑器,支持 VS Code 配置迁移和 Java 开发环境配置。主要功能分为 Cursor Settings(AI 相关设置)和 Editor Settings(基础编辑器设置)。用户可通过一键导入或手动方式迁移 VS Code 配置,配置包括主题、扩展和快捷键等。对于 Java 开发,需配置 JDK 和 Maven 路径,并安装 Java 扩展插件以获得完整开发体验,如代码补全、调试和 Maven 项目管理。此外,Cursor 支持汉化配置,用户可安装中文语言包切换

Knight 3557

GEIS框架:AI长文生成的生成-评估-改进闭环与智能体技能进化

在人工智能领域,大型语言模型(LLM)已展现出强大的内容生成能力,但其在生成长篇、结构化文本时,常面临逻辑断裂、内容冗余等挑战。这背后的核心原理在于,模型不仅需要知识储备,更需要动态组织和运用知识的“技能”。GEIS框架通过构建“生成-评估-改进”的自动化闭环,系统性地解决了这一问题。其技术价值在于将AI从静态工具转变为具备自我优化能力的协同创作者,通过多轮迭代,使智能体在规划式写作、多维度评估和基于反馈的元学习中,持续进化其长文生成技能。这一方法在需要高质量、结构化内容输出的场景,如深度行业分析、复杂技术

weixin_30723433的博客 391

国产麒麟系统下Kettle安装避坑指南:解决aarch64架构不兼容问题

本文针对在国产麒麟系统上安装Kettle时遇到的aarch64架构不兼容问题,提供了详细的解决方案。通过剖析错误根源,指导用户获取并放置正确的SWT库文件,并修改启动脚本,成功解决“平台不支持”的报错,确保ETL工具在ARM架构的国产化环境中顺利运行。

weixin_29214691的博客 278

2026 智能体值不值得学?从开发、部署到落地的全流程技术拆解

2026年智能体开发与应用指南摘要:智能体技术值得投入但需精准定位。开发者掌握国产模型(如Step3.5Flash)和场景化能力可获得15%-30%薪资溢价;企业从客服、产线等小场景切入可实现60%效率提升。技术栈需分场景选择:个人开发者推荐开源模型+LangChain框架,企业级需自研多智能体协同系统。关键部署要点包括:采用国产芯片降本30%、数据脱敏处理、分阶段验证ROI。高价值落地场景包括电商客服(人力降45%)、制造预警(停机减50%)。建议开发者3个月完成项目实操,企业50万内试点验证,应届生需先

LiAng_crush的博客 734

Verilog 并行 FIR 滤波器设计

FIR(Finite Impulse Response)滤波器是一种有限长单位冲激响应滤波器,又称为非递归型滤波器。FIR 滤波器具有严格的线性相频特性,同时其单位响应是有限长的,因而是稳定的系统,在数字通信、图像处理等领域都有着广泛的应用。

m0_61687959的博客 1604

数字加网(一)— —概念及分色合成

由于大多数图像复制设备是二值设备,因此在图像复制过程中,必须先把连续调的灰度图像或彩色图像处理成二值的半色调图像,用单位面积的网点覆盖率来表现图像的颜色深浅变化。这个过程被称之为加网(Screening) 数字加网就是根据人眼视觉的空间混色特性,用人眼无法分辨的细小黑白点的单位覆盖面积来模拟灰度图像或彩色图像的层次变化,使得到

Sin_Geek成长の迹 8595

AI智能体实战:从核心能力拆解到智能运维助手搭建

AI智能体(AI Agent)作为能感知环境、自主决策并执行任务的AI系统,其核心原理在于结合大语言模型的规划推理能力与外部工具调用,实现从“流程自动化”到“目标自动化”的跃迁。在工程实践中,智能体通过任务规划拆解、工具使用(如API调用、代码沙盒执行)、记忆学习等能力,将模糊指令转化为具体操作步骤,从而创造显著的技术价值。其典型应用场景包括智能运维、数据分析与自动化报告生成等。本文以搭建“智能运维值班助手”为例,深入探讨了如何利用Dify、LangChain等平台或框架,通过配置工具链(如设置智能体沙盒以

356

Motoman机器人离线编程——Motocom32开发简介

欢迎关注Jungle的Motoman机器人离线编程专栏系列文章: Motoman机器人离线编程——Motocom32开发简介 Motoman机器人离线编程——Visio Studio环境配置 Motoman机器人离线编程——Motocom32库函数的使用与封装 Motoman机器人离线编程——Motocom32参考文献及注意事项 Motoman机器人离线编程——MotocomES介绍 ...

冯Jungle的个人博客 8714

基于角色扮演与推理时编排的小模型智能体架构设计与实践

大语言模型智能体是当前人工智能领域的热点,其核心在于让模型具备规划、推理与执行复杂任务的能力。然而,直接使用大模型成本高昂,而小模型在复杂任务上又常表现不佳。为解决这一矛盾,一种创新的技术路径应运而生:通过精妙的流程设计,引导同一个基础模型在推理时动态扮演不同角色,从而模拟大模型的深度思考过程。这种方法的核心原理是‘推理时编排’,它不依赖昂贵的模型微调,而是利用角色特定的提示词,在运行时将单一任务分解为规划、推理、执行等多个阶段,由模型分时扮演相应角色。这种架构显著降低了小模型的认知负荷,提升了任务完成的可

weixin_30235225的博客 493

PCL 读取和保存点云

PCL (Point Cloud Library) 是一个用于处理 3D 点云数据的开源库。在处理点云数据时,常见的任务包括点云的读写和可视化。PCL 提供了强大的 IO 模块来读取和写入各种格式的点云文件,并且提供了可视化模块来对点云进行渲染和显示。点云的读写与显示是很多 3D 数据处理任务的基础步骤,通过这些步骤,可以对点云进行预处理、分析和操作。

纵马踏花向自由 1740

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

动态重要性估计:解码时优化提升角色扮演智能体人设一致性

大语言模型(LLM)的文本生成基于自回归解码过程,模型根据输入上下文预测下一个词的概率分布。在角色扮演等任务中,标准解码策略往往难以在生成流畅回复与遵循特定人设之间取得平衡,导致“人设崩塌”。动态重要性估计(Dynamic Importance Estimation)作为一种解码时优化技术,通过实时评估人设信息在当前生成步骤中的关键程度,动态调整词表概率分布,从而在不修改模型参数的情况下实现细粒度引导。该技术将优化点从训练阶段前置到推理阶段,具有部署灵活、成本较低的优势,能有效提升智能体在对话中对性格、背景

weixin_30681121的博客 390

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

AI智能体进化顾问:构建自动化AI优化系统的核心架构与实践

在人工智能工程实践中,自动化机器学习(AutoML)旨在通过算法自动完成模型选择、超参数调优等过程,从而降低机器学习应用的门槛并提升效率。其核心原理在于将优化过程形式化为一个搜索问题,利用贝叶斯优化、进化算法等技术在庞大的参数空间中寻找最优解。这项技术的价值在于能够显著减少人工干预,实现模型的持续自我改进,尤其适用于智能体系统等复杂AI应用场景。具体到AI智能体领域,进化顾问系统通过双层架构实现了对工作智能体的自动化监控、分析与优化建议生成。该系统基于LLM驱动的分析引擎,能够从交互轨迹中诊断问题,并结合强

weixin_30740581的博客 613

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

智能体自我优化框架VeRO:让AI自主进化,实现持续性能提升

在人工智能领域,智能体(Agent)作为能够感知环境、做出决策并执行动作的自主系统,其核心原理在于通过强化学习、规划算法与环境交互实现目标。这一技术价值在于将静态的模型能力转化为动态的问题解决能力,广泛应用于客服自动化、代码生成、数据分析等场景。然而,智能体在部署后常面临性能瓶颈,传统手动调优方式效率低下。VeRO框架创新性地引入“智能体优化智能体”的元优化范式,通过构建一个管理智能体来自动评估、诊断并优化目标智能体的提示词、工具使用策略与工作流。该框架采用分层架构,上层优化器基于轨迹数据分析,下层执行器在

aofan9566的博客 429

可微分智能体混合:基于群体智能与反射进化的大模型协作框架

在人工智能领域,模型集成是一种提升系统鲁棒性与性能的经典方法,其核心原理在于通过组合多个模型的预测结果来降低方差与偏差,从而获得比单一模型更优的泛化能力。传统集成方法如投票法或加权平均,虽有效但存在静态、不可学习的局限。随着大语言模型的兴起,一种更具潜力的技术路径——可微分智能体混合应运而生。该技术借鉴了群体智能与反射进化的思想,其核心价值在于将多个异构的LLM智能体(如代码生成、逻辑推理、事实核查等不同角色)的协作过程构建为一个可端到端优化的计算图。系统通过一个可学习的路由器网络,能根据具体任务动态分配各

weixin_34310369的博客 420

ToolVerse:基于工具生态的智能体强化学习新范式

强化学习是人工智能的核心技术之一,其核心原理是智能体通过与环境的交互,通过试错学习最优策略以最大化累积奖励。传统强化学习通常在封闭、低维的模拟环境中训练,但在面对真实世界的大规模、长视野任务时,往往因环境复杂度和奖励稀疏性而失效。其技术价值在于为解决开放世界中的复杂决策问题提供了理论基础。应用场景广泛,涵盖机器人控制、游戏AI、自动驾驶、资源调度等多个领域。近年来,随着大型语言模型和工具调用能力的发展,一种名为ToolVerse的新范式应运而生。它将外部工具(如API、数据库、云服务)的集合视为一个可供探索

weixin_33985507的博客 284

《COZE》超详细拆解与学习笔记

定义:字节跳动推出的AI Agent开发平台。核心卖点零代码/低代码。无论是否会编程,都能像搭积木一样搭建基于大模型的AI应用。发布渠道:可发布到微信、飞书、抖音,或通过API/SDK集成到自有业务系统。如果面试官问起,除了讲“会用了”,更要体现出架构思维和问题解决能力对AI应用架构的理解:我明白了现代AI应用不再是单纯调API,而是“大模型 + 工具(插件)+ 数据(知识库/数据库)”的三层架构。Coze通过可视化工作流将这三点完美串联。工程化落地能力:通过“历史老师”和“动物世界”项目,我掌握了。

2302_81153516的博客 571

AI智能体如何用长程记忆与博弈策略玩转狼人杀?

在人工智能领域,智能体(Agent)的长程记忆与复杂策略规划能力是衡量其智能水平的关键。传统对话模型常受限于上下文长度,难以处理多轮次、信息动态变化的场景。通过向量数据库与知识图谱技术,可以实现信息的结构化存储与高效检索,从而支持智能体进行持续推理与决策。这种能力在需要多层策略博弈与角色扮演的应用中极具价值,例如商业谈判模拟、社交机器人及复杂系统诊断。OpenViking项目以狼人杀为试验场,深入探索了AI智能体在长程记忆与博弈策略方面的突破,展现了多智能体协作与对抗框架的技术实力。

ciqiaofu0192的博客 334

智能体工作流与推理优化:o3与Gemma 3双轨实践指南

智能体(Agentic AI)正从概念走向工程落地,其核心是将任务规划、工具调用与结果整合内化为模型原生能力,而非依赖提示词工程;而推理优化(Inference Optimization)则通过量化感知训练(QAT)、混合架构设计等手段,让大模型真正适配消费级硬件。二者协同构成新一代AI应用的底层支柱:前者定义‘做什么’,后者保障‘做得快、稳、省’。在实际场景中,智能体高频调用依赖低延迟执行,未经优化的模型会因首token延迟高而拖垮整个工作流;反之,仅优化不支持工具调用的模型,也难以支撑真实业务闭环。本文

460

DeepSeek-V3.2硬核解析:稀疏注意力、强化学习与智能体合成三重突破

大语言模型(LLM)在长上下文推理、工具调用泛化与多步任务编排中面临显存爆炸、指令漂移和状态坍塌三大工程瓶颈。稀疏注意力机制通过动态局部-全局混合策略重构计算范式,显著降低KV缓存占用并提升推理效率;强化学习框架则从结果反馈升级为token级、步骤级与轨迹级的全过程干预,增强决策确定性与因果鲁棒性。这些技术突破共同支撑起真正可落地的LLM智能体——不仅能理解复杂API规范,还能自动生成带时空约束的多跳任务链。本文聚焦DeepSeek-V3.2的核心创新,涵盖DSA稀疏注意力实现原理、CANN适配下的昇腾高效

weixin_30432579的博客 466

搜索智能体数据飞轮构建:从反馈采集到模型迭代的工程实践

在人工智能与搜索技术融合的背景下,智能体正从传统的信息检索工具演变为能理解复杂意图、规划并执行任务的关键技术。其核心原理在于结合大型语言模型的深度理解能力与外部工具调用,实现从“匹配链接”到“解决问题”的范式转移。这一转变的技术价值在于显著提升了任务完成率与用户体验,为个性化服务、自动化决策等应用场景奠定了基础。要让智能体持续进化,关键在于构建一个高效的数据飞轮——通过系统性地采集用户交互中的隐式与显式反馈(如任务完成信号、修正行为),并利用这些数据驱动提示词工程、监督微调及强化学习等环节的迭代优化,从而形

weixin_34117211的博客 316
上一篇: (建议收藏)智能体记忆终极指南!Mem0/Letta/Zep等六大神器横评,这篇是天花板!
下一篇: 你的AI还只会“说话”?具身智能让它学会“动手”!万字长文详解VLA模型!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值