大模型私有部署的最优解:构建企业级大模型统一能力底座

AI大底座:大模型时代的深度解析与实践 为了构建一个高效、可靠的AI大底座,我们需要综合考虑高性能计算能力、大数据管理能力、自动化机器学习平台、模型可扩展性和安全性与隐私保护等方面的问题。大数据管理能力:AI大底座需要提供高效的数据管理功能,包括数据存储、数据传输、数据标注、数据清洗等方面的服务。模型可扩展性:AI大底座需要具备良好的可扩展性,能够支持不同规模和类型的模型,满足各种应用场景的需求。AI大底座是大模型时代的核心基础设施,它能够提供从数据采集、标注、清洗、存储、传输到模型训练、部署、推理等全流程的服务。 阅读详情

企业在推进AI大模型私有化部署时,往往会陷入从算力选型适配到系统配置的多重困境,真正限制落地效率的并非单一技术点,而是多环节间的耦合与不确定性,构建企业级大模型统一能力平台针对这一全链条复杂性,提供平台化解耦方案,可以帮助企业缩短部署周期,降低尝试门槛。

img

通过整合软硬件资源、预置多类AI应用与模型支持,构建了适用于多行业的标准化私有化部署体系,既提升了部署一致性,也为企业提供了更清晰的技术演进路径,使模型不再只是“能跑”,而是真正“能用、好用、可管”。

img

大模型的运行不仅依赖于算力和框架,更与上层应用深度绑定。传统部署方式下,模型、硬件与业务流程高度耦合,难以迁移、难以扩展。构建可解耦的技术体系,成为企业实现灵活演进与持续创新的关键。
img

当前主流企业的算力资源呈现出多芯片、多架构共存的趋势,如何在异构环境中实现统一管理和高效调度,成为影响大模型部署效率与资源利用率的核心问题,也是在规模化应用过程中必须解决的技术瓶颈。

img

在多轮对话、长文本处理等高负载场景中,推理过程对显存调度能力提出了更高要求。精细化的显存切分与动态资源分配机制,成为提升并发能力与响应稳定性的关键手段,直接影响模型服务的可用性和稳定性。

img

随着大模型推理任务持续复杂化,企业在实际部署中往往面临显存瓶颈、计算资源分配冲突和任务排队拥堵等现实问题。为了提升整体效率,越来越多系统开始尝试引入量化压缩、张量并行、显存管理与调度策略优化等手段,在保障模型精度的同时降低资源消耗和响应延迟。但这些优化技术分散在底层执行逻辑、资源调度和算力分层之间,缺乏统一调度与封装机制,导致部署工作仍然依赖高度工程化能力,也进一步凸显了对系统化调度架构的迫切需求。

img

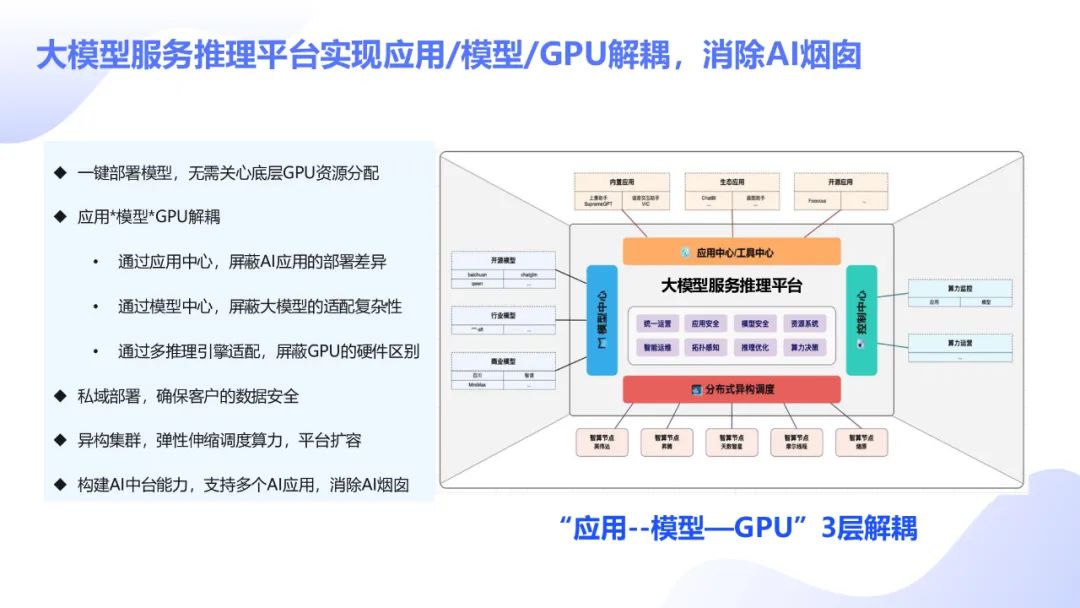
为了解决上述推理部署过程中的复杂协同与资源管理问题,我们构建了SpiritX灵启大模型推理服务平台,通过模型中心、工具中心、应用中心与控制中心四大模块,将模型接入、能力调用、资源调度与应用封装进行系统化统一管理。平台不仅降低了企业使用多模型、多设备、多工具的工程复杂度,更让大模型能力具备了“像服务一样被调用”的交付模式,为私有化部署环境下的高效落地提供了强有力的支撑。

img

SpiritX灵启大模型推理服务平台以弹性架构支撑高并发推理请求,通过多模型调度与异构集群适配,帮助企业在资源受限的私有环境中实现能力最大化。同时,平台预集成知识库问答、文档写作、智能问数等常用组件,配合统一的API接口与权限体系,为各类业务快速调用与复用提供完整支持,真正将复杂的模型能力转化为企业可用、可控、可持续的智能基础设施。

img

在大模型部署从探索走向规模化的过程中,企业需要的不只是单点能力的积累,而是一套真正可交付、可迭代、可扩展的体系。SpiritX灵启大模型推理服务平台正是基于这一核心理念构建,帮助组织从底层资源管理到上层业务集成全面打通,将复杂的AI部署转化为标准化、可复制的智能生产力底座。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

【大模型学习】私有大模型部署(基础知识) 保护内部隐私。 阅读详情

相关推荐

通用性技术底座AI大模型与各行业专用性AI小模型搭建(第一篇)

行业专用性AI小模型:- **特点**:这些模型针对特定行业或具体业务需求进行设计和训练,其规模可能相对较小,但对特定问题有更高的精准度和专业性。例如医疗影像诊断模型、金融风控模型、法律文档分析模型等。- **优势**:因为专注于某一特定领域,所以对这个领域的专业知识掌握更深入,能够捕捉到领域内的细微差异和复杂关系,提供更为精确的服务。- **应用场景**:主要应用于专业化程度高、需要深度行业知识和经验的场景,如病历分析、股票走势预测、合规文件审核、产品推荐等。

初心不忘产学研的博客 4665

大模型私有部署怎么做?构建统一能力底座才是关键!

企业在推进AI大模型私有化部署时,往往会陷入从算力选型适配到系统配置的多重困境,真正限制落地效率的并非单一技术点,而是多环节间的耦合与不确定性,构建企业级大模型统一能力平台针对这一全链条复杂性,提供平台化解耦方案,可以帮助企业缩短部署周期,降低尝试门槛。

2401_85375186的博客 1028

企业级AI平台选型指南:从算力底座到应用落地的四层架构

企业级AI平台并非单一模型或推理代码,而是融合算力、数据、模型与应用的一体化基础设施。在技术选型中,比模型跑分更重要的是平台能否将企业数据转化为业务结果。大模型只是发动机,完整的平台才是整车——算力调度决定边际成本,数据层常是项目卡点,模型层提供微调与评测,应用层则让AI嵌进真实业务流程。隐藏门槛在于运维、安全与工程化能力。本文横评百度千帆、阿里百炼、华为ModelArts、腾讯TI、火山引擎、讯飞星火、商汤大装置与第四范式先知,从价格、开放度、行业落地三维度给出判断框架,并提示TPM并发限制、数据合规与迁

weixin_34133829的博客 368

【手把手教你】搭建私有大模型+私有知识库

就是把目前最流行的开源大模型部署到自己的电脑上,无需联网、也不用买会员,隐私可不会泄露,直接可以和AI聊天。就是你可以把你喜欢的资料统统喂给大模型,然后让AI查询你指定的材料,再来回复你的问题。若是在公司搭建这套组合,可以把公司的介绍、产品数据、销售数据等等都发给私有大模型,回复用户的信息就更有针对性。大模型搭建已经分享过了,就不在此赘述,直接进入主题,知识库搭建。AnthingLLM可以直接在其界面上对话,导入各种形式的资料。也可以把本地AI大模型和知识库做成接口API,在企业的其他应用里面去调用。

2301_76168381的博客 4828

2026企业级AI数据分析平台选型指南:从BI到数字同事

数据分析正经历从传统BI报表向AI驱动智能分析的范式迁移。过去,企业依赖人工取数与固定报表,业务人员提出需求后需等待数天才能获得结果;如今,大模型与Agent架构的成熟让“用自然语言直接问数、自动归因、生成结论”成为可能,数据分析角色从“看数工具”进化为“用数同事”。这一转变的核心在于语义层与指标层的建设,它决定了AI在真实业务场景中的准确性与可靠性。与此同时,ChatBI、私有化部署、权限治理、POC验证等概念已成为企业选型时的高频考量维度。本文基于2026年主流厂商与开源方案的实际表现,梳理了传统BI转

weixin_33768481的博客 401

大模型部署六种方式:从Ollama到vLLM的选型实战指南

大模型部署本质上是资源约束、开发效率与生产可靠性的系统性权衡。理解推理引擎(如vLLM)、轻量服务框架(如FastAPI)、低门槛工具(如Ollama)和交互界面(如Gradio)各自解决的核心问题,是避免‘技术堆砌’的关键。vLLM通过PagedAttention重构GPU显存管理,显著提升吞吐;Ollama以GGUF量化+自动后端适配降低硬件门槛;Gradio聚焦快速验证,FastAPI支撑高并发API,SGLang实现推理流程可编程,Docker Compose保障多服务协同一致性。这些技术并非互斥,

481

企业级大模型应用实战:从Qwen3私有化部署到数字人交互

在人工智能落地进程中,大模型应用开发已从简单的API调用转向全链路工程化。要实现企业级可靠交付,需理解模型服务、应用编排、提示词调优与交互形态的协同关系。Qwen3作为开源模型支持私有化部署,保障数据安全与可控性;Dify等编排平台则串联知识库与工作流,降低系统集成门槛。提示词工程通过系统指令与少样本示例提升输出稳定性,为业务场景提供确定性。当交互延伸至语音与形象时,多模态数字人整合ASR、LLM、TTS与渲染组件,形成完整闭环。本文以一套实战路线为框架,拆解从私有化LLM服务搭建到数字人交互的关键技术路径

weixin_34208185的博客 308

从零构建PEMFC仿真模型:MATLAB/Simulink中的模块化拆解与系统集成

本文详细介绍了如何在MATLAB/Simulink环境中从零构建质子交换膜燃料电池(PEMFC)仿真模型,包括电化学模型、气体供应系统和热管理系统的模块化实现。通过多物理场耦合技巧和系统集成策略,帮助工程师和研究者高效开发PEMFC控制策略,优化性能并实现实时仿真。

weixin_29294975的博客 360

私有知识库 + 智能体开发:JBoltAI 的两大核心能力解析

在客户服务中,智能体可联动销售系统、售后数据库,为用户提供从 “需求咨询” 到 “方案定制” 再到 “售后跟进” 的一站式服务,大幅降低人工介入成本。而智能体则为私有知识库赋予了 “行动能力”,让静态的知识转化为动态的业务服务,例如将产品手册中的参数信息自动转化为报价单,或将历史案例中的解决方案应用于新的客户需求。私有知识库解决了 “数据如何用” 的问题,智能体开发回答了 “系统如何动” 的疑问,二者共同构成了企业实现 AIGS(人工智能生成服务)的技术支柱,为数智化转型提供了可操作、可延伸的实践路径。

m0_59800488的博客 709

告别IIS折腾!用.NET8+Kestrel在Windows上5分钟搞定Web API部署

本文介绍了如何使用.NET8和Kestrel在Windows上快速部署Web API,告别繁琐的IIS配置。通过5分钟实战教程,开发者可以轻松实现高性能、跨平台的API服务部署,显著提升开发效率和系统性能。

weixin_42528780的博客 246

不止于使能:用汇川PLC功能块封装,实现伺服轴状态管理与安全逻辑

本文深入探讨了汇川PLC功能块封装在伺服轴控中的应用,详细介绍了如何通过高级封装技术实现伺服轴的状态管理与安全逻辑。文章涵盖了从基础使能到全生命周期监控的进化,多轴协同的实例化管理策略,以及安全逻辑的防御性编程技巧,为工业自动化领域的工程师提供了实用的解决方案和最佳实践。

weixin_28684825的博客 272

OpenClaw翻车后怎么选?2026国产私有化替代方案商排名与企业级定制化智能体选型

据51CTO博客联合行业机构发布的2026年AI办公行业数据显示,国内超92.8%职场人认可AI智能体可提升办公效率,但超70%用户反馈原生OpenClaw(龙虾)本地部署流程繁琐、设备依赖度高、安全隐患突出,65%企业用户因平替产品适配性差、运维成本高频繁更换工具。随着国产AI办公技术快速迭代,openclaw/龙虾国产平替平台成为政企、职场人群、开发者的主流选择,但市面产品同质化严重、功能参差不齐,普通用户难以精准选型。   效率红利真实存在,落地痛点同样真实存在——这构成了2026年企业AI选型的

2600_96788433的博客 113

将CityScapes数据集转换为COCO格式的实例分割数据集

##¥##2019年结束前最后两小时,写出本年度最后一篇博客,不是博主没地方去跨年,实在是Coding乐趣无穷ahhhh ##¥## COCO数据集是研究实例分割的通用数据集,但是针对道路环境的数据较少,对于自动驾驶和移动机器人的应用并不适配。而提供道路环境的实例分割数据的数据集目前有KITTI、CityScapes、Apllo等,CityScapes算是应用较广,数据质量较高的一个,所以,本篇...

陆羽飞的博客 9940

企业级低代码平台选型与落地:从Java集成到AI Agent编排

低代码开发平台正在从表单审批工具进化为支撑企业级应用的运行时底座。在传统Java技术栈与AI原生应用加速融合的背景下,现代低代码平台已具备模型驱动架构、可视化服务编排和API生命周期管理三大核心能力,能够承载企业级Java应用开发、AI Agent编排以及复杂系统集成等高要求场景。它的技术价值在于:一方面通过可视化方式降低业务应用的交付门槛,另一方面以统一的权限模型和审计机制保障企业级合规需求。面向制造、零售、互联网等数字化压力较大的行业,低代码平台正成为打通ERP、CRM与自研系统数据孤岛、缩短业务响应周

weixin_32308101的博客 325

置顶必读(2) |《滚雪球学数学建模》专栏目录 & 历年国赛/美赛真题库 & 真题解析(持续更新中)

本专栏《滚雪球学数学建模》采用“从零开始、逐步滚雪球”的学习路径,把数学建模的基础理论、方法工具与大量实战真题(尤其是国赛题,涵盖2025-1992所有真题)有机融合,形成一套系统化训练路线。非常适合零基础入门、希望提升模型与工程化能力的本科/研究生,以及备战全国大学生数学建模竞赛(国赛/省赛)的同学。加油,我们一起把建模能力打造成可迁移的核心竞争力!

**My Coding Family** 26万+

Spring AI 项目实战(十二):Spring Boot +AI + DeepSeek + 百度OCR 公司发票智能处理系统的技术实践(附完整源码)

本文介绍了基于百度OCR API与DeepSeek AI的发票智能处理系统,通过整合AI技术实现发票识别、信息提取和验证的全流程自动化。系统采用Spring Boot 3.2.0架构,结合百度OCR的高精度图像识别和DeepSeek的语义理解能力,显著提升了发票处理效率与准确率。关键技术包括多模型融合、智能错误纠正和自适应学习机制,实现了95%以上的识别准确率,将传统处理效率提升90%以上。该系统为数字化转型中的企业财务管理提供了智能化解决方案,具备高精度识别、实时处理、智能验证等核心优势。

博客 1627

赋能企业智能数据新基建,SQL 生成推荐哪家大模型?火山引擎筑牢数智落地底座

如果您的团队正为沉重的取数需求所累,渴望通过AI赋能BI平台与数据分析流,那么兼具强语义理解、多方言适配、支持专属微调,且有火山引擎提供强大工程化与成本管控支撑的豆包大模型,绝对是不容错过的最优解。依托火山引擎海量算力的并池优化,豆包大模型展现出了极致的性价比,让企业不仅“用得好”,而且“用得起”,为大规模推广铺平了道路。首先是高并发API服务,即便是在企业内部BI平台或自助查询系统中,面对大量业务人员的同时调用,火山引擎底座依然能提供稳定、流畅的流式输出响应,大幅降低等待时延。

2600_96788429的博客 20

PCIE的MSI中断处理机制与优化策略

PCIe设备的。

xiaoheshang_123的博客 518

MaxKB企业级知识库问答与智能体编排实战:从RAG调优到落地部署

检索增强生成(RAG)通过向量检索与重排序技术,将外部知识注入大模型生成过程,有效解决知识割裂与幻觉问题。其核心原理是文档分段向量化后,结合混合检索与重排序模型精筛上下文,再交由大模型生成答案。技术价值在于低成本构建私有化知识问答系统,应用场景覆盖企业内部文档问答、售后支持与智能体任务编排。MaxKB作为开源平台,内置RAG全流程与工作流引擎,支持本地模型对接与权限审计,显著降低企业落地门槛。

weixin_29050513的博客 212

Cadence OrCAD Capture 保持元器件编号情况复制元件,复制后元器件编号与复制前不同的问题解决

如下图所示复制时,已经勾选了“Preserve reference on copy”但是复制后的编号却与复制前不一样。本文简单介绍其原因及解决方法。

fydar的博客 3164

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

企业AI算力工作站/AI大模型训练工作站DLTM零代码私有化部署守护企业数据安全

AI的价值最终要通过数据来兑现,但数据的安全边界决定了AI能走多远。企业AI算力工作站DLTM通过私有化部署、全链路数据安全控制,帮助企业在“拥抱AI”与“守住数据”之间找到最优解。

AI与流媒体视频技术 236

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

2026国内MaaS平台选型指南:模型服务、API调用、私有化部署与成本解析

大模型技术加速落地,越来越多的开发者和企业开始关注“模型即服务”(MaaS)这一形态。当模型能力趋于同质,选择标准便从单纯看效果转向模型服务的综合体验,包括API调用是否稳定、是否支持私有化部署、整体成本是否可控。当前主流平台如通义千问、DeepSeek、智谱GLM等均提供OpenAI兼容接口,大幅降低接入门槛。无论是通过Postman快速调试千问接口,还是在Python中调用GLM、星火、Kimi,开发者都希望获得更顺滑的集成路径。同时,对于数据敏感和高调用量场景,基于开源模型加Dify平台构建私有化服务

weixin_34074740的博客 460

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Qwen3私有化部署与提示词工程:从模型选型到多模态数字人全栈开发

大语言模型在企业级应用中的落地,远不止调用一个API那么简单。理解模型推理模式、私有化部署与提示词工程的基本原理,是构建稳定、可控的智能应用的前提。Qwen3系列通过可切换的思考模式与多尺寸开源权重,为不同业务场景提供了灵活的技术底座。从部署环境准备、推理框架选型,到设计结构化系统提示词以约束输出质量,再到结合ASR、TTS与数字人渲染的端到端多模态交互,完整链路展现出工程化能力的重要性。本文梳理了一套从模型私有化到提示词调优,最终落地为数字人应用的开发路径,为企业构建低延迟、高可控的LLM系统提供参考。

weixin_34279579的博客 397

Qwen开源大模型全栈解析:推理优化、编程能力与生产部署

大语言模型(LLM)的开源实践正从‘可用’迈向‘好用’,其核心在于基础模型能力、高效推理引擎与工程化落地能力的协同。Qwen系列作为当前中文场景SOTA开源模型代表,依托3T高质量多语言训练数据、NTK+LogN长上下文优化、Int4/KV Cache量化推理及原生Code Interpreter支持,在C-Eval、HumanEval等基准上实现全面领先。技术价值体现在显存可控(如7B-Int4单卡3090仅需8.2GB)、API兼容(OpenAI格式)、多端部署(CPU/GPU/Android)与低成本

weixin_34080571的博客 525

中小企业AI落地的算力“最优解”:一台插电即用的Mac mini

中小企业不是没有 AI 需求,而是缺少合适的方案,正如 20 年前的用友和金蝶普及了 ERP,Mac mini 代表了一种AI普惠的新可能:高性能、低功耗、易维护。而开箱即用+订阅服务也可能是最适合的商业模式。正如任何有价值的技术实践一样,从知道到做到,中间隔着无数的细节、经验和坑。AI 普惠的时代已经到来,但行动永远是拉开差距的关键。如果希望实际动手实现这套方案,或者你希望在企业 AI 落地的过程中,获得更深入的指导和交流,欢迎加入我的知识星球社群。

欢迎来到我的博客 1335
上一篇: GraphRAG变种:HippoRAG进化到HippoRAG2.0,提升多跳复杂推理性能
下一篇: 论文浅尝 | LightPROF:一种用于基于知识图谱的大语言模型的轻量级推理框架(AAAI2025)
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值