AAAI 2025 | CNC:用于无监督多类异常检测的跨模态正态约束

论文速递|Graph-MoE模型让多元时间序列异常检测更精准 传统图神经网络(GNN)虽能建模变量关系,但仅依赖最后一层输出,忽略中间层的局部与全局信息(例如浅层捕捉短距离依赖,深层捕获长距离依赖)。- 即插即用:Graph-MoE可无缝集成至其他GNN模型(如GANF、MTGFlow),平均提升2.5%-3.5%的检测精度。- 多层信息融合:传统GNN仅用最后一层输出,而Graph-MoE通过混合专家(MoE)模块,动态整合不同GNN层的信息。- 动态路由决策:根据当前数据与历史模式的相关性,自适应调整各层信息的贡献,提升对突发异常的敏感度。 阅读详情
AI摘要

本文介绍了一种名为CNC(跨模态正态约束)的新方法,用于无监督多类异常检测。该方法通过学习不同视觉模式中的文本正态性,引导解码特征朝向“正常”文本表示,抑制解码器对异常模式的过度泛化。此外,引入了门控专家混合模块来处理多类训练中的模式干扰,以及特征级正态促进机制来增强视觉特征对异常模式的敏感性。CNC在MVTec AD和VisA数据集上取得了具有竞争力的性能。

论文信息

题目:CNC: Cross-modal Normality Constraint for Unsupervised Multi-class Anomaly Detection
CNC:用于无监督多类异常检测的跨模态正态约束

论文创新点

  1. 跨模态正态约束(CNC):论文提出了一种新的跨模态正态约束方法,利用类别无关的可学习提示来捕捉不同视觉模式中的常见文本正态性,并引导解码特征朝向“正常”文本表示,从而抑制解码器对异常模式的过度泛化(OG)。

  2. 门控专家混合模块(MoE):为了处理多类训练中不同补丁模式之间的相互干扰,论文引入了门控专家混合模块。该模块通过选择性地分配不同专家组合来处理不同的补丁模式,减少了模式间的干扰,进一步提升了检测性能。

  3. 特征级正态促进(FNP):论文设计了一种特征级正态促进机制,通过引入跨模态控制系数,增强了视觉特征对异常补丁模式的敏感性。

  4. 多模态蒸馏框架:论文构建了一个全新的跨模态蒸馏框架,结合了视觉和文本模态的信息,显著提升了异常检测的准确性。

摘要

现有的基于无监督蒸馏的方法依赖于编码和解码特征之间的差异来定位测试图像中的异常区域。然而,仅在正常样本上训练的解码器仍然能够很好地重建异常补丁特征,从而降低了性能。这个问题在无监督多类异常检测任务中尤为突出。作者将这种行为归因于解码器的“过度泛化”(OG):多类训练中补丁模式的多样性显著增加,增强了模型对正常补丁的泛化能力,但也不可避免地扩大了对异常补丁的泛化。为了缓解“OG”,作者提出了一种新方法,利用类别无关的可学习提示来捕捉各种视觉模式中的常见文本正态性,然后将其应用于引导解码特征朝向“正常”文本表示,抑制解码器对异常模式的“过度泛化”。为了进一步提高性能,作者还引入了一个门控专家混合模块,专门处理多样化的补丁模式,并减少多类训练中它们之间的相互干扰。该方法在MVTec AD和VisA数据集上取得了具有竞争力的性能,证明了其有效性。

关键字

异常检测,跨模态学习,正态约束,专家混合,无监督学习

方法

概述

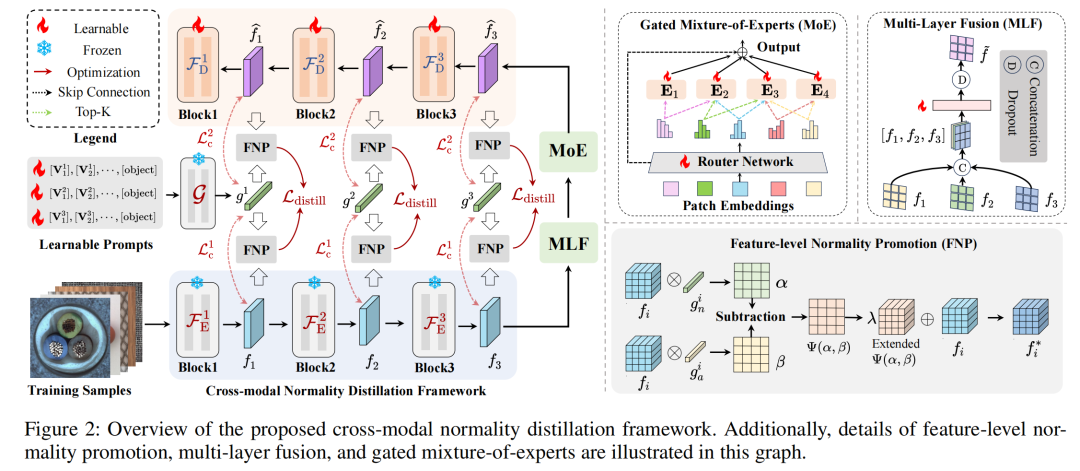
所提出方法的框架如图2所示。作者的方法包括三个主要部分:(1)视觉蒸馏框架;(2)跨模态正态约束;(3)门控专家混合。在(1)中,作者介绍了基本的反向蒸馏网络。在(2)中,作者提出了跨模态正态约束,以确保解码特征与文本“正常”表示对齐。此外,作者提出了一个跨模态控制系数,用于提高对异常补丁模式的敏感性,称为特征级正态促进。在(3)中,详细展示了门控专家混合(MoE)模块,专门处理各种补丁模式。最后,为了方便起见,给出了作者方法的推理阶段。
视觉蒸馏框架

与之前的单模态蒸馏方法相比,作者选择了多模态骨干网络CLIP-ViT作为编码器,这意味着可以利用文本模态信息来提高检测性能。具体来说,对于给定的图像,CLIP视觉编码器将编码为多层潜在空间特征,其中表示第层特征(ViT中每层的特征大小一致),是ViT中残差注意力层的数量。作者选择第层、第层和第层特征作为视觉编码特征。为了方便起见,设、、分别表示第层、第层和第层块,是对应的编码特征。对于视觉解码器,作者采用三个通用的残差注意力块(ViT的基本模块)作为解码器,并提取相应的特征进行重建。因此,作者将解码器表示为,包含三个块,对应的解码特征为(见图2)。此外,为了进一步缓解“过度泛化”,在编码特征上应用高斯噪声以获得其扰动版本。

跨模态正态约束

为了缓解多类训练中意外的“过度泛化”,作者提出了文本模态正态约束,以引导解码特征朝向“正常”文本表示,抑制解码器对异常方向的“过度泛化”。作者提出的跨模态正态约束的关键在于应用可学习的类别无关提示,从各种正常样本中学习常见的正态性,并在训练阶段保持视觉编码和解码特征在文本空间中的语义一致性。

学习跨模态正态性

在本节中,作者旨在应用类别无关的可学习提示,从各种编码特征中学习文本正态性。具体来说,对于给定的图像,作者应用编码器中的块来获取多层特征。根据公式(2)和公式(3),作者初始化了三组可学习提示,其中用于从不同层的视觉编码特征中学习文本正态性。然后,每个提示对被输入到CLIP文本编码器,生成相应的文本特征,其中,。接下来,作者采用模态对齐优化目标,从中学习文本正态性:

其中表示的全局特征,是温度系数。接下来,文本特征被应用于特征蒸馏和解码,以缓解意外的“过度泛化”。

特征蒸馏与正态促进

在本节中,文本特征被应用于蒸馏,以提高对异常补丁模式的敏感性。具体来说,作者首先在视觉编码和解码特征和上定义了一个跨模态控制系数。它旨在计算视觉补丁特征与文本特征之间的跨模态激活图,提高对意外异常补丁模式的敏感性。具体来说,作者设计了新的编码特征,带有跨模态正态控制系数,如下所示:

其中,是一个缩放系数,是L2范数,控制系数写为

其中权重图和定义为:

其中,,表示与的每个补丁嵌入之间的向量乘积,是补丁嵌入的索引。因此,,是逐元素加法操作。类似地,根据公式(5)和公式(6),作者还获得了带有跨模态控制系数的解码特征:

其中,。

作者将上述步骤称为“特征级正态促进”(FNP),如图2所示。接下来,作者给出了一个新的跨模态蒸馏损失,以确保编码和解码特征与相应的控制系数的一致性:

其中是展平函数。

特征解码与正态约束

在本节中,作者应用由公式(4)训练的文本特征作为锚点,以指导特征解码,缓解意外的“OG”。作者的解决方案是在训练期间约束解码特征的文本表示不偏离“正常”,即作者还保持解码特征的类别标记与正常文本特征对齐:

其中表示的全局特征。作者结合公式(4)和公式(10)给出跨模态约束损失:

其中是一个超参数。每个文本特征是一个动态锚点,用于保持解码特征朝向“正常”方向。

门控专家混合模块

多层融合

遵循之前的工作,预训练编码器的不同层特征被聚合,以提高检测性能。对于输入,作者首先应用编码器提取多层特征,并将它们连接为。作者采用投影层(一个带有dropout块的线性层)将其通道维度转换为:

其中是一个融合特征(见图2 MLF),并输入到后续的MoE模块。

门控专家混合

作者采用不同的专家组合来处理不同的补丁模式,减少它们之间的相互干扰。具体来说,对于给定的小批量融合特征,作者获得一批补丁嵌入特征,其中。作者的目标是为每个补丁分配不同的专家组合,以识别不同的补丁模式。因此,作者首先使用路由器网络为每个补丁分配专家相关分数,即

其中,是专家网络的数量,每个由一个MLP组成。接下来,作者选择具有前个分数的专家来处理补丁嵌入向量,记为。接下来,作者获得每个补丁嵌入的唯一处理组合,即

为了防止路由器将过大的权重分配给少数专家,从而导致单一的评分操作,作者应用了一个通用重要性损失来优化MoE:

其中是标准差操作,是为了数值稳定性而添加的。最后,根据公式(9)、(11)和(15),作者获得了训练模型的总损失:

实验设置
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

论文整理1——《基于高阶非局部哈希的无监督跨模态检索》 论文整理1——《基于高阶非局部哈希的无监督跨模态检索》 前言 无监督的跨模态检索需要解决的难点就在于如何在没有标签信息的情况下度量模态间和模态内的相似性。 一、正文 本篇论文拟解决“无监督跨模态散列缺乏可靠的相似性监督”、“如何高效处理不同模态间的异质性”等问题。 采用的是高阶非局部哈希方法,具体而言,就是(1)、引入高阶亲和力度量矩阵;(2)、引入一种通用的表示法来关联不同的模态;(3)、构造能保持亲和力的目标函数,从而生成高质量的二进制代码。 如下图,首先通过深度学习分别提取图像和文本的特征 ,进而分别 阅读详情

相关推荐

论文阅读:深度监督跨模态检索 Deep Supervised Cross-modal Retrieval, CVPR 2019

Deep Supervised Cross-modal Retrieval, CVPR 2019 摘要 跨模式检索旨在实现跨不同模式的灵活检索。跨模式检索的核心是如何衡量不同类型数据之间的内容相似性。在本文中提出了一种新颖的跨模式检索方法,称为深度监督跨模式检索(Deep Supervised Cross-modal Retrieval, DSCMR)。它旨在找到一个通用的表示空间,在其中可以直接...

Chris Blog 3539

【CLIP综述】CLIP在医学影像中的应用(二)

本节中,展示了一些典型的 CLIP 驱动的应用,以展示在CLIP帮助下的性能改进。虽然这些研究侧重于各种任务,但它们通常表明,预训练的 CLIP 的优势在于其解释和传达人类知识的能力。在一些研究中,将描述性文本 prompts 输入到 CLIP 中,实验结果表明 CLIP 能够熟练地理解嵌入在 prompts 中的语义,并有效地将语义传递给框架内的其他模块。

风巽·剑染春水的博客 5979

Cross-modal Retrieval(跨模态检索)

前一篇文章整理了多模态融合Multimodal Fusion,最近看到一篇很好的跨模态检索的文章,这篇博客就来整理几篇博主认为idea还不错的跨模态检索。另,如果有其他idea很好的跨模态论文,希望你在文章后面留言! Cross-modal Retrieval 一般一个跨模态检索过程可以既包括模态表征,模态转换,模态对齐和联合学习(唯独没有模态融合,基本上不需要融合)。 Adversarial ...

nakaizura 2万+

入选CVPR 2025!清华&华科大提出超强异常检测新方法!学会你也能发顶会

有新突破了!清华和华科大推出了INP-Former,从单张图像中提取正常模式,展现出卓越的性能和强大的泛化能力!成功被CVPR 2025收录。仔细一瞧,今年的CVPR上异常检测相关的研究还挺多,比如最新零样本工业缺陷异常检测SOTA:AA-CLIP,还有突破跨领域限制的UniVAD,通过统一模型实现无需训练的泛化异常检测!这些成果也足以证明,而且根据其在AIGC等新兴技术领域的拓展,未来在方面应该会更有搞头。同时,我们也可以关注可解释、低资源等核心挑战,再结合垂直场景的深层次需求做创新。本文整理了。

学姐带你玩AI的博客 2014

AAAI 2024 | CNC:用于无监督多类异常检测的跨模态正态约束

现有的基于无监督蒸馏的方法依赖于编码和解码特征之间的差异来定位测试图像中的异常区域。然而,仅在正常样本上训练的解码器仍然能够很好地重建异常补丁特征,从而降低了性能。这个问题在无监督多类异常检测任务中尤为突出。作者将这种行为归因于解码器的“过度泛化”(OG):多类训练中补丁模式的多样性显著增加,增强了模型对正常补丁的泛化能力,但也不可避免地扩大了对异常补丁的泛化。

小白学视觉 252

56、关系引导的双哈希网络:无监督跨模态检索的新突破

本文提出了一种名为关系引导的双哈希网络(RDHN)的无监督跨模态检索方法,通过异构特征融合模块和双网络架构有效增强模态间语义相关性并抑制冗余信息。该方法在多个公共数据集上显著优于现有技术,展现出优异的检索性能。核心创新包括基于自注意力的特征融合、CNN过滤全局语义关系以及模态内与模态间的联合损失优化,为跨模态哈希学习提供了新思路。

beta5的博客 66

遥感论文 | Arxiv | SM3Det:基于混合专家模型(MoE)的多模态数据集和多任务目标检测模型,代码已开源!

传统的目标检测模型通常是在单一数据集上训练的,往往局限于特定的成像模式和注释格式。这种方法忽视了跨多模态的宝贵共有知识,并限制了模型在更多样化场景中的适用性。为此,本文介绍了一项新的任务,称为多模态数据集和多任务目标检测(M2Det),旨在精确地从任何传感器模式中检测水平或定向的物体。本文建立了一个基准数据集,并提出了一种统一的模型,即SM3Det(用于多模态数据集和多任务目标检测的单模型)。SM3Det利用网格级别的稀疏MoE(专家混合)骨干网络,在保留不同模态独特特征表示的同时,实现联合知识学习。

m0_59163425的博客 3804

通过多模态图正则化平滑矩阵分解散列的无监督跨模态检索

通过多模态图正则化平滑矩阵分解散列的无监督跨模态检索

跨模态检索论文阅读:Cross-Modal Implicit Relation Reasoning and Aligning for Text-to-Image Person Retrieval

文本到图像的人物检索仍然是一项艰巨的任务,原因在于身份内部的显著差异以及视觉和语言之间的模式异质性。前一个挑战源于这样一个事实,即身份的视觉外观因姿势、视角、照明和其他因素而不同,而文本描述则因任意描述顺序和文本模糊性而不同。后一个挑战是跨模态任务中的主要问题,是由视觉和语言之间固有的表征差异造成的。为了应对上述两个挑战,文本到图像的人物检索的核心研究问题是探索更好的方法来提取具有区分性的特征表征,并设计更好的跨模态匹配方法来将图像和文本统一到一个联合嵌入空间中。

zag666的博客 3291

Coupled CycleGAN:用于跨模态检索的无监督哈希网络

近年来,由于其在大规模跨模态检索中的低存储成本和高查询效率的出色能力,散列吸引了越来越多的关注。 得益于深入学习,跨模式检索社区取得了令人信服的结果。 但是,现有的深层交叉模式散列方法要么依赖于标记信息的数量,要么无法学习不同模式之间的准确性相关性。 在本文中,我们提出了用于交叉模式检索的无监督耦合循环生成对抗式哈希网络(UCH),其中外循环网络用于学习强大的通用表示,并解释内循环网络以生成可靠的哈希码。 具体而言,我们提出的UCH将这两个网络与生成对抗机制无缝耦合,可以同时进行优化以学习表示和哈希码。 在三个流行的基准数据集上进行的大量实验表明,所提出的UCH优于最新的无监督交叉模式哈希方法。

RTL8211F千兆PHY原理图与PCB设计:从手册到量产的完整指南

在工业网关、边缘计算和FPGA/CPU以太网扩展设计中,千兆PHY芯片的稳定运行取决于外围电路的精细设计。RTL8211F(I)作为应用广泛的物理层收发器,其原理图设计涉及电源域划分、时钟与复位时序、RGMII/ MDIO接口匹配以及MDI差分网络等多个环节。正确理解数据手册的阅读顺序,掌握100Ω差分阻抗控制、等长约束和EMI布局技巧,是保证链路可靠性和信号完整性的关键。本文从芯片选型与数据手册解析切入,系统梳理从电源去耦到PCB布局布线的工程实践要点,帮助工程师规避Link不稳定、MDIO读取失败、吞吐

weixin_28721917的博客 351

Multimodal Industrial Anomaly Detection by Crossmodal Feature Mapping 论文精读

工业异常检测(AD)旨在识别产品中的异常特征或缺陷,是质量检测流程的关键部分。由于异常的罕见性和不可预测性,收集能体现异常情况的数据颇具挑战性。因此,大多数研究聚焦于无监督方法,即仅使用无缺陷样本(也称为标称样本)训练的算法。当前,多数现有的异常检测方法侧重于分析RGB图像。然而,在许多工业场景中,仅基于彩色图像难以有效识别异常,例如,光照条件变化易导致误检,表面偏差可能不会以明显异常的颜色呈现。结合彩色图像和三维传感器获取的表面信息可解决上述问题,并显著提升异常检测效果。

oj_geen的博客 1632

开源分享:苹果群控手机源代码解析与实战

本文介绍了苹果设备群控的基本原理和实现方法,重点解析了基于Python+Appium的群控系统构建。主要内容包括:1)设备连接管理技术(USB/Wi-Fi);2)自动化控制方式(WDA/AppleScript/Appium);3)实战演示了通过Python脚本实现多设备同时控制,涵盖环境配置、代码解析和功能说明;4)提出了多线程、图像识别等优化方向。文章为开发者提供了快速上手的群控方案,适用于自动化测试、批量管理等场景,并推荐了相关开源项目参考。

2403_88540309的博客 1344

【CVPR2025】【数据据蒸馏】Neural Characteristic Function Matching,上海交大在2080成功CIFAR-100的无损蒸馏

在CVPR 2025上,上海交通大学等机构提出了一种新的数据集蒸馏方法:NCFM(Neural Characteristic Function Matching)。这种方法显著降低了GPU显存占用,提升了训练速度,并在单张NVIDIA 2080 Ti GPU上成功完成了CIFAR-100的无损蒸馏。NCFM相比其他方法,GPU显存占用降低了300倍以上,训练速度提升了20倍‌。

AbiUni(YY熊) 1375

Matlab实战:用卡尔曼滤波搞定无人机GPS轨迹优化(附完整代码)

本文详细介绍了如何使用Matlab实现卡尔曼滤波(KF)算法优化无人机GPS轨迹,提供完整代码和工程实践指南。通过线性卡尔曼滤波技术,有效降低定位噪声,提升轨迹平滑度,适用于无人机导航和控制系统开发。

weixin_29061425的博客 253

DrissionPage无头模式破盾记:实战绕过CloudFlare 5秒验证

本文详细介绍了如何使用DrissionPage无头模式绕过CloudFlare 5秒盾验证,提升爬虫效率。通过关键参数配置、服务器环境问题处理及高级绕过技巧,如动态UA轮换和鼠标移动模拟,帮助开发者有效应对反爬机制。实战案例展示了如何结合最新Chrome UA和参数设置实现稳定数据采集。

weixin_29327525的博客 487

深度学习:多模态与跨模态

多模态”和“跨模态”是另外两个容易混淆的术语,“多模态”和“跨模态”都是处理多种数据类型或特征的术语,但“多模态”更关注同时处理多种数据类型的算法,而“跨模态”更侧重于将一种数据类型映射到另一种数据类型进行处理。

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 2万+

解锁Cherry Studio高阶玩法:用MCP实现自动化测试与数据爬取

本文深入探讨了如何利用MCP协议与Cherry Studio结合,实现自动化测试与数据爬取的高阶应用。通过Playwright等工具的MCP集成方案,详细解析了自动化测试流水线构建和智能爬虫系统开发的关键技术,显著提升工程效率和系统适应性。

defi6farmer的博客 275

跨模态检索

目录 一、定义 二、分类 基于特征表示方法 基于图文匹配的方法 三、相关概念 四、相关网络结构 五、相关文献 一、定义 通过一种模态样本来检索具有近似语义的另一种模态样本。 跨模态学习是多模态学习的分支。 跨模态检索训练过程中所有模态的数据都存在,但在测试过程中只有一种模态可用。 挑战:如何度量不同模态数据之间的内容相似性,也称之为异质鸿沟问题。 二、分类 基于实值表示学习:提升跨模态语义相关性,进而提高跨模态检索准确度。 基于二进制表示学习:提升跨模态图文检索效率,减少

Exception_3212536934的博客 8649

auboi5 + d435i 使用easy handeye进行标定时,遇到相关问题记录。

解决办法:在easy_handeye默认的 calibrate.launch 文件中move group 的默认值为 "manipulator",但针对每个人的机械臂,这个值需要更改。以aubo_i5为例,需要将其改为"manipulator_i5",或者自己编写launch文件时,传入参数move group的值,便能顺利解决问题!easy_handeye_calibration_server 进程出现崩溃。

weixin_61025092的博客 958

gtsam官方文档: The new IMU Factor学习笔记

gtsam官方文档:The new IMU Factor 本文为gtsam imu预积分文档学习笔记,为gtsam基于切向量实现的imu预积分的理论基础。 导航状态 定义导航状态为 Xbn={Rbn,Pbn,Vbn}X^n_b=\{R^n_b,P^n_b,V^n_b\}Xbn​={Rbn​,Pbn​,Vbn​} 上角标n:导航(navigation)坐标系 下角标b:载体(body)坐标系 下文均省略上下标 矢量场与微分方程 对于导航问题我们用如下微分方程描述 X˙(t)=F(t,X)\dot X(t)

南柯一梦的博客 1608

基于深度学习的跨模态检索方法

基于深度学习的跨模态检索方法 基本思想 利用深度学习的特征抽取能力,在底层提取不同模态的有效表示,在高层建立不同模态的语义关联。 两个阶段 首先,对不同模态学习单独的表示,然后利用高层网络最大化不同模态表示的相关性。 文献 Ngia[17] 等提出了基于深度网络的跨模态学习方法。该模型考虑了多模态融合学习、跨模态学习和共享表示学习,通过视频、语音识别证实了方法的有效性。 考虑到跨模态数据的关联重点在不同模态的语义相关性,Srivastava[18] 等提出了深度玻尔兹曼机。该方法先对不同模态分别学习底层表示

anqi3776的博客 1809

华为OD机试真题 新系统2026-04-08 C++ 实现【直捣黄龙】

小王在玩一款叫做直捣黄龙的小游戏,在该游戏中他需要从入口位置进入敌营,绕过哨兵的层层封锁,达到敌军司令部实施斩首行动。 敌军阵营是一个n*n的矩阵,入口在坐标(0,n/2),敌军司令部在坐标(n-1,n/2),每个 哨兵警戒以自己为中心的9宫格,一旦被哨兵发现则行动失败。

MISAYAONE的博客 261

跨模态检索Coupled CycleGAN: Unsupervised Hashing Network for Cross-Modal Retrieval

核心思想    本论文是无监督方法,主要由两层循环对抗网络构成,外层的循环对抗网络主要是使不同模态提取更有代表性的公共特征向量,内层循环对抗网络使学的高质量的哈希编码。   外层循环对抗网络: 过程描述:图像通过卷积提取特征作为FrealIF_{real}^IFrealI​,然后通过生成器GfI−>TG_f^{I->T}GfI−>T​(是一个encode->decode...

m0_38102073的博客 2171

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

ACM MM18 | 用于跨模态检索的综合距离保持自编码器

作者丨黄澄楷研究方向丨多媒体信息检索/内容理解本文是发表在 MM18 上的一篇跨模态检索文章,作者提出了一种采用综合保持距离的自编码器(CDPAE)的新颖方法,用以解决无...

Paper weekly 1329

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 223

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: 【开源】腾讯的通用Agent系统,轻松实现AI自主化
下一篇: 细节制胜: 多模态大模型最新进展
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值