前沿论文 Arxiv‘24 | 定向目标检测与增强小目标识别

目标检测技术趋势与2026年突破方向预测 目标检测是计算机视觉的核心技术,通过边界框定位和类别识别实现物体检测。其技术原理主要基于卷积神经网络和Transformer架构,在自动驾驶、安防监控等领域具有重要应用价值。随着边缘计算和IoT设备普及,轻量化模型和实时推理成为关键技术需求。当前研究热点集中在多模态融合、自监督学习和领域自适应等方向,其中YOLO系列和DETR等框架持续推动性能边界。2026年预计将在神经符号系统结合、持续学习优化等方向取得突破,解决小目标检测和跨域泛化等工程难题。 阅读详情
AI摘要

本文介绍了航空影像定向目标检测的创新模型,提出自适应尺度特征金字塔和C2f相关卷积模块,减少参数量并提升检测精度。还分享大模型AI学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段,提供了完整学习资料。

论文信息

题目:Efficient Oriented Object Detection with Enhanced Small Object Recognition in Aerial Images

高效航空影像中的定向目标检测与增强小目标识别

作者:Zhifei Shi,Zongyao Yin,Sheng Chang,Yi Xiao,XianChuan Yu

论文创新点

  1. 自适应尺度特征金字塔(ASFP):作者提出了一种新的ASFP结构,通过利用骨干网络中的P2和P3层,结合SPDConv提取小目标丰富的特征,并引入OKM-CSP模块,专门用于小目标特征提取,显著提升了模型对小目标的检测能力。

  2. C2f-小波变换卷积(C2f-WTC):为了增强特征提取能力,作者引入了C2f-WTC模块,利用小波变换来扩展感受野,同时最小化参数增长。该模块通过多尺度特征提取,显著提升了模型在复杂图像中的检测精度。

  3. C2f-Ghost动态卷积(C2f-GDC):作者结合了GhostModule和C2f模块,提出了C2f-GDC结构,通过动态卷积和专家网络实现高效的特征处理,显著减少了参数数量,同时保持了较高的检测精度。

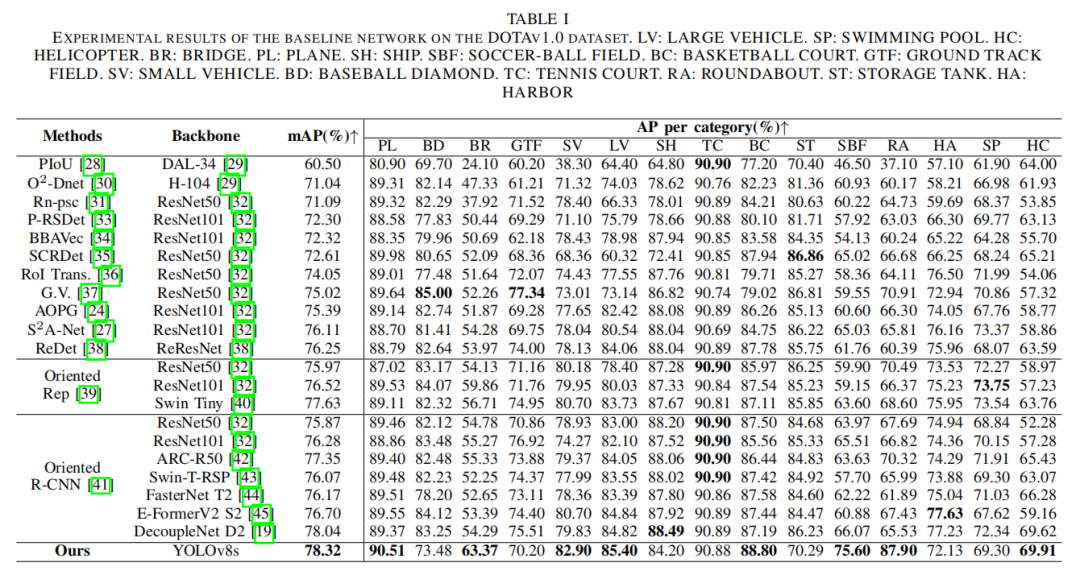
  4. 轻量级框架设计:作者提出的模型在保持高检测精度的同时,显著减少了参数量,达到了21.6M,相比具有23.3M参数的DecoupleNet,提供了更高效的架构设计,特别适用于资源受限的环境。

摘要

在航空影像中实现旋转边界框目标检测的计算效率与检测精度之间的平衡是一个重大挑战。尽管先前的研究致力于创建轻量级模型以提升计算性能和特征提取能力,但在遥感(RS)影像中检测小目标和多尺度目标时,这些网络的性能仍存在差距。为了应对这些挑战,作者提出了一种针对YOLOv8模型的创新增强,专门用于定向目标检测任务,并优化了计算资源有限的环境。该模型采用了基于小波变换的C2f模块来捕捉关联特征,并引入了自适应尺度特征金字塔(ASFP)模块,利用P2层细节信息。此外,GhostDynamicConv的引入显著增强了模型的轻量化特性,确保了航空影像分析的高效性。该方法的参数量为21.6M,相比具有23.3M参数的DecoupleNet,提供了更高效的架构设计,同时在DOTAv1.0数据集上展示了与DecoupleNet等领先方法相媲美的平均精度(mAP)。该模型的效率及其减少的参数量使其成为航空目标检测的强有力候选,特别是在资源受限的环境中。

关键词

旋转检测,小目标识别,轻量级模型,航空图像处理

II. 方法

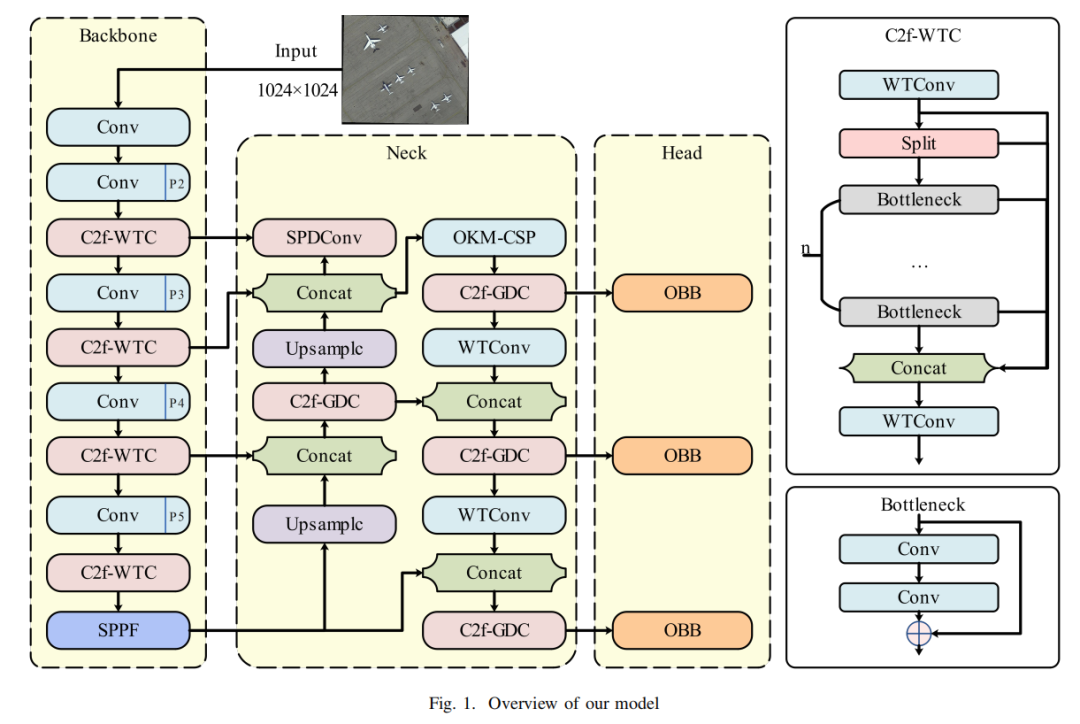
为了实现增强模型检测小目标能力的同时保持低参数量,作者提出了网络结构,如图1所示。
A. 小目标增强金字塔

为了解决传统YOLO改进方法在检测低分辨率图像和小目标时的性能不佳问题,作者在YOLOv8的特征提取阶段设计了自适应尺度特征金字塔(ASFP)结构。ASFP结构旨在利用骨干网络中P2和P3层的优势。P2层以其高分辨率提供了丰富的特征细节,这对于小目标检测至关重要。相反,P3层在分辨率和上下文信息之间提供了平衡,适合捕捉中等尺度的特征。

为了避免引入P2检测层带来的计算负担,作者利用SPDConv从骨干网络的P2层中提取小目标丰富的特征。这些特征与P3检测层的特征合并,为OKM-CSP模块提供了一个全面的特征集,从而在保持对小目标敏感性的同时增强了计算效率。

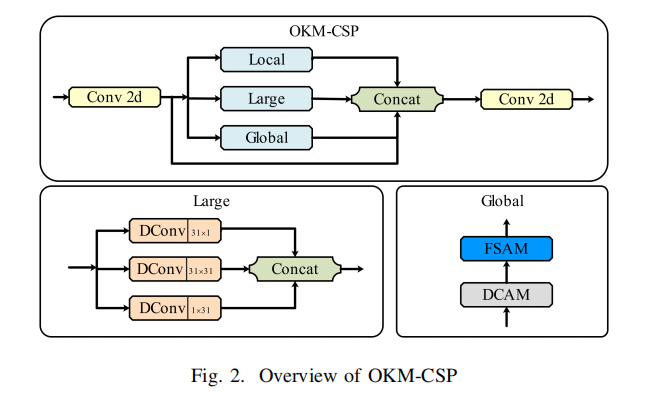
作者发现原始CSP结构在减少计算负载和通过特征图分割与合并增强特征多样性方面具有有效性,但在小目标检测方面存在不足。为了解决这一问题,作者受Omni-Kernel模块(OKM)启发,引入了OKM-CSP模块,其中包含专门用于小目标特征提取的分支。利用参数来调节通道分配,输入特征图被分为okbranch和identity,通道比例分别为和。okbranch的输出进一步通过三个并行分支——全局、大尺度和小尺度——来细化小目标特征提取。

全局分支:该分支专注于提取具有大感受野的特征,以捕捉全局上下文信息。具体来说,它使用双域通道注意力模块(DCAM)和基于频率的空间注意力模块(FSAM)来扩展感受野,而不会显著增加参数数量。

大尺度分支:该分支旨在捕捉中等尺度的特征。它采用具有中等感受野大小的标准卷积层,确保全局上下文和局部细节之间的平衡。

小尺度分支:该分支专注于提取细粒度特征,这对于小目标检测至关重要。它使用具有小核尺寸的标准卷积层来捕捉详细的局部信息。

三个分支的输出随后通过卷积层与identity分支连接并合并,最终获得输出特征图,如图2所示。
假设输入特征图的通道数为,okbranch的通道数为,identity分支的通道数为。输入特征图被分为两部分:

和

其中是输入到OmniKernel模块的特征图,直接连接到下一层。参数控制分割比例。为了获得更好的性能,作者选择。

接下来,OmniKernel模块接收并输出特征图。最后,OmniKernel模块的输出与连接并通过卷积层进行特征融合,得到最终的输出特征图

通过引入OKM-CSP模块,作者可以增强模型在多尺度上提取特征的能力,从而提高小目标的检测精度。

B. C2f与下一代卷积

C2f模块是YOLOv8模型中的关键组件,旨在增强特征提取过程。该模块通过在网络的不同阶段进行部分连接,实现了更集成和全面的特征表示。这种方法在目标检测中特别有利,因为它允许从网络的不同层次更详细和细致地整合特征。

然而,C2f模块在检测小目标方面存在显著局限性,这需要进一步研究。模块的局部卷积操作可能不足以从需要更广泛感受野的复杂图像中提取特征。此外,C2f模块的参数量随着卷积核大小的增加呈二次增长,这引发了关于过参数化的担忧。这一问题可能会对模型的计算效率和可扩展性产生不利影响,突显了在详细特征表示和计算资源约束之间取得平衡的必要性。

1. C2f-小波变换卷积(C2f-WTC)

YOLOv8中的C2f模块在目标检测中至关重要,但由于局部卷积操作,特别是在处理复杂图像时,特征提取存在局限性。为了解决这些挑战,作者引入了C2f-小波变换卷积(C2f-WTC),利用小波变换来增强感受野,同时最小化参数增长。

利用Haar小波的简单性,作者将尺寸为的图像分解为四个子带:(低频)、、和(高频)。变换过程专注于在不同尺度上提取相关特征。Haar小波变换可以表示为:

其中表示当前分解级别。通过递归地将Haar小波变换应用于,作者创建了一个小波变换的级联,有效地捕捉输入图像的低频和高频成分,从而促进详细的特征提取。

在WTConv方法中,输入通过小波技术进行变换,然后在每个频率子带上应用具有小核的卷积。该过程表示为:

其中IWT表示逆小波变换,将变换后的频率成分重新组合回空间域。该技术使模型能够有效地整合多尺度特征,增强其对精细和粗糙细节的敏感性。

在C2f-WTC中,瓶颈结构起到了双重作用:它简化了特征处理流程并控制了计算开销。本质上,瓶颈通过初始的卷积将特征图缩小到其最显著的方面。然后,这些浓缩的表示通过卷积进一步细化,然后再扩展回原始维度。通过战略性地减少和随后扩展特征图,WTC模块能够在减少计算负载的情况下保持高水平的特征区分度,这对于航空影像中准确检测小目标至关重要。

C2f-WTC的主要优势在于其参数数量相对于感受野大小的对数增长,与传统方法的二次增长形成对比。这种设计在提高检测精度和参数效率方面进行了优化,能够以经济的计算足迹处理复杂图像,从而提升模型的定向目标检测能力。

2. C2f-Ghost动态卷积(C2f-GDC)

鉴于C2f模块的计算和复杂性约束,作者集成了GhostModule以在最小额外计算的情况下增强模型的容量。GhostModule采用动态卷积和专家网络进行特征处理,通过动态系数加权求和实现增强的表达能力和效率。

设为输入特征图,为第个专家的权重,为相应的动态系数。动态卷积可以表示为:

其中是专家的数量,动态系数生成为,其中是对输入进行池化操作以减少其空间维度,是一个小型两层前馈网络,将池化向量转换为系数向量,通过softmax函数确保所有系数的总和为1。

结合C2f模块和GhostModule,作者提出了C2f-GDC结构。在该结构中,每个瓶颈块中的卷积操作被动态卷积取代。设和分别为第一个和第二个动态卷积的输出,C2f-GDC模块可以表示为:

其中是残差连接的输入,Conv是第二个卷积层。

在C2f-GDC中,每个动态卷积引入了个额外的卷积核,但这些核共享相同的输入和输出维度,因此参数的增加与成正比,与核大小无关。此外,由于动态系数的计算成本相对较低,整体计算负载(FLOPs)的增加有限。

III. 实验

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

AI论文工程化落地的三重过滤与实战指南 人工智能模型研发中,学术论文如何转化为可部署、可复用、可度量的工业级能力?这涉及从基础概念(如自监督学习、元学习、图神经网络)出发,理解其核心原理对数据效率、泛化性与模块化设计的支撑作用;技术价值体现在降低标注依赖、提升小样本适应性、增强边缘部署可行性等关键工程指标;典型应用场景覆盖医疗影像分割、工业缺陷检测、卫星遥感分析及金融风控建模;而本文聚焦于真实世界约束下的论文筛选逻辑——以数据/计算/部署三重过滤为轴心,结合10篇高价值论文的接口解耦、长尾验证与开源审计实践,提供一套面向AI工程师的即插即用型论文 阅读详情

相关推荐

CV研究者的周度作战地图:高效筛选与实操复现指南

计算机视觉(CV)作为人工智能落地最广的领域之一,正面临论文数量激增与工程落地脱节的双重挑战。其核心原理在于从海量arXiv预印本中识别真正具备问题切口精准度、技术增量可验证性与工程友好度的‘种子型’工作。这种筛选能力直接决定算法工程师和硕博研究者的时间投资回报率,尤其在小样本学习、无监督域自适应、模型轻量化等工业强需求场景中价值凸显。本文聚焦‘论文筛选’与‘研究节奏’两大关键实践维度,提供覆盖环境配置、数据预处理、权重迁移、超参微调到结果评估的完整复现实操链路,助力研究者在信息过载时代锚定高价值技术坐标。

weixin_30693683的博客 491

YOLOV8V10改进系列指南

YOLOV8V10改进系列指南,仅仅69.9包含YOLOV8、YOLOV10的两个主流模型改进方案、含有300+种改进的集合,且含有多种二次创新和原创改进!

qq_37706472的博客 12万+

2020计算机视觉十大论文:从DETR到CLIP的技术落地路线图

计算机视觉(CV)作为人工智能核心分支,其技术演进正从追求精度极限转向关注工程落地效能。自监督学习、Transformer架构、鲁棒数据增强和跨模态表征等基础范式,正在重塑模型设计逻辑——不再依赖海量标注,而强调低样本适应性、边缘部署友好性与分布漂移鲁棒性。DETR以端到端集合预测重构目标检测流程,ViT通过全局注意力突破CNN感受野局限,SimCLR推动无监督预训练走向工业可用,AugMix与CLIP则分别在数据扰动应对和零样本迁移上提供可复用方案。这些技术共同指向一个趋势:CV已进入‘系统收敛’阶段,算

weixin_30328063的博客 423

RTDETR改进专栏(包含RTDETR、YOLOV5-DETR、YOLOV8-DETR)

RTDETR改进专栏(性价比高,创新度高),目前RTDETR改进已经有350+个改进点!

qq_37706472的博客 7万+

AI研究问题价值评估:四维实战判断框架

在机器学习与人工智能研究中,识别高价值研究问题远比技术实现更关键。其本质是建立一套可验证的问题筛选机制——从真实业务痛感出发,结合技术断层测量、非线性解法潜力和18个月价值闭环周期,形成工程化决策逻辑。该方法直击当前科研选题常见误区:如过度追逐SOTA指标、脱离工业落地约束、忽视数据与算力现实瓶颈等。它融合AI研究问题识别、ML研究价值评估等核心能力,适用于高校研究生课题设计、企业算法团队资源分配及产学研协同立项,为从实验室成果到商业落地提供可信度锚点。

weixin_30908103的博客 405

YOLO26涨点改进 |独家创新,小目标涨点改进篇 | Arxiv 2025 | MHAF‑YOLO,引入RepHMS高效特征提取模块,适合轻量级目标检测、小目标检测、图像分类、旋转目标检测、实例分割

本文提出了一种改进的YOLO26目标检测模型,通过引入RepHMS模块和多分支辅助特征金字塔结构(MAFPN),显著提升了模型性能。RepHMS模块采用多分支异构卷积和重参数化策略,在不增加推理开销的情况下增强多尺度特征提取能力,尤其提升了小目标检测效果。实验表明,改进后的MHAF-YOLO模型在COCO数据集上仅用7.1M参数就达到48.9% AP,相比YOLO11-s参数量减少24.4%而性能提升1.9%。文章详细介绍了RepHMS模块的原理、实现代码及在YOLO26中的集成方法,并提供了两种改进配置。

Ai缝合怪、助力小伙伴高效发论文 199

论文阅读:Omni-Kernel Network for Image Restoration

1、整个论文的出发点在于Transformer在图像增强领域效果好的核心在于全局感知能力,故而在cnn方法上提出OKM模块可以使模型具备全局感知能力。 2、OKM模块由全局分支(频域感知)、大分支(conv63x63)和局部分支(conv1x1)组成,模块设置在瓶颈层(bottleneck层,即网络中特征图空间最小的区域),可以降低计算量 3、最后就是在描述OKM模块在图像增强(图像去模糊、图像去雨和图像去模糊)领域的效果(加入OKM模块设计后psnr上涨了5个点。);表明其方法在FLOP为17.86G

a486259的博客 7054

全新YOLO26有效涨点改进专栏目录 | 本专栏持续更新500+篇内容 | 包含各种卷积、主干网络、各种注意力机制、检测头、损失函数、小目标检测改进、二次创新模块、独家创新等几百种创新点改进

🔥《2026年YOLO26改进专栏》🔥 🚀持续更新500+最前沿创新改进点(顶会顶刊论文/独家创新策略),涵盖主干网络、各种卷积、注意力机制、检测头等模块,助力科研论文发表与模型性能提升,支持检测/分割/分类任务。订阅即获完整可运行项目,提供专业QQ答疑群,适合科研发论文(SCI/CCF/核心)及工业应用(PCB/医学/遥感检测)。专栏价格将逐步上涨,早订更优惠! ⭐特色:非计算机专业友好、模块可自由组合、全网独家创新;📌适用:研究生大论文和小论文创新、小目标检测、多领域科研应用,满足不同研究需求。

Ai缝合怪、助力小伙伴高效发论文 5174

24’AAAI-Omni-Kernel Network for Image Restoration完全核形态的图像恢复网络文章概括

受基于strip的自注意,我们还使用1×K和K ×1深度卷积来获取strip形状的上下文信息。:受局部信息在图像恢复中起重要作用这一事实的启发,除了捕获大规模感受野的外,一个非常简单但有效的局部分支,通过使用1 × 1深度卷积层进行局部信号整合。整体OKNet为类U-Net结构,ResGroup作为其中的基本模块,OKM作为U型结构的瓶颈的核心模块,具有巨大的卷积核(63*63)。:分为三个分支(局部分支,大分支和全局分支),三个分支的结果然后通过加法融合,并通过另一个1×1卷积整合出结果。

qq_68734642的博客 2881

全新YOLOv11有效涨点改进专栏目录 | 本专栏持续更新500+篇内容 | 包含各种卷积、主干网络、各种注意力机制、检测头、损失函数、小目标检测改进、二次创新模块、独家创新等几百种创新点改进

YOLOv11专栏持续更新500+种创新改进方案,涵盖卷积优化、注意力机制、主干网络、Neck特征融合、检测头、小目标检测等核心模块。提供独家创新点组合方案、模型轻量化改进及最新Mamba架构融合技术,配套完整实验代码和训练参数解析。订阅用户可加入专属答疑群,获取一键运行项目支持。专栏包含YOLOv11网络结构详解、配置文件解读等入门必读内容,助力科研论文发表与模型性能提升。限时开放订阅通道,提供多种涨点改进方案组合,满足不同研究需求。

Ai缝合怪、助力小伙伴高效发论文 4014

【YOLOv13多模态涨点改进】独家复现创新首发 | CVPR 2025 | 引入 FEFM 频率穷举融合机制和二次创新CFEM交叉融合增强模块,适合红外与可见光融合,多模态融合目标检测、实例分割

本文提出FEFM(Frequency Exhaustive Fusion Mechanism)模块,用于改进YOLOv13多模态目标检测框架。FEFM通过强化跨模态(如RGB与NIR)的共性特征并补充差异性高频纹理信息,有效提升复杂场景下的检测精度。相比传统方法,FEFM能更精准识别目标边缘与细节,显著提升小目标检测能力。文章详细介绍了FEFM的网络结构、优势机制(CRM和DRM子模块)及实现代码,并提供了模块配置和YAML文件修改指南。该创新方法在低光、遮挡等挑战性环境中表现优异,为多模态目标检测提供了新

Ai缝合怪、助力小伙伴高效发论文 128

(aaai2024) Omni-Kernel Network for Image Restoration

其中,局部分支( 1x1 的卷积)和大核卷积分支( 63x63 的大核卷积)如图所示,比较简单。在DCAM中,首先计算频率域的 channel attention,然后计算一个空间域的 channel attention。研究动机:作者认为Transformer模型计算复杂度太高,因此提出了 omni-kernel module (OKM),可以有效的学习局部到全局的特征表示。整体网络架构比较简单,就是非常简单的encoder-decoder结构,OKM插入在网络瓶颈位置,特征分辨率最低,计算高效。

OUC的搬砖日常 678

【YOLO26多模态涨点改进】独家复现创新首发 | CVPR 2025 | 引入 FEFM 频率穷举融合机制和二次创新CFEM交叉融合增强模块,适合红外与可见光融合,多模态融合目标检测、实例分割

🔥本文提出了一种基于FEFM模块改进的YOLO26多模态目标检测框架。FEFM模块通过强化RGB与NIR图像的共性特征并补充差异性高频纹理信息,显著提升了模型在低光、遮挡等复杂场景下的检测性能。文章详细介绍了FEFM的网络结构、工作原理及其相对于传统融合方法的优势,提供了完整的核心代码实现。同时,还介绍了二次创新的CFEM模块。最后,文章给出了三种融合策略(中期、中后期和后期融合)的YAML配置文件,指导读者如何将FEFM/CFEM模块集成到YOLO26框架中,以提升多模态目标检测的精度和鲁棒性。

Ai缝合怪、助力小伙伴高效发论文 25

51c~视觉~红外小目标检测~合集1

本文提出了一个多尺度方向感知网络(MSDA-Net),首次将高频方向特征作为领域先验引入红外小目标检测网络。为充分挖掘这类特征,该团队设计了两个关键模块:其一是无参数的高频方向注入(HFDI)模块,用于将原始图像的高频方向信息直接嵌入特征提取的早期阶段;其二是多尺度方向感知(MSDA)模块,用于促进不同尺度下局部关系的充分提取和不同方向上关键特征的充分感知。

whaosoft~aiotの开发板商城 1681

SGLang:结构化生成语言推理框架深度解读

SGLang是由斯坦福大学和加州大学伯克利分校联合提出的高性能大语言模型推理框架,针对复杂多轮对话、结构化输出等场景优化。其核心创新包括: RadixAttention机制:通过基数树数据结构实现跨请求的KV Cache自动复用,避免重复计算共享前缀 跳跃前瞻解码:对格式化输出中的固定模板部分直接填充,仅采样变量槽位,提升3-5倍生成速度 约束解码引擎:通过正则表达式和JSON Schema保证输出严格符合预定义格式 声明式DSL:提供类Python的编程接口简化复杂推理流程开发 相比传统框架,SGLang

Ricky Yang的专栏 333

shader多图叠加变换

shader Shader "Paint3D/AddTexture" { Properties { _MainTex ("Main Texture", 2D) = "white" {} _MainColor("Main Color", Color)=(1,1,1,1) _AddTex0 ("Texture0", 2D) = "white" {} _AddTex1 ("Texture1", 2D) = "white" {} .

李长江的博客 909

YOLOV11|YOLO12改进系列指南

YOLOV11V12改进系列指南,仅仅69.9包含YOLOV11V12模型改进方案、含有440+种改进的集合,且含有多种二次创新和原创改进!

qq_37706472的博客 15万+

实现自己的AI视频监控系统-第一章-视频拉流与解码4(重点)

使用本章节代码请引用此优快云链接,尊重知识、尊重他人劳动。这一小节将正式进入代码实现部分。我们会结合实际业务需要和拉流解码流程实现一个灵活、轻便、易用的视频拉流解码模块,支持多路视频拉流解码且可以动态更新更新内部参数。在开始设计之初,我们首先考虑的是使用大家所熟知的 **OpenCV(cv2.VideoCapture)**来实现拉流和解码功能。它的 API 简单直接,几行代码就能实现从网络流中读取帧,对于快速原型验证来说非常方便。然而,在经过深入的调研和测试后,我们发现 OpenCV 在处理多路视频流、追

soulproficiency的博客 2269

51c深度学习~合集8

方法的完整数学描述略显复杂,如果只是想了解主要思想,可以只看上面 PatchMix的流程图即可(其实只是公式多,每个公式也不复杂,后续有机会做个演示动画,帮助大家理解。这个方法也可以用简单的 Mask 方法实现,但是本方法在大规模图像处理上效率是最高的),对该工作感兴趣的同行可以看一下,我尽量写得清楚一些。结合 PatMix 的流程图,主要过程如下:由于混合图像和混合图像之间,重叠比例的不同,mix-to-mix label 中每一项的权重分数是不同的,根据上图,可以得到权重系数可以表示为。

whaosoft~aiotの开发板商城 2963

SSD性能测试进阶:用fio的io_uring引擎榨干你的NVMe硬盘

本文深入探讨了如何利用fio的io_uring引擎对NVMe SSD进行深度性能测试。通过对比传统libaio引擎,详解了io_uring低开销、高并发的优势。文章提供了从测试矩阵设计、队列深度分析到写入放大观察和尾延迟可视化的完整进阶方法,并附有实战案例与脚本,旨在帮助用户科学压榨NVMe硬盘的极限性能,获取更真实的评估数据。

weixin_29247219的博客 328

优雅谈大模型:“System2”与“System 1”

研究人员探索了三种System 2方法——RaR、S2A 和 BSM,这些方法已经成功提炼到新的LLM,这个新的模型与System 1相比,产生了更好的结果,而且成本低于System 2。然而这种方法是有局限性,只能适用于特定的任务。

鲁班模锤 5167

【Reading Notes】(6)Favorite Articles from 2023

Feature-Based Knowledge,一般而言,在基于特征的知识迁移中,研究的对象包括了:如何需选择知识类型?对于台积电的客户来说,这个数字是难以接受的,因为客户需要为整个晶圆买单,包括其中有缺陷的芯片。最后大家采取了一个折中方案,4号线经过北大的789米轨道段,将采用世界上最先进的轨道减振技术,也就是在钢轨下铺设钢弹簧浮置板。毕竟,有苹果这样的金主愿意成为台积电新制造工艺的第一个客户,能分担台积电先进制程节点的研发费用和专用工厂的建设费用。(2023年01月01日)(2023年01月04日)

bryant_meng 1717

Ubuntu 20.04下大陆ARS408毫米波雷达点云数据采集与RVIZ实时可视化全流程解析

本文详细解析了在Ubuntu 20.04系统下,如何实现大陆ARS408毫米波雷达的点云数据采集与RVIZ实时可视化全流程。内容涵盖硬件连接、ROS Noetic环境搭建、CAN接口配置、数据验证及自动化脚本编写,为机器人感知、自动驾驶等领域的开发者提供了一套稳定、实用的实战方案。

bash7scripter的博客 699

51c视觉~合集55

要么生成的异常真实性不足、掩码精度低,且难以跨领域复用。试想一下,在工业质检、医疗影像诊断、日常物品瑕疵识别等场景中,无需任何示例缺陷样本,也无需针对特定领域微调模型,就能根据文字或图像提示,自动生成真实且符合语义的异常,还能精准输出缺陷掩码,大幅提升下游异常检测模型的性能。Anomagic引入对比掩码细化策略,通过计算输入正常图像与生成异常图像的像素级差异,结合预训练的MetaUAS模型,自动生成高精度缺陷掩码,实现异常区域与掩码的像素级对齐,大幅提升生成数据的实用性。

whaosoft~aiotの开发板商城 1732

RAG 提示词工程最佳实践

虽然目前网络上关于提示工程的相关资料已经多如牛毛,然而 RAG (检索增强生成) 任务中提示工程如何进行的资料相对而言却较少。不少朋友之前也热烈的讨论过 RAG 场景下提示词的运用,因此 Zen 禅与计算机程序设计艺术 特别推出 RAG 任务下的提示词实践经验系列分享。RAG 是检索增强生成(Retrieval Augmented Generation)的简称,是当前最火热的企业级LLM应用方案。

AI天才研究院 2013

9.23华为OD机试真题 新系统 - 世界杯徽章换购 (Java/Py/C/C++/Js/Go)

9.23华为OD机试真题 新系统 - 世界杯徽章换购 (Java/Py/C/C++/Js/Go)

算法大师! 1628
上一篇: 【论文日报】LLM合集:字节推出Agent-R框架, 让LLM Agent进行自我迭代进化,学会反思
下一篇: BiomedGPT:一种用于多样化生物医学任务的通用型跨模态基础模型 - 宾州Lehigh大学、佐治亚大学、哈佛医学院等
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值