OCR多模态大模型:视觉模型与LLM的结合之路

【ChatOCR】OCR+LLM定制化关键信息抽取(附开源大语言模型汇总整理) OCR文字识别与大语言模型的结合,智能抽取感兴趣的关键信息,无需复杂繁琐的OCR提取结果后处理规则,大大提升泛化性。 阅读详情
AI摘要

本文提出Guidance OCR算法,在不额外训练模型的情况下,利用OCR算法获取图片文字内容,约束VLM生成过程,减少视觉信息抽取时的错字情况。还分享了大模型AI学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段。

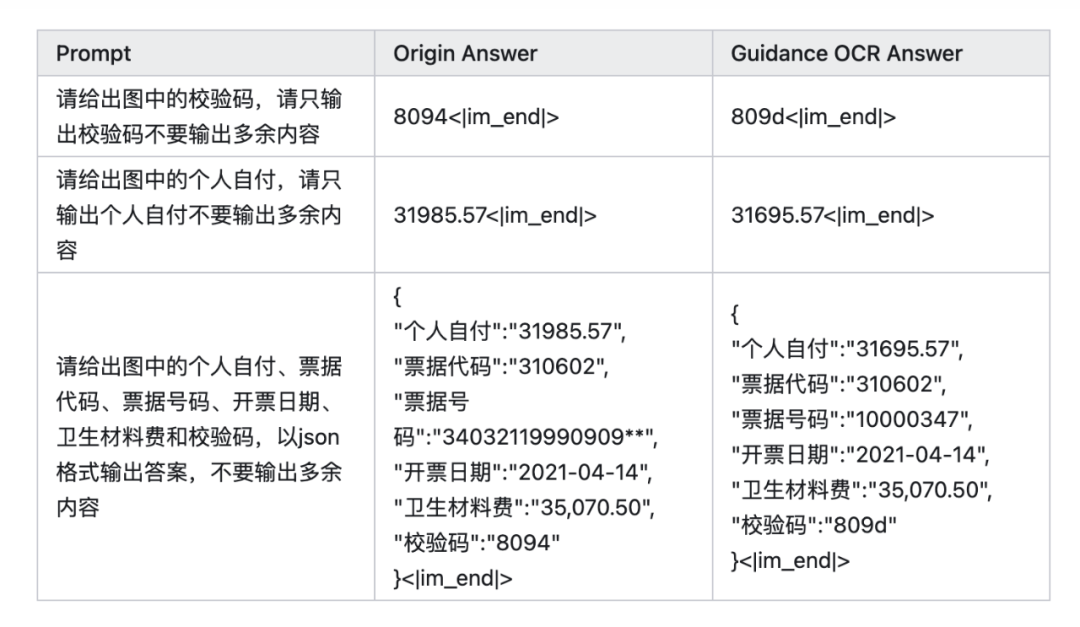
在使用多模态大模型(Visual Language Model, VLM)做视觉信息抽取时,常常出现错字的问题。为了解决这一问题,本文提出了一种名为Guidance OCR的方法。该方法在不额外训练模型的情况下,先利用OCR算法获取图片中的文字内容,再利用OCR识别出的文字对VLM的生成过程进行约束,从而一定程度上减少VLM做视觉信息抽取任务时出现错字的情况。
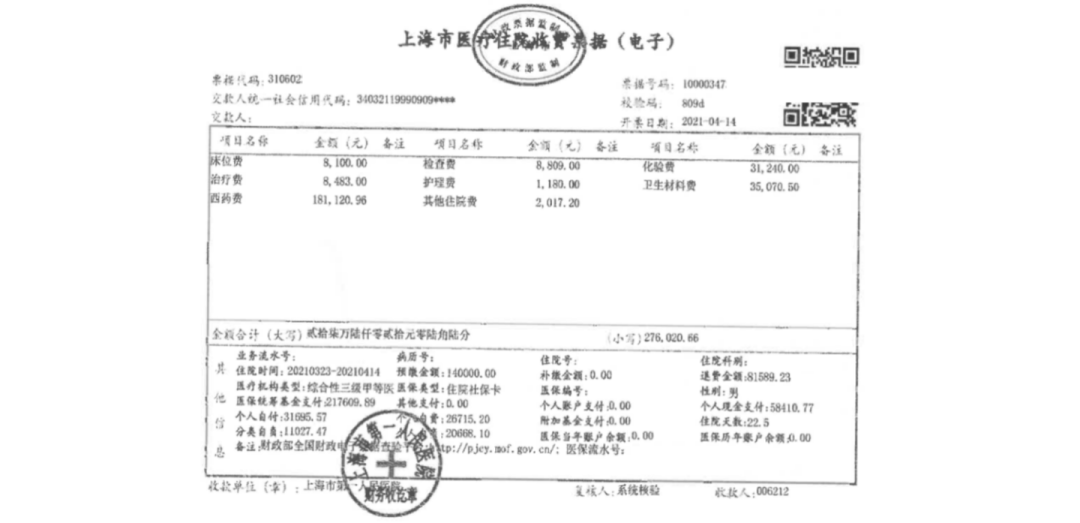
图1:一张医疗发票,其中的敏感信息已被抹去

使用Qwen2-VL-2B模型抽取图1中的信息时,模型原生回答和使用GuidanceOCR后的回答见下表
项目链接:

https://github.com/hzauzxb/guidance-ocr

一、项目背景

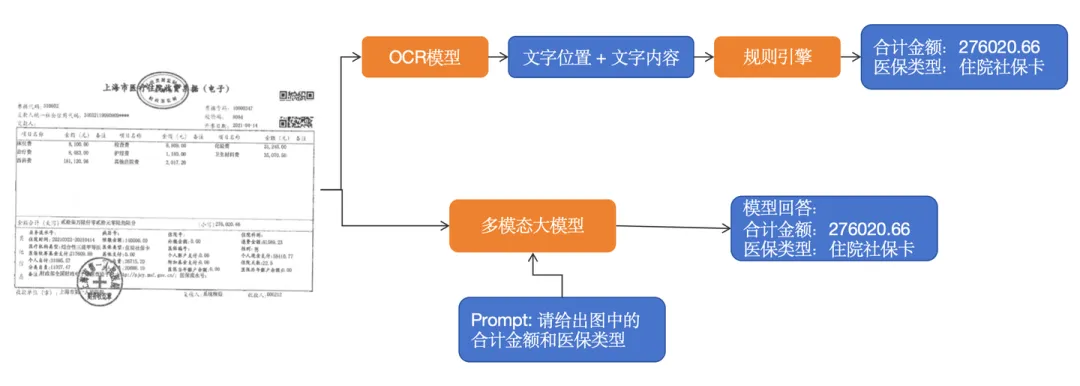
视觉信息抽取任务是给定一张单证图片,并从图片中抽取对应的关键字段,如从图1所示的医疗发票中抽取金额合计,住院时间和医保类型。传统的信息抽取模型先利用OCR算法获取图中的文字位置和文字内容,再利用规则引擎或模板匹配获取关键字段。VLM则可以将图片先输入给模型,再用提问题的方式要求模型给出需要抽取的字段。在开放场景的信息抽取中,由于单证板式太多,规则引擎难以维系,因此常常使用基于VLM的方案。
在这里插入图片描述

图2:传统信息抽取流程和多模态大模型(VLM)做视觉信息抽取任务的流程图(以抽取合计金额,医保类型为例)

在实际使用时,为了避免显存OOM,VLM常常会将输入的图像大小限制在一定范围。因此VLM在视觉信息抽取任务中,可能会由于文字太小,模糊不清而给出错误的答案。OCR模型分为检测和识别两部分,检测模型负责给出图中的文字位置,而识别模型会根据检测模型给出的文字位置,将图片中的文字一一裁剪下来,并缩放到指定大小,再去识别文字内容。因此传统OCR模型的识字能力通常是高于多模态大模型的识字能力的。
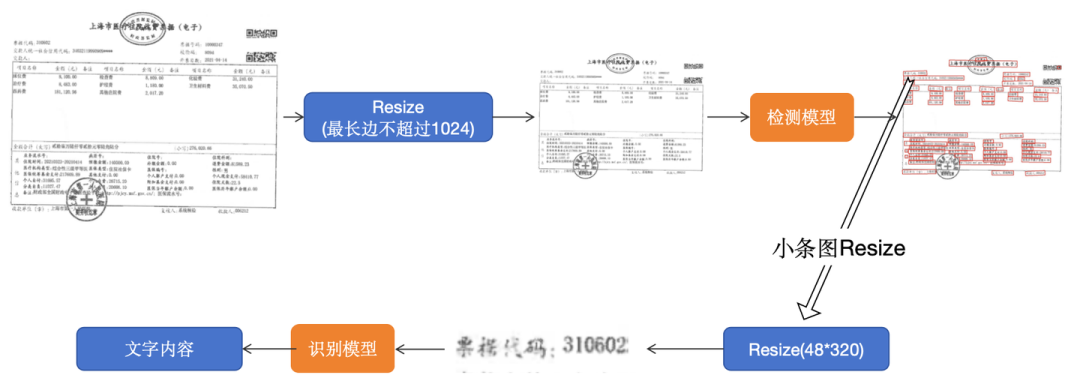
图3:OCR模型的PipeLine

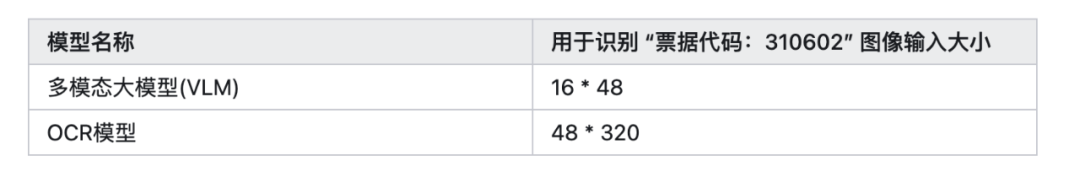
可以看到,同样是"票据代码",输入多模态大模型的分辨率是 16 * 48,而输入传统OCR识别模型的分辨率则为 48 * 320。该特性导致在视觉信息抽取任务中,若使用VLM抽取图中较小的字段,会出现错字的问题,而传统OCR模型则基本都能识别出正确的文字。
为了解决该问题,本文提出了名为Guidance OCR的算法,该算法在不额外训练模型的情况下,先利用OCR算法获取图片中的文字内容,再利用OCR识别出的文字对VLM的生成过程进行约束,从而一定程度上减少VLM做视觉信息抽取任务时出现错字的情况。

二、算法流程

本节将先介绍GuidanceOCR的任务设定,再介绍单个字段信息抽取的算法流程(一次调用VLM只抽取图片中的一个关键字段),最后在介绍多个字段信息抽取的算法流程(一次调用VLM会抽取图片中的多个关键字段,并以Json格式返回结果)。

GuidanceOCR的任务设定
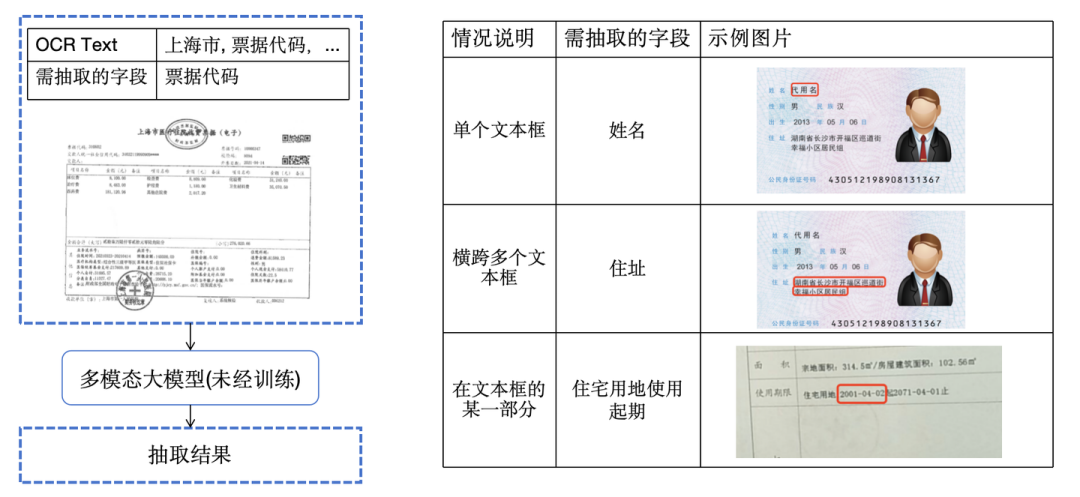
图4:Guidance OCR的输入输出,以及视觉信息抽取任务中常见的三种Case

如图4左侧所示,Guidance OCR会将OCR识别出的文字,需要抽取的字段和对应的图片作为输入,并利用多模态大模型(VLM)获取信息抽取结果。Guidance OCR为测试时增强算法(Test Time Argument, TTA), 其并不要求对VLM进行额外的训练。

如图4右侧所示,视觉信息抽取任务有三种常见的情况即:

  • 1.需抽取的字段为单个文本框,即为图4左侧OCR Text列表中的某个字符串

  • 2.需抽取的字段横跨多个文本框,即为图4左侧OCR Text列表中的多个字符串,按特定顺序组合而成

  • 3.需抽取的字段为文本框中的某一部分,即为图4左侧OCR Text列表中的某个字符串的子串

单个字段的信息抽取

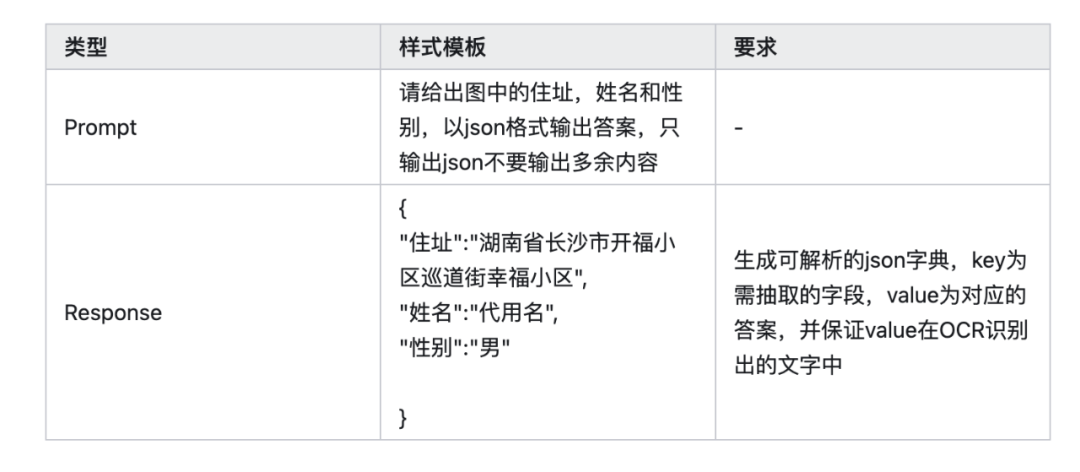
在单个字段信息抽取的场景下,多模态大模型的Prompt和Response的要求如下
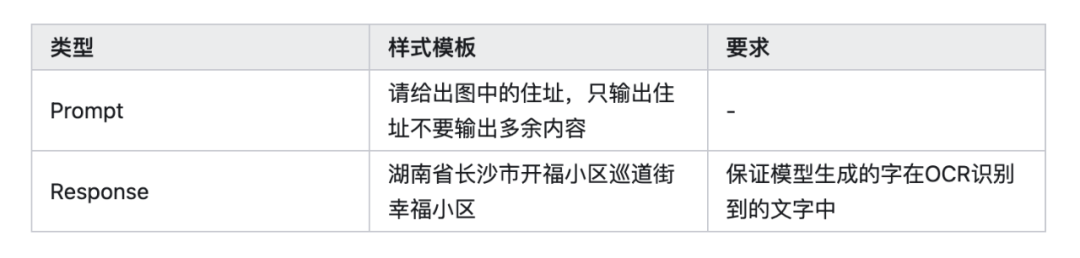
图5:Guidance OCR的算法流程,其本质为基于OCR的Token判别器

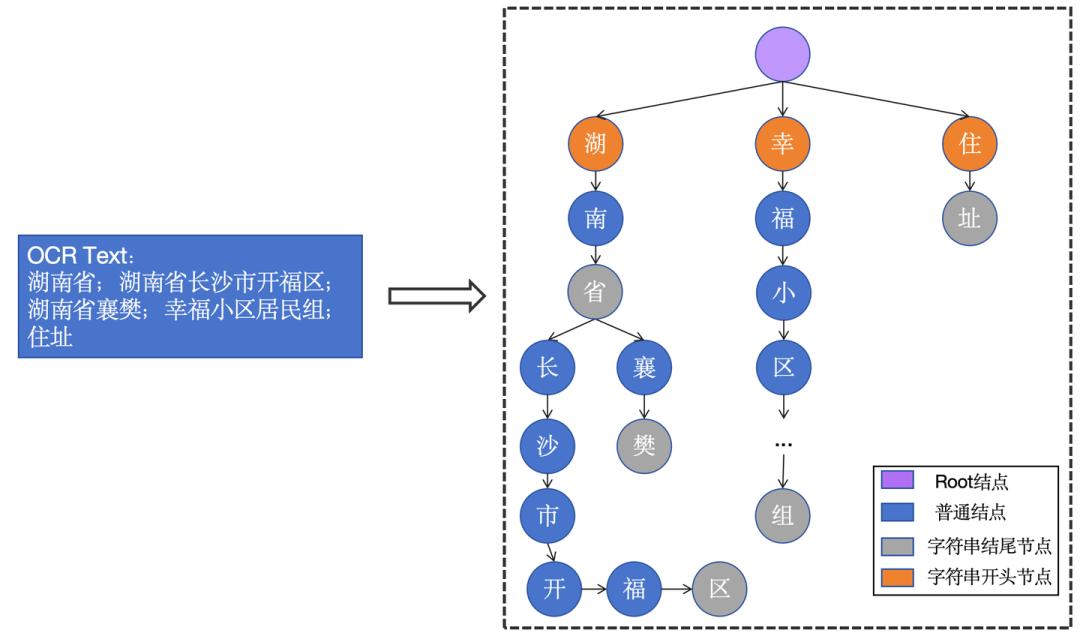
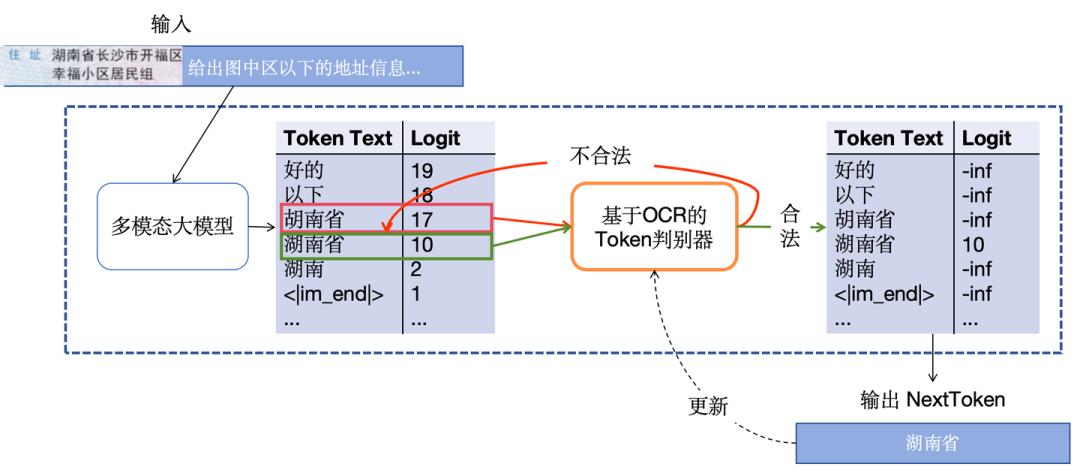
图5给出了Guidance OCR的算法流程:在VLM每次生成Token的时候,先将候选的token按logit从大到小进行排序(图5 左侧);再使用基于OCR的token判别器逐个判断候选Token是否合法(图五 中间);找到的第一个合法Token即为VLM该次生成的Token(图5 右侧);在进行下一次生成候选token前,Guidance OCR还会根据此次生成的Token更新基于OCR的Token判别器(图5 虚线部分)。

图6:基于OCR的Token判断器,其结构为OCR识别出的字符串组成的字典树

图6给出了基于OCR的Token判别器中的数据结构。在该字典树中,每个被OCR识别出的字符串的开头节点和结尾节点都特殊标识了出来。在介绍如何根据该字典树判断Token是否合法前,我们需要先定义字典树上连续的一条边

字典树上连续的一条边:

  • 字典树中从上到下连续的字,如:湖南省,小区,南省长沙市;

  • 若灰色节点后接橙色节点,则仍然连续,如:开福区幸福小区、湖南省幸福小区、襄樊湖南省。

被token判别器判定为合法的候选token必须满足:

  • 若为大模型首次生成的候选token,对应的文字必须是字典树上连续的一条边或生成结束标识符;

  • 若不是大模型首次生成的候选token,大模型之前生成的文字 + 候选token对应的文字,是字典树上连续的一条边或生成结束标识符。

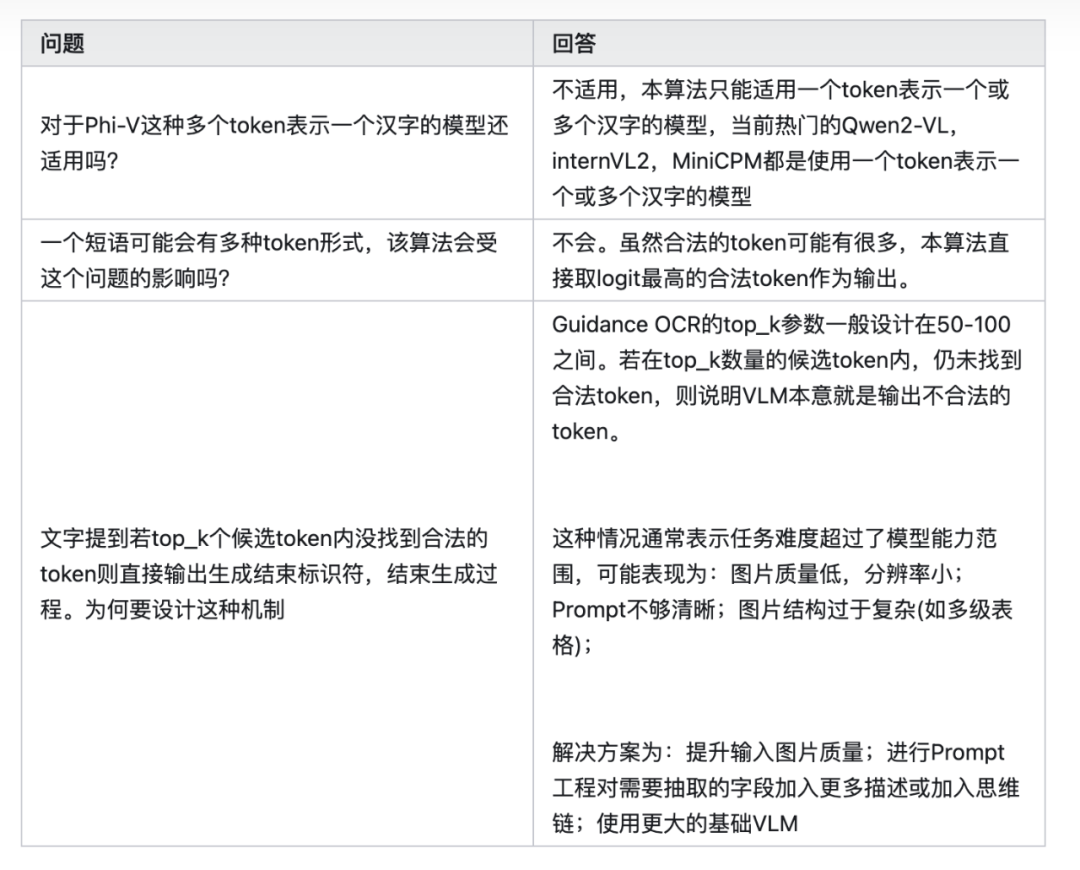
额外的top_k参数:为了节省时间并提高准确率,Guidance OCR会设置top_k参数,在使用图5所示的算法筛选token时,仅筛选logits为前top_k大的token。若前top_k token中无合法token,则直接输出生成结束标识符,结束生成过程。在实际使用中,通常将top_k设定在50到100之间的数值。

小结:在单个字段的信息抽取的场景下,GuidanceOCR会将OCR识别出的文字内容组合成一个字典树并保证大模型的输出内容为字典树上连续的一条边。在这里我们扩展了连续性的定义,这是为了兼容信息抽取时,需抽取的字段横跨多个文本框的情况。

多个字段的信息抽取

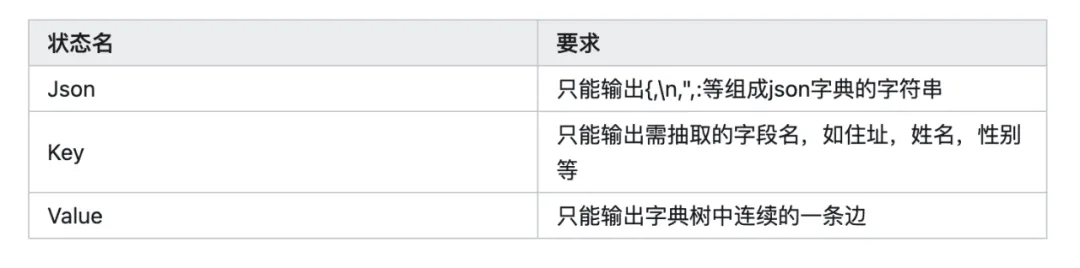
在多个字段信息抽取的场景下,多模态大模型的Prompt和Response的要求如下
与上节的方法类似,多个字段的信息抽取仍然是使用图5所示的Token判别器实现的。与上节不同的是,token判别器有json,key和value三个状态
在这里插入图片描述

当生成时,token判别器为json状态,随着生成的进行,token判别器会基于启发式的规则,进行状态转移,从而保证能生成json格式的结果。与2.2节一致,若输出生成结束标识符或top_k内没找到符合条件的候选token时,生成过程结束。

三、模型效果

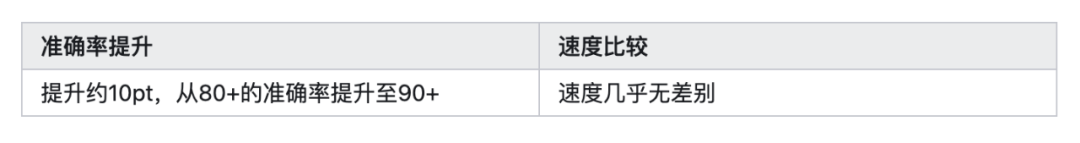
在信息抽取数据集上,使用Qwen2VL-2B进行测试;输入图像进行等比例缩放,并将最长边固定为1024;使用Guidance OCR的多个字段信息抽取模式;使用transformers中AutoModel.from_pretrained()部署模型,进行infer
四、讨论
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

OCR多模态模型Vary的论文阅读笔记 vary论文的阅读笔记 阅读详情

相关推荐

【文档理解】TextMonkey:一种OCR-Free的用于文档理解的多模态大模型

TextMonkey在多个方面进行改进:通过采用零初始化的Shifted Window Attention,TextMonkey实现了更高输入分辨率下的窗口间信息交互;通过使用相似性来过滤出重要的图像特征,TextMonkey不仅能够简化输入,还可以提高模型的性能。此外,通过扩展多个文本相关任务并将位置信息纳入回答,TextMonkey增强了可解释性并减少了幻觉。与此同时,TextMonkey在微调之后还可以具备APP Agent中理解用户指令并点击相应位置的能力,展现了其下游应用的巨大潜力。

让算法融入生活,改变生活! 2101

本地部署大模型实现OCR识别

在数字化时代,光学字符识别(OCR)技术已成为信息处理和文档管理的重要工具。近年来,随着大模型技术的兴起,OCR技术迎来了新的发展机遇。本文将探讨大模型在OCR识别中的应用,分析其技术优势、行业实践以及未来趋势。

qq_63708623的博客 5283

多模态大模型研究综述

尽管LLMs在自然语言处理(NLP)任务上表现出色,但它们在视觉方面是“盲”的,即只能理解离散的文本信息。与此同时,大型视觉模型(LVMs)虽然在视觉识别上表现出色,但在推理方面通常不如LLMs。MLLM的出现,正是为了结合LLM和LVM的优势,实现对多模态信息的接收、推理和输出。

人工智能讲师分享前沿技术 1859

万字分享多模态大模型OCR工作 OCR VLM

文本OCR任务是目前MLLM领域比较受重视的一个方向,业务场景相对较多,且如果能实现也是对当前OCR pipeline一次很好的变革。很多实验室和企业都有相关的重点工作。过去的OCR主要是多模块pipeline设计,流程上包括: 元素检测、区域裁剪和字符识别部分。每个模块都容易过拟合,使整个系统产生较高的维护成本。此外,传统的 OCR 方法泛化能力不足,针对不同场景要选择或专门训练相应的模型。现在就有一批尝试通过VLM范式解决OCR任务的工作。

2401_85375151的博客 4390

使用无 OCR 大型多模态模型解析 PDF 的方法

本文重点介绍使用无 OCR 大型多模态模型解析 PDF 的方法。它主要讨论了三种典型的无 OCR 大型多模态模型用于文档理解。

RA AI衍生者训练营的博客 3599

视觉大模型学习总结

视觉大模型(VLMs)在视觉与语言结合的多模态任务中展现出强大能力。Idefics系列(HuggingFace)基于LLaMA/Mistral架构,支持多图输入和开放式问答,适合图文推理;Qwen-VL系列(阿里巴巴)优化中文能力,擅长中文图文理解和OCR任务;LLaVA系列(UC Berkeley)轻量且教学友好,适合视觉问答和聊天机器人;Phi-3 Vision(Microsoft)以极小模型实现高效图文理解,适合边缘设备等等。

xiaomu_347的博客 1423

可以本地部署的最强OCR大模型:OlmOCR

支持结构化精准提取复杂PDF文件内容!完美识别中英文文档、模糊扫描件与复杂表格!本地部署与实际测试全过程!医疗法律行业必备!轻松应对企业级PDF批量转换需求!

m0_59235699的博客 4781

使用 Mid360 从零开始搭建实物机器人入门级导航系统 —— 基于 Fast_Lio 和 Move_Base

本文详细介绍了如何使用Mid360机器人从零开始搭建一个基于Fast_Lio和Move_Base的入门级导航系统。通过配置 ROS2、集成激光雷达、IMU、Fast_Lio、Move_Base 等模块,我们成功构建了一个能够实现自动导航的机器人系统。在实际开发中,随着需求的变化,你可以不断调整参数、优化路径规划算法、增加新的传感器等,逐步提升机器人的智能与功能。

小蜗牛的珍贵百宝箱 3568

多模态大模型架构_视觉语言模型VLM原理

VLM(Vision-Language Model,视觉语言模型)让大模型同时处理图片和文字。它不是简单“OCR 后交给文本模型”,而是通过视觉编码器、投影模块和语言模型,把图像特征接入生成过程

倔强的石头的博客 1万+

不用买显示器!用USBMMID虚拟显示器软件在Win10上扩展4个屏幕(保姆级教程)

本文提供了一份详细的保姆级教程,指导用户如何在Windows 10系统上,无需购买额外硬件,通过USBMMID虚拟显示器软件扩展出多达4个虚拟屏幕。文章深入解析了虚拟显示器的核心原理,并基于微软IDD框架,手把手教学从软件获取、环境检查到安装配置的全过程,帮助开发者和多任务用户构建高效、免费的虚拟多屏工作站,实现生产力的飞跃。

backprop5master的博客 661

从STM32F411到华大HC32F460:一个真实项目移植的踩坑与填坑全记录

本文详细记录了从STM32F411移植到华大HC32F460芯片的全过程,包括开发环境搭建、时钟树配置、中断处理、外设驱动、看门狗陷阱、Flash操作和低功耗设计等关键坑点及解决方案。特别针对HC32F460的200MHz主频、双PLL架构和HSRUN模式等特性进行了深入分析,为工程师提供实用的移植指南,帮助节省大量调试时间。

weixin_33691817的博客 421

多模态大模型:视觉模型与LLM的结合之路三:InternVL-v1.5、Qwen2VL

相较于之前的工作,本文的主要贡献在于将更精细的动态图像预处理方式和统一的多模态位置编码引入了多模态大模型。 Qwen2VL仅要求图像的宽高能被28整除,该方式能处理更多样的长宽比。且能根据图像分辨率分配img_emb的token数量,资源消耗更加合理。 统一的多模态位置emb(M-Rope)统一了图像,视频和文本。对比实验证明了该编码方式能提升模型效果。

1320

一文看懂分布式存储架构

目录一、集中存储结构二、分布式存储1 、分布式存储的兴起2 、分布式存储的重要性3 、分布式存储的种类和比较三、分布式理论浅析1 、一致性和可用性2 、数据分布3 、复制4 、分布式协议5、跨机房部署四、分布式文件系统1、 Google 文件系统( GFS )2、 Taobao 文件系统( TFS )3、 Fackbook Haystack 文件系统4、 CDN 内容分发网络五、分布式键值系统1、 Amazon Dynamo2、 Taobao Tiar3、 ETCD4 、产品选型比较( Etcd , Zoo

weixin_70730532的博客 2万+

本地OCR+LLM智能解析:图片文字精准提取与排版还原

你可以根据自己的需求选择组合方案。如果需要更详细的部署教程(如Donut+PaddleOCR+Ollama的Pipeline),可以告诉我,我可以提供完整代码示例!平台,支持本地运行并通过API调用。Ollama 主要支持。这些模型适合通用文本生成、问答和代码生成,可以在。等架构的模型,但也有一些。

Leon_Jinhai_Sun的博客 2541

如何搭建pikachu靶场

Pikachu靶场本地搭建指南 下载安装PHPStudy并启动Apache/MySQL服务 获取Pikachu靶场源码并解压到网站根目录 配置数据库连接信息(修改config.inc.php文件) 创建pikachu数据库(用户名/密码设为root) 访问http://localhost/pikachu测试功能 常见问题:数据库连接失败需检查服务状态和配置信息,页面报错需检查PHP版本兼容性。建议使用PHP7.3/7.4版本,在隔离环境中搭建使用。 (150字)

2401_85351702的博客 1278

Open3D 计算点云的倒角距离(Chamfer Distance)【2025最新版】

;Chamfer Distance距离可以计算生成点云数据与标签点云数据之间的平均最短点距离。Open3D可以直接用来计算点云的Chamfer Distance距离。博客长期更新,本文最近一次更新时间为:2025年2月18日。

点云侠的博客 3254

【大模型开发】视觉模型和大语言模型的多模态版本分析与选型

以下内容将对多模态大模型的选型进行剖析,主要分为视觉模型与大语言模型(LLM)的多模态版本两个方向

人工智能(AI)技术,大模型技术,深度学习,机器学习,计算机视觉,AI工具实践应用等分享 1209

A*寻路算法的最简单通俗讲解

为什么我的眼里常含泪水?因为我有一个算法不会。为了节约点眼泪,今天我们就来介绍著名的A*寻路算法(或简称A*算法)。 Peter Hart, Nils Nilsson 和 Bertram Raphael 在1968年首次提出了著名的A*算法。A*算法其实是Dijkstra最短路径算法的一种扩展。不一样的是,在A*算法中我们需要使用Heuristics 来导引搜索过程,以期达到更好的表现。 ...

白马负金羁 2万+

【文档智能 & LLM】LayoutLLM:一种多模态文档布局模型和大模型结合的框架

传统的文档理解任务,通常的做法是先经过预训练,然后微调相应的下游任务及数据集,如文档图像分类和信息提取等,通过结合图像、文本和布局结构的预训练知识来增强文档理解。LayoutLLM是一种结合了大模型和视觉文档理解技术的单模型方法,通过多模态指令数据集的微调来提高对图像文档的理解和分析能力。本文介绍了一种传统布局模型结合大模型做文档理解的方法:LayoutLLM。这个框架通过结合VrDU编码器来捕捉文档图像的特征,以及使用LLM作为解码器来处理任务指令,有效地提高了对文档图像的理解和分析能力。

余俊晖,NLP炼丹师,目前专注自然语言处理领域研究。曾获得国内外自然语言处理算法竞赛TOP奖项近二十项。 3345

2025年7月12日全国青少年信息素养大赛图形化(Scratch)编程小学低年级组复赛真题+答案解析

2025年7月12日全国青少年信息素养大赛图形化(Scratch)编程小学低年级组复赛真题+答案解析

伶俐角少儿编程 712

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Mathtype公式识别升级之路:多模态大模型加持OCR精准解析

借助多模态大模型与ms-swift框架,数学公式OCR实现从字符识别到结构理解的跨越。无需复杂编程,通过LoRA微调即可在单卡GPU上高效训练高精度模型,支持手写、扫描等多种场景,并可快速部署为高性能服务,广泛应用于教育、科研与无障碍领域。

weixin_35045970的博客 1024

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

多模态大模型集成:DeepSeek-OCR与LLM联合应用案例

本文介绍了如何在星图GPU平台上自动化部署🏮 DeepSeek-OCR · 万象识界镜像,实现高精度多模态文档理解。该镜像可一键解析PDF、扫描件等复杂文档,精准还原表格、公式与图表结构,典型应用于智能合同审查、科研文献速读及多语言政务文件处理,显著提升非结构化文本的AI分析效率。

weixin_33480380的博客 296

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

上一篇: 论文分享 | 多模态大模型最新进展
下一篇: knowledge-graph-studio:一个为RAG应用设计的知识图谱构建和管理平台
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值