【3k star!】最新开源ASR模型Moonshine性能超过whisper: 速度更快、准确率更高!实测一把,感觉。。。

微软ASR与开源模型分析 您指的是 微软语音识别(Automatic Speech Recognition,ASR)技术方案,这是微软人工智能服务中的核心能力之一,主要集成在 Azure Cognitive Services(认知服务) 的 Speech Service 中。以下是深度解析:音频输入Azure Speech Service语音识别ASR说话人识别语音合成TTS文本输出/分析 2. 接入方式 方式 适用场景 工具 REST API 简单异步识别(<60秒音频) + 认证密钥 SDK 实时流/复杂应 阅读详情
AI摘要

本文分享了开源ASR模型Moonshine,它基于Transformer架构,处理速度比Whisper快,准确率也更高。通过多个案例对比了Moonshine-base和Whisper-base的语音识别效果,还给出了大模型AI的学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段。

前言

今天给大家分享最新开源的一款ASR模型Moonshine, 据官方介绍,比whisper同等级规模的参数版本识别速度更快,准确率更高! 本文将准备多个案例进行实测ASR效果,仅供参考。下面进入今天的主题~

本文目录

  • moonshine模型介绍

  • moonshine性能介绍

  • 实战篇:下载moonshine模型权重&&步骤代码进行语音识别

  • 使用 onnxruntime 包来运行 Moonshine 模型,不依赖torch

  • 使用huggingface框架加载moonshine模型进行asr语音识别

  • 效果篇: moonshine-base模型 VS whisper-base模型ASR效果对比

  • 案例1: 短文本语音识别-2种模型效果展示

  • 案例2: TED演讲视频-2种模型效果展示

moonshine模型介绍

Moonshine 是由 Useful Sensors公司推出开源的语音到文本(speech-to-text, STT)转换模型,旨在为资源受限设备提供快速而准确的自动语音识别(ASR)服务。Moonshine 基于先进的编码器-解码器架构,采用了Transformer模型。其编码器部分负责处理输入的语音信号,而解码器部分则生成文本输出。目前在gitihub社区点赞量达2k!Moonshine模型具有以下特点:
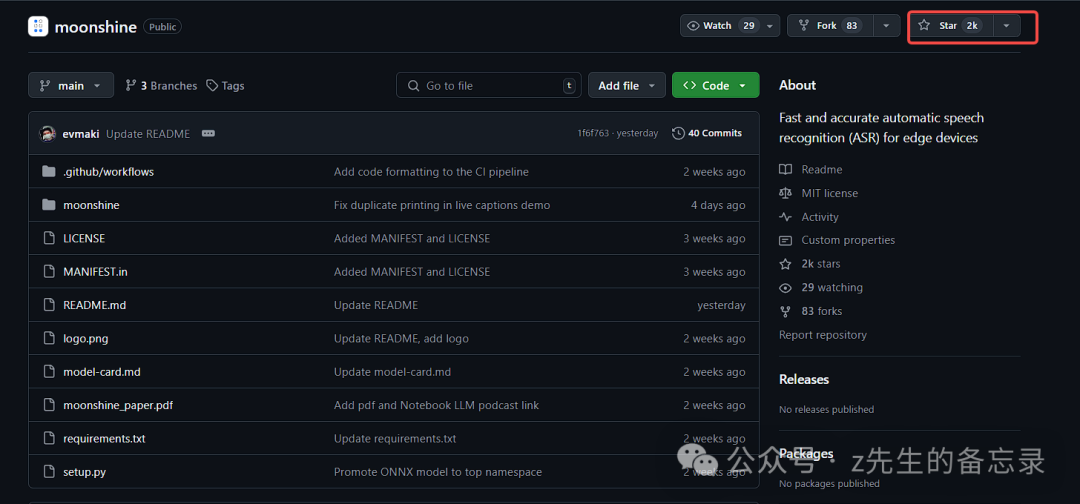
  1. 开源tiny版本,参数量:27 M, 只支持英文语言; 开源base版本,参数量:61 M, 只支持英文语言;

  2. 更快的处理速度,Moonshine 的处理速度比 Whisper 快 1.7 倍。对于 10 秒的短音频片段,处理速度可达 Whisper 的五倍。

  3. 基于20w小时的语音样本训练而来。

moonshine性能介绍

Moonshine 在多个维度上超越了现有的语音识别解决方案,特别是在处理速度和准确度方面。据官方报告,Moonshine 的处理速度「比 OpenAI 的 Whisper 快五倍」,并且在词错误率方面也表现得更好,如下图所示。这种显著的优势使得 Moonshine 成为资源受限环境下语音识别的理想选择。
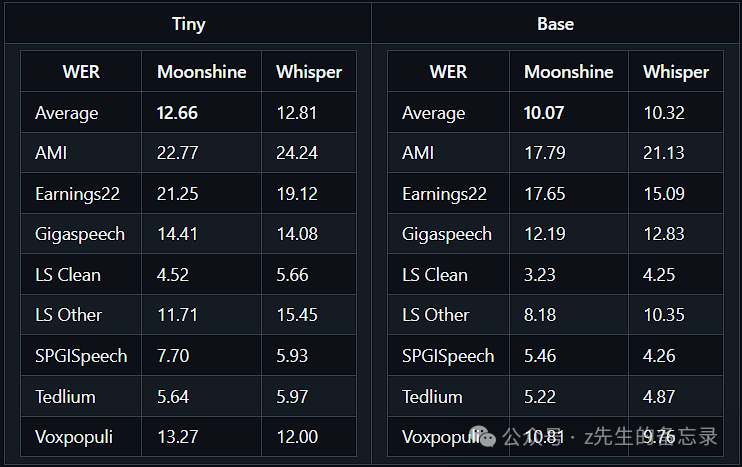
下面我将给大家实操部署moonshine-base模型和whisper-base模型,准备几个案例来实际展示具体的语音识别效果,仅供参考~

实战篇:下载moonshine模型权重&&步骤代码进行语音识别

使用 onnxruntime 包来运行 Moonshine 模型,不依赖torch

from IPython.display import clear_output   !pip install moonshine   !git clone https://github.com/usefulsensors/moonshine.git   !pip install silero_vad onnxruntime  sounddevice tokenizers einops   !pip install onnxruntime-gpu   
下载模型权重
!huggingface-cli download UsefulSensors/moonshine  --local-dir . --local-dir-use-symlinks False   clear_output()   
加载moonshine模型onnx格式权重进行推理
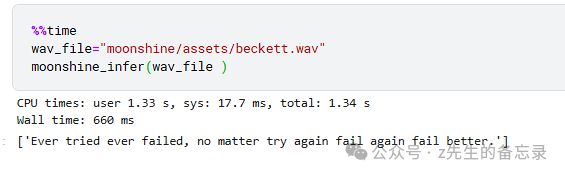
model = MoonshineOnnxModel(models_dir= "./onnx/base")   def moonshine_infer(wav_file):       with wave.open(wav_file) as f:           params = f.getparams()           assert (               params.nchannels == 1               and params.framerate == 16_000               and params.sampwidth == 2           ), f"wave file should have 1 channel, 16KHz, and int16"           audio = f.readframes(params.nframes)       audio = np.frombuffer(audio, np.int16) / 32768.0       audio = audio.astype(np.float32)[None, ...]       tokens = model.generate(audio)       tokenizer = tokenizers.Tokenizer.from_file("./moonshine/assets/tokenizer.json")       text = tokenizer.decode_batch(tokens)       return text   
进行模型推理
使用huggingface框架加载moonshine模型进行asr语音识别

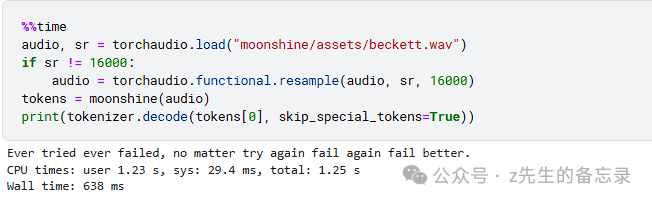
%%time    %cd /kaggle/working/moonshine   from IPython.display import clear_output   from transformers import AutoModelForSpeechSeq2Seq, AutoConfig, PreTrainedTokenizerFast   import torchaudio   import torch   import sys   device = "cuda:0" if torch.cuda.is_available() else "cpu"   # 'usefulsensors/moonshine-base' for the base model   moonshine = AutoModelForSpeechSeq2Seq.from_pretrained('usefulsensors/moonshine-base', trust_remote_code=True)   tokenizer = PreTrainedTokenizerFast.from_pretrained('usefulsensors/moonshine-base')   audio, sr = torchaudio.load("moonshine/assets/beckett.wav")   if sr != 16000:       audio = torchaudio.functional.resample(audio, sr, 16000)   tokens = moonshine(audio)   print(tokenizer.decode(tokens[0], skip_special_tokens=True))   
下面我将利用moonshine-base版本和whisper-base版本的模型进行语音识别效果对比,看具体实际案例情况下,模型的具体表现情况,随便找的素材,经供参考~

效果篇: moonshine-base模型 VS whisper-base模型ASR效果对比

案例1: 短文本语音识别-2种模型效果展示

参考音频1效果展示:

moonshine-base的ASR效果展示
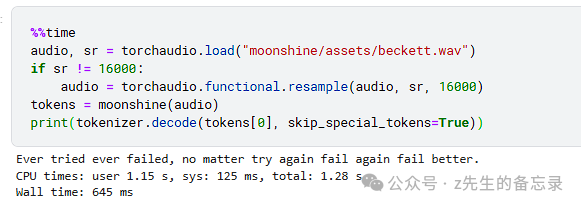
识别结果: Ever tried ever failed, no matter try again fail again fail better.

whisper-base的ASR效果展示
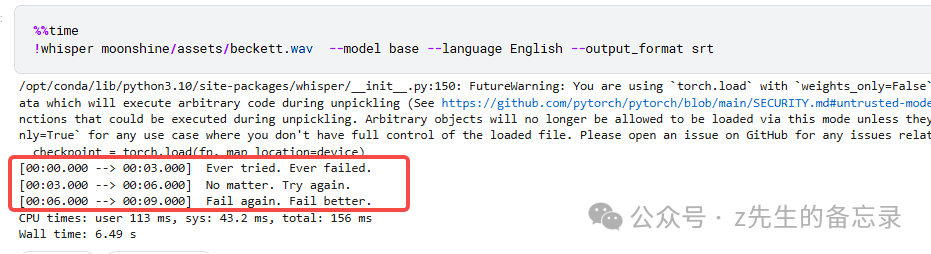
2种模型识别结果都非常正确,而moonshine-base速度很快,只用来不到0.6秒,即便算上模型加载的时间,也才1.2秒。

案例2: TED演讲视频-2种模型效果展示

随便找一份英语的演讲视频进行测试,我这个找到https://www.youtube.com/playlist?list=PLosaC3gb0kGDUYoRq-VioWOZ5Ke0UIoSE,截取前2分钟的视频转化为音频效果如下:

moonshine-base的ASR效果展示
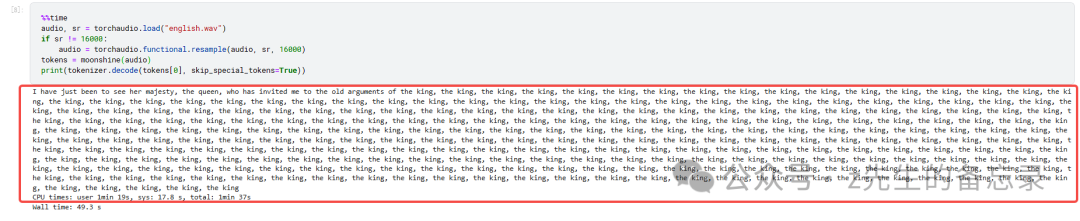
单次不支持长语音识别,采用分段识别,代码如下:

import librosa   import os   import moonshine   import soundfile as sf   # !mkdir temp   def benchmark(audio_pth):       # 读取音频文件       audio, sr = torchaudio.load("english.wav")       if sr != 16000:           audio = torchaudio.functional.resample(audio, sr, 16000)       # 分割音频文件成小段       chunk_duration = 10  # 每个片段的长度(秒)       chunk_size = int(chunk_duration * sr)       chunks = [audio[0:1,i:i + chunk_size] for i in range(0, audio.shape[1], chunk_size)]          # 转录音频       transcription = ""       for i, chunk in enumerate(chunks):           print(f"正在转录... ({i + 1}/{len(chunks)})")           tokens = moonshine_model(chunk)           chunk_transcription = tokenizer.decode(tokens[0], skip_special_tokens=True)              if isinstance(chunk_transcription, list):               chunk_transcription = ' '.join(chunk_transcription)              transcription += chunk_transcription       return transcription   

最后识别的结果如下:
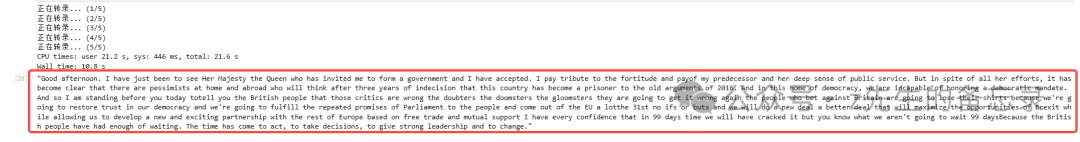
whisper-base的ASR效果展示
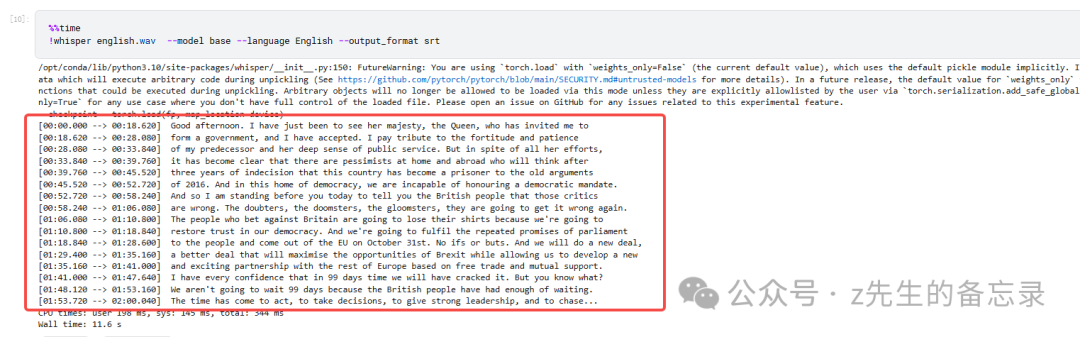
我感觉2个模型识别的效果相差不大,moonshine速度是比较快的,但是目前moonshine只支持英文。大家可以对比录音听听,看看谁识别的更准~

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

开源语音TTS与ASR大模型选型指南(2025最新版)(疯聊AI提供) 开源语音大模型正重塑智能语音市场格局,TTS(文本转语音)和ASR(语音识别)技术取得显著突破。国产模型Speech-02-HD在TTS领域表现突出,支持32种语言和情感控制,在自然度和音色克隆方面领先。ASR领域,FireRedASR中文识别效果优异,Whisper多语言覆盖广。选型需考虑场景需求,如智能客服推荐Speech-02-HD+FireRedASR组合。未来趋势包括多模态融合、边缘计算和情感计算,但面临数据合规、技术同质化等挑战。开源技术正加速语音AI在各行业的应用渗透。 阅读详情

相关推荐

Whisper OpenAI开源语音识别模型

Whisper 是一个自动语音识别(ASR,Automatic Speech Recognition)系统,OpenAI 通过从网络上收集了 68 万小时的多语言(98 种语言)和多任务(multitask)监督数据对 Whisper 进行了训练。OpenAI 认为使用这样一个庞大而多样的数据集,可以提高对口音、背景噪音和技术术语的识别能力。除了可以用于语音识别,Whisper 还能实现多种语言的转录,以及将这些语言翻译成英语。语音转文字在许多不同领域都有着广泛的应用。

在网搬砖的日常 1万+

ASR系列1 - 主流开源ASR框架介绍

现代 ASR 可以非常可靠地将口语单词转录为数字文本格式,从而可以更轻松地分析、存储和处理音频数据,以供电信、医疗保健、教育、客户服务和娱乐等行业的广泛应用。当今大多数领先的 ASR 模型都是围绕编码器-解码器架构构建的。编码器从输入中提取听觉特征,解码器将这些特征重构为自然语言序列。利用这种架构,这些模型可以实现接近人类水平的音频和视频记录转录,例如采访、会议和讲座,甚至是实时的;它有助于将语音查询或命令转换为可操作的数据,从而增强用户体验和客户服务应用程序的效率。

ms44的专栏 4278

SenseVoice 实测,阿里开源语音大模型,识别效果和效率优于 Whisper,居然还能检测掌声、笑声!5分钟带你部署体验

阿里开源语音大模型:语音识别效果和性能强于 Whisper,还能检测掌声、笑声、咳嗽等

u010522887的专栏 4万+

开源(离线)中文语音识别ASR(语音转文本)工具整理

ASRT是一个基于深度学习的语音识别工具,可以用于开发最先进的语音识别系统,是由AI柠檬博主(西安电子科技大学 · 西安市大数据与视觉智能重点实验室)从2016年起做的开源语音识别项目,基线为85%识别准确率,在某些条件下可做到95%左右的识别准确率。ASRT包含了语音识别算法服务端(用于训练或部署API服务)和多种平台及编程语言的客户端SDK,支持一句话识别和实时流式识别,相关的代码已经开源在GitHub和Gitee上。微软语音服务通过 Azure 语音资源提供语音转文本和文本转语音功能。

guigenyi的专栏 1万+

自动驾驶轨迹规划算法——Apollo Lattice Planner

Apollo Lattice Planner是百度Apollo自动驾驶系统中的一种基于采样的实时轨迹规划算法。其核心思想是在离散化的状态空间中,对终端状态进行采样,并通过多项式曲线连接当前状态与候选终端状态,形成候选轨迹集,最后基于代价函数选择最优轨迹。该算法将车辆可达状态按纵向距离、横向偏移和速度等维度规则离散化,形成"格点"状态空间。 Lattice Planner通过三个主要步骤实现轨迹规划:1)终端状态采样,在规划时域内枚举多种驾驶意图;2)轨迹生成,使用五次多项式连接起点与各终

swaggytiger的博客 1624

手把手教你用Ubuntu Desktop搭建个人L2TP服务器,手机电脑都能连(Network Manager配置详解)

本文详细介绍了在Ubuntu Desktop上使用Network Manager图形化配置L2TP服务器的方法,实现手机、电脑等多设备安全连接。从环境准备、图形界面设置到各平台客户端配置,提供一站式解决方案,并包含常见问题排查与安全增强措施,帮助用户快速搭建个人远程访问网络。

weixin_30555125的博客 119

目前主流OCR/语义理解/ASR

注:以上排名综合了2024年多篇横向评测,测试环境均采用各工具默认预训练模型。实际效果可能因具体图片质量、语言类型和部署环境有所差异。需要更高精度可考虑基于业务数据微调模型(推荐PaddleOCR或RapidOCR)。注:以上排名基于开源社区实测数据和Papers With Code榜单,具体表现可能因硬件环境和任务类型有所差异。基于多篇专业评测的结果,以下是目前免费开源OCR工具的推荐排名(侧重中文场景)注:以上排名综合开源社区评测数据(如Gigaspeech基准测试)

AI大模型/Python/Java/MySQL技术栈,快来和我一起学习吧 ~ 3567

新手避坑指南:从GEO数据库下载单细胞测序数据的5个关键步骤(附实操截图)

本文为单细胞测序数据下载新手提供5个关键避坑步骤,涵盖数据搜索准备、样本量评估、文件选择决策、元数据诊断及高效下载技术。通过实操截图和代码示例,帮助研究者快速锁定GEO数据库中的优质单细胞测序数据,避免常见错误。

weixin_30296405的博客 675

十大开源语音识别项目

通过支持在 ModelScope 上发布的工业级语音识别模型的训练和微调,研究人员和开发人员可以更方便地进行语音识别模型的研究和生产,并促进语音识别生态系统的发展。SpeechBrain 是一个基于 PyTorch 的开源、全能的对话人工智能工具包,可用于开发最先进的语音技术,包括语音识别系统,说话人识别、鉴定和记录,语音增强,语音分离,语言识别,语言翻译等。ASRT 是一个基于深度学习的中文语音识别系统,在训练中使用了大量中文语音数据,将声音转录为中文拼音,并通过语言模型,将拼音序列转换为中文文本。

m0_49711991的博客 8002

使用GDScript(godot)生成仿杀戮尖塔地图

使用GDScript(godot)生成仿杀戮尖塔地图 extends Node2D export (PackedScene) var Ball var 被连接数 = {} # 每个怪物被下层怪物连接的数量 最多为2 var 连接1 = {} # 第一次连接的上层怪物位置 var 连接2 = {} # 第二次连接的上层怪物位置 var 怪物数量 = [0,0,0,0,0,0,0,0,0,0,0,0,0,0] # 每层怪物的数量 var 总层数 =8 # 总层数 var 怪物坐标行 = {} #

weixin_45038716的博客 3011

世界职业院校技能大赛商贸赛道项目参考逐字稿一

商贸赛道“智选优品”—基于大数据与AI驱动的跨境电商平台项目参考逐字稿您订阅本专栏后即可`永久享有所有文章的查阅权`,希望我们更新的参考资料能帮助到您。如果您需要我们团队赋能培训可联系我(企业一线工程师及国一获奖选手在线培训支持:每周直播精讲(可回放,支持弹幕答疑)、代码Review+技术售后(拉群随时问,12h内响应)、④路演PPT+答辩话术一对一点评,评委视角提前彩排、适合:中职/高职赛项选手、指导老师带队、校企工作室、整校打包另谈(可开发票))

我是网络安全兼技能大赛工程师,专注网络安全技术学习与技能大赛实战!持续分享最新的技术文章,帮你少走弯路,一起在技术赛道上进步~ 1591

【GitHub项目推荐--13个最佳开源语音识别引擎】【转载】

它主要支持日语ASR,但作为一个独立于语言的程序,该模型可以理解和处理多种语言,包括英语,斯洛文尼亚语,法语,泰语等。ESPnet是一个基于Apache 2.0许可证发布的开源语音转文本软件,它提供端到端语音处理功能,涵盖了ASR、翻译、语音合成、增强和日志化等任务。语音识别基本过程一般包括:分析音频、音频分解、格式转换、文本匹配,但实际的语音识别系统可能会更复杂,并且可能包括其他步骤和功能组件,例如:噪声抑制、声学模型、语言模型和置信度评估等。它训练执行转录,翻译,自动语音识别和情感分析任务的语言模型。

j8267643的博客 5万+

Ghost卷积原理与构建YOLOv11的GhostNet变体

本文探讨了在边缘设备部署YOLOv11时使用Ghost卷积进行模型轻量化的实践经验。针对Jetson Nano的4GB内存限制,作者通过替换Backbone中的3x3标准卷积为Ghost卷积,实现了参数减少28%、推理速度提升38%,仅损失1.1%mAP的优化效果。文章详细介绍了Ghost卷积的实现原理、在YOLOv11中的具体替换策略,以及训练调参和部署优化的关键技巧。作者强调轻量化是计算效率与模型性能的权衡,建议工程团队保留原模型和Ghost变体两个版本,根据实际需求灵活切换。Ghost卷积的核心价值在

as1225120794的博客 169

【语音识别】WeNet——CPU开源中文语音识别模型选择、部署、封装与流式实现

本文介绍了一次ASR项目开发,包括知识介绍、模型选择、部署、封装、流式逻辑实现等内容。

m0_63589378的博客 4823

cuRobo 入门教程(二)基于CUDA的机器人运动规划加速库

cuRobo是一款基于CUDA加速的机器人算法库,提供正向/逆向运动学、碰撞检测、数值优化等核心功能,支持在NVIDIA Jetson Orin等平台上实现毫秒级运动规划。该库创新性地采用并行轨迹优化技术,结合nvblox工具实现深度摄像头避障功能,并通过多层ESDF结构处理动态障碍物。性能测试显示,在RTX 6000 Ada显卡上可实现99.85%的成功率,平均规划时间仅39毫秒。cuRobo还提供Python API支持神经网络集成,并具备批量环境处理能力,特别适用于工业机器人应用场景。最新版本通过算法

2506_90492529的博客 1303

高级数据结构之R树(R-tree)

R树(R-tree)是一种将B树扩展到多维情况下得到的数据结构,它最初由Antonin Guttman于1984年提出。B树的结点中会存储一个键的集合,这些键把线分成片段,沿着那条线的点仅属于一个片段。因此,B树使得我们可以很容易地找到点。如果把沿线各处的点表示成B树结点,我们就能够确定点所属唯一子结点,在那里可以找到该点。 Antonin Guttman在他提出R树的经典论文中给出的R树例子...

白马负金羁 1万+

6款支持中文语音识别开源软件的简单使用

语音识别技术,也被称为自动语音识别(Automatic Speech Recognition,ASR),其目标是将人类的语音中的词汇内容转换为计算机可读的输入,例如按键、二进制编码或者字符序列。与说话人识别及说话人确认不同,后者尝试识别或确认发出语音的说话人而非其中所包含的词汇内容。语音识别是深度学习领域之一, 在 github 上也有很多项目实现 ASR, 支持中文 ASR 的部分项目如下,下面会演示简单使用。...

十十办文武的博客 1万+

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

AI模型产品经理成长之路:AI大模型产品经理学习全攻略,从入门到精通!

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

2401_84495872的博客 740

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

.Net 使用OpenAI开源语音识别模型Whisper

Open AI在2022年9月21日开源了号称其英文语音辨识能力已达到人类水准的Whisper神经网络,且它亦支持其它98种语言的自动语音辨识。Whisper系统所提供的自动语音辨识(Automatic Speech Recognition,ASR)模型是被训练来运行语音辨识与翻译任务的,它们能将各种语言的语音变成文本,也能将这些文本翻译成英文。whisper的核心功能语音识别,对于大部分人来说,可以帮助我们更快捷的将会议、讲座、课堂录音整理成文字稿;

guigenyi的专栏 7517

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

阿里 FunASR 开源中文语音识别大模型应用示例(准确率比faster-whisper高)

FunASR是一个基础语音识别工具包,提供多种功能,包括语音识别(ASR)、语音端点检测(VAD)、标点恢复、语言模型、说话人验证、说话人分离和多人对话语音识别等。FunASR提供了便捷的脚本和教程,支持预训练好的模型的推理与微调。 我们在ModelScope与huggingface上发布了大量开源数据集或者海量工业数据训练的模型,可以通过我们的模型仓库了解模型的详细信息。代表性的Paraformer非自回归端到端语音识别模型具有高精度、高效率、便捷部署的优点,支持快速构建语音识别服务,详细信息可以阅读(服

心若有所向往,何惧道阻且长。 3050

ASR强力模型「Whisper」:解密Whisper:AI驱动的语音识别新时代 -

它是一个强大的模型,能够处理多种语言的语音输入,支持实时转录、语音翻译等功能,并且在不同的音频质量和语境下都有良好的表现。,Whisper 将使用 16 位浮点数进行计算,从而加速推理过程并减少内存占用,适合在有 GPU 的情况下使用。是的,Whisper 会自动处理长音频文件,并将其分成多个段落进行转录,最终合并为完整的转录文本。Whisper 提供了多种不同大小的模型,选择合适的模型可以根据你的硬件条件和实际需求来决定。模型是较为推荐的选择。:能够处理多种语言的输入,并且可以进行多语言之间的翻译。

具身机器人和通用AI 3399

Moonshine - 新型开源ASR(语音识别)模型,体积小,速度快,比OpenAI Whisper快五倍 本地一键整合包下载

Moonshine 是由 Useful Sensors 公司推出的一系列「语音到文本(speech-to-text, STT)转换模型」,旨在为资源受限设备提供快速而准确的「自动语音识别(ASR)服务」。相比同类产品,如 OpenAI 的 Whisper,Moonshine 在处理速度上提高了五倍,并且在多个标准数据集上展示了更低的词错误率(WER)。据官方报告,Moonshine 的处理速度「比 OpenAI 的 Whisper 快五倍」,并且在词错误率方面也表现得更好。,期待后期更多语种的支持。

前沿AI资讯技术和应用 1874

阿里开源0.8B语音识别模型fun-asr,性能直逼12B巨头,语音AI迎来效率革命

近日,阿里巴巴通义团队开源了Fun-ASR-Nano-2512和Fun-CosyVoice3-0.5B-251

全世界的博客 2100

小红书语音识别新突破!开源FireRedASR,中文效果新SOTA

FireRedASR 系列模型包含两种核心结构:FireRedASR-LLM 和 FireRedASR-AED,分别针对语音识别的极致精度和高效推理需求量身打造。团队开源了不同规模的模型和推理代码,旨在满足全面覆盖多样化的应用场景。FireRedASR-LLM 和 FireRedASR-AED 的结构如下图所示:FireRedASR-LLM(左):结合了文本预训练 LLM 的能力,为极致的 ASR 准确率而生,适用于对准确率要求极高的应用场景。

具身机器人和通用AI 2437

推荐一款革命性的语音识别开源项目——asr-study

推荐一款革命性的语音识别开源项目——asr-study 在当今世界,随着人工智能技术的飞速发展,语音识别成为了人机交互的关键环节之一。今天,我将向大家推荐一个极具潜力的开源项目:asr-study(自动语音识别研究)。这个项目不仅提供了全面的技术实现,还展示了如何从零构建一个端到端的神经网络语音识别系统。 项目介绍 asr-study是一个专注于开发全神经网络巴西葡萄牙语语音识别模型的仓库。它基于...

gitblog_00017的博客 917
上一篇: Nature | 用于快速、无需标记的胶质瘤浸润检测的基础模型!
下一篇: 大型多模态模型中新出现的像素级语义理解,没有语义理解监督
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2839原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值