


摘要
当前大型多模态模型 (LMM) 在语义理解方面面临挑战,这要求模型将语言成分与视觉实体相关联。 与使用额外语义理解监督微调 LMM 的常见做法相反,我们发现语义理解能力实际上可以在 没有 明确语义理解监督的情况下,在训练的 LMM 中出现。 为了揭示这种新出现的语义理解,我们引入了一种“注意和分割”方法,该方法利用来自标准 LMM 的注意力图来执行像素级分割。 此外,为了增强语义理解能力,我们提出了 DiffLMM,这是一种利用基于扩散的视觉编码器 (而不是标准 CLIP 视觉编码器) 的 LMM,并使用相同的弱监督进行训练。 我们的方法不受语义理解特定监督数据的偏差和有限规模的约束,因此具有更好的泛化性和可扩展性。 与分别使用语义理解 LMM 和通用 LMM 相比,我们在语义理解特定和通用视觉问答基准测试中都取得了有竞争力的性能。 值得注意的是,我们在没有任何语义理解监督的情况下,在基于语义理解的对话生成方面实现了 44.2 的语义理解掩码召回率,优于经过广泛监督的模型 GLaMM。 项目页面:https://groundLMM.github.io。
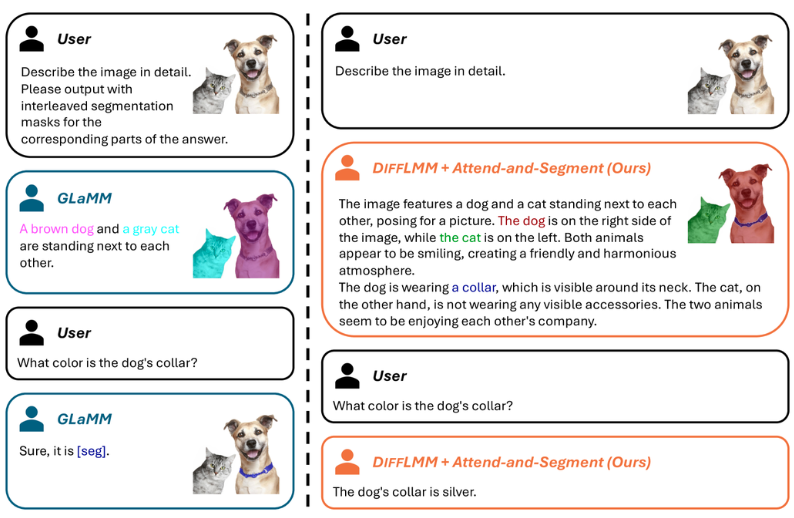
图 1: 使用 GLaMM (Rasheed 等人,2024) 与. 我们的方法,DiffLMM + 注意和分割 的基于语义理解的对话。 左侧: 作为最先进的语义理解 LMM,GLaMM 在生成响应时被训练将文本短语与分割掩码相关联。 然而,由于接地监督引起的限制,它通常无法精确遵循人类用户的指令(例如。,详细描述图像,回答正确的_颜色_)。 右侧: 我们的方法揭示并增强了 LMM 在没有显式语义理解监督的情况下隐式学习的语义理解能力,这在保持 LMM 的通用视觉语言对话能力的同时,导致了视觉上基于语义理解的响应。 图 4 中显示了更多示例。
1引言
大型多模态模型 (LMMs) (Liu等人,2023; Zhu等人,2024; Dai等人,2023) 为以通用方式解决视觉语言任务带来了新的机遇,这些模型通常通过连接视觉编码器和大型语言模型 (LLM) 并通过视觉指令进行微调来构建。 目前,LMMs 面临的一个主要挑战是_语义关联_——将语言成分(例如,名词短语)与给定图像中的视觉实体(例如,物体)关联起来的关键能力(Yu等人,2016; Krishna等人,2017)。 凭借语义关联能力,LMMs 可以解除仅限文本响应的约束,并解决现实世界中更多视觉语言任务。
为了使 LMMs 具备语义关联能力,普遍认为需要_针对语义关联的额外监督_,并且需要引入相应的架构修改。 例如,最近的工作将输出模式从纯文本扩展到边界框(Chen等人,2023b; Peng等人,2024)、轨迹点(Xu等人,2024)或分割掩码(Lai等人,2024; Rasheed等人,2024),方法是:1) 向普通 LMM 架构附加额外的模块,以及 2) 使用语义关联监督对 LMM 进行微调。 语义关联监督源于重新利用包含人工标记的对象级标注的现有数据集,或使用其他模型自动标注图像。
然而,这种_对强监督的依赖_带来了更多不希望有的约束:1) 可扩展性:具有高质量对象级标注的当前图像数据集规模(最多数百万张图像(Shao等人,2019; Kuznetsova等人,2020))远小于只有粗略图像文本对的数据集(最多数十亿张图像(Schuhmann等人,2022)),因此重新利用此类对象级标注只能导致有限规模的视觉指令数据。 同时,如果对象级标注是由自动化模型生成的,则此类标注比人工标注的标注更嘈杂且可靠性更低(Rasheed等人,2024)。 2) 监督偏差:将数据重点转向语义关联任务会导致灾难性遗忘(French, 1999)并损害 LMM 的通用对话能力。 此外,无论语义关联数据是手动标注的(Lin等人,2014)还是由其他模型伪标注的(Rasheed等人,2024),它们都会受到标注者或模型知识的偏差,并且可能无法与普遍的人类偏好相符,因为这些细粒度的标注在不同的标注者或模型之间可能差异很大。 3) 泛化能力:语义关联监督受限于现有数据集或其他模型中的视觉概念,这与开发用于解决开放世界问题的通用助手这一最终目标相矛盾(Bendale & Boult, 2015)。 因此,生成的 LMMs 可能 难以扩展,受语义关联监督数据的影响,并且在新的视觉概念和领域中泛化能力差。 图1和4显示了这些限制的示例。
为避免此类限制,一个值得重新思考的问题出现了: 是否有除了强监督之外的其他方法来进行 LMM 的语义关联? 事实上,在这项工作中,我们揭示了一个关键但以前被忽视的事实:LLM 通过弱监督的视觉指令调优 (Instruction Tuning) 本身就获得了语义理解能力。 换句话说, 大语言模型 (LLM) 的语义理解能力可以在没有语义理解监督的情况下涌现出来。 与先前对传统卷积神经网络的观察结果(Zhou et al., 2015; 2016) 相呼应,我们发现,在图像级别的视觉语言学习过程中,LLM 隐式地_implicitly_学习检测视觉实体并将它们与语言关联起来。
因此,我们提出了一种简单有效的“attend-and-segment”策略,以_将这种涌现的语义理解能力转化为像素级的分割掩码_。 直观地说,LLM 中的注意力机制(Vaswani et al., 2017)揭示了_LLM 在关注什么_,从而为视觉语义理解提供了线索。 我们从使用标准视觉指令调整(Liu等人,2023)训练的基础LMM开始,但没有基础监督,并获取与视觉输入相对应的_注意力图_生成输出 Token 。 然后,注意力图进一步细化为像素级的分割掩码。 使用这种attend-and-segment方法,我们能够实现直接依赖于语义理解能力的视觉语言任务(e.g.,基于语义理解的对话生成(Rasheed et al., 2024))。 值得注意的是,attend-and-segment不需要像先前工作那样进行明确的语义理解监督;相反,来自标准视觉指令调优数据的_弱监督_就足以实现与之前的语义理解监督模型相当甚至更高的性能。 此外,作为一种通用的方法,attend-and-segment可以很容易地与最近的通用LLM(Li et al., 2024a; Tong et al., 2024a)集成,并受益于其更强大的视觉语言能力。
此外,我们提出了一种简单的解决方案来_增强LLM 涌现的语义理解能力_。 以前,CLIP(Radford et al., 2021)由于其视觉语言特征对齐,在LLM的视觉编码器中扮演着主导作用。 然而,众所周知,CLIP在提供局部视觉特征方面较弱(Zhou et al., 2022; Ghiasi et al., 2022; Li et al., 2022),因为它的预训练只是对图像-文本对的全局表示进行对齐。 通过对特定语义理解和一般任务的系统评估,我们发现扩散模型(Ho et al., 2020; Rombach et al., 2022)是CLIP更好的替代方案,因为它们文本到图像的生成能力能够_实现视觉语言对齐和局部特征_。 因此,我们提出了基于扩散的 LMM (DiffLMM),它使用基于扩散的视觉编码器增强了 LMM 的 CLIP 视觉编码器,同时使用与原始 LMM 相同的数据进行微调。 据我们所知,DiffLMM 是 第一个 成功将基于扩散的视觉编码与 LMM 相结合,用于视觉接地和一般视觉语言任务的模型。 与原始 LMM 相比,DiffLMM 增强了接地能力,而没有牺牲通用视觉语言任务的性能。
我们广泛的实验表明,LMM 的接地能力可以 从弱监督中涌现。 我们的方法不需要额外的接地监督,因此 更具可扩展性和通用性,并且 受接地监督数据中偏差的影响更小。 尽管 (Lai 等人,2024;Rasheed 等人,2024) 比之前接地 LMM 的训练数据少,但 DiffLMM 在接地特定基准测试中取得了更好或相当的性能,同时保持了视觉语言任务的强大泛化能力。 总结一下,我们的贡献有三点:
-
与依赖接地特定强监督的先前方法不同,我们展示了在没有接地监督的情况下接地 LMM 的可能性。 我们的方法不需要来自人类或外部模型的细粒度标注,因此更具可扩展性和通用性。
-
我们发现了一种简单有效的方法 attend-and-segment,通过检查模型生成过程中的注意力图并将这些图转换为分割掩码,为 LMM 实现像素级接地,这不需要接地监督或架构更改。
-
我们提出了 DiffLMM,它采用基于扩散模型的视觉编码器。 DiffLMM 提供比原始 LMM 更强的接地能力,同时保持一般的视觉语言任务性能。
2相关工作
大型多模态模型 (LMM)。 LMM 的先驱工作,如 LLaVA (Liu 等人,2023;Sun 等人,2024;Liu 等人,2024a;b)、MiniGPT-4 (Zhu 等人,2024;Chen 等人,2023a) 和 InstructBLIP (Dai 等人,2023;Li 等人,2023a),通过视觉语言特征对齐 (Radford 等人,2021) 和指令调优 (Wei 等人,2022) 为大型语言模型 (LLM) 启用视觉输入。 为了使 LMM 具备接地能力,人们提出了一系列方法来生成模型输出,包括边界框 (Peng 等人,2024;Chen 等人,2023b;Wang 等人,2023;Pi 等人,2023;You 等人,2024;Li 等人,2024b)、点迹 (Xu 等人,2024) 或分割掩码 (Lai 等人,2024;Rasheed 等人,2024;Zhang 等人,2024;Ren 等人,2024),方法是添加区域特定符元或解码器。 这些方法需要进一步的接地监督,因此具有细粒度标注的图像数据集(Lin et al., 2014; Yu et al., 2016; Zhou et al., 2017)通常被重新用于视觉指令调优。 与这些监督方法不同,我们的方法,attend-and-segment,不改变 LMM 架构,也不需要任何接地监督数据。
一项同时进行的工作 F-LMM(Wu et al., 2024a) 展示了一种类似的方法,用于在冻结的 LMM 中利用注意力图进行视觉接地,但我们与它的主要区别在于两个方面:1) F-LMM 仍然遵循监督学习范式,并使用接地数据来学习额外的模块,而我们的attend-and-segment 需要_零监督_。 我们首次揭示了 LMM 在没有显式监督的情况下出现的接地能力。 2) F-LMM 检查现有的 LMM,而不改变它们的视觉编码。 相反,基于我们对视觉表示及其接地能力的系统分析,我们提出了DiffLMM 进一步增强隐式接地。
扩散模型 (DM) 作为视觉特征提取器。 DM(Song & Ermon, 2019; Ho et al., 2020; Song et al., 2021; Karras et al., 2022; Nichol & Dhariwal, 2021; Rombach et al., 2022) 已成为视觉生成中的普遍范式,并且来自 DM 的中间特征被探索用于超越生成任务的应用。 例如,DDPM-Seg(Baranchuk et al., 2022)、ODISE(Xu et al., 2023) 和 EmerDiff(Namekata et al., 2024) 利用 DM 特征用于各种分割任务。 来自 DM 的特征还可以建立图像之间点或像素级别的对应关系(Tang et al., 2023; Luo et al., 2023; Zhang et al., 2023; Hedlin et al., 2023)。 我们首次展示了 DM 可用于学习具有强大接地能力的通用 LMM。
3方法
在本节中,我们首先介绍 LMM 的通用架构设计(第3.1 节)。 然后,我们讨论attend-and-segment,它将隐式学习的接地能力转换为分割掩码(第3.2 节)。 基于标准 LMM 和attend-and-segment,我们提出DiffLMM,以进一步增强接地能力,而无需额外的监督(第3.3 节)。
3.1预备知识:大型多模态模型 (LMM) 的元架构
大多数大语言模型(LLM)(Liu et al., 2023; Zhu et al., 2024; Dai et al., 2023) 共享一个通用的元架构,该架构由一个视觉编码器MV、一个视觉到语言特征投影器MV↦L和一个大型语言模型 (LLM)ML组成,如图2所示。 给定分辨率为H×W的图像I,采用视觉编码器MV(例如,CLIP(Radford et al., 2021))来提取视觉特征V=MV(I)∈ℝh×w×cV,其中h×w表示特征图大小,cV是视觉特征维度。 然后,将视觉特征图视为hw个元素的序列,并由投影器MV↦L将其逐元素投影到语言特征空间。 投影器可以实现为一个可学习的轻量级多层感知器 (MLP)。 第k个投影的视觉符元计算为vk=MV↦L(Vk)∈ℝcL,其中cL是LLM中的特征维度。 将视觉符元与其他语言符元连接起来,形成输入序列Sinput:
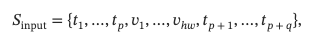
其中{v1,…,vhw}是从视觉特征图投影的hw个视觉符元,t1,…,tp是视觉符元之前的p个语言符元,{tp+1,…,tp+q}是视觉符元之后的q个语言符元。
LLM通常是一个仅解码器的Transformer模型,能够进行下一个符元的预测。 给定输入序列Sinput,输出序列Soutput={o1,…,or}以自回归的方式生成,其中第i个符元预测为:
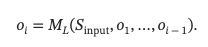
当最后一个预测的符元or是特殊的“序列结束”符元时,生成终止。
3.2Attend-and-Segment:无需地面真值监督的LLM接地方法
以前将LLM接地的方法是将检测或分割模块附加到LLM架构,并使用接地监督专门训练LLM,即,通过对象级标注扩充的视觉指令数据,以便LLM学习预测文本响应和图像内容之间以局部边界框或分割掩码形式的连接。 与这些强监督方法相反,我们提出了attend-and-segment,这是一种简单有效的方法,用于在_不改变其架构或提供额外接地监督_的情况下对LLM进行接地。 我们在生成符元时研究了基于Transformer的语言模型内部的注意力图,并观察到与注意力图相关的强大可解释性。 直观地说,注意力图可以提供关于_模型在生成输出时关注的位置_的信息。
正式地,我们考虑第3.1节中详述的输入符元序列Sinput。 在预测输出符元 oi 时,我们捕获了基于 Transformer 的 LLM ML 内部原始注意力图 Airaw∈[0,1]nlayer×nhead×(p+hw+q+i−1),其中 nlayer 是 LLM 中的层数,nhead 是每层的头数,p+hw+q+i−1 是在第 i 个输出符元 oi 之前的符元数。 我们只使用与 hw 视觉符元相关的注意力图,并通过在 nlayer 层和每层 nhead 个头上的平均来减少维度。 此操作返回一个注意力矩阵 Aireduced∈[0,1]h×w,其空间维度与视觉特征图相同。
输出符元和视觉符元之间的注意力已经可以提供可解释的接地信号。 为了进一步放大接地信号并减少噪声,我们在整个输出序列上应用归一化:
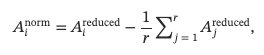
其中 r 是输出序列长度。
为了提供像素级接地,我们通过对注意力图进行上采样并使用预训练的 Segment Anything Model (SAM) (Kirillov et al., 2023) 来推导出一个分割掩码。 对于每个需要接地的符元,我们通过用具有最高归一化注意力的坐标提示 SAM 来生成其对应的二元掩码。 因此,对于输出序列的元素,我们的 attend-and-segment 方法提供了像素级接地结果。 值得注意的是,我们使用现成的 SAM,没有任何修改,而以前的像素级接地 LMM (Lai et al., 2024; Rasheed et al., 2024) 需要用其他模块微调 SAM。
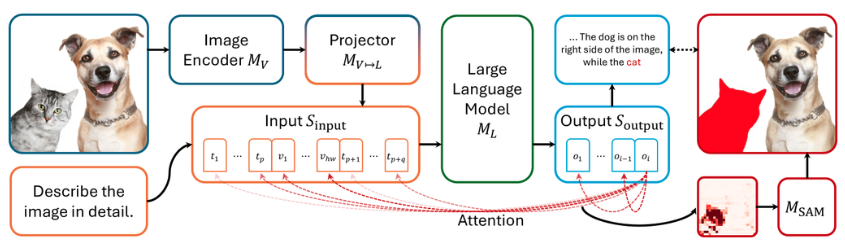
图 2: LMM 的元架构和 attend-and-segment 策略。 在标准 LMM 中,图像编码器 MV 从输入图像中提取视觉特征,这些特征通过投影器 MV↦L 转化为视觉符元。 大语言模型 ML 以自回归的方式生成输出。 在生成一个需要接地的新符元 (e.g.,“猫”) 时,我们捕获了新符元和输入视觉符元之间的 注意力。 然后使用 SAM (Kirillov et al., 2023) 将处理后的注意力图细化为 分割掩码 (e.g.,图像中的猫)。
在诸如基于语境的对话生成之类的下游任务中,最好将名词短语而不是符元与图像内容关联起来。 为此,我们利用现有的自然语言处理工具(例如,spaCy (Honnibal et al., 2020))将输出序列解析为名词短语,并将名词短语与输出符元关联起来。 对于每个名词短语,我们使用来自对应符元的归一化注意力图的平均值来生成分割掩码。 更多细节包含在附录A中。
3.3DiffLMM:基于扩散的LMM增强型定位
大多数LMM使用CLIP (Radford et al., 2021)作为视觉编码器,因为它已经被预训练以对齐视觉和语言表示,但是CLIP在需要精确定位的任务(例如,目标检测,图像分割)中被认为是次优的(Zhou et al., 2022; Ghiasi et al., 2022; Li et al., 2022)。 为了增强LMM的定位能力,一个直接的选择可能是用更好的局部纯视觉主干网络(例如DINO (Caron et al., 2021; Oquab et al., 2024))替换CLIP。 然而,缺乏与语言表示的对齐可能会损害视觉-语言任务的性能(Jiang et al., 2023; Tong et al., 2024b)。
与具有图像级对齐的视觉-语言模型(例如,CLIP)和纯视觉模型(例如,DINO)相比,来自扩散模型(DM)的视觉表示取得了更好的平衡:1)DM学习生成高保真图像,这需要良好定位的视觉特征。 因此,它们在定位方面优于CLIP。 2)DM被训练执行文本到图像的生成,在这个过程中,它们获得了与语言指令的对齐,而这在像DINO这样的纯视觉模型中是缺乏的。 因此,我们提出了基于扩散的LMM(DiffLMM,如图3所示),它使用预训练的DM增强了视觉编码器。
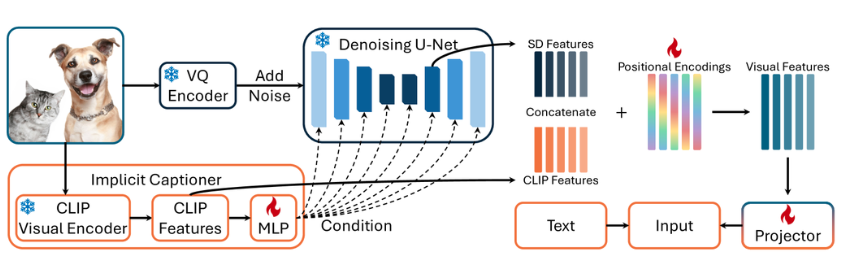
图3: DiffLMM中的视觉编码。 我们使用扩散模型(DM) (Ho et al., 2020; Rombach et al., 2022)执行一步去噪,并从U-Net的中间块提取视觉特征。 隐式字幕器(Xu et al., 2023)生成类似文本的条件,并改进U-Net中的视觉特征。 我们将 DM 特征和 CLIP 特征结合起来,并在其中添加可学习的位置编码。 最终的视觉特征被投影到语言特征空间,并与其他文本符元一起被输入到 LLM 中。 DM 和 CLIP 视觉编码器被冻结。
为了提取给定输入图像 I 的视觉特征,我们在扩散过程中模拟一个去噪步骤。 该图像通过向量量化 (VQ) 编码器进行标记化,添加随机噪声,并输入到 DM 的 U-Net 模型中 (Ho 等人,2020; Rombach 等人,2022)。 我们从 U-Net 中的第二个上采样块中提取视觉特征图,它最好地保留了视觉语义 (Tang 等人,2023)。 文本条件可以增强 DM 中的视觉特征提取,但图像标题通常不可用。 我们采用隐式字幕机制 (Xu 等人,2023),它通过 CLIP 视觉编码器模拟文本条件。 具体来说,CLIP 视觉特征被提取为 VCLIP=MCLIP(I),通过多层感知器 (MLP) MCLIP↦SD 进行投影,并通过交叉注意力模块注入 U-Net。 我们将 DM 视觉特征表示为 VSD=MSD(I,MCLIP↦SD(VCLIP))。 最后,视觉特征图 V 通过连接 DM 特征和 CLIP 特征(注意,我们可以重复使用 CLIP 特征而无需额外开销)并添加一组可学习的位置编码 PE (Vaswani 等人,2017) 来进一步增强定位意识而构成:
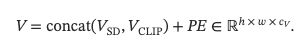
为了高效训练并防止过拟合,我们在 CLIP 视觉编码器和 DM 中冻结了预训练参数。 只有隐式字幕器中的 MLP、位置编码和视觉语言特征投影器在 DiffLMM 的视觉编码器中是可学习的。 由于计算量主要由 DiffLMM 中的大型语言模型组件决定,因此在 DiffLMM 中集成扩散模型不会显着影响效率。 我们只观察到训练和推理时间略有增加 (<5%)。
4实验
本节首先呈现全面的实证结果,以评估我们提出的attend-and-segment和DiffLMM在特定基础任务(第4.1节和4.2节)和一般的视觉问答任务(第4.3节)上的表现。 然后,我们将考察我们的模块设计(第4.4节)并展示定性结果(第4.5节)。 由于篇幅有限,我们将实现细节和进一步的结果放在附录中。 值得注意的是,attend-and-segment和DiffLMM是适用于大型语言模型 (LMM) 的通用方法,但考虑到计算限制,我们将重点放在使用7B或8B规模语言模型(Chiang et al., 2023; Meta, 2024)的基础性增强上。
4.1预备研究:实例分割
我们首先通过对MS-COCO(Lin et al., 2014)数据集进行_实例分割_(He et al., 2017)分析研究,以证明大型语言模型中基础能力的涌现,以及不同的视觉编码器如何影响这种能力。 与视觉语言纠缠基准(将在后面的章节中测试)不同,_以视觉为中心_的实例分割任务1)直接关注将图像区域(表示为分割掩码)与视觉概念(物体类别)相关联,这正是基础目标;2)不基于语言生成进行评估,这使得更方便直接比较不同模型的基础能力。
大型语言模型 (LMM) 原本并非为实例分割而设计。 因此,为了进行评估,我们要求大型语言模型生成给定图像的详细描述,并利用attend-and-segment从大型语言模型的响应中生成名词短语和分割掩码对。 然后,我们使用spaCy(Honnibal et al., 2020)计算它们的嵌入相似度,从而找到每个名词短语最匹配的类别标签。 由于大型语言模型不受限于仅描述数据集标注的对象(并且不应因检测到域外对象而获得奖励或惩罚),我们排除了无法与给定图像中出现的任何类别标签匹配的预测。 我们比较了实例分割中的标准指标:掩码平均精度 (AP) 和掩码平均召回率 (AR)。 在这种情况下,AP 低于 AR,因为模型未针对该任务进行监督,并且我们没有明确删除重复的预测。 为了进一步解耦注意力图_vs_.SAM细化的质量,我们计算了一个新的指标,点精度 (PAcc),它是正确落入对应类别掩码中的提示点的比率。 为了进行比较,我们考虑了一个模拟“盲”大型语言模型的基线,它使用随机点提示SAM来分割每个真实类别的目标。
表1: 基于实例分割的定位能力分析。 我们研究了大型语言模型 (LLM) 注意力图中嵌入的定位能力,并基于LLaVA-1.5 (Liu et al., 2024a),比较了使用不同视觉主干网络(包括CLIP (Radford et al., 2021; Cherti et al., 2023)、DINOv2 (Oquab et al., 2024)和Stable Diffusion (Rombach et al., 2022))以及相同数据但没有定位监督的LLM。 与随机采样点和提示SAM的基线相比,原始LLaVA-1.5取得了非凡的性能。 DiffLMM利用基于扩散的视觉特征增强了这种定位能力,甚至在掩码AR上超过了依赖于四个视觉编码器集合的Cambrian-1 (Tong et al., 2024a)。
| Model | Visual Backbone | PAcc | APS | APM | APL | AP | ARS | ARM | ARL | AR |
|---|---|---|---|---|---|---|---|---|---|---|
| Random Point | 10.53 | 0.0 | 0.2 | 0.8 | 0.3 | 0.1 | 1.2 | 10.1 | 3.8 | |
| — | — | — | — | — | — | — | — | — | — | |
| LLaVA-1.5 | CLIP (original) | 34.01 | 1.8 | 6.6 | 6.3 | 3.9 | 5.8 | 21.7 | 43.2 | 22.8 |
| ConvNeXt CLIP | 37.16 | 3.1 | 7.0 | 8.4 | 4.9 | 8.4 | 22.1 | 44.0 | 23.9 | |
| DINOv2 | 34.55 | 1.9 | 6.7 | 7.2 | 4.2 | 6.4 | 22.0 | 41.7 | 23.0 | |
| DiffLMM | SD-1.5 | 38.92 | 2.1 | 7.6 | 9.9 | 5.7 | 6.4 | 25.3 | 48.8 | 25.9 |
| (Ours) | SD-1.5 + CLIP | 40.22 | 1.6 | 7.9 | 9.6 | 5.6 | 6.3 | 25.5 | 47.3 | 26.0 |
| Cambrian-1 | Ensemble | 44.49 | 2.0 | 6.9 | 10.6 | 6.0 | 6.3 | 20.7 | 39.1 | 21.4 |
如表 1所示,原始LLaVA-1.5中的注意力图达到了34.01的非凡准确率,表明注意力图可用于细粒度定位。 将注意力图进一步细化为分割掩码,得到22.8 AR。 比较配备不同视觉编码器但使用相同数据训练的模型,我们的DiffLMM无论是否将扩散特征与CLIP特征连接,都实现了最佳的整体点精度和掩码AP/AR。 最近一种以视觉为中心的LLM,Cambrian-1 (Tong et al., 2024a),利用包括CLIP变体和DINOv2在内的四个视觉主干网络的集合,具有更高的点精度和掩码AP。 然而,由于训练数据不同,它生成的描述往往比LLaVA-1.5短,导致更多目标遗漏和更低的掩码AR。
4.2基于定位的对话生成
实例分割的初步研究表明,在没有显式定位监督的情况下训练的LLM已经隐式地获得了定位能力,这可以用来生成像素级别的分割掩码。 根据以上讨论,我们在一个更全面的基准测试——基于定位的对话生成 (GCG) (Rasheed et al., 2024)上检查了LLM的定位能力。 GCG的目标是理解图像中的视觉实体,并将它们组织成局部描述。 具体来说,GCG任务要求LLM为给定图像生成详细的标题,其中短语与其在图像中对应的分割掩码相关联。
由于GCG任务需要模型在标题生成和分割方面的能力,因此考虑了三种类型的指标:1)为了衡量标题质量,仅文本指标,METEOR (Banerjee & Lavie, 2005),将生成的标题与人工标注的参考标题进行比较。 2)为了评估分割掩码质量,仅掩码指标,平均交并比 (mIoU) 量化了真值掩码与其匹配的预测掩码之间的相似性。 3) 地面掩码召回率 (Rasheed 等人,2024) 是一个用于区域特定接地的_综合指标_,它同时考虑了掩码 IoU 以及预测与真实情况之间的文本相似性。 因此,在地面掩码召回率主要用于比较不同的模型。
在表 2 中,我们将我们学习 LMM 的方法(无需任何地面监督)与用于接地 LMM 的先前方法进行了比较 (赵等人,2023 年;彭等人,2024 年;赖等人,2024 年;Rasheed 等人,2024 年)。 即使没有地面监督,我们的 attend-and-segment 对于原始 LLaVA-1.5 (Liu 等人,2024a) 也获得了 42.7 的掩码召回率,这已经_高于所有之前的接地 LMM_。 作为一种通用方法,attend-and-segment 可以与最近的 LMM(如 LLaVA-NeXT (Li 等人,2024a) 和 Cambrian-1 (Tong 等人,2024a))结合使用,并受益于它们改进的视觉编码和视觉语言功能。 与基于 CLIP 的 LMM 相比,DiffLMM 提供了更好的局部视觉特征,并提高了接地能力。 当使用我们的 DiffLMM 作为 LMM 时,我们获得了最高的 44.2 测试召回率。 我们的方法实现了像素接地,但不会受到地面注释带来的监督偏差的影响,因此更好地保留了纯文本对话能力,如更高的 METEOR 分数所示。 附录 C 展示了 GCG 上更多的定性结果。
表 2: 基于接地的对话生成 (GCG) 结果。 即使没有地面监督,attend-and-segment (a&s 在表中) 也释放了 LLaVA-1.5 (Liu 等人,2024a) 中隐式学习的接地能力,在该任务上优于所有特定于接地的模型。 DiffLMM 进一步增强了接地能力,并带来了更强的接地性能。 更高的 METEOR 分数证明了我们更好地保留了对话能力。 作为一种通用方法,attend-and-segment 可以应用于不同的 LMM (Li 等人,2024a; Tong 等人,2024a)。 所有方法都通过纯文本指标 METEOR (M) (Banerjee & Lavie, 2005)、纯掩码指标 mIoU 和组合指标地面掩码召回率 (Rec) (Rasheed 等人,2024) 在 Grandf 数据集 (Rasheed 等人,2024) 上进行了评估。 基线结果来自 GLaMM (Rasheed 等人,2024)。
| Model | Grounding | Validation Set | Test Set |
|---|---|---|---|
| Supervision | M↑ | mIoU↑ | Rec↑ |
| — | — | — | — |
| BuboGPT (Zhao et al., 2023) | ✓ | 17.2 | 54.0 |
| Kosmos-2 (Peng et al., 2024) | 16.1 | 55.6 | 28.3 |
| LISA (Lai et al., 2024) | 13.0 | 62.0 | 36.3 |
| GLaMM (Rasheed et al., 2024) | 16.2 | 66.3 | 41.8 |
| LLaVA-1.5 + a&s (Ours) | ✗ | 18.6 | 58.0 |
| LLaVA-NeXT + a&s (Ours) | 15.6 | 64.5 | 45.6 |
| Cambrian-1 + a&s (Ours) | 14.6 | 59.8 | 42.0 |
| DiffLMM + a&s (Ours) | 18.4 | 61.2 | 46.6 |
4.3视觉问答
在增强 LLM 的接地能力时,我们不希望 LLM 失去其一般的视觉语言能力。为了评估这种一般能力,我们在广泛的视觉问答 (VQA) 基准上评估了 DiffLMM,包括 VQAv2 (Goyal 等人,2017)、GQA (Hudson & Manning, 2019)、Vizwiz (Gurari 等人,2018)、ScienceQA-IMG (Lu 等人,2022) 和 TextVQA (Singh 等人,2019)。我们还考虑了更全面的 LLM 基准,包括 POPE (Li 等人,2023b)、MMBench (Liu 等人,2024c) 和 LLaVA-Bench (Liu 等人,2023)。
值得注意的是,以前的接地 LLM(例如。,LISA (Lai 等人,2024),GLaMM (Rasheed 等人,2024))通常不会在这些通用 VQA 基准上进行评估。 例如,POPE 用于量化 LLM 中的对象幻觉,方法是询问诸如“ 图像中是否有 [对象]? ” 但查询的对象通常不存在。 但是,我们发现 GLaMM 几乎总是回答“ 当然,它是 [seg]。 ” 并提供错误的分割掩码(参见图 4 中的示例)。 这种回答一般问题的能力丧失是由于 监督偏差——这些 LLM 是针对接地任务进行微调的,它们忘记了如何在没有接地的前提下回答一般视觉问题。 因此,像 GLaMM 这样的接地 LLM 在这些基准上的得分非常低,我们选择与更强大的通用 LLM 进行比较,这些 LLM 不是针对 VQA 基准上的接地任务而设计的。
与相同规模的最先进 LLM(从 7B LLM 微调而来)相比,包括 InstructBLIP (Dai 等人,2023)、IDEFICS (HuggingFace, 2023)、Qwen-VL-Chat (Bai 等人,2023) 和 LLaVA-1.5 (Liu 等人,2024a),DiffLMM 在 3 个基准上排名第一,在 4 个基准上排名第二。 由于 DiffLMM 是在与 LLaVA-1.5 相同的数据上训练的,因此观察到类似的结果。 因此,我们基于扩散的 DiffLMM 改善了细粒度的视觉语言理解,这特别需要接地能力,同时保留了强大的通用视觉语言能力。
表 3: 视觉问答 (VQA) 结果。 我们在广泛的基准测试中评估和比较了相同规模的通用 LLM(所有都具有 7B 大小的 LLM),包括 VQAv2 (Goyal 等人,2017)、GQA (Hudson & Manning,2019)、Vizwiz (VW) (Gurari 等人,2018)、ScienceQA-IMG (SQA) (Lu 等人,2022)、TextVQA (TQA) (Singh 等人,2019)、POPE (Li 等人,2023b)、MMBench (MM-B) (Liu 等人,2024c) 和 LLaVA-Bench (LV-B) (Liu 等人,2023)。 不同于之前的模型,DiffLMM 基于扩散模型 (DM) 视觉编码器构建,它提供了更强的基础(表 1 和 2)并在一般任务中保留了视觉语言能力。 值得注意的是,GLaMM (Rasheed 等人,2024) 在这些通用的 VQA 任务中失败了。 对于每个基准测试,标记了前 1 个和 2 个最佳模型。 基线结果来自 LLaVA-1.5 (Liu 等人,2024a)。
| Model | Visual | VQAv2 | GQA | VW | SQA | TQA | POPE | MM-B | LV-B |
|---|---|---|---|---|---|---|---|---|---|
| InstructBLIP (Dai et al., 2023) | CLIP | - | 49.2 | 34.5 | 60.5 | 50.1 | 78.9 | 36.0 | 60.9 |
| IDEFICS (HuggingFace, 2023) | CLIP | 50.9 | 38.4 | 35.5 | - | 25.9 | - | 48.2 | - |
| Qwen-VL-Chat (Bai et al., 2023) | CLIP | 78.2 | 57.5 | 38.9 | 68.2 | 61.5 | - | 60.6 | - |
| LLaVA-1.5 (Liu et al., 2024a) | CLIP | 78.5 | 62.0 | 50.0 | 66.8 | 58.2 | 85.9 | 64.3 | 65.4 |
| DiffLMM (Ours) | DM | 78.3 | 62.1 | 48.1 | 69.3 | 57.2 | 85.7 | 66.2 | 63.7 |
4.4消融研究
在本节中,我们考察了 attend-and-segment 和 DiffLMM 中的设计。 我们在附录 B 中包含了对注意力图的进一步分析。
表 4: 关于 attend-and-segment 的消融研究。 跨整个序列对注意力图进行归一化消除了噪声模式并提高了基础。 使用单个点而不是低分辨率掩码来提示 SAM (Kirillov 等人,2023) 更有效。 我们的 attend-and-segment 结合了这两种技术。 结果基于在 GCG 任务 (Rasheed 等人,2024) 上评估 DiffLMM。
| Attn | SAM | GCG Val |
|---|---|---|
| Norm | Prompt | mIoU↑ |
| — | — | — |
| ✓ | Mask | 50.0 |
| ✗ | Point | 57.4 |
| ✓ | Point | 61.2 |
表 5: 关于DiffLMM的消融研究。 我们使用LLaVA-1.5 (Liu et al., 2024a)的数据预训练DiffLMM,并比较了包括CLIP (Radford et al., 2021)、DINOv2 (Oquab et al., 2024)和SD-1.5 (Rombach et al., 2022)在内的各种主干网络的收敛损失。 较低的损失表明更好的视觉-语言对齐。 位置编码 (PE) 和隐式字幕器 (IC) 都提高了DiffLMM的收敛速度。
| Model | Visual Backbone | PE | IC | Loss↓ |
|---|---|---|---|---|
| LLaVA-1.5 | CLIP | – | 2.027 | |
| DINOv2 | – | 2.403 | ||
| CLIP+DINOv2 | – | 2.088 | ||
| SD-1.5 | 2.384 | |||
| DiffLMM | SD-1.5 | ✓ | 2.338 | |
| (Ours) | SD-1.5 | ✓ | ✓ | 2.141 |
| SD-1.5+CLIP | ✓ | ✓ | 2.032 | |
我们的attend-and-segment方法对注意力图序列进行归一化处理(公式3),这显著减少了图中的噪声(图6)。 从注意力图中,我们选择注意力值最高的单个点来提示SAM,而不是提供整个图作为掩码提示。 根据经验,我们发现注意力图是稀疏的,倾向于关注对象内的一些关键点而不是整个对象,因此点提示更有效。 定量比较总结在表5中。
在DiffLMM(图3)中,我们采用了一些模块来增强视觉特征提取并促进与语言模型更好的对齐。 具体来说,我们1)向视觉特征添加可学习的_位置编码_ (Vaswani et al., 2017),以及2)使用_隐式字幕器_ (Xu et al., 2023)来模拟使用CLIP视觉特征的文本条件。 由于计算资源有限,我们无法使用LLaVA-1.5 (Liu et al., 2024a)的完整数据集重新训练模型,也无法像前几节那样进行彻底的评估。 相反,我们根据预训练阶段(Liu et al., 2023)的优化目标检查模块的影响,总结见表5。 简单地用DINOv2 (Oquab et al., 2024)替换CLIP (Radford et al., 2021)视觉编码器会导致损失显著增加,这意味着视觉-语言对齐效果更差。 多亏了文本到图像的训练,SD-1.5 (Rombach et al., 2022) 的损失较小。 位置编码将损失差距缩小了约13%,进一步添加隐式字幕器又将差距缩小了55%。
4.5定性结果
图4展示了DiffLMM + attend-and-segment在处理与训练数据不同的更具挑战性的视觉问题上的定性结果,并与GLaMM(Rasheed et al., 2024)进行了比较。 首先,当问题措辞不寻常时,GLaMM倾向于将这些问题解释为图像字幕或参考分割任务,而DiffLMM仍然能够遵循用户的指令并准确地回答问题。 同时,attend-and-segment提供了良好依据的答案,这些答案将文本短语和视觉实体联系起来。 此外,我们的方法显示出_对不熟悉的_问题类型、视觉概念和图像领域具有更好的泛化能力。
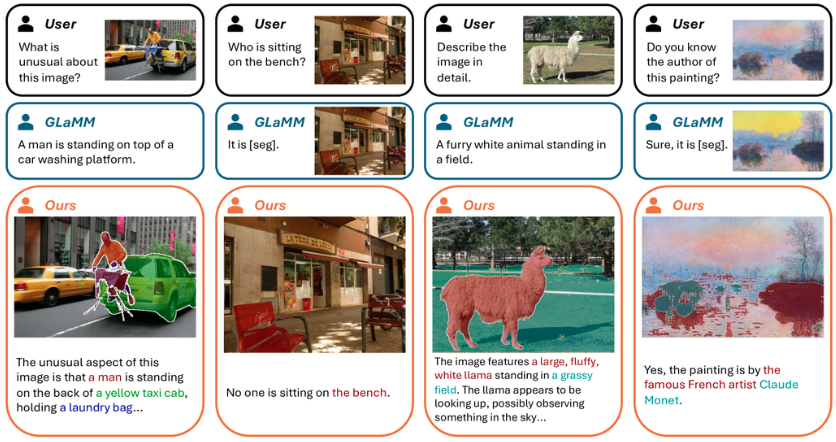
图4: 模型对具有挑战性的视觉问题的响应比较。 1) 不寻常的图像内容:要求模型分析给定图像中不寻常的方面。 与GLaMM相比,我们的方法提供了更详细、更准确且具有依据的答案。 2) 对抗性问题:询问模型图像中不存在的事物。 在此示例中,GLaMM坚持分割长凳后面的自行车。 3) 罕见的视觉概念:图像包含频率较低的类别对象。 在此示例中,GLaMM无法识别羊驼,而是以一般的方式进行描述,而我们的方法提供了更准确的描述。 4) 偏移的图像领域:向模型提供来自新领域的一幅图像。 有趣的是,我们的方法似乎是根据绘画中的纹理和风格做出决策的。 为了视觉清晰起见,如果我们的模型响应过长,我们只显示其开头部分。 这些具有挑战性的例子证明了_我们方法的更好泛化能力_。
5结论
在这项工作中,我们揭示了一个先前被忽视但至关重要的现象,即即使 LMM 是 没有 基于地面的监督进行训练的,它们也具有接地能力。 我们提出了一种 注意力-分割 方法将这种隐式接地能力转换为分割掩码,并引入了 DiffLMM 来进一步增强接地能力。 与监督方法相比,我们的方法更具可扩展性和泛化性。 此外,大量的评估结果表明,在接地特定的和通用视觉语言基准测试中,我们的方法表现出强大的性能,甚至在具有挑战性的接地对话生成任务中超越了使用大量监督训练的接地 LMM。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 357


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


