小数据,大突破!揭秘仅0.3B个token如何让8B模型逼近GPT-4,长文本开源新纪元

如何为业务场景选‘最接近GPT-3’的实用模型 大语言模型选型本质是工程化决策,而非单纯比拼参数或榜单分数。理解GPT-3的核心能力边界——如长上下文稳定性、指令遵循鲁棒性、商用API故障降级机制——是判断‘最接近’的前提。真正的技术价值在于将抽象能力映射到具体约束:成本预算、延迟SLA、中文支持强度、微调可行性与授权合规性。应用场景决定指标权重,教育平台重一致性,律所重事实准确,IoT设备重模型体积与离线能力。因此,‘最接近GPT-3’不是静态排名,而是基于多目标优化的动态解,涵盖闭源API、开源大模型、知识蒸馏小模型及RAG/Agent混合架构四类路 阅读详情

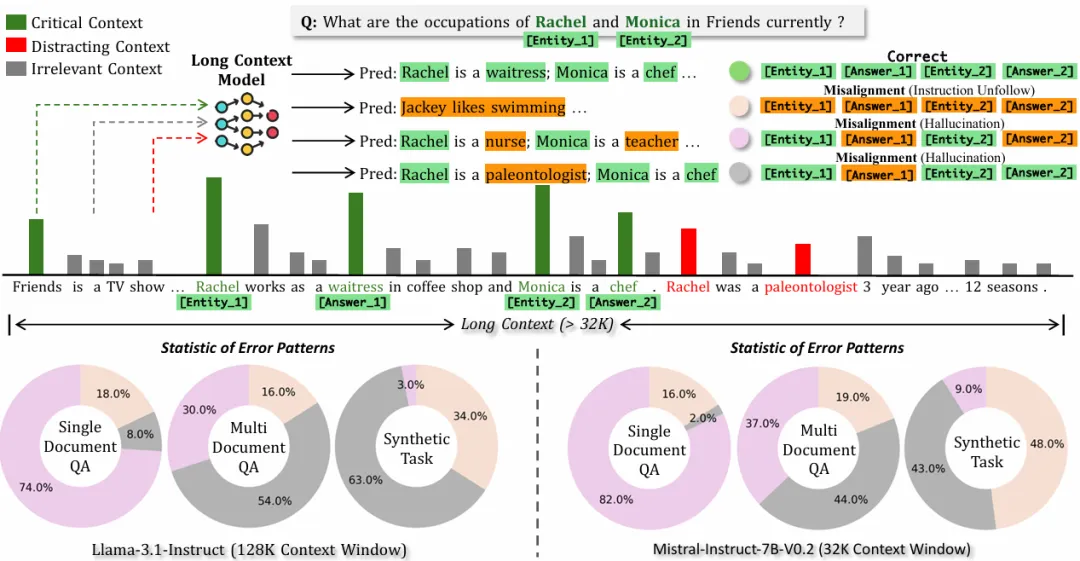
当前,越来越多的研究指出,长文本模型(Long-context Model, LCM)在输出时可能会遇到多种问题,其中最为突出的是幻觉(Hallucination)和指令不遵循(Instruction Unfollowing)现象。以下面的示例来说明:
在这里插入图片描述

图1:长文本模型幻觉(Hallucination)与指令跟随失效(Instruction Unfollowing)问题

首先,模型会接收到一段详细的背景信息,例如关于美剧《老友记》(Friends)的某个情节的描述。然后,可能会有用户提出这样的问题:“在《老友记》中,Rachel和Monica的职业分别是什么?”根据背景信息,正确的回答应该是Rachel是一名服务员(waitress),而Monica是一名厨师(chef)。然而,长文本模型有时会出现幻觉现象,错误地告诉你Rachel是一名护士(nurse),或者完全忽视问题,转而讲述一段毫不相关的内容,比如“Jackey喜欢游泳”(当然,这种情况出现的概率相对较低)。总的来说,幻觉现象是最常见的问题。

针对长文本模型所表现出的这些问题,可以借鉴先前的研究,将它们统称为长文本领域的不对齐/偏差现象(Misalignment Phenomenon)。近期,众多研究工作揭示了长文本领域中存在的Misalignment现象(LongHalQA[1], L-CiteEval[2])。

长上下文中的对齐与非对齐(Alignment & Misalignment)

在深入探讨长文本模型(Long-context Model, LCM)的非对齐或偏差现象之前,有必要先梳理一下目前的研究进展。

长文本模型为什么会出现偏差(Misalignment)?

一个较为底层且广泛接受的解释是,长文本模型中包含了检索头(Retrieval Head[3]),这些检索头专门负责根据输入的问题定位长上下文中的关键片段,然后模型可以根据这些关键片段进行回复。(本人也通过这篇论文受益匪浅)。长文本模型出现偏差无非只有两种原因:1)检索头没有定位到关键信息;2)检索头定位到关键信息,但是模型没法处理这些关键信息有效输出。

如何做长文本对齐?

很简单,训练是最好的方法。然而,遗憾的是,之前大多数长文本模型的研究都集中在如何更好地扩展模型的上下文窗口(Long Context Scaling),即让模型能够“看到”更多的信息。相比之下,关于如何在已有长上下文窗口的模型上获得更好的效果(Long Context Alignment),相关的研究工作却相对较少。这方面的研究主要集中在制作更高质量的“长文本指令数据”,例如Long Alpaca,或者通过LongLoRA、PoSE等高效微调方法来提升长文本模型的效果。

但问题在于,这些方法主要还是集中在监督式微调(Supervised Fine-Tuning, SFT)阶段。众所周知,针对非对齐问题,SFT可能只能做到“哪里不足补哪里”,其收益相对有限。最终,可能还是需要借助强化学习(Reinforcement Learning)这一大杀器来有效地对齐模型,这一点在下面的实践中也会进行详细阐述。

一种基于强化学习的长上下文对齐策略:LOGO

最近,我们在长文本处理领域尝试了一种新的强化学习对齐策略,名为LOGO(Long cOntext aliGnment via efficient preference Optimization)。

Arxiv & Project 传送门(Code还在整理,近期在开发和贡献OpenRLHF[4]库,应该大概率集成或者继承OpenRLHF库之后再Release,月底之前会release出一版本code):

论文:https://arxiv.org/abs/2410.18533
项目:https://github.com/ZetangForward/LCM_Stack

基于偏好对齐的长文本对齐效果展示

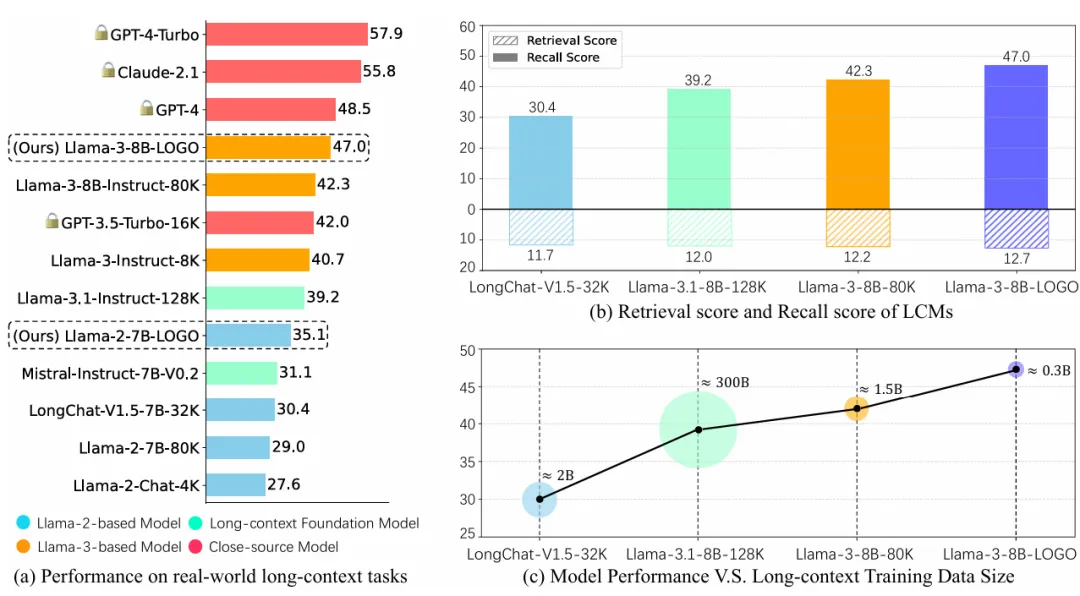
在介绍LOGO方法之前,我们先展示一个preview:该策略仅需在0.3B个token上进行训练,就能够显著提升Llama-3-8B-Instruct模型在长文本实际任务中的表现(这里我们选取的是LongBench数据集),甚至逼近GPT-4这种强闭源模型。

通过图2,我们还能发现一个问题:图(b)中模型的Retrieval Score都大差不差,说明这些模型都能很好的定位长上下文中的关键信息,但是输出结果(Recall Score)确大相径庭。这也和上面的猜想联系起来了:长文本模型可以定位关键信息,但是没法很好的处理结果,换句话说,不知道什么样的结果是对的,什么样的结果是错的。
在这里插入图片描述

图2:LOGO方法效果展示(Preview)

如何在长上下文场景下做基于强化学习的对齐?

在长上下文场景下,采用强化学习进行训练(题主这里采用的是偏好对齐,DPO[5])需要考虑两个问题:

  1. 训练的可行性?长文本模型通常需要较大的显存和计算资源。传统的直接偏好优化(Direct Preference Optimization, DPO)需要在GPU中同时存储参考模型(Reference Model)和策略模型(Policy Model)。对于参数量庞大且词汇表庞大的模型(训过的应该知道,词表越大,越会有一个GPU Comsumption Peak),这可能导致显存消耗达到峰值,使得训练变得困难。需要开发或优化训练库以适应长上下文模型的训练需求,这可能涉及大工程量(文末会安利一个训练框架~)。

  2. 数据哪里来?在长文本领域,通常缺乏专门标注了对齐/非对齐的数据对。如果需要自己构造这样的数据,长文本模型生成结果的评测可能难以依赖于人工或强模型(如GPT-4),因为这既耗费资金,又存在标注难度。巧妇难为无米之炊,缺少数据自然也就很难在长文本上做偏好对齐了。

LOGO分别从建模目标(Training Objective),长偏好数据构建(Long-Dependency Preference Data Construction) 以及 高效训练(Efficient Training)三个方面介绍了长文本场景下的强化学习训练方法(下面的内容和原文的讲述思路不太一样,但是内容是一样的)。

1. Training Objective

在长上下文场景下,基于强化学习的对齐策略面临着显存和训练数据的双重挑战。近期很多工作表明,直接使用DPO会出现严重的Reward Hacking和生成能力退化的现象,为了解决这个问题,他们在DPO公式的基础上加了很多约束项,这样不仅让DPO变得更加难以训练和优化,在长文本场景下,也加剧了训练部署的困难。我们主要参考了一个Reference-Free且对生成模型友好的训练目标函数:SimPO[6]。SimPO的目标函数可以写成:

其中 是策略模型(待优化的模型), (奖励差异的缩放因子)和 (目标奖励边际)是用来区分偏好和非偏好响应的超参数。

考虑到偏好数据构建的困难,LOGO采取了一种折中策略,即不特定标注错误类别,而是将所有错误都视为负样本。这样,通过扩大负样本空间,一方面避免了标注的困难,另一方面可能使模型更好地学习。因此,LOGO的目标函数可以写为:

这里 是一个偏好数据中的负样本数目,即一条训练数据中包含一条正样本和个负样本。最后,考虑到Reward Hacking和生成能力退化的问题,我们加了一个SFT的正则项(通过 去控制相对强度)优化目标函数:

2. Long-Dependency Preference Data Construction

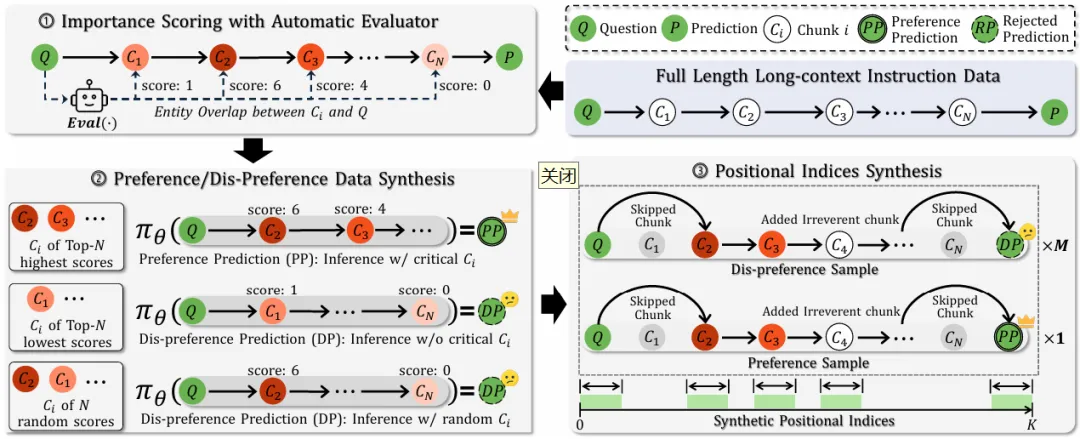
有了上述的建模目标,构建对应的偏好数据则方便和简单许多,因为我们压根不需要考虑特定的错误类型(题外话:让模型生成错误答案还是非常简单的)。具体可以参考下面这个示意图:
在这里插入图片描述

图3:长文本训练偏好对的构建

简单来说分为三个步骤:

  • 关键片段打分:对长上下文进行片段(Chunk)的划分,然后通过实体抽取模型(NER)抽取出每个片段中和问题相关的实体,如果实体越多,说明这个片段对最终答案的贡献越大

  • 引导模型生成偏好数据:通过组合不同分数的片段作为上下文(context),引导模型生成偏好数据。例如,可以利用贡献大的片段引导模型生成正确的结果,然后利用一部分贡献大+一部分贡献小的片段引导模型生成“可能出现幻觉的结果”,用完全没有贡献的片段引导模型生成不遵循指令的结果。**这样做有两个优点:**1)每个片段的长度都不长,实际切分下来每个片段只有1024个tokens,组合8个片段也在Llama3-8B 8K的上下文范围内,便于构造数据;2) 片段长度不长,降低了对最后结果判断正确与否的难度,可以利用GPT4等高级模型进行评测。

  • 位置编码合成:这是一个在长文本领域(可能比较冷门)但是很实用的Trick(苏神、Weifuru、Fuyao等大佬都有相关的工作,可以去搜一搜)。简单来说就是通过调整位置编码来影响Transformer-based模型对序列长度的感知。

  • 正常来说,一段文本都是从0开始标位置,一直标到N-1 : (N是序列长度)。

  • 如果现在标的是 ,通过跳过一些位置编号,模型会认为序列长度是(远远大于 ),从而实现对“无限长”数据的构建。

  • 虽然方便构建,但是会出现中间缺失的片段信息。所以,原文中采用了混合位置编码合成的方式,在长度扩充的同时,尽可能保证每个Batch中所有的位置全部覆盖,细节可以参考原文的Appendix D。

3. Efficient Training

最后就是如何部署高效的训练了。一方面,通过上述的Reference-Free 训练目标函数和位置编码合成的策略可以大大减少所需的GPU显存大小,LOGO采用了LoRA(Low-Rank Adaptation)训练方法,这是一种参数高效的微调技术,它通过在预训练模型的权重上添加低秩矩阵来实现微调,而不是直接修改原始权重。在叠满这些buff之后,所有的训练仅仅在一台A800的机器上完成,且在16小时的训练时间之内,就可以让Llama-3-8B-Instruct在长文本任务上的性能得到提升和改善。

最终的训练结果 & 一些消融实验带来的 Insight

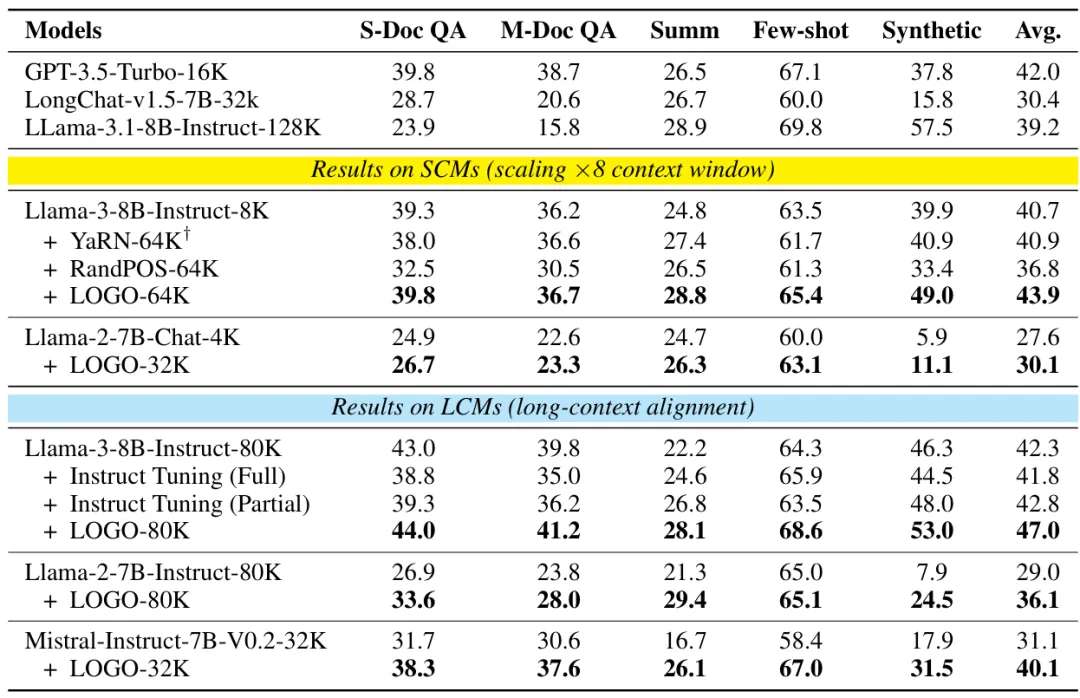
真实任务上的效果 这里我们采用了LongBench
在这里插入图片描述

图4:LOGO在长文本模型(Long Context Model, LCM)和短文本模型(Short Context Model, SCM)上的效果

合成任务上的效果,测试LOGO的长文本窗口扩充的能力
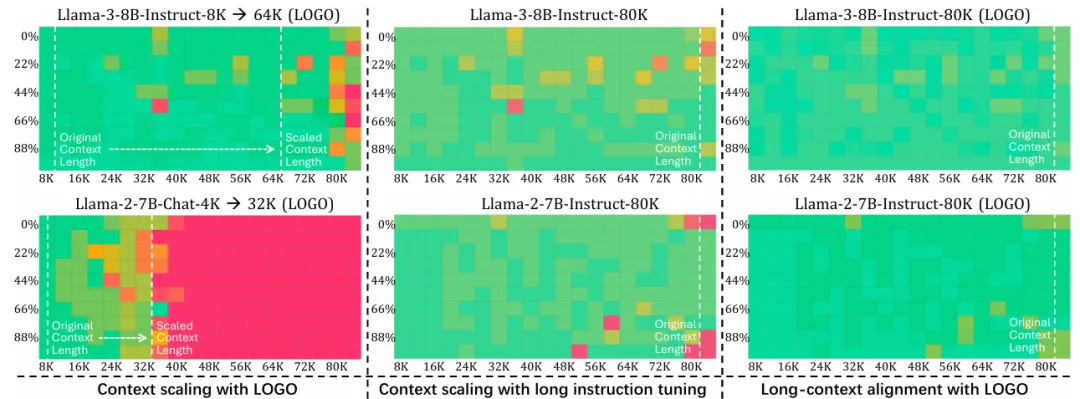
在这里插入图片描述

图5:LOGO在大海捞针(NIAH)上的效果,看出来不仅可以让SCM获得长文本能力,原来LCM做不好的位置也能做对了

短文本任务上的效果,这里我们挑选了MMLU、TruthfulQA、ARC三个常用的测试集,分别覆盖了多种语言任务、事实核查和多项选择问答等不同的挑战。我们发现,如果全量训练模型(下面中间图红色的箭头),长文本模型可能会在长文本任务上取得不错的性能,但这种训练方式往往会导致模型在短文本任务上的能力下降。这种现象可以被看作是“对齐税”。LOGO通过使用LoRA训练方法,有效地避免了全量训练可能带来的问题,所以所以原始的能力非但没有丢失,还小涨了一点。
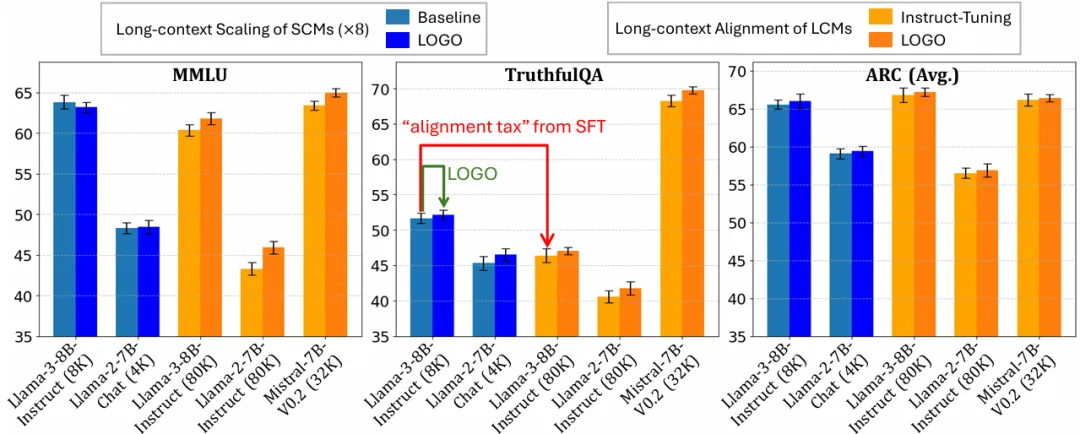
在这里插入图片描述

图6:LOGO在短文本任务上的效果

(部分)分析实验:不同长文本对齐算法之间的比较。我们比较了两种标准的SFT策略:一种是在整个序列上施加交叉熵(CE)损失,另一种是仅在最终预测上施加CE损失。实验结果显示,这两种方法都会导致模型性能达到一个瓶颈。一方面,这可能是由于训练数据的质量所限;另一方面,CE损失仅推动模型输出接近真实标签,但并未教会模型如何避免错误答案。反观LOGO,可以当模型获得一个持续增长的效果,同时,我们还通过检索头计算了Retrieval Score,越大的Retrieval Score表明模型可以定位到更多的重要信息。这表明,LOGO甚至还激活了检索头的能力。
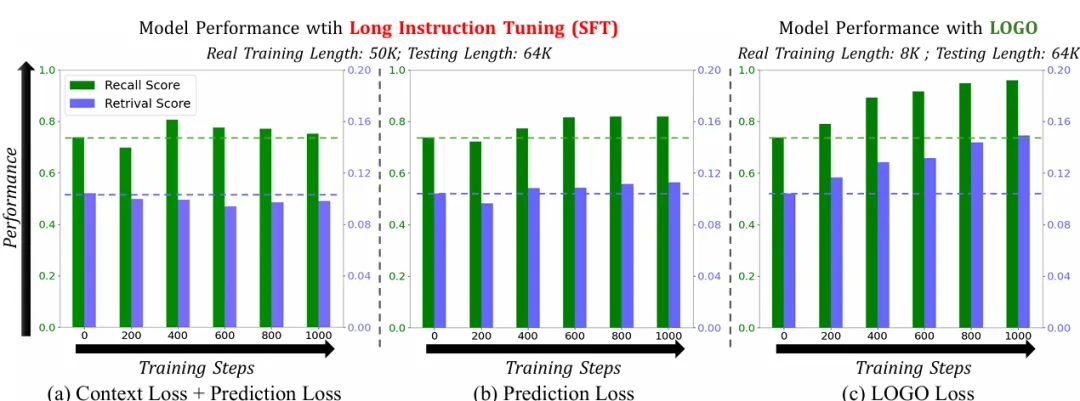
在这里插入图片描述

图7:不同长文本对齐算法之间的比较

结语

随着人工智能技术的不断进步,长文本模型在理解和生成自然语言方面展现出了巨大的潜力。然而,这些模型在处理长文本时常常会遇到幻觉和指令不遵循等问题,这些问题限制了它们在实际应用中的有效性。

在探索长文本对齐的征途上,位置编码的激活(窗口扩充技术)已经被很好的解决。同时,我们已见证令人振奋的进展,如o1-preview模型的问世,它们在长推理链和真实使用场景中展现出了卓越的性能。然而,这一领域的研究与应用仍然面临着诸多挑战和未知,随着模型推理能力越发被重视,未来的研究可能会集中在如何进一步提升这些模型的推理能力和效率,以及如何将它们更好地集成到实际应用中等。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

GPT-4稀疏激活原理:2%参数如何驱动万亿模型高效推理 大语言模型的‘参数量’常被误读为算力消耗的直接指标,但现代万亿级模型如GPT-4已普遍采用稀疏激活机制——即每次推理仅动态调用约2%的总参数。其底层依托稀疏门控混合专家(MoE)架构,通过轻量路由器(Router)按token语义实时选择Top-K专家,实现计算密度、显存效率与任务专业性的三重优化。这种条件计算范式不仅突破稠密模型的显存墙、计算墙与训练墙,更重塑了API成本结构、提示工程逻辑与私有化部署策略。对开发者而言,理解‘2%’的本质,即是掌握在延迟、精度与开销之间做工程权衡的关键支点。 阅读详情

相关推荐

GPT-4稀疏激活原理:MoE架构中2%参数如何实现高效推理

混合专家(MoE)是一种通过结构化稀疏提升模型容量同时控制计算开销的关键技术,其核心在于路由(Router)机制与top-k选择原理。不同于密集模型的全参数参与,MoE在每次前向传播中仅激活少量专家子网络,显著降低FLOPs与显存占用,但需权衡表达能力、通信开销与负载均衡。该技术已广泛应用于GPT-4等超大规模语言模型,支撑其1.8万亿参数下的毫秒级响应。实际工程中,‘2%每token’并非随机采样,而是由确定性top-k路由驱动,并依赖温度调节、负载均衡损失和专家分片等关键技术保障稳定性与可扩展性。本文深

weixin_30564785的博客 354

为应对输出风险文本的情况,提出一种针对LLMs简单有效的思维链解毒方法

作者:汤泽成、周柯言单位:苏州大学人工智能研究院论文标题:[2308.08295] Detoxify Language Model Step-by-Step (arxiv.org)论文代码:https://github.com/codinnlg/detox-cot研究背景近年来,随着大语言模型(Large Language Model, LLM)在自然语言处理任务上展现出优秀表现,大模型的安全问题...

zenRRan的博客 324

大模型底层原理:从词嵌入到自注意力的数学本质

语言模型的核心是将离散文本转化为连续向量空间中的概率建模。其基础在于词嵌入(Word Embedding)实现语义稠密表示,位置编码(Positional Encoding)注入序列顺序信息,而自注意力机制则通过QKV计算与缩放点积,在高维空间中动态建模任意两词间的条件依赖关系。这种基于统计规律的概率预测范式,决定了模型既具备强大泛化能力,也存在幻觉、上下文窗口受限等固有边界。理解这些数学构件,是掌握大模型训练逻辑、推理行为与工程调优的前提。

weixin_33670713的博客 495

GPT-4的1.8万亿参数与2%稀疏激活真相解析

大语言模型中的稀疏激活(Sparse Activation)是突破算力瓶颈的关键技术路径,其核心原理在于解耦模型的知识容量与实时计算负载。通过专家混合(MoE)架构,系统可在超大规模参数空间(如万亿级)中动态路由至少量活跃专家,实现按需计算,显著降低显存带宽压力与推理延迟。该技术不仅支撑了GPT-4等顶尖模型的高并发、低延迟服务,更在推荐系统、多任务学习和边缘AI部署中展现出工程普适性。本文聚焦MoE架构下的稀疏性本质、动态路由机制与真实激活比例验证方法,结合参数规模、负载均衡、硬件约束等维度,还原‘1.8

weixin_30387423的博客 410

N-Gram、词向量与Transformer:语言模型演进的三层本质

语言模型的本质是建模词序列的条件概率,其发展始终围绕三大核心约束展开:计算可行性、语义表征能力与长程上下文建模。N-Gram通过滑动窗口近似解决组合爆炸问题,以极低延迟支撑拼写纠错与输入法预测;词向量(Embedding)则将离散符号映射为稠密语义空间,使‘国王-男人+女人≈女王’成为可计算关系,显著提升语义相似度与类比推理能力;而Transformer借助Self-Attention机制实现全局并行的关系建模,突破RNN的时序枷锁,成为大模型可训练、可扩展的工程基石。从统计查表到向量运算,再到动态注意力,

chouchijiao8952的博客 475

大模型记忆系统与多模态协同工作流实战指南

大模型已从单纯的语言生成工具,演进为具备长期记忆、跨模态理解与个性化行为调控的智能协作体。其核心原理在于向量数据库驱动的分层记忆架构、文本-图像联合嵌入空间的重参数化,以及基于用户画像的动态响应调控机制。这类技术显著提升了AI在教育、法律、营销等垂直场景中的任务完成度与用户留存率,尤其支撑起‘对话即工作流’的新范式——如自动关联历史文案生成品牌视觉图。本文聚焦可落地的记忆管理、图像生成自动化与LoRA微调三大实操路径,帮助产品经理与工程师绕过概念炒作,直击GPT-4o及GPT-Image 2真实技术内核。

aikenqiu5098的博客 373

GPT-4万亿参数与2%稀疏激活的工程真相

大语言模型中的稀疏激活并非简单减少参数使用,而是专家混合(MoE)架构下基于token动态路由的计算资源调度机制。其核心原理在于:通过轻量级路由网络为每个输入token实时选择Top-K专家子网络,实现参数高效复用与知识专业化分工。这种设计在保持模型容量(如1.8万亿参数)的同时,显著优化FLOPs分配和显存带宽利用率,技术价值体现在高知识广度、低推理冗余与硬件友好性上。典型应用场景包括多领域长文本生成、跨模态指令理解及低延迟API服务。本文聚焦GPT-4所采用的2%稀疏激活现象,深入解析其背后MoE架构、

weixin_30684743的博客 348

2020计算机视觉十大论文:从DETR到CLIP的技术落地路线图

计算机视觉(CV)作为人工智能核心分支,其技术演进正从追求精度极限转向关注工程落地效能。自监督学习、Transformer架构、鲁棒数据增强和跨模态表征等基础范式,正在重塑模型设计逻辑——不再依赖海量标注,而强调低样本适应性、边缘部署友好性与分布漂移鲁棒性。DETR以端到端集合预测重构目标检测流程,ViT通过全局注意力突破CNN感受野局限,SimCLR推动无监督预训练走向工业可用,AugMix与CLIP则分别在数据扰动应对和零样本迁移上提供可复用方案。这些技术共同指向一个趋势:CV已进入‘系统收敛’阶段,算

weixin_30328063的博客 422

GPT-4的1.8万亿参数与2%稀疏激活真相:MoE架构的工程本质

大模型中的MoE(Mixture of Experts)是一种通过专家路由实现计算稀疏性的关键技术,其核心原理是将海量参数分拆为多个子网络,在单次前向传播中仅激活其中一小部分(如Top-2),从而在不显著增加FLOPs的前提下扩展模型容量。这种设计并非降低显存占用,而是缓解算力瓶颈与数据搬运压力,技术价值体现在高吞吐、低延迟推理能力上。典型应用场景包括千卡级私有化部署、金融/客服等高并发LLM服务,以及需平衡性能与功耗的大规模推理平台。理解‘2%’的真实含义——即计算路径稀疏性而非存储稀疏性——是避免部署失

weixin_30736301的博客 496

SoIC、CoWoS、InFO一次讲透:从2D/2.5D/3D看懂先进封装

先进封装是后摩尔时代提升芯片性能的关键路径,但面对SoIC、CoWoS、InFO这些名词,很多人容易混淆。理解它们,需从最基本的2D、2.5D、3D封装概念入手:2D是传统平房,2.5D通过硅中介层实现高密度互连,3D则让芯片直接堆叠。CoWoS作为2.5D中介层封装,已成为AI芯片与HBM高带宽存储集成的行业标准;SoIC通过铜-铜混合键合实现真正的3D堆叠,为逻辑与缓存提供极致带宽;InFO以扇出型封装兼顾成本与集成度,广泛用于移动SoC。在系统级封装(SiP)和CPO共封装光学等前沿趋势中,这些技术往

weixin_42388898的博客 309

解决mamba_ssm库安装难题:两种高效方法详解

本文详细解析了mamba_ssm库安装失败的常见原因,并提供了两种高效的解决方案。针对其依赖C++/CUDA扩展编译的特性,文章手把手指导用户通过GitHub克隆源码编译安装,或寻找匹配的预编译Wheel文件直接安装,帮助开发者彻底解决环境配置难题,顺利部署Mamba模型。

weixin_29056865的博客 553

2小时用RTX 3060本地训练GPT:开源+Gemini显存优化实战

大语言模型训练长期受限于GPU显存瓶颈,其本质是参数、梯度与激活值在有限显存空间内的资源争抢问题。基于ZeRO与动态内存调度的Gemini技术,通过CPU-GPU协同卸载与张量生命周期预测,显著降低PCIe搬运开销,使消费级显卡具备训练1.3B级GPT模型的工程可行性。该方案依托PyTorch生态与开源框架Colossal-AI,以极简API封装分布式复杂性,支持指令微调、领域知识注入与本地化部署,广泛适用于客服、医疗、教育等垂直场景的轻量专属模型构建。GPT训练与开源工具链的深度结合,正推动大模型从云中心

chiman6219的博客 419

数学建模 种群竞争模型 学习笔记

模型背景 应用场景 种群竞争模型 例如 s1=0.5,则表示对于供养甲的资源来讲,单位数量的乙的消耗为单位数量的甲的0.5倍,即表示乙对于该资源的占有能力是甲的0.5倍(即竞争力弱) 仿真结果及分析 (1)设置自然增长率 r1=r2=1 (2)改变自然增长率 r1=r2=0.3 (3)修改甲和乙的最大容量 n1=10000, n2=100 (4)修改甲和乙的初始数量 x1=10, x...

Test_tju的博客 2028

Zephyr-7B实操指南:DPO微调、Mistral架构与推理优化全解析

Zephyr-7B是基于Mistral-7B架构的轻量级指令微调模型,其核心价值在于将Direct Preference Optimization(DPO)训练范式与滑动窗口注意力、分组查询注意力(GQA)等高效架构特性深度融合,在7B参数规模下实现接近GPT-3.5的指令遵循能力。相比传统RLHF流程,DPO显著提升训练稳定性与资源效率,降低中小团队落地门槛;而Mistral基座带来的长上下文支持与显存友好性,使其在消费级GPU(如T4、4090)上即可完成端到端部署与LoRA微调。本文聚焦工程实践,覆盖

weixin_30509393的博客 347

上下双相机定位贴合(原理到应用,halcon源码详解)

上下双相机定位贴合(原理到应用,halcon源码详解) 一、简介(类型与之前的文章)看你们理解那个文章快 主要讲解上下双相机定位贴合的原理和实现过程,包括各种标定、组合使用及具体的halcon源码实现,适用于的X、Y、Z三轴加一旋转轴系统,如模组组成的多轴系统、Scara四轴机器、六轴机器人(在运行过程中保证几个自由度不动,运行即可) 二、标定介绍 这一小节总结了通用的相机和轴的相对位置模型,并对其标定进行详细讲解 本系统仅使用了九点标定,精度可做到0.05mm 九点标定作用: A、本质就是仿射变换,一个坐

苏州程序大白的博客 9972

华为OD机试双机位C卷 - 高矮个子排队 (C++/Py/Java/Js/Go/C)

华为OD机试双机位C卷 高矮个子排队,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解。华为OD机试 - 高矮个子排队。

qq_45776114的博客 2158

GPT-4稀疏激活真相:MoE架构、2%参数使用率与工程落地陷阱

大语言模型的稀疏激活(Sparse Activation)是突破千亿参数规模瓶颈的核心技术路径,其原理源于条件计算范式——通过门控路由(Router)动态选择子网络(Expert),实现按需计算。该机制显著降低前向传播的FLOPs和显存带宽压力,但不减少静态显存占用;技术价值体现在推理延迟优化、能效提升与硬件利用率改善,广泛应用于GPT-4、Mixtral、Qwen2-MoE等主流模型。实际部署中需区分专家粒度稀疏度(如16选2≈12.5%)与参数级激活率(受专家内剪枝、量化、动态top-k等多层压缩影响)

weixin_30764771的博客 465

【GEE数据库】WRF常用数据集总结

【GEE数据库】WRF常用数据集总结

WW、forever的博客 633

51c深度学习~合集8

方法的完整数学描述略显复杂,如果只是想了解主要思想,可以只看上面 PatchMix的流程图即可(其实只是公式多,每个公式也不复杂,后续有机会做个演示动画,帮助大家理解。这个方法也可以用简单的 Mask 方法实现,但是本方法在大规模图像处理上效率是最高的),对该工作感兴趣的同行可以看一下,我尽量写得清楚一些。结合 PatMix 的流程图,主要过程如下:由于混合图像和混合图像之间,重叠比例的不同,mix-to-mix label 中每一项的权重分数是不同的,根据上图,可以得到权重系数可以表示为。

whaosoft~aiotの开发板商城 2955

自定义View系列教程04--Draw源码分析及其实践

通过之前的详细分析,我们知道:在measure中测量了View的大小,在layout阶段确定了View的位置。 完成这两步之后就进入到了我们相对熟悉的draw阶段,在该阶段真正地开始对视图进行绘制。按照之前的惯例,我们来瞅瞅View中draw( )的源码 public void draw(Canvas canvas) { final int privateFlags = mPriv

谷哥的小弟 2万+

解决anaconda占用C盘空间过多问题

anaconda就算安装在其他盘,默认会把索引、锁定文件、压缩包等都放到系统盘(C盘),我用了两年,占用30GB。 1. 卸载不用的虚拟环境 查看已安装的虚拟环境 conda env list 卸载不用的、过期的虚拟环境 conda remove -n (要卸载的环境的名字) --all 2. 删除索引缓存、锁定文件、未使用过的包和tar包 conda clean -a 清理完之后,删除了15GB,还剩15GB,舒服了 ...

沉迷单车的追风少年 3万+

【AIGC面试面经第10期】深度学习基础模型训练篇

注:以下内容摘自社区共建开源项目AIGC时代算法工程师面试秘籍【三年面试五年模拟】完整学习请关注:https://github.com/WeThinkIn/AIGC-Interview-Book本章围绕深度学习模型训练体系,系统梳理 AIGC 算法工程师面试中的高频经典问题,按“数据—正则化—优化—训练实操—稳定性—进阶范式—评估”的完整链路展开。内容从数据标注、噪声标签、数据增强、清洗与长尾处理切入,讲清 L1/L2、Dropout、早停、标签平滑、权重衰减与 AdamW 解耦等正则手段;剖析学习率衰减与

677

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Large World Models:统一时空表征的AI新范式

世界模型(World Model)是AI从静态感知迈向动态理解的关键跃迁,其核心在于构建跨模态、带有时空坐标的统一隐空间表征,而非简单拼接图像与文本。它融合视觉、语言、音频等多源信号,在共享语义坐标系中实现对‘正在发生什么’的联合建模与因果推理。相比传统多模态模型,LWM通过时空联合编码、分层注意力与时序对齐损失,显著提升长上下文下的事件定位精度与跨模态对齐能力。该技术已落地于工业质检、会议纪要生成、手术记录辅助等强时空耦合场景,成为处理视频-语音-传感器融合数据的工程新基座。

a1311010193的博客 376

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

上一篇: 超越传统:GNN和Transformer结合的创新突破!
下一篇: 数字孪生与AI大模型的融合基础:技术、数据与算法的协同
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值