超越传统:GNN和Transformer结合的创新突破!

GNN与Transformer创新结合!模型性能起飞! 近年来,图神经网络(GNN)和Transformer模型因其在处理复杂数据结构和序列依赖性方面的卓越表现而受到广泛关注。这种优势使得将GNN与Transformer结合成为图表示学习领域的一个新兴且充满潜力的研究方向。通过结合这两种模型,我们不仅能够扩大模型的感受野,捕捉更复杂的图结构信息,还能强化信息传递机制,从而提高推荐系统的准确性。此外,这种结合还能简化模型结构,降低计算成本,并提升训练效率。 阅读详情
AI摘要

本文聚焦GNN与Transformer结合的研究方向,分享23种创新方案,详解3篇相关论文的方法与创新点。还给出大模型AI学习的四个阶段,包括初阶应用、高阶应用、模型训练和商业闭环,并提供免费学习资料,助读者了解领域进展与掌握学习路径。

近年来,图神经网络(GNN)和Transformer模型因其在处理复杂数据结构和序列依赖性方面的卓越表现而受到广泛关注。这种优势使得将GNN与Transformer结合成为图表示学习领域的一个新兴且充满潜力的研究方向。

通过结合这两种模型,我们不仅能够扩大模型的感受野,捕捉更复杂的图结构信息,还能强化信息传递机制,从而提高推荐系统的准确性。此外,这种结合还能简化模型结构,降低计算成本,并提升训练效率。

本文精心挑选了过去两年中顶级会议和期刊上发表的23种最新的GNN与Transformer结合的创新方案,与您分享。我们不仅总结了每种方法的核心思想和创新点,还整理了相关的模型和代码,供您学习和参考。这些资源将帮助您深入了解这一领域的最新进展,并启发您在图表示学习领域的研究和实践。

三篇论文详解

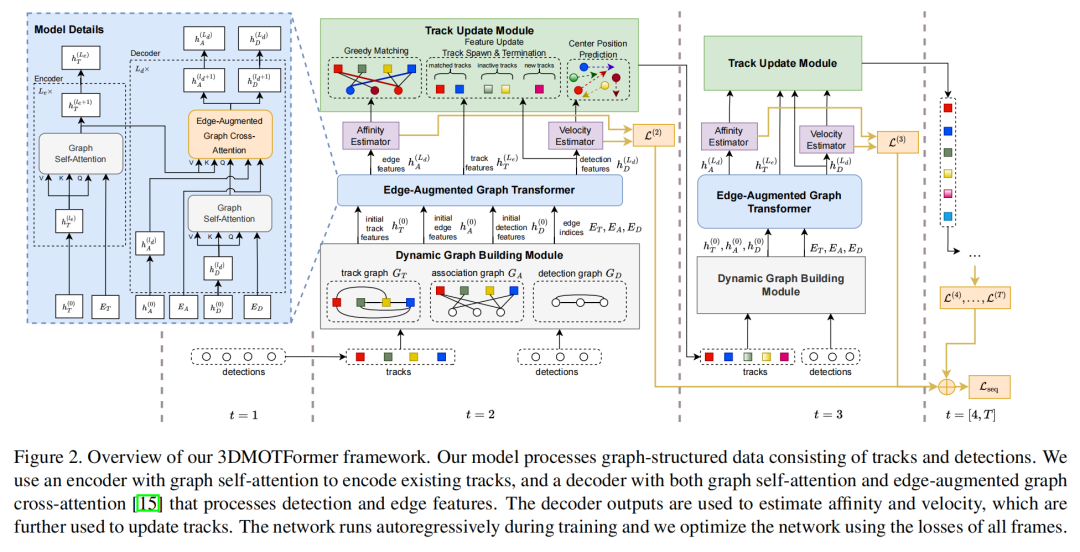
1、3DMOTFormer: Graph Transformer for Online 3D Multi-Object Tracking

方法

3DMOTFormer 是一种基于图变换器(Graph Transformer)的在线3D多目标跟踪(MOT)框架。该方法主要包含以下几个关键步骤:

  • 图表示:使用图结构表示多目标跟踪问题,其中检测到的目标和已有的轨迹分别作为图中的节点。构建了三种图:检测图(用于更新检测特征)、轨迹图(用于模拟轨迹间的交互)和关联图(用于关联检测和轨迹)。

  • 图变换器编码器:通过自注意力机制更新轨迹节点特征,模拟轨迹之间的关系。

  • 边增强图变换器解码器:结合自注意力机制和跨注意力机制,处理新的检测并预测边特征,用于关联计算。

  • 关联估计:使用解码器的最后一层输出的边特征,通过一个多层感知器(MLP)估计检测和轨迹之间的关联概率。

  • 速度估计:使用检测特征通过MLP回归速度,用于预测下一帧中轨迹的位置。

  • 损失函数:使用焦点损失(Focal Loss)作为关联损失和平滑L1损失作为速度损失。

  • 全在线训练策略:模型在训练时以自回归的方式运行,使用累积的损失通过整个训练序列进行优化,模拟在线推理阶段的操作模式和数据分布。

创新点

3DMOTFormer的主要创新点包括:

  • 基于图的跟踪框架:提出了一种新颖的基于图的3D MOT框架,使用变换器架构来处理关联问题。

  • 边增强图变换器:引入了边增强图变换器,它是一种变体的变换器,可以处理稀疏图并考虑边特征进行注意力计算。

  • 全在线训练策略:提出了一种新的全在线训练策略,包括自回归前向传播和顺序批量优化,以减少训练和推理之间的分布不匹配。

  • 状态艺术性能:在nuScenes验证和测试集上实现了71.2%和68.2%的AMOTA,达到了几何基础方法中的最先进性能。

  • 良好的泛化能力:训练的3DMOTFormer模型在不同的目标检测器上具有良好的泛化能力,可以灵活地部署相同的3DMOTFormer模型,而与目标检测器无关。

  • 高效的实时性能:模型能够以54.7Hz的速率在Nvidia GeForce 2080Ti GPU上运行,适合实时应用,如自动驾驶汽车。

  • 简化的跟踪更新操作:与需要复杂启发式算法解码网络输出的方法相比,3DMOTFormer使用动态二分图,需要更简单的跟踪更新操作来解码网络输出。

  • 软关联特性:利用变换器的软关联特性,即使在二分图表示中有限的时间感受野内,也能够隐式地从过去帧中获取信息。
2、ARE MORE LAYERS BENEFICIAL TO GRAPH TRANSFORMERS?

方法

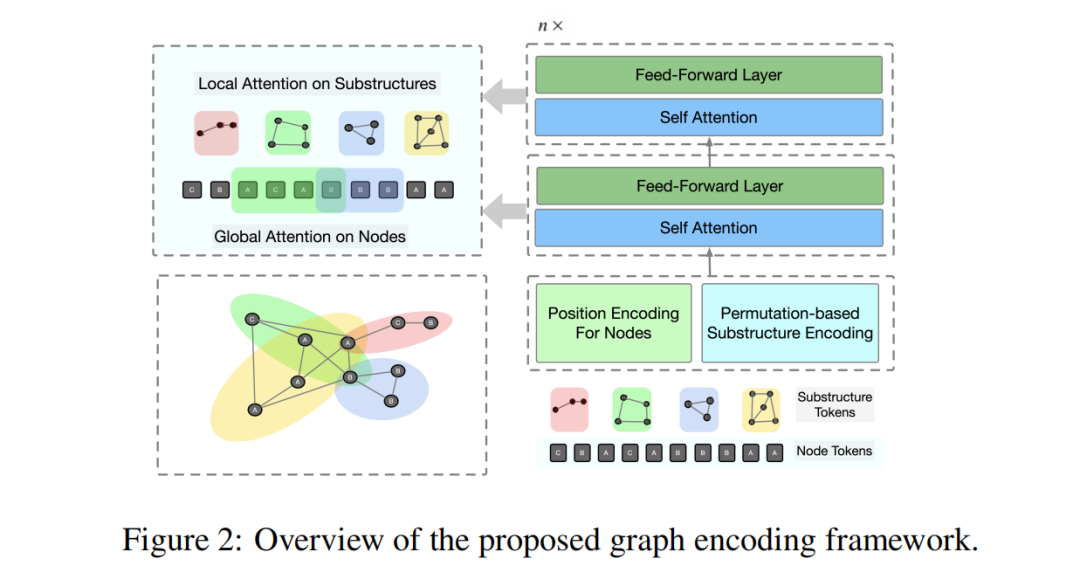
该论文研究了增加深度(层数)对图变换器(Graph Transformers)性能的影响,并提出了一个新的图变换器模型DeepGraph。主要方法包括:

  • 全局注意力机制:在图变换器中使用全局注意力机制,允许所有节点之间的信息传递,以学习图结构的长距离依赖性。

  • 深度瓶颈分析:通过实验发现,当前的图变换器在增加深度时会遇到性能瓶颈,超过一定层数后性能会下降。

  • 子结构注意力机制:DeepGraph模型通过引入子结构标记(substructure tokens)和在相关节点上应用局部注意力来增强对子结构的编码能力。

  • 子结构采样:在每次编码时,从图中采样子结构,以确保计算的可行性并减少由于子结构密度不均而产生的偏差。

  • 子结构标记编码:将子结构邻接矩阵直接编码为标记,使用基于排列的编码方法,并应用深度优先搜索(DFS)减少可能的排列组合。

  • 局部注意力应用:在子结构标记和相应节点上应用局部注意力,通过掩码(mask)限制子结构标记只能关注相应节点。

创新点
  • 子结构注意力机制:提出在图变换器中引入子结构级别的注意力机制,以解决随着深度增加全局注意力机制性能下降的问题。

  • 子结构标记:明确地在编码表示中使用子结构标记,这有助于模型关注子结构特征并提高表达能力。

  • 理论分析:提供了关于注意力容量随着深度变化的理论分析,证明了增加深度会导致注意力容量减小,从而限制了图变换器的性能。

  • 深度归一化:使用深度归一化(deepnorm)方法来稳定深度变换器的训练过程。

  • 子结构采样策略:提出了一种贪心采样算法,确保所采样的子结构尽可能均匀地覆盖每个节点。

  • 排列不变编码:使用基于排列的编码方法来减少子结构的可能排列组合,从而降低了计算复杂度。
3、Cell Graph Transformer for Nuclei Classification

方法

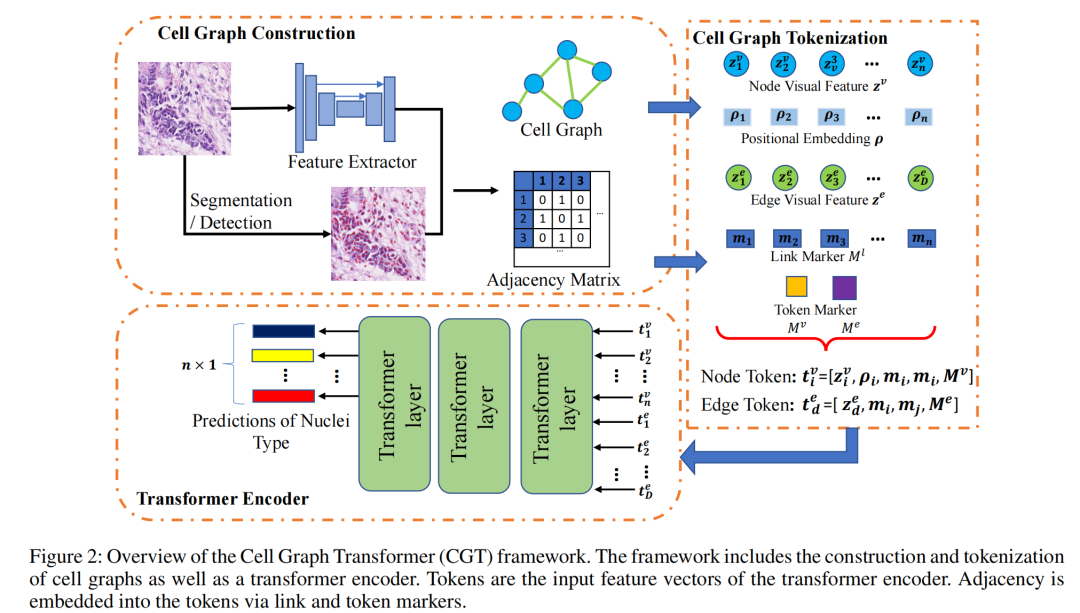
该论文提出了一个基于细胞图的变换器(Cell Graph Transformer, CGT)框架,用于在组织病理学图像中对细胞核进行分类。主要方法包括:

  • 细胞图构建:使用细胞核的中心坐标构建无向细胞图,其中节点代表细胞核,边代表相邻细胞之间的连接。

  • 细胞图标记化(Cell Graph Tokenization, CGToken):将细胞图转换为标准变换器可以处理的一组标记,同时保留图的拓扑结构信息。

  • 变换器编码器:使用标准的变换器层对输入的节点和边标记进行编码,以输出细胞类型的预测。

  • 拓扑感知预训练策略:使用图卷积网络(GCN)预训练特征提取器,以减少细胞图变换器的初始噪声并提高其表示能力。

  • 训练和推理方案:在预训练特征提取器之后,与变换器编码器同步微调,使用交叉熵和焦点损失进行节点类别的分类。

创新点
  • 细胞图变换器(CGT):提出了一种新的基于变换器的框架,通过将节点和边作为输入标记,计算所有节点对之间的相关性,以更灵活地捕获长程上下文。

  • 拓扑感知预训练:提出了一种新颖的预训练策略,利用GCN的局部消息传递机制来指导特征提取器的学习,从而在训练初期减少不合理的相关性,加快CGT框架的训练收敛。

  • 细胞图标记化(CGToken):开发了一种新的方法将细胞图转换为变换器可以处理的标记,通过链接标记和标记标记嵌入邻接信息。

  • 状态艺术性能:在多个细胞核分类基准测试中,提出的方法显著优于现有的最先进方法,并实现了最先进的性能。

  • 模型灵活性:CGT框架可以适应各种形式的分割/检测结果,使其成为一个灵活的模型,能够基于任何形式的二元分割或检测结果进行细胞类型的识别。

  • 计算效率:尽管与现有的分割方法相比,CGT在参数数量、推理时间和模型大小上有所增加,但这些增加在实际应用中是可接受的,并且性能提升显著。
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
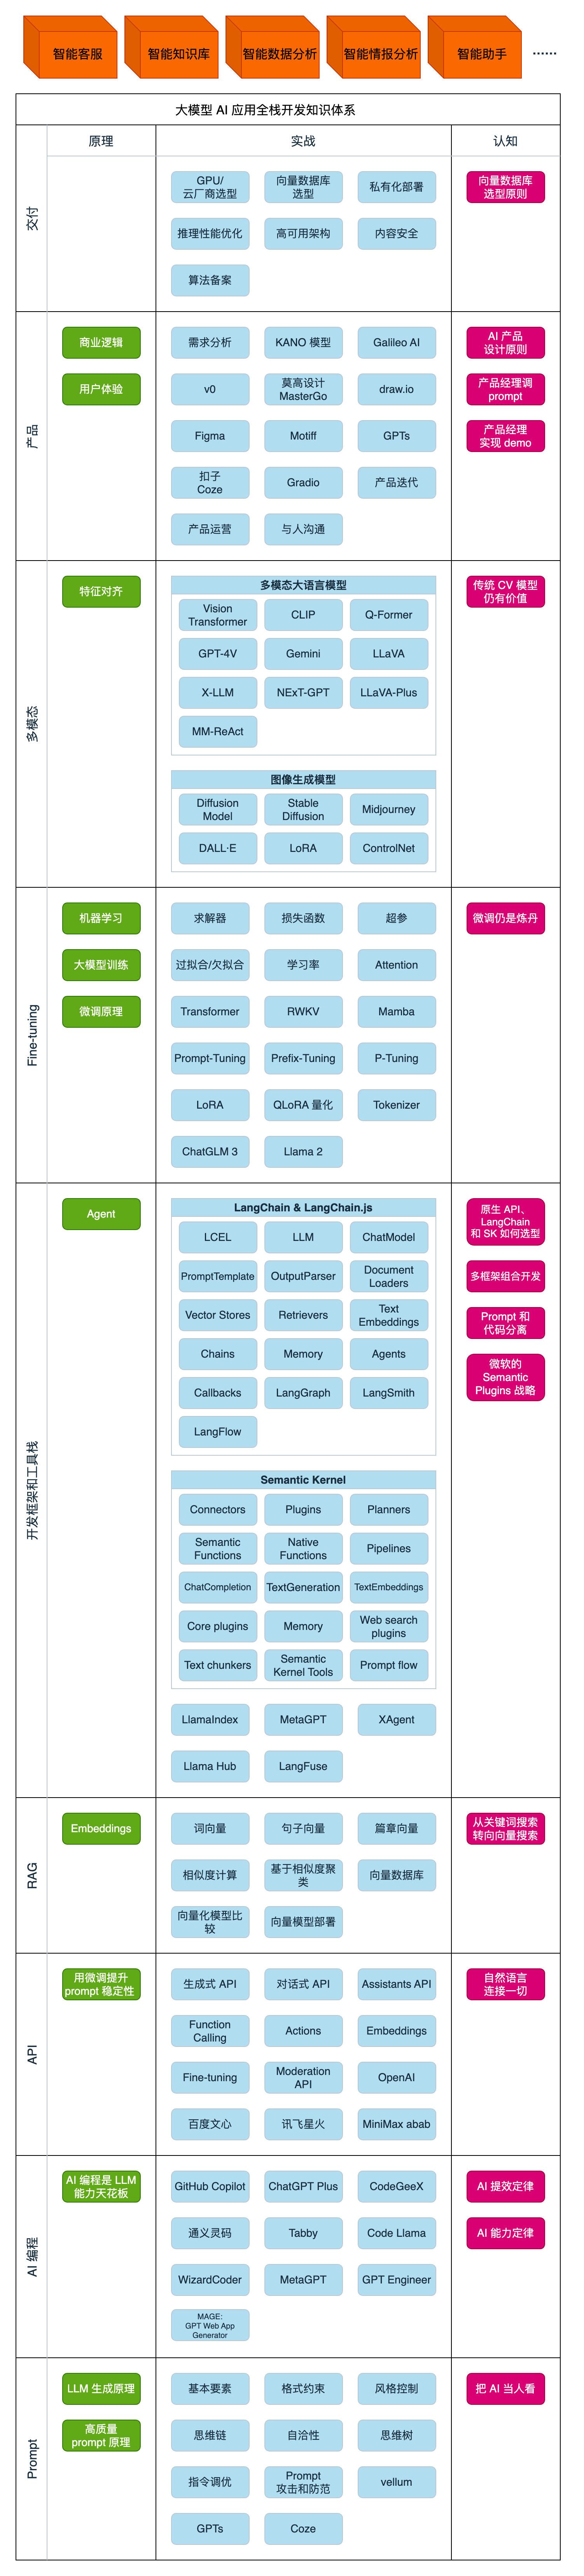
在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

ICCV2023 Tracking paper汇总(二)(多目标跟随、单目标跟随等) 在视觉目标跟踪(VOT)和视频目标分割(VOT,VOS)的共同目的。一些研究已经尝试过联合跟踪和分割,但在初始化和预测中往往缺乏box和mask的完全兼容性,主要集中在单对象场景上。为了解决这些限制问题,本文提出了一种用于统一跟踪和分割的多对象mask和box集成框架,称为MITS。首先,提出了统一的识别模块来支持初始化的box引用和mask参考,其中详细的对象信息从box中推断或直接从mask中保留。此外,还提出了一种新的精确框预测器,用于精确的多目标框预测,促进了面向目标的表示学习。 阅读详情

相关推荐

GNN-Transformer新突破!全局与局部的完美融合

这类结合不仅能够让两者发挥各自的优势,还能推动模型的创新,提高处理图数据的效率和性能。具体点讲,通过利用Transformer,我们可以扩展GNN的感受野,包括那些距离中心节点较远的相关节点。相对的,GNN也可以帮助Transformer捕捉复杂的图拓扑信息,并从相邻区域高效地聚合相关节点。目前,,这其中有不少个人认为很值得学习的成果。比如GNN 嵌套 Transformer 模型、仅使用一层全局注意力的简化图Transformer模型。

BetrayFree的博客 3349

最新涨点新神器:【卡尔曼滤波+目标检测】双热点强强联合!

卡尔曼滤波(Kalman Filter)是一种有效的递归滤波器,它在目标检测和跟踪领域有着广泛的应用。目标跟踪的三个主要阶段:首先进行移动目标的检测,然后是跨图像跟踪这些目标,最后分析目标的轨迹以识别它们的行为。卡尔曼滤波器在这一过程中扮演着重要的角色,尤其是在跟踪阶段。卡尔曼滤波器的工作原理:卡尔曼滤波器是一组数学方程,它提供了一个高效(递归)的计算方法,用于估计一个过程的状态。它非常强大,因为它支持对过去、现在甚至未来状态的估计,即使在跟踪和检测目标的系统性质不完全清楚的情况下也能进行。

Aimoxin111的博客 357

深度学习网络选型指南:CNN、GNN、YOLO、Transformer实战解析

深度学习作为人工智能的核心技术,通过神经网络模拟人脑处理复杂数据。其原理基于层次化特征提取与表示学习,能够自动从数据中挖掘规律。在工程实践中,深度学习显著提升了图像识别、自然语言处理等任务的性能,广泛应用于医疗诊断、自动驾驶、智能推荐等场景。针对不同数据类型,CNN擅长处理图像的空间特征,GNN专攻图结构关系推理,而Transformer凭借自注意力机制在序列任务中表现卓越。本文聚焦CNN、GNN、YOLO、Transformer四大经典网络,从数据特性出发解析其设计逻辑与适用边界,帮助开发者建立科学的模型

weixin_33794672的博客 343

双热点新突破:GNN-Transformer超越传统起飞!

GNN-Transformer融合模型的核心在于利用Transformer的自注意力机制增强GNN的全局信息聚合能力,同时通过GNN的图结构归纳偏置提升Transformer在处理非欧几里得数据时的效率。例如,Graph Transformer通过将节点特征和边特征嵌入到Transformer的输入序列中,实现了对图结构数据的端到端学习;而Graph-BERT则通过引入图感知的位置编码和节点上下文采样策略,进一步优化了Transformer在图数据上的表现。

m0_59235699的博客 2011

图结构感知的Transformer:一种新的图表示学习方法

尽管图神经网络(GNNs)在处理图数据方面取得了显著成就,但它们在表达能力和捕获长距离依赖方面存在局限性。为了突破这些局限,研究者们开始探索将Transformer架构应用于图表示学习。在此基础上,瑞士苏黎世联邦理工学院的研究团队提出了一种创新的方法——Structure-Aware Transformer(SAT),旨在通过在自注意力机制中引入基于子图的表示,增强模型对图结构的感知能力,从而在计算注意力时能够显式地考虑节点间的图结构信息。

人工智能讲师分享前沿技术 1853

微信聊天记录丢失原因与恢复方案详解

SQLite数据库作为移动应用常见的本地存储方案,其加密机制和存储结构直接影响数据安全性。以微信为例,聊天记录存储在EnMicroMsg.db等SQLite文件中,采用AES加密保护。当手机清理工具误删这些文件时,会导致特定时间段记录丢失。理解数据恢复原理需要掌握文件系统删除机制和闪存特性,其中关键点包括TRIM指令的影响和数据块覆盖风险。通过专业工具如DiskDigger或iMyFone D-Back,配合ADB调试和SQLite数据重组技术,可在黄金时间窗口内恢复记录。日常维护建议结合自动化备份方案和存

weixin_32612263的博客 386

Graphormer开源大模型详解:纯Transformer架构如何超越传统GNN?

本文介绍了如何在星图GPU平台上自动化部署Graphormer分子属性预测模型的纯Transformer架构图神经网络,实现高效分子属性预测。该模型通过创新的结构编码技术,在药物发现和材料科学领域展现出卓越性能,可快速预测分子溶解度、渗透性等关键属性,大幅加速科研流程。

SapphireOwl29的博客 772

LangFuse部署与实践

LangFuse的原理主要是基于可观察性和分析技术来监控和优化低延迟消息(LLM)应用。它提供了一套完整的解决方案,通过收集、处理和分析LLM应用在运行过程中产生的各种数据,来生成实时的、深入的、可操作的见解。通过提供实时的、深入的见解和可视化的跟踪功能,LangFuse使得识别和解决应用性能问题变得更加简单和高效。总的来说,LangFuse的原理是通过综合运用可观察性和分析技术,来提供对LLM应用的全面监控和优化能力。这使得开发者和运维团队能够更加高效地管理和维护他们的应用,从而提升用户体验和业务效益。

pumpkin84514的博客 7934

GraphGPS与传统GNN的对比:为什么图Transformer是未来趋势?

GraphGPS作为新一代图Transformer模型,正在重新定义图神经网络(GNN)的能力边界。本文将深入剖析传统GNN的局限性,揭示GraphGPS如何通过创新架构解决这些痛点,以及为什么图Transformer技术代表了图深度学习的未来方向。 ## 传统GNN的三大核心局限 传统GNN模型在处理复杂图结构时面临着难以突破的瓶颈,主要体现在以下三个方面: ### 1. 感受野受限:局部

gitblog_01001的博客 375

a股level2数据接口的最优委托信息

Level-1提供的数据并不可以知道委托了xxx手是有多少人下的,以及每个人下了多少的明细。通过Level-2的这个详细买卖盘数据,盘口上的单子到底是散户小打小闹,还是主力真刀实枪在干,都一览无余。交易类型:1-市价,2-限价,3-本方优先,10-撤单, 11-暂不清楚( 基金/ 债券有此值)除了提供逐笔成交记录这个信息外,还提供了最优委托信息,也就是盘口中前50笔订单的委托数量明细。那么Level-2盘口委托数据的速度更新是非常快的,大家可以通过。交易方向:0-未知,1-买入,2-卖出。

Qq_2037696191的博客 1165

手机刷双系统

刷机教程(https://www.geekeyes.cn/forum.php/forum.php?mod=viewthread&tid=492) 解锁教程(http://www.gioov.com/index.php/1386)   解锁教程 cmd下 进入adb目录( 如果环境变量配置了adb 可以直接在cmd 下输入命令) 手机连接电脑,确保usb 调试打开,然后手机连接电脑,...

超宇的博客 1万+

Graphormer惊艳效果展示:PCQM4M榜单超越传统GNN的真实预测结果集

本文介绍了如何在星图GPU平台上自动化部署Graphormer分子属性预测模型的纯Transformer架构图神经网络,实现高效分子属性预测。该镜像在PCQM4M榜单中表现优异,特别适用于药物发现和新材料设计等场景,帮助科研人员大幅提升预测精度和研发效率。

weixin_33628677的博客 839

杂货店商品数据集挖掘关联规则实验

(2)选择事务集中前100条事务,选择合适的支持度阈值,使用Apriori算法和FP-growth算法挖掘频繁项集(推荐使用mlxtend包的apriori和fpgrowth函数),并对比apriori算法和fpgrowth算法的时间复杂度;(比如用户1000在2015年3月15日对应的事务为{‘sausage’,’whole milk’,’semi-finished bread’,’yogurt’}),然后按照用户ID递增,时间递增的方式对事务进行排序;7. 排版工整自洽,图表标题准确(10分)

m0_62500122的博客 1441

Graphormer效果对比:超越传统GNN的分子属性预测精度实测报告

本文介绍了如何在星图GPU平台上自动化部署Graphormer分子属性预测模型的纯Transformer架构图神经网络,实现高精度分子属性预测。该镜像特别适用于药物发现和材料设计领域,能够快速评估分子生物活性和材料特性,显著提升研发效率。通过实测对比,Graphormer在预测精度上比传统GNN提升23-28%,为科研和工业应用提供强大工具支持。

weixin_42309599的博客 402

语音数据标注工具与平台

最近在做语音深度学习的项目,整理了一下语音数据标注工具和语音标注平台,供大家参考 语音标注工具–Praat Praat是目前已经成为比较流行也比较专业的语音处理的软件,可以进行语音数据标注、语音录制、语音合成、语音分析等等,具有免费、占用空间小、通用性强、可移植性好等特点 官网链接 http://www.fon.hum.uva.nl/praat/ 汉化版下载 http://www.hejingzo...

qq_21379593的博客 1万+

突破Shopee平台数据采集的风控挑战与技术解决方案

高效、稳定、合规的数据采集能力,始终是我们服务的核心价值。多类型代理组合:采用高匿名住宅代理(模拟真实用户IP)与数据中心代理(高并发需求)混合策略,结合IP轮换频率与目标国家后缀(如.com.my、.vn)动态匹配14。反反爬数据过滤:针对Shopee页面中的混淆数据(如虚假价格标签、隐藏元素),采用XPath精准定位结合正则表达式清洗,确保数据准确性89。随机化请求间隔:在爬虫代码中引入随机延迟(如1-5秒),并模拟“浏览-点击-滚动”等用户行为链,降低行为模式的可预测性48。

klj3388的博客 2976

Graphormer开源大模型价值解读:为何纯Transformer能在分子图任务上超越GNN

本文介绍了如何在星图GPU平台上自动化部署Graphormer分子属性预测模型的纯Transformer架构图神经网络,实现高效的分子属性预测。该镜像专为分子图结构设计,可应用于药物发现领域,快速预测候选药物的溶解度和毒性等关键性质,显著提升研发效率。

weixin_42298254的博客 28

云服务器安装ros教程

要在 CentOS 7 系统上安装 RouterOS,您需要将 RouterOS 安装为虚拟机或直接安装到物理硬盘上。这里提供的是将 RouterOS 安装到物理硬盘上的步骤,这将完全替换现有的 CentOS 7 系统。请确保您已经备份了所有重要数据。

qq_37662563的博客 2145

Graphormer模型效果对比展示:超越传统GNN,在多个基准数据集上刷新SOTA

本文介绍了如何在星图GPU平台上自动化部署Graphormer分子属性预测模型的纯Transformer架构图神经网络,实现高效的分子属性预测。该模型通过创新的空间编码和全局注意力机制,在溶解度预测、毒性识别等药物研发场景中展现出超越传统GNN的性能优势,为分子科学研究提供强大工具。

weixin_42611177的博客 36

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Graphormer效果展示:实测分子属性预测,准确率超越传统GNN方法

本文介绍了如何在星图GPU平台上自动化部署Graphormer分子属性预测模型的纯Transformer架构图神经网络,实现高效准确的分子属性预测。该模型通过全局注意力机制和三维结构编码,在药物分子溶解度预测等场景中展现出超越传统GNN方法的精度,为药物研发和材料设计提供强大工具。

weixin_34581040的博客 45

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

告别GNN老套路:Graphormer中的Spatial Encoding如何让Transformer‘看见’图的全貌

本文深入解析Graphormer如何通过Spatial Encoding技术让Transformer架构直接理解图的空间拓扑,突破传统GNN的局部邻居聚合限制。文章详细介绍了最短路径距离矩阵、可学习的距离编码以及改造后的注意力机制,展示了这一技术在全局视野和拓扑信息保留方面的显著优势。

weixin_30292745的博客 423

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

为什么PoseFormer能在2D-to-3D姿态估计中超越传统方法?深入解析其时空Transformer设计

本文深入解析了PoseFormer模型如何凭借其创新的时空Transformer设计,在2D-to-3D姿态估计任务中超越传统方法。通过解耦空间与时间注意力机制,该模型能有效建模关节间的全局空间关系和长程时间依赖,从而在复杂遮挡和运动场景下实现更精准、平滑的三维姿态重建,为视频理解提供了新范式。

zero1的博客 773

Transformer模型相比传统的一些模型的优势

相比之下,Transformer 中的encoder模块的自注意力机制(self-attention)允许每个位置直接关注输入序列的所有位置,使得计算可以高度并行化,提高了计算效率,而且在特征提取时可以考虑与当前位置相关性强的其它位置的信息。空间有效性:传统的 RNN 在处理长序列时,需要保存每个时间步的隐藏状态,消耗大量的存储空间。总的来说,Transformer 模型相对于传统的 RNN、GNN 和 GAN 具有更好的并行计算能力、更好的长程依赖建模能力,更高的空间效率和适用性广泛。

menteei的博客 2113

Graphormer效果展示:OGB/PCQM4M基准上超越传统GNN的分子预测结果

本文介绍了如何在星图GPU平台上自动化部署Graphormer分子属性预测模型的纯Transformer架构图神经网络,实现高效分子属性预测。该模型在药物发现和材料科学领域表现出色,能够准确预测分子溶解度、带隙等关键属性,显著提升科研效率。通过简单配置,用户可快速搭建预测环境,应用于药物筛选和新材料设计等场景。

weixin_42515842的博客 144

从ResNet到Transformer:5个改变游戏规则的深度学习突破

本文探讨了从ResNet到Transformer等五种革命性的深度学习突破,这些算法彻底改变了计算机视觉和自然语言处理等领域。重点介绍了残差网络、自注意力机制、生成对抗网络、图神经网络和扩散模型的核心创新与应用,展示了它们在解决复杂任务中的卓越表现和广泛影响。

agile9scrum的博客 449
上一篇: 大模型部署技巧
下一篇: 小数据,大突破!揭秘仅0.3B个token如何让8B模型逼近GPT-4,长文本开源新纪元
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2826原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值