OpenAI o1复现:自动构造prm训练数据-OmegaPRM

PRM训练数据收集:保证解的多样性策略 文章标题:PRM训练数据收集:保证解的多样性策略 关键词: PRM 训练数据收集 多样性策略 算法原理 数学模型 摘要: 本文将深 阅读详情

openai o1复现中,有个比较关键的问题,怎么样自动化构造prm模型的训练数据?本文主要从代码层面,来解析OmegaPRM原理。

论文

Improve Mathematical Reasoning in Language…[1]

原理

Markov决策过程
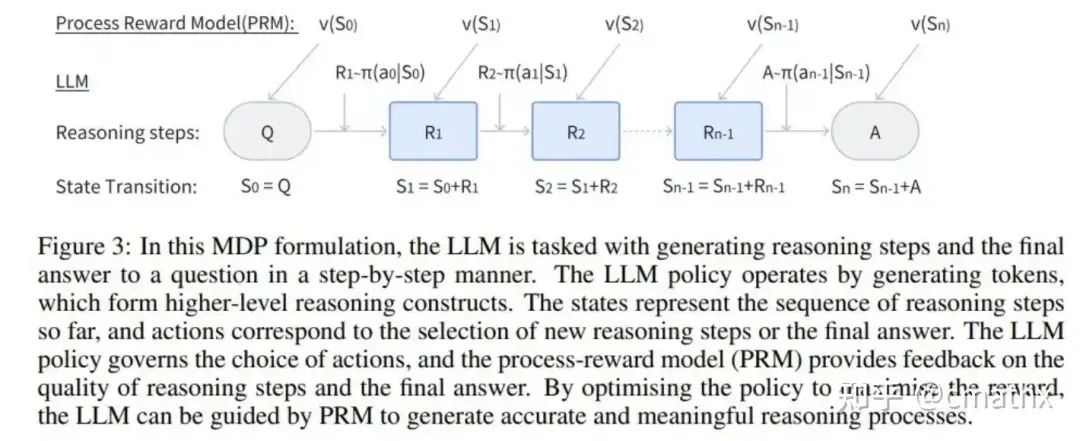
OmegaPRM

State:对应Markov决策过程中的状态,rollout:对应Markov决策过程中的动作;

  • step1:初始化root节点state;每个state包含n个扩展rollouts,q+pa作为prompt,进行n次llm生成采样;基于bootstrap采样方法估计Monte Carlo模拟正确答案的概率mc;

  • step2:从所有节点中,基于UCB1(Explore&&Exploit方法)选取最优的“state和rollout”,添加到PRM训练集;Exploit:alpha ** (1 - mc) * beta ** (len® / L),其中:mc表示蒙特卡洛模拟正确答案概率、len®表示LLM生成的长度;Explore:c_puct * sqrt(N_sum) / (1 + s.v),其中:N_sum表示所有节点的访问次数,s.v表示当前节点的访问次数,c_puct控制MCTS树的探索程度;

  • step3:评估最优“state和rollout”,二分rollout的结果,将左半部分纳入到新的state中,并计算新的mc;mc=1,表示state完全包含正确答案,忽略;mc=0,表示state完全没有生成正确答案可能性,添加到叶子节点;mc>0,表示state作为继续探索的节点;

  • step4:重复step2、step3,直至“探索到足够的样本、无法继续探索”退出;

  • step5:将叶子节点全部添加到PRM训练集;

PRM模型训练效果

论文的base模型

基于OmegaPRM方法合成数据,在MATH数据集,相比base model51%的准确率,OmegaPRM准确率提高到69.4%;

其他PRM方法

OmegaPRM:gemini提到的方法;

AlphaMath:qwen提到的方法;

Math-Shepherd: Verify and Reinforce LLMs Step-by-step without Human Annotations[2]

AlphaMath Almost Zero: Process Supervision without Process[3]

源码来源

https://github.com/openreasoner/openr[4]

源码解析

数据结构

class State:       def __init__(self, q, pa, a):           self.q = q #问题           self.pa = pa #当前step的prompt           self.a = a #答案           self.mc = None #基于当前节点,生成正确答案的概率           self.v = 0 #被访问次数           self.rollouts = [] #扩展的子节点           self.rollout_was_visited = [] #扩展的子节点是否被访问

主流程

 `# Load the JSON data       data = load_json_file(json_file_path)              # Process each problem and its final answer       for i, item in enumerate(data):           problem = item.get('problem', 'No problem found')           final_answer = item.get('final_answer', 'No answer found')                      # Print to console           print(f"Problem {i + 1}: {problem}")           print(f"Final Answer: {final_answer}")                      # Log each problem and answer           logging.info(f"Processed Problem {i + 1}: {problem}")           logging.info(f"Final Answer: {final_answer}")                      # Call getrollout and handle the result           states = []           root = State(problem, "", final_answer)           max_roll_num = 20           rollouts, corrs = getrollouts(root, max_roll_num)           mcst = cal_mc_bs(root)           root.mc = mcst                         # 生成root节点           states.append(root)              if sum(corrs) > 0 and sum(corrs) < max_roll_num:                print("Process annotation ...\n")               filename = str(i+1) +'_states_list.json'               # 生成PRM训练数据               process_annotation(problem, final_answer, states, filename)`

蒙特卡洛采样

#针对节点s进行n次采样,基于LLM生成n个rollouts,并给出每个rollout是否包含正确答案;   def getrollouts(s, n = 5):     corrs = []     q = s.q     pa = s.pa     for i in range(n):       re = complete_answer(q, pa)       s.add_rollout(re)       #check the answer       a = s.a       if check_answer(a, re):         corrs.append(1)       else:         corrs.append(0)     return s.rollouts, corrs          #蒙特卡洛采样,并给出包含正确答案的概率     def cal_mc_bs(s, bs = 5):       n = len(s.rollouts)       subn = max(1,random.randint(n//2, n))       mc = 0       for i in range(bs):       corr = 0           sub = random.sample(s.rollouts, subn)           for r in sub:               if check_answer(s.a, r):                   corr += 1           mc += corr * 1.0 / len(sub)       return mc / bs           #针对问题problem,使用problem+partial_answer作为prompt,进行LLM生成     complete_answer(problem, partial_answer, checkpoint)     #LLM生成的response是否包含正确答案groundtruth_answer     check_answer(groundtruth_answer, response)

基于mcts方法自动构造prm训练数据

#基于MCTS方法生成PRM训练数据   def process_annotation(q, a, states, filename = 'states_list.json'):      print("++++++")      it = 0      leaf_states = []      while True:          s, rollout, maxqu = select(states)          if s is not None and s.pa!='':              new_data = {                  "q": q,           # Ensure q is serializable                  "states": s.pa, # Ensure states is serializable                  "mcs": s.mc        # Ensure mcs is serializable              }              # Call the function to append the new data              append_to_json_file(filename, new_data)              it += 1              if it > 100:                  break          # all state-rolls pairs were exhausted          if s is None:              break          print()          print("[sel]")          print(s)          print("  roll=",rollout," || qu=", maxqu)                    s.add_visit()          div_roll_sts,leaf_sts = error_locate(s, rollout)          if len(div_roll_sts)==0:              continue                    states.extend([s for s in div_roll_sts if s!=None and s.pa != ''])          leaf_states.extend(leaf_sts)      #      ## add leaf states to data      for s in leaf_states:          new_data = {              "q": q,           # Ensure q is serializable              "states": s.pa, # Ensure states is serializable               "mcs": s.mc        # Ensure mcs is serializable          }          # Call the function to append the new data          append_to_json_file(filename, new_data)      print("++++++")

基于UCB1方法,选择最优的节点,纳入到训练集

#选择当前最优的节点   #exploitation:使用“更大的mc、更短的llm生成”节点;   #exploration:探索“未充分访问的、更大的树探索程度”节点;   def select(states):       best_st = None       best_roll_idx = -1       best_qu = -1       for s in states:           # mcs = cal_mc(s) if s.mc is None else s.mc           mcs = cal_mc_bs(s) if s.mc is None else s.mc           if mcs == 0 or mcs==1.0:               continue           for i,r in enumerate(s.rollouts):               if s.rollout_was_visited[i]:                   continue               q = Q(r, mcs)               u = U(s,states)               qu = q + u               if qu > best_qu:                   best_st = s                   best_roll_idx = i                   best_qu = qu                     #       if best_roll_idx != -1:           best_st.rollout_was_visited[best_roll_idx] = True       return best_st,best_st.rollouts[best_roll_idx],best_qu      #exploitation:倾向于选择已知表现好的状态和rollout;   #alpha ** (1 - mc) * beta ** (len(r) / L)   #1. 鼓励使用更大mc(生成包含正确答案可能性更大);   #2. 更短rollout(更短的生成,更可能推理出正确答案)的节点,   def Q(r, mc, alpha  = 0.5, beta = 0.9, L = 500):       part1 = alpha ** (1 - mc)       part2 = beta ** (len(r) / L)       Q_value = part1 * part2       return Q_value      #exploration:鼓励尝试未充分探索的选项,使用UCB1算法(Upper Confidence Bound 1);   #c_puct * sqrt(N_sum) / (1 + s.v)   #1. s.v:当前状态访问次数,鼓励探索访问次数较少的节点;   #2. N_sum:所有状态的访问次数总和,表示搜索过程的广度和深度,即鼓励更大的搜索树探索程度;   #3. c_puct:控制探索程度的常数;   def U(s, states, c_puct = 0.125):       N_sum = 0       for item in states:           N_sum += item.v       numerator = math.sqrt(N_sum)       denominator = 1 + s.v       U_value = c_puct * (numerator / denominator)       return U_value      def qu(i, r, mc, ncs):       q = Q(r, mc)       u = U(i, ncs)       return q+u

评估最优节点,是否继续探索?无法探索(完全错误)作为叶子节点,纳入到训练集

#评估最优“state和rollout”,二分rollout的结果,将左半部分纳入到新的state中,并计算新的mc;   def error_locate(s, rollout):       current_span = rollout       prev = ""       divide_roll_pos_st = []       leaf_st = []       while True:           word_count = len(current_span.split())           if word_count < 2:               break           np1, np2 = split_sentence_middle(current_span)           print("----")           print(" BS[l]=", np1)           print(" BS[r]=", np2)           #二分LLM生成结果rollout,新的prompt:已有生成结果+左半部分           st = State(s.q, prev + np1, s.a)           rollouts, corrs = getrollouts(st)           # mcst = cal_mc(st)           mcst = cal_mc_bs(st)           st.mc = mcst           # case 1: always correct (we are not interested in this kind of state)           if mcst == 1:            # leaf_st.append(st)               break           # case 2: right span(继续扩展节点)           elif mcst > 0:               current_span = np2               prev = prev + np1               divide_roll_pos_st.append(st)           # case 3: left span(这里LLM生成完全没有可能包含正确答案,因此节点扩展terminated)           elif mcst == 0:               current_span = np1               leaf_st.append(st)                  #       print("----")       return divide_roll_pos_st,leaf_st

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

RTL优化与PPA分析:数字电路设计的关键技术 在数字集成电路设计中,RTL(寄存器传输级)优化是提升芯片性能、降低功耗和减小面积的核心技术。通过PPA(Power-Performance-Area)指标的平衡,工程师可以在不同时序约束下实现设计的最优化。本文基于Synopsys Design Compiler和开源工具Yosys的实验数据,展示了RTL优化在算术单元和控制逻辑中的显著效果,特别是在乘法器和除法器等复杂运算模块中。文章还探讨了AI辅助工具在RTL优化中的应用潜力,为数字电路设计提供了实用的技术参考和工程实践建议。 阅读详情

相关推荐

Xilinx Vitis 2020.1中Microblaze SREC SPI Bootloader初始化失败的调试与修复指南

本文详细解析了在Xilinx Vitis 2020.1开发环境中,Microblaze SREC SPI Bootloader初始化失败的常见原因与解决方案。核心问题通常源于Flash上电时序或软件配置,如`serial_flash_family`参数未生效、链接脚本设置不当或BRAM初始化文件选择错误。文章提供了从硬件配置检查、工程设置修正到代码级添加重试机制的完整调试路径,帮助开发者快速定位并修复启动故障,确保系统稳定启动。

weixin_29163857的博客 186

【Reasoning】Improve Mathematical Reasoning in LanguageModels by Automated Process Supervision

arxiv: https://arxiv.org/abs/2406.06592COT和SC-COT对于模型推理能力的提升仍然有效,已有研究提出用一个验证器去帮助LLM提升推理能力。采用ORM结果验证器岁可以对最终结果生成一个信号,但是不能去奖励或者惩罚中间步骤。采用PRM可以对中间步骤在更细粒度的视角下,对中间步骤进行奖励或者惩罚。受到AlphaGo Zero的启发,本文提出了一个分而治之的蒙特卡洛树搜索算法OmegaPRM,来有效的收集高质量过程监督数据。这篇论文提出了一种名为OmegaPRM的新型分治风

STAR GAME 1568

别再死记硬背GNN公式了!用PyTorch Geometric从零实现一个GraphSAGE(附完整代码)

本文通过PyTorch Geometric从零实现GraphSAGE模型,深入解析图神经网络的核心原理与实战应用。文章提供完整代码示例,涵盖环境配置、邻居采样、信息聚合等关键步骤,帮助开发者掌握图表示学习技术,避免陷入公式推导的困境。适合希望将GNN应用于实际项目的中级开发者和学生。

weixin_42530570的博客 347

2024年5月7日大语言模型最新论文中文摘要

在这里,我们将使用 LangGraph、Groq-Llama-3 和 Chroma 构建可靠的 RAG 代理。我们将结合以下概念来构建 RAG 代理。自适应 RAG (论文。我们已经实现了本文中描述的概念,构建了一个路由器,用于将问题路由到不同的检索方法。校正 RAG (论文。我们已经实现了本文中描述的概念,开发了一个回退机制,用于在检索到的上下文与所问问题不相关时继续进行。自身 RAG (论文。我们已经实现了本文中描述的概念,开发了一个幻觉评分器,即修正那些产生幻觉或未回答所问问题的答案。

数智笔记 4582

MySQL服务启动失败?手把手教你排查NET HELPMSG 3534错误(附完整修复流程)

本文针对Windows平台上MySQL服务启动失败并提示NET HELPMSG 3534错误的常见问题,提供了系统性的排查与修复指南。文章深入剖析了错误本质,并手把手教你通过查看MySQL错误日志、检查并初始化数据目录、修正Windows服务配置、排查my.ini配置文件陷阱等核心步骤,彻底解决这一棘手问题,帮助开发者和运维人员快速恢复数据库服务。

wdx0123456的博客 895

FreeRTOS OTA实战:从Bootloader设计到安全升级的完整流程(附MQTT示例代码)

本文详细介绍了在FreeRTOS系统中实现安全OTA固件升级的完整流程。内容涵盖从Bootloader设计、存储分区规划到与MQTT协议集成的OTA Agent任务开发,并重点解析了固件签名验证、防回滚等关键安全机制,为嵌入式物联网设备提供了一套高可靠性的远程升级解决方案。

weixin_29248653的博客 161

【论文解读】OmegaPRM:MCTS驱动的自动化过程监督,赋能LLM数学推理新高度

论文提出了一种名为 OmegaPRM 的新颖的、基于蒙特卡洛树搜索 (MCTS) 的算法,用于全自动、高效地收集大规模、高质量的过程监督数据,以训练过程奖励模型 (PRM) 来提升大型语言模型 (LLM) 的数学推理能力。

分享论文解读,分享思考见解,分享实践经验 1389

华大HC32F460RS485通信实验

华大HC32F460RS485通信实验

ZhuoWuKeJi的博客 1798

通过自动化的过程监督提高语言模型中的数学推理能力

24年6月来自谷歌DeepMind的论文“Improve Mathematical Reasoning in Language Models by Automated Process Supervision”。

yorkhunter的博客 1901

国产系统(统信 UOS )漏洞修复方式

2.1 服务器版(单漏洞更新):服务器标准版:yum upgrade-minimal --cve “CVE编号”服务器 D 版:sudo apt update&&sudo apt install “受影响的软件包”1 统信 UOS 漏洞修复方式在线升级修复桌面专业版:通过以下步骤打开在线升级:控制中心–>更新–>更新设置–>打开系统更新、安全更新。安装过程中,请勾选“我已阅读并知晓”,然后点击“开始升级”。2 点击“检查更新”–“全部下载”,如果不想进行系统更新,可以选择只下载“安全更新”。

Reyn_观极 5016

Nvidia Orin Driveos Camera 介绍及调试详解

自动驾驶-nvidia orin driveos Camera 驱动详解及调试

u011803281的博客 2992

OpenAI o1 复现——过程奖励模型(PRM)

o1 作为 OpenAI 在推理领域的最新模型,大幅度提升了 GPT-4o 在推理任务上的表现,甚至超过了平均人类水平。o1 背后的技术到底是什么?o1 隐藏的长思维链是如何生成的?

xx_nm98的博客 6171

RK3588在线更新系统内核的方法

《RK3588设备在线升级系统内核方法》 本文介绍了RK3588设备在线升级系统内核的简易方法。通过将新内核文件boot.img拷贝至目标主机后,使用dd命令配合关键参数(fsync确保写入磁盘、notrunc避免截断分区)进行安全更新,更新后需执行sync同步操作并重启生效。文章特别强调操作过程中断电风险,并扩展说明了Uboot的类似更新方法。该方法避免了现场设备拆卸的麻烦,为嵌入式系统维护提供了实用解决方案。

荻夜的博客 1049

大模型推理能力优化技术总结:兼看大模型落地6个误区

这其实是属于o1专题,大模型推理的范畴。这个方向上,目前主流方式是引入“cot”,即引入代表推理过程中间步骤的一系列标记,使LLMs能够模仿复杂的人类推理过程,如树搜索和反思性思维。最开始,大家发现,在测试时推理过程中鼓励大模型使用更多标记进行“思考”,可以进一步提高推理准确性。后面openai-o1出来之后,大家有发现,可以应用强化学习(RL)来训练LLMs掌握推理过程,这种方法通过试错搜索算法自动生成高质量的推理轨迹,通过提供大量更多的训练数据显著扩展了LLMs的推理能力。

z551646的博客 1021

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

理解大模型训练中的PRM(过程奖励模型)训练

本文描述了ORM (Outcome Reward Model)的定义和作用。并基于OpenRLHF源码详细解读了ORM的训练过程。在RM的研发范式中,还有最近比较火热的PRM(Process Reward Model)。

Androiddddd的博客 3335

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

OpenAI使用过程监督提升数学推理能力

近年来,大型语言模型在多步推理能力上取得了显著进步,但即使是最先进的模型仍然常犯逻辑错误。为了训练更可靠的模型,我们可以采用结果监督(对最终结果提供反馈)或过程监督(对每个推理步骤提供反馈)。考虑到人类反馈的高成本,比较这两种方法至关重要。虽然已有研究开始探索这一问题,但仍有许多未解之处。我们的研究表明在解决 MATH 数据集的复杂问题时,过程监督明显优于结果监督。我们的过程监督模型解决了 MATH 测试集代表性子集中的 78% 的问题。此外,主动学习显著提升了过程监督的效果。

m0_59164520的博客 1800

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

利用大模型构造数据集,并微调大模型

目前大模型的微调方法有很多,而且大多可以在消费级显卡上进行,每个人都可以在自己的电脑上微调自己的大模型。但是在微调时我们时常面对一个问题,就是数据集问题。网络上有许多开源数据集,但是很多时候我们并不想用这些数据集微调模型,我们更希望使用某本书、某个作者的作品、我们自己的聊天记录、某个角色的对话来微调模型。用于微调的数据通常是成千上万的问答对,如果手工搜集,需要花费大量时间。文本将介绍一种方式,利用大模型来构造自己的数据集,并使用我们构造的数据集来微调大模型。

m0_63171455的博客 1万+

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 224

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 398

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 246

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 500

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 201

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 199

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 558

AI前沿日报 · 2026-11-04 | 祛魅时刻:Astra“纯读权重“神话的崩塌

①Astra"裸权重通吃"被spaCy创始人Honnibal精准祛魅——仅1/3实验真裸读,数学能力提升依赖Python+50次迭代;②Simon Willison用Qwen 3.8-27B端侧复现权重空间编程;③Nvidia开源Auto-Ontology自动知识图谱;④$800开源全域抓取机器人Stringman;⑤OpenAI悄然重开Codex训练开关引信任危机;⑥DeepMind发布Gemini 4 Argon机器人基础模型;⑦美国科技巨头隐性AI债务达3.2万亿美元,6个月增90%。

johnsong2009的博客 573
上一篇: 使用大型语言模型构建主动协作型智能体
下一篇: Time-MMD:首个涵盖9大主要数据领域的多域多模态时间序列数据集
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值