使用ollama搭建自己的本地中文大语言模型

Ollama 可以在 Windows 上运行了 阅读详情
AI摘要

本文介绍如何使用ollama框架在本地部署和运行Llama3等大型语言模型,包括模型下载、配置及测试,同时分享了构建中文模型的方法及提升运行速度的技巧。

说到ai,大家应该不陌生了,它应该是目前最火的研究方向之一了,下面是目前比较流行的一些ai(人工智能大模型):

  • openai的chatgpt

  • google的Gemma

  • Anthropic的Claude

  • 月之暗面的kimi

  • 阿里的通义千问

  • 百度的文心一言

  • 字节跳动的豆包

但今天聊的是ollama这个开源框架加上开源模型来实现自己本地的ai。

Ollama 是一款开源的本地运行大型语言模型(LLM)的框架,它允许用户在自己的设备上直接运行各种大型语言模型,包括 Llama 3、Mistral、Dolphin Phi 等多种模型,无需依赖网络连接。此外,Ollama 还提供跨平台的支持,包括 macOS、Windows、Linux 以及 Docker, 几乎覆盖了所有主流操作系统。

Llama 3是Meta AI开源的第三代Llama系列模型,其新的 8B 和 70B 参数 Llama 3 模型在Llama 2的基础上,实现了更大性能的提升。由于预训练和训练后的技术改进,其Llama 3模型是当今 8B 和 70B 参数规模的最佳模型。Llama 3模型的改进大大降低了错误拒绝率,改善了一致性,并增加了模型响应的多样性。Llama 3模型在推理、代码生成和指令跟踪等功能也得到了极大的改善。而未来更大的4000亿参数大模型还在继续训练中。其Llama 3大模型可以直接在Meta AI官网直接使用,且支持无需注册登陆即可使用,简直是开箱即用。

官网:https://ollama.com/

github: https://github.com/ollama/ollama

一、部署ollama

首先到ollama的官网,或者GitHub链接下载ollama进行安装,其ollama支持window版本,Mac版本,以及Linux版本,根据自己的电脑操作系统下载对应的安装包即可。
MAC

https://ollama.com/download/Ollama-darwin.zip
Windows(本次也是在windows测试为主)

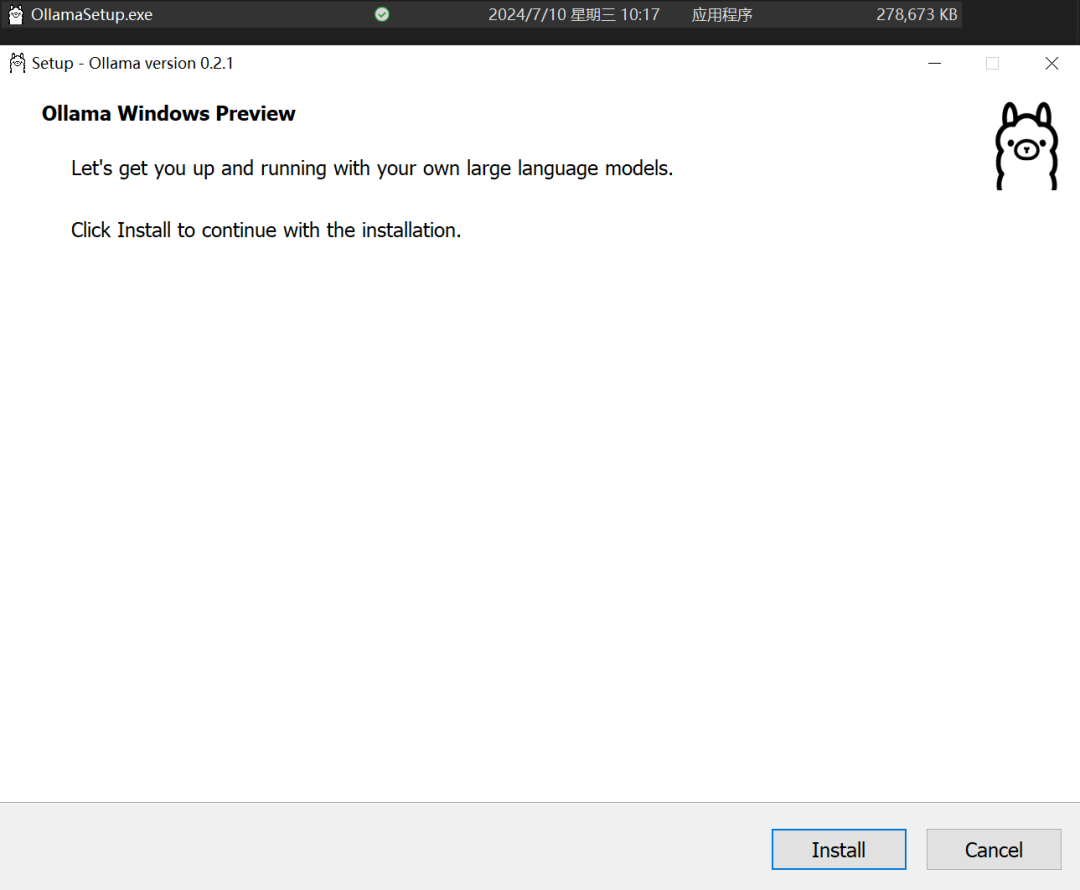
https://ollama.com/download/OllamaSetup.exe

  1. 安装,直接双击,下一步下一步就行了,不多赘述

  1. 获取模型

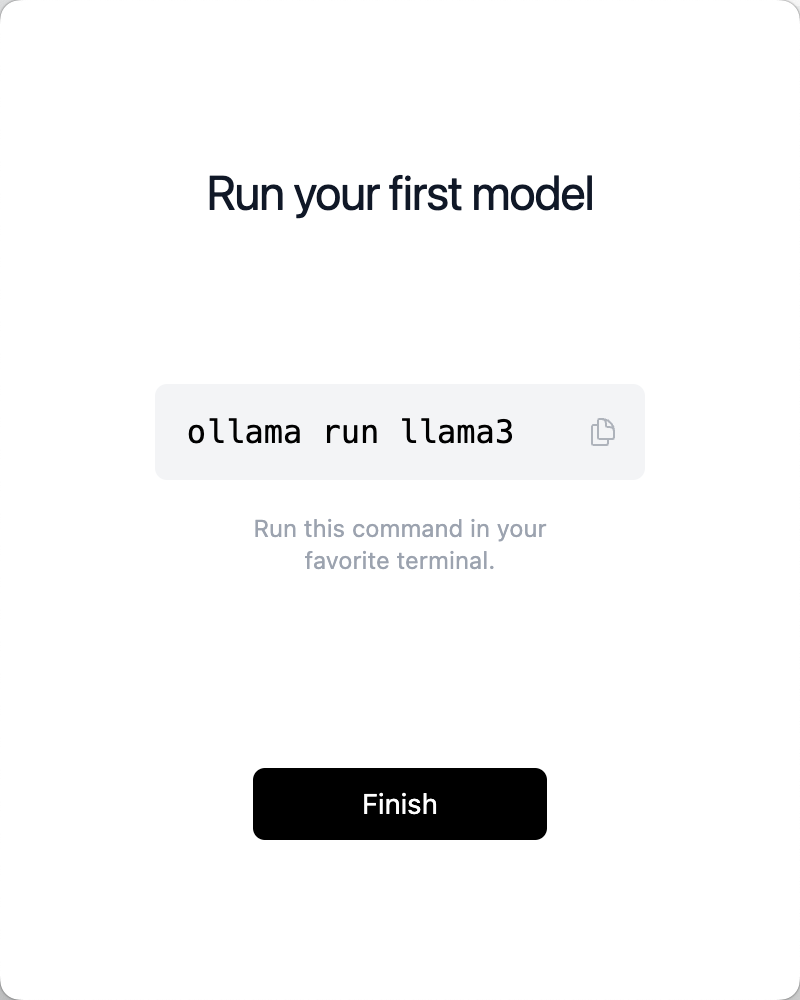
ollama安装完成后,并没有一个可视化的界面,其服务运行在后台。还需要加载模型。首次运行时,ollama会自动检测电脑上是否下载了你需要的模型,若没有相关模型,会自动下载:比如llama3
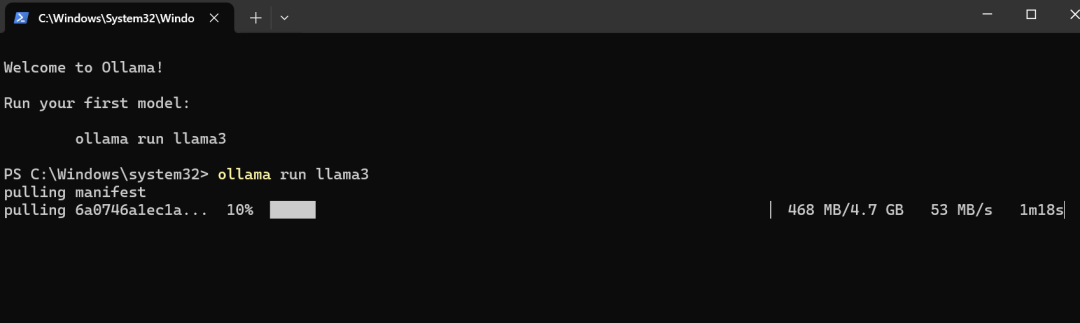
#运行8B参数的模型,其模型约4.7G``ollama run llama3``#运行70B的模型,其模型约40G``ollama run llama3:70b
  1. 测试

运行下面的命令即可启动:

ollama run llama3

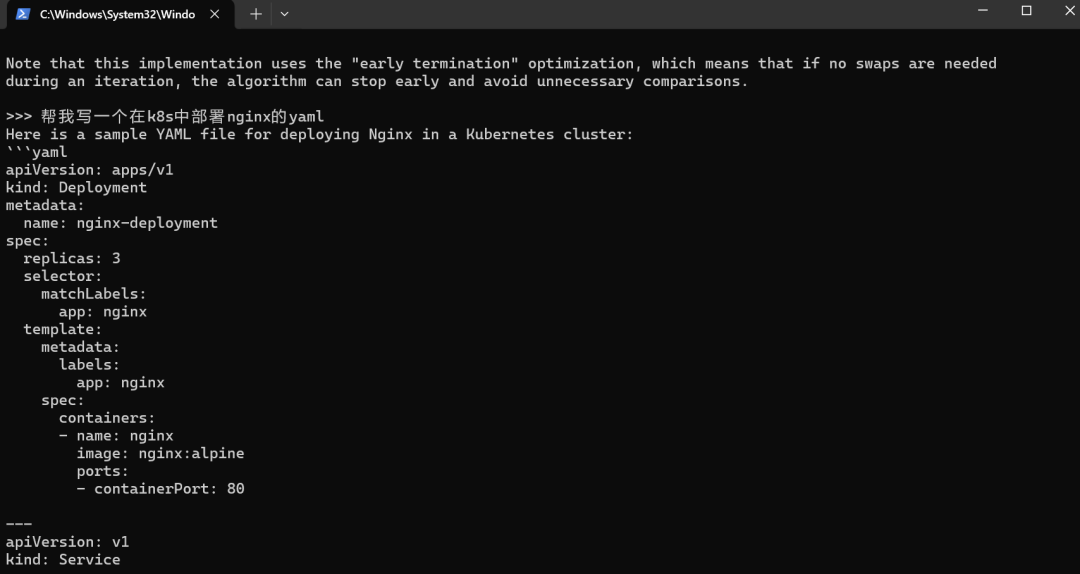
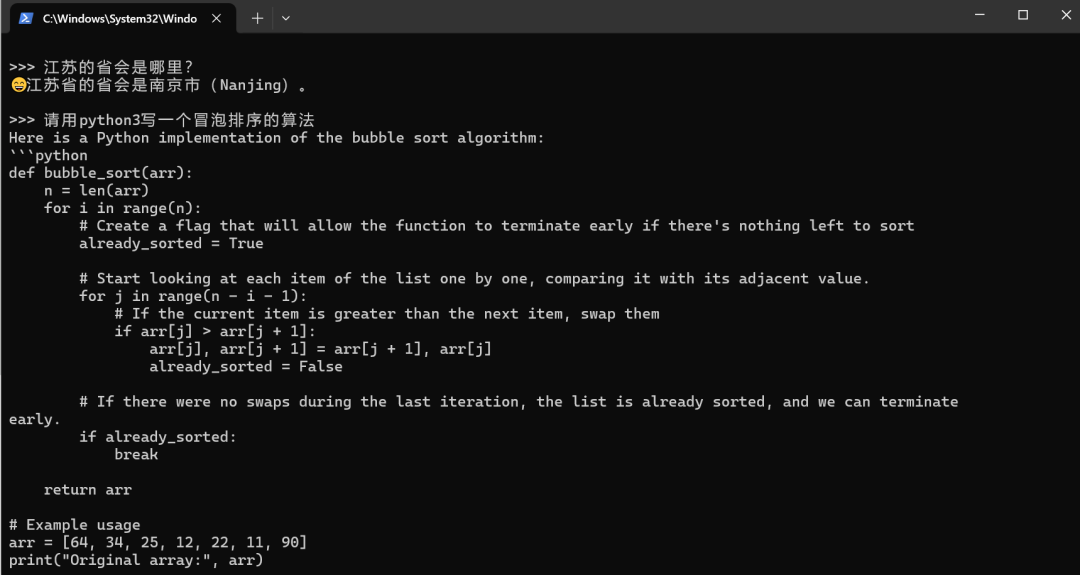
经过测试,简单问题,速度还是可以的:
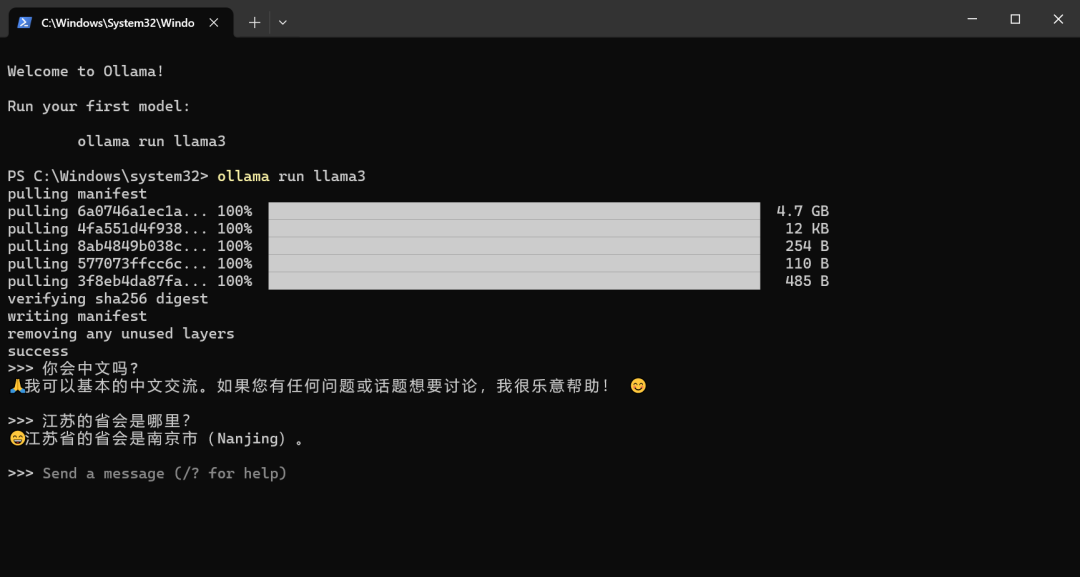
这里的速度跟自己的电脑配置有很大的关系,毕竟大模型运行在本地,且还是8B的模型,由于自己的电脑内存不大,并没有本地体验70B的模型,这个可以自行尝试。
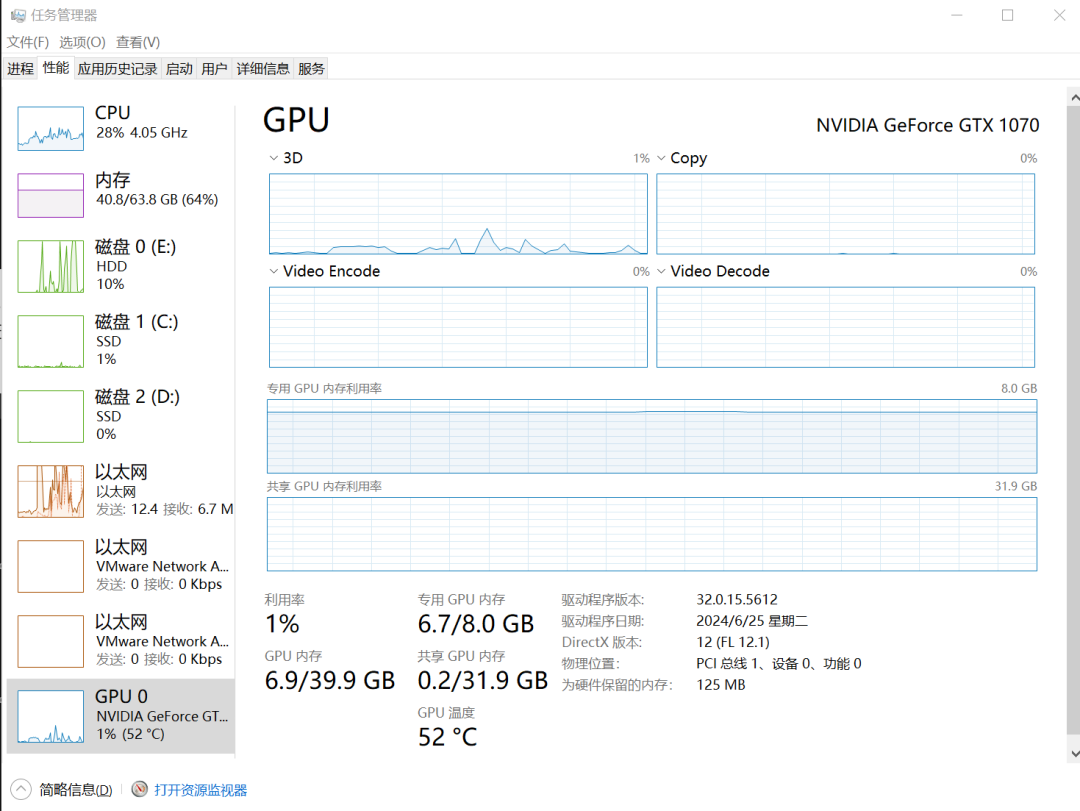
我的显卡是1070,整体用下来,使用率还不算高,大家如果有好的显卡,可以尝试更大的模型:
linux在线安装

curl -fsSL https://ollama.com/install.sh | sh``ollama run llama3

docker

环境变量

描述

默认值

附加说明

OLLAMA_HOST

绑定的主机和端口

"127.0.0.1:11434"

设置 0.0.0.0: 端口号 可以指定所有人访问特定端口

OLLAMA_ORIGINS

允许的跨域源列表,逗号分隔

仅本地访问

设置 "*" 可以避免 CORS 跨域错误,按需设置

OLLAMA_MODELS

模型存放的路径

"~/.ollama/models" 或 "/usr/share/ollama/.ollama/models"

按需指定

OLLAMA_KEEP_ALIVE

模型在显存中保持加载的持续时间

"5m"

按需加载和释放显存可以有效降低显卡压力,但会增加硬盘读写

OLLAMA_DEBUG

设置为 1 以启用额外的调试日志

默认关闭


docker run -d --gpus=all -v ollama:/root/.ollama -e OLLAMA_ORIGINS="*" -p 11434:11434 --name ollama ollama/ollama``docker exec -it ollama ollama run llama3

二、构建自己的Llama3中文模型

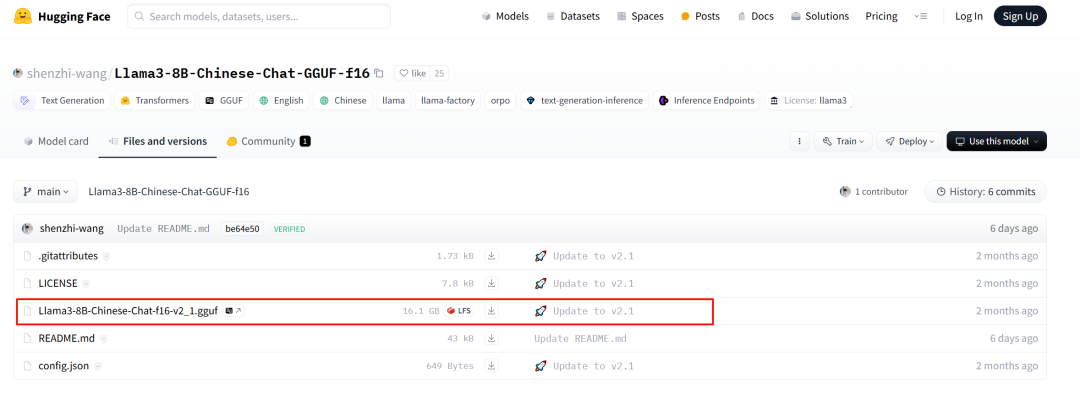
  1. 下载Llama3-8B-Chinese-Chat-f16-v2.gguf

下载地址:https://huggingface.co/shenzhi-wang/Llama3-8B-Chinese-Chat-GGUF-f16/tree/main
  1. 创建文件 Llama3-8B-Chinese-Chat-f16-v2
FROM C:\Users\WUQY\.ollama\models\Llama3-8B-Chinese-Chat-f16-v2.gguf
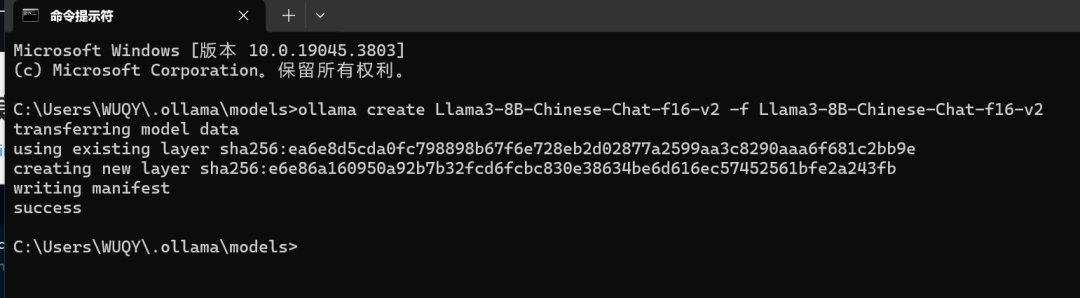
  1. 创建 Ollama 模型
cd /d C:\Users\WUQY\.ollama\models``ollama create Llama3-8B-Chinese-Chat-f16-v2 -f Llama3-8B-Chinese-Chat-f16-v2
![](https://mmbiz.qpic.cn/sz_mmbiz_png/VuibtHqr8zAoqYibExWtD96UZn36kcibhma6ttYY9rpUXhnKXHdU7seZzgZV4J7tZzRQWT5x3VdCiapBELXV3qzquw/640?wx_fmt=png&from=appmsg)  

  1. 运行模型
ollama run Llama3-8B-Chinese-Chat-f16-v2
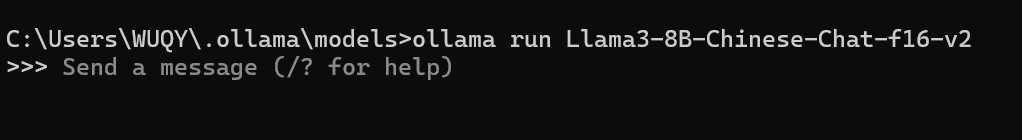
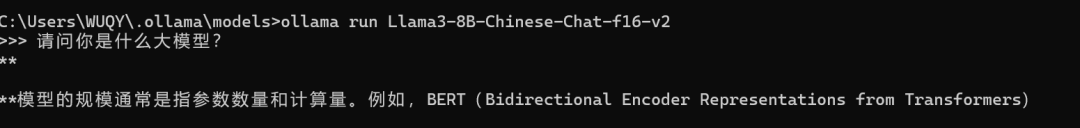
  1. 模型测试

我的电脑测下来这个还是比较慢的,后面经过实测可以直接用这个:https://github.com/Shenzhi-Wang/Llama3-Chinese-Chat

ollama run wangshenzhi/llama3-8b-chinese-chat-ollama-q4  # to use the Ollama model for our 4bit-quantized GGUF Llama3-8B-Chinese-Chat-v2.1``# or``ollama run wangshenzhi/llama3-8b-chinese-chat-ollama-q8  # to use the Ollama model for our 8bit-quantized GGUF Llama3-8B-Chinese-Chat-v2.1``# or``ollama run wangshenzhi/llama3-8b-chinese-chat-ollama-fp16  # to use the Ollama model for our FP16 GGUF Llama3-8B-Chinese-Chat-v2.1

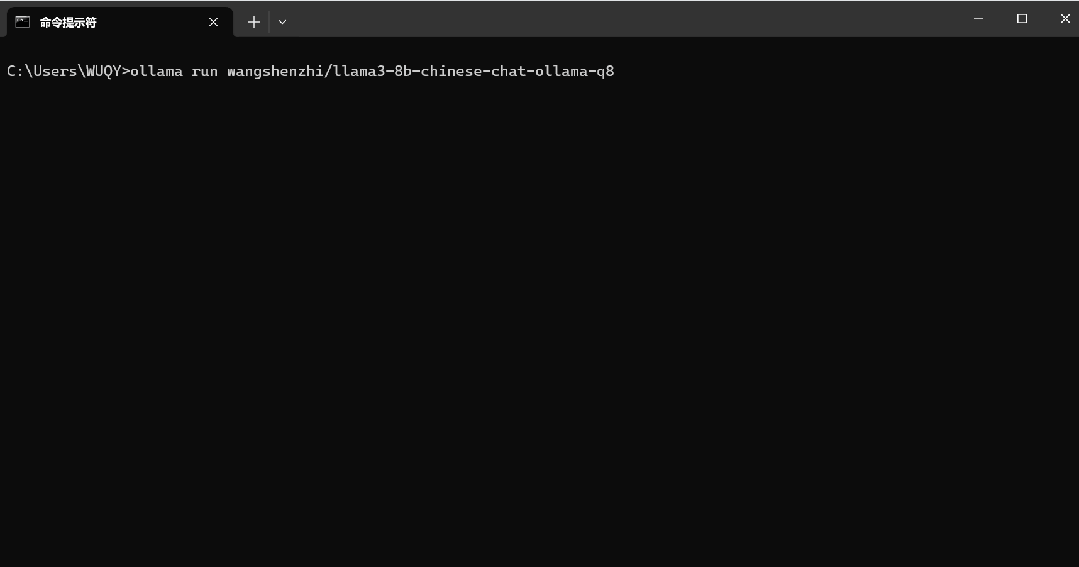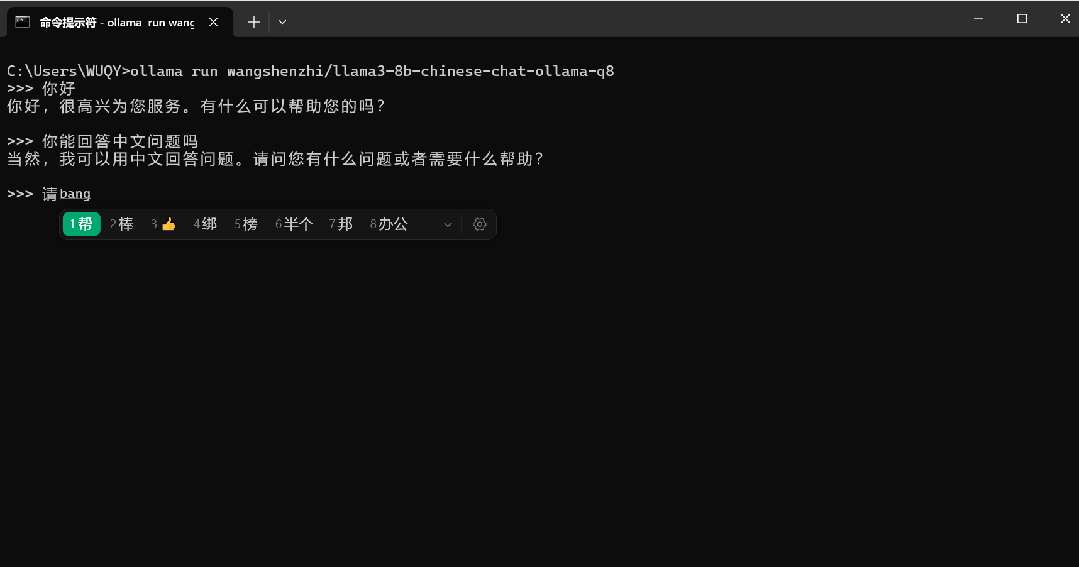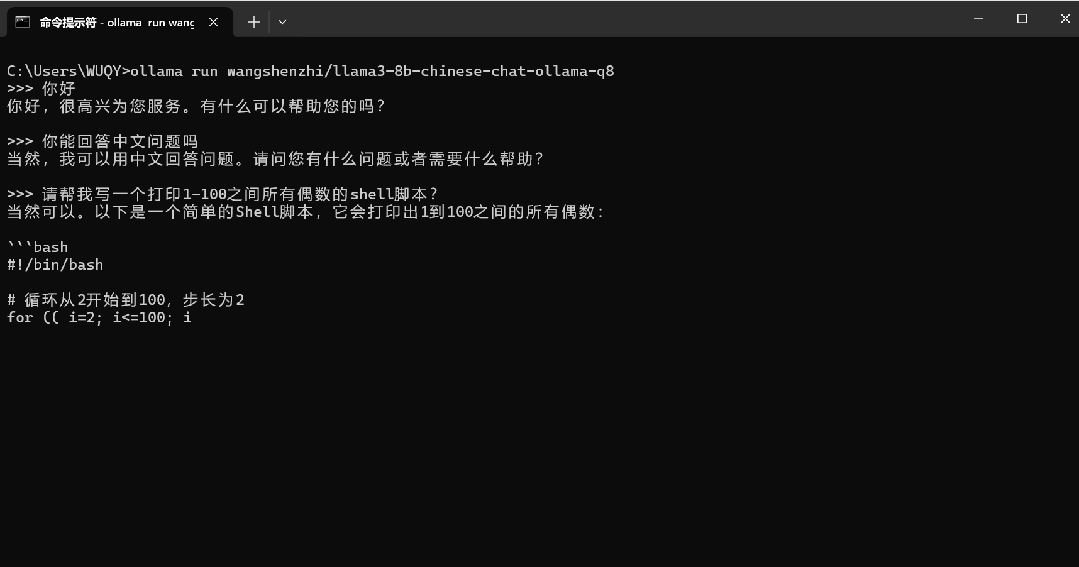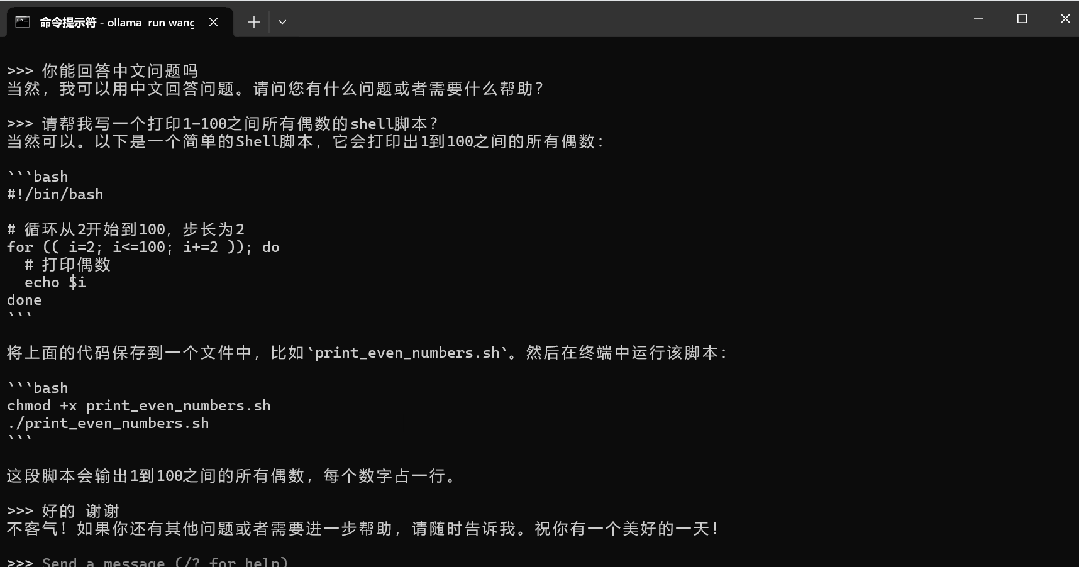
如果你的电脑配置不是很高的话,速度上会快很多。

下面是我在自己的电脑上用wangshenzhi/llama3-8b-chinese-chat-ollama-q8实测的速度:
三、搭建ollama web UI

由于ollama只是一个后台服务,并没有一个可视化的界面,虽然可以在终端窗口中使用,但是有一个漂亮的UI界面会增加体验效果。当然看个人需求,比如我就更喜欢在终端中用。

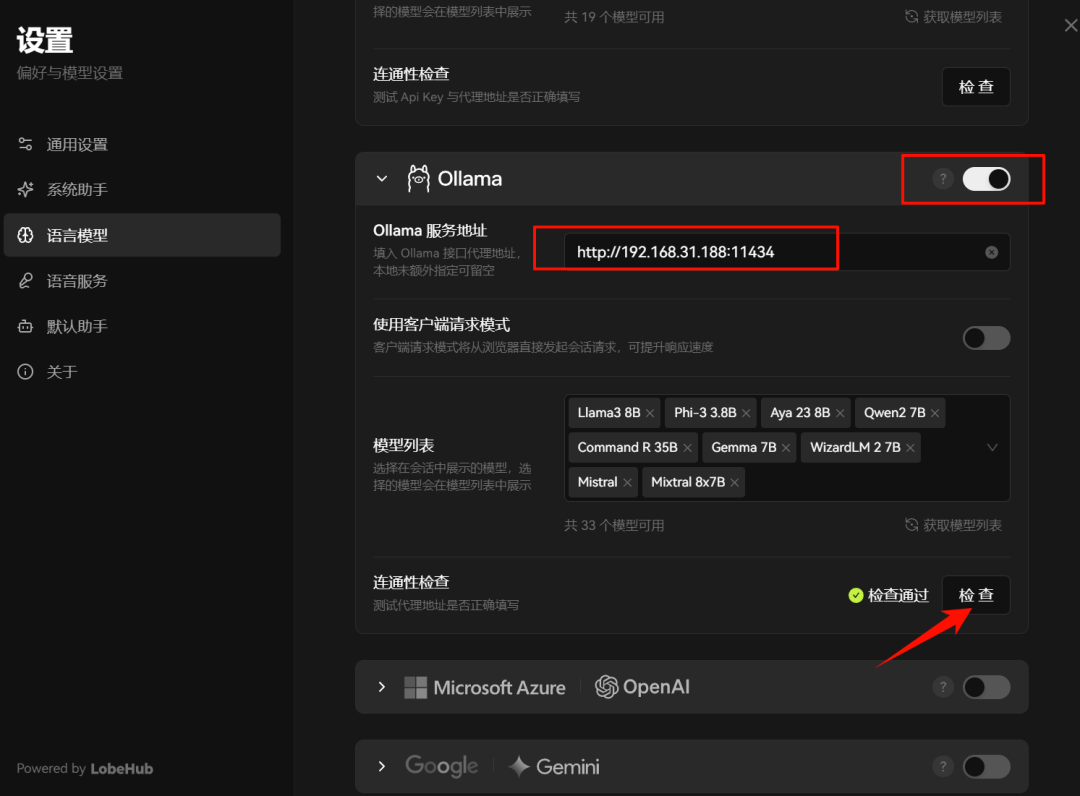
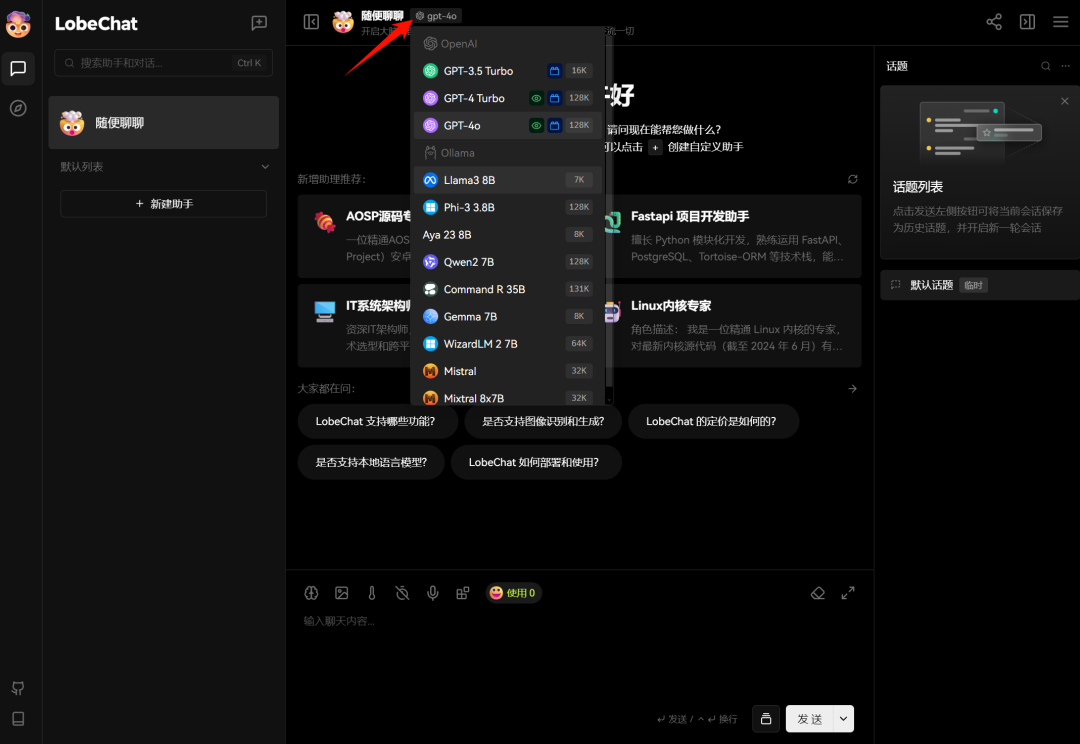
Lobe Chat 是一个开源聊天机器人平台,旨在让开发者轻松构建和部署自定义聊天机器人。Lobe Chat安装完成后,可以使用Lobe Chat来使用AI语言大模型,当然,Lobe Chat不仅支持llama系列模型,还支持一系列其他的大语言模型,可以设置每个模型的API接口以及下载本地模型来使用。LobeChat 作为一款开源的 LLMs WebUI 框架,支持全球主流的大型语言模型,并提供精美的用户界面及卓越的用户体验。该框架支持通过本地 Docker 运行,亦可在 Vercel、Zeabur 等多个平台上进行部署。用户可通过配置本地 Ollama 接口地址,轻松实现 Ollama 以及其他本地模型的集成。

github地址:https://github.com/lobehub/lobe-chat

使用文档参考:https://lobehub.com/zh/docs/usage/providers/ollama

  1. 配置 Ollama 允许跨域访问
  • mac
launchctl setenv OLLAMA_ORIGINS "*"
  • windows

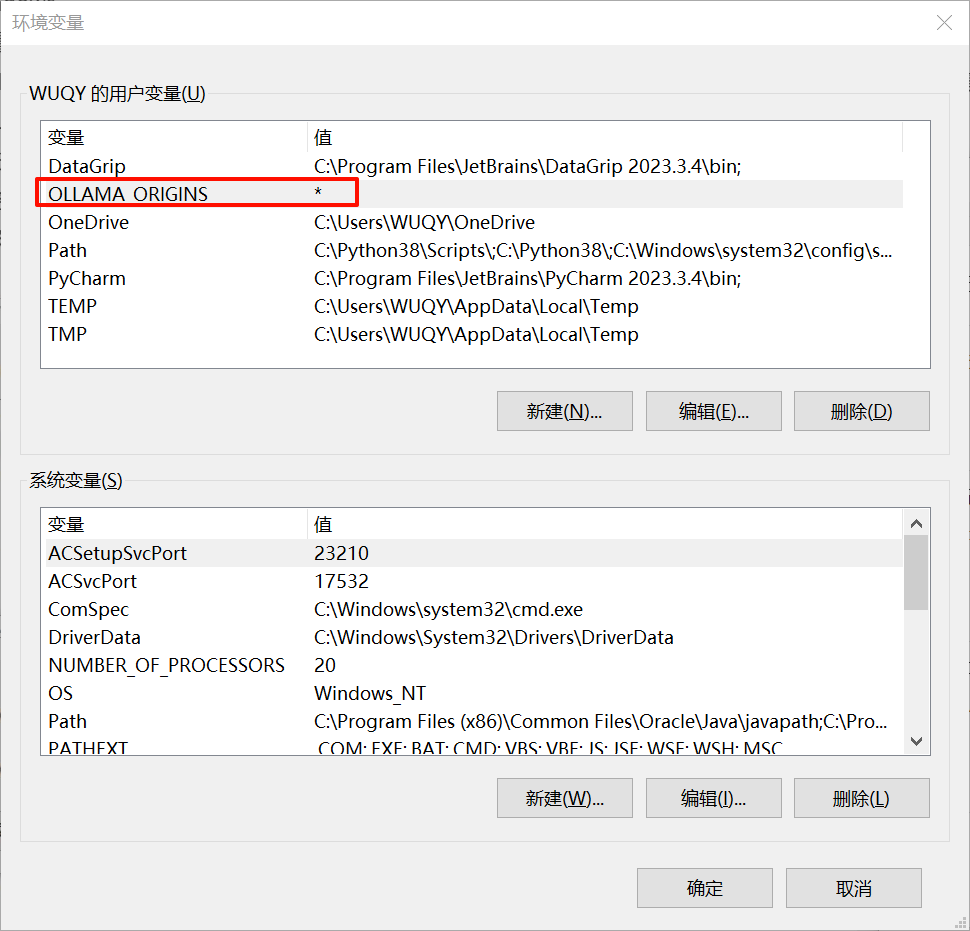
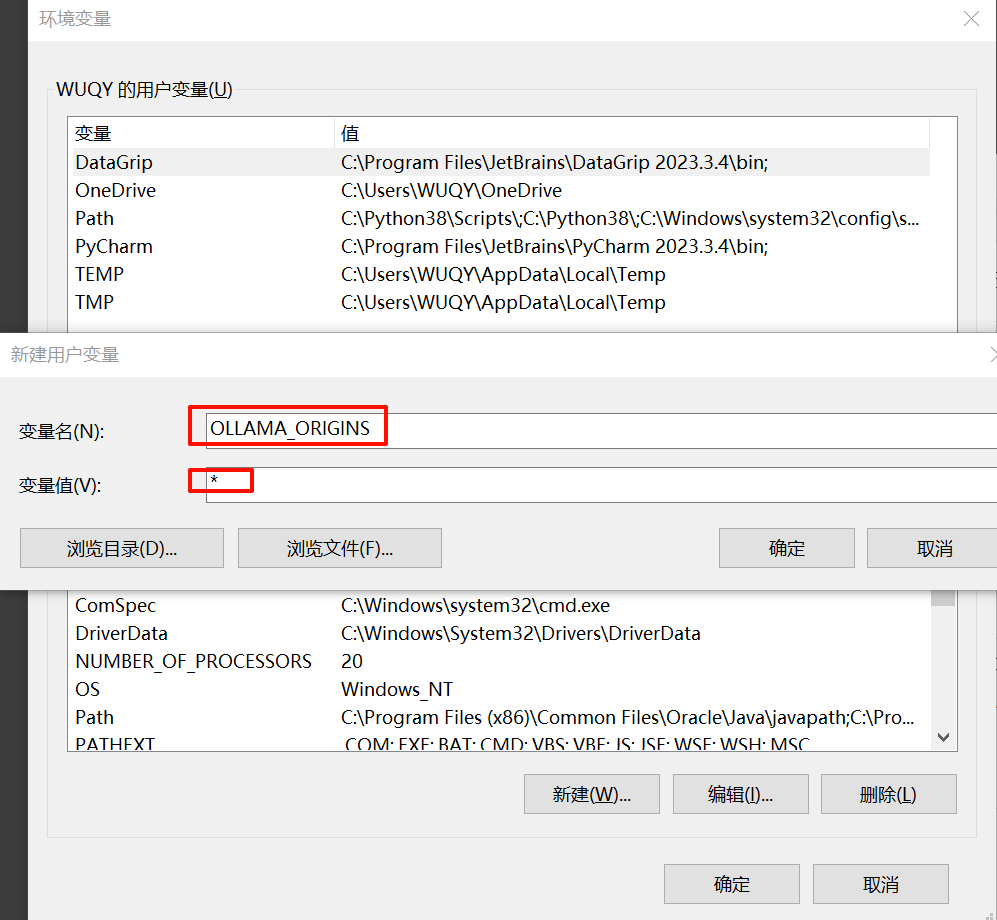
由于 Ollama 的默认参数配置,启动时设置了仅本地访问,所以跨域访问以及端口监听需要进行额外的环境变量设置 OLLAMA_ORIGINS。在 Windows 上,Ollama 继承了您的用户和系统环境变量。

1)首先通过 Windows 任务栏点击 Ollama 退出程序。

2)从控制面板编辑系统环境变量。

3)为您的用户账户编辑或新建 Ollama 的环境变量 OLLAMA_ORIGINS,值设为 * 。
4)点击OK/应用保存后重启系统。

5)重新运行Ollama。

  1. docker 部署
$ docker run -d -p 3210:3210 \`  `-e OLLAMA_PROXY_URL=http://192.168.31.188:11434 \`  `-e ACCESS_CODE=lobe66 \`  `--name lobe-chat \`  `lobehub/lobe-chat

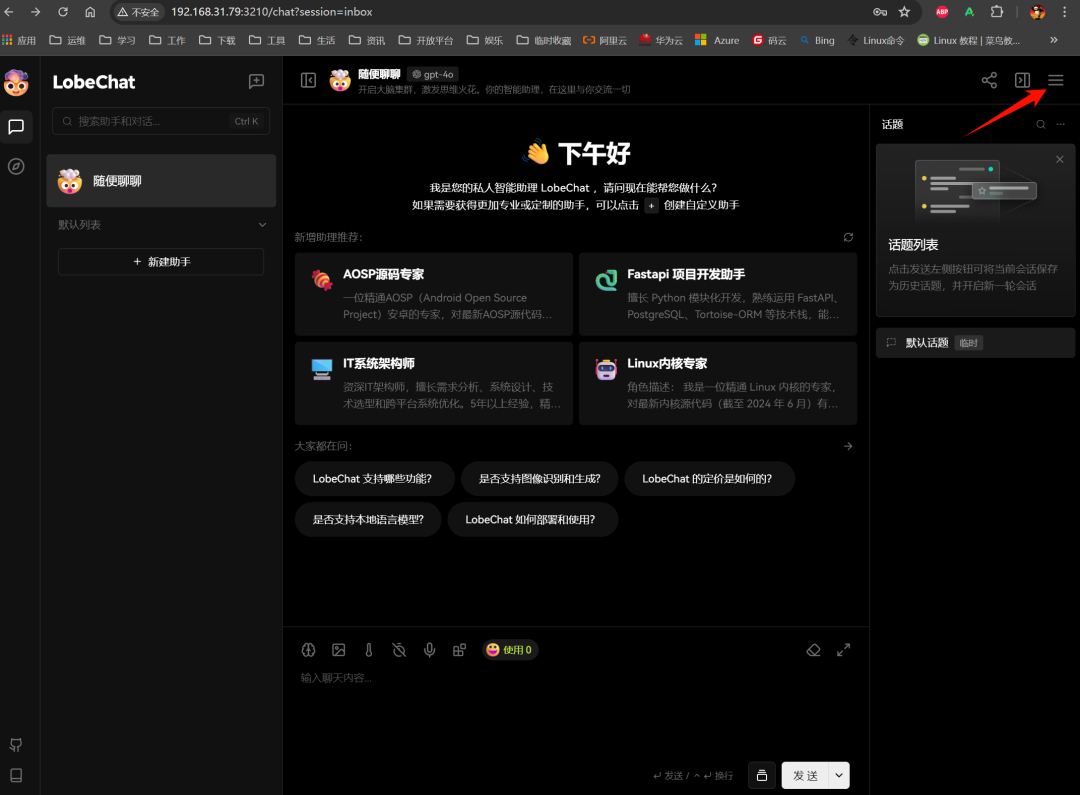
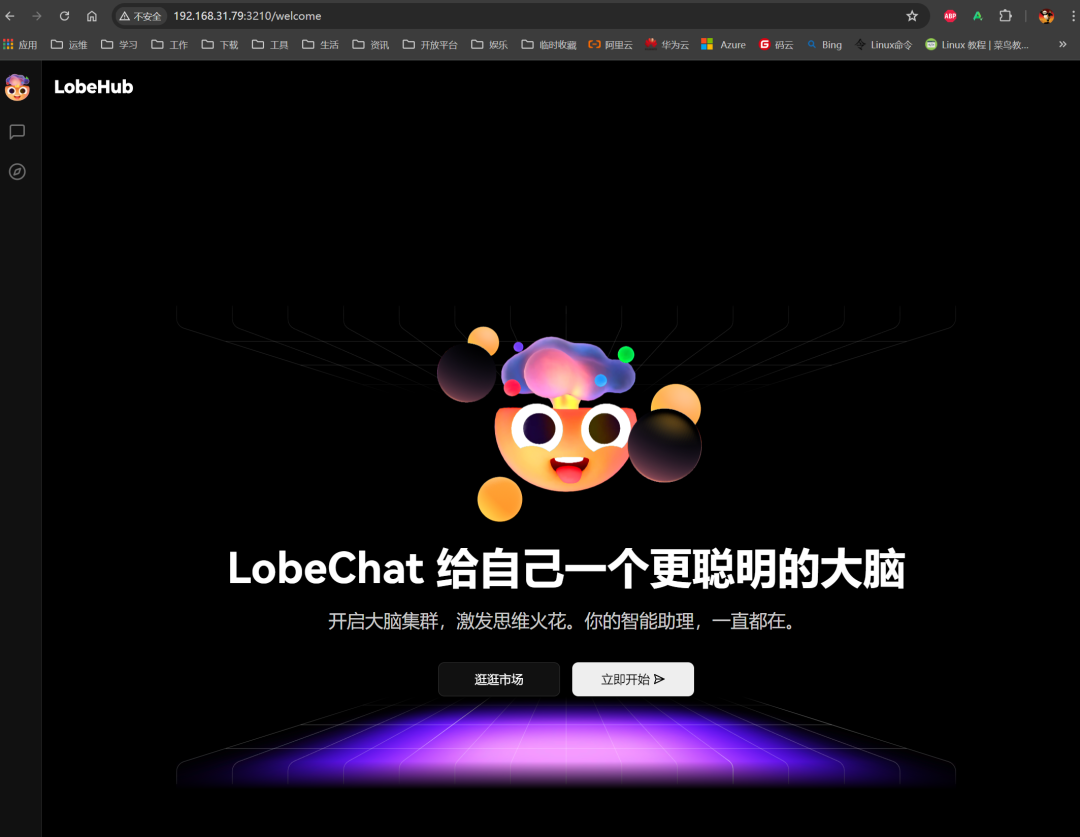
3. web端访问
  1. 配置ollama

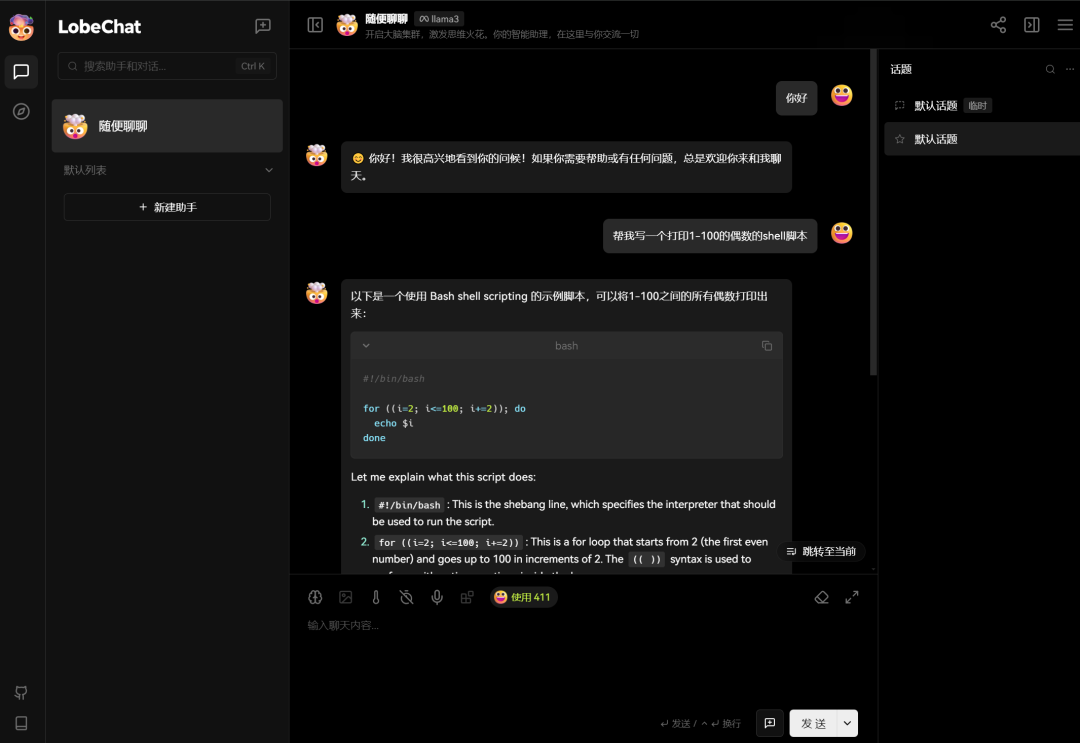
  1. 开始会话

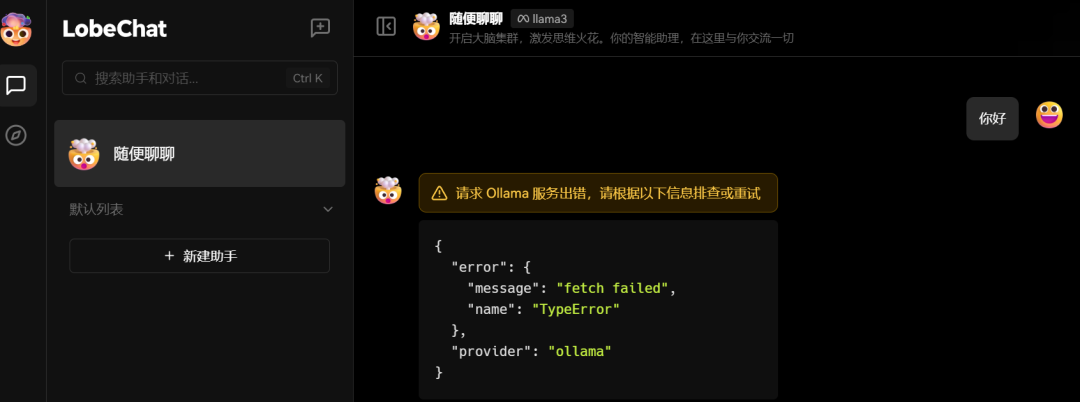
如果设置里面连通性检查没问题,但是会话出现下面的错误:

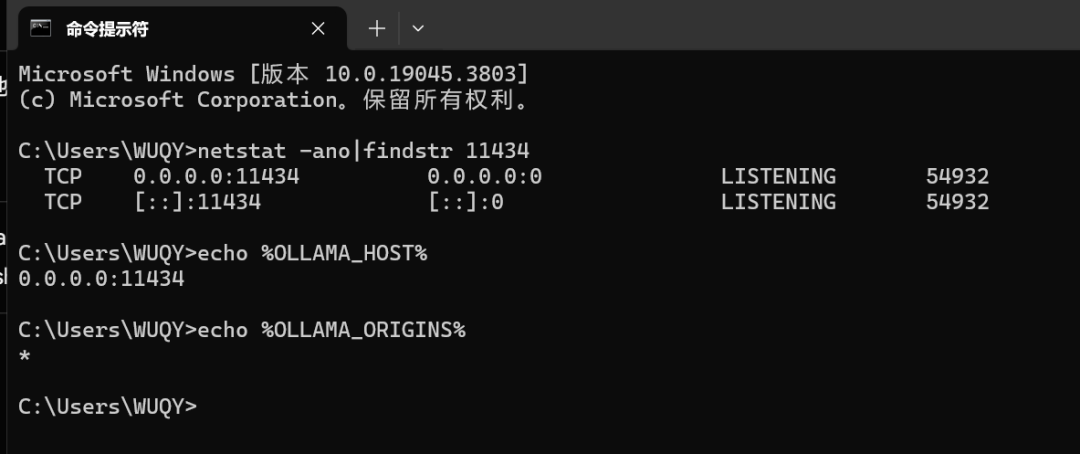
请检查下面ollama的环境变量:

OLLAMA_HOST 0.0.0.0:11434

OLLAMA_ORIGINS *
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Ollama入门教程:从安装到运行的完整指南 随着人工智能(AI)技术的快速发展,大型语言模型(LLMs)逐渐成为了各行各业的重要工具。然而,使用这些强大模型的同时,数据隐私、处理效率和部署复杂度等问题也逐渐浮现。为了解决这些问题,Ollama 提供了一种创新的解决方案——通过本地化部署大型语言模型,不仅能够增强数据隐私性,还能提高模型的运行效率。本文将详细介绍如何下载和安装 Ollama,如何选择和运行不同的语言模型,以及 Ollama 的特点、适用场景、优缺点等内容,帮助大家深入了解这一平台。ollama官网🚪 ollama官方文档🚪 根据自己 阅读详情

相关推荐

Ollama:一个在本地部署、运行大型语言模型的工具

所谓自定义模型就是不适用Ollama官方模型库中的模型,理论可以使用其他各类经过转换处理的模型Ollama库中的模型可以通过提示进行自定义。python复制代码FROM llama3 # 设置温度参数 PARAMETER temperature 1 # 设置SYSTEM 消息 SYSTEM """作为AI智能助手,你将竭尽所能为员工提供严谨和有帮助的答复。"""Modelfile文档One-API是一个OpenAI接口管理 & 分发系统,支持各类大模型。这里使用Docker快速进行部署。拉取镜像。

2401_84495725的博客 6724

ollama实战:搭建你的本地中文大语言模型全攻略!

说到ai,大家应该不陌生了,它应该是目前最火的研究方向之一了,下面是目前比较流行的一些ai(人工智能大模型):openai的chatgptgoogle的GemmaAnthropic的Claude月之暗面的kimi阿里的通义千问百度的文心一言字节跳动的豆包但今天聊的是ollama这个开源框架加上开源模型来实现自己本地的ai。

2401_84204413的博客 2133

Ollama +Mixtral + ChatBox 搭建本地团队使用的大语言模型

使用ollama在本地部署中文大语言模型

weixin_43556377的博客 2255

一文彻底整明白,基于Ollama工具的LLM大语言模型Web可视化对话机器人部署指南

在上一篇博文中,我们在本地部署了**Llama 3 8B**参数大模型,并用 Python 写了一个控制台对话客户端,基本能愉快的与 Llama 大模型对话聊天了。但控制台总归太技术化,体验不是很友好,我们希望能有个类似 ChatGPT 那样的 Web 聊天对话界面,本博文就安排起来……

老牛啊 1万+

不用Docker!3分钟用Ollama+DeepSeek搭建本地AI助手(Windows版)

本文详细介绍了如何在Windows系统上使用Ollama和DeepSeek快速搭建本地AI助手,无需Docker等复杂配置。通过简单的命令行操作,用户可以在3分钟内完成环境部署和模型运行,特别适合中文场景的日常问答和文档处理。文章还提供了性能调优和生产力提升的实用技巧,帮助用户充分利用本地AI资源。

weixin_29084111的博客 249

ISP 基础知识储备

ISP(image signal processing),图像信号处理芯片,在手机摄像头和车载摄像头等领域有着广泛应用,是图像信号处理的核心芯片。 ISP pipeline 流程图如下: 光线经过lens镜头,投射到sensor上,经过光电转换成模拟电信号,再由A/D转换成数字信号,交给ISP芯片进行一系列的处理,在LENS部分也需要进行镜头校正、颜色矫正等一些操作。 然后,得到的bayer ...

qq_39444290的博客 778

使用ollama在本地部署llama3-8b大模型

使用ollama在本地部署llama3-8b大模型

weixin_39945822的博客 1万+

OnlyOffice Docker部署踩坑实录:解决Nginx反向代理导致的editor.bin下载失败

本文详细解析了在Docker中部署OnlyOffice时,因Nginx反向代理配置不当导致editor.bin下载失败的常见问题。通过分析问题根源,提供了从Nginx代理配置、Docker网络设置到OnlyOffice容器内部调整的完整解决方案,并分享了实战调试技巧与性能优化建议,帮助用户彻底解决这一部署难题。

wine的专栏 524

快速搭建本地大语言模型和知识库

本地运行大模型比较耗资源,只能选择较小的模型来作为基础模型中文支持不大好### 导入外部Documents还可以通过UI界面导入website数据以及各种本地文件数据[外链图片转存中...(img-ElrdyjwW-1748264557954)]## 总结总体使用下来有惊喜,但是也有不少的问题:1. 本地运行大模型比较耗资源,只能选择较小的模型来作为基础模型2. 中文支持不大好3. 响应速度慢。

jennycisp的博客 894

保姆级教程:用Python脚本一键把选股结果导入通达信自选股(附完整代码)

本文提供了一份详细的Python自动化教程,教你如何将选股结果一键导入通达信自选股。通过解析通达信文件结构、编写Python脚本实现股票代码转换和批量导入,大幅提升量化交易效率。教程包含完整代码示例,特别适合使用通达信(TDX)的投资者和量化交易开发者。

weixin_30915951的博客 361

LoRaWAN数据包分析工具

前言:LoRaWAN的射频数据包是加密的,而且有些字段是某个字节的某几位,看着不是那么直观,因此在某些情况下需要借助工具来分析数据包。 1、安装npm 这个工具是用JavaScript写的,其中用到了一些依赖库,而npm就可以一次性把这些依赖库下载下来,因此我们先要下载安装npm这个工具。 安装:sudo apt install npm 输入y,等待安装完成: 检查是否安装成功:npm -v 说明安装完成。 2、安装LoRa数据包分析工具lora-packet 安装:npm i.

freemote的博客 4633

Ollama与qwen2.5:7b本地大语言模型部署指南

大语言模型(LLM)作为当前AI领域的重要技术,通过海量参数实现自然语言理解与生成。其核心原理基于Transformer架构,通过自注意力机制处理长距离依赖关系。本地部署LLM能有效解决数据隐私和网络延迟问题,特别适合开发测试和敏感数据场景。Ollama作为轻量级工具链,封装了模型加载、硬件适配等工程细节,大幅降低部署门槛。结合通义千问团队开源的qwen2.5:7b模型,可在消费级GPU上实现高效推理。本文以NVIDIA显卡和CUDA加速为例,详细演示如何通过量化技术和参数调优,在有限显存条件下运行70亿参

weixin_29072299的博客 194

本地 Ollama 安装大模型完整教程

>> 请总结以下文章的主要内容:[粘贴文章内容]创建Modelfile# 设置系统提示词SYSTEM """你是一个专业的编程助手,擅长 Python 和 JavaScript。请用简洁、专业的语言回答问题。"""# 设置参数Ollama 让本地运行大模型变得异常简单:✅安装简单,一键部署完全离线,保护隐私模型丰富,选择多样免费开源,持续更新支持 GPU 加速⚠️大模型需要较多内存和存储中文场景建议选择中文优化模型首次下载模型需要时间。

weixin_42551921的博客 1157

六轴机器人正解

采用的是John H.Craig在【机器人学导论】中的改进DH模型 1.六轴坐标系 2.DH参数 i αi−1\alpha_{i-1}αi−1​ ai−1a_{i-1}ai−1​ did_idi​ θi\theta_iθi​初值 1 0 0 0 0 2 -90 a1a_1a1​ 0 -90 3 0 a2a_2a2​ 0 -90 4 -90 a3a_3a3​ d4d...

m0_37581770的博客 2511

操作系统课程项目 OS project —— Pintos from Project 1 to Project 3

Pintos Project 陪伴我们操作系统课程大半个学期了…… 虽然做了这么长时间,个人能力有限,pintos代码,看过的可能也就看懂了一半吧,更不用说没看过的了…… 但是也找到了一些有价值的资料,整理一下,供后辈们参考…… 关于环境的问题,最好是用ubuntu 16.04 windows用户不要折腾装双系统了,特别是win10,动不动更新一下,说不定双系统就出问题了,linux...

Deserted Land 8557

本地大模型OCR集成:用PaddleOCR与Ollama构建图像文本智能处理管道

OCR(光学字符识别)技术通过计算机视觉算法将图像中的文字转换为可编辑文本,是文档数字化和信息提取的基础。其核心原理通常基于深度学习模型进行文本检测与识别。这项技术的价值在于打通了物理文档与数字系统之间的桥梁,是实现自动化办公、智能文档管理的关键环节。在实际应用中,OCR常与自然语言处理技术结合,用于合同解析、票据处理、知识库构建等场景。本文聚焦于将OCR与本地部署的大语言模型(LLM)相结合,通过PaddleOCR实现高精度文字提取,并利用Ollama框架管理本地大模型进行语义理解与生成,构建一个完全在本

weixin_30859423的博客 426

超简单五步实现VOS3000客户端呼入配置

1.查看SIP代理  在注册管理中查看自己线路注册的SIP代理IP地址,记录下来。 2.创建普通账户  创建一个呼入使用的普通账号,选择“计费费率”,根据自己情况选择费率,这里做测试就配置了免费的费率,如果费率不是免费,需要给这个普通账户充值。 3.新建对接网关 新建一个对接网关,点击该网关的“补充设置”,选择“网关类型”为静态IP,然后在IP地址栏填上刚才在注册管理里面记录的SIP代...

非著名运维的博客 1万+

本地大模型应用实战:Dify + Ollama + Qwen2

本指南介绍如何使用 Dify、Ollama 和 Qwen2 构建本地大语言模型应用。这套技术栈具有以下优势: 完全本地化:数据不出本地,隐私安全 成本低廉:无需付费 API 调用 灵活可控:可自定义模型和应用 易于扩展:支持多种模型和应用场景

d3y1`5 81_09 1155

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【必藏】零代码搭建本地AI知识库:从显卡选择到完整部署指南,小白也能轻松上手!

大模型学习指南:零基础快速入门 1️⃣ 核心路线: 理论筑基:掌握Transformer架构、注意力机制等基础概念 工具准备:Python+PyTorch必备,推荐Colab免费GPU资源 模型实践:从BERT/GPT-2等轻量模型入手,逐步接触LLaMA、Qwen等开源大模型 2️⃣ 学习资源包: ✅ 精选论文解读(含《Attention Is All You Need》逐行注释版) ✅ 50+实战Notebook(文本生成/微调/知识蒸馏等场景) ✅ 中文大模型训练数据集(500GB清洗后语料) ✅ 最

ytt0523_com的博客 678

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

(2026年最新版)手把手教你搭建本地知识库:个人与中小企业专属指南

本文将为你提供一份零代码、面向实际应用的本地知识库搭建教程,涵盖模型选择、显卡推荐、后端部署工具(如 Ollama、LM Studio)到用户界面的完整链条,特别适配2025年主流的NVIDIA 40/50系列显卡,助你轻松打造专属AI知识助手。

python1234567_的博客 5629

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

OpenClaw对接ollama-QwQ-32B实战:本地部署与模型调用全流程

本文介绍了如何在星图GPU平台上自动化部署【ollama】QwQ-32B镜像,实现本地大模型的高效调用。通过OpenClaw工具与QwQ-32B的组合,开发者可构建安全的数据处理流程,如自动整理文档、提取PDF关键信息等,确保敏感数据不出本地。该方案特别适合需要隐私保护的AI应用场景。

NightshadeEagle34的博客 300

LangFlow是否支持中文?多语言处理能力测试与优化部署方案

本文介绍了如何在星图GPU平台上自动化部署LangFlow镜像,快速构建可视化AI应用工作流。通过集成Ollama等本地大模型,该方案能便捷地搭建智能客服、内容分析等中文场景应用,有效降低多语言AI应用的开发门槛。

weixin_35751194的博客 790

大语言模型实战——最小化模型评测:用 ollama + qwen 跑通 F1 值验证

用 ollama 拉起 qwen 后,先跑一条 jsonl 数据验证链路,再写 config.toml 与评测脚本算 F1 值。本文给出可复制命令与代码,把大语言模型评测拆成预测、清洗、打分三步,并附 TaoToken 统一接口配置,方便切换模型来源。详见 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_35756130的博客 14

granite-4.0-h-350m中文微调指南:Ollama本地大模型定制化训练教程

本文介绍了如何在星图GPU平台上自动化部署【ollama】granite-4.0-h-350m镜像,并利用该镜像进行本地大模型定制化训练。通过微调,用户可以让这个轻量级模型学习特定领域的知识和风格,例如生成符合项目规范的代码注释或撰写特定语气的邮件,从而打造个性化的AI助手。

weixin_42518334的博客 224
上一篇: 大语言模型SFT的业务开发流程
下一篇: 74MB跑GPT!CPU单核就能聊天的超轻量“大”模型来了
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值