利用Python爬虫实现数据收集与挖掘

超详细Python教程——网络数据采集概述 爬虫(crawler)也经常被称为网络蜘蛛(spider),是按照一定的规则自动浏览网站并获取所需信息的机器人程序(自动化脚本代码),被广泛的应用于互联网搜索引擎和数据采集。使用过互联网和浏览器的人都知道,网页中除了供用户阅读的文字信息之外,还包含一些超链接,网络爬虫正是通过网页中的超链接信息,不断获得网络上其它页面的地址,然后持续的进行数据采集。正因如此,网络数据采集的过程就像一个爬虫或者蜘蛛在网络上漫游,所以才被形象的称为爬虫或者网络蜘蛛。 阅读详情

Python爬虫是一种自动化程序,可以模拟浏览器行为,自动地从互联网上抓取、分析和收集数据。Python爬虫通常使用requests、selenium等库来发送HTTP请求,获取网页内容,并使用BeautifulSoup、lxml等库来解析网页,提取所需的数据。
在这里插入图片描述

以下是一个简单的Python爬虫示例,用于从某个网页上抓取数据:

import requests  
from bs4 import BeautifulSoup  
  
# 发送HTTP请求,获取网页内容  
url = 'https://example.com'  
response = requests.get(url)  
html = response.text  
  
# 使用BeautifulSoup解析网页  
soup = BeautifulSoup(html, 'html.parser')  
  
# 提取所需的数据  
titles = soup.find_all('h1')  
for title in titles:  
    print(title.text)

上述代码中,我们首先使用requests库发送HTTP请求,获取指定URL的网页内容。然后,我们使用BeautifulSoup库解析网页,并查找所有的h1标签。最后,我们遍历所有的h1标签,并打印出它们的文本内容。

当然,实际的爬虫程序可能会更加复杂,需要处理各种异常情况、使用代理IP、设置请求头等信息,以避免被网站屏蔽或限制。同时,我们也需要注意遵守网站的爬虫协议和法律法规,不要进行恶意爬取或滥用爬虫技术。

除了上述示例中的requests和BeautifulSoup库之外,Python爬虫还可以使用其他库和工具来提高效率和准确性。例如,Scrapy是一个强大的Python爬虫框架,可以帮助我们快速地构建高效的爬虫程序。Selenium库可以模拟真实的浏览器行为,以应对一些反爬虫机制。同时,我们还可以使用各种数据库或存储技术来保存和处理爬取到的数据。

需要注意的是,爬虫技术有一定的技术门槛和法律风险,建议在使用前充分了解相关法律法规和平台规定,并谨慎操作。

爬虫的高级特性
    1. 动态内容爬取:有些网页使用JavaScript动态加载内容。这种情况下,直接使用requests库可能无法获取到全部内容。解决方案包括使用Selenium(模拟真实浏览器环境)或Pyppeteer(控制无头Chrome或Chromium浏览器)来加载和执行JavaScript。
    1. 处理Cookies和Sessions:对于需要登录的网站,爬虫需要处理Cookies和Sessions以保持登录状态。requests.Session对象可以自动处理Cookies,使得在多个请求之间保持会话状态。
    1. 设置请求头:为了避免被网站识别为爬虫并阻止访问,通常需要设置请求头(User-Agent等),以模拟正常浏览器访问。
    1. 处理分页和异步加载:对于分页或异步加载的内容,需要分析网站的请求方式,模拟相应的请求以获取完整数据。
    1. 数据清洗和存储:爬取到的数据通常需要进行清洗和整理,以便后续分析。可以使用pandas库进行数据清洗,并将数据保存到CSV、Excel、数据库等。
    1. 多线程/异步爬虫:为了提高爬虫效率,可以使用多线程(threading模块)或异步IO(如asyncio库)来并发发送请求。
    1. **遵守robots.txt**:在爬取网站之前,应检查robots.txt文件,以确保你的爬虫遵循网站所有者的规定。
    1. 错误处理和日志记录:爬虫程序应包含错误处理机制,并记录详细的日志以便于调试和监控。
操作代码示例(使用Selenium)

以下是一个使用Selenium爬取动态加载网页内容的简单示例:

from selenium import webdriver  
from selenium.webdriver.common.by import By  
from selenium.webdriver.support.ui import WebDriverWait  
from selenium.webdriver.support import expected_conditions as EC  
  
# 启动Chrome浏览器(需要安装对应的ChromeDriver)  
driver = webdriver.Chrome()  
  
# 打开目标网页  
driver.get("https://example.com/dynamic-page")  
  
# 等待某个元素加载完成(例如:一个特定的ID或类名)  
element = WebDriverWait(driver, 10).until(  
    EC.presence_of_element_located((By.ID, "dynamic-content"))  
)  
  
# 提取所需数据(这里以文本为例)  
content = element.text  
print(content)  
  
# 关闭浏览器窗口  
driver.quit()

在这个示例中,我们使用了Selenium来启动一个真实的Chrome浏览器窗口,并等待动态加载的内容出现后再提取数据。这种方式比单纯使用requests库更强大,但也会消耗更多的资源,并且运行速度可能较慢。

请注意,在使用Selenium时,你需要确保已经安装了对应的WebDriver(如ChromeDriver),并且它与你的浏览器版本兼容。此外,Selenium爬虫更容易被网站检测到,因此在使用时应谨慎。

爬虫的应用场景
    1. 数据收集与挖掘:爬虫可以用于收集特定领域的数据,如市场价格、竞争对手分析、学术研究等。
    1. 内容聚合:例如新闻聚合网站,通过爬虫实时抓取各大新闻源的最新报道。
    1. 搜索引擎优化:搜索引擎使用爬虫(也称为网络蜘蛛或机器人)来索引互联网上的内容,以便为用户提供搜索服务。
    1. 安全与渗透测试:在网络安全领域,爬虫可用于检测网站的安全漏洞。
爬虫开发的关键步骤
    1. 确定目标:明确需要爬取的数据类型和目标网站。
    1. 分析网站结构:了解目标网站的HTML结构、URL格式、可能存在的反爬虫机制等。
    1. 设计爬虫策略:选择合适的库(如requests、BeautifulSoup、Scrapy等),编写爬虫逻辑。
    1. 发送请求并处理响应:模拟浏览器向服务器发送请求,接收并解析服务器的响应。
    1. 提取数据:从响应内容中提取所需的数据。
    1. 存储数据:将数据保存到本地文件、数据库或其他存储系统中。
    1. 测试和调优:测试爬虫的准确性和性能,根据实际情况进行调整和优化。
注意事项与合规性
    1. 遵守法律法规:在爬虫开发过程中,必须遵守相关的法律法规,如版权法、个人信息保护法等。
    1. 尊重网站的爬虫协议:检查并遵守目标网站的robots.txt文件中的规定。
    1. 避免对目标网站造成过大负担:合理设置爬虫的请求频率,避免对目标服务器造成过大的访问压力。
    1. 数据准确性和时效性:确保爬取的数据准确无误,并关注数据的更新频率。
    1. 网络安全和隐私保护:在爬虫开发过程中,要注意网络安全和隐私保护,避免泄露敏感信息。
示例代码(使用Scrapy框架)

Scrapy是一个强大的Python爬虫框架,可以简化爬虫的开发过程。以下是一个简单的Scrapy爬虫示例:

import scrapy  
  
class MySpider(scrapy.Spider):  
    name = 'example_spider'  
    start_urls = ['https://example.com']  
      
    def parse(self, response):  
        for title in response.css('h1.title'):  # 假设网页中的标题位于h1标签中,且有一个'title'的类名  
            yield {'title': title.get_text()}

在这个示例中,我们创建了一个名为MySpider的爬虫类,它继承自scrapy.Spider。我们定义了爬虫的起始URL和解析方法。在parse方法中,我们使用CSS选择器来定位并提取网页中的标题文本。最后,我们使用yield语句将提取的数据以字典的形式返回。

请注意,这只是一个简单的示例,实际的爬虫代码可能会更加复杂,并需要处理各种异常情况和反爬虫机制。

最后,这里免费分享给大家一套免费的学习资料,包含视频、源码/电子书,希望能帮到那些不满现状,想提升自己却又没有方向的朋友,也可以加我微信一起来学习交流。

在这里插入图片描述

① Python方向的学习路线图,清楚各个方向要学什么东西

② 100多节Python课程视频,涵盖必备基础、爬虫和数据分析

③ 100多个Python实战案例,学习不再是只会理论

④ Python漫画教程,手机也能学习

在这里插入图片描述

一、Python所有方向的学习路线

Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

二、学习软件

工欲善其事必先利其器。学习Python常用的开发软件都在这里了,给大家节省了很多时间。
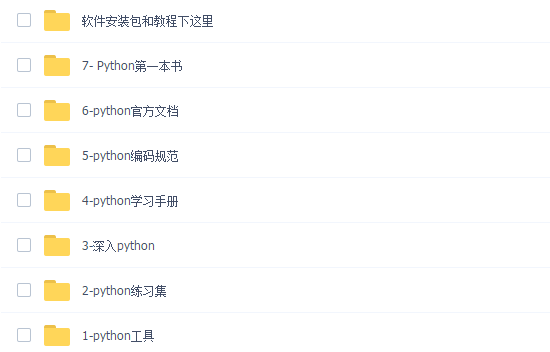
三、全套PDF电子书

书籍的好处就在于权威和体系健全,刚开始学习的时候你可以只看视频或者听某个人讲课,但等你学完之后,你觉得你掌握了,这时候建议还是得去看一下书籍,看权威技术书籍也是每个程序员必经之路。

在这里插入图片描述

四、入门学习视频

我们在看视频学习的时候,不能光动眼动脑不动手,比较科学的学习方法是在理解之后运用它们,这时候练手项目就很适合了。
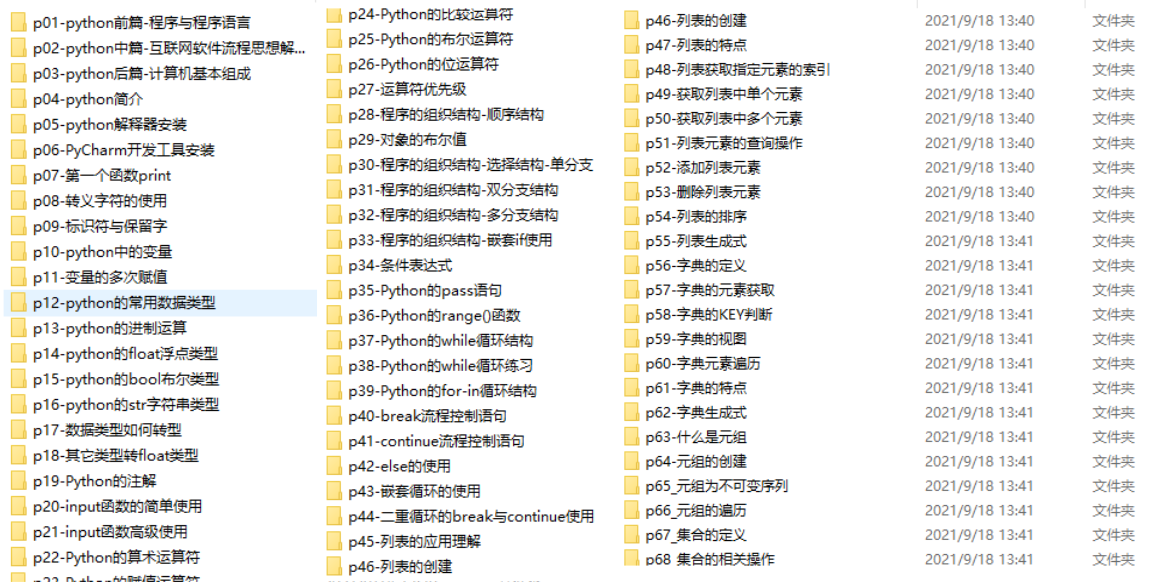
四、实战案例

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
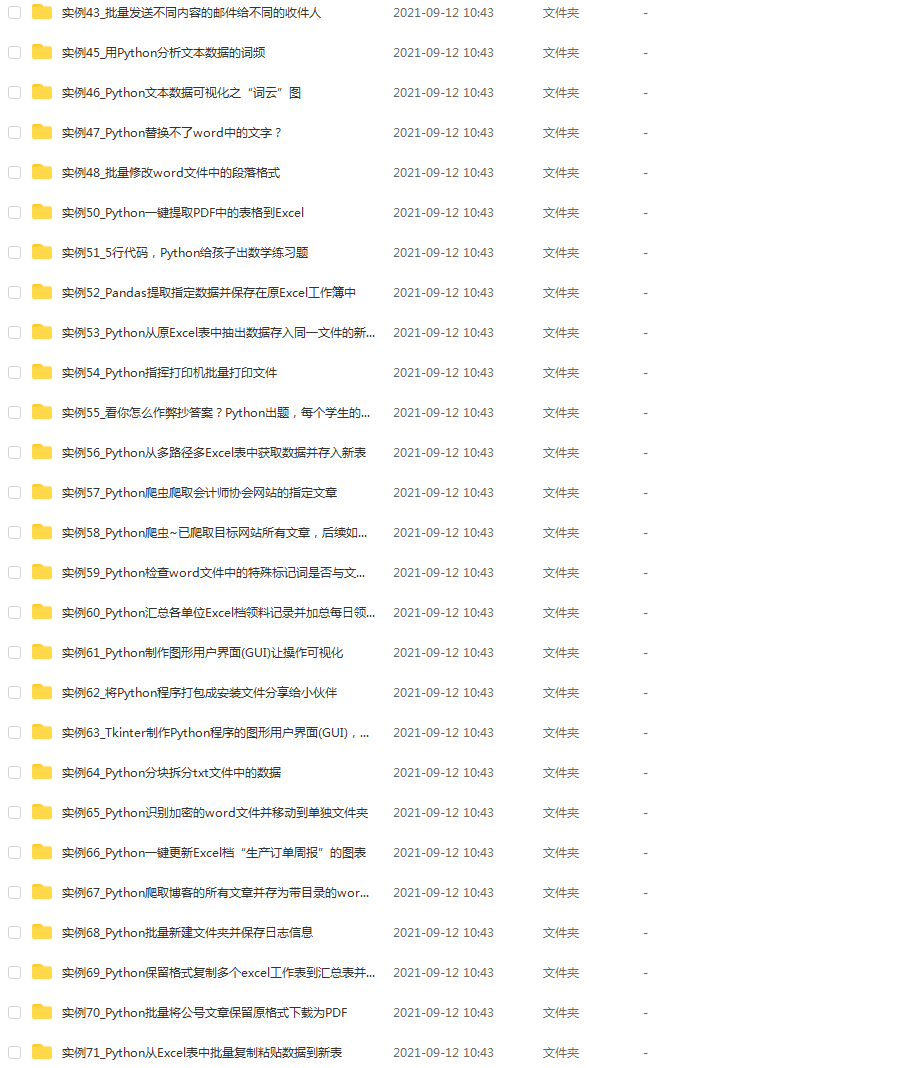
**学习资源已打包,需要的小伙伴可以戳这里【学习资源】

基于Python爬虫的新闻热点分析与挖掘 本文介绍了基于Python爬虫的新闻热点分析与挖掘方法,主要包括数据收集、预处理、热点分析和可视化四个部分。首先通过爬虫抓取新浪新闻数据,利用文本清洗和存储技术进行数据预处理;接着采用TF-IDF和LDA算法进行关键词提取与主题建模;最后通过词云图和主题分布图实现数据可视化。该方法能有效识别新闻热点,为信息筛选和决策提供支持。 阅读详情

相关推荐

超强干货之---Python-数据爬取(爬虫)

定义: 深度优先搜索是一种遍历或搜索树或图的算法,从起始节点开始,一直沿着一个分支走到底,再回溯到上一个节点继续搜索下一个分支,直到遍历完所有节点。特点递归:通常用递归实现,或者使用栈来模拟递归过程。内存占用低:在有大量分支的情况下,内存占用比广度优先搜索低。适合目标较深的情况:如果目标节点距离起始节点较深,DFS能更快找到目标。适用场景需要遍历所有节点的情况,如生成树、迷宫搜索。目标节点较深,且分支较多时。在大规模数据爬取时,选择合适的存储方式取决于数据的规模、结构和访问需求。

房东的猫的博客 5万+

爬虫数据采集基础

1

m0_46427459的博客 7869

Python网络爬虫的设计与实现研究

摘要:随着互联网技术的快速发展,网络爬虫作为获取互联网信息的重要工具,其在数据分析、数据挖掘、自然语言处理等领域的应用越来越广泛。本文首先对网络爬虫的基本原理进行了介绍,然后详细阐述了基于Python的网络爬虫设计与实现过程,包括爬虫架构的选择、网页抓取、数据解析、数据存储等方面。URL管理器负责维护一个待爬取的URL队列,网页下载器负责从URL队列中取出URL并下载对应的网页内容,网页解析器负责对下载的网页内容进行解析和提取所需信息,数据输出器负责将提取的信息以指定格式输出。关键词:Python;

铭渊老黄 2563

数据收集—自动化采集脚本(爬虫)

1、什么叫自动化采集脚本:自动去采集网站上我们需要的数据。2、批量采集数据:谷歌浏览器—百度—东方财富网。①安装(pip install)和导入模块(import);②本次操作需要的模块requests、pandas、re;re不用安装,是python自带的。③模块说明:requests—用来请求网站的数据;pandas—用来操作表格;re—用来筛选数据的。3、爬虫:请求某一个网站的数据。①确定目标:请求哪一个网址;②以什么样的身份去请求?③请求。

捡垃圾的朵 6314

ANSYS Twin Builder实战:5步搞定数字孪生模型部署(附ROM配置技巧)

本文详细解析了ANSYS Twin Builder在数字孪生模型部署中的实战应用,重点介绍了ROM(降阶模型)配置技巧。通过5个关键步骤,从环境搭建到工业部署,帮助工程师高效实现高精度三维仿真到轻量化数字孪生的转化,提升预测性维护和系统仿真效率。

weixin_27330481的博客 661

EB配置输入捕获ICU模块----基于S32K3

基于S32K311芯片,EB配置ICU输入捕获(Emios 和Siul)

weixin_43586400的博客 1772

适合零基础 Python爬虫数据采集的4种方式

本文总结比较了4种爬虫采集数据的方法,每种方法都有自己的利弊,当然,在实际的问题中,并不是用的工具或方法越高级就越好,具体问题具体分析嘛~

weixin_55154866的博客 4443

第9章:Embedding、Pooling 与检索增强基础

本文介绍了律师事务所如何利用vLLM构建法律文档RAG系统,解决传统关键词检索在语义匹配上的不足。主要内容包括: 项目背景:传统Elasticsearch检索在法律术语上的低准确率问题,及多模型维护的复杂性; 技术方案:采用vLLM统一支持生成和向量化能力,通过语义向量检索提升相关性; 关键实现: 用vLLM的Embedding端点处理文档向量化 构建包含离线索引和在线检索的完整RAG流程 采用余弦相似度进行语义匹配 实践建议:切片大小选择、向量归一化处理、不同场景下的数据库选型等。

davidwang456的专栏 60

利用Python爬虫实现高效数据收集与挖掘实战指南

在当今数据驱动的时代,如何高效获取互联网上的海量数据成为许多企业和研究者的核心需求。Python凭借其丰富的爬虫库和简洁的语法,成为了数据采集领域的首选工具。Python爬虫技术为数据收集提供了强大工具,结合数据挖掘技术可以从中提取有价值的信息。希望本文能帮助你快速入门Python爬虫与数据挖掘,在实际项目中创造价值!网络爬虫(Web Crawler)是一种自动抓取互联网信息的程序,它通过模拟浏览器行为访问网页并提取所需数据。Requests:简洁的HTTP请求库。Scrapy:专业的爬虫框架。

Python_trys的博客 1312

包络检波电路(Envelope Detector)

把 100 kHz 载波想象成"电台的高频信号",把 1 kHz 包络想象成"主持人说话的声波"。而今天电路的工作,就是把这个"调大调小的外壳"(包络)重新剥出来,还原成主持人的声音 🎵。这是三极管开关电路的重要搭档,也是从"二极管家族"过渡到"三极管家族"的桥梁 🔌。——倍压整流看的是"幅值累积"(多个电容接力),包络检波看的是"频率分离"(高低频分开)。同样的"D1 串联 + RC 并联"拓扑,今天被赋予了"AM 解调"的新生命。——电感负载的"泄洪闸",保护三极管开关不被反向电动势击穿。

飞多学堂的博客 94

【全网首发】2026华为OD双机位C卷 机考真题题库含考点说明以及在线OJ (Java)

如果你收到的是双机位C卷考试通知,需要针对性地调整备考策略。自2025年11月19日起,华为OD机试已正式从双机位A卷切换至。复杂度明显提升,需要组合多个算法点。题面相对简单,直接考查编程基本功。考查问题分析、算法选择和优化能力。通常为1-2个核心算法点的应用。

算法大师! 165

Python爬虫技术:高效数据收集与深度挖掘

利用Python进行爬虫开发以实现数据收集与挖掘是一个相对复杂但非常强大的任务。

2401_89383634的博客 1190

YOLO126优化:损失篇 | AAAI 2025 | 一种基于尺度的动态(SD)损失,根据目标大小动态调整尺度和位置损失的影响,提高了网络检测不同尺度目标的能力

提出了一种基于尺度的动态(SD)损失,它根据目标大小动态调整尺度和位置损失的影响,提高了网络检测不同尺度目标的能力。

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 447

Python大数据零售生鲜超市数据可视化大图平台的设计与实施

然而,随着技术的不断发展和市场的变化,我们还需要进一步完善和优化系统。我们利用Python的爬虫库(如Scrapy、BeautifulSoup等)编写爬虫程序,自动爬取零售生鲜超市的销售数据、价格信息、库存情况等。我们利用Python的数据分析库(如NumPy、SciPy等)和机器学习库(如scikit-learn、TensorFlow等)实现销售数据的深度分析和挖掘。(3)数据分析模块:该模块提供丰富的数据分析算法和挖掘工具,能够对销售数据进行深度分析,提取有价值的信息,如销售趋势预测、库存优化建议等。

qq_53797749的博客 540

K-BERT: Enabling Language Representation with Knowledge Graph 代码复现 直接运行

K-BERT: Enabling Language Representation with Knowledge Graph K-BERT K-BERT 代码复现

1073

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

零基础爬虫入门(一) | 初识网络爬虫

本篇博文主要介绍网络爬虫的基本概念、工作原理以及开发环境。 我们为什么要了解网络爬虫? 因为当今从事科学研究等,需要大量的数据,但是这些数据公开的又非常的少,大量的数据都在大公司的手中。我们这些普通人本身并没有那么多数据,但是我们又需要大量的数据。那么,这时我们就需要用到网络爬虫了。 Chapter01 | 初识网络爬虫一、什么是网络爬虫1、爬虫产生的背景1.1、万维网的高速发展1.2、搜索引...

不温卜火 6722

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

一文带你掌握Python网络爬虫

Python 网络爬虫作为数据获取的有力工具,在当今数字化时代发挥着重要作用。通过本文,我们深入了解了爬虫的基本概念、工作流程、常用库以及实战应用。从简单的网页请求与解析,到复杂的反爬虫策略应对,每一个环节都蕴含着丰富的技术知识和实践技巧。在实际应用中,爬虫已经广泛渗透到各个领域,如市场调研、数据分析、舆情监测等。它帮助企业和研究人员快速获取大量有价值的数据,为决策提供了有力支持。但我们也不能忽视爬虫使用过程中的法律和道德问题,遵守 Robots 协议、保护数据隐私和合法使用数据是我们必须坚守的原则。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 4660

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Python网络爬虫:深入解析爬虫的概念与分类

网络爬虫作为一种自动化的数据收集工具,在数据处理和分析领域发挥着重要作用。通过深入了解网络爬虫的概念、分类以及其在数据处理中的应用,我们可以更好地利用这一工具来收集和分析数据,为决策支持、预测分析等领域提供有力支持。同时,我们也需要注意遵守相关法律法规和道德规范,在合法合规的前提下使用网络爬虫技术。

2301_79727522的博客 1389

网络爬虫基本原理介绍

需要注意的是,这只是一个简单的示例代码,实际编写爬虫时需要根据具体的网站结构和规则进行相应的调整和优化。根据其目的和工作方式的不同,网络爬虫可以分为多种类型,如通用爬虫、聚焦爬虫、增量式爬虫等。通用爬虫也称为广泛爬虫,其目的是全面抓取互联网上的所有网页,以尽可能地覆盖更多的网页。增量式爬虫也称为持续式爬虫,其目的在于定期更新已经抓取过的网页,并新增有变化的页面。编写网络爬虫需要具备一定的编程技能和经验,同时需要了解相关的法律法规和道德规范,尊重网站的知识产权和隐私权,避免对网站的正常运行造成干扰和损害。

日常笔记/总结/系列知识梳理 2725

Python网络爬虫技术及其应用

网络爬虫(Web Crawler)是一种按照一定的规则,自动抓取互联网信息的程序或脚本。它通过访问网页,解析页面内容,提取所需数据,并根据链接跳转到其他页面继续抓取,直到满足设定条件为止。网络爬虫可以用于数据挖掘、搜索引擎索引建立、网站内容监控等多个领域。

↓ ↓ 1388

【python爬虫基础】年轻人的第一个爬虫程序

【python爬虫基础】年轻人的第一个爬虫程序,爬取豆瓣读书的top250书籍及对应连接。

Yui_的博客 5509

爬虫python能做什么 知乎,python网络爬虫能做什么

模拟浏览器打开网页,获取网页中我们想要的那部分数据浏览器打开网页的过程:当你在浏览器中输入地址后,经过DNS服务器找到服务器主机,向服务器发送一个请求,服务器经过解析后发送给用户浏览器结果,包括html,js,css等文件内容,浏览器解析出来最后呈现给用户在浏览器上看到的结果所以用户看到的浏览器的结果就是由HTML代码构成的,我们爬虫就是为了获取这些内容,通过分析和过滤html代码,从中获取我们想要资源。由于后台服务器的通用性,除了狭义的网站之外,很多App和游戏的服务器端也同样用 Python实现。

wenangou的博客 5675

Python 网络爬虫

摘要: Python网络爬虫是一种自动化提取网络数据的技术,通过程序代理从网站获取、解析和存储信息。不同于网络爬取(索引构建),爬虫专注于特定数据提取,适用于电商比价、内容聚合、营销推广等场景。其核心模块包括网络请求、数据解析、清洗转换及存储,工作流程涵盖网页下载、数据提取、存储和分析。相比人工采集,爬虫高效处理海量公开数据,广泛应用于SEO、机器学习及科研领域。

路漫漫其修远兮,吾将上下而求索 1427
上一篇: 【python学习】10个Python必备第三方库
下一篇: 2024年超详细Pycharm安装保姆级教程,Python环境配置和使用指南,看完这一篇就够了
HUHU爱学习
博客等级 码龄4年 1215粉丝 75原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值