


前言:
阅读指南
📊 字数:约 6,500 字
⏱️ 阅读时间:8-12 分钟
👥 适合人群:产品经理、技术工程师、创业者、AI 爱好者
🎯 核心内容:
三大AI技术(RAG、Graph RAG、DeepSeek-OCR)的本质区别
小红书如何通过 NoteLLM 搭建推荐系统
未来演进路线:从单一向量检索到多维图谱推理(小红书AI推演)
产品决策中的技术权衡与成本控制
一、问题的起点:为什么推荐越来越难
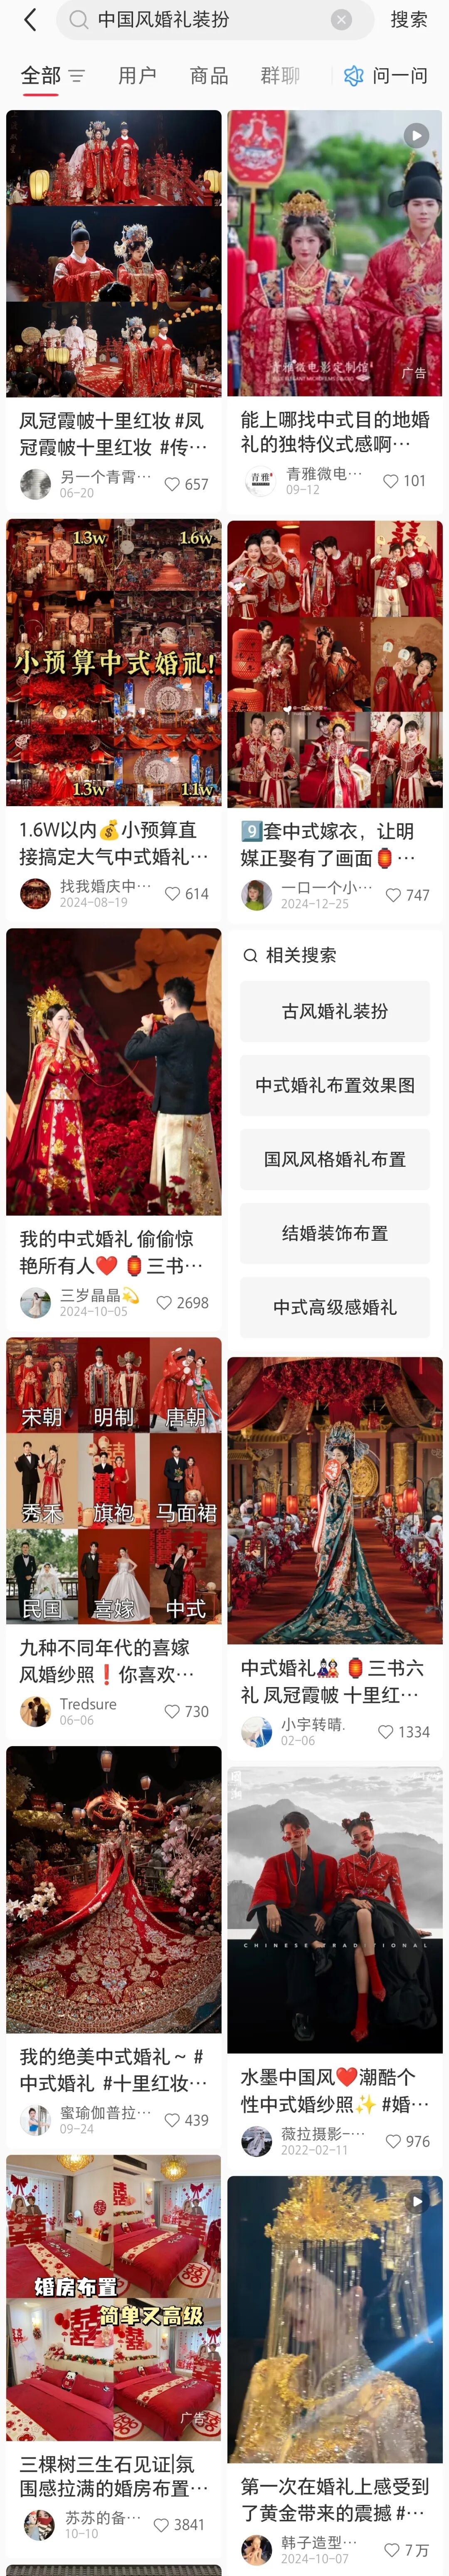
上周回了趟老家,顺便参加了同学的婚礼,同学跟我说她结婚前在小红书上一顿搜”中国风婚礼装扮“,然后系统推荐了几十条笔记。有趣的是,前 20 条几乎都是同一类风格的装扮,虽然都很专业,但同质化太严重了。她说,反而是滑到后面有一条笔记是讲冬季暖色系新娘妆容的,这一条反而更符合她的实际需求和气质。(我老家吉林的,前阵子都下雪了)
这个小小的”挫折“背后,其实隐藏的,正是目前绝大多数App推荐系统最大的困境:如何在"准确推荐"和"多元发现"之间找到平衡。
小红书的日均搜索量从 2023 年的 3 亿次增长到 2024 年底的 6 亿次,但搜索量增长的背后,是推荐系统面临的前所未有的挑战:
-
内容爆炸:每天新增数千万笔记,无法全量处理
-
冷启动难题:优质的新笔记因为互动少而被埋没
-
个性化不足:同样的查询,不同用户需要完全不同的答案
-
多维理解困难:一张图胜千言,纯文本理解显得过于单薄
如何破局?小红书给出的答案是从NoteLLM1.0到NoteLLM2.0,对于这部分内容,我不再赘述,之前两篇文章详细介绍过,🔗都放文末了。
但是今天这篇文章,针对这个问题,我给出一个新的建议和方案↓
三种AI技术的渐进式融合:先用传统 RAG(检索增强生成)快速建立基础,再用 DeepSeek-OCR 优化输入效率,最后用 Graph RAG 深化推理能力。
这不是一步到位的技术升级,而是产品与技术的协同共进!
二、理解三种技术的关键区别
2.1 RAG:最经济的选择
想象一个图书馆的推荐系统。你问图书馆员:"给我推荐一本关于婚礼的书"。
传统的做法是什么?图书馆员会在脑海里比对你的问题与图书馆中所有书籍的相似度,然后按匹配度从高到低推荐。这就是 RAG(Retrieval-Augmented Generation,检索增强生成) 的核心逻辑。
RAG 的工作流程:
用户查询          向量化          向量数据库         相似度计算
    ↓              ↓               ↓                 ↓
"婚礼装扮" → 转换为数字向量 → 查找相似向量 → 返回 Top-20 笔记
                                                    ↓
                                               LLM 生成答案
RAG 的优势:
-
⚡ 响应极快(毫秒级)
-
💰 成本低廉
-
🎯 部署简单
RAG 的局限:
-
❌ 只看"内容相似度",看不到"用户关系"
-
❌ 无法理解"喜欢A风格的用户通常也需要B相关内容"
-
❌ 冷启动笔记难以获得曝光
实际案例:用户 A 看过"极简风格穿搭",系统只会推荐其他"极简风格"的笔记,而看不到"极简风格通常搭配的护肤品是什么"这种隐含需求。
2.2 DeepSeek-OCR:效率的革命
现在问题来了。小红书的笔记不仅是文字,还包括大量的图片、表格甚至上传的 PDF。处理这些多模态内容的成本很高。
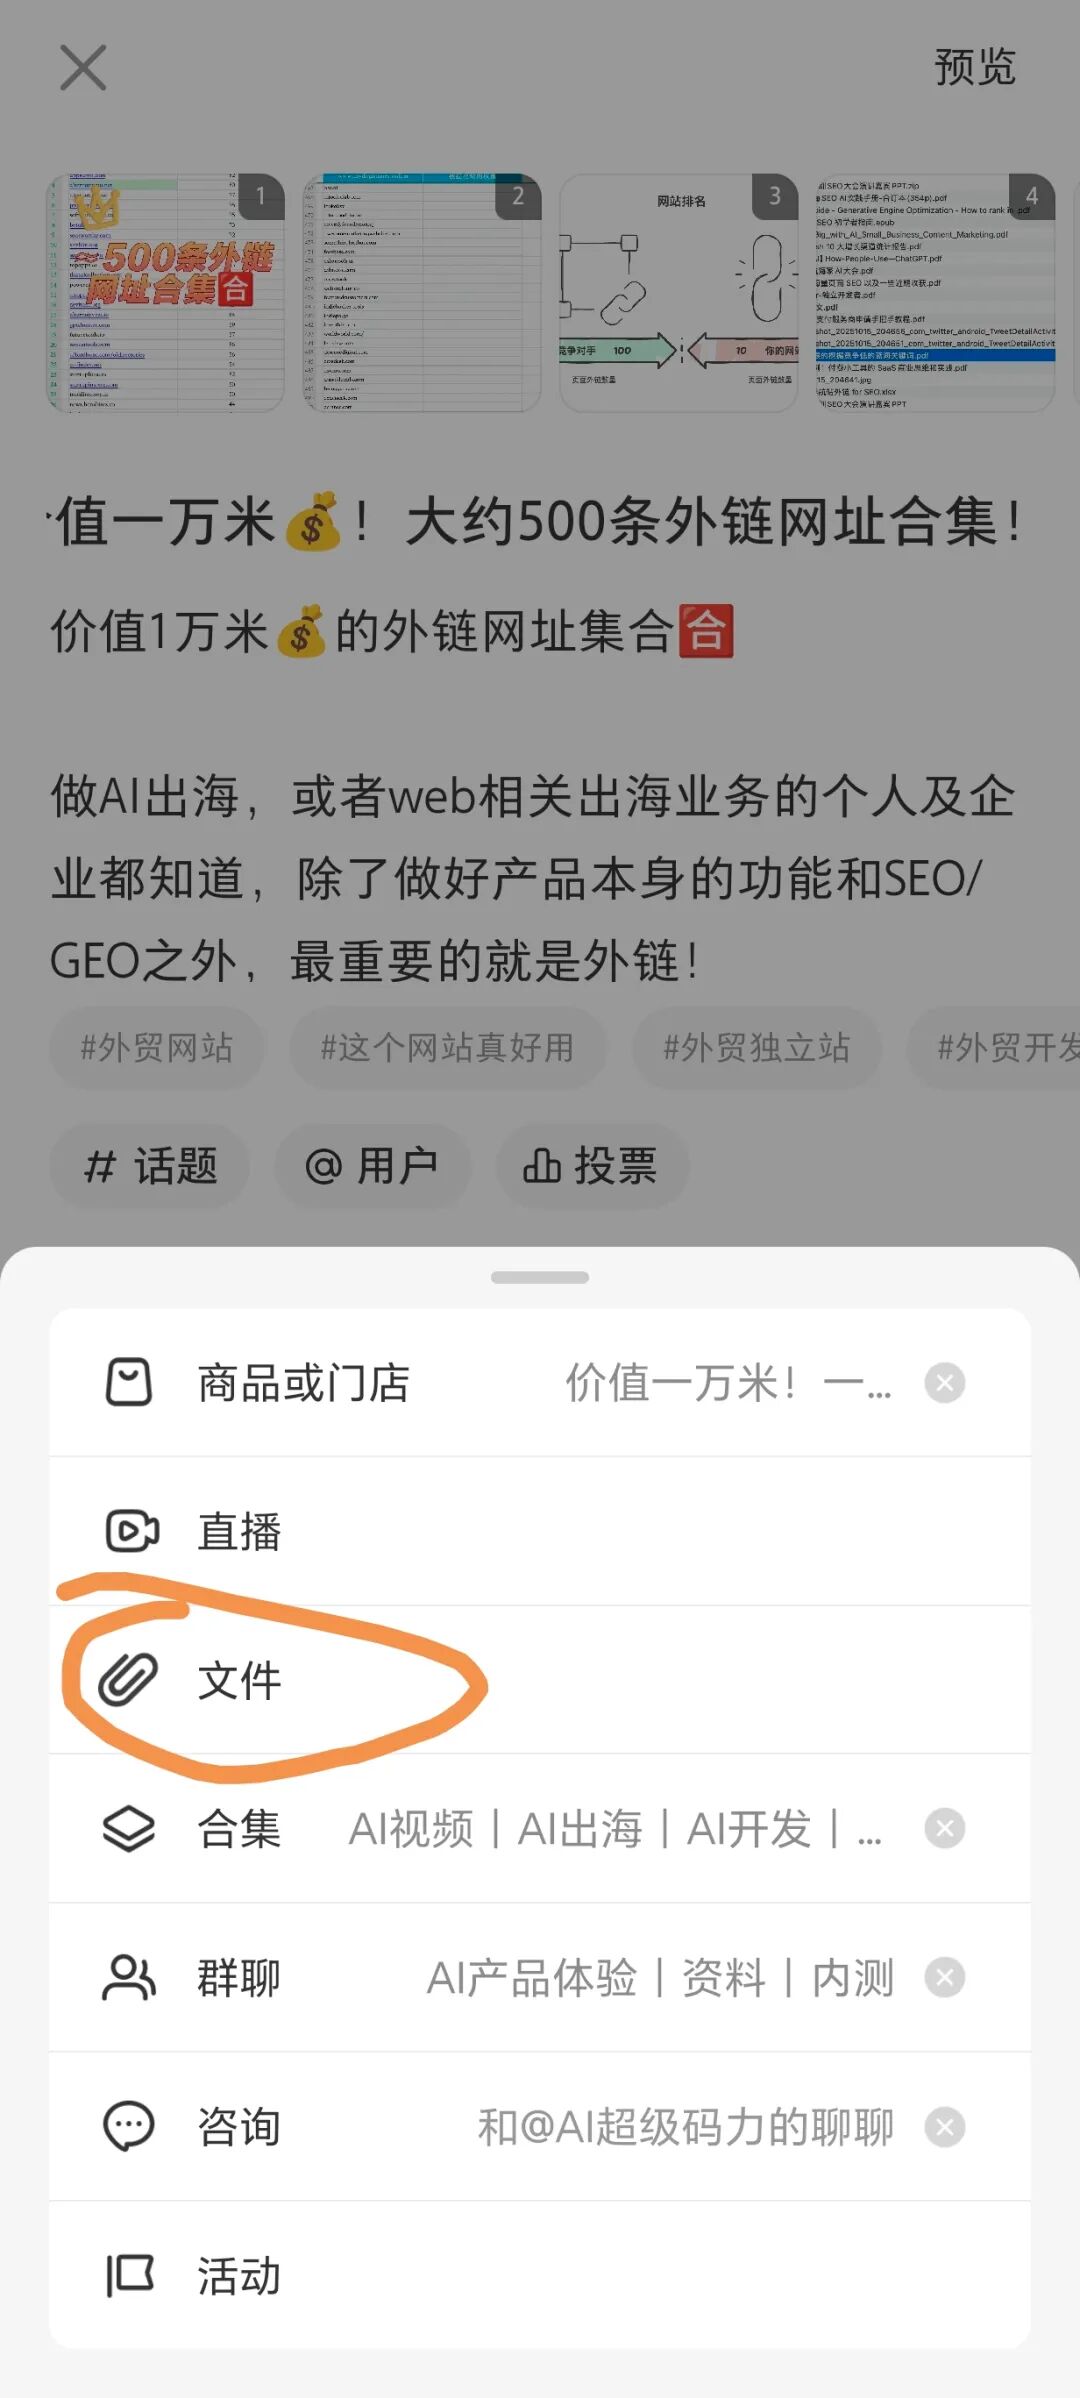
(小红书现在支持文件上传)
一张高清图片,传统方法需要转换成约 256 个数字向量。如果一条笔记有 3 张图片,就需要 768 个向量。当你处理数亿条笔记时,这个数字会变成天文数字。
这时,DeepSeek-OCR 出场了。它的核心创新是什么?光学压缩。
不同于传统 OCR(光学字符识别)需要提取所有文字,DeepSeek-OCR 采用了一种巧妙的压缩策略:直接从图像中提取核心语义信息,而不需要转换成完整的文字。
压缩效果:
传统处理:一张图 → 256 个向量 → 需要存储和计算
DeepSeek压缩:一张图 → 100 个向量 → 成本 ↓60%,速度 ↑50%
DeepSeek-OCR 的真实价值:
假设用户上传了一份"2025 婚礼筹备完全指南"PDF(100 页)。
-
传统方法:转成约 400,000 个单词,需要花费大量 token 和计算资源
-
DeepSeek-OCR:压缩到约 20,000 个"智能信息单元",成本 ↓95%
产品意义:小红书可以轻松支持用户上传和索引长文档(攻略、指南、教程),而不用担心成本爆炸。
尤其是:对于部分优质的PGC用户或商家,他们如果只是通过笔记传达自己的产品和商品,根本无法在有限的载体中充分表达。而现在既然小红书支持文件上传,那么就应该充分的挖掘附件文件中的所有重要信息,并进行便签和特征的详细分解。这样当用户在做检索时(或系统主动推荐时),即使用户输入的检索词query没有命中或匹配到商家笔记,但是匹配到商家上传的文件,那么也会展示给用户。而且,这大概率就是用户想要的最优解!
建议小红书官方,可以认真考虑下!
DeepSeek-OCR 的限制:它只优化了"输入处理",检索和推荐逻辑没变。系统仍然基于相似度匹配,依然无法理解更深层的关系。
2.3 Graph RAG:推理的升维
如果说 RAG 是"相似度匹配",那 Graph RAG 就是"关系推理"。
回到图书馆的比喻。如果图书馆员不仅知道书籍本身,还知道:
-
哪些作者经常合作
-
哪些读者的阅读品味相近
-
哪些书籍经常被同时借阅
-
不同书籍之间的隐含联系
那么,即使你只问一个模糊的问题,图书馆员也能通过这些关系网络,为你推荐出出人意料又合理的书籍。
Graph RAG 的工作流程:
用户查询      实体识别      知识图谱      多跳遍历      社区检测
    ↓           ↓             ↓            ↓            ↓
"婚礼妆" → 识别关键词 → 找到相关节点 → 沿关系推理 → 聚合信息
                                                      ↓
                                            融合 RAG 和图的结果
                                                      ↓
                                                  LLM 生成答案
Graph RAG 中的关键概念:
-
节点:笔记、创作者、品牌、标签等
-
关系:笔记由哪个创作者创建、笔记提到哪个品牌、创作者之间的合作等
-
社区:通过图的结构识别出紧密相连的节点集合
-
多跳推理:从一个节点出发,沿关系边走多步,找到隐含相关的内容
一个完整的例子:
用户搜"50 万预算冬季婚礼妆扮"
RAG 的做法(传统):
-
搜索"50 万""冬季""婚礼""妆扮"相关笔记
-
返回前 20 条最相似的笔记
-
完成
Graph RAG 的做法(升级):
-
识别关键实体:预算范围、季节、场景、内容类型
-
在知识图上多跳遍历:
-
第一跳:找到标记为"婚礼妆扮"的笔记
-
第二跳:找到这些笔记的创作者
-
第三跳:找到这些创作者合作过的摄影师、策划师
-
第四跳:找到这些专业人士所在社区或群组的热门讨论
-
-
社区检测:识别"婚礼筹备社区/群组"内最权威的笔记
-
最终推荐:不仅推荐内容相似的笔记,还推荐:
-
来自信任度高的创作者的新笔记
-
该社区/群组内的热点讨论
-
关联领域的专业建议(如服装、摄影)
-
Graph RAG 的优势:
-
✅ 支持多维度推荐
-
✅ 解决冷启动问题
-
✅ 提升用户满意度(+8-12%)
-
✅ 可解释性强(用户知道推荐原因)
Graph RAG 的代价:
-
⏱️ 计算复杂度增加(响应时间 200ms → 1s)
-
💾 需要构建和维护大规模图结构
-
🔧 实体抽取准确度影响最终效果
三、三者关系的产品视角理解
3.1 一句话总结
RAG 是基础框架,DeepSeek-OCR 加强输入端,Graph RAG 加强检索端。
从产品经理的角度,这三种技术解决的问题是层级递进的:
| 技术 | 解决的问题 | 优先级 | 部署难度 |
|---|---|---|---|
| RAG | 如何快速找到相似内容 | 🔴 必须 | ⭐ 简单 |
| DeepSeek-OCR | 如何高效处理多模态内容 | 🟡 重要 | ⭐⭐ 中等 |
| Graph RAG | 如何理解内容的深层关系 | 🟢 优化 | ⭐⭐⭐ 复杂 |
3.2 层次关系图
┌─────────────────────────────────────────────────────────┐
│  第三层:生成层 (由 LLM 驱动)                            │
│  - 理解用户意图                                          │
│  - 融合多维信息                                          │
│  - 生成个性化推荐理由                                    │
└─────────────────────────────────────────────────────────┘
                          ↑
┌─────────────────────────────────────────────────────────┐
│  第二层:检索层(大脑)                                  │
│  ┌────────────────────────────────────────────────────┐ │
│  │ 传统 RAG:向量相似度检索(速度优先)               │ │
│  │ Graph RAG:知识图多跳推理(准确度优先)            │ │
│  └────────────────────────────────────────────────────┘ │
└─────────────────────────────────────────────────────────┘
                          ↑
┌─────────────────────────────────────────────────────────┐
│  第一层:输入处理层(眼睛和耳朵)                        │
│  ┌────────────────────────────────────────────────────┐ │
│  │ 传统处理:文本分块、简单图像转换                   │ │
│  │ DeepSeek-OCR:多模态压缩、结构化提取               │ │
│  └────────────────────────────────────────────────────┘ │
└─────────────────────────────────────────────────────────┘
四、小红书的现实情况:NoteLLM 系统
4.1 NoteLLM 是什么
NoteLLM是小红书在当前AI大战略领域里的核心技术和发展线索,在2024 年初,小红书发表了一篇学术论文,介绍了自己的推荐系统核心——NoteLLM。
简单来说,NoteLLM 就是一个特殊的 LLM(大语言模型),它的训练目标不是聊天,也不是写文章,而是理解笔记内容,并生成推荐用的"笔记指纹"。
核心创新:笔记压缩
想象你要把一条完整的笔记(标题、图片、正文、标签)的所有信息浓缩到一个特殊的"数字指纹"里。传统方法是:逐一处理标题、图片、正文,再合并结果。
NoteLLM 的做法是:用 LLM 一次性处理所有信息,生成一个统一的"笔记指纹"(embedding)。
优势是什么:
-
信息融合更充分(不是简单的拼接)
-
利用 LLM 的理解能力(比 BERT 更强)
-
成本可控(不是全量使用 LLM)
4.2 NoteLLM-1.0 vs NoteLLM-2.0
NoteLLM-1.0(2024 年初)
-
✅ 使用向量检索(即传统 RAG)
-
✅ 融入用户行为信号(哪些笔记经常被一起看)
-
❌ 纯文本理解(图片信息损失严重)
效果:线上推荐准确度提升,点击率(CTR)提升 5-8%
NoteLLM-2.0(2024 年中)
-
✅ 多模态融合(同时处理文本和图片)
-
✅ 解决了"文本压制图片"的问题
-
❌ 仍然是向量检索为主
-
❌ 尚未采用 DeepSeek-OCR 的压缩技术
效果:CTR 进一步提升 6.35%,互动率提升 8.08%
4.3 NoteLLM 使用了哪些技术
| 技术维度 | 是否使用 | 说明 |
|---|---|---|
| 向量检索(RAG) | ✅ 完全使用 | 基于相似度的 Top-K 检索 |
| 用户行为信号 | ✅ 部分使用 | 类似图结构,但未显式化 |
| 知识图谱(Graph RAG) | ❌ 未使用 | 没有构建显式的实体关系图 |
| 多跳推理 | ❌ 未使用 | 无法进行关系推理 |
| 多模态理解 | ✅ NoteLLM-2 有 | 文本+图片融合 |
| 视觉压缩(DeepSeek-OCR) | ❌ 未使用 | 图片仍需 256 个向量,未压缩 |
核心结论:NoteLLM 目前是一个增强版的传统 RAG 系统,已经融入了协同过滤的思想,但还没有完全走向 Graph RAG。
五、小红书的未来演进路线(产品假设)
注意!这部分内容我我个人基于当前技术趋势,并假设我是小红书AI战略产品负责人,所做的推断。其实就是为了更好的讲述RAG的发展路线,所以就代入小红书这个场景,来给大家做一次”亲身实践“式的推演!
第一阶段:当前状态
技术栈:NoteLLM-2.0 + 传统 RAG
产品体验:
-
用户搜索时得到相似笔记的推荐
-
推荐列表基于内容相似度和用户互动
-
多模态理解增强了准确性
产品经理的思考:
-
✅ 系统稳定性强
-
✅ 成本可控
-
⚠️ 无法捕捉更深层的用户需求
-
⚠️ 冷启动笔记难以被推荐
第二阶段:短期优化(2026 年 Q1E)
新增技术:引入 DeepSeek-OCR 的压缩技术
具体改进:
-
视觉信息压缩:从 256 向量压缩到 100 向量(节省 60% 成本)
-
长文档支持:支持用户上传 PDF 指南、攻略(成本降至原来的 1/20)
-
结构化提取:识别表格、图表、关键数据点
产品意义:
-
💰 成本下降 60%,可投入更多资源在其他地方
-
⚡ 推理速度提升 50%,用户体验更流畅
-
📁 支持长文档,用户可上传更丰富的内容
(我认为小红书应该优先考虑检索提效,这样可以为下一步充分关联图、文、视频、文档等多媒体数据,从当前的网状结构,慢慢升级为立体结构,打下坚实的基础!)
产品经理的决策: 这个阶段的直接价值是"成本优化"而非"功能升级"。而间接价值,就是为下一步的立体化数据关联做准备。
第三阶段:中期升级(2026 年 Q2~Q3E)
新增技术:引入 Graph RAG 的知识图谱
具体改进:
-
知识图谱构建:
-
节点:笔记、创作者、用户、品牌、社区、标签
-
关系:创作、合作、推荐、关注等
-
-
混合检索:同时跑传统 RAG 和图 RAG,融合结果
-
社区赋能:识别高价值社区,精准推荐社区内的热点内容
产品体验变化:
用户搜"50 万预算冬季婚礼",系统不仅推荐相似笔记,还会:
-
推荐该领域最信任的创作者新发布的笔记
-
推荐社区/群组内的热门讨论
-
推荐相关领域的关联内容(如服装、摄影)
产品经理的决策: 这个阶段涉及大量的工程投入(图构建、维护、查询优化)。需要在试点社区验证效果后,才决定是否全量推出。关键指标:准确度是否提升 8-12%、用户满意度是否提升。
第四阶段:长期愿景(2026 年 Q4+)
终极架构:多模态 Graph RAG 全量部署
产品愿景: 不再仅仅是"推荐笔记",而是成为用户的"生活决策助手"。
例如用户问"帮我规划一个完整的婚礼方案",系统可以:
-
根据预算自动规划各环节的支出
-
推荐不同阶段需要的笔记(筹备、采购、执行)
-
连接创作者和用户,促成交易
-
记录用户的每个决策,优化下一次推荐
产品经理的思考: 这不仅是技术升级,更是商业模式升级。从"内容平台"升级为"生活决策基础设施"。
六、技术权衡与产品决策
6.1 三个关键决策点
决策 1:什么时候引入 DeepSeek-OCR
| 选择 | 适用场景 | 后果 |
|---|---|---|
| 立即引入 | 成本是主要瓶颈 | 节省 60% 成本,快速扩张能力 |
| 观察再入 | 成本暂不紧张 | 等待技术更成熟,风险更低 |
| 结合现状 | 仅在上传 PDF 时使用 | 平衡成本与风险 |
决策 2:什么时候试点 Graph RAG
| 选择 | 适用场景 | 后果 |
|---|---|---|
| 立即推全 | 对标竞品,技术优势是核心竞争力 | 快速赢得市场,但风险大 |
| 精准试点 | 在高端社区(婚礼、奢侈品)试验 | 可控地验证效果,成本低 |
| 保守等待 | 继续优化 RAG | 稳妥但可能被竞品超越 |
决策 3:如何平衡成本与准确度
成本                          准确度
  ↑                            ↑
  |                            |
  | 多模态 Graph RAG           | 多模态 Graph RAG
  |(最贵,最准)             |(最贵,最准)
  |                            |
  | Graph RAG                   | Graph RAG
  |                            |
  | RAG+DeepSeek-OCR           | RAG+DeepSeek-OCR
  |                            |
  | 传统 RAG                    | 传统 RAG
  |(最便宜,一般)            |(最便宜,一般)
  |__________________________|

产品经理需要在这条曲线上找到"最优点"
6.2 小红书的产品成功因素
回顾小红书推荐系统的成功,有几个关键因素值得注意:
-
不盲目跟风:业界热议"生成式搜索"时,小红书坦诚说"生成式搜索不是银弹",而是坚持混合方案(传统搜索+AI 搜索+工作流)
-
渐进式创新:NoteLLM-1.0 → 2.0 是持续优化,而非颠覆性创新。这样可以随时调整方向
-
数据驱动:每个技术决策都有明确的线上指标验证(CTR、互动率、留存率)
-
成本意识:即使有强大的技术能力,也会优先考虑如何"用最少的成本做最好的效果"
七、对产品经理的启示
7.1 技术评估框架
当面对新技术时,产品经理可以用这个框架评估:
表格:技术评估框架
| 维度 | 评估要点 | 示例 |
|---|---|---|
| 成本 | 实施费用、人力投入、运维成本 | DeepSeek-OCR 可节省 60% 成本 |
| 效果 | 用户体验提升、业务指标改进 | NoteLLM-2.0 CTR 提升 6.35% |
| 风险 | 技术成熟度、系统稳定性 | Graph RAG 维护成本高 |
| 时机 | 是否是最佳窗口期 | 用户增长快时优化成本 |
| 竞争 | 竞品是否已有、先发优势 | 小红书在 NoteLLM 上领先 |
7.2 三个常见的决策陷阱
陷阱 1:技术越先进越好
❌ 错误:看到 Graph RAG 效果好,就立即全量推出
✅ 正确:在试点社区验证效果后,根据数据决定推进速度
陷阱 2:忽视用户体验
❌ 错误:为了提升准确度,把响应时间从 200ms 增加到 1s
✅ 正确:在 600ms 左右找到准确度和速度的最优平衡
陷阱 3:成本估算过于乐观
❌ 错误:认为新技术能完全替代旧技术,节省所有成本
✅ 正确:新旧技术混合运行,降低风险,成本可能只省 30-40%
八、小结:一个产品经理的思考
作为产品经理,当我们评估 RAG、Graph RAG 和 DeepSeek-OCR 这三种技术时,不应该问"哪个最好",而应该问:
-
现在用户最大的痛点是什么?(推荐准确度低?检索速度慢?无法处理复杂内容?)
-
用多少成本能解决这个痛点?(RAG 很便宜,Graph RAG 很贵)
-
解决这个痛点能带来多少业务收益?(CTR 提升 5%?留存率提升 10%?)
-
现在是否是最佳时机?(竞品有了吗?用户增速快吗?成本压力大吗?)
假设,你是小红书 PM,你当下会优先选择哪一个:
对于Graph RAG,如果你是小红书 PM,你当下会优先选择哪一个? 单选
全量推进Graph RAG
试点验证,再全量部署
继续优化RAG
投票
附录1:
上文提到的过往关联笔记,以及一张刚刚我在小红书app中检索”中国风婚礼妆扮“截图给大家看看,你也可以阅读完本文后,再去小红书app里面检索你喜欢的内容感受一下。
小红书AI战略深度解析,NoteLLM,产品经理友好版。
小红书AI战略深度解析 | 2027年,小红书将成为中国第一大移动搜索引擎!
附录2:核心术语表
这部分内容也非常多,主要包括以下这些表格数据,所以我全都放在下图这篇附带文章里了,为了不影响本文的阅读体验,完整的表格汇总数据大家去那儿看吧↓
-
✅ 25+ 核心技术术语(英文全称、中文名、核心释义、应用说明、相关产品)
-
✅ 8 个核心概念术语
-
✅ 8 个产品指标术语(CTR、Recall 等)
-
✅ 6 个数据库/工具术语
-
✅ 5 个应用场景术语
-
✅ 12 个关键数字一览(数据速查)
-
✅ 24 个英文缩写快速查询
如何学习AGI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取