【2025版】最新大语言模型LLM基础扫盲速通版,(非常详细)零基础入门到精通,收藏这篇就够了

Build a Large Language Model (From Scratch)学习汇总 https://github.com/Czi24/Awesome-MLLM-LLM-Colab/tree/master/LLMs-from-scratch-CN-Colab通过网盘分享的文件:Build a Large Language Model (From Scratch).pdf 链接: https://pan.baidu.com/s/1BKVbCtaW7BV2my-9_T9xSA?pwd=8vjk 提取码: 8vjk –来自百度网盘超级会员v7的分享md版本: https://blog.csdn.n 阅读详情

1. 什么是LLM?

LLM 是“大型语言模型”(Large Language Model)的缩写。它指的是使用深度学习技术训练出来的,具有大规模参数量的语言处理模型。这些模型通常在互联网上的大量文本数据上进行训练,以学习自然语言的模式和结构。训练后的 LLM 能够执行各种自然语言处理任务,如文本生成、机器翻译、问答系统、摘要生成、情感分析等。

当我们说人类语言时,不仅仅指中文、英语或法语等,人类语言还延伸到:

  • 摩尔斯电码

  • 遗传密码

  • 象形文字

  • 加密

  • 手语

  • 肢体语言

  • 乐谱

  • 化学信号

  • 表情符号和符号

  • 动物交流

  • 触觉通信

  • 交通标志和信号

  • 数学方程

  • 编程语言

LLM 经过数百、数千亿、甚至数万亿个参数的训练,能够从广泛的数据源中学习到规律。

这种广泛的训练使他们能够根据收到的输入预测和生成文本,以便他们可以参与对话、回答查询甚至编写代码。

2. LLM如何工作?

大型语言模型使用神经网络和机器学习 (ML) 的混合。正是这种混合使得该技术能够首先处理然后生成原始文本和图像。神经网络是 LLM 的大脑。这些网络从大量数据中学习,随着接触更多数据而不断进步。

随着模型接受更多数据的训练,它会学习语言的模式、结构和细微差别。这就像同时教它语法规则、诗歌节奏和技术手册的术语一样。

然后,机器学习模型帮助模型根据句子前面的单词预测下一个单词。这个过程重复了无数次,提高了模型生成连贯且上下文相关的文本的能力。

LLM 现在采用 Transformer 架构,该架构允许模型查看并权衡句子中不同单词的重要性,这与我们阅读句子并寻找上下文线索来理解其含义时的情况相同。

虽然 LLM 可以生成原创内容,但其输出的质量、相关性和创新性可能会有所不同,需要人工监督和改进。

3. LLM开发的关键里程碑

大型语言模型并不总是像今天这样有用。随着时间的推移,它们得到了很大的发展和迭代。

让我们回顾一下 LLM 历史上的一些关键时刻。这样你就可以了解他们取得了多大的进步,以及与几十年的缓慢进步相比,过去几年的快速发展。
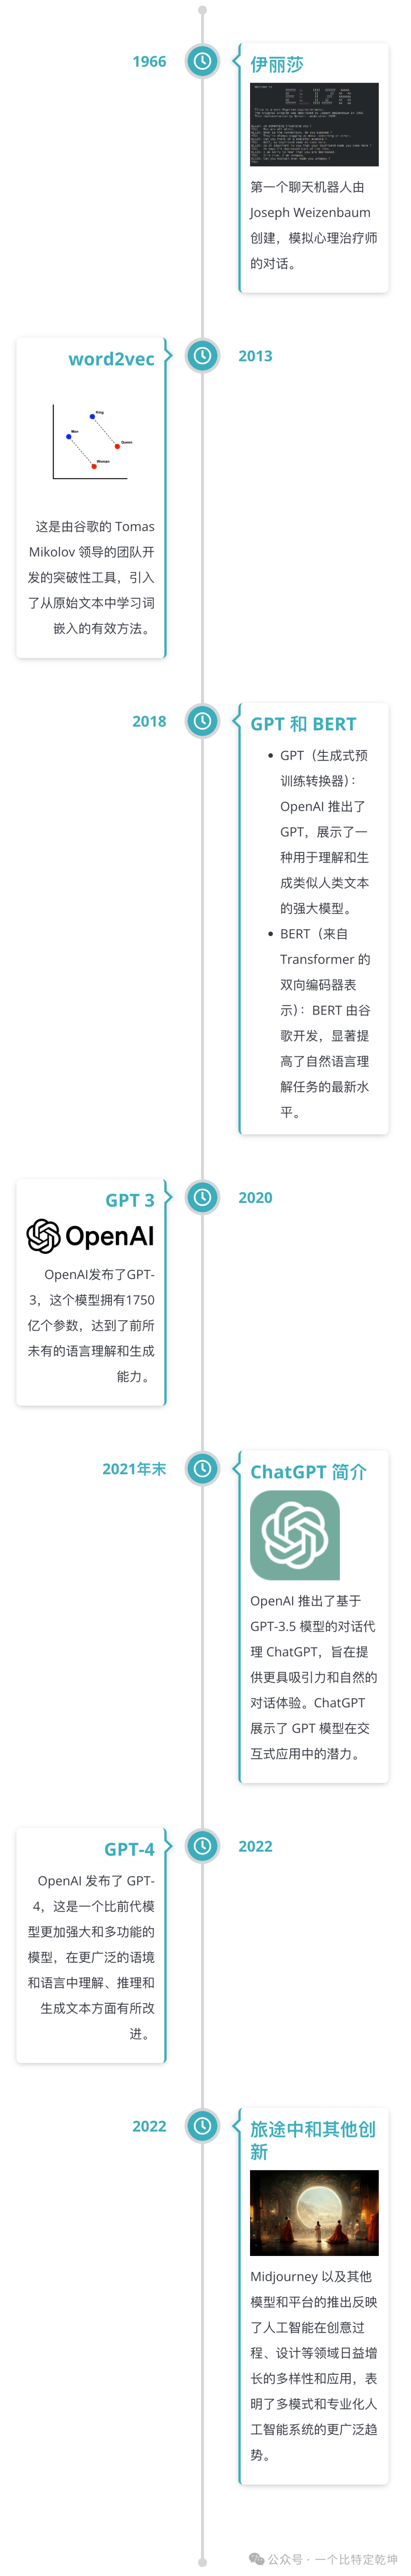
(1)2010 年之前:早期基础

1950 年代至 1970 年代:早期的人工智能研究为自然语言处理奠定了基础。最著名的是,名为“Eliza”的技术人员是世界上第一个聊天机器人。

1980 年代至 1990 年代:NLP 统计方法的发展,逐渐摆脱基于规则的系统。

(2)2010 年:初始模型

2013 年推出了 word2vec,这是一种计算词语向量表示的工具,通过捕捉词语的语义,显著提高了 NLP 任务的质量。

(3)2014-2017:RNN 和注意力机制

2014 年:序列到序列 (seq2seq) 模型和循环神经网络 (RNN) 在机器翻译等任务中变得流行。

2015年:引入注意力机制,提高神经机器翻译系统的性能。

2017年:《Attention is All You Need》论文中提出了Transformer模型,以对序列的高效处理为NLP任务树立了新的标准。

(4)2018 年:GPT 和 BERT 的出现

2018 年 6 月:OpenAI 推出 GPT(生成式预训练变压器),这是一种利用无监督学习生成连贯且多样化文本的模型。

2018 年 10 月:Google AI 推出 BERT(来自 Transformers 的双向编码器表示),它使用 Transformer 模型的双向训练来提高对语言上下文的理解。

(5)2019-2020:更大、更强大的类型

2019 年:推出 GPT-2,这是 GPT 的改进版本,具有 15 亿个参数,展示了该模型在扩展段落中生成连贯且上下文相关的文本的能力。

2020 年:OpenAI 发布 GPT-3,这是一个拥有 1750 亿个参数的更大模型,在生成类似人类的文本、翻译和回答问题方面表现出卓越的能力。

(6)2021-2023:LLM的专业化、多模态性和民主化

2021-2022:开发专门的模型,例如用于对话应用程序的 Google LaMDA 和用于开放预训练变压器的 Facebook OPT。

2021 年:引入多模态模型,例如 OpenAI 的 DALL·E,能够根据文本描述生成图像,以及 CLIP,可以在自然语言环境中理解图像。

2022 年:GPT-4 和其他先进模型(如 Midjourney)的出现,继续突破 LLM 在各个领域和任务(包括图像生成)中生成和理解自然语言方面的潜力。它也更容易被更多人接受。

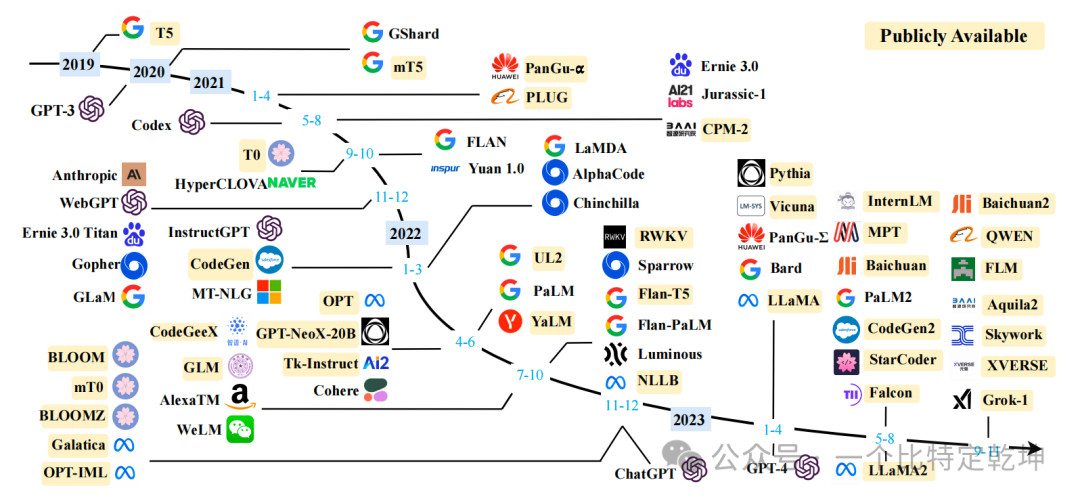
下图是2023年之前的大模型发布的时间线:
4. 训练可用LLM模型的完整流程

(1)模型定义与准备

  • 选择或设计模型架构:根据任务需求选择适合的神经网络结构,例如Transformer架构。

  • 初始化模型参数:设定初始权重和偏置值,这些通常是随机初始化或者从预训练模型加载。

(2) 数据收集与预处理

  • 数据源采集:获取来自多种渠道的数据,如网页、书籍、新闻文章等。确保数据的质量和多样性。

  • 数据清洗:去除噪声、重复内容和其他不需要的信息,以提高数据质量。

  • 分词器训练:如果需要自定义分词规则,则需训练一个合适的分词器(Tokenizer),将文本转换成模型可以理解的形式。

  • 数据格式化:将文本转化为适合输入给模型的形式,比如将句子分割成tokens,并添加特殊标记如[CLS]和[SEP]。

(3) 预训练(Pre-training)

  • Next Token Prediction:通过预测下一个token的任务来学习语言模式。这是无监督学习的一部分,旨在让模型掌握广泛的语言规律。

  • 掩码语言建模(Masked Language Modeling, MLM):随机遮蔽一部分词汇,然后让模型去预测被遮蔽的词汇。这有助于模型更好地理解和表示上下文信息。

  • 使用大规模语料库:利用大量未标注的数据进行预训练,使模型能够获得丰富的语言知识。

(4)监督微调(Supervised Fine-Tuning, SFT)

  • 引入带标签的数据集:针对特定下游任务,使用带有明确标签的数据集对模型进行微调。

  • 指令跟随能力:通过提供具体的指令,使模型学会按照指示生成响应或执行任务。

  • 减少错误输出:修正预训练期间可能学到的一些不正确的行为或输出。

(5) 可选,强化学习与人类反馈(Reinforcement Learning from Human Feedback, RLHF)

  • 偏好对齐:通过人类评估者的反馈,调整模型的输出使其更符合人类的价值观和期望。

  • 控制有害内容:防止模型生成任何可能引起伤害的内容,如仇恨言论、虚假信息等。

  • 优化对话风格:改善模型的回答方式,使得其语气更加自然友好,更适合人机交互。

(6)模型评估与验证

  • 内部测试:在开发过程中持续监控模型性能,确保其稳定性和准确性。

  • 外部基准测试:使用公共可用的基准数据集来衡量模型相对于其他同类模型的表现。

  • 用户反馈:收集真实用户的评价,了解实际应用场景下的用户体验。

(7) 部署与推理

  • 模型压缩:为了降低计算成本和加速推理速度,可能会采用量化、剪枝等技术简化模型。

  • 服务化部署:将训练好的模型部署到生产环境中,供API或其他应用程序调用。

  • 在线更新机制:建立定期更新机制,以便随着新数据的到来不断改进模型。

5. LLM具备的能力

以下是 LLM 能力的列表:

  • 文本生成

  • 语言翻译

  • 总结

  • 问答

  • 情绪分析

  • 对话代理

  • 代码生成与解释

  • 命名实体识别

  • 文本分类

  • 内容推荐

  • 语言建模

  • 拼写检查和语法校正

  • 释义和重写

  • 关键字和短语提取

  • 对话系统

6. 领先的LLM模型包含哪些?

  • GPT系列:由 OpenAI 推出

  • LLaMA:由 Meta 推出

  • PaLM 2:由 Google DeepMind 推出

  • Gemini:由 Google DeepMind 推出

  • Claude:由 Anthropic 推出

  • Qwen:由阿里巴巴推出

  • …

7. 可以从头开始训练LLM吗?

可以,但是一般公司难以承担成本,需要大量的资源、时间和技术支持。

训练一个大型模型通常需要数百万美元的计算资源。为了训练一个与 GPT-3、GPT-4 等规模相当的模型,通常需要数百到上千个 GPU 卡,可能花费数百到数千万美元。

训练时间因硬件资源和模型规模而异。使用高性能的硬件(如TPU集群),训练一个大规模的模型可能需要几周到几个月的时间。

所以目前很多公司的策略是采用开源模型,如 LLaMA、Qwen 等,把这些已经训练好的模型权重作为基础模型,在此基础上增加新的语料进行 sft 或增量训练,以此大大降低时间和机器成本。

8. LLM的训练数据源包含哪些?

  1. 网页内容

  2. 书籍和文献

  3. 社交媒体平台

  4. 新闻文章和期刊

  5. 百科全书和其他参考

  6. 开源项目和代码库

下面是一些开源的数据集:

|
数据集名称

|

使用者

|

类型

|

语言

|

大小

|

描述 ️

|
| — | — | — | — | — | — |
| proof-pile |

proof-GPT

|

预训练 (PT)

|

英文
LaTeX

|

13GB

|

一个预训练数据集,类似于Pile但包含LaTeX语料库以增强模型在证明上的能力。

|
| peS2o |

/

|

预训练 (PT)

|

英文

|

7.5GB

|

用于预训练的高质量学术论文数据集。

|
| StackOverflow
帖子 |

/

|

预训练 (PT)

|

/

|

35GB

|

以Markdown格式的原始StackOverflow数据,用于预训练。

|
| SlimPajama |

/

|

预训练 (PT)

|

主要为英文

|

/

|

RedPajama的清理和去重版本

|
| NMBVC |

/

|

预训练 (PT)

|

中文

|

/

|

大规模、持续更新的中文预训练数据集。

|
| falcon-refinedweb |

tiiuae/falcon系列

|

预训练 (PT)

|

英文

|

/

|

CommonCrawl的精炼子集。

|
| CBook-150K |

/

|

预训练 (PT), 构建数据集

|

中文

|

150K+书籍

|

原始中文书籍数据集。需要一些预处理流程。

|
| Common Crawl |

LLaMA(经过一些处理后)

|

构建数据集,
预训练 (PT)

|

/

|

/

|

最著名的原始数据集之一,很少直接使用。一种可能的预处理流程是CCNet

|
| nlp_Chinese_Corpus |

/

|

预训练 (PT),
TF

|

中文

|

/

|

包括维基百科、百度百科、百度问答、一些论坛问答和新闻语料库的中文预训练语料库。

|
| The Pile (V1) |

GLM(部分)、LLaMA(部分)、GPT-J, GPT-NeoX-20B, Cerebras-GPT 6.7B, OPT-175b

|

预训练 (PT)

|

多语言,
代码

|

825GB

|

包含22个更小的高质量数据集的多样化开源语言模型数据集,涵盖许多领域和任务。

|
|

C4
Huggingface数据集
TensorFlow数据集

|

Google T5系列, LLaMA

|

预训练 (PT)

|

英文

|

305GB

|

Common Crawl网页爬虫语料库的巨量清理版本。经常被使用。

|
| ROOTS |

BLOOM

|

预训练 (PT)

|

多语言,
代码

|

1.6TB

|

包括Wikipedia和StackExchange等子数据集的多样化开源数据集,用于语言模型。

|
| PushshPairs reddit

论文

|

OPT-175b

|

预训练 (PT)

|

/

|

/

|

Reddit原始数据,一种可能的处理流程见此论文

|
| Gutenberg项目 |

LLaMA

|

预训练 (PT)

|

多语言

|

/

|

书籍数据集,主要是小说。未经过预处理。

|
| CLUECorpus |

/

|

预训练 (PT),
微调,
评估

|

中文

|

100GB

|

来源于_Common Crawl_的中文预训练语料库。

|

9. 其他关于LLM的常见问题

9.1 Transformer在LLM中有何意义?

Transformer 模型至关重要,因为它们使 LLM 能够通过自注意力机制处理文本中的长距离依赖关系。该机制允许模型衡量句子中不同单词的重要性,从而提高语言模型在理解和生成语言方面的表现。

9.2 在LLM中,微调 (fine-tuning) 是什么?

微调是在预训练之后的环节,针对特定任务进一步训练它。此过程会调整模型权重,使其在特定任务(如情绪分析、处理编程语言或其他专门应用程序)上表现更好。

9.3 模型大小如何影响LLM的性能?

模型大小通常以参数数量来衡量,它会影响 LLM 捕捉复杂语言模式的能力。根据多篇论文的实验表明,具有数千亿个参数的超大型模型通常表现更好,但在训练过程中需要更多的计算资源。

9.4 LLM 能生成编程语言的代码吗?

是的,LLM 可以生成各种编程语言的代码。它们通过提供代码片段、调试帮助和翻译代码来帮助开发人员,这要归功于它们在包含编程代码的各种数据集上进行的训练。

9.5 LLM的“上下文学习”是什么?

上下文学习是指 LLM 能够仅根据推理过程中提供的输入文本来学习和执行特定任务,而无需进行额外的微调。这使模型能够动态适应新任务或指令,从而增强其在广泛应用中的多功能性。

9.6 LLM中的“零样本”和“小样本”学习是什么?

零样本(zero shot)学习允许 LLM 利用其一般的语言理解能力来执行未经过明确训练的特定任务。

少样本(few shot)学习涉及在提示中为模型提供一些任务示例来指导其推理。

这两种方法都展示了模型在极少或没有额外训练数据的情况下进行泛化和适应新任务的能力。

下面给大家分享一份2025最新版的大模型学习路线,帮助新人小白更系统、更快速的学习大模型!
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

AI渗透入门:LLM、智能体、Skills与MCP的关系与实战 大语言模型(LLM)作为人工智能的核心推理引擎,正在重塑安全测试的工程范式。在安全实践中,模型提供语言理解与决策能力,而智能体(Agent)则通过规划、记忆和工具调用,将模型能力转化为具体行动。为了实现能力的标准化复用,Skills将专家经验封装为可加载的技能包,MCP协议则像USB接口一样,统一了模型与外部扫描器、漏洞库等工具的通信方式。这套技术栈共同构成了AI渗透的基础设施:一方面辅助安全工程师提升日志分析、信息收集与报告生成的效率;另一方面也催生出针对大模型应用本身的安全评估新课题。理解LLM、模型、 阅读详情

相关推荐

面向开发者的 LLM 入门课程

一个中文版的大模型入门教程,围绕吴恩达老师的大模型系列课程展开,主要包括:· 书写 Prompt 的原则;· 文本总结(如总结用户评论);· 文本推断(如情感分类、主题提取);· 文本转换(如翻译、自动纠错);· 扩展(如书写邮件);· 使用大语言模型的基本规范;· 通过分类与监督评估输入;· 通过思维链推理及链式提示处理输入;· 检查并评估系统输出;· 模型、提示和解析器;· 应用程序所需要用到的存储;· 搭建模型链;· 基于文档的问答系统;· 评估与代理;· 上下文学习;

AI天才研究院 1万+

什么是LLM?看这一篇就够了!

自从2022年12月 ChatGPT 横空面世以来,AI 领域获得了十足的关注和资本,其实AI的概念在早些年也火过一波,本轮 AI 热潮相比于之前的 AI,最大的区别在于:生成式。本文主要介绍大语言模型(Large Language Model,简称LLM)。通过海量文本训练的、能识别人类语言、执行语言类任务、拥有大量参数的模型,称之为大语言模型。

python1222_的博客 2万+

最流行的开源 LLM (大语言模型)整理

Large Language Model (LLM) 即大规模语言模型,是一种基于深度学习的自然语言处理模型,它能够学习到自然语言的语法和语义,从而可以生成人类可读的文本。

互联网架构师笔记 7038

LLM(大语言模型)——大模型简介

ChatGPT 的巨大成功激发了越来越多的开发者兴趣,他们希望利用 OpenAI 提供的 API 或者私有化模型,来开发基于大型语言模型的应用程序。尽管大型语言模型的调用相对简单,但要创建完整的应用程序,仍然需要大量的定制开发工作,包括API集成、互动逻辑、数据存储等等。为了解决这个问题,从 2022 年开始,许多机构和个人相继推出了多个开源项目,旨在帮助开发者们快速构建基于大型语言模型的端到端应用程序或工作流程。其中一个备受关注的项目就是 LangChain 框架。

telescopewang的博客 5万+

扣子Coze智能体万字教程:从入门到精通,一文掌握AI工作流搭建

智能体 = 角色设定 + 提示词 + 变量输入一个好提示词的核心是结构、风格和复用性创建后可以一键发布成网页应用、对话助手整个过程0代码,只靠配置,人人可学,人人可用四、进阶一:理解「工作流」的威力如果你已经用扣子创建了几个简单的智能体,比如写个爆款小红书文案、生成一段短视频脚本,那恭喜你已经入门。但如果你还停留在“一个智能体 = 一段提示词”的层级,你离真正的智能体生产力革命,还差一步:学会搭建“工作流”——让多个大模型自动协同完成任务。

互联网架构师笔记 3505

excel 利用SUBTOTAL函数计算筛选后数列总和、均值、最大、最小值

表里有三个人,咱们需要筛选出三个人,并分别计算他们的总和值。 先看一下数据范围(A1:B27) 通过筛选找张三。 按照上图所示输入函数,选择9,求和。 然后按照函数输入即可。 就能计算出结果。 筛选项选择王五,就会自动计算王五的总和。 筛选到李四就会自动计算李四的总和。 如果把9改成1,就是自动计算筛选出来的均值结果,如下图所示。 如果改成4就是取筛选项的最大值,选择5就是取最小值。 ...

yuanYW7556的博客 3万+

【2025版】最新大语言模型LLM基础扫盲速通版,零基础入门到精通,收藏这篇就够了

根据任务需求选择适合的神经网络结构,例如Transformer架构。

Javachichi的博客 2963

【Python脚本】Python自动大麦网抢票,准点原价秒杀演唱会门票,拒绝黄牛交易!从我做起!!!1

你是否错过了周杰伦的票,最近又没抢到五月天的票,不要太难过,今晚有张学友的票,后天还有张杰的票,加油哦!

weixin_45841831的博客 6万+

扣子Coze智能体万字教程:从入门到精通,一文掌握AI工作流搭建,大模型从入门到精通,收藏这篇就够了

我决定写一篇扣子Coze智能体小白入门教程,一站式带你搞懂扣子的基础逻辑、核心概念、关键操作和落地场景。

huang9604的博客 3347

Windows+VSCode+Cline+MCP全流程配置指南

本文提供了一份详细的Windows+VSCode+Cline+MCP全流程配置指南,旨在帮助开发者打造高效的AI辅助编码工作站。文章从环境准备讲起,逐步指导安装VSCode、配置Cline插件、搭建Node.js环境,并重点详解如何通过MCP为Cline集成文件系统和GitHub等工具服务器,实现用自然语言操控开发环境,从而显著提升日常编码与文件管理效率。

weixin_28840143的博客 552

数据产品需求文档(PRD)怎么写?阿里P8分享的模板+5个避坑点

作用:记录文档的版本、作者、评审信息,避免“文档混乱”。填写规范字段说明示例文档名称清晰反映产品名称,如“用户行为分析平台PRD”用户行为分析平台PRD_V1.0文档版本用“版本号+日期”,如V1.0_20240301编写人数据产品经理姓名+联系方式张三(138-XXXX-XXXX)评审人员业务负责人、开发经理、数据分析师、运维负责人李四(业务)、王五(开发)、赵六(数据)、周七(运维)评审时间评审日期2024-03-05评审意见。

架构师的AI之路,分享AI应用开发架构的学习与实践。 1574

新手必读!2025最全AI智能体入门手册,50个问题全讲透,大模型入门到精通,收藏这篇就足够了!

我把近半年在智能体领域的学习、实战经验、和线下大家最常问的问题,整理成这篇《智能体最全入门指南50个问题解答》合集, 尽量用通俗易懂的语言讲清楚每个关键点。

2401_82469710的博客 1456

【计算机三级-数据库技术】操作题大题(第1套)

从触发器的语法中可知,【1】处应该填写的是执行触发器的表,【2】处应该填写指定在表或视图上执行哪些数据修改语句时将激活触发器的关键字。使用FOR或AFTER选顶定义的触发器为后触发器,即只有在引发触发器执行的语句中的操作都已成功执行,并且所有的约束检查也成功完成后,才执行触发器。转换成新的独立的模式,模式的属性由联系本身的属性及两个实体的键构成,主键由两端实体的键组合而成。实体的转换:在从ER图转换为关系模式时,一个实体转换成一个关系模式,实体的属性就是关系模式的属性,实体的键就是关系的主键。

放纵小开爱的博客 1101

扣子Coze智能体万字教程:从入门到精通,一文掌握AI工作流搭建,大模型入门到精通,收藏这篇就足够了!

我决定写一篇扣子Coze智能体小白入门教程,一站式带你搞懂扣子的基础逻辑、核心概念、关键操作和落地场景。

2401_82469710的博客 3334

Allegro23.1新功能之软件自带阻抗计算工具操作指导

Allegro升级到了23.1后,软件新增了一个自带阻抗计算的功能,如下图。Propagation velocity:传输速度,单位是光速的多少倍。Dielectric constant输入介电常数,这里使用常规4。新功能之软件自带阻抗计算工具。如何使用,具体操作如下。

weixin_54787054的博客 783

基于 OpenCVSharp 的晶圆缺口自动检测与旋正方案

在半导体制造过程中,晶圆(Wafer)需要精确定位才能进行后续加工。每个晶圆边缘都有一个特定的缺口,这个缺口就像 "箭头" 一样,帮助机器确定晶圆的方向。我们的任务就是通过摄像头拍摄的图片,自动找到这个缺口的位置,计算出需要旋转多少角度才能让晶圆对准正确方向。简单来说,这个技术就像给晶圆 "找方向",确保它在生产线上始终保持正确的姿态。

品质生活,极致编程。 1211

一文看懂大模型热门核心概念:LLM、Prompt、AI Agent、RAG...【建议收藏】

大模型(

Libra1313的博客 879

SAP SD模块定价过程后台配置简介

只有手工输入定价时(例如,在定价中的定价浏览屏幕中),或者只有从外部处理转移这些定价时(例如,成本核算),才将这些定价包括在确定(价格确定、输出确定,批次确定)之中。定价过程的定义和分配是SD模块中最核心的配置,包含了条件表、条件类型、存取顺序、发票类型、客户定价过程等,确定了销售订单已什么价格销售、税率、附加折扣等多个条件行程有一个定价过程。12、小计:记录该条件类型在VBAP表中是否存储,以及其后续用途,如记入信贷,占用信贷额度,记入成本等,如果需要金额暂用信贷额度的话,在小计这里选择A即可。

我小时候很黑的博客 3782

AI Agent 第四篇:【2026零基础AI教程4】2026AI术语零基础速查!LLM/ReAct/DAG/MCP/A2A全网大白话词典(新手扫盲必备)

知识点听得懂、术语全看不懂。看技术文档、框架源码、面试题时,满屏缩写和专业名词:LLM、ReAct、DAG、Checkpoint、MCP、A2A、FC、Workflow、Multi-Agent……一个个陌生词汇直接劝退,导致学习断层,越学越乱。本篇作为整套22篇合集的专属术语词典,专门为纯小白打造,不堆砌公式、不讲晦涩理论,全部生活化比喻+通俗大白话。同时严格区分2025过时技术和2026最新行业标准,帮你彻底扫清后续所有文章的阅读障碍,从此看AI架构、框架、面试内容零门槛。建议。

weixin_44661794的博客 246

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

一篇文章帮你扫盲AI基础知识

LLM是AI的“大脑皮层”,负责把杂乱的信息转化成人类能理解的逻辑——比如把“我想吃火锅”翻译成“搜索附近评分高的川味火锅店”。如果把AI比作“打工人”,普通AI是只会回答问题的客服,而‌Agent则是能帮你订机票、写报告、管日程的全能管家‌。代码:"print('hello')" → ["print","(","'","hello","'",")"](6个Token)官方解释:RAG技术,是一种基于检索增强的生成技术。中文:"人工智能" → ["人","工","智能"](3个Token)

分享Java、Python、AI相关技术以及面试技巧 465

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

从 0 到 商用:AI Agent x SKILL x MCP 全栈实战教程:L1 基础篇:概念扫盲 + Hello World

》本篇目标:用半天时间理解 LLM / Agent / SKILL / MCP 四个核心概念, 》并在你的电脑上跑出第一个能用的 Agent 和 SKILL.

sou_time 220

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

【AI大模型知识点扫盲】Transformer到底是个啥?(说人话版)

Transformer架构简介 Transformer是一种革命性的深度学习模型,采用自注意力机制并行处理序列数据,克服了传统RNN的顺序处理限制。该架构由编码器和解码器组成,核心组件包括多头注意力机制、位置编码、前馈网络等,能够高效捕捉长距离依赖关系。其并行处理能力和可扩展性推动了BERT、GPT等大模型的发展,成为当前自然语言处理领域的主流架构。随着AI技术的快速发展,掌握Transformer等大模型技术将为职业发展带来新机遇。

javatiange的博客 1262

从零开始学AI--AI知识点扫盲

AI大模型与RAG技术发展现状分析 当前AI大模型已形成国际国内两大梯队:国际主流如GPT-5、Claude 4和Gemini 2.5各具优势,国内则以DeepSeek-V3、Qwen2-Plus等为代表。RAG(检索增强生成)技术通过"检索-生成"机制有效解决了大模型知识过时、幻觉等问题,成为企业定制AI的重要方案。相比微调,RAG具有成本低、知识更新快等优势,在AI技术栈中扮演"外接大脑"角色,与Function Calling共同构成AI Agent的核心能力组

66就是六六啦的博客 1289

AI大模型基础概念扫盲篇:Agent、Token、MoE、RAG、Embedding、对齐、Transformer、预训练、微调

OpenAl对Al Agent的定义是: 以大语言模型为核心驱动,具备自主感知需求、拆解任务、记忆信息、调用工具能力,能端到端完成复杂目标的智能系统

javatiange的博客 967

(2025年)计算机专业必看的保姆级教程!AI大模型学习路线图,从入门到实战全程指南,超详细!

【摘要】本文针对计算机专业学生系统学习大模型的痛点,提出2025年技术趋势下的四阶段学习路径:1)1-3个月打基础,掌握数学框架和PyTorch;2)3-6个月突破核心,深入Transformer架构与微调技术;3)6-12个月实战落地,开发RAG系统并掌握模型优化;4)1年以上追踪前沿,参与开源项目。强调AI时代"早学早受益"原则,并提供包含提示词工程、RAG系统开发等实用工具包。文章指出大模型岗位缺口达47万,初级工程师平均月薪28K,并分享成功转行案例,最后附赠免费学习资源包

WANGJUNAIJIAO的博客 1744

(2025)大模型学习路线:4个月从入门到能独立调参的完整路径,巨详细!

本文提供了一套四阶段大模型学习路线图:基础打底期(数学与编程基础)、核心突破期(Transformer深入理解)、实战落地期(RAG知识库等项目实践)和前沿冲刺期(多模态等前沿技术)。强调边学边练的实践方法,通过PyTorch、Hugging Face等工具,从零基础逐步提升至能独立调参、做项目的实战能力。

2401_84495872的博客 1444
上一篇: 2025年供应链攻击或成企业主要威胁,(非常详细)从零基础到精通,收藏这篇就够了!
下一篇: 【2025版】最新DeepSeek大模型微调实战(超详细实战篇)零基础入门到精通,收藏这篇就够了
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值