Python干货:panda特殊索引器——过滤数据

pandas实现将dataframe满足某一条件的值选出 今天小编就为大家分享一篇pandas实现将dataframe满足某一条件的值选出,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧 立即下载

迄今为止最常见从DataFrame获取元素、行和列的数据索引方式:

  • Dataframe.[];此函数也称为索引运算符。
  • Dataframe.loc[] :此函数用于标签。
  • Dataframe.iloc[] :此函数用于基于位置或整数的
  • Dataframe.ix[] :此函数用于标号和基于整数的函数。

它们统称为索引器。而布尔索引是一种索引类型,它使用DataFrame中数据的实际值。

它们统称为索引器。而布尔索引是一种索引类型,它使用DataFrame中数据的实际值。

根据DataFrame中数据的实际值而不是它们的行/列标签或整数位置来选择数据子集。

在布尔索引中使用布尔向量过滤数据,通过四种方式过滤数据:

  • 使用布尔索引访问DataFrame
  • 将布尔掩码应用于数据帧
  • 基于列值的掩蔽数据
  • 基于索引值的掩蔽数据

使用布尔索引访问DataFrame:

创建一个dataframe,其中的dataframe索引包含一个布尔值。即“True”或“false”。例如

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}
   
df = pd.DataFrame(dict, index = [True, False, True, False])
   
print(df)

产出:

借助布尔索引访问数据,使用以下三个函数访问数据文件.loc[], .iloc[], .ix[]

使用布尔索引访问Dataframe.loc[]

为了访问具有布尔索引的数据,使用.loc[],我们只需将布尔值(真或假)传递给.loc[]功能。

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}
  
# creating a dataframe with boolean index 
df = pd.DataFrame(dict, index = [True, False, True, False])
  
# accessing a dataframe using .loc[] function 
print(df.loc[True])

产出:
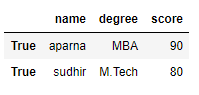
使用布尔索引访问Dataframe.iloc[]

为了访问数据文件,请使用.iloc[],我们必须在iloc[]功能但iloc[]函数只接受整数作为参数,因此它将引发一个错误,因此我们只能在将整数传递给iloc[]功能
代码1:

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}
  
# creating a dataframe with boolean index  
df = pd.DataFrame(dict, index = [True, False, True, False])
  
# accessing a dataframe using .iloc[] function 
print(df.iloc[True])

产出:

TypeError 

代码2:

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}
  
# creating a dataframe with boolean index  
df = pd.DataFrame(dict, index = [True, False, True, False])
   
  
# accessing a dataframe using .iloc[] function
print(df.iloc[1])

产出:
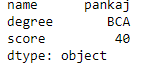
使用布尔索引访问Dataframe.ix[]

为了访问数据文件,请使用.ix[],我们必须将布尔值(真或假)和整数值传递给.ix[]因为我们知道.ix[]函数是.loc[]和.iloc[]功能。
代码1:

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}
  
# creating a dataframe with boolean index 
df = pd.DataFrame(dict, index = [True, False, True, False])
   
  
# accessing a dataframe using .ix[] function
print(df.ix[1])

产出:
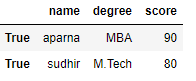
代码2:

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}
  
# creating a dataframe with boolean index 
df = pd.DataFrame(dict, index = [True, False, True, False])
   
  
# accessing a dataframe using .ix[] function
print(df.ix[1])

产出:
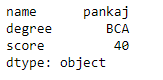
将布尔掩码应用于dataframe:

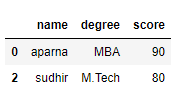
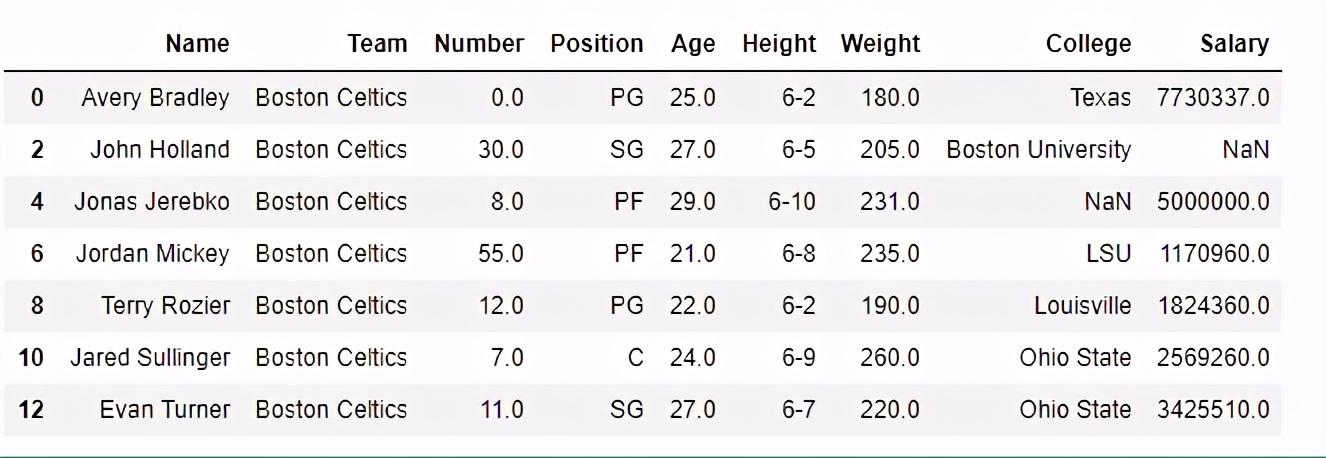
应用一个布尔掩码,它将只打印传递布尔值True的数据,使用__getitems__或[]访问。

用dataframe中包含的长度相同的真假列表来应用布尔掩码,

代码1:

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["MBA", "BCA", "M.Tech", "MBA"],
        'score':[90, 40, 80, 98]}
   
df = pd.DataFrame(dict, index = [0, 1, 2, 3])


print(df[[True, False, True, False]])

产出:
代码2:

# importing pandas package
import pandas as pd
   
# making data frame from csv file
data = pd.read_csv("nba1.1.csv")
   
df = pd.DataFrame(data, index = [0, 1, 2, 3, 4, 5, 6,
                                 7, 8, 9, 10, 11, 12])
  
   
df[[True, False, True, False, True,
    False, True, False, True, False,
                True, False, True]]

产出:
基于列值的掩蔽数据:
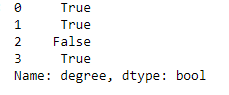
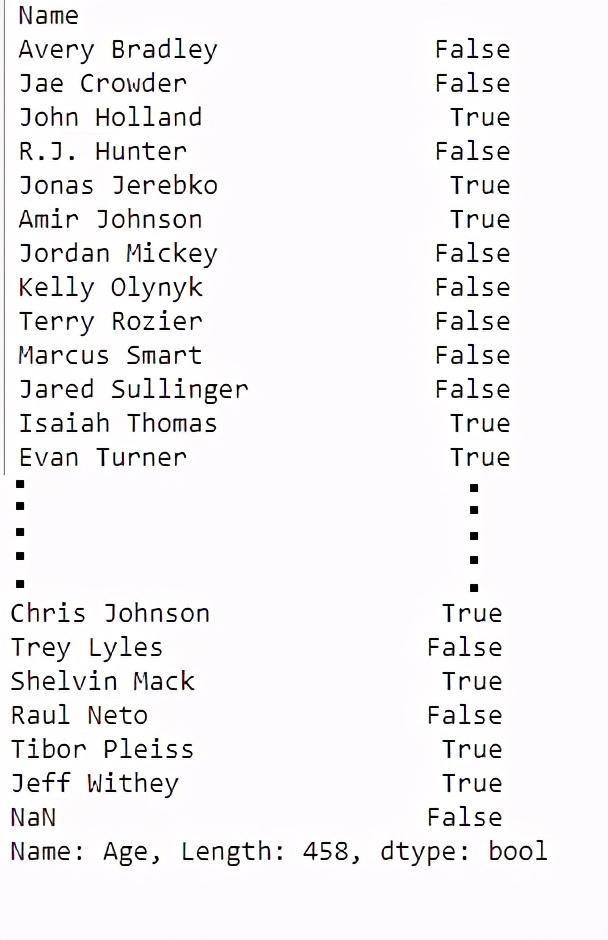
在dataframe中,使用不同的运算符(如==, >, <, <=, >=)根据列值对数据进行过滤。

代码1:

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["BCA", "BCA", "M.Tech", "BCA"],
        'score':[90, 40, 80, 98]}
  
# creating a dataframe 
df = pd.DataFrame(dict)
   
# using a comparison operator for filtering of data
print(df['degree'] == 'BCA')

产出:
代码2:

# importing pandas package
import pandas as pd
   
# making data frame from csv file
data = pd.read_csv("nba.csv", index_col ="Name")
   
# using greater than operator for filtering of data
print(data['Age'] > 25)

产出:
基于索引值的掩蔽数据:
在dataframe中,使用不同的运算符创建基于索引值的掩码 ==, >, <

代码1:

# importing pandas as pd
import pandas as pd
   
# dictionary of lists
dict = {'name':["aparna", "pankaj", "sudhir", "Geeku"],
        'degree': ["BCA", "BCA", "M.Tech", "BCA"],
        'score':[90, 40, 80, 98]}
   
  
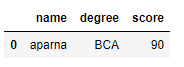
df = pd.DataFrame(dict, index = [0, 1, 2, 3])
  
mask = df.index == 0
  
print(df[mask])

产出:
代码2:

# importing pandas package
import pandas as pd
   
# making data frame from csv file
data = pd.read_csv("nba1.1.csv")
  
# giving a index to a dataframe
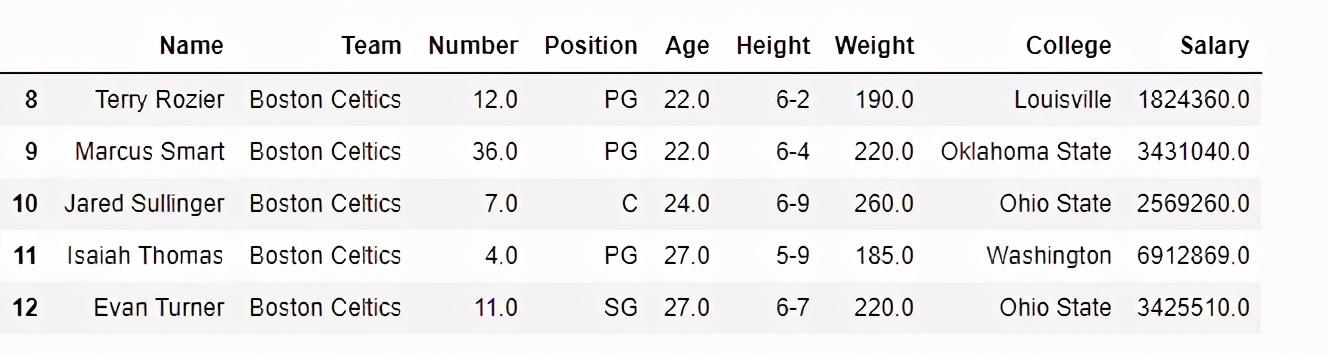
df = pd.DataFrame(data, index = [0, 1, 2, 3, 4, 5, 6,
                                 7, 8, 9, 10, 11, 12])
  
# filtering data on index value
mask = df.index > 7 
  
df[mask]

  产出:
 

华为CCA架构软件栈VehicleStack解析:3层服务化设计与AOS/VOS双核OS 本文深入解析华为CCA架构下的VehicleStack软件平台,重点介绍其三层服务化设计(硬件抽象层、服务框架层、应用层)与AOS/VOS双核操作系统协同机制。该架构通过计算与通信的深度融合,推动汽车电子电气架构向集中式发展,为智能汽车提供灵活、高效的软件定义汽车解决方案。 阅读详情

相关推荐

从波形到代码:手把手调试GaN图腾柱PFC的过零点切换与软启动策略

本文详细解析了GaN图腾柱无桥Boost PFC电路在过零点切换与软启动策略中的调试方法。通过波形分析、代码实现和寄存器配置,提供了解决误开通、震荡波形等问题的实用方案,帮助工程师优化电源设计效率与可靠性。

weixin_30831529的博客 424

Python dataframe 多条件筛选/过滤数据的方法及函数isin,query,contains,loc的使用介绍

1. 背景概述 日常的数据分析中,经常遇到需要根据各种不同的条件从数据集中筛选相应的数据记录,再进行提取、分析、替换、修改等操作。因此,筛选是数据分析中使用频率很高的功能。一般而言,通常是使用for循环在数据中进行筛选,本文总结了在python中常用的并且使用效率比较高的几种数据筛选函数如:isin(), query(), contrains(),以及它们的实践示例。 2. 筛选方法和函数简介 简单的筛选方法: 单一的筛选条件或值 df.loc[df[“column_name”] == value] 复

weixin_45914452的博客 13万+

基于多物理参数数据融合和先进人工智能算法的锂电池热失控监测传感器

基于多物理参数数据融合和先进人工智能算法的锂电池热失控监测传感器是多种方案中的优选项!是一种快速、准确、可靠、应用广泛的传感方案!可有效监测锂离子电池热失控风险,保障化学能储能电站安全!

chicheng_danxin的博客 2414

python - pandas 之 dataframe - 行列筛选/遍历/新增/删除/连接/合并/修改/跨表update

1.dataframe遍历或迭代 list1=[['B1','2019-12-01',3], ['B2','2019-12-01',8],['A1','2019-12-02',4],['A2','2019-12-09',5]] data=pd.DataFrame(list1,columns=('asin','date','qty')) (1)按行遍历iterrows() iterrows() 按行遍历,返回(index, Series)对,通过row[name]访问元素 ...

开码河粉 1万+

大疆OcuSync系统背后的黑科技:跳频扩频技术如何让你的无人机飞得更稳

本文深入解析了大疆OcuSync系统如何运用跳频扩频技术等先进无线通信方案,显著提升无人机在复杂环境下的飞行稳定性。系统通过跳频扩频与直接序列扩频技术协同工作,结合双频智能切换与多天线MIMO,有效对抗信号干扰与多径效应,确保控制指令与高清图传的可靠、低延迟传输,为用户带来更安心、更流畅的飞行体验。

ol7890123的博客 630

快速上手:网页版EggNOG功能注释全流程解析

本文详细解析了网页版EggNOG在蛋白序列功能注释中的全流程操作,从初识工具到实战技巧,涵盖FASTA格式处理、参数设置、结果解读及常见问题解决方案。特别适合生物信息学初学者快速掌握这一高效注释工具,提升非模式生物基因组研究的注释效率。

weixin_29310631的博客 191

pandas 过滤数据 ,布尔型数组索引Series, DataFrame

过滤Series中或DataFrame列中数据,在pandas中,可以用isin(values)函数。

lx104921的博客 233

常见消息队列:ActiveMQ、RabbitMQ、RocketMQ、Kafka的区别总结

常见消息队列:ActiveMQ、RabbitMQ、RocketMQ、Kafka的区别。

qq_30713721的博客 3472

Series与DataFrame索引、选取和过滤

Series from pandas import Series import numpy as np obj = Series(np.arange(4),index=['a','b','c','d']) obj a 0 b 1 c 2 d 3 dtype: int64 obj['b'] 1 obj[1] 1 obj[2:4] c 2 d 3 dt...

Mikowoo007的博客 1942

通过JLink下载实现工控MCU批量烧录实战案例

利用JLink下载工具实现高效稳定的工控MCU批量烧录,提升产线效率。案例详细解析了脚本配置与自动化流程,突出jlink下载的可靠性和可扩展性,适用于大规模嵌入式部署场景。

weixin_30205153的博客 814

英特尔SVS:十亿级向量搜索的硬件优化与LVQ压缩实战

向量搜索作为处理高维嵌入数据的核心技术,其核心原理是通过近似最近邻(ANN)算法在海量数据中快速找到相似项,以解决传统暴力搜索在规模上的瓶颈。这项技术的核心价值在于为推荐系统、图像检索、自然语言处理等AI应用提供高效的相似性匹配能力,尤其在RAG架构中成为连接非结构化数据与大语言模型的关键基础设施。面对十亿级数据带来的内存与算力挑战,局部自适应向量量化(LVQ)等压缩技术通过减少存储开销并保持精度,而硬件层面的深度优化则利用AVX-512等指令集大幅提升计算效率。本文聚焦于英特尔开源的Scalable Ve

weixin_42526310的博客 553

代码索引_Python干货:panda特殊索引器——过滤数据

迄今为止最常见从DataFrame获取元素、行和列的数据索引方式:Dataframe.[];此函数也称为索引运算符。Dataframe.loc[] :此函数用于标签。Dataframe.iloc[] :此函数用于基于位置或整数的Dataframe.ix[] :此函数用于标号和基于整数的函数。它们统称为索引器。而布尔索引是一种索引类型,它使用DataFrame中数据的实际值而不是它们的行/列标签或整...

weixin_42354944的博客 173

halcon与QT联合:(5.1)瓶盖检测以及QT界面搭建

halcon实现瓶盖检测与定位代码: dev_close_window() dev_open_window(0, 0, 1024, 1024, 'black', WindowHandle) list_image_files('C:/Users/TIMI/Desktop/picture/circle', 'default', [], ImageFiles) for J := 1 to 4 by 1 *read image read_image(halconImage, ImageFil

m0_37957160的博客 1044

python dataframe 获取index列_Python实用干货:panda多方面处理数据

Padas是用于数据分析的最流行的python库。它提供了高度优化的性能,后端源代码纯粹是用C或Python。可以用来分析:Series、DataFrames。Series系列是在熊猫中定义的一维(1-D)数组,可用于存储任何数据类型。代码1:创作系列# Program to create series# Import Panda Libraryimport pandas as pd#...

weixin_39778106的博客 5694

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Python实用干货:panda多方面处理数据

Padas是用于数据分析的最流行的python库。它提供了高度优化的性能,后端源代码纯粹是用C或Python。可以用来分析:Series、DataFrames。 Series系列是在熊猫中定义的一维(1-D)数组,可用于存储任何数据类型。 代码1:创作系列 # Program to create series # Import Panda Library import pandas as pd # Create series with Data, and Index a = pd.S...

Python6886的博客 255

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

【Python】20个Pandas数据实战案例,干货多多

今天我们讲一下pandas当中的数据过滤内容,小编之前也写过也一篇相类似的文章,但是是基于文本数据的过滤,大家有兴趣也可以去查阅一下。下面小编会给出大概20个案例来详细说明数据过滤的方法,...

fengdu78的博客 2204

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

python数据处理常用库_Python实用干货:多方面处理数据,panda库全搞定!

Padas是用于数据分析的最流行的python库。它提供了高度优化的性能,后端源代码纯粹是用C或Python。可以用来分析:Series、DataFrames。Series系列是在熊猫中定义的一维(1-D)数组,可用于存储任何数据类型。代码1:创作系列# Program to create series# Import Panda Libraryimport pandas as pd# Creat...

weixin_39980360的博客 444

python筛选数据时间_Python数据神器pandas,日期时间索引,快速筛选

发现许多小伙伴入门Python几个月,还是低效率做数据处理。这套课程以形象的示意图,精心安排的案例,循序渐进带你玩转数据处理分析神器——pandas,课程中还有分析案例噢,干货满满!前言想象一下你有一份销售数据,你能够解决以下哪些问题:日销量,周销量,月销量如何?哪些是工作日中最好卖的产品。周末呢?如果包含一些节假日呢?销量在一个月的时间内,周销量一直保持上升或下降的产品有哪些?销量出现大幅波动的...

weixin_39689506的博客 3915

dataframe去掉索引 python_Python小白数据科学教程:Pandas (上)

点击“简说Python”,选择“置顶/星标公众号”福利干货,第一时间送达!本文转载自公众号 |王的机器作者 |王圣元本文偏长(2w+字),老表建议先收藏,然后转发朋友圈,然后吃饭、休闲时慢慢看,基础知识重在反复看,反复记,反复练。【注:本帖小节 2.2 用万矿里的 WindPy 来下载金融数据】0引言Pandas 是 Python 为解决数据分析而创建的,详情看官网 (https:/...

weixin_35725821的博客 1836

20个Pandas数据实战案例,干货多多

今天我们讲一下pandas当中的数据过滤内容,小编之前也写过也一篇相类似的文章,但是是基于文本数据的过滤,大家有兴趣也可以去查阅一下。下面小编会给出大概20个案例来详细说明数据过滤的方法,...

小詹学python的博客 1379

3.5万字,图解Python数据分析最强库Pandas(全是干货,建议收藏)

大家好,在 Python 各个工具包中,最频繁使用的应该就是 Pandas 了。今天我以图解的方式给大家介绍 Pandas 中各种常用的操作,内容有点长,喜欢记得点赞、收藏、关注。

wangluoanquan152的博客 1万+

python比较灵活_Python数据分析处理,pandas中最灵活的查询方式,你真的会吗?

前言在使用 pandas 处理数据的场景中,根据某些条件对数据进行过滤,是一个使用频率非常高的操作。而 pandas 也提供了几种不同的操作方式。本文就对这些知识点做一次详细的讲解。通过本文你将学会以下内容:理解布尔过滤query 方法的一般用法、在多层索引中的使用、各种特殊用法在实战中如何混合使用布尔过滤与 query 方法注意,这同样是一篇3000字的干货长文……案例数据本来打算使用只有单层索...

weixin_39850143的博客 176

干货分享 | Python数据分析

keep:有三个可选参数,分别是first、last、False,默认为 first,表示只保留第一次出现的重复项,删除其余重复项,last表示只保留最后一次出现的重复项,False则表示删除所有重复项。1. 针对不同的数据文件格式,需要选择相应的模块进行数据导入,如导入excel文件需要使用xlrd模块,导入json文件需要使用json模块等。Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

m0_58477260的博客 83

python 报表分析网站_「干货」Python Pandas 做数据分析之玩转 Excel 报表分析

在工作中,实验数据和工作表格通常存储在 Excel 的文件中。也有人使用数据库,数据库本身自带简单的求和、计数等功能。如果做深入的数据分析,就离不开像 Python Pandas、TensorFlow 等专业工具了。数据库导出的数据文件通常为 CSV、UNL 格式。CSV 和 UNL 格式数据也可以用 Excel 打开并正常显示为表格,它们是使用特殊分隔符(比如 ,、| 或 ;)的文本型数据文件。...

weixin_42638139的博客 657

干货 | 一文让你了解Pandas数据结构

作者:木木 来源:Python数据分析实战与AI干货1导入相关的包importnumpyasnp importpandasaspd frompandas...

数据森麟 156
上一篇: 学历不再是大厂敲门砖!女孩子这样进互联网大厂
下一篇: Python知识:Python 3.x和2.x版本的使用区别
土豆编程
博客等级 码龄6年 105粉丝 117原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


