Python实用干货:panda多方面处理数据

Python干货宝典:如何处理Pandas中丢失的数据 当一个或多个项目或整个单元没有提供信息时,可能会出现丢失数据。在现实生活中,丢失数据是一个很大的问题,往往找半天还找不回来。 在Pandas中,缺少的数据由两个值表示: None:None是Python单例对象,通常用于丢失Python代码中的数据。 NaN(非数字的缩写),是所有使用标准ieee浮点表示的系统所认可的特殊浮点值。 pandas对于None和NaN本质上是可互换的,用于表示缺失或空值。 在Pandas DataFrame中有几个用于检测、删除和替换空值的有用函数: isnull() 阅读详情

Padas是用于数据分析的最流行的python库。它提供了高度优化的性能,后端源代码纯粹是用C或Python。可以用来分析:Series、DataFrames。

Series系列是在熊猫中定义的一维(1-D)数组,可用于存储任何数据类型。

代码1:创作系列

# Program to create series
  
# Import Panda Library
import pandas as pd  
  
# Create series with Data, and Index
a = pd.Series(Data, index = Index) 
  1. 标量值可以是整值、字符串
  2. Python字典可以是键,值对
  3. Ndarray

可以通过Series的两个属性,index 和 value  来分别获取索引和值

obj.index
Out[5]: RangeIndex(start=0, stop=4, step=1)
 
obj.values
Out[7]: array([2, 9, 5, 6], dtype=int64)

代码2:当数据包含标量值时

# Program to Create series with scalar values  
  
# Numeric data 
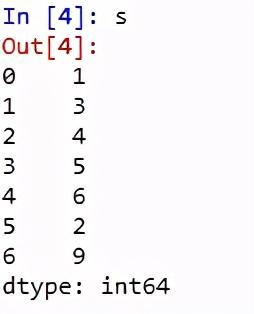
Data =[1, 3, 4, 5, 6, 2, 9]   
  
# Creating series with default index values 
s = pd.Series(Data)     
  
# predefined index values 
Index =['a', 'b', 'c', 'd', 'e', 'f', 'g']  
  
# Creating series with predefined index values 
si = pd.Series(Data, Index)  

输出量:
代码3:当数据包含字典时

# Program to Create Dictionary series 
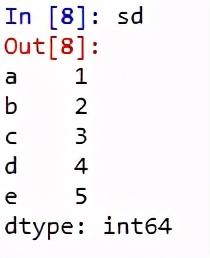
dictionary ={'a':1, 'b':2, 'c':3, 'd':4, 'e':5}  
  
# Creating series of Dictionary type 
sd = pd.Series(dictionary)  

输出量:
代码4:当数据包含Ndarray时

# Program to Create ndarray series 
  
# Defining 2darray 
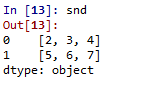
Data =[[2, 3, 4], [5, 6, 7]]   
  
# Creating series of 2darray 
snd = pd.Series(Data)     

输出量:
Series 索引的 name 和 值的 name(相当于这两个向量的名字)

obj3.name
obj3.name="population"
obj3.index.name="ind"
obj3
Out[23]: 
ind
b    2.0
a    1.0
d    NaN
Name: population, dtype: float64

DataFrames:

DataFrames是在熊猫中定义的由行和列组成的二维(2-D)数据结构。是一个典型的表格型数据,既有行索引,又有列索引。相当于一个大字典,字典的键是列索引,字典的值是一个Series;  构成这些索引的每一个值的Series都是共用一个 Series 索引的。

代码1:创建DataFrame

# Program to Create DataFrame
  
# Import Library
import pandas as pd   
  
# Create DataFrame with Data
a = pd.DataFrame(Data)  

在这里,数据可以是:

  1. 一个或多个字典
  2. 一个或多个系列
  3. 2D-Numpy Ndarray

代码2:当数据是字典时

# Program to Create Data Frame with two dictionaries
  
# Define Dictionary 1
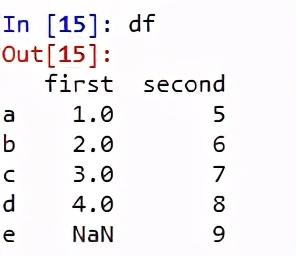
dict1 ={'a':1, 'b':2, 'c':3, 'd':4}   
  
# Define Dictionary 2     
dict2 ={'a':5, 'b':6, 'c':7, 'd':8, 'e':9} 
  
# Define Data with dict1 and dict2
Data = {'first':dict1, 'second':dict2} 
  
# Create DataFrame 
df = pd.DataFrame(Data)  

输出量:
 DataFrame 默认通过 列索引获取一个series;(在series中默认通过索引获取一个值)

df["popular"] 或者 df.popular
Out[37]: 
0     8
1     9
2    10
3    11
Name: popular, dtype: int64

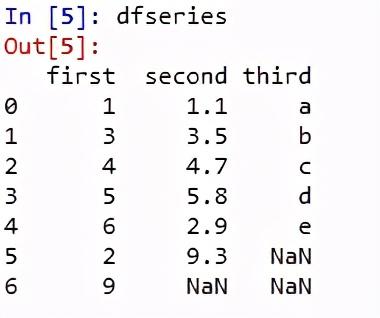
代码3:当数据是序列时

# Program to create Dataframe of three series 
import pandas as pd
  
# Define series 1
s1 = pd.Series([1, 3, 4, 5, 6, 2, 9])   
  
# Define series 2       
s2 = pd.Series([1.1, 3.5, 4.7, 5.8, 2.9, 9.3]) 
  
# Define series 3
s3 = pd.Series(['a', 'b', 'c', 'd', 'e'])     
  
# Define Data
Data ={'first':s1, 'second':s2, 'third':s3} 
  
# Create DataFrame
dfseries = pd.DataFrame(Data)    


输出量: 
DataFrame 通过 ix 间接获取行向量,行向量也是一个series,它的索引是原来DF的列索引。

df.loc[2]
Out[40]: 
cities       bj
year       2003
popular      10
Name: 2, dtype: object

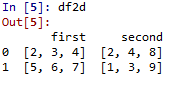
代码4:当数据为2D-numpy ndarray时
注:在创建2D数组的DataFrame时,必须维护一个约束--2D数组的维数必须相同。

# Program to create DataFrame from 2D array
  
# Import Library
import pandas as pd 
  
# Define 2d array 1
d1 =[[2, 3, 4], [5, 6, 7]] 
  
# Define 2d array 2
d2 =[[2, 4, 8], [1, 3, 9]] 
  
# Define Data
Data ={'first': d1, 'second': d2}  
  
# Create DataFrame
df2d = pd.DataFrame(Data) 
输出量:
 

干货 | 利用pandas处理Excel数据 新建一个excel表格(table1.csv)用于案例讲解: 导库 importpandasaspd importnumpyasnp 读取数据 df=pd.read_excel('table1.xlsx')#相对路径 #df=pd.read_excel(r'E:\Anaconda\hc\dataScience\table1.csv')#绝对路径 显示数据 显示数据的行与列数 df.shape (6,5) 显示数据格式dtpyes df.d... 阅读详情

相关推荐

麒麟OS恢复出厂设置原理与实操:非重装的系统状态回滚

Linux操作系统中的‘恢复出厂设置’并非简单重装或镜像还原,而是一种基于状态快照、包管理与配置模板的可控回滚机制。其核心原理依赖LVM快照技术、RPM包签名验证和预置配置模板,兼顾系统稳定性与用户数据安全。该方案在政务、教育等国产化场景中具有显著技术价值——不格式化硬盘、不丢失/home文档、不重配驱动与授权,大幅降低运维复杂度。典型应用场景包括系统卡顿修复、软件冲突清理、桌面环境异常恢复等。本文深入解析银河麒麟V10的kylin-restore-cli工具链与麒麟管家集成逻辑,聚焦‘恢复出厂设置’这一高

weixin_30879169的博客 776

python——pandas用法详解

Python本身的数据分析功能并不强,需要安装一些第三方的扩展库来增强它的能力。其中,针对结构化数据(可简单理解为二维表数据,或我们常用的Excel表格数据)分析能力最强的第三方扩展库就是Pandas。Pandas 是python的一个数据分析包,最初由AQR Capital Management于2008年4月开发,并于2009年底开源出来的,目前由专注于Python数据包开发的PyData开发team继续开发和维护,属于PyData项目的一部分。Pandas最初被作为金融数据分析工具。

longhaierwd的博客 1万+

关于对鱼眼相机图片进行畸变校正的两种思路

鱼眼畸变主要表现为径向畸变(Radial Distortion),图像中心正常,边缘向外拉伸。畸变模型通常基于入射角θ\thetaθ(光线与光学轴夹角)和图像半径rrr的关系。等距投影(Equidistant Projection)rdfθrd​fθ,其中rdr_drd​为畸变图像半径,fff为焦距,θ\thetaθ为入射角。等立体角投影(Equisolid Angle Projection)rd2fsin⁡θ2rd​2fsinθ/2。

qq_45670407的博客 1548

pandas 第三章 索引

第三章 索引 import numpy as np import pandas as pd 一、索引器 1. 表的列索引 列索引是最常见的索引形式,一般通过[]来实现。通过[列名]可以从DataFrame中取出相应的列,返回值为Series,例如从表中取出姓名一列: df = pd.read_csv('../data/learn_pandas.csv', usecols = ['School', 'Grade', 'Name', 'Gender', 'Weight', 'Transfer']) df['N

qq_41133851的博客 966

AI报告撰写实战指南:从提示词工程到全流程优化的底层逻辑与实践突破

传统AI写作常被诟病为“信息拼贴”——模型虽能生成文本,却常出现逻辑断裂、数据矛盾、风格不符等问题。而“全流程优化”则是通过系统化设计,将报告生成拆解为需求解析→数据对齐→提示词设计→初稿生成→迭代优化→格式适配六大环节,每个环节均通过技术手段提升输出质量。提示词工程:本质是通过结构化指令(如角色设定、任务分解、格式约束、示例引导)精准控制模型输出方向,是连接用户需求与模型能力的“翻译器”。全流程优化。

2501_92808811的博客 888

ETL第八章无人售货机零售项目实践

ETL实战项目——无人售货机

m0_52058217的博客 4418

python-panda库学习-从基础到高级操作

菜鸡一枚,仅学习记录

个人做题记录,大佬勿喷 1283

STM32CubeMX实战:TIM定时器中断配置避坑指南(附100ms精准定时代码)

本文深入解析STM32CubeMX配置TIM定时器中断的常见误区与避坑技巧,重点阐述时钟源、预分频器与自动重装载值的精准计算方法。通过实战案例,提供一份可直接复用的100ms精准定时中断代码模板,并分享调试验证方法,帮助开发者构建稳定可靠的嵌入式系统心跳。

grafana8visual的博客 500

python panda是什么_python pandas浅析

之前一直想自学一下大数据,正好七月在线在做1元优惠购活动,所以机缘巧合开始学习,今天就对最近学习的pandas进行一个笔记梳理,以便后续回顾。本次课程主要学习了以下内容:一. 简介pandas 是基于NumPy的一种工具,该工具是为了解决数据分析任务而创建的。Pandas 纳入了大量库和一些标准的数据模型,提供了高效地操作大型数据集所需的工具。pandas提供了大量能使我们快速便捷地处理数据的函数...

weixin_39600616的博客 3461

196、NPU的编译器开发:教程与示例代码编写

NPU编译器开发实战指南 摘要:本文分享了NPU编译器开发中的核心挑战与实战经验,通过具体代码示例展示了关键实现技术: 指令生成:必须考虑硬件特性(如地址对齐)和芯片配置抽象化 图优化:重点处理常见冗余结构(Reshape合并、BN融合),并注意数值稳定性 算子拆分:采用分块计算策略适配有限SRAM,需特别注意边界条件处理 内存分配:基于张量使用频率的贪心算法优化SRAM使用效率 文中包含多个真实踩坑案例: DMA地址未对齐导致硬件错误 BN融合时的除零风险 tile边界处理不当引起的精度下降 这些经验为开

m0_50546716的博客 99

天龙八部TLBB系列 - 网单用数据库修改为其他门派

专注于Android/Unity和各种游戏开发技巧,以及各种资源分享(网站、工具、素材、源码、游戏等) --- 天龙八部修改门派

空名先生 9431

3.5万字,图解Python数据分析最强库Pandas(全是干货,建议收藏)

大家好,在 Python 各个工具包中,最频繁使用的应该就是 Pandas 了。今天我以图解的方式给大家介绍 Pandas 中各种常用的操作,内容有点长,喜欢记得点赞、收藏、关注。

wangluoanquan152的博客 1万+

AI穿透式智慧粮仓

本报告基于 2025-2026 年全国多地智慧粮储实践案例,系统分析了 "AI + 穿透式" 智慧粮储体系的技术架构、AI 算法应用、提质增效成效、区域差异化特点及未来发展趋势。该体系通过多模态感知、智能算法与管控平台的深度融合,实现粮食存储全流程精准感知、智能预警与科学调控,显著降低储粮损耗与运营成本,大幅提升储粮安全水平与管理效率。报告梳理了各地差异化实践路径,提出针对性发展建议,为推动我国粮食仓储高质量发展、筑牢国家粮食安全防线提供参考。

reset2021的博客 231

python dataframe 获取index列_Python实用干货:panda多方面处理数据

Padas是用于数据分析的最流行的python库。它提供了高度优化的性能,后端源代码纯粹是用C或Python。可以用来分析:Series、DataFrames。Series系列是在熊猫中定义的一维(1-D)数组,可用于存储任何数据类型。代码1:创作系列# Program to create series# Import Panda Libraryimport pandas as pd#...

weixin_39778106的博客 5694

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

python数据处理常用库_Python实用干货:多方面处理数据,panda库全搞定!

Padas是用于数据分析的最流行的python库。它提供了高度优化的性能,后端源代码纯粹是用C或Python。可以用来分析:Series、DataFrames。Series系列是在熊猫中定义的一维(1-D)数组,可用于存储任何数据类型。代码1:创作系列# Program to create series# Import Panda Libraryimport pandas as pd# Creat...

weixin_39980360的博客 444

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

干货:用Python进行数据清洗,这7种方法你一定要掌握

导读:数据清洗是数据分析的必备环节,在进行分析过程中,会有很多不符合分析要求的数据,例如重复、错误、缺失、异常类数据。作者:常国珍、赵仁乾、张秋剑本文摘编自《Python...

大数据 4万+

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Python干货:panda特殊索引器——过滤数据

迄今为止最常见从DataFrame获取元素、行和列的数据索引方式: Dataframe.[];此函数也称为索引运算符。 Dataframe.loc[]:此函数用于标签。 Dataframe.iloc[]:此函数用于基于位置或整数的 Dataframe.ix[]:此函数用于标号和基于整数的函数。 它们统称为索引器。而布尔索引是一种索引类型,它使用DataFrame中数据的实际值。 它们统称为索引器。而布尔索引是一种索引类型,它使用DataFrame中数据的实际值。 根据DataFrame...

Python6886的博客 564

干货 | 利用Python操作mysql数据库

↑↑↑关注后"星标"简说Python 人人都可以简单入门Python、爬虫、数据分析 简说Python推荐作者:Tao 来源:知乎整理:凹凸数据 Oneold...

简说Python的博客 8202

超长干货:Python实操数据分析教程,轻松上手数据分析

在当今数据驱动的时代,数据分析成为了解锁洞见和驱动业务决策的关键。Python,作为一种功能强大且易于学习的编程语言,已成为数据分析的首选工具之一。本文将引导您了解使用Python进行数据分析的一般流程,包括数据清洗、分析处理、可视化和得出结论。

xiaolinyui的博客 2万+

Python学习干货,如何用Python进行数据分析?

我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

Python_cocola的博客 9883

python处理excel数据-Python干货:自动整理Excel表格

相信有不少朋友日常工作会用到 Excel 处理各式表格文件,更有甚者可能要花大把时间来做繁琐耗时的表格整理工作,今天我们就通过Python实现对表格的自动化整理。首先我们有这么一份数据表 source.csv:我们要做的是从上表中提取数据,来生成一份符合以下要求的表格:按照以下分组名单 group.xls 来整理数据表中的数据:最终要展现的数据项:其中"K数据/60”为数据表中的&quo...

weixin_37988176的博客 1886

python中excel数据分组处理

1.场景描述 因文本相似性热度统计(python版)需求中要根据故障类型进行分组统计,需要对excel进行分组后再分词统计,简单记录下,有需要的朋友可以直接拿走,不客气! 2.解决方案 采用pandas包首先进行分组,然后获取具体明细再进行分词处理(分词处理这里就不展开了),只介绍下python下excel分组,然后对具体明细进行处理。 2.1 完整代码 import pandas as pd ...

软件老王 6974

【Python】相当全面的Pandas文本数据处理,干货多多

今天我们来谈论一下pandas库当中文本数据的操作,希望大家再看完本篇文章之后会有不少的收获,我们大致会讲创建一个包含文本数据的DataFrame常用处理文本数据的方法的总结正则表达式与D...

fengdu78的博客 1342

代码索引_Python干货:panda特殊索引器——过滤数据

迄今为止最常见从DataFrame获取元素、行和列的数据索引方式:Dataframe.[];此函数也称为索引运算符。Dataframe.loc[] :此函数用于标签。Dataframe.iloc[] :此函数用于基于位置或整数的Dataframe.ix[] :此函数用于标号和基于整数的函数。它们统称为索引器。而布尔索引是一种索引类型,它使用DataFrame中数据的实际值。它们统称为索引器。而布尔...

weixin_39883670的博客 113

干货 :如何用Pandas处理文本数据?

作者:耿远昊,Datawhale成员,华东师范大学文本数据是指不能参与算术运算的任何字符,也称为字符型数据。如英文字母、汉字、不作为数值使用的数字(以单引号开头)和其他可输入的字符。文本...

数据分析 2332
上一篇: Zilliz开源!中国首位LF AI 董事会主席,曾获最大单笔融资
下一篇: Python干货宝典:如何处理Pandas中丢失的数据
土豆编程
博客等级 码龄6年 105粉丝 117原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


