小米开源MiMo-V2-Flash:打破大模型成本想象的技术密码

OSDU(Open Subsurface Data Universe,开放地下数据空间 / 开源地下数据生态系统) OSDU是由油气行业与云厂商共建的开源、云原生数据平台规范,旨在解决勘探开发领域数据孤岛、格式不统一、应用绑定等问题。其核心是“数据与应用解耦”,通过统一元数据模型、API及权限体系,实现跨云、跨项目的数据互通。平台支持地震、井筒、储层等专业数据管理,配套OpenVDS、ETP等标准,适配PB级体数据,支撑AI训练与数字孪生。虽为参考实现,非即用系统,但已成国际油气数字化底座趋势,国内三桶油正推进试点与国产化适配。 阅读详情

小米破局开源大模型:150亿参数如何与千亿级模型比肩

这一次,小米的AI野心超乎想象。
图片

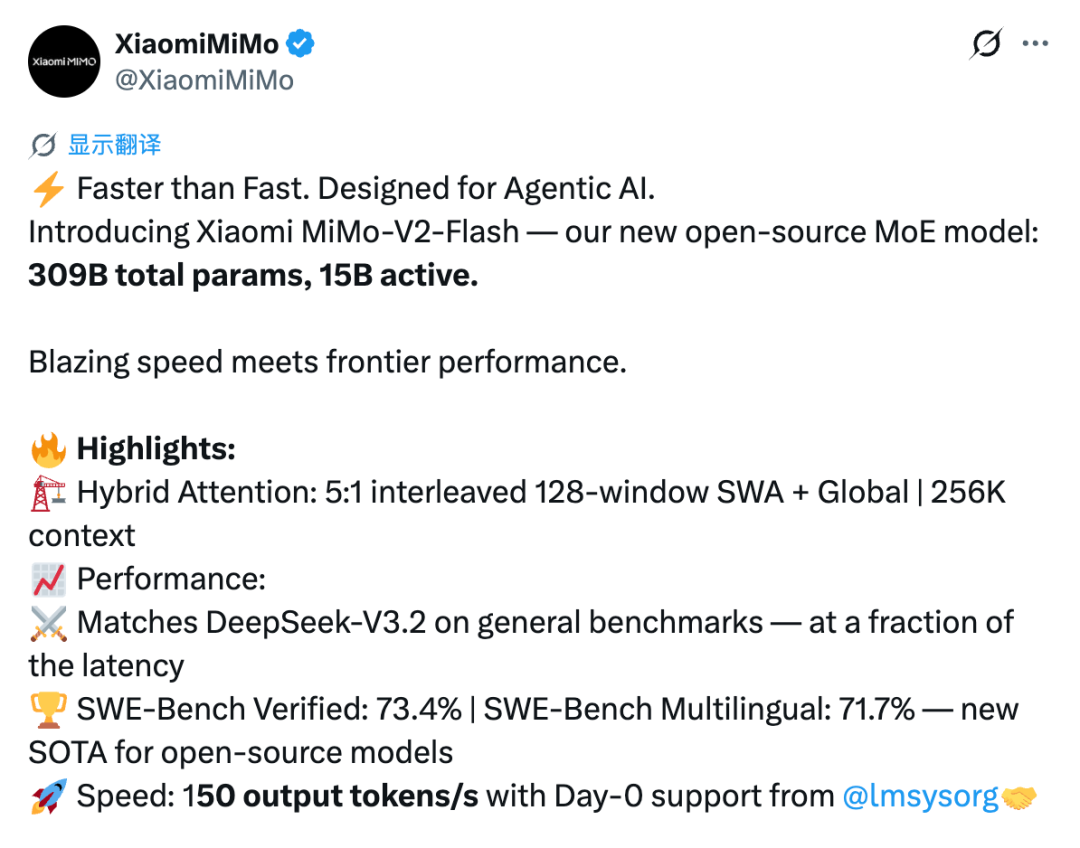
就在上周,小米正式发布并开源了MiMo-V2-Flash——参数量超300亿,但实际运算只用150亿参数的混合专家模型。更关键的是,这个“少数派”的性能却能与DeepSeek-V3.2、Kimi-K2等主流模型相近。这不是简单的追赶故事,而是重新考量了大模型必须堆砌海量参数的路线,为大模型效率提供了新视角。

这背后的技术逻辑,值得拆开来看。

架构如何打破效率天花板

传统大模型的低效已是众所周知的问题。推理慢、显存占用高、成本让人咋舌——这道难题横亘在每个开发者面前。MiMo-V2-Flash从架构层面动了真格。

小米采用了MoE(混合专家)结构,但玩法不同。超300亿参数中,每次推理只激活150亿。这等于什么?用一个"有选择性的大脑"——模型不铺张浪费地激活所有参数,而是聪慧地选中最相关的专家来处理任务。结果是计算成本直降,性能毫无妥协。

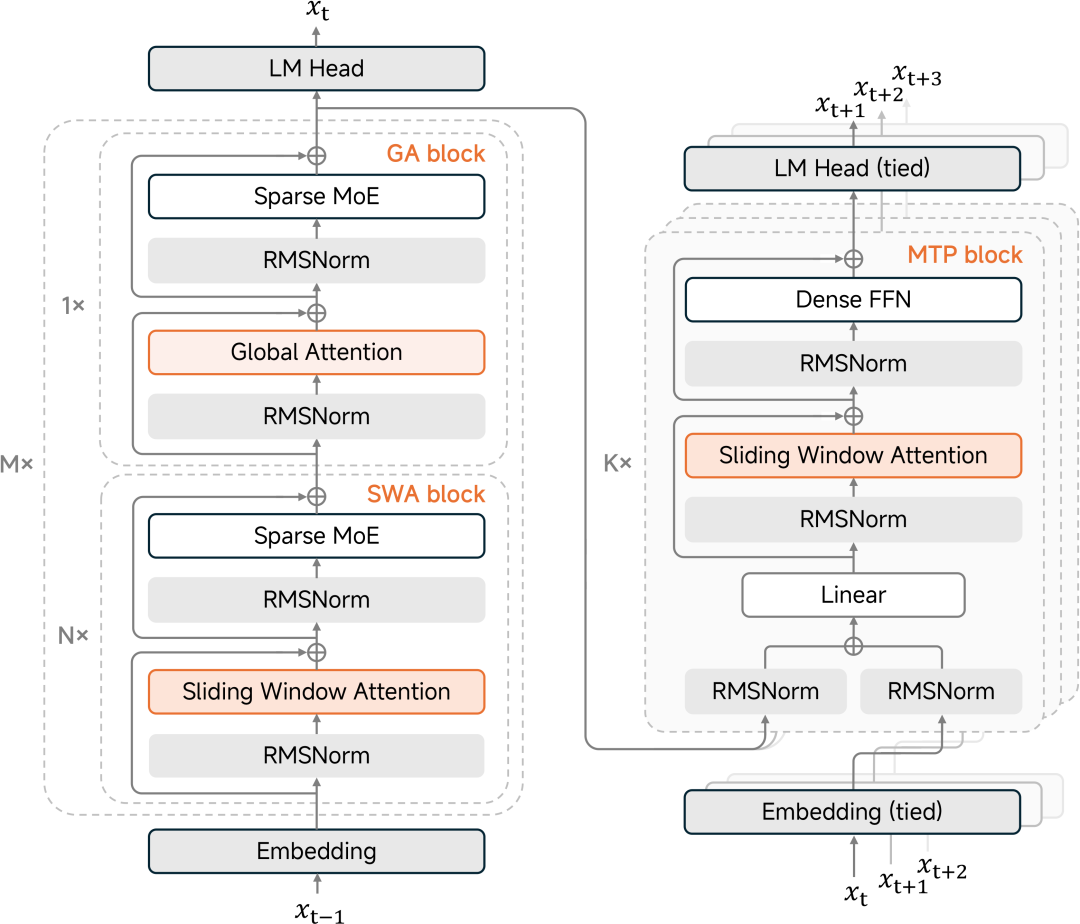
推理加速靠两项关键技术——混合滑动窗口注意力(SWA)和多Token预测(MTP)。传统模型处理长文本时,计算开销会飙升。小米的思路是:只看最近的128个token(滑动窗口),加上定期的全局扫描。这个激进的5:1配置听起来有风险,实验却证明,128这个数字恰好踩对了节点——不多不少。同时MTP让模型能一次预测多个token,就像人脑思考不是逐字蹦出,而是短句长段涌现。测试结果是推理速度提升2到2.6倍,达到每秒一百五十多个token。

训练效率上的创新更猛。MOPD(多教师在线策略蒸馏)技术打破了传统RL训练的束缚。以往的RL既不稳定又烧算力。新方法让学生模型自主采样,多个教师在token粒度上实时打分,而非等完整文本生成才评估。效率提升有多大?仅需传统方案1/50的算力,学生模型就能逼近教师性能。换个角度说——小米用50天做完的事,竞争对手要花2500多天。
图片

性能对标:数据怎么说

说再多也得看数据。

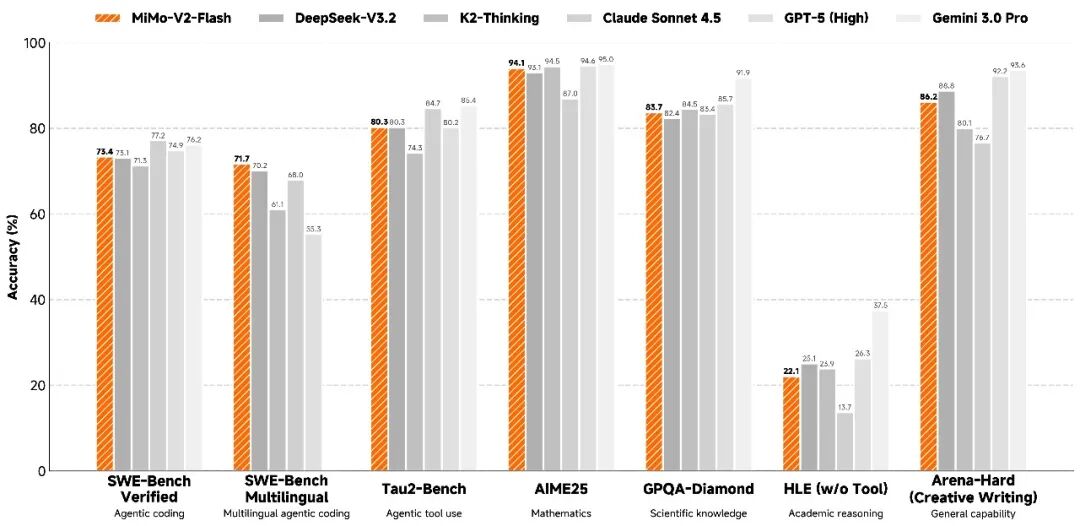
代码能力上,它在SWE-Bench Verified中超七成得分,在开源模型中表现突出,接近闭源顶稚水平。这不是让AI写“Hello World”,而是修复真实软件bug的真刀真枪考试。七成多的成功率意味着生产环境多数问题都能自动解决。SWE-Bench Multilingual那边的七成左右得分也足够亮眼,说明对不同编程语言的理解已达到可优先水准。

数学推理方面,AIME 2025和GPQA-Diamond评测中,MiMo-V2-Flash都排在开源模型前两位。这类测试考的不是参数数量,而是真正的推理能力——能否从零开始逐步推导复杂问题。

Agent任务那块更有看头——需要模型在工具调用、上下文切换、多轮互动中保持连贯。MiMo-V2-Flash在τ²-Bench的通信类得分较高,零售类也超七成,展现出在复杂真实场景中的驾驭能力。

性能没打折,成本大幅下降。
图片

Alt text: 性能基准对比图,展示MiMo-V2-Flash与DeepSeek-V3.2、Claude Sonnet 4.5、GPT-5、Gemini 3.0 Pro等模型在SWE-Bench、数学、科学知识、Agent任务等多项基准上的表现。图源:小米官方GitHub仓库

成本如何控制得这么低

全部优势背后,其实是一套精心的成本控制体系。

推理成本的症结在KV缓存——模型得存储历史token信息来处理长文本。常规方案下缓存随序列长度线性增长,MiMo-V2-Flash的滑动窗口方案把这需求从O(N)降到O(w),w只有128。结果是什么?缓存存储量少了近六倍,即便在二十五万多token超长上下文情境下,性能也没衰减。关键卡点是"sink values"这个设计——没它性能会崩,加上它就像推开了秘密门。

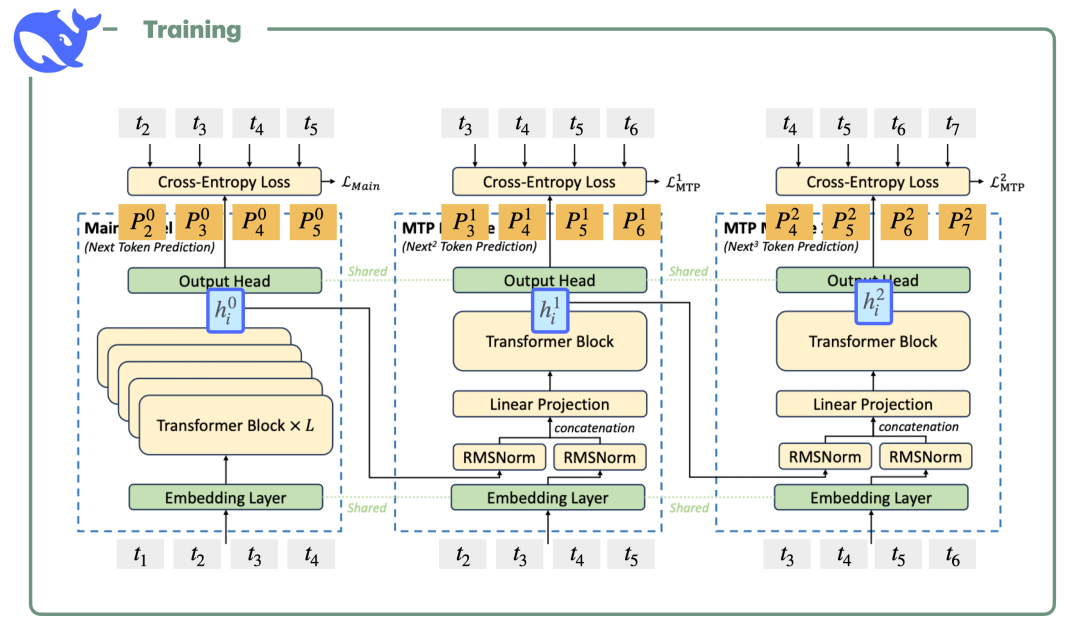
多Token预测那块同样精妙。传统生成文本是逐个token蹦出来,GPU大量时间在空转。MiMo-V2-Flash能一次预测接近四个token左右,速度平均提升两倍多。妙的是推理加速之外,训练采样阶段也能减少GPU闲置,两个好处一起拿。
图片

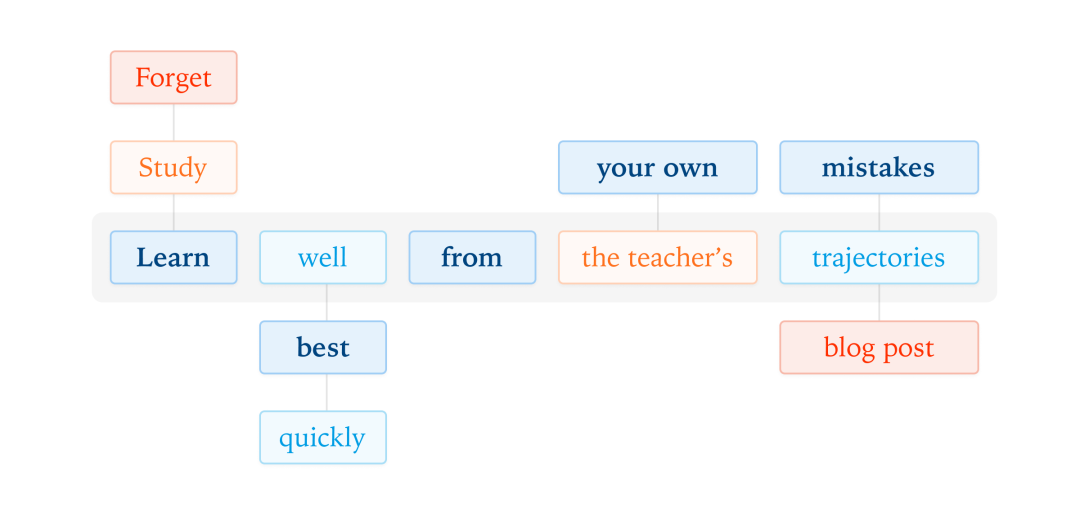
训练效率那块,MOPD威力更显著。它建构了教与学的循环:学生模型在自己策略分布上采样,多教师在token层面密集打分。对比传统SFT加RL的流程,这套思路不仅训练更稳,算力消耗也天差地别——花1/50的成本就能获得同等性能。学生模型后来变强了,还能反过来当教师,形成螺旋式进化。
图片

具体数字呢?输入成本不到一毛钱每百万token,输出成本约3、毛钱每百万token。这价格比同级别商业模型水滘较低,推理速度比主流方案提升了一倍。从经济账看,这就叫成本下降。

对开发者和产业的实际意义

对开发者而言,二十五万多token超长上下文是什么概念?约等于一部中等长度小说,或几十页的技术文档。足够让开发者在单次请求里塞下整个代码库、完整项目背景、数百轮聊天历史。与Claude Code、Cursor、Cline这些主流工具无缝协作,开发工作流从此改变。

对产业而言,MiMo-V2-Flash代表AI能力去中心化的一阶段。曾经高端模型是少数大厂独占。现在任何有GPU的团队都能本地部署一个与业界顾閱商业模型相孔的版本。小米还把全部推理代码贡献给了SGLang社区,技术报告完全开放,模型权重用MIT协议免费发行。这股彻底的开放姿态,为开源社区提供了新的参考范式。

深层看,这是小米对自身AI基础设施策略的一次深层投注。手机、IoT、汽车——小米硬件生态需要强劲的AI引擎。MiMo-V2-Flash就是那块基石。现在的开源模型,改日可能成为小米全生态的核心引擎。

十四年前,小米用一千九百九十九块钱重新定义旗舰手机价格。今天,MiMo-V2-Flash用性价比的创新、用效率的拓展,为开源大模型的成本与能力标准提供了新的参考。这一次,小米的节奏真的变了。

社区地址

OpenCSG社区:https://opencsg.com/models/XiaomiMiMo/MiMo-V2-Flash

hf社区:https://huggingface.co/XiaomiMiMo/MiMo-V2-Flash

关于 OpenCSG

OpenCSG 是全球领先的开源大模型社区平台,致力于打造开放、协同、可持续生态,AgenticOps是人工智能领域的一种AI原生方法论,由OpenCSG(开放传神)提出。AgenticOps是Agentic AI的最佳落地实践也是方法论。核心产品 CSGHub 提供模型、数据集、代码与 AI 应用的 一站式托管、协作与共享服务,具备业界领先的模型资产管理能力,支持多角色协同和高效复用。

更多推荐

图片

2024东南大学533复试C++程序设计笔试真题精讲 【东南553复试C++】2024东南大学533复试C++程序设计笔试真题精讲 阅读详情

相关推荐

ARM CMSIS DAP源码分析(二)

今天分析的是RDDI_DAP_GetARMRegs(DWORD *regs, DWORD *rfpu, ULONG64 mask)和RDDI_DAP_SetARMRegs(DWORD *regs, DWORD *rfpu, ULONG64 mask)这两个函数。 以RDDI_DAP_GetARMRegs(DWORD *regs, DWORD *rfpu, ULONG64 mask)为例,代码如下:

pengxiao618的专栏 7976

MiMo-Audio技术报告

MiMo-Audio技术报告摘要:该研究提出了一种基于无损压缩语音预训练的大规模音频语言模型MiMo-Audio,其核心创新包括:1)采用新型音频分词器架构,通过残差向量量化保留完整语音信息;2)将预训练数据扩展到1亿小时量级,验证了规模扩展带来的任务泛化能力;3)提出两阶段训练策略,结合多任务学习和对抗训练优化模型性能。实验表明,该模型在语音重建质量和多任务泛化能力上显著优于现有基线,特别是在少样本学习场景下展现出强大潜力。研究还首创性地将思维链技术整合到语音建模中,为弥合语音感知与复杂认知任务间的鸿沟提

weixin_64451672的博客 1852

SAR成像系列:【9】合成孔径雷达(SAR)成像算法-波数域(omega-K)成像算法[也叫距离徙动(RM)算法](附Matlab代码)

合成孔径雷达(SAR)波数域(wK)成像算法也称为距离徙动(RM)算法,它不存在近似条件,可以对整个成像区域基于散射点模型进行精确聚焦。有的文章中称它为SAR成像的最佳实现。

zr2006_7的专栏 1万+

MiMo-V2-Flash

小米开源大语言模型MiMo-V2-Flash采用创新的混合专家架构(MoE)和混合滑动窗口注意力机制,显著提升推理效率。该模型具备3090亿参数,支持256k上下文窗口,在数学竞赛、编程测试等多项基准中表现优异。通过轻量级多Token预测技术,推理速度提升2-2.6倍,成本仅为同类产品的2.5%。目前提供2周免费试用,开发者可通过GitHub获取完整开源代码和权重。

爱喝水的木子的博客 1871

从零开始开发AI Agent:基于大模型的智能体实战指南

### 摘要 本文介绍了AI Agent的开发全流程,从基础概念到实际部署,涵盖大模型集成、工具调用和记忆系统构建等核心技术。通过电商客服案例展示实战应用,并提供调试优化与部署方案,最后展望了AI Agent的未来发展方向,帮助开发者快速掌握智能体开发技能。

ghs_gss的博客 4860

BetaFlight开源飞控源码分析

BetaFlight是穿越机领域比较成熟的开源飞控,本篇文章主要分析一下源代码以及如何使用这个开源代码

weixin_43811044的博客 1万+

重磅!小米刚刚发布新模型MiMo-V2-Flash开源了!

小米开源3090亿参数大模型MiMo-V2-Flash,采用MoE架构,性能媲美DeepSeek-V3.2等顶尖开源模型。该模型具备150 tokens/秒推理速度,成本仅0.1美元/百万token输入,支持256K上下文窗口和多语言编程。在数学、科学测试中位列开源前二,编程能力尤其突出。关键技术包括混合滑动窗口注意力机制和多Token预测技术,显著提升效率。采用FP8混合精度训练和多教师在线策略蒸馏方法,仅需传统方法1/50算力。小米计划持续优化性能,构建支撑手机、IoT和汽车的AI核心架构。

javatiange的博客 800

基于Simulink的BCH码编解码仿真建模示例

BCH码是一类循环码,能够纠正一定数量的随机错误。灵活性:可以根据需要选择不同的码长和纠错能力。高效性:适用于短码长和中等码长的场景,广泛用于卫星通信、存储系统等。实现简单:编码和解码过程可以通过硬件或软件高效实现。在本示例中,我们将使用MATLAB/Simulink中的和模块来完成BCH码的编解码操作,并通过仿真验证其误码率(BER)性能。通过本指南,我们介绍了如何基于Simulink搭建一个BCH码的编解码模型,并进行了仿真以验证其性能。背景介绍:理解BCH码的基本原理及其在通信系统中的应用。

xiaoheshang_123的博客 188

小米的MiMo-V2-Flash,谷歌味挺浓

小米的风格是这样:当别人做得火热时,它先开始观望,等大家把路线探得差不多之后,它开始下场超车了。手机是如此,汽车是如此,MiMo亦是如此。总体来看,它不像是DeepSeek,能整新鲜的想法,它更多是把人家已经比较成熟的想法拼装起来。拼装的技术也是技术,就像是开源方案那么多,能整合用好,解决问题的仍然不多。MiMo-V2-Flash 一下子成绩追上来,速度还极快,确实有点超乎预期。这个模型当前仅支持文本输入,按照它的风格,下一步估计是扩展规模或者加入多模态,可以起名为 MiMo-V2-Pro了。

兴趣使然的创作者 2109

YOLOv11半监督学习深度解析:基于FixMatch改进的先进目标检测框架

本文探讨了半监督学习与YOLOv11结合的创新方法。针对目标检测中半监督学习面临的伪标签质量不稳定、特征一致性难保证等挑战,研究提出改进版FixMatch框架。通过分析YOLOv11架构特性(如多尺度特征提取、双标签分配策略等)与半监督学习的适配性,设计了三项关键技术改进:空间感知阈值策略、多任务解耦处理和记忆增强机制。该方法在少量标注数据下可实现接近全监督的性能,显著降低工业检测等场景的数据标注成本。

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 2081

R语言广义加型模型(GAM)的运用例子及实现教程

一旦拟合了广义加型模型,我们可以查看模型摘要和诊断,以评估模型的质量和拟合情况。# 查看模型摘要响应变量:mpg(汽车的燃油效率)拟合函数:mpg ~ s(hp) + s(wt)

Mrrunsen的博客 3444

Agent学习——小米MiMo-V2-Flash使用方法

小米推出MiMo-V2-Flash大模型,主打高性价比与高效能。该模型API定价仅为输入$0.1/Mtokens、输出$0.3/Mtokens,推理成本仅为Claude4.5Sonnet的2.5%,且目前限时免费。技术上采用混合注意力机制,支持32K原生上下文并可扩展至256K,在多个Agent测评基准中保持全球开源模型Top2。模型适用于智能对话场景,支持深度思考和联网搜索,采用MIT协议开放商用。提供在线体验和四种调用方式(Python/curl/JavaScript),启动服务后即可直接使用OpenA

2702

Qt CEF融合技QCefView使用教程

如果从事C++客户端开发,对CEF应该不陌生,当C++界面需要和web交互时,CEF是很好的解决方案,当然Qt也提供了QWebEngineView来进行web交互,最近在万兴喵影的安装目录看到了QCefView.dll,之前也听说过这个库,没在意,没想到还真有人用到项目里面,于是决定自己编译写个demo看看......

琅嬛福地 1万+

国产大模型包揽OpenRouter前五:当“白菜价“MoE改写全球AI调用版图

国产大模型能在调用量上碾压海外对手,核心密码不在模型有多大,而在激活有多小。中国大模型普遍采用MoE(混合专家)架构。以DeepSeek V4 Flash为例:总参数284B,但单次推理只激活13B——激活比不到5%。这意味着,模型拥有大参数带来的知识容量,却只付出小参数的推理成本。官方定价每百万Token输入1元、输出2元,这个价格在海外厂商看来几乎不可理解。腾讯Hy3更极端:总参数295B,单次推理仅激活21B,激活比约7%。

interpromotion的博客 542

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

小米MiMo-V2-Flash技术解析:混合滑动窗口与MTP技术,让大模型推理如闪电般快速,附部署攻略

小米LLM团队发布的MiMo-V2-Flash模型采用MoE架构,总参数309B但激活参数仅15B。其核心技术包括混合滑动窗口注意力机制和轻量化多Token预测(MTP),实现2.7倍推理加速。模型通过三阶段预训练和MOPD多老师在线蒸馏范式进行后训练,在SWE-Bench软件工程榜单上登顶开源模型第一梯队,性能对标Kimi-K2-Thinking和DeepSeek-V3.2-Thinking,展示了高效大模型的新范式。

2401_85379281的博客 1636

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Agent学习——xiaomi MiMo V2 Flash大模型的API申请

小米xiaomi mimo大模型的API申请、使用、超参的设置等操作

6138

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

小米开源MiMo-V2-Flash:用1_2参数挑战DeepSeek-V3,代码Agent能力登顶开源榜首

小米LLM团队开源了MiMo-V2-Flash,一个仅309B总参数(15B激活)的MoE模型,在代码Agent任务上达到73.4%(SWE-Bench Verified),超越所有开源模型。更令人惊讶的是,它仅用DeepSeek-V3.2一半的参数,就实现了接近的推理和Agent能力。核心创新在于128-token极致激进的滑动窗口注意力架构,以及首创的Multi-Teacher On-Policy Distillation (MOPD)后训练范式,通过让学生模型从多个领域专家教师中在线蒸馏,完美继承各领

PAN_Andy的博客 1011

MiMo-V2-Flash: Efficient Reasoning, Coding, and Agentic Foundation Model——MiMo-V2-Flash 技术报告

MiMo-V2-Flash: Efficient Reasoning, Coding, and Agentic Foundation Model——MiMo-V2-Flash 技术报告

Together_CZ的博客 1570

【AI大模型前沿】Mistral 3:欧洲开源力量的AI力作,多模态与高性能的完美融合

Mistral 3是Mistral AI推出的新一代开源AI模型系列,包括小型的Ministral 3(3B、8B、14B参数)和大型的Mistral Large 3(675B总参数,41B激活参数)。该系列模型支持多模态(文本和图像)与多语言功能,具有高性能和高性价比,在多种硬件上可高效运行,适用于边缘计算、企业级部署等多种场景。

寻道AI,探索AI无限可能! 1730

小米开源 MiMo-V2-Flash 详解

2025 年小米开源 MiMo-V2-Flash,这是一种混合专家模型(Mixture-of-Experts,MoE),总参数规模为 309B,其中 15B 为激活参数,专为快速且强大的推理能力与智能体(agentic)能力而设计

kebijuelun的博客 1086

Ollama本地运行大模型完整教程(亲测有效)

本文详细介绍如何使用Ollama框架在本地运行开源大语言模型。内容包括下载安装Ollama、运行Microsoft的phi-2模型、自定义模型配置,以及实现流式传输、思考能力、结构化输出、视觉任务和工具调用等高级功能。通过Ollama,开发者可以在本地轻松部署LLM,并与各种编排框架集成,便于构建LLM应用。

2401_85390073的博客 993

开源密码管理与双因素认证工具离线镜像合集

本集合汇总等开源密码管理与双因素认证相关离线包。侧重密码箱与 2FA,与「安全审计/渗透扫描」合集错开。

222

百度开源文心5.5 Flash Base:280B MoE 只激活 14B,4 步部署 + 3 个坑,微调还是等指令版

百度开源文心 5.5 Flash 基座权重:280B MoE 每 token 激活 14B,1M 上下文,同尺寸开源 Base 30 项基准多数领先。4 步部署(vLLM/SGLang completions 链路)+ 3 个高频坑 + 动手前 6 点核对清单,并给出微调 Base 还是等指令版的判断线。

weixin_50937681的博客 223

GitHub 开源趋势日报 | 2026-11-08

每日精选 GitHub Trending 热门项目,聚焦 AI 与大模型、Agent 智能体领域,带你用一篇文章看懂开源风向。

weixin_45631123的博客 162

云捷EMS开源能源管理系统JAVA实战,好用的能源管理系统

云捷EMS是一款开源能源管理系统,覆盖物联网网关、数据采集、分析与可视化全链路,支持50余种工业协议,适配水、电、汽、光伏等多类能耗设备。系统基于微服务架构,采用SpringBoot+Vue3技术栈,支持MQTT、WebSocket双通道采集,具备低代码大屏配置、实时数据与预计算分析能力,助力企业实现能耗监测、节能降耗与碳管理数字化,可直接部署或二次开发,适用于工厂、园区等高耗能场景。

weixin_42648890的博客 216

【QT入门到晋级】用开源的自定义控件开发

直接点击mainwindow.ui文件是看不到quc控件的,关键步骤是右键点击mainwindow.ui,右键菜单选择【Qt Designer】,在UI设计器中才能找到“Quc Widget”。注意:以上是前端调用自定义控件的方式,需要编译动态库等操作,相对要麻烦一些。如果有自定义控件的源码.h和.cpp文件,直接加入到现有qt项目中,以后台方式直接调用即可,以下是我分享过一个手搓的自定义控件类【QT自定义2D控件】QGraphics绘制仪表盘_qt仪表盘控件-优快云博客。

ocy的博客 174
上一篇: 多场景应用支持, AgenticHub如何根据业务需求定制智能体
下一篇: CSGHub v1.14.0开源版本更新
OpenCSG
博客等级 码龄3年 1679粉丝 575原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值