云端体验 DeepSeek V3 0324/ Qwen2.5 VL 32B

Qwen 2.5-Max + Cline 组合,真的能替代 DeepSeek V3 和 R1 吗?实测见真章! 2025 年1月29日,阿里正式推出了 Qwen 2.5-Max,这款模型在各大评测基准上展现了全球领先的能力。其编程实战能力是否能匹敌 DeepSeek V3、GPT-4o 甚至 Claude 3.5 Sonnet?本文将重点探讨 Qwen 2.5-Max 在实际开发中的表现。 阅读详情

一、创建最新vLLM 实例

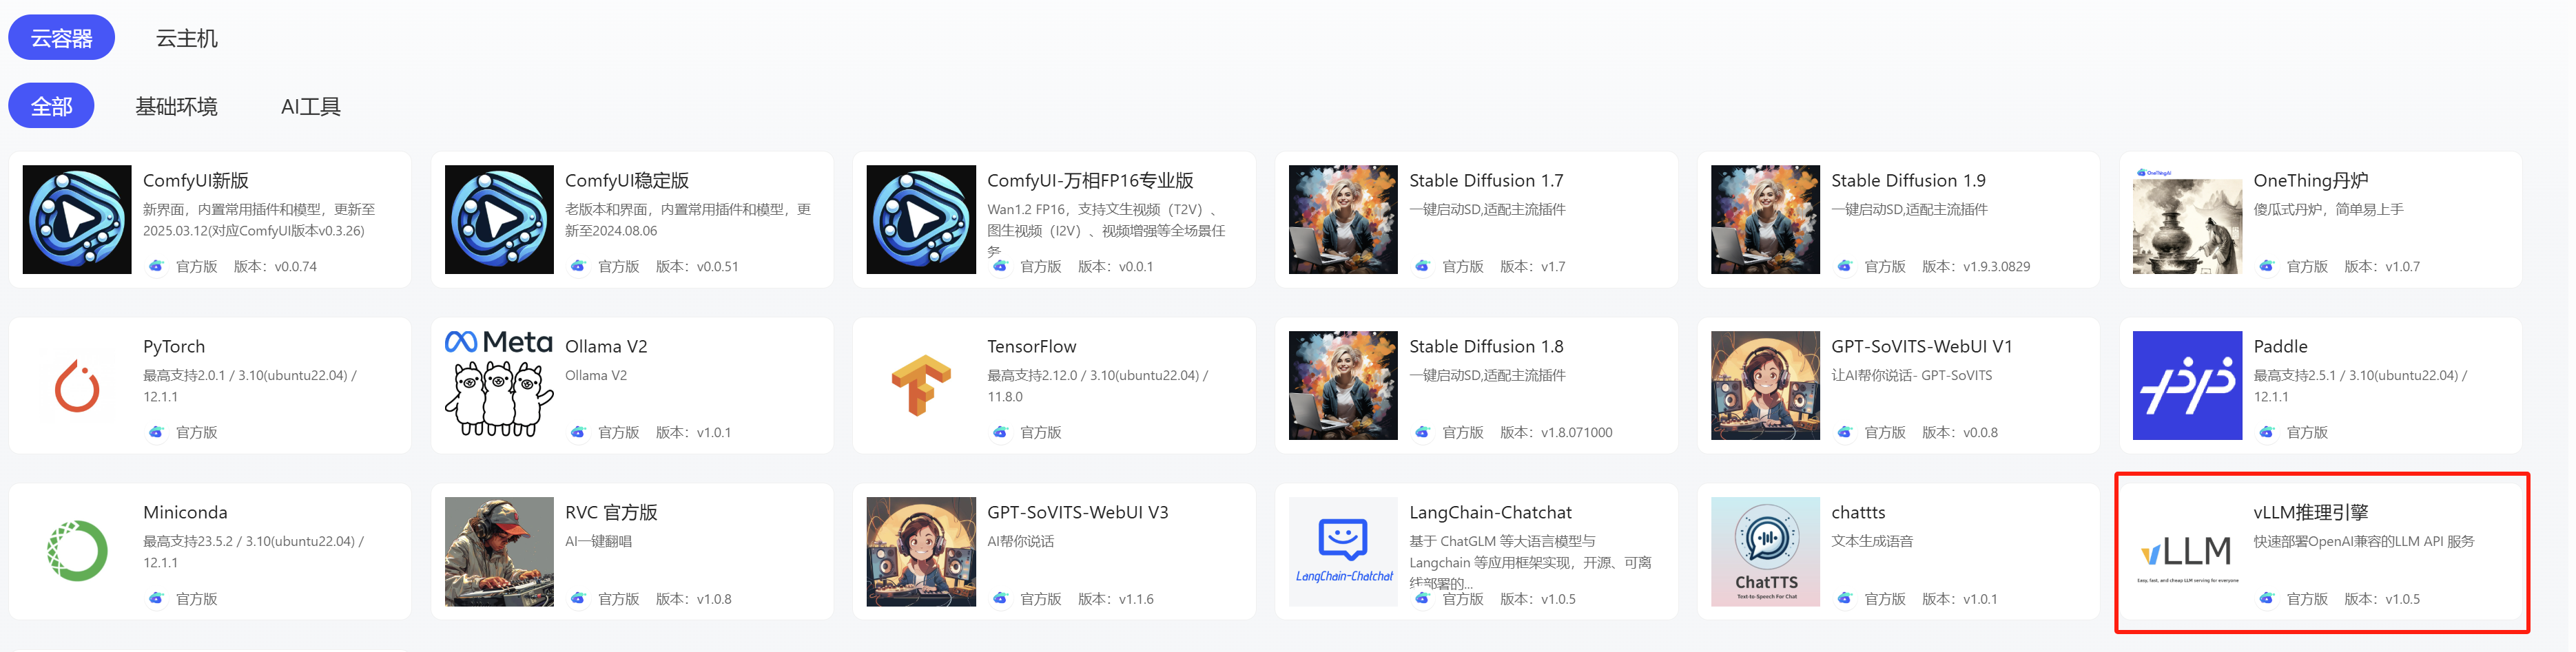
登录OneThingAI平台OneThingAI算力云 - 热门GPU算力平台,进入镜像中心,选择vLLM推理引擎,点击创建实例(8卡可跑,更好的体验需要2台H20)
通过【文件管理】查看DeepSeek 相关模型

二、补全DeepSeek V3 0324模型相关配置文件

cd /app/deepseek
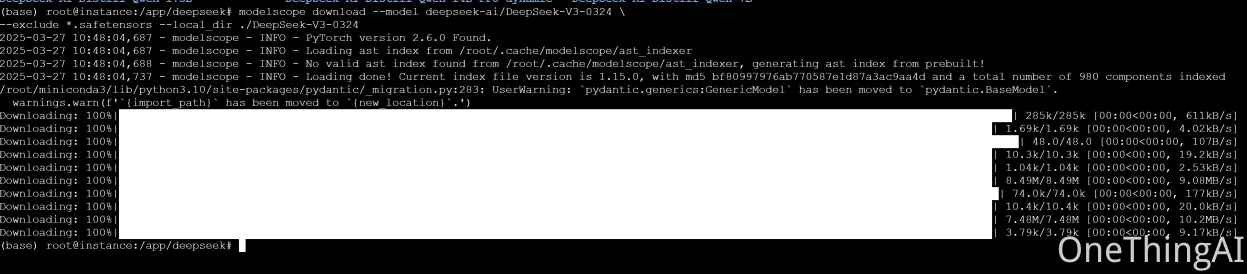
modelscope download --model deepseek-ai/DeepSeek-V3-0324 \
--exclude *.safetensors --local_dir ./DeepSeek-V3-0324

结果如图:
三、启动DeepSeek V3 0324

vllm serve /app/deepseek/DeepSeek-V3-0324 --tensor-parallel-size 8 --max-model-len 8192 \
--enable-prefix-caching --trust-remote-code --host 0.0.0.0 --port 6006 --enforce-eager \
--max_num_seqs=16   --gpu_memory_utilization 0.95

四、补全 Qwen2.5-VL-32B-Instruct

模型路径:/root/.cache/modelscope/hub/models/Qwen

cd /root/.cache/modelscope/hub/models/Qwen
modelscope download --model Qwen/Qwen2.5-VL-32B-Instruct \
--exclude *.safetensors --local_dir ./Qwen2___5-VL-32B-Instruct

五、启动Qwen2.5-VL-32B-Instruct

vllm serve /root/.cache/modelscope/hub/models/Qwen/Qwen2___5-VL-32B-Instruct --tensor-parallel-size 8\ 
--max-model-len 128000 --enable-prefix-caching --trust-remote-code --host 0.0.0.0 --port 6006 \
--enforce-eager  --gpu_memory_utilization 0.95

qwen2.5-max 和deepseek 比较 是两个不同团队开发的大语言模型,各有其技术特点和适用场景。是垂直领域模型,技术类任务更专业。建议根据具体场景测试后再做选择。是通用型多模态模型,中文生态完善; 阅读详情

相关推荐

【零基础】基于DeepSeek-R1与Qwen2.5Max的行业洞察自动化平台

被调用;DeepSeek 分析energy行业,返回结构化趋势总结;将该总结作为输入,分别用 Qwen 生成三段报告内容;最终组合成完整报告(包含三大板块);输出 JSON 结构的报告。

caoyongsheng的博客 1375

DistilQwen2.5-DS3-0324发布:知识蒸馏+快思考=更高效解决推理难题

DistilQwen2.5-DS3-0324 系列模型引入快思考策略,显著提升推理速度,使得在资源受限的设备和边缘计算场景中,模型能够高效执行复杂任务。DistilQwen2.5-DS3-0324 系列发布,助力“大模型+快思考”的新模式。

科技很有意思 1380

DeepSeek 模型本地部署指南(针对 DP32b 等参数模型)

DeepSeek 模型本地部署指南(针对 DP32b 等参数模型)

rick的博客 4618

本地玩转 DeepSeek 和 Qwen 最新开源版本(入门+进阶)

今年的春节注定不寻常,开源大模型领域的“国货之光”们接连发布新版本,多项指标对标 OpenAI 的正式版(收费服务)。1月20日,DeepSeek R1 发布,在数学、代码、自然语言推理等任务上,性能比肩 OpenAI o1 正式版。1月27日,Qwen2.5-1M:支持 100万 Token 上下文,其中 14B 的杯型在短文本任务上实现了和 GPT-4o-mini 相近的性能,同时上下文长度是...

阿里巴巴中间件 2518

如何在本地部署魔搭上千问Qwen2.5-VL-32B-Instruct-AWQ模型在显卡1上面运行推理,并开启api服务

如何在本地部署魔搭上千问Qwen2.5-VL-32B-Instruct-AWQ模型在显卡1上面运行推理,并开启api服务。13.保持后台运行,使用 systemd 制作系统服务(生产环境推荐)进入目标目录cd /mnt/program/Qwen2.5-VL。下载Qwen2.5-VL-32B-Instruct-AWQ模型。下载Miniconda(选择适合的版本)3.清除conda缓存(有问题才操作)上面安装不行就使用conda安装。8.验证CUDA可用性。安装logrotate。12.测试聊天和识图。

本博客,博文仅代表个人操作经验,不能完全解决你的问题,仅供参考,佛系回复。 3481

C++控制台实现简单的注册登录

C++控制台实现简单的注册登录 #include<iostream> #include<string> #include <vector> #include <conio.h> void Display();//调用display显示switch()界面 void Register();//注册 void Enter();//登录 using nam...

乔路非 2万+

Qwen2.5-VL模型新尺寸32B以及新版本deepseekV3来了!

不过我个人觉得还是要加大力度使用起来,claude 3.7 Sonnet写代码的感觉已经是我能感觉到目前最好的,deepseekV3新版本,最近也多用一用。链接:https://huggingface.co/deepseek-ai/DeepSeek-V3-0324。和2.5的72B来相比指标相差的也不是很多,但是32B的模型尺寸对于部署玩起来就相对友好太多了。链接:https://huggingface.co/Qwen/A。开源的不叫V4,是V3基础上的一个新的版本。卷就完了,这不又来了。

AI蜗牛车 1387

自动化学报Ctex+texstudio配置方法

自动化学报Latex的模板win10使用方法(CTEX+texstudio)

zxy15924462502的博客 7375

使用 ollama 部署本地模型,零基础入门到精通,非常详细收藏我这一篇就够了

在本地启动并运行大型语言模型。运行Llama 2,Code Llama和其他模型。自定义并创建您自己的。

m0_65555479的博客 3735

大数据课程综合实验案例:网站用户行为分析

大数据课程综合实验案例1 案例简介1.1 案例目的1.2 适用对象1.3 时间安排1.4 预备知识1.5 硬件要求1.6 软件工具1.7 数据集1.8 案例任务1.9 实验步骤2 本地数据上传到数据仓库Hive2.1 实验数据集的下载2.2 数据集的预处理(1)删除文件第一行记录,即字段名称(2)对字段进行预处理(3)导入数据库3 Hive数据分析3.1 操作Hive3.2 简单查询分析3.3 查询条数统计分析3.4 关键字条件查询分析3.4.1 以关键字的存在区间为条件的查询3.4.2 关键字赋予给定值为

weixin_44616879的博客 1万+

手把手教你用Simulink给C2000配置SCI串口发送数据(附模型与避坑点)

本文详细介绍了如何使用Simulink为C2000系列微控制器配置SCI串口发送数据,包括硬件资源分配、模型搭建、参数设置及调试技巧。通过代码生成和串口通信实践,帮助开发者高效实现嵌入式系统开发,避免常见通信问题。

weixin_30831529的博客 295

Qwen2.5-VL系列模型正式开源,千问永远不会让你失望 | 附实测结果

我想说Qwen是国内开源Top,当之无愧,期待后续Qwen3、 QwQ、QvQ的更新模型。最后,在春节串门前,大家可以先把模型下载上,晚上回来,直接开测~~

m0_63171455的博客 5416

【DICOM后处理】qt+vs 实现DICOM数据四视图显示

方法用于 设置 2D 视图的“向上”方向,即定义图像在屏幕坐标系中的朝向。该方法直接影响影像的显示方向,尤其在多平面重建(MPR)或非标准切面显示时至关重要。:方法用于 设置渲染窗口在屏幕上的显示位置(以像素为单位)。它控制的是 VTK 渲染窗口的左上角在屏幕坐标系中的坐标位置。DICOM四视图通常指同时显示医学影像的四个不同平面或视角,用于全面分析三维数据(如CT、MRI等)。:基于 标量值 设置不透明度(控制不同组织的显示),显示骨骼or显示高密度流体等。默认朝向原点 (0, 0, 0)

weixin_41804847的博客 1325

最强开源视觉大模型Qwen2.5-VL:本地部署完全免费

Qwen2.5-VL 是 Qwen 推出的全新旗舰视觉语言模型,较前身 Qwen2-VL 实现了重大飞跃。该模型不仅能够识别花、鸟、鱼、昆虫等常见物体,还能分析图像中的复杂文本、图表、图标、图形和布局,为多模态 AI 树立了新标准。Qwen2.5-VL 具备高度代理能力,支持动态推理和工具指导,适用于计算机和手机等多种设备。

Python_cocola的博客 9619

Unity的粒子系统使用shadergraph(内置管线)制作的一个顶点偏移shader,但是粒子模型移动时,顶点也会偏移?

🏆本文收录于 《全栈Bug调优(实战版)》 专栏,该专栏专注于分享我在真实项目开发中遇到的各类疑难Bug及其深层成因,并系统提供高效、可复现的解决思路和实操方案。无论你是刚入行的新手开发者,还是拥有多年项目经验的资深工程师,本专栏都将为你提供一条系统化、高质量的问题排查与优化路径,助力你加速成长,攻克技术壁垒,迈向技术价值最大化与职业发展的更高峰🚀!

**My Coding Family** 1174

零基础学习simulink-- 基于自适应模糊PID控制的直流电机速度控制系统

通过上述代码实现,您可以逐步创建和搭建一个基于自适应模糊PID控制的直流电机速度控制系统。该系统能够根据电机的状态和误差实时调整PID参数,确保电机速度稳定在设定范围内。自适应模糊PID控制具有较强的鲁棒性和适应性,能够在存在不确定性和扰动的情况下提供快速且精确的控制性能。Simulink提供了强大的建模和仿真工具,使得控制系统工程师能够快速构建复杂的控制算法,并将其应用于实际工程中。直流电机建模:建立直流电机的动态模型,包括电枢电压、电流、转速和负载扭矩。自适应模糊PID控制器设计。

amy_mhd的博客 413

Qwen 2.5 Max与DeepSeek R1测试对比,看到就是赚到!!

随着AI的飞速发展,各大领先语言模型之间的竞争愈发激烈。阿里的Qwen 2.5 Max和DeepSeek V3 (R1) 是这一领域中两款极为强大的人工智能模型。在本文中,我们将分析它们在不同领域的基准测试表现,包括推理、编码、常识以及实际任务等方面。 我们利用公开可用的基准测试数据来对这两款模型进行比较,并以易于理解的图表形式展示结果。

Android23333的博客 2723

AFSim2.9.0学习笔记 —— 2、AFSim的Wizard软件概述(ArkSIM集成开发环境 (IDE))

AFSim2.9.0学习笔记 —— 2、AFSim的Wizard软件详述(ArkSIM集成开发环境 (IDE))

920

阿里多模态大模型Qwen2.5-VL-32B ,本地部署实践

Qwen2.5-VL-32B 介绍,我就不帮忙吹嘘了,阿里没有给我广告费通过视觉理解:Qwen2.5-VL 不仅擅长识别常见的花朵、鸟类、鱼类和昆虫,而且能够高效地分析图像中的文本、图表、图标、图形和布局。具有自主性:Qwen2.5-VL 直接扮演视觉代理的角色,能够进行推理并动态指导工具使用,具备计算机使用和手机使用的能力。理解长视频并捕捉事件:Qwen2.5-VL 能够理解时长超过 1 小时的视频,并且这次它新增了捕捉事件的能力,能够定位相关的视频片段。

2201_75499313的博客 4850

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

OpenVINO™2025与QWen-VL多模态视觉模型实现零样本对象检测

QWen2.5-VL视觉多模态大模型支持通过生成边框或点来精确定位图像中的对象,并能为坐标和属性提供稳定的 JSON 输出,不仅能熟练识别花、鸟、鱼和昆虫等常见物体、还可以精准检测多种水果、交通工具、动物与人类,可以零代码实现超过300种以上的对象检测并输出它们的JSON格式坐标位置信息与标签信息。

英特尔开发人员专区 1443

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

开源模型新突破:DeepSeek-V3与Qwen2.5的颠覆性创新

在全球人工智能模型快速发展的浪潮中,DeepSeek-V3和Qwen 2.5系列的亮相为开源模型注入了新的活力。这两大模型通过技术创新和高效优化,成功将训练成本和资源消耗降至最低,同时实现了与闭源顶级模型相媲美的性能。DeepSeek-V3技术报告报告内容详见:DeepSeek-V3模型–一个100%开源的LLM,在许多基准上击败了GPT 4o和Claude 3.5 Sonnet;一个强大的混合专家(MoE)语言模型,总参数为671B,每个token激活了37B。

2401_84204413的博客 2886

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

10分钟私有部署QwQ-32B模型,像购买Ecs实例一样快捷

​ 因此,阿里云计算巢提供了基于ECS镜像与VLLM的大模型一键部署方案,通过ECS镜像打包标准环境,通过Ros模版实现云资源与大模型的一键部署,用户无需关心模型部署运行的标准环境与底层云资源编排,10分钟即可部署使用。​ 本服务通过ECS镜像打包标准环境,通过Ros模版实现云资源与大模型的一键部署,开发者无需关心模型部署运行的标准环境与底层云资源编排,仅需添加几个参数即可享受主流LLM(如Qwen、DeepSeek等)的推理体验。复制Api调用示例,在资源标签页的ECS实例中粘贴Api调用示例即可。

AliCloudROS的博客 1067

vllm推理qwen14B、qwen2.5-vl-32B

【代码】vllm推理qwen14、qwen2.5-vl-32B

asdzdh的博客 1402

qwen2.5-vl多机多卡分布式部署

记录一下工作中进行多机多卡部署qwen2.5-vl多模态大模型踩过的坑第一个天坑就是官方提供的镜像qwenllm/qwenvl:2.5-cu121有问题,在titan显卡会抛出cuda error:no kernel image is availabe for execution on the device. 这是cuda内核与GPU不兼容的问题,可是手动制作的其他cuda12镜像就能跑。

weixin_42479327的博客 5927

千万不要尝试 Qwen2.5-Max,你会因此忘掉 DeepSeek V3

在对 Qwen2.5-Max 深度评测后,我想到了一句话——有人逐日,有人摘星。DeepSeek V3 的发布和爆火,让我们看到了 MoE 模型的潜力,让世界看到中国 AI 的锋芒。探索 AGI 的路上并不孤单,DeepSeek 和 Qwen 都是中国 AI 大模型的代表力量,当然还有很多优秀国产代表。说个冷知识,DeepSeek 将 R1 蒸馏出的 6 个小尺寸模型,有 4 个用的是 Qwen 开源模型,李飞飞最新发布的 S1,也是用 Qwen2.5-32B 作为基座模型。

m0_65555479的博客 2236
上一篇: 云端H20实战:基于LlamaFactory实现LLM高效微调
下一篇: OneThingAI算力云平台的入门指南
OneThingAI
博客等级 码龄2年 135粉丝 44原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值