任务调度中心实现(二)节点竞争拉取任务的方式

【AI生成】 LoRa无中心自组网实现方案 LoRa技术是一种低功耗广域网通信技术,它采用了扩频频率调制技术,能够实现远距离的传输。LoRa在物联网中具有重要的应用价值,可以支持大规模的设备连接并且具有较低的成本。同时,LoRa具有高度的抗干扰能力和适应性,能够在复杂的环境中实现稳定的通信。通过使用无中心自组网实现方案,可以进一步提高LoRa网络的灵活性和可靠性,实现设备之间的智能互联。LoRa无中心自组网实现方案将为物联网应用提供更加便捷和高效的通信解决方案。LoRa无中心自组网实现方案一、无中心自组网概念及优势。 阅读详情

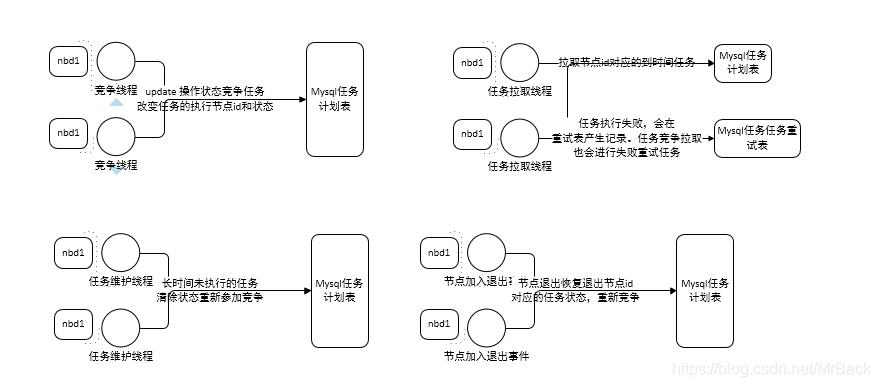
流程图:

任务调度工作流程图


1、任务详情表、任务计划表、任务计划表、任务执行记录表设计。

任务情况表 折叠原码

DROP TABLE IF EXISTS `APP_TASK_DESC`;

CREATE TABLE `APP_TASK_DESC` (

  `id` bigint(10) NOT NULL AUTO_INCREMENT COMMENT 'id',

  `schedule_type` varchar(20) NOT NULL COMMENT 'cron、simple两种模式',

  `task_name` varchar(50) NOT NULL COMMENT '应用任务名称',

  `task_type` varchar(200) NOT NULL COMMENT '任务类型,比如归档任务为DATAFILER',

  `is_deleted` TINYINT(3) NOT NULL COMMENT '删除标识,有效:0,已删除:1',

  `status`  TINYINT(3) NOT NULL COMMENT '启停标识 启动:0,停止:1',

  `param_json` VARCHAR(500) COMMENT '不同任务需要的参数json,如数据归档需要制定数据表id',

  `task_json` VARCHAR(500) COMMENT 'task_type为DAG时需要任务list的json,根据顺序依次执行',

  `modified_user_id` bigint(20) unsigned NOT NULL COMMENT '修改用户ID',

  `modified_time` datetime(6) NOT NULL COMMENT '修改时间',

  `creation_user_id` bigint(20) unsigned NOT NULL COMMENT '创建用户ID',

  `creation_time` datetime(6) NOT NULL COMMENT '创建时间',

  PRIMARY KEY (`id`)

) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

任务计划表 折叠原码

DROP TABLE IF EXISTS `TASK_PLAN`;

CREATE TABLE `TASK_PLAN` (

  `id` bigint(10) NOT NULL AUTO_INCREMENT COMMENT 'id',

  `task_id` varchar(20) NOT NULL COMMENT 'cron、simple两种模式',

  `task_name` varchar(50) NOT NULL COMMENT '应用任务名称',

  `task_type` varchar(200) NOT NULL COMMENT '任务类型,比如归档任务为DATAFILER',

  `next_time` datetime(6) NOT NULL COMMENT '下次执行时间',

  `modified_user_id` bigint(20) unsigned NOT NULL COMMENT '修改用户ID',

  `modified_time` datetime(6) NOT NULL COMMENT '修改时间',

  `creation_user_id` bigint(20) unsigned NOT NULL COMMENT '创建用户ID',

  `creation_time` datetime(6) NOT NULL COMMENT '创建时间',

  PRIMARY KEY (`id`)

) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

任务执行记录表 折叠原码

DROP TABLE IF EXISTS `TASK_LOG`;

CREATE TABLE `TASK_LOG` (

  `id` bigint(10) NOT NULL AUTO_INCREMENT COMMENT 'id',

  `task_id` bigint(10) NOT NULL COMMENT 'task id',

  `task_name` varchar(50) NOT NULL COMMENT '应用任务名称',

  `task_type` varchar(200) NOT NULL COMMENT '任务类型,比如归档任务为DATAFILER',

  `start_time` DATETIME NOT NULL COMMENT '任务开始时间',

  `end_time` DATETIME NOT NULL COMMENT '任务结束时间',

  `execute_status` INT COMMENT '执行状态:成功、异常',

  `execute_message` VARCHAR(500) COMMENT '异常信息',

  `ip` VARCHAR(20) NOT NULL COMMENT '执行任务的ip',

  `result_json` VARCHAR(20) NOT NULL COMMENT '任务执行结果的重要信息比如归档路径等',

  `modified_user_id` bigint(20) unsigned NOT NULL COMMENT '修改用户ID',

  `modified_time` datetime(6) NOT NULL COMMENT '修改时间',

  `creation_user_id` bigint(20) unsigned NOT NULL COMMENT '创建用户ID',

  `creation_time` datetime(6) NOT NULL COMMENT '创建时间',

  PRIMARY KEY (`id`)

) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

失败待重试任务表 折叠原码

DROP TABLE IF EXISTS `ERROR_TASK_DESC`;

CREATE TABLE `ERROR_TASK_DESC` (

  `id` bigint(10) NOT NULL AUTO_INCREMENT COMMENT 'id',

  `task_id` bigint(10) NOT NULL AUTO_INCREMENT COMMENT '原任务id',

  `schedule_type` varchar(20) NOT NULL COMMENT 'cron、simple两种模式',

  `task_type` varchar(200) NOT NULL COMMENT '任务类型,比如归档任务为DATAFILER',

  `error_param_json` VARCHAR(500) COMMENT '不同任务需要的参数json,如数据归档需要制定数据表id',

  `modified_user_id` bigint(20) unsigned NOT NULL COMMENT '修改用户ID',

  `modified_time` datetime(6) NOT NULL COMMENT '修改时间',

  `creation_user_id` bigint(20) unsigned NOT NULL COMMENT '创建用户ID',

  `creation_time` datetime(6) NOT NULL COMMENT '创建时间',

`next_time` datetime(6) NOT NULL COMMENT '下次执行时间',

 `repeat_count` INT NOT NULL COMMENT '重复次数',

  PRIMARY KEY (`id`)

) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;


2、参数介绍。

1)、task_type.任务类型。对于开发好的不同后端逻辑的任务。比如:任务归档的任务类型为DATAFILER.task_type要与对应job的实现对应。

TaskType示例 折叠原码

/**

 *

 * @author back

 *

 */

public enum TaskType {


    DATAFILER(DataFilerJob.class);

    Class<? extends AbstractJob> jobClass;

    int nodeUse;

    TaskType(Class<? extends AbstractJob> jobClass){

        this.jobClass = jobClass;

    }

    public Class<? extends AbstractJob> getJobClass() {

        return jobClass;

    }

}

上面的TaskType中用到了自定义Job。Job初步设计如下:

AbstractJob 折叠原码

package com.back.task;


import com.back.model.AppTask;

import com.back.model.TaskLog;


/**

 * 这里思考对于任务记录操作能否统一处理

 * 如果能够统一处理,代表也可以在这里加控制。做一个是否持久化任务痕迹的配置

 * @author Administrator

 *

 */

public abstract class AbstractJob implements Job<TaskLog> {


    private AppTask task;

    private TaskLog log;


    public AbstractJob(AppTask task){

        this.task = task;

    }

    /**

     * 对于call内部逻辑中的异常 ,自定义一个异常,单独记录一个message

     * 在这里的catch后 拿到message 后在after()逻辑中落库

     * 这里是为了完成比如归档任务中任务分为两个(或多个)阶段,message可以帮助我们记录哪些阶段成功,在哪个阶段失败。

     */

    @Override

    public TaskLog execute() {

        before();

        try{

            call();

        }catch(Exception e){


        }

        after();

        return log;

    }


    //前置逻辑

    private void before() {


    }


    public abstract void call();


    //这里完成任务记录落库逻辑

    private void after() {


    }

}


2)、schedule_type调度类型。暂时支持SIMPLE、CRON两种。SIMPLE是每隔多长时间触发一次的(可指定开始何时触发)。CRON是填写CRON表达式触发。

    3)、参数param_json。当schedule_type为SIMPLE时paramJson中存在interval(代表执行周期)和timeunit(代表时间单位:day、hour、minute、second) CRON是填写CRON表达式触发,需要参数cronExpression。

不同任务需要的差异化参数都存在这个json中。

3、集群下任务执行设计。

1)每个节点的线程通过update的原子性进行任务竞争,可通过配置修改每次竞争得到的任务数量。


任务竞争线程实现思路 折叠原码

/**

 * 利用Mysql Update来竞争改变competeStatus的状态和node_id

 * @author back

 *

 */

public class TaskCompeteHandler extends Thread{


    public static AtomicBoolean status = new AtomicBoolean(true);

    private static final long TASK_COMPETE_INTERVAL = 500;

    long startMills = System.currentTimeMillis();

    private static final String DEFAULT_THREAD_NAME = "TaskCompeteHandler";

    @Override

    public void run() {

        Thread.currentThread().setName(DEFAULT_THREAD_NAME);

        while(status.get() && !Thread.currentThread().isInterrupted()) {

            if(System.currentTimeMillis() - startMills >= TASK_COMPETE_INTERVAL){

                updateTask();

                startMills = System.currentTimeMillis();

            }  


        }

    }


    /**

     * 从mysql update 查询任务状态为开启的、当前时间大于或等于任务中下一次执行时间 的、task_type属于当前节点用途的、compete_status = 1任务 。

     * 将node_id=ignite.localNode.id和compete_status = 0 写入

     * 这里后面考虑update时每次udpate固定条数 where id in (select ..... order by next_time desc limit 10)

     */

    private void updateTask(){


        Date current = new Date();

        String currentId = ConfigUtils.ignite.cluster().localNode().id().toString();

        /**

         * update application_task set compete_status = 0 , node_id = currentId where

         * is_deleted = 0 and status = 0 and compete_status = 1 and next_time <= current

         *

         */

    }

}

2)任务拉取线程。

任务拉取线程实现思路 折叠原码

public class ExecuteTaskHandler extends Thread{


    public static AtomicBoolean status = new AtomicBoolean(true);

    private static final long PULL_TASK_INTERVAL = 500;

    long startMills = System.currentTimeMillis();

    private static final String DEFAULT_THREAD_NAME = "PullTaskHandler";

    IgniteComputeManager manager;

    public ExecuteTaskHandler(){

        manager = CommonUtils.getInstance(IgniteComputeManager.class);

    }

    @Override

    public void run() {

        Thread.currentThread().setName(DEFAULT_THREAD_NAME);

        while(status.get() && !Thread.currentThread().isInterrupted()) {

            if(System.currentTimeMillis() - startMills >= PULL_TASK_INTERVAL){

                sendTask();

                startMills = System.currentTimeMillis();

            }  


        }

    }

    private void sendTask() {

        Date currentDate = new Date();

        String currentId = ConfigUtils.ignite.cluster().localNode().id().toString();

        /**

         * select * from application_task where is_deleted = 0 and status = 0 and

         * next_time <= currentDate and node_id = currentId

         */


        List<AppTask>  tasks = null;

        for (AppTask task : tasks) {

            //1、sendTask 至本地线程池


            //2、下次执行时间

            task.setNextTime(TaskDateUtils.getNextDate(task, task.getNextTime()));

            //恢复竞争标识

            task.setCompeteStatus(1);

            //这个操作可以不做,因为通过竞争标识已经可以控制

            task.setNodeId(null);

        }

        //batchUpdate

    }

}


3)节点退出集群时,将退出节点id对应的任务(竞争状态为可执行的任务)恢复竞争状态

4)存在任务维护线程。定期检查是否存在到达执行时间但是长时间未执行任务,恢复竞争状态,从新竞争执行任务。


4、增删改查、启停任务。

1)

 任务新增:在Mysql中新增一条app_task_desc记录,前段有可能指定时间,则next_time为指定时间,若没有指定时间当前时间写入next_time。同时任务计划表新增竞争转状态为待竞争的任务。

  任务修改:mysql修改对应属性即可,其中next_time改为当前时间写入库中。

 任务的启停在任务表中修改状态即可。

2)项目启动。在master节点调度未删除且状态为有效的任务

5、对于脚本任务等部分节点才能生效的任务。

1)配置文件中配置节点用途。schedule.node.use = “DATAFILER,.....”  。既可以得到在这个节点不能执行的taskType 拉取任务时放入查询条件中。


6、应用任务的基础功能

1)在web提供手动触发任务。请求被分到哪个节点就在哪个节点上执行即可。

2)开发一个新类型任务的步骤。

1、继承AbstractJob ,实现自己的逻辑。

2、TaskType新增枚举,并建立与自定义Job的联系

如何实现一个任务调度系统,看这篇文章就够了 2015年其实是非常有趣的一年。ElasticJob 和 XXL-JOB 这两种不同流派的任务调度项目都开源了。在 XXL-JOB 源码里,至今还保留着许雪里老师在开源中国的一条动态截图:刚写的任务调度框架 ,Web动态管理任务,实时生效,热乎的。没有意外的话,明天中午推送到git.osc上去。哈哈,下楼炒个面加个荷包蛋庆祝下。看到这个截图,内心深处竟然会有一种共情,嘴角不自禁的上扬。我又想起:2016年,ElasticJob的作者张亮老师开源了sharding-jdbc。... 阅读详情

相关推荐

节点中心度MATLAB实现

节点度是指和该节点相关联的边的条数,又称关联度。 特别地,对于有向图, 节点的入度 是指进入该节点的边的条数; 节点的出度是指从该节点出发的边的条数。

网络中心节点的选举算法

在多节点自组织网络中,有中心节点或簇头节点的选举问题。在实际的网络仿真中经常会碰到类似的问题,设网络中有两种类型的节点,即服务节点和客户节点,服务节点为连接到本节点的用户节点提供服务,管理客户节点。客户节点受服务节点控制,在服务节点管理下正常运行。网络中节点与节点之间存在着物理连

Wisheat的轨迹 2193

统一监管报送平台系统功能介绍

1、统一监管报送平台功能介绍 1.1 背景分析 随着中国经济的飞速发展,近年来中国的金融行业也处在飞速的发展阶段, 银行的改制、分支机构的扩张、异地分行的开设、村镇银行的兴起、财务公司的 成立等,均可以看出中国的金融行业的发展已经进入到了前所未有的阶段。然而 随着金融行业的飞速发展,中国的监管当局也不断加大对各金融机构的监管力度, 中国的三大监管机构银监会、人民银行和外管局也都需要金融机构按照不同的要 求、方式等报送报表或数据,通过这些报表和数据的进一步分析结果来对金融机 构制定不同的监管策略。 从目前情形来看,各金融机构,尤其是商业银行,为应对三大监管机构的监 管要求所需要报送的内容给商业银行的业务人员带来了繁重的工作压力。在这种 情况下,就需要有一套统一的监管报送平台来完成这些报表、数据的自动化生成 工作,使用这种自动化的方式代替传统的手工填报的方式。这样既减轻了业务人 员的工作压力,也保证了所报送的报表、数据的准确性。因此,对金融机构来说, 建立一套统一的监管报送平台是非常必要的。 在本方案中主要包括以下两个主要的报送模块:银监会 1104 报送、人民银 行大集中报送。中软融鑫公司利用公司自有的产品“统一监管报送平台”来实现

【AI绘画】轻松秒出质感“大片”,Flux生成卡通角色、场景的提示词分享。

这次分享8组生成卡通角色和场景的提示词,这些提示词包含了正向提示词和采样器、种子等图片信息。 用法也很简单,你只要把图片信息复制粘贴到正向提示词框里,再点击 “ ↙ ” 图标就可以了。

m0_59162559的博客 1251

【SIP基础】SIP协议基本呼叫流程

SIP呼叫流程下图显示了一个SIP会话的基本呼叫流程。 下面是上述呼叫流程的详细解释: Alice发送INVITE请求到代理服务器,INVITE请求负责发起会话。 代理服务器立即发送Trying 100给请求者(Alice),表示试图响应INVITE请求,以防止重传该INVITE请求。 代理服务器搜索Bob所在位置服务器的地址,得到的地址后,将转发INVITE请求到Bob。 此后,Bob回应180

VVSIP官网博客 1万+

Solidworks曲面建模学习(三)——样条曲线

本文主要演示平面的空间样条曲线的一些绘制。

东东不熬夜的博客 6504

k-中心点算法(k-medoids)及Matlab代码实现

k-中心点算法(k-medoids)及Matlab代码 1. 提出: 上篇文章给出了 k-means算法的具体思想和代码实现:https://blog.youkuaiyun.com/qiu1440528444/article/details/80611942 k-means算法是每次选择簇的均值作为新的中心点,迭代直到簇中心不再变化(趋于稳定)。其缺点是对离群点特别敏感,因为一个很大的极端值对象...

万勇's Blog 2万+

小红书图文AI创作:输入主题,一键生成图文(coze工作流教程+获取)

输入主题,工作流一键生成小红书风格图文,30s一条,可批量生成

2301_79384090的博客 2800

LTS任务调度算法解析:负载均衡与任务分配的核心原理

Light Task Scheduler (LTS) 作为一款分布式任务调度框架,其核心竞争力在于高效的负载均衡与任务分配机制。本文将深入解析LTS内置的四种调度算法原理,帮助开发者理解框架如何智能分配任务,确保集群资源的最优利用。 ## 一、LTS负载均衡架构概览 LTS采用分层架构设计,通过负载均衡模块实现任务在多节点间的智能分配。核心架构如图所示: [![LTS架构图](https:/

gitblog_01164的博客 652

Camera(5)metadata

Metadata 是整个 Android camera 中类似于高楼大厦中的管道系统一样,贯穿了整个 Camera 的 Framework 和 vendor HAL。Metadata 里面包含了所有的控制、参数、返回值等等。Metadata分为Android原生的Metadata和芯片商或者用户自定义的Metadata,即Android Tag和Vendor Tag。Vendor Tag在Hal中定义,并在camx和chi目录中使用。

qq_55893245的博客 3053

LAMMPS实战:如何用ReaxFF力场模拟碳氢化合物热解(附完整脚本)

本文提供了一份使用LAMMPS软件中ReaxFF反应力场模拟碳氢化合物热解过程的完整实战指南。内容涵盖从环境准备、力场参数选择、能量最小化,到升温恒温动力学模拟的完整脚本编写,并介绍了基于轨迹文件的产物分析方法,帮助计算化学与材料科学研究者快速上手这一关键的分子动力学仿真技术。

soda5的博客 1100

XXL-JOB分布式任务调度中心:从核心原理到生产实践

在微服务架构中,定时任务和延时任务的可靠执行是常见的业务需求。其核心原理在于将任务触发与业务执行解耦,通过中心化的调度器统一管理任务生命周期,实现分布式环境下的任务协调与容错。这一技术价值在于提供了统一的任务管理、监控和运维能力,有效解决了任务分散、重复执行和故障排查困难等问题。典型的应用场景包括数据统计报表生成、延时业务处理(如订单超时关单)以及大数据量的并行处理。本文以流行的开源框架XXL-JOB为例,深入剖析其调度中心与执行器分离的架构设计,并结合分片广播、故障转移等高级特性,展示如何应对海量数据处理

weixin_34294649的博客 332

部署资源管理系统chemx

资源管理系统的部署教程

weixin_40784215的博客 822

Spring Boot集成XXL-JOB:构建高可用分布式任务调度中心实战指南

在微服务架构和分布式系统中,定时任务调度是支撑业务连续性的核心技术组件。其核心原理在于将任务的触发与执行解耦,通过中心化的调度器统一管理任务生命周期,实现任务的可视化编排、精准触发与状态监控。这一技术价值在于显著提升系统的可观测性和运维效率,解决了传统@Scheduled注解方式下任务分散、难以统一管理和监控的痛点。在实际应用场景中,它广泛应用于数据报表生成、订单状态同步、缓存刷新等需要周期性执行的业务逻辑。本文聚焦于如何将Spring Boot应用与XXL-JOB这一主流分布式任务调度框架进行深度集成,详

weixin_30629653的博客 375

Qt | 开发过程中总结的经验

关于如何判断自己的Qt库是多少位,有个误区就是很多人要么看成了QtCreator的关于信息中列出的位数,要么以为自己是64位的系统就认为是64位的Qt,最终要在Qt构建套件中查看具体位数,大概从Qt5.14开始基本上很少提供32位的库,尤其是Qt6.0以后基本上默认就是只有64位的库了,这也是顺应时代潮流,毕竟不久的将来(个人预计2030年以前)基本上32位的系统占比不超过1%,放心大胆的用64位的库吧,抛弃烦人的32位以及XP系统。Qt常用类的头文件的函数看完学完使用一遍并加以融会贯通,月薪30K起步。

Qt历险记,专注Qt技术,三年医疗设备研发经验,1年机器视觉研发经验,半年柔性传感研发经验。 491

【Burp入门第三十一篇】Burp+SwitchyOmega实现本地localhost代理

在部分情况下(如本地靶场),当我们需要在Burp中查看、修改本地流量包的时候,按以下三个配置是不能得到本地流量包的。

等风来 3214

什么是xxl-job?

xxl-job是一款开源的分布式任务调度框架,主要用于解决大规模分布式任务的调度和执行问题。它提供了任务调度中心、执行器和任务日志等组件,可以实现任务的定时调度、动态添加和删除任务、任务执行情况的监控和日志记录等功能。4. 任务执行监控:xxl-job提供了任务执行日志和状态监控功能,可以实时查看任务的执行情况、成功率、耗时等指标,方便进行任务调优和故障排查。3. 动态任务管理:xxl-job支持动态添加、删除和修改任务,可以根据业务需求灵活调整任务的执行计划和参数配置,无需重启应用即可生效。

qq_45088552的博客 2260

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

StarRocks K8s 部署排障:FE Proxy DNS 解析 3 个根因 + 1 张决策表

凌晨两点告警:StarRocks 新扩的 FE Follower 一直加不进集群,日志刷着连接超时,把域名换成 IP 直连却秒通。 先别急着改 Service 配置。FE 侧的 DNS 链路比你想的长:JVM 自带一层缓存,CoreDNS 依赖 Endpoints 表,任何一环断掉,症状都是同一句"超时"。下面按"定位 → 止血 → 根治"的顺序走一遍。 ## 30 秒看懂:FE 靠 DNS

gitblog_00423的博客 644

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

分布式任务调度平台:从Cron到企业级Bezicron架构演进

定时任务调度是软件工程中实现自动化执行的核心技术,其原理基于时间触发器与作业执行器的解耦设计。通过调度中心与执行器分离的架构模式,系统能够实现高可用、弹性扩展与精确调度,为分布式环境下的任务管理提供了可靠基础。这一技术价值在于将分散的Crontab脚本、Spring Scheduler等方案统一纳管,显著提升运维效率与系统可观测性。在实际应用场景中,它广泛支撑着数据同步、报表生成、业务状态检查等关键流程。本文以Bezicron为代表,深入探讨了分布式任务调度平台如何通过**高可用架构**与**任务分片**等

weixin_28481133的博客 225

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Agent系统设计:面试题解析与实战优化指南

分布式系统中的Agent架构是现代计算中实现异步任务处理的核心技术,其设计原理基于任务调度、工作节点管理和状态持久化的解耦。通过消息队列和最终一致性保证,这类系统能够实现水平扩展和高可用性。在工程实践中,任务去重、指数退避重试和资源隔离等机制对系统稳定性至关重要。典型的应用场景包括批量作业处理、实时数据处理等需要高吞吐量的领域。本文深入解析了优先级调度算法和容错处理方案,其中任务批处理优化可提升320%的QPS,而合理的内存管理能有效预防泄漏问题。这些技术要点也是评估系统设计能力的重要指标。

weixin_33268861的博客 294

【调度器任务窃取策略深度解析】:揭秘高性能并发系统的幕后核心机制

深入解析调度器的任务窃取策略,提升并发系统性能。适用于多线程任务调度场景,通过工作线程间动态负载均衡实现高效资源利用。揭示核心机制与关键优势,优化程序响应速度与吞吐量,值得收藏。

VarIsle的博客 582

PyRunner:轻量级Python脚本调度与可视化批量任务管理工具

任务调度是自动化运维和数据处理中的核心概念,它通过预设规则自动触发和执行特定任务,其原理通常基于时间触发器或事件驱动。在Python生态中,这一技术能显著提升脚本管理的效率和可靠性,尤其适用于数据分析、爬虫和自动化测试等场景。PyRunner作为一款轻量级解决方案,集成了脚本调度、批量任务管理和环境可视化监控等核心功能,有效解决了手动管理脚本繁琐易错的问题。通过其Web界面,用户可以轻松实现任务的定时触发、批量启停和状态监控,而无需部署复杂的重型调度系统。对于需要运行大量独立脚本的场景,PyRunner提供

weixin_32487557的博客 331

XXL-JOB分布式任务调度平台:从核心原理到生产环境部署实战

在分布式系统架构中,任务调度是确保后台作业按时、可靠执行的关键组件。其核心原理在于将调度逻辑与业务执行解耦,通过中心化的调度器管理任务的生命周期、触发时机与执行路由。这一设计带来了显著的技术价值:它实现了任务的可视化管理、高可用保障、负载均衡以及失败重试机制,从而大幅提升了系统的可观测性与运维效率。典型的应用场景包括数据统计报表生成、定时数据同步、日志清理以及需要跨多个服务节点协调的批处理作业。本文以热门的开源解决方案XXL-JOB为例,深入剖析其“调度中心”与“执行器”分离的架构设计,并详细演示如何从零开

weixin_33690963的博客 451

如何构建高可用分布式代理池:haipproxy完整架构与实现指南

haipproxy是一个基于Scrapy和Redis构建的高可用分布式IP代理池,能够自动抓取、验证和管理代理IP资源,为爬虫开发提供稳定可靠的代理服务。本文将深入解析其架构设计与实现原理,帮助开发者快速掌握分布式代理池的核心技术。 ## 一、核心架构概览:分布式系统设计 haipproxy采用微服务架构设计,主要由三大核心模块组成:分布式爬虫系统、任务调度中心和代理验证机制。这种架构确保了系

gitblog_00955的博客 397

分布式爬虫集群管理:构建搜索引擎级数据采集系统

在当今大数据时代,高效的数据采集系统已成为企业获取竞争优势的关键基础设施。本文旨在提供一个全面的技术指南,介绍如何构建一个类似Google、百度等搜索引擎级别的分布式爬虫集群管理系统。分布式爬虫架构设计任务调度与负载均衡分布式去重策略反爬机制应对方案监控与管理体系容错与恢复机制首先介绍基础概念和架构设计然后深入核心算法和实现细节接着通过实际案例展示完整实现最后探讨高级主题和未来发展方向分布式爬虫:由多个爬虫节点组成的系统,协同工作完成大规模网页抓取任务集群管理。

专注搜索引擎技术 2907

AI大模型测试效率提升实战:从自动化到智能化的演进

基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)技能提升:学会申请、配置与调用火山引擎AI服务定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”从0到1构建生产级别应用,脱离Demo,点击打开。

2600_94959968的博客 674
上一篇: 任务调度中心实现方式(三) 事件驱动异步任务分发
下一篇: 任务调度中心实现(一) Quartz集群方式
MrBack
博客等级 码龄9年 27粉丝 99原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

