MatrixOne Git4Data 技术详解(六)·数据运维实践篇:数据协作开发——像合并代码一样合并数据

视觉辅助RIS波束追踪:用摄像头“看见”用户,实现毫秒级波束对准 在无线通信领域,波束成形技术是提升高频段信号覆盖与质量的核心手段,其原理是通过调整天线阵列的相位,使信号能量在特定方向相干叠加,形成高增益定向波束。这项技术的价值在于能有效克服高频信号路径损耗大、穿透性差的瓶颈,广泛应用于5G/6G、毫米波通信及室内定位等场景。然而,传统波束追踪依赖信道估计或波束扫描,存在训练开销大、实时性差的问题。本文聚焦于一种创新解决方案:将计算机视觉与可重构智能表面(RIS)相结合。通过摄像头直接感知用户位置,并利用RIS快速重构反射波束方向,实现了近乎零开销、毫秒级延迟的波束追踪, 阅读详情

上一篇讲的是一个人出了事故怎么救。这一篇讲一件更日常、也更容易被低估的事:一个团队,同时改同一份数据。

但"数据协作"具体会发生在什么场景?这一篇先把它常出现的地方讲清楚,再用一个最贴合的场景把动作完整走一遍。SQL 全部在 MatrixOne 4.0.0-rc3 上实测过。

📦 本文 SQL 整体可跑:matrixorigin/git4data-tutorial 的 06-collaborative-dev/。环境:docker run -d -p 6001:6001 --name matrixone matrixorigin/matrixone:4.0.0-rc3。


数据协作开发,会发生在哪些场景?

它其实比你想的更常见——只要一个团队直接拥有、并且频繁手改同一份数据,数据协作就已经在发生了,区别只在于你是用 Git 那套方法做,还是用"拷一堆副本 + 群里喊话"那套老办法。比如:

  • 小的机器学习 / 数据团队,合着养一张特征表 / 训练集:多人同时加特征、补标注、灌新数据;
  • 零售 / 电商团队集中改价、上活动:运营、定价、类目几拨人,deadline 前要在同一张商品表上同时改;
  • 分析团队共同维护一张口径表 / 指标表:各改各的口径,发布前要统一对齐;
  • 多人协作清洗、标注一批数据:分头清不同部分,最后并到一起。

这些场景的共同点是同一句话:多拨人、多条改动要同时往前推,最后还得安全地并到一起。 "谁的改动算数"于是成了天天要面对的问题——团队越小、改得越勤、越是直接拿 SQL 和 notebook 上手,这个问题越突出。

下面我们选其中最典型的一种——一个三人机器学习小队,一起迭代一张特征表——把这套动作完整走一遍。其余场景用的其实是同一套:分支、自查、合并、裁决冲突。


起点:一张共享的特征表,每人一条分支

先交代点背景,方便不熟悉机器学习的读者跟上。训练一个模型,第一步往往不是写算法,而是准备数据:把原始的日志、交易、行为记录,加工成一张特征表(feature table)——一个样本(这里是一个用户)一行,每一列是一个"特征"(模型用来做判断的信号,比如最近活跃天数 recency、消费金额 monetary),再加一个 label(要预测的答案,比如这个用户会不会流失)。这张表就是直接喂给模型训练的输入,模型效果好不好,很大程度上取决于它。

而特征表很少是一个人、一锤子做完的。它的典型流程是反复迭代的:清洗数据 → 造特征 → 训练、看效果 → 回头改特征 / 补数据 → 再训练。一个团队里,常常几个人同时在动这张表:有人调特征、有人清洗补缺、有人灌新标注的数据。这就又回到了上一节那个核心问题——多人同时改一张表,谁的改动算数?

具体到我们的例子:三个人在做一个用户流失预测模型,共用一张特征表 ml_features(一个用户一行:recency / frequency / monetary 等几个特征列 + 一个 label,十万行量级)。这两周,三个人要同时改它:

  • Alice 做特征工程:重算、校准某个特征(比如把 monetary 重新标定);
  • Bob 做数据清洗:补缺失值、修离群、给漏标的样本补 label;
  • Carol 灌新数据:接一批新来源的、已标注好的用户进来。

没有版本控制时,这种局面只有两条难走的路:要么排期串行(你改完我再改,根本来不及),要么各自 ml_features_alice副本 这样拷一份、最后人肉对账合并(极易把彼此的成果覆盖掉)。

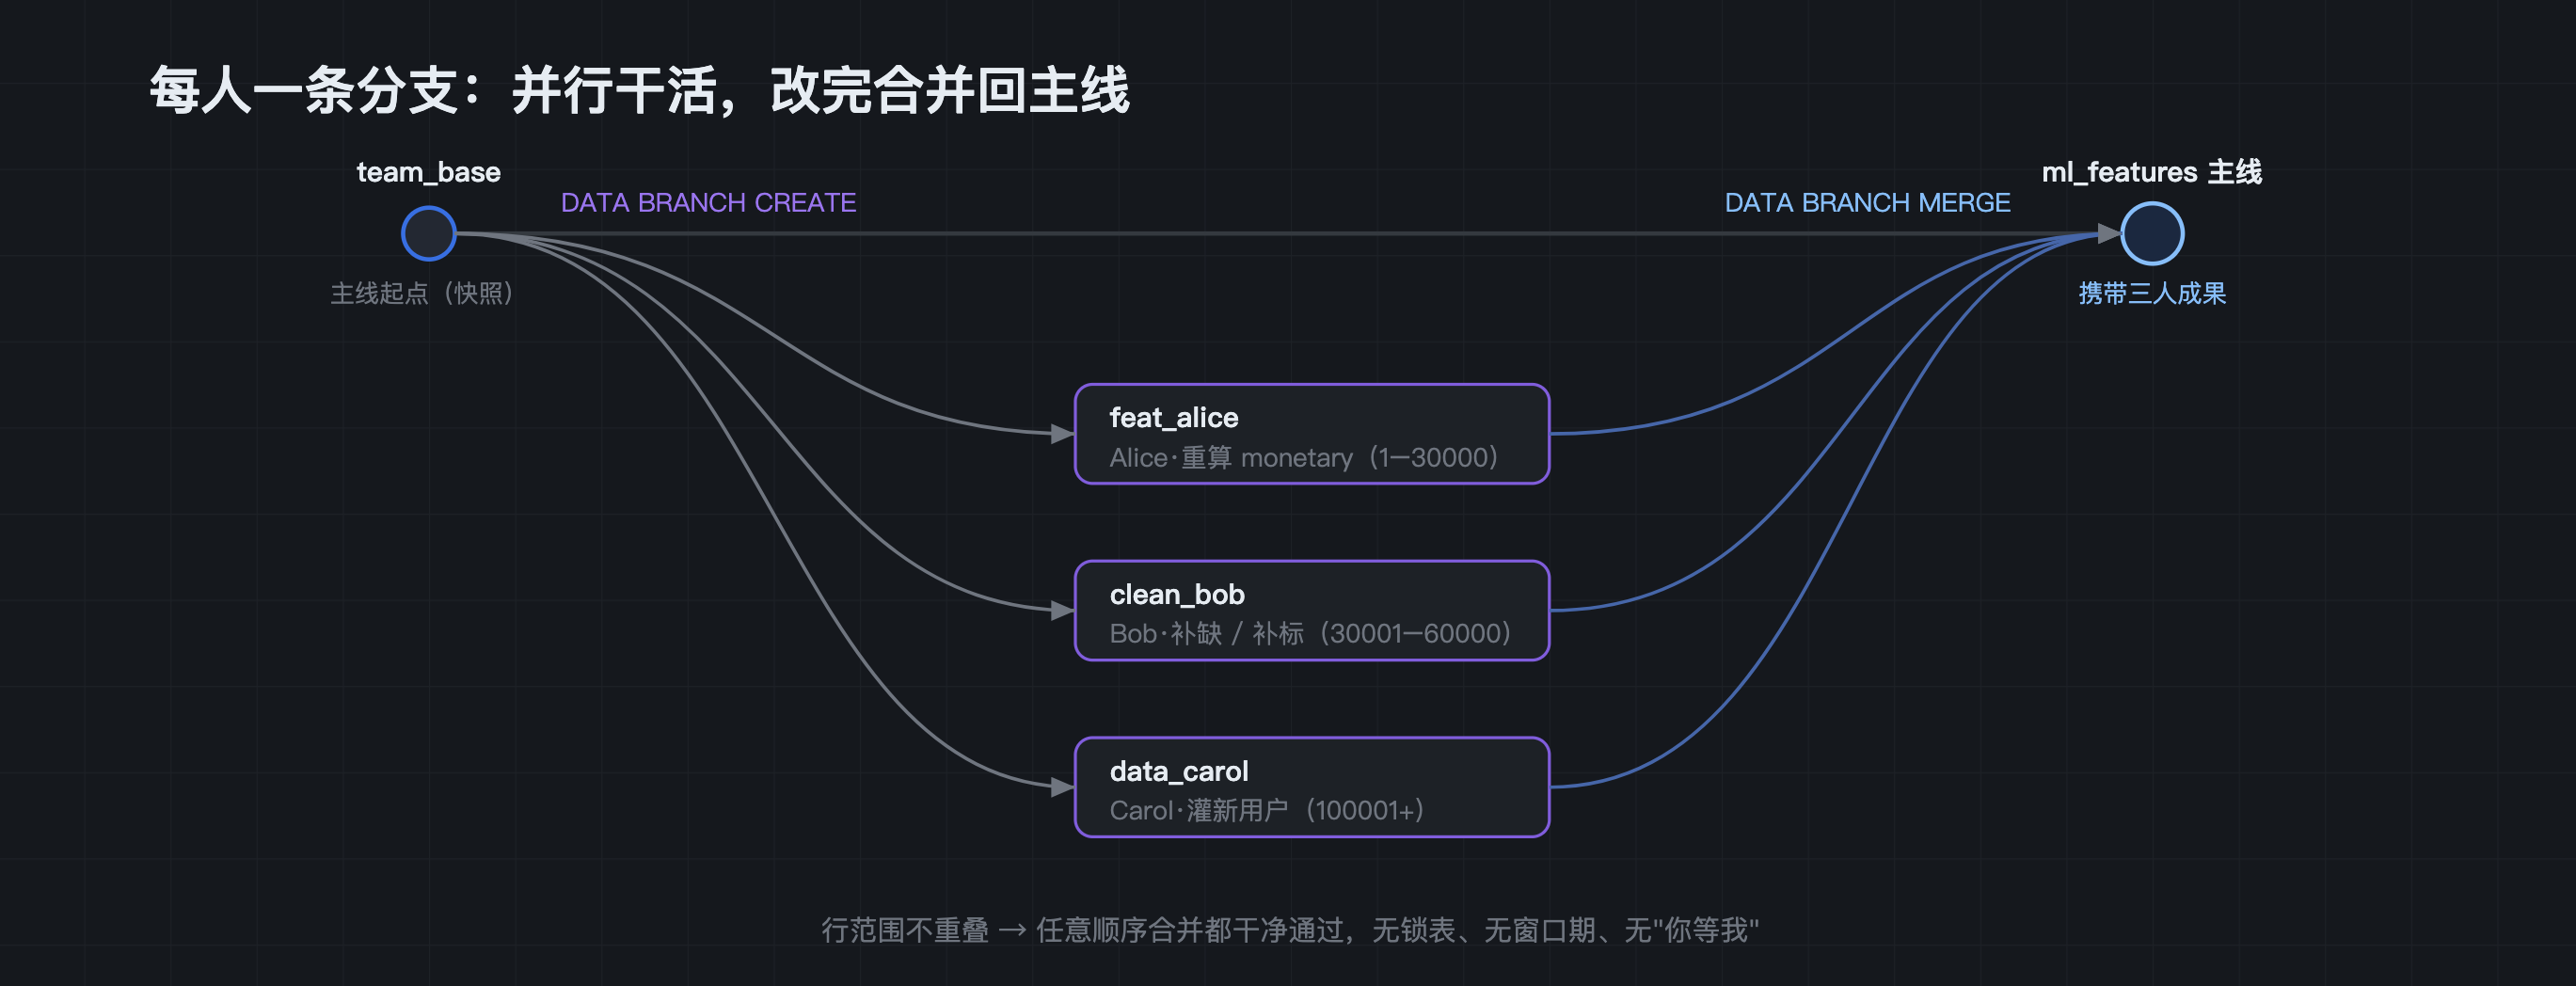
git4data 的做法:固定一个全队共同的起点,三个人各 fork 一条分支,互相完全不可见、互相完全不影响地并行干。

CREATE SNAPSHOT team_base FOR TABLE collab_demo ml_features;   -- 全队的共同起点

DATA BRANCH CREATE TABLE feat_alice FROM ml_features;   -- Alice·特征工程
DATA BRANCH CREATE TABLE clean_bob  FROM ml_features;   -- Bob·数据清洗
DATA BRANCH CREATE TABLE data_carol FROM ml_features;   -- Carol·新数据

三条分支瞬间就位(第三篇讲过:分支只复制对象引用、不搬数据,毫秒级,十万行和六亿行一样快)。从这一刻起,谁也不用问"这张表现在谁占着"。
请添加图片描述


三个人并行改:各管一段,改完自查再合

-- Alice·特征工程(负责 1~30000 号用户):重算 / 校准 monetary 特征
UPDATE feat_alice SET monetary = round(monetary * 1.10, 2)
WHERE user_id <= 30000 AND monetary IS NOT NULL;

-- Bob·数据清洗(负责 30001~60000):补缺失 monetary、给漏标的补 label
UPDATE clean_bob SET monetary = 0 WHERE monetary IS NULL AND user_id BETWEEN 30001 AND 60000;
UPDATE clean_bob SET label    = 0 WHERE label    IS NULL AND user_id BETWEEN 30001 AND 60000;

-- Carol·新数据(负责 100001 号以上):灌一批新来源的已标注用户
INSERT INTO data_carol
SELECT result + 100000, result % 90, result % 50, round(rand()*500, 2), result % 365, result % 2
FROM generate_series(1, 2000) g;

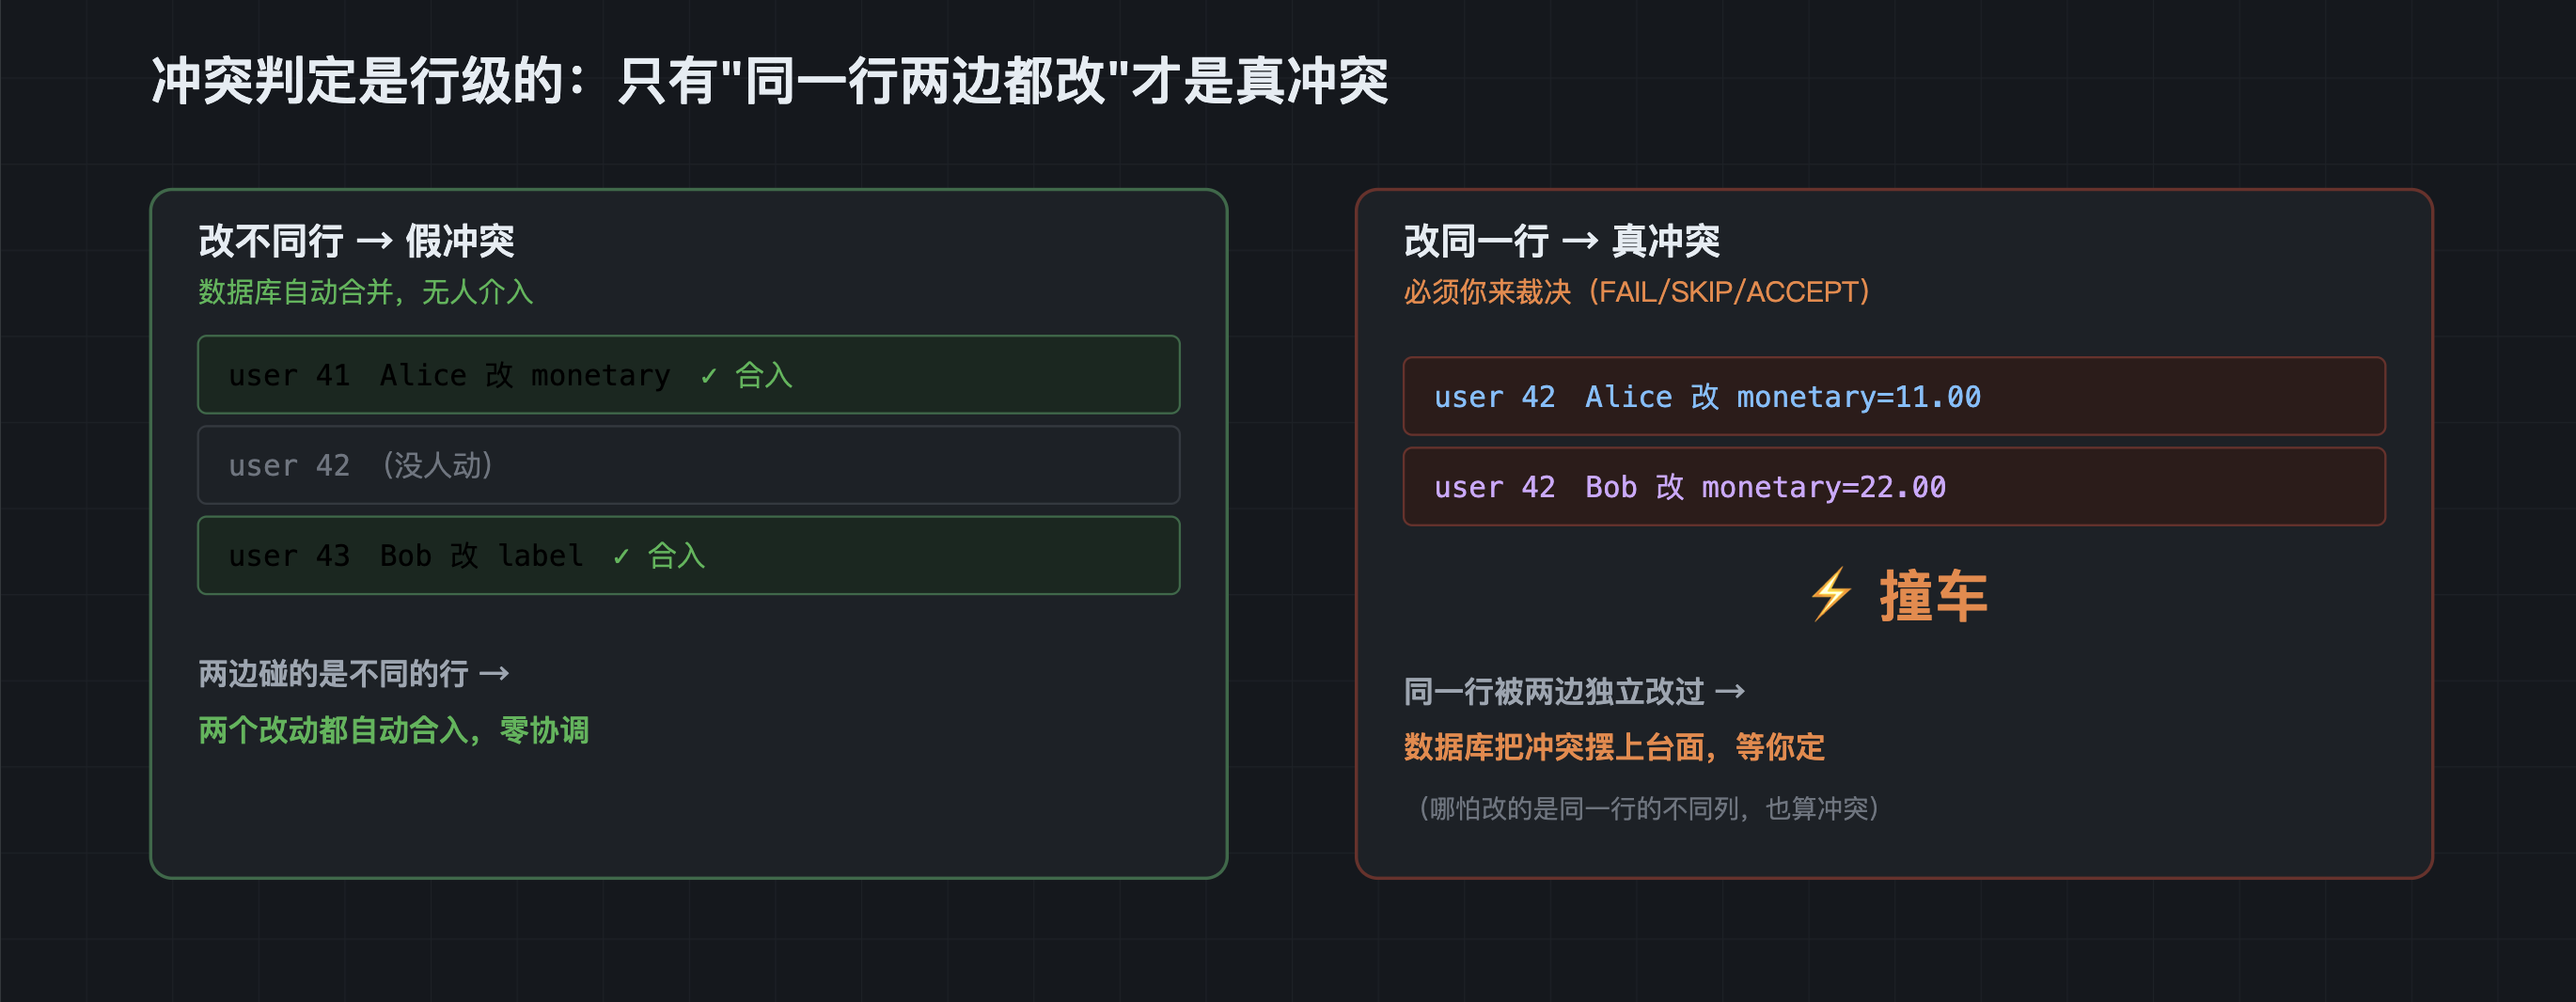
⚠ 一个实操要点:分工按「行」切,不要按「列」切。 git4data 的冲突判定是行级的——哪怕 Alice 改的是某用户的 monetary、Bob 改的是同一用户的 label,碰的是不同列,合并时也会算作冲突(我们写这篇时真踩到过这个坑)。所以让每个人负责不重叠的 user_id 号段,就天然无冲突。

合并前,每人用 DIFF 给自己的改动做一次行级 self-review——相当于提 PR 前先看一眼自己的 diff:

DATA BRANCH DIFF feat_alice AGAINST ml_features OUTPUT SUMMARY;   -- UPDATED 27000:我重算了多少行?范围对不对?
DATA BRANCH DIFF clean_bob  AGAINST ml_features OUTPUT SUMMARY;   -- UPDATED  6857:补了多少缺失 / 漏标?
DATA BRANCH DIFF data_carol AGAINST ml_features OUTPUT SUMMARY;   -- INSERTED 2000:灌进来多少新用户?

注意 Carol 那条是 INSERTED 2000——DIFF 不只看"改了哪些行",新增、删除一样分得清。确认无误,依次合并。因为号段不重叠,三条分支以任意顺序合并都干净通过,不需要任何协调:

DATA BRANCH MERGE feat_alice INTO ml_features;
DATA BRANCH MERGE clean_bob  INTO ml_features;
DATA BRANCH MERGE data_carol INTO ml_features;
-- 实测:合并后主线 102000 行(Carol 的 2000 个新用户进来了),Bob 负责段的缺失值也补齐了(还剩 0 个)。

整个过程:没有锁表、没有窗口期、没有"你等我先合"。 三个人真正并行往前推。

🎯 对机器学习团队还有一个额外的好处:每条分支就是一个完整、可复现的数据集版本。Alice 可以直接拿 feat_alice 跑一版模型,看自己重算的特征到底有没有带来提升,确认有用再合回主线——而不是改完直接覆盖、出了问题谁也说不清是哪一步。分支让"改特征"这件事,从"赌一把"变成"先验证、再合入"。


一次大改:整表重算一个特征,当前训练集照常用

团队决定把某个特征整体重算一遍——比如把 recency 按 30 天分桶。这不是一两行 SQL,而是要试好几版、还要看对模型的影响,前后好几天。难点在于:这期间当前这版训练集还得能用(线上模型在用、别人也在拿它做实验)。

git4data 的做法和上一篇的迁移如出一辙:开一条分支,在分支上慢慢试,主线零感知、照常被使用:

DATA BRANCH CREATE TABLE feat_recompute FROM ml_features;

-- 在分支上反复迭代重算逻辑(几小时 / 几天都行),主线 ml_features 完全不受影响
UPDATE feat_recompute SET recency = (recency DIV 30) * 30;   -- 把 recency 分到 0 / 30 / 60 桶

-- 验收:切换前先 DIFF 确认改动范围正是预期
DATA BRANCH DIFF feat_recompute AGAINST ml_features OUTPUT SUMMARY;   -- UPDATED 102000(全表)

-- 一切无误,一次性原子切换(合并是秒级的一步)
DATA BRANCH MERGE feat_recompute INTO ml_features;

分支就是你的"实验场":里面怎么折腾都行,外面用的人无感;切换(合并)是秒级一步。万一重算的特征上线后发现反而掉点?RESTORE TABLE … {SNAPSHOT = team_base} 一键回到改之前。

边界提醒:这套行级 diff/merge 要求两边 schema 一致。如果你的改动是加一个新特征列(动表结构),顺序得是"先在主线加列,再开分支灌这一列的值",而不是在分支里加完列再合(第四篇讲过这个边界)。


改动进主数据集之前:让队友 review 一下

训练集是全队的"事实来源",谁都不想某天它被悄悄改了却没人知道、也复现不出来。于是团队定了条规矩:任何对主数据集的改动,先在分支上做,合并前要有人 review。

这正是 git4data 最自然的用法——把每个人的改动变成一个可评审、可留痕的 PR:

-- 作者:在分支上改,绝不直接动主数据集
DATA BRANCH CREATE TABLE feat_review FROM ml_features;
UPDATE feat_review SET label = 1 WHERE user_id <= 2000 AND label = 0;   -- 修正一批系统性标错的样本

-- Reviewer 把分支当 PR 审:先看规模,再逐行看,最后导出补丁存档
DATA BRANCH DIFF feat_review AGAINST ml_features OUTPUT SUMMARY;   -- UPDATED 858:改了多少、什么类型
DATA BRANCH DIFF feat_review AGAINST ml_features OUTPUT LIMIT 20;  -- 逐行看改成了什么
DATA BRANCH DIFF feat_review AGAINST ml_features OUTPUT FILE '/tmp';  -- 存一份 .sql 补丁,谁、何时、改了什么一清二楚

这一步,和你在 GitHub 上点开一个 PR、逐行看 diff,是完全一样的动作——只不过看的是数据。看完之后:

DATA BRANCH MERGE feat_review INTO ml_features;   -- 批准:合入主线
-- 或者打回:DROP TABLE feat_review; —— 主数据集一行都没动过

三个关键点正好对上"数据集可信"这件事:改动在合并前对主数据集完全不可见;review 建立在行级事实(DIFF)上、而非口头描述;OUTPUT FILE 导出的 .sql 补丁可以归档留痕,哪条样本、什么时候、被谁改成了什么,事后随时可查、可复现。


真撞车了:两个人改到了同一个用户

分工再清楚也有意外。Alice 在重算特征时调了 42 号用户的 monetary,而 Bob 在清洗时恰好也"修"了 42 号——42 号就撞上了,这是真冲突。先记住那条唯一的规则:

只有"两条分支都独立改了同一行",才算真冲突。 改的是不同的行 → 假冲突,数据库自动合并、无人介入;哪怕两人改的是同一行的不同列,也算真冲突(行级判定)。
请添加图片描述

DATA BRANCH CREATE TABLE feat_alice2 FROM ml_features;
DATA BRANCH CREATE TABLE clean_bob2  FROM ml_features;
UPDATE feat_alice2 SET monetary = 11.00 WHERE user_id = 42;   -- Alice 改 42
UPDATE clean_bob2  SET monetary = 22.00 WHERE user_id = 42;   -- Bob 也改 42(撞车)
UPDATE clean_bob2  SET label    = 1     WHERE user_id = 20;   -- Bob 独有、不冲突

DATA BRANCH MERGE feat_alice2 INTO ml_features;     -- Alice 先到,干净合入,主线 42 号 monetary = 11.00

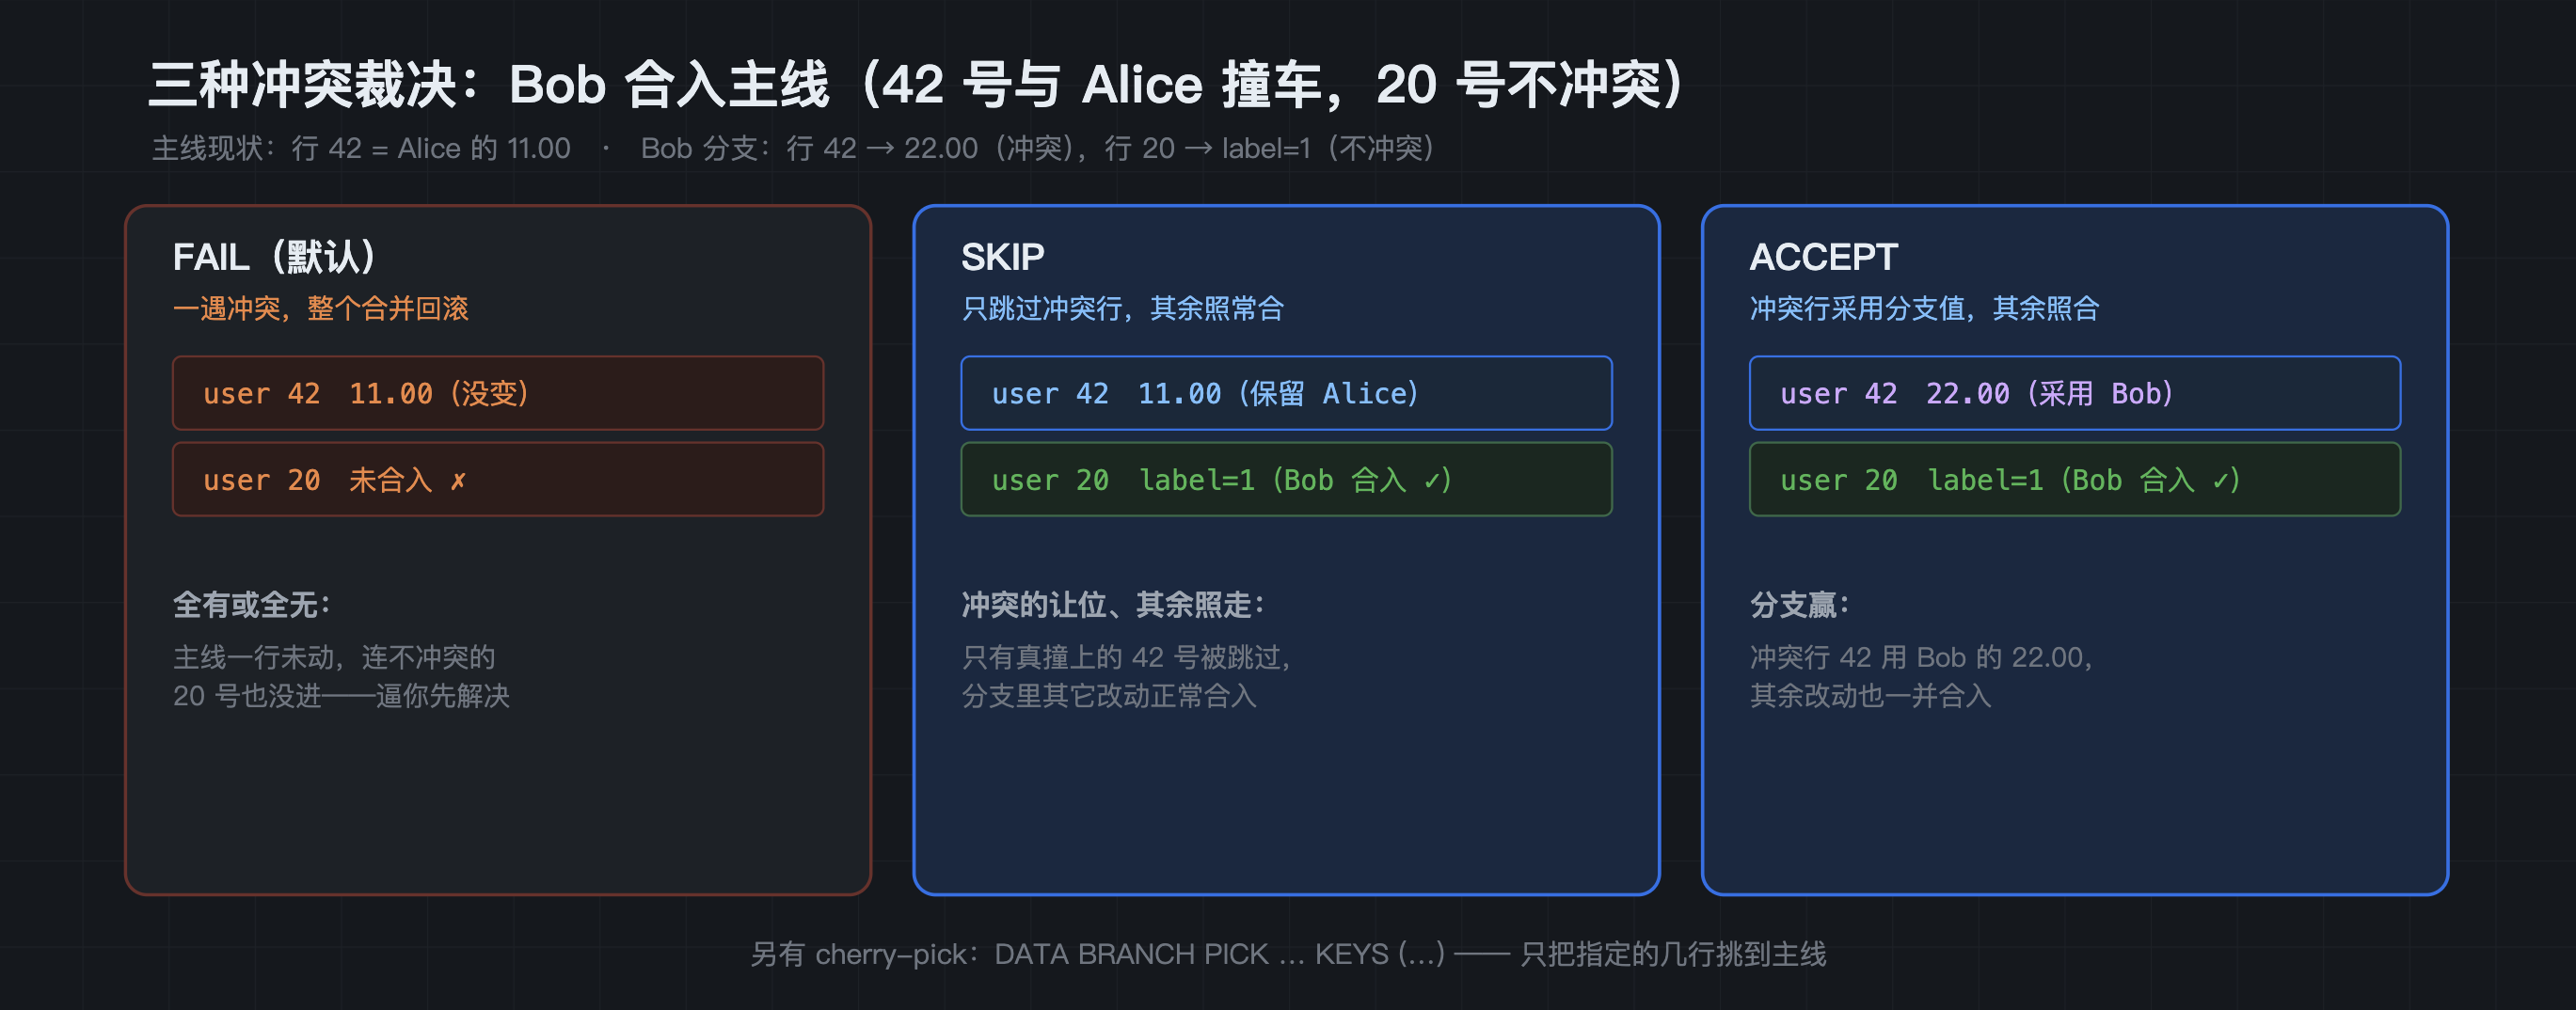
现在 Bob 来合,42 号撞上了。三种裁决方式,行为各不相同(实测确认):

-- ① FAIL(默认):一旦发现冲突,整个合并中止回滚。
DATA BRANCH MERGE clean_bob2 INTO ml_features WHEN CONFLICT FAIL;
--   报错:conflict on pk(42);主线一行未动——连 Bob 不冲突的 20 号也没合进来。
--   FAIL 是"全有或全无":把冲突摆上台面,逼你先去解决。

-- ② SKIP:只跳过冲突的行,其余正常合入。
DATA BRANCH MERGE clean_bob2 INTO ml_features WHEN CONFLICT SKIP;
--   结果:42 号保留主线(Alice 的 11.00);20 号成功合入(Bob 的 label=1)。

-- ③ ACCEPT:冲突行采用分支的值,其余也照常合入。
DATA BRANCH MERGE clean_bob2 INTO ml_features WHEN CONFLICT ACCEPT;
--   结果:42 号变成 Bob 的 22.00。
请添加图片描述

放到这个场景里就很具体了:如果Bob 的清洗结果更可信,就 ACCEPT 他那条分支;如果只是想把几个确认无误的用户单独提到主线、不合整条分支,就用 cherry-pick:

DATA BRANCH CREATE TABLE feat_pick FROM ml_features;
UPDATE feat_pick SET recency = 999 WHERE user_id IN (50, 51, 52);
-- 只把 50、51 两个用户的改动挑到主线,其余不动(PICK 需要主键)
DATA BRANCH PICK feat_pick INTO ml_features KEYS (50, 51) WHEN CONFLICT FAIL;
--   实测:只有 50、51 号被合入,52 号即便在分支里也改过,主线保持原值。

这里有两个容易忽略、但很关键的点:

  1. 数据库把冲突显式摆出来,而不是悄悄让后写覆盖先写。 "后写静默覆盖先写"正是没有版本控制时最常见的事故来源(lost update)——多人同时改一张特征表时,它意味着有人辛辛苦苦标的数据,被另一个人一次合并悄无声息地冲掉了。
  2. 要裁决的只有真撞上的那一行。 Bob 分支里其它正常改动会跟着 SKIP / ACCEPT 自动合入——要人拍板的,永远只是那几行真冲突。

回到上一篇埋的伏笔:第五篇里"手工 UPDATE … JOIN 把受损行还原、保住新订单"的定点修复,本质上就是这里 DATA BRANCH MERGE 自动做的三方合并——以共同祖先为基准、自动区分真假冲突。当时我们手工跑了一遍原理,现在把它交还给数据库。


几条让冲突更少的实践

  • 按 user_id 号段 / 分区分工,让各人的改动天然不重叠——这是成本最低的"无冲突"。
  • 小步快合:频繁地把小分支合回主线,比攒两周再做一次大爆炸式合并,冲突少得多。
  • 全队固定一个 base 快照(team_base),所有分支从它分出——血缘清晰,合并走第三篇说的增量快路径。
  • 要加新特征列(动表结构)?先在主线加列、再开分支灌值,别在分支里改完结构再合。

这就是数据的 Pull Request

把上面的动作抽出来,对照你每天在 GitHub 上做的事,几乎一一对应:

GitHubgit4data
fork / branchDATA BRANCH CREATE TABLE … FROM …
看自己 / 别人的 diffDATA BRANCH DIFF … AGAINST … OUTPUT SUMMARY / LIMIT / FILE
merge PRDATA BRANCH MERGE … INTO …
冲突解决WHEN CONFLICT FAIL / SKIP / ACCEPT
cherry-pickDATA BRANCH PICK … INTO … KEYS (…)
回到分叉点RESTORE TABLE … {SNAPSHOT = team_base}

区别只有一个:GitHub 合的是代码文件,这里合的是一张几十万、乃至上亿行的表——而且分支、合并都是秒级,与表多大无关。


成本与边界

  • 分支免费、合并秒级,且与表多大、并行多少人无关:之前实测过,6 亿行的表、4 个人各自 fork、各改百万行,每次合并都是秒级。无论是三人小队还是更大的数据团队,瓶颈都不在 git4data 这一侧。
  • 冲突裁决是行级,不是单元格级:同一行的不同列也算冲突(第四篇讲过;单元格级自动合并是未来工作)。
  • diff / merge 要求 schema 一致,且血缘可用时才走增量快路径(第三篇)。
  • FAIL 是全有或全无:要"部分合并",用 SKIP / ACCEPT,或用 PICK 精确挑行。

结语

数据协作开发不是一个抽象能力,而是一个团队直接共养一份数据集时,每天都会用上的基础设施:分支免费、合并秒级、冲突显式且只裁决真撞上的行。它最先打动的,往往就是那些"几个人一起喂一个模型"的小队——没有成熟流程兜着,改特征、补标注、灌新数据全靠手,"谁的改动算数"过去只能靠群里喊话,现在和合并代码一样自然。

但有个问题这篇还没回答:合并进主数据集的数据,质量谁来把关?万一某条分支合进来的本身就是脏数据呢?下一篇讲发布侧的答案:Write-Audit-Publish——新数据先进 staging 分支、过一道 SQL 审计门禁、再原子发布,让主数据集永远看不到没过关的数据。

📎 可运行 SQL:github.com/matrixorigin/git4data-tutorial | 源码与社区:github.com/matrixorigin/matrixone

让 OData V4 界面更聪明:SAP UI5 中的 Side Effects 全解析 摘要:在OData V4应用中,字段修改常触发联动更新(Side Effects)。SAP UI5支持通过后端PATCH响应隐式返回或前端显式请求(requestSideEffects)两种方式处理。最佳实践包括:在validateFieldGroup事件中触发同批次请求,使用$$patchWithoutSideEffects避免重复刷新,并在草稿场景优化响应体。注解定义触发规则,而前端负责执行时机,二者配合可减少网络开销并保证数据一致性。Fiori elements进一步扩展了Side Effects在批 阅读详情

相关推荐

WangEditor 5.0版本dangerouslyInsertHtml方法的正确使用方式

WangEditor 5.0版本dangerouslyInsertHtml方法的正确使用方式

yang1067155909的专栏 4291

MatrixOne Git for Data详解:如何像管理代码一样管理数据

MatrixOne的Git for Data功能是数据库领域的革命性创新,它将Git版本控制的强大能力引入数据管理领域。正如Git彻底改变了代码协作方式一样,Git for Data让您能够像管理代码一样管理数据库,为数据工作流带来前所未有的灵活性和安全性。本文将为您全面解析这一创新功能的原理、优势和实践方法。 ## 🎯 什么是Git for Data? Git for Data是Matri

gitblog_00115的博客 714

questasim的傻瓜式安装与仿真教程

一、安装 1、下载软件 链接:https://pan.baidu.com/s/1S05AnO_w-wy6RsAj_kdUXg 提取码:p2nt 2、根据电脑类型是32位还是64位,解压不同安装包。 解压得: 2、运行.exe文件,出现: 问题及解决办法: 这是杀毒软件造成的,因此在安装过程中关闭杀毒软件即可。关闭之后,再次运行.exe文件。 3、点击下一步,进入选择安装位置界面,如下:选择好安装位置后点击下一步。 4、点击同意 5、接下来等待安装结束即可,在安装过程中,会跳出来弹框,询问是否要添

树下等苹果的博客 3万+

Git for Data:像Git一样管理你的数据

摘要 AI时代的数据管理面临新挑战,MatrixOne提出"Git for Data"解决方案,将代码版本控制理念引入数据管理。该方案支持数据版本控制、快速回滚、分支管理等功能,能有效应对AI幻觉、确保数据溯源、提升协作效率。核心能力包括细粒度版本控制、秒级恢复、数据分支/克隆、权限管理等,基于存储优化技术实现低成本高效运作。作为云原生超融合数据库,MatrixOne兼容MySQL,支持多模态数据存储,为AI应用开发提供敏捷、安全的数据管理新范式。

MatrixOrigin的博客 1095

从手机到单片机:聊聊ARM Cortex家族那些事,A、R、M系列到底有啥不同?

本文深入解析ARM Cortex家族的A、R、M三大系列处理器,揭示它们在性能、实时响应和能效方面的核心差异。从智能手机到汽车电子和物联网设备,Cortex-A、R、M各司其职,分别应对复杂运算、实时控制和超低功耗场景。通过技术指标对比和典型应用案例,帮助开发者理解如何根据DMIPS/MHz等关键参数选择适合的处理器架构。

weixin_31574149的博客 351

LC滤波器设计实战:从理论计算到PCB布局的完整指南

滤波器是信号处理与电路设计中的基础组件,用于从复杂信号中提取特定频率分量或抑制干扰噪声。其核心原理基于电感(L)和电容(C)等无源元件的频率选择特性,通过特定的网络拓扑实现幅频与相频特性的塑造。在工程实践中,LC滤波器因其结构简单、可靠性高、成本可控,成为射频、模拟及电源电路中的关键技术手段。其设计价值在于将理论网络综合转化为可量产、高性能的硬件解决方案,广泛应用于通信系统、音频处理、电源净化和传感器信号调理等场景。本文聚焦于LC滤波器的工程设计全流程,深入剖析了巴特沃斯、切比雪夫等经典类型的选型权衡,并重

weixin_34194829的博客 273

MatrixOne Git4Data 技术详解(三):MatrixOne 架构及 Git4Data 原理解析,快照、Diff、Merge 凭什么这么快

文章摘要: MatrixOne数据库通过云原生存算分离架构,实现毫秒级数据版本控制。核心原理为:1) 数据以不可变对象存储,仅目录元数据可变;2) 快照通过记录时间戳保护对象版本,克隆仅复制元数据引用,均无需数据拷贝;3) Diff操作仅扫描增量变更对象而非全表;4) 合并采用三方对比机制,自动处理非冲突修改。这种设计使得对1亿行数据创建快照仅需5ms,克隆25ms,比对1000行差异23ms,版本控制成本与数据量解耦,成为存储引擎的自然特性而非额外开销。

MatrixOrigin的博客 775

Windows下用Anaconda安装d2l库避坑指南(附PermissionError解决方案)

本文详细介绍了在Windows系统下使用Anaconda安装d2l库的完整指南,特别针对常见的PermissionError问题提供了多种解决方案。从环境准备到库安装,再到VSCode配置和数据路径处理,帮助读者顺利搭建深度学习环境并运行《动手学深度学习》的代码示例。

3a9bq4r8t2y的博客 226

MatrixOne Git4Data 技术详解(五)·数据运维实践篇:误操作急救——从手滑 UPDATE 到误删整表,都能秒级回退

本文针对数据运维四大典型事故场景(误更新、批处理错误、脏写、误删表),提供了一套基于git4data的应急方案。核心策略是事前布防+精准恢复:通过PITR自动保护近期数据,配合毫秒级快照建立存档点。事故后先通过DATA BRANCH DIFF快速定位受损行,再根据业务连续性需求选择整表回滚或行级修复。关键优势在于:1)无需全表扫描即可生成行级事故报告;2)支持保留事故后的正常写入;3)所有操作均通过标准SQL实现,配套仓库提供可立即执行的示例。

MatrixOrigin的博客 467

Linux系统下Materials Studio 2020安装避坑指南:从依赖包到许可证配置全流程

本文提供了一份在Linux系统上安装Materials Studio 2020的深度避坑指南。详细解析了从系统依赖包检查、安装流程、许可证配置到Gateway服务部署的全过程,并分享了与Slurm作业调度系统集成的实战经验,旨在帮助用户高效、稳定地完成部署。

weixin_29313547的博客 387

【STM32实物】基于STM32的扫地机器人/小车控制系统设计

扫地机器人系统采用分层结构设计,主要包括底层硬件控制层、中间数据处理层和上层用户交互层。底层硬件控制层负责对各个硬件模块进行控制和数据采集,中间数据处理层负责对采集到的数据进行处理和解算,上层用户交互层负责与用户进行交互并显示系统状态信息。

嵌入式阿齐Archie 1万+

MatrixOne Git4Data 技术详解(四):数据版本控制全景——MatrixOne、lakeFS、DVC、Neon、Dolt 到底有什么不同

Git4Data 系列(四):画一张数据版本控制的全景地图。'git for data' 这个词被 DVC / Git LFS、lakeFS、Iceberg / Delta + Nessie、Snowflake / Neon、Dolt 一起用,但它们说的并不是同一件事。本文用五个问题立框架,按版本控制所在的层次分成四个种类(每类配一张架构图),再用一张 git 原语完整度矩阵把各家的 git 语义对齐,最后标定 MatrixOne 的准确坐标与诚实边界。

MatrixOrigin的博客 417

【Autoware】2小时安装Autoware1.13(保姆级教程)

Autoware是一款“一体化”开源自动驾驶软件,能实现感知、决策、控制等功能,通过在Ubuntu中搭建Autoware开发环境和案例的运行,使大家对自动驾驶技术的实现有一个更清晰的认识。

DevFrank的博客 1万+

# MatrixOne Git4Data 技术详解(八)·AI 训练实践篇:从数据进入到模型迭代——Git4Data 能力如何贯穿机器学习全流程

Git4Data 系列(八),AI 训练实践篇开篇:先建立机器学习全流程的坐标系。从数据接入、质量门禁、清洗标注、特征工程、训练/验证/测试集发布、模型评估,到上线监控与反馈重训,逐环节说明 snapshot、branch、diff、merge、cherry-pick、restore 与 PITR 能解决什么、不能解决什么,并以一个持续迭代的风控模型完整串联。配套脚本在 MatrixOne 4.1.0 上实测。

MatrixOrigin的博客 429

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

MatrixOne Git4Data 技术详解(九)·AI 训练实践篇:数据集发布与泄漏——别让离线指标骗了你

Git4Data 系列(八),AI 训练实践篇开篇:先建立机器学习全流程的坐标系。从数据接入、质量门禁、清洗标注、特征工程、训练/验证/测试集发布、模型评估,到上线监控与反馈重训,逐环节说明 snapshot、branch、diff、merge、cherry-pick、restore 与 PITR 能解决什么、不能解决什么,并以一个持续迭代的风控模型完整串联。配套脚本在 MatrixOne 4.1.0 上实测。

MatrixOrigin的博客 406

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

MatrixOne Git4Data 技术详解(七)·数据运维实践篇:Write-Audit-Publish——给 ETL 流水线装一道发布门禁

Git4Data 系列(七),数据运维实践篇收官:Write-Audit-Publish(WAP)。新数据先落 staging 分支、跑一组 SQL 审计门禁、再一次原子 MERGE 发布——脏批次在门口就被拦下,生产表全程零感知。含真实场景、三步落地、以及和直接灌/蓝绿改名/staging+INSERT/事务/DQ 工具等方案的详细对比。全部 SQL 在 MatrixOne 4.0.0-rc3 上实测。

MatrixOrigin的博客 264

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

MatrixOne Git4Data 技术详解(十)·深度学习篇:训练数据怎么管——lakeFS 管文件,MatrixOne 管元数据

Git4Data 系列(十),深度学习篇:文件型(图像等)训练数据分成两个世界——图/音/视频文件交给 lakeFS,指针/标签/哈希/切分组成的元数据交给 MatrixOne。以训练一个图像分类模型为例,用 SQL 在元数据上完成接入(WAP)、精确+感知去重、评测去污染、完整性检查、重标注、data curation 发布,并用「元数据快照 × lakeFS commit」钉成可复现训练集;lakeFS + MatrixOne 端到端脚本已实测。SQL 在 MatrixOne 4.1.0 上实测。

MatrixOrigin的博客 346

MatrixOne Git4Data 技术详解(十一)·大模型篇:SFT 数据 curation——可审计、可复现的数据清洗

Git4Data 系列(十一),大模型篇:SFT 的数据量比预训练小好几个数量级,每一次取舍都印在模型行为上。本文用一个对话模型的 SFT 数据池,在零拷贝分支上完整走一遍 curation——精确去重、近重复、质量门、安全、评测去污染、多轮对话完整性六步过滤,每步先计数,DATA BRANCH DIFF 给出这一轮的净变更,再按先登记、后替换、再快照的顺序发布;并对比业内其他做法。SQL 在 MatrixOne 4.1.0 上实测。

MatrixOrigin的博客 358

在数据库里玩“平行宇宙”:MatrixOne Data Branch 让数据也拥有Git 的分支/合并/对比/回滚(含跨集群同步)

这篇文章讲一件事:当数据像代码一样频繁迭代时,数据库内生的“分支工作流”会比备份/复制更可靠、更省钱、更工程化。

MatrixOrigin的博客 1156

MatrixOne Git4Data 技术详解(十二)·大模型篇:RLHF 偏好数据——分歧、裁决与可复现

Git4Data 系列(十二),大模型篇:偏好数据的单位不是行而是对,而且不是采集来的、是从标注投票算出来的二阶数据——RLHF 与 DPO 两条路线共用同一份。本文用 20000 个 prompt 的偏好池,从 63000 条投票推导偏好对,在分支上审计退化对、无共识、偏好环与长度偏置,DIFF 出这一轮的净变更,用分支裁决标注分歧、合并前先把冲突清单物化下来,最后先登记后快照把数据集与奖励模型绑成可复现的一对。SQL 在 MatrixOne 4.1.0 上实测,全部确定性可复现。

MatrixOrigin的博客 432

MatrixOne Git4Data 技术详解(二):从零跑通所有 Git 原语

本文是Git4Data系列第二篇,通过10分钟实操演示如何在MatrixOne数据库上实现Git式数据版本控制。内容包括: 快速安装单机版MatrixOne(兼容MySQL协议) 在百万行订单表上实操Git核心功能: 快照(CREATE SNAPSHOT)与恢复(RESTORE) 克隆(CLONE)与分支(DATA BRANCH CREATE) 差异比对(DATA BRANCH DIFF) 数据合并(MERGE)与拣选(PICK) 所有操作均支持百万级数据量,性能优异 配套完整SQL脚本和GitHub教程仓

MatrixOrigin的博客 257

ETL发布门禁:基于Git4Data的Write-Audit-Publish模式实践

在数据工程领域,ETL(提取、转换、加载)是构建数据仓库和数据分析平台的核心技术,负责将原始数据转化为可信、可用的数据资产。其核心原理是通过一系列预定义的转换逻辑与工作流,实现数据的清洗、整合与建模。该技术的核心价值在于确保数据质量、一致性与时效性,为业务决策和数据分析提供可靠基础。典型的应用场景包括报表生成、用户画像构建和机器学习特征工程。然而,传统“写后即走”的ETL发布模式存在直接将未经验证的数据变更推入生产环境的风险。为此,结合**数据版本控制**与**分支隔离**的Write-Audit-Publ

weixin_30265103的博客 369

MatrixOne Git4Data 技术详解(一):海量数据的 Git 时刻

摘要: MatrixOne推出的Git4Data技术为海量数据提供了类似Git的版本控制能力(commit、branch、diff等),解决了数据管理长期缺乏高效并行协作的痛点。通过指针而非复制实现分支,其在TB级数据上仍能毫秒级操作,成本近乎为零。这一突破尤其适配AI时代需求——AI Agent的自主性、错误率和并行探索特性亟需数据版本化支撑,如同Git曾推动开源协作革命。Git4Data填补了数据基础设施的关键空白,成为AI安全操作数据的前提。后续文章将深入解析其技术原理及在MLOps、Agent进化等

MatrixOrigin的博客 246

MatrixOne Git4Data:为机器学习数据管理打造可执行、可审计、可复现的版本链

清洗与标注环节,先打快照,标注员各自开分支,处理重叠标注区冲突,资深评审员挑回争议样本,标注平台与 Git4Data 能力分工明确;训练、验证、测试集发布环节,不仅要冻结数据,还要明确切分成员关系与规则,采用库级快照发布,可复现样本角色,新版本发布前需分别 review 样本内容和切分成员关系;实际管理中存在诸多难题,背后反映出机器学习缺乏作用在数据本身的版本语义,MatrixOne 的 Git4Data 能力可填补这一缺口,本文先建全流程地图,后续深入典型节点。Branch 用于隔离未证明正确的假设;

IT界那些事儿 16

AI时代的数据管理新范式:Git for Data让数据工程化

AI快速发展与企业数据管理滞后的矛盾日益突出。算法迭代日新月异,但企业数据多沉睡在孤岛中,格式杂乱,导致70%的AI项目时间耗费在数据准备上。软件开发已实现工程化,数据管理却仍处"前Git时代":变更难追溯、版本靠复制、协作靠默契。文章提出"Git for Data"新范式,通过瞬间快照、毫秒级克隆分支和版本审计三大能力,实现数据工程化管理。MatrixOne数据库作为技术底座,支持这一范式落地,将AI开发周期从数周缩短至数天,助力企业构建AI核心竞争力。

MatrixOrigin的博客 646

基于MatrixOne Git4Data的ETL流水线Write-Audit-Publish模式实战

在数据工程领域,ETL(提取、转换、加载)是构建数据仓库和数据湖的核心技术,负责将分散、异构的源数据转化为统一、可用的目标数据。其核心原理是通过一系列可编程的数据处理步骤,实现数据的整合与价值提炼。该技术的核心价值在于保障数据质量、提升处理效率,并支持复杂的业务分析需求,广泛应用于数据集成、报表生成和机器学习等场景。随着数据规模与业务复杂度的增长,确保ETL任务在生产环境中的稳定性和数据准确性成为关键挑战。为此,业界引入了Write-Audit-Publish(WAP)模式,通过将数据写入、审计校验和发布生

weixin_30800987的博客 324
上一篇: MatrixOne Git4Data 技术详解(五)·数据运维实践篇:误操作急救——从手滑 UPDATE 到误删整表,都能秒级回退
下一篇: Snowflake 的 AI 标签终于贴牢了,数据公司的底蕴也终于在 AI 浪潮下凸显了
MatrixOrigin
博客等级 码龄5年 708粉丝 230原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值