


上一篇我们做了一轮完整的 SFT 数据 curation:在分支上做六步过滤,每步先计数,DIFF 留下审计记录,先登记后快照发布。这一篇沿着大模型的训练链路往下走一步,进入偏好对齐——RLHF / DPO 依赖的那份偏好数据。
第十一篇讲过,SFT 教模型「按人期望的方式回答」。但 SFT 有个天花板:它只能学「这是一个好回答」,学不了「这两个都还行的回答里,哪个更好」。而后者恰恰是把模型从"能用"推到"好用"的关键。偏好对齐要解决的就是这个:让人(或模型)在多个候选回答之间做比较,再用这些比较去调整模型。
这里要先分清两条路线——它们吃的是同一份偏好数据,但下游完全不同:
- RLHF:先用这些比较训练一个奖励模型(Reward Model),再用强化学习(PPO 等)拿奖励模型去优化策略模型;
- DPO(Direct Preference Optimization):不训练奖励模型,直接从偏好对上优化策略模型。
本文讲的是这份偏好数据本身——它对两条路线是共用的。后文凡是出现「奖励模型 / rm_v1」的地方(包括把数据集和奖励模型绑定的那张注册表),说的都是 RLHF 这条链路;如果你走 DPO,绑定的对象换成策略模型的版本,前面的构建、审计、裁决、发布流程完全一样。
于是训练数据的形态又变了一次。这一次的变化,比前面几篇都更根本。
这一篇讲清楚偏好数据特殊在哪、它会以什么方式坏掉(退化对、无共识、偏好环、长度偏置)、多个标注员的分歧怎么裁决、以及一份偏好数据集怎么和奖励模型绑成可复现的一对。文中 SQL 全部在 MatrixOne
4.1.0上实测,且全部使用确定性表达式(没有rand()),每个数字都可逐次复现;可跑版本见 git4data-tutorial 的12-rlhf-preference/rlhf_preference_demo.sql(已固定到具体 commit,避免后续改动导致数字对不上)。
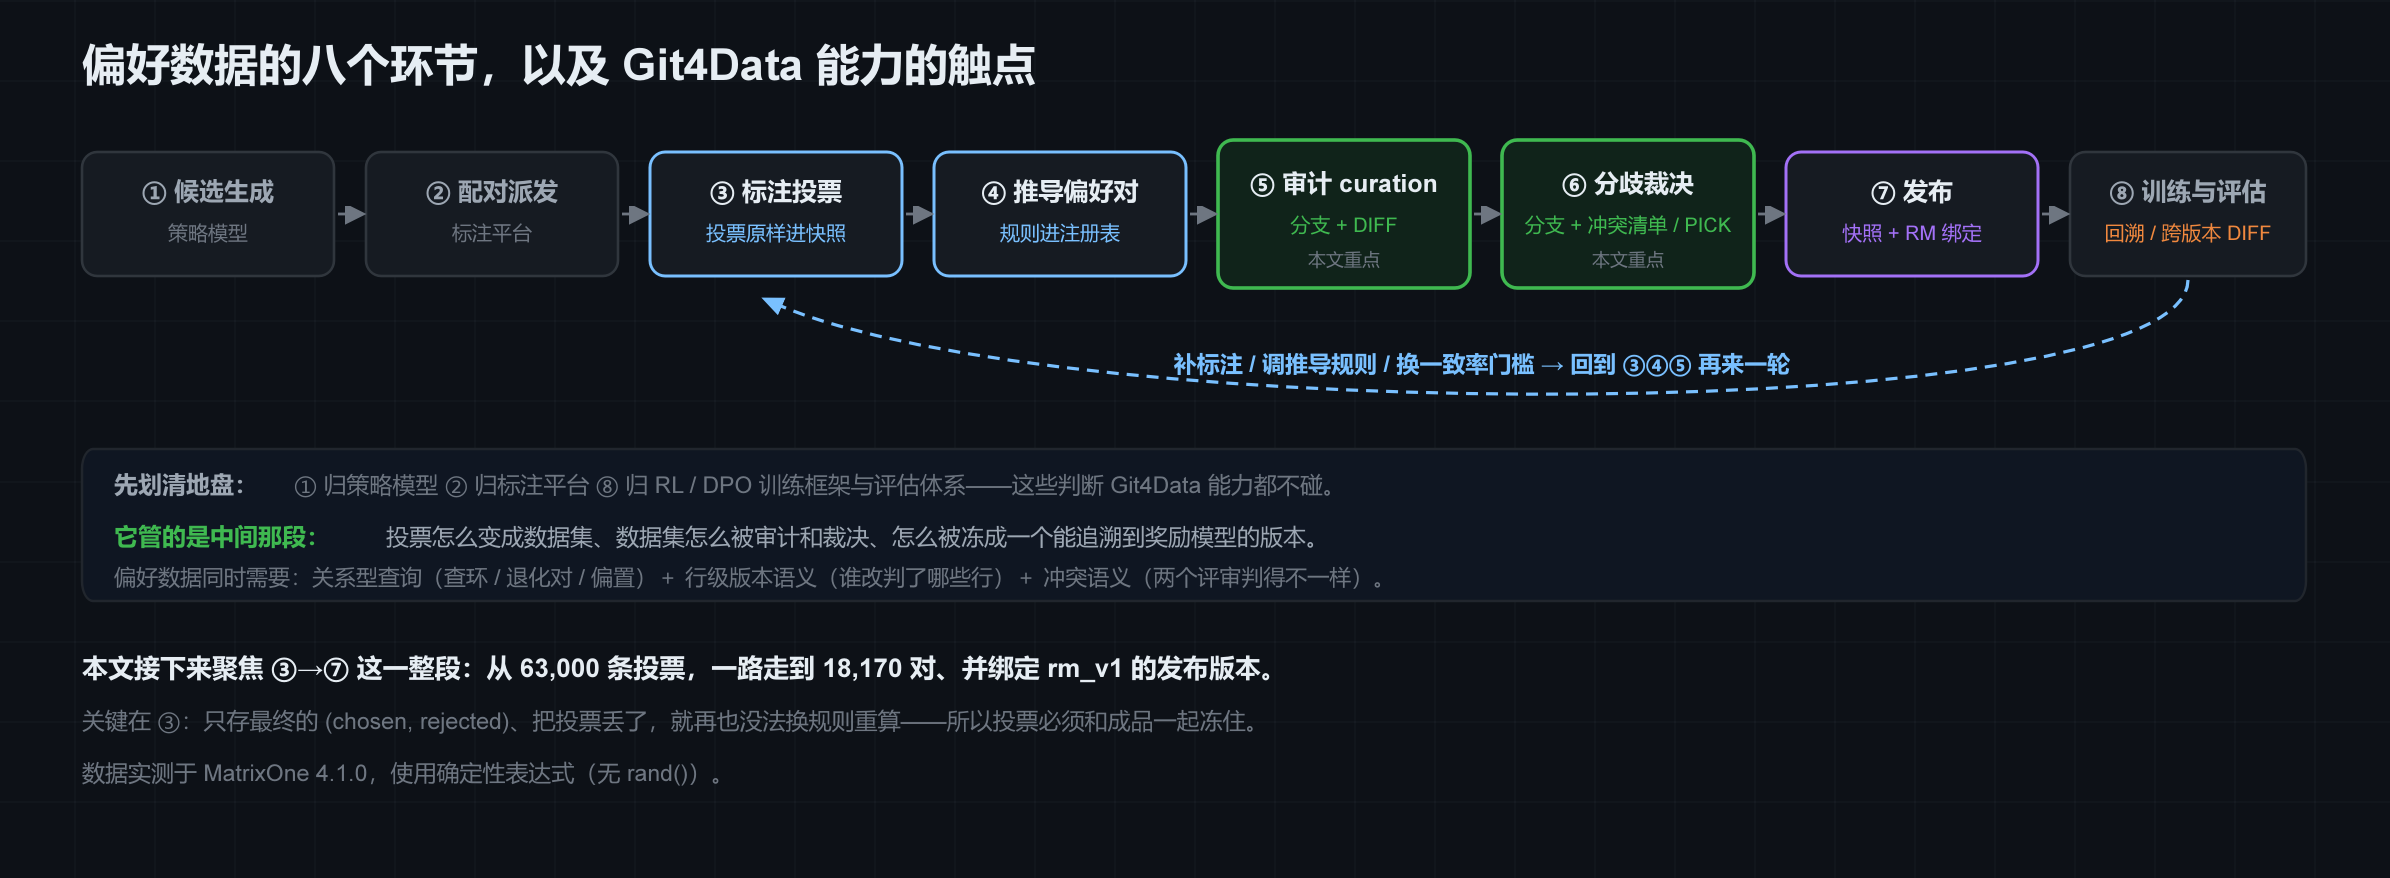
先看全貌:一份偏好数据要走完的八个环节
和上一篇一样,先把整条链路摊开,再钻细节。一批偏好数据从产生到真正改变模型行为,要走完这些环节:
① 候选生成 ─▶ ② 配对派发 ─▶ ③ 标注投票 ─▶ ④ 推导偏好对 ─▶ ⑤ 审计 curation
                                                                    │
                                    ⑧ 训练与评估(RM+PPO / DPO) ◀── ⑦ 发布 ◀── ⑥ 分歧裁决
                                                    │
                                                    └──── 补标注 / 调规则 / 换门槛 ──▶ 回到 ③④⑤
① 候选生成:用不同策略版本、不同温度,对同一个 prompt 采样出多个候选回答。这里就埋下了后面所有偏置的种子——如果某一版策略天生话多,它的回答就会系统性地更长。
② 配对派发:决定哪些候选两两比较、派给谁标。属于标注平台的地盘。
③ 标注投票:标注员(或 LLM-as-judge)在每一对里选一个。注意这一步产出的是投票,不是数据集本身。
④ 推导偏好对:按规则从投票算出 (chosen, rejected)——多数票怎么定?平局算不算?一致率门槛卡多少?规则本身就是一次决策,换个门槛就是另一份数据集。
⑤ 审计与 curation:查退化对、无共识、偏好环,统计长度偏置。
⑥ 分歧裁决:把 2:1 的分歧样本送资深评审重裁。多个评审并行改判同一批数据,冲突怎么办?
⑦ 发布:冻结成一个确定版本,并和即将训练的奖励模型绑定。
⑧ 训练与评估:走 RLHF 就是「训奖励模型 → PPO 优化策略」,走 DPO 就是直接用偏好对优化策略;评估之后回头补标注、调规则——回到 ③④⑤ 再来一轮。而"策略模型开始说废话"这种症状,往往要回溯三层才能找到根因。
这八个环节里,哪些是数据版本控制的地盘
同样先划清楚:① 归策略模型,② 归标注平台,⑧ 归 RL / DPO 训练框架和评估体系——这些判断 Git4Data 这套能力都不碰。它管的是中间那段:投票怎么变成数据集、数据集怎么被审计和裁决、怎么被冻成一个能追溯到奖励模型的版本。
| 环节 | 真实问题 | MatrixOne 的 Git4Data 能力怎么帮 |
|---|---|---|
| ③ 标注投票 | 只存最终结论,投票丢了就再也算不回去 | 投票原样入库并进快照,换规则随时可重算 |
| ④ 推导偏好对 | 换个门槛就是另一份数据集,但规则没留痕 | 推导规则写进注册表,随版本一起冻结 |
| ⑤ 审计 curation | 退化对、偏好环这类问题只能靠脚本零散查 | 在分支上用 SQL 关系型查询,一条 DIFF 出审计记录 |
| ⑥ 分歧裁决 | 多个评审改同一批数据,谁的判断算数 | 每人一条分支,合并前用 SQL 把重叠的行物化成冲突清单,MERGE 时按显式策略(SKIP/FAIL/ACCEPT)处理,或用 PICK 只取终审行 |
| ⑦ 发布 | 训练读的数据集一直在变 | 库级 SNAPSHOT 冻结;注册表把模型 ← 数据集绑成一对 |
| ⑧ 回溯 | 策略模型出症状,追不到偏好数据 | 沿 rm_vN → pref_vN → 快照 一路查回去,跨版本 DIFF 看差异 |
一句话:偏好数据同时需要关系型查询(查环、查退化对、算偏置)、行级版本语义(谁改判了哪些行)和冲突语义(两个评审判得不一样)——而这三件事,恰好是同一张表上的同一件事。
本文接下来聚焦 ③→⑦ 这一整段,从投票一路走到发布。
偏好数据的两个特殊之处
一、单位不是「行」,而是「对」
前面几篇里,一条样本就是一行:一条 SFT 记录、一张图的元数据。偏好数据不是——它的最小单位是一个三元组:
(prompt,chosen 更好的回答,rejected 较差的回答)
一条偏好记录天生是关系型的:它把同一个 prompt 下的两个候选关联起来,说的是它们之间的相对关系。这带来一串前面没有的问题:
- 两个候选是同一段文本,这条"偏好"就没有信息量(退化对);
- 同一个 prompt 下的多个对之间,可能互相矛盾(A>B、B>C,却又 C>A);
- 你没法孤立地看一行判断它对不对,必须放在同一个 prompt 的上下文里看。
二、偏好数据不是「采集」来的,是「算」出来的
这一点更关键。SFT 数据是拿来的:供应商给你一条,它就是一条。偏好数据不是——你拿到的原始物料是投票:
pair #1024 标注员 anno_1: 选 A 标注员 anno_2: 选 A 标注员 anno_3: 选 B
真正用来训练的那条 (chosen, rejected),是从这些投票推导出来的:多数票是谁?三个人各执一词怎么办?有人投了"平局"算不算数?推导规则本身就是一次决策。
所以偏好数据集是一份二阶数据:
偏好数据集版本 = 原始投票的版本 × 推导规则(多数票 / 一致率门槛 / 平局处理)
换了门槛,同一批投票能算出不同的数据集。这意味着「这份偏好数据是怎么来的」必须和数据一起被版本化——否则半年后没人能说清 rm_v1 到底是用什么规则、从哪一批投票里算出来的。
一个真实会发生的故障:奖励模型学会了「话长就是好」
先看一个 RLHF 里非常经典、也非常隐蔽的失败模式。
团队训完奖励模型 rm_v1,接上 PPO 跑策略优化。几轮之后发现:模型的回答越来越长,废话越来越多,但奖励分一路走高。人工看反而觉得变差了。
问题不在 PPO,在偏好数据。人类标注员(以及用来打标的模型)有一个已被研究反复观察到的倾向:在两个都还行的回答之间,倾向于选更长、更详细的那个(Singhal 等人对 RLHF 中长度相关性的系统分析见文末参考资料)。如果这个倾向没被察觉,偏好数据里就会系统性地出现「chosen 比 rejected 长」,于是奖励模型学到的其实是长度这个捷径特征,而不是质量。策略模型再顺着这个奖励爬——就爬成了废话生成器。
这个问题的麻烦之处在于:它不会报错,各项指标看着都在涨。要在训练之前发现它,得对偏好数据做一次统计审计——检测手段不止一种(建模侧也有长度去偏、长度分层评估等做法),而本文这套的好处是:数据本来就在表里,一条 SQL 就能把这个数字算出来。
后面我们会看到:本文这份数据池实测 75.9% 的 chosen 比 rejected 长,平均长 95.2 个字符。这个数字必须在训练之前被摆到桌面上。
贯穿全文的案例:一轮偏好数据的构建与发布
案例设定:为一个对话模型准备偏好数据。20,000 个 prompt,每个 prompt 有 3 个候选回答(分别来自不同版本的策略模型),标注员在候选之间两两比较。
数据分三张表,对应"原料 → 投票 → 成品":
-- ① 候选回答(原料)
CREATE TABLE candidates (
    cand_id   BIGINT PRIMARY KEY,
    prompt_id BIGINT,
    slot      CHAR(1),          -- A / B / C
    response  VARCHAR(512),
    resp_len  INT,              -- 长度:后面审计长度偏置要用
    model_tag VARCHAR(32)       -- 哪个策略版本生成的
);

-- ② 原始投票(每个标注员对每个 pair 投一票)
CREATE TABLE annotations (
    anno_id   BIGINT PRIMARY KEY,
    pair_id   BIGINT,
    prompt_id BIGINT,
    cand_a    BIGINT,
    cand_b    BIGINT,
    annotator VARCHAR(16),
    verdict   CHAR(1)           -- 'a' / 'b' / 't'(平局)
);

-- ③ 推导出的偏好对(成品,真正拿去训奖励模型的)
CREATE TABLE preference_pairs (
    pair_id     BIGINT PRIMARY KEY,
    prompt_id   BIGINT,
    chosen_id   BIGINT,
    rejected_id BIGINT,
    n_votes     INT,
    top_votes   INT,
    agree_rate  DOUBLE          -- 一致率 = 最高票 / 总票数
);
保留 ② 这张原始投票表非常重要。很多团队只存最终的 (chosen, rejected),把投票扔了——一旦要换推导规则(比如把一致率门槛从 0.6 提到 0.8),就再也算不回去了。原始投票是这份数据的"源代码"。
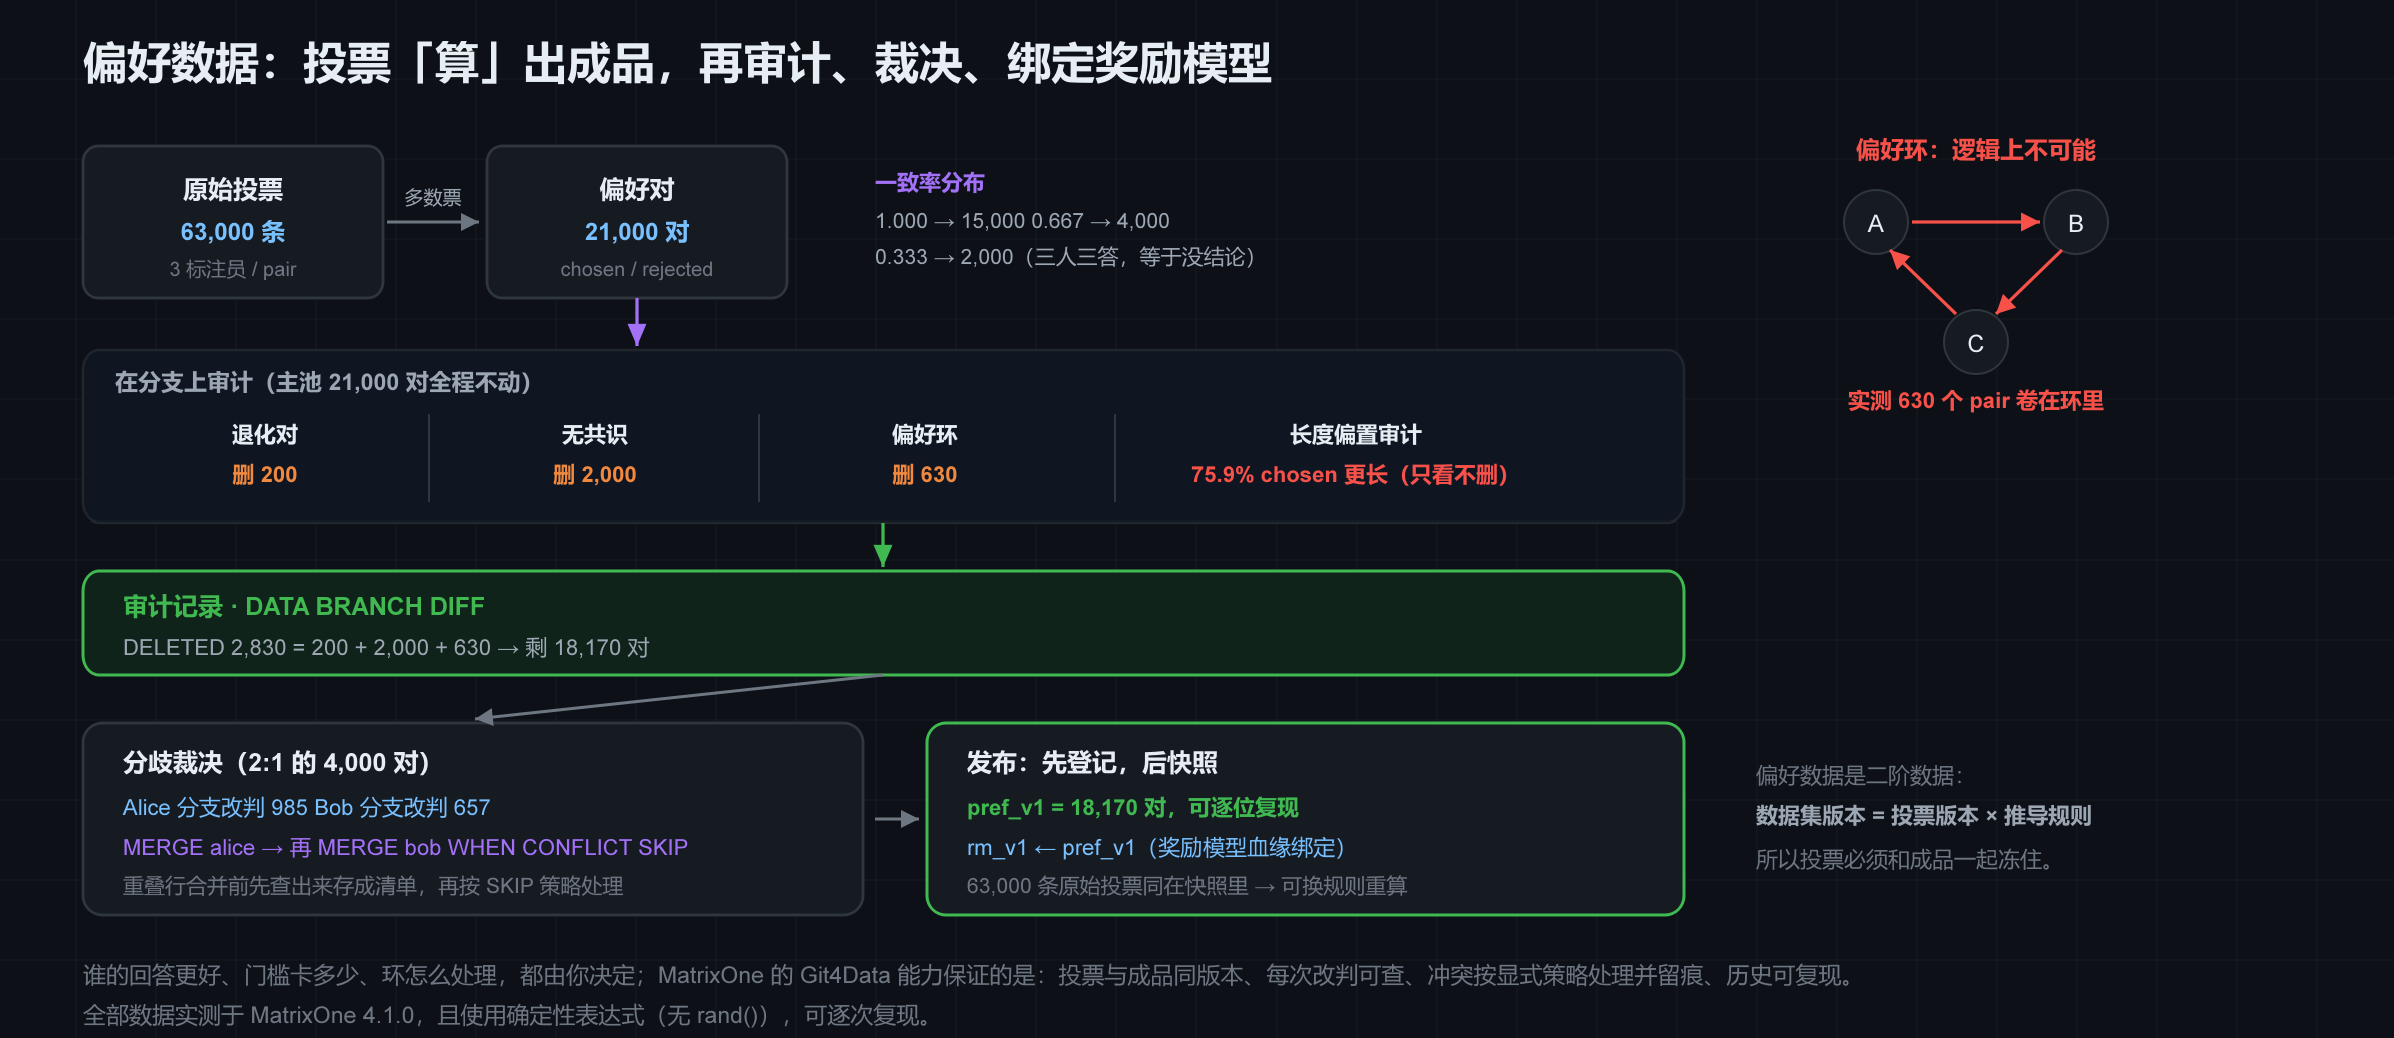
案例规模:60,000 个候选、63,000 条投票、21,000 个 pair(20,000 个主 pair,加上给 500 个 prompt 额外构造的 B-vs-C、C-vs-A,用来演示偏好环)。
第一步:从投票推导偏好对
推导本身就是一条 SQL——按 pair 聚合投票,取多数,同时算出一致率:
INSERT INTO preference_pairs
SELECT v.pair_id, v.prompt_id,
       CASE WHEN v.a_votes >= v.b_votes THEN v.cand_a ELSE v.cand_b END,   -- chosen
       CASE WHEN v.a_votes >= v.b_votes THEN v.cand_b ELSE v.cand_a END,   -- rejected
       v.n_votes,
       GREATEST(v.a_votes, v.b_votes, v.t_votes),
       ROUND(GREATEST(v.a_votes, v.b_votes, v.t_votes) / v.n_votes, 3)     -- 一致率
FROM (
  SELECT pair_id, MIN(prompt_id) AS prompt_id, MIN(cand_a) AS cand_a, MIN(cand_b) AS cand_b,
         COUNT(*) AS n_votes,
         SUM(CASE WHEN verdict = 'a' THEN 1 ELSE 0 END) AS a_votes,
         SUM(CASE WHEN verdict = 'b' THEN 1 ELSE 0 END) AS b_votes,
         SUM(CASE WHEN verdict = 't' THEN 1 ELSE 0 END) AS t_votes
  FROM annotations GROUP BY pair_id
) v;
--   实测得到 21,000 个 pair
一致率的分布,是这份数据的第一项质量指标:
SELECT agree_rate, COUNT(*) AS n FROM preference_pairs GROUP BY agree_rate ORDER BY agree_rate;
--   实测 0.333 → 2,000    (三个人各执一词,等于没结论)
--        0.667 → 4,000    (2:1,有多数但有分歧)
--        1.000 → 15,000   (一致通过)
这张表本身就在说话:有 2,000 个 pair 三个标注员完全没达成共识,还有 4,000 个存在分歧。前者基本是噪声,后者需要裁决——两件事后面分别处理。
第二步:在分支上审计与 curation
和第十一篇一样,先拉分支,主池一行不动:
DATA BRANCH CREATE TABLE pairs_curated FROM preference_pairs;
检查一:退化对——两个候选是同一段文本
同一个回答被两个 slot 采到(或者候选生成时撞了),这条"偏好"就毫无信息量,还会给奖励模型灌进矛盾梯度:
SELECT COUNT(*) AS degenerate FROM pairs_curated p
JOIN candidates c1 ON p.chosen_id   = c1.cand_id
JOIN candidates c2 ON p.rejected_id = c2.cand_id
WHERE c1.response = c2.response;
--   实测 200

DELETE FROM pairs_curated WHERE pair_id IN (
  SELECT pair_id FROM (
    SELECT p.pair_id FROM pairs_curated p
    JOIN candidates c1 ON p.chosen_id   = c1.cand_id
    JOIN candidates c2 ON p.rejected_id = c2.cand_id
    WHERE c1.response = c2.response
  ) t
);
注意这条检查必须 JOIN 回候选表——光看 preference_pairs 是发现不了的,因为 chosen_id 和 rejected_id 是两个不同的 ID,只有正文才知道它们其实一样。这正是"偏好数据是关系型的"的直接体现。
检查二:无共识——三个人给出了三种答案
一致率 0.333 意味着三个人给出了三种答案。这种 pair 训不出任何有用的信号,反而是纯噪声:
SELECT COUNT(*) AS no_consensus FROM pairs_curated WHERE agree_rate < 0.6;
--   实测 2,000
DELETE FROM pairs_curated WHERE agree_rate < 0.6;
0.6 这个门槛是一次决策,不是自然规律:卡得高,数据更干净但更少、且会系统性丢掉"难题"(越难的问题越容易有分歧);卡得低,噪声更多。所以它必须被记进版本规则里。
检查三:偏好环——A>B,B>C,却又 C>A
这是成对比较(pairwise preference / ranking)数据里的典型问题——不限于 RLHF,任何靠两两比较得出排序的场景都会遇到;只是在偏好数据里格外要紧。单看每一条都是合法的判断,但放在一起在逻辑上不可能成立:
        A ────▶ B          A 比 B 好
        ▲       │          B 比 C 好
        │       ▼          C 比 A 好   ← 矛盾
        └────── C
它是怎么产生的?通常不是标注员在犯傻,而是:不同的对由不同的人判断;或者这三个回答本来就水平相当,比较标准在细微处不一致(一个人重视准确、一个人重视简洁)。环的存在,本身就说明这组比较不可靠。
奖励模型如果吃进一个环,等于同时被告知 A>B>C>A——它只能在矛盾中学出一个平庸的折中。检测方法是在同一个 prompt 内做三段自连接:
SELECT COUNT(DISTINCT p1.pair_id) AS pairs_in_cycles
FROM pairs_curated p1
JOIN pairs_curated p2 ON p1.prompt_id = p2.prompt_id AND p1.rejected_id = p2.chosen_id
JOIN pairs_curated p3 ON p2.prompt_id = p3.prompt_id AND p2.rejected_id = p3.chosen_id
WHERE p3.rejected_id = p1.chosen_id;
--   实测 630 个 pair 卷在环里
处理方式有两种:整环丢弃(本文的做法,干净),或者送回人工重裁(更贵但保留了难样本)。本文选前者:
DELETE FROM pairs_curated WHERE pair_id IN (
  SELECT pair_id FROM (
    SELECT DISTINCT p1.pair_id
    FROM pairs_curated p1
    JOIN pairs_curated p2 ON p1.prompt_id = p2.prompt_id AND p1.rejected_id = p2.chosen_id
    JOIN pairs_curated p3 ON p2.prompt_id = p3.prompt_id AND p2.rejected_id = p3.chosen_id
    WHERE p3.rejected_id = p1.chosen_id
  ) t
);
这里的顺序会直接改变数字:630 是在删掉退化对和无共识 pair 之后测出来的。如果不先删退化对就查环,同一份数据实测是 1,050 个 pair 卷在环里——因为退化对本身(chosen 和 rejected 是同一段文本)也在制造虚假的环。所以三步检查的先后顺序,本身就是这一版 curation 规则的一部分,换个顺序就是另一份数据集,必须记进版本里。
检查四:长度偏置——这一步不删数据,只做统计
前面那个「奖励模型学会话长就是好」的故障,就在这里被拦下:
SELECT
  COUNT(*) AS pairs,
  SUM(CASE WHEN c1.resp_len > c2.resp_len THEN 1 ELSE 0 END) AS chosen_longer,
  ROUND(100.0 * SUM(CASE WHEN c1.resp_len > c2.resp_len THEN 1 ELSE 0 END) / COUNT(*), 1) AS pct_longer,
  ROUND(AVG(c1.resp_len - c2.resp_len), 1) AS avg_len_gap
FROM pairs_curated p
JOIN candidates c1 ON p.chosen_id   = c1.cand_id
JOIN candidates c2 ON p.rejected_id = c2.cand_id;
--   实测 pairs 18170 / chosen_longer 13790 / pct_longer 75.9 / avg_len_gap 95.2
75.9%。也就是说,如果你只按"谁长选谁"这个规则去猜,就能猜对四分之三——奖励模型当然会先学会这个捷径。
要强调的是:这一步不应该直接删数据。长回答有时确实更好,粗暴地砍掉会误伤真实信号。它是一个必须被看见的信号,可选的应对包括:按长度分层采样、让奖励模型显式做长度去偏、或者干脆接受并在评估时单独盯住长度指标。Git4Data 能力的职责是让这个数字在发布之前一定会被看到,而不是替你决定怎么办。
审计记录:这一轮到底动了什么
DATA BRANCH DIFF pairs_curated AGAINST preference_pairs OUTPUT SUMMARY;
--   实测 INSERTED 0 / DELETED 2830 / UPDATED 0
2830 = 200(退化)+ 2000(无共识)+ 630(环),主池 21,000 个 pair 一行没动。剩下 18,170 个 pair 进入下一步。
第三步:分歧的裁决——分支、冲突、只挑裁决过的行
现在回头处理那 4,000 个 2:1 的分歧 pair。这类样本恰恰是最有价值也最危险的:分歧往往出现在真正的难题上,直接丢掉可惜,照单全收又可能是错的。
标准做法是送资深评审重裁。而"多个评审并行改同一批数据",正是第六篇那套并行协作的场景——每人一条分支:
DATA BRANCH CREATE TABLE pairs_alice FROM pairs_curated;
DATA BRANCH CREATE TABLE pairs_bob   FROM pairs_curated;

-- 评审改判 = 把 chosen / rejected 对调
UPDATE pairs_alice SET chosen_id = rejected_id, rejected_id = chosen_id
WHERE agree_rate < 0.7 AND pair_id % 4 = 0;

UPDATE pairs_bob   SET chosen_id = rejected_id, rejected_id = chosen_id
WHERE agree_rate < 0.7 AND pair_id % 6 = 0;
每个人改了多少,各自一条 DIFF 就能说清:
DATA BRANCH DIFF pairs_alice AGAINST pairs_curated OUTPUT SUMMARY;   -- 实测 UPDATED 985
DATA BRANCH DIFF pairs_bob   AGAINST pairs_curated OUTPUT SUMMARY;   -- 实测 UPDATED 657
两人改判的集合是部分重叠的(pair_id 同时被 4 和 6 整除的那些)。重叠的这部分,就是真正需要人来定夺的集合。
合并之前,先把这个集合查出来存下来——这一步不能省:
-- 两条分支都改过的同一批行:这就是这一轮的冲突清单
SELECT a.pair_id, a.chosen_id AS alice_chosen, b.chosen_id AS bob_chosen
FROM pairs_alice   a
JOIN pairs_bob     b ON a.pair_id = b.pair_id
JOIN pairs_curated m ON m.pair_id = a.pair_id
WHERE a.chosen_id <> m.chosen_id      -- Alice 改过这行
  AND b.chosen_id <> m.chosen_id;     -- Bob 也改过这行
为什么必须自己先查:WHEN CONFLICT SKIP 会按策略跳过冲突行,但它不会把被跳过的 pair_id 返回给你——执行完你只拿到一个合并后的结果,没有清单。想留下「哪些行被跳过了、Bob 当时的意见是什么」,只能在合并之前用上面这条普通查询把它物化下来(CREATE TABLE … AS SELECT 存成一张冲突表,跟着版本一起冻住)。
清单在手,再合并:
DATA BRANCH MERGE pairs_alice INTO pairs_curated;                    -- 先合入
DATA BRANCH MERGE pairs_bob   INTO pairs_curated WHEN CONFLICT SKIP; -- 冲突处保留主线已有裁决
SKIP 的语义是:Bob 改到的行如果主线已经被 Alice 改过,就保留主线的版本、跳过 Bob 的;不冲突的部分照常合入。要点在于「按显式声明的策略处理」,而不是「系统替你自动暴露」——策略是你选的(SKIP 保主线、FAIL 直接报错中止、ACCEPT 采纳来源分支),而冲突集合的留痕要靠上面那条查询。这两件事合起来,才让"谁的判断算数"变成一个有据可查的决策,而不是一次静默覆盖。
如果流程上要求"只有终审裁决过的行才能进主线",那就该用 PICK,只把评审队列里那批行挑回去,而不是整条分支合并。
第四步:发布,并把奖励模型绑上去
发布的顺序和第十一篇一样——先登记、后快照,这样绑定才会被冻进版本里,而不是只躺在活库中:
INSERT INTO dataset_registry
SELECT 'pref_v1', 'pref_v1', COUNT(*),
       'drop degenerate, agree_rate>=0.6, drop cycle pairs, length bias reported'
FROM pairs_curated;

-- 偏好数据特有的一条:把奖励模型和它吃的那份偏好数据绑起来
INSERT INTO reward_model_registry
VALUES ('rm_v1', 'pref_v1', 'pref_v1', 'policy_v3-base', '9c41ab');

DROP TABLE preference_pairs;
ALTER TABLE pairs_curated RENAME TO preference_pairs;
CREATE SNAPSHOT pref_v1 FOR DATABASE rlhf_pool;
reward_model_registry 这张表是偏好数据这一环特有的。RLHF 的链路很长——偏好数据 → 奖励模型 → 策略模型——中间任何一环出问题,症状都表现在最末端的策略模型上。有了这条绑定,“策略模型开始说废话"这个现象,才能一路回溯到"rm_v1 是用 pref_v1 训的,而 pref_v1 的长度偏置是 75.9%”。
发布后验证绑定确实在版本里:
SELECT n_pairs FROM dataset_registry {SNAPSHOT='pref_v1'} WHERE dataset_version = 'pref_v1';
--   实测 18170
SELECT rm_version, pref_snapshot FROM reward_model_registry {SNAPSHOT='pref_v1'};
--   实测 rm_v1 / pref_v1
SELECT COUNT(*) AS v1_pairs FROM preference_pairs {SNAPSHOT='pref_v1'};
--   实测 18170
于是整条血缘链闭合了:
rm_v1
  ├── pref_version  = pref_v1
  ├── pref_snapshot = pref_v1          ← 18,170 个 pair,可逐位复现
  ├── curate_rule   = agree>=0.6, 去环, 去退化…
  ├── base_model    = policy_v3-base
  └── code_commit   = 9c41ab
而原始投票(63,000 条)也一并冻在同一个快照里——这意味着换一套推导规则重算,随时可以:把一致率门槛提到 0.8 再推一遍,和 pref_v1 DIFF 一下,就知道这个决策会改变多少个 pair。
行业里的其他做法,各自卡在哪
偏好数据的管理,业内常见这么几种:
做法一:标注平台导出一份文件,训练脚本直接读。 最常见。标注平台(Label Studio、Argilla、或自研)负责收集,再导出给下游——具体形态取决于平台和配置:Label Studio 支持导出 JSON / JSON-MIN / CSV 等多种格式(也能导出原始 annotations),Argilla 的常见路径是导出成 HuggingFace 数据集。下面统一用一份 pref_v1.jsonl 代指。问题不在格式,而在导出这个动作本身就是断链:一致率、谁投的票、后来谁改判过,都留在平台里;数据集这边只剩最终的 (chosen, rejected),想换推导规则得回平台重导,想查偏好环得另写脚本把文件读回来。
做法二:把原始投票留在标注平台,只把成品进仓库。 比做法一好,至少投票没丢。但投票和成品分处两个系统,版本对不齐——你没法说清"pref_v1 是从哪一时刻的投票算出来的",因为平台里的标注还在继续增加和修改。
做法三:HuggingFace Datasets + Hub 管版本。 数据集有 revision(Hub 上每个仓库就是一个 git 仓库),生态好用。但在这条工作流里,可回溯的粒度是数据集的 revision:能告诉你 v2 不是 v1,要说清"这 630 个 pair 因为构成偏好环被删了",得你自己在脚本里另外记;推导规则、审计查询也依然在外部脚本里。
做法四:数仓(Spark / BigQuery)里做推导和审计。 用 SQL 做聚合投票、查环、算长度偏置——这条路和本文完全一致,也是大团队的常见选择。差别还是在版本语义:留住每一版靠新表或表版本,行级的分支 / DIFF / 冲突合并不是这类系统的原生语义,而"多个评审并行改判、重叠部分要留痕"这件事,用表版本很难表达。
放进一张表里。先说清这张表的范围:它比较的是上面列出的这几种典型工作流的默认路径,不是对相关产品全部能力的评价——各家的能力边界以官方文档为准(见文末参考资料),标「否」的格子多数能靠额外工程补上,代价是你得自己拼装和维护。
| 做法 | 原始投票与成品同版本 | 行级审计记录 | 并行裁决与冲突 | 关系型审计(环 / 退化对) | 换推导规则重算 |
|---|---|---|---|---|---|
| 平台导出 JSONL | 否(断链) | 否 | 平台内,外部不可见 | 另写脚本 | 要回平台重导 |
| 投票留平台 + 成品进仓 | 否(跨系统) | 否 | 平台内 | 半(成品侧可查) | 版本对不齐 |
| HF Datasets + Hub | 否 | 否(数据集级) | 否 | 外部脚本 | 重新上传 |
| 数仓 SQL | 是(同库) | 否(表版本级) | 无行级冲突语义 | SQL ✅ | 是 |
| MatrixOne(Git4Data 能力) | 是(同一个库级快照) | 是(DATA BRANCH DIFF) | 分支 + MERGE 显式冲突策略 / PICK | SQL ✅ | 是(投票也在快照里) |
一句话:偏好数据同时需要关系型查询(查环、查退化对、算偏置)、行级版本语义(谁改判了哪些行)和冲突语义(两个评审判得不一样)。就本文列出的这几条路径而言,前两者数仓能给一半,第三者要么留在标注平台里、外部看不到,要么得自己拼装——而在 MatrixOne 上,它们恰好是同一张表上的同一件事。
边界与适用范围
-
一致率不等于质量。 一致率高只说明标注员们看法一致,不代表他们判对了;系统性的偏见(比如都偏爱长回答)会以很高的一致率通过。所以一致率门槛和偏置审计必须同时做,缺一个都会漏。
-
偏好环不总是噪声。 有些环反映的是候选之间真的没有全序关系(各有各的好)。整环丢弃是最省事的处理,但如果这类样本占比很高,说明该重新设计标注标准,而不是一直删。
-
长度偏置不要靠删数据来"修"。 直接砍掉"chosen 更长"的样本会连真实信号一起砍掉。审计的价值是让它被看见,具体怎么去偏是建模侧的决策。
-
Git4Data 这套能力不做语义判断。 谁的回答更好、门槛卡多少、环怎么处理,都是你的决策。它保证的是:投票和成品在同一个版本里、每次改判有据可查、冲突按显式策略处理、任何历史版本可复现。
-
冲突清单要自己物化。
WHEN CONFLICT SKIP处理冲突,但不返回被跳过的行。要留痕,就在合并之前把两条分支都改过的那批行查出来存成一张表。 -
检查的先后顺序是规则的一部分。 退化对、无共识、偏好环三步换个顺序,数出来的环就不是同一个数(本文实测 630 vs 1050)。顺序要和门槛一起写进注册表。
-
原始投票要长期保留。 它是这份数据的源代码。删了它,你就永远失去了换规则重算的能力。
参考资料
- OpenAI, Aligning language models to follow instructions(InstructGPT) —— RLHF 的「示范 → 人类比较 → 奖励模型 → PPO」链路
- Rafailov et al., Direct Preference Optimization: Your Language Model is Secretly a Reward Model —— DPO:不训练奖励模型,直接从偏好对优化策略
- Singhal et al., A Long Way to Go: Investigating Length Correlations in RLHF —— 偏好数据长度偏置对奖励模型的影响
- Label Studio, 导出标注结果(JSON / JSON-MIN / CSV 等)
- Argilla, Quickstart(导入 / 标注 / 导出到 Hub)
- HuggingFace, Repositories getting started(revision / commit 语义)
- Apache Spark, Spark SQL Programming Guide | Google Cloud, BigQuery 介绍
结语
偏好数据是整个大模型训练链路里最依赖主观判断的一环:它不是采集来的事实,而是从一堆人类判断里推导出来的结论;它的最小单位不是一行,而是一对;它坏掉的方式也不是缺字段,而是逻辑上自相矛盾(偏好环)或系统性地偏向某个捷径特征(长度偏置)。
也正因如此,它特别需要「可查、可裁、可复现」:21,000 个 pair 里 630 个卷在偏好环里、2,000 个根本没达成共识、75.9% 的 chosen 比 rejected 长——这三个数字都是一条 SQL 的事,而且都应该在训练开始之前就被看到。两位评审并行改判的 985 和 657 条,重叠部分在合并之前先被查出来记成清单,再按 SKIP 策略统一处理,而不是被悄悄覆盖。最后 rm_v1 和 pref_v1 绑在同一个快照里,连 63,000 条原始投票一起冻住——换个推导规则重算,随时可以。
📎 可运行 SQL(固定 commit
354b9cf):github.com/matrixorigin/git4data-tutorial | 源码与社区:github.com/matrixorigin/matrixone
 1210


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


