目标检测(二):OverFeat

目标检测:从overfeat到Fast R-CNN 以下内容摘自斯坦福cs231n目标检测课程: 计算机视觉任务: ImageNet 分类和定位任务: Idea #1:定位问题视为回归问题 实现步骤: 1. 训练(或下载)一个分类模型(AlexNet, VGG, Inception) 2. 添加新的全连接层用作“回归” 3. 仅训练“回归”模块,SGD,L2 Loss 4. 测试时加入“分类”和“回归” 回归分为两种: 独立于类别的回归: Class agnostic (4 numbers / per box 阅读详情

说实话这篇论文1看得有点头大,很多过程理解得不够透彻,论文里的插图也并没有看懂,只能结合其他资料大概了解了一下。
本篇论文中作者主要使用了一个共享的CNN来同时解决视觉任务中的分类、定位和检测三个问题。

1 分类

论文使用的CNN网络分为极速版和精准版两个版本,其中极速版的结构如下图所示。整个CNN可以看作一个全卷积网络,并可以作为两个部分看待:前五层为一个特征提取器,得到图像特征;后面的全连接层(实质也为卷积层)为分类层。
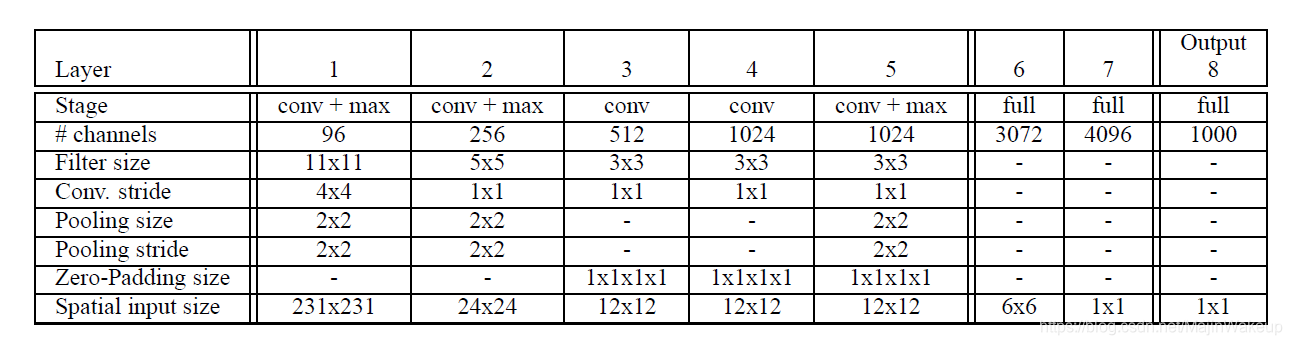
极速版结构
其具体的分类步骤为(以下为个人理解):

1.1 多尺度处理

对图像进行缩放,得到6个不同scale的图像,并对其进行翻转,得到6 * 2个输入。(AlexNet是裁剪四个角落和中间区域,并对图像做翻转得到5 * 2个输入图像,然后送进网络里面得到10个结果求平均来进行预测。这样的做法有两个问题,裁剪时可能忽略了图像的一些区域,以及10张图像有很多重叠部分导致了冗余计算。)6个scale如下表所示:
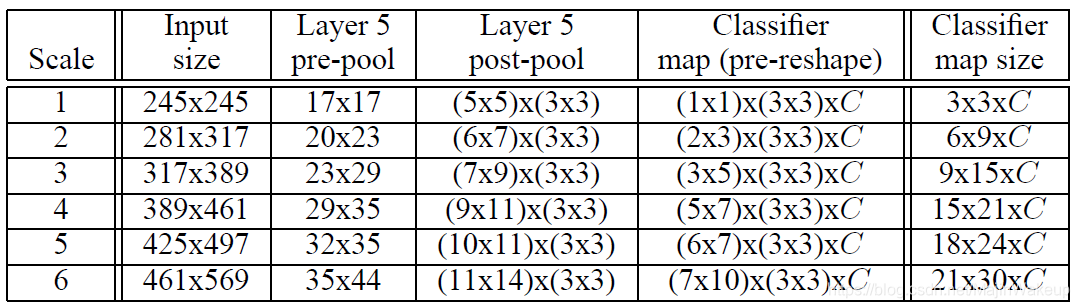
6个scale

1.2 特征提取

对于上述的每一个尺度的图像,将其输入至CNN中,经过前5层卷积层后可以得到带有空间信息的特征张量。在此作者主要提出了一种offset池化方法,用于Layer5特征的池化处理(也就是上表中的从Layer5 pre-pool到post-pool的过程)。接下来对其进行详细介绍。
结合上面的表进行理解,这里我们用scale2来进行举例。offset池化输入的空间大小为20 * 23(对应于Layer5 pre-pool),为了方便理解,这里先用一个维度进行解释,即其短边20。处理过程如下图所示:
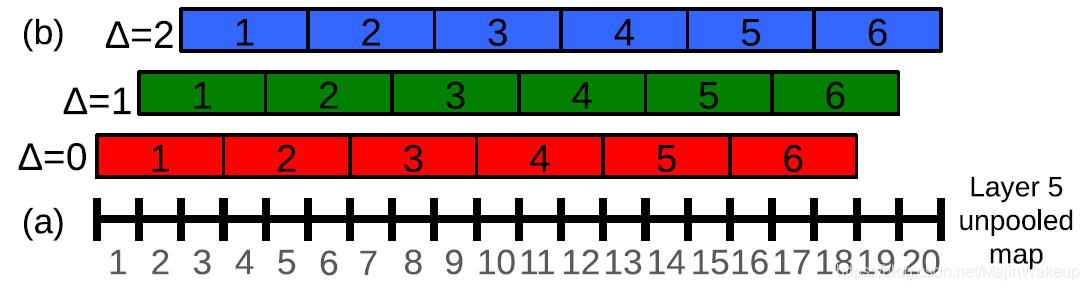
offset池化
图中(a)是一维的输入,长度为20个单位。max-pooling核大小为3,且不重叠,这样正常情况下得到的是6个单位的输出(对应b中的 Δ = 0 \Delta=0 Δ=0的情况)。但是作者在此将核的初始位置进行了调整,分别向后调整一个单位( Δ = 1 \Delta=1 Δ=1)和两个单位( Δ = 2 \Delta=2 Δ=2),这样pooling后的输出就变为6 * 3了,其中3代表pooling核的3种初始位置。
拓展到二维空间中,核的初始位置有了3 * 3种情况,这样20 * 23的输入对应的输出也就变为了(6 * 7) * (3 * 3),对应于上表的Layer5 post-pool。

1.3 分类

上面说到特征提取最终得到的特征图大小为(6 * 7) * (3 * 3)。之后还需将此特征图作为输入提交给分类器(第一张图的6-8层)。
在此首先单独考虑一个6 * 7的输入,分类器的卷积核大小为5 * 5,通过卷积核在空间上步长为1的滑动过程,得到输出的大小为2 * 3。故最终分类的输出为(2 * 3)*(3 * 3) * C,其中C是类别总数,这一结果对应于上表中的Classifier map(Pre-reshape)。最后进行reshape得到三维输出6 * 9 * C,对应于上表中Classifier map size。
三维输出6 * 9 * C会进行最大化处理(相当于全局max-pooling),得到一个长度为C的预测结果。注意这只是一个scale的分类结果,还需对总共12个结果求均值得到最终的预测结果。

之前的一些方法是在原始图像上滑动窗口,将所有窗口部分图像输入到CNN进行处理。虽然OverFeat免去了这一步骤,只需输入一次图像,但是工作量都转移到了offset池化这一操作上,这一步骤也使需要处理的数据量大大增加,整个流程还是比较繁琐的,况且还需要输入12个不同scale的图像进行处理。
下图是其分类效果,其中coarse stride表示 Δ = 0 \Delta=0 Δ=0,fine stride表示 Δ = 0 , 1 , 2 \Delta=0,1,2 Δ=0,1,2。个人感觉offset处理效果并不是很明显,反而是accurate model提升效果比较显著,还有多个模型融合也帮助了大量提升。
分类效果

2 定位

定位任务只需将之前的分类层改为回归网络即可,1-5层不用改动。

2.1 边界框预测

同样以scale2的Layer5池化后的特征为例,通过回归预测边界框的过程如下图所示。输入大小为(6 * 7) * (3 * 3),卷积核大小依然为5 * 5,最终的输出为(2 * 3) * (3 * 3),channel数目为4,代表边界框的位置信息。这还只是一个scale下生成的边界框预测,一幅图像最终会预测出(2 * 3) * (3 * 3) * (6 * 2)个边界框。
回归过程
这里有一个问题:是对每个类别分别训练一个边界框回归器还是对所有类别训练一个统一的边界框回归器?作者在文中进行了讨论,发现只使用一个统一的回归器效果更好。推测原因是某些类别样本太少,导致这些类别的错误率偏高,后续可以对相似类别训练一个回归器来提升效果(如各种狗类训练一个回归器,各种猫类训练一个回归器)。

2.2 预测边界框的组合

得到这么多预测的边界框后,自然需要对其进行过滤,不同于经常使用的NMS操作,作者在这里使用了一种独特的方法Combining Predictions,借用别人的描述2,其步骤如下:

  1. 首先对于每个scale计算出前k个类别,对每个类别计算出所有的bouding box。
  2. 然后合并所有scale的bounding box得到集合B,重复以下步骤
    1. ( b 1 ∗ , b 2 ∗ ) = a r g m i n b 1 ≠ b 2 ∈ B m a t c h _ s c o r e ( b 1 , b 2 ) (b^*_1,b^∗_2)=argmin_{b_1\ne b_2\in B}match\_score(b_1,b_2) (b1∗​,b2∗​)=argminb1​̸​=b2​∈B​match_score(b1​,b2​)
    2. 假如 m a t c h _ s c o r e ( b 1 , b 2 ) > t match\_score(b_1,b_2)>t match_score(b1​,b2​)>t,则停止
    3. 否则, B ← B B←B B←B\ { b 1 ∗ , b 2 ∗ } ∪ b o x _ m e r g e ( b 1 ∗ , b 2 ∗ ) \{b^*_1,b^∗_2\}∪box\_merge(b^*_1,b^∗_2) {b1∗​,b2∗​}∪box_merge(b1∗​,b2∗​)

其中 m a t c h _ s c o r e ( b 1 , b 2 ) match\_score(b_1,b_2) match_score(b1​,b2​)计算的是两个边界框中点的距离和交集区域的面积之和,当它大于某个阈值时算法停止; b o x _ m e r g e ( b 1 ∗ , b 2 ∗ ) box\_merge(b^∗_1,b^∗_2) box_merge(b1∗​,b2∗​)计算的是两个边界框坐标的平均值。
这是通过合并具有高置信度的边界框来得到最终预测。这种方法可以淘汰那些低置信度以及低连续(多个边界框相差很远)的类别,会更加鲁棒。

3 检测

检测这部分作者并没有做细致的介绍,只提到以下两点:

  1. 检测的训练和分类的训练差不多,只是以一种spatial的方式,一张图像的多个位置被同时训练。
  2. 和定位任务相比,最主要的是在一个图像中没有物体时,需要加入一个背景类别。

其实检测的目的也就是对物体进行定位和分类,所以上面两个部分的介绍基本可以沿用至此。


  1. Sermanet P, Eigen D, Zhang X, et al. OverFeat: Integrated Recognition, Localization and Detection using Convolutional Networks[J]. arXiv: Computer Vision and Pattern Recognition, 2013. ↩︎

  2. 论文笔记:OverFeat ↩︎

OverFeat论文笔记 论文全名:《OverFeat:Integrated Recognition, Localization and Detection using Convolutional Networks》 论文链接:https://arxiv.org/abs/1312.6229v4 参考博客: hjimce大神博客:https://blog.youkuaiyun.com/hjimce/article/details/... 阅读详情

相关推荐

可微编程:当深度学习遇见物理定律,重塑科学计算新范式

本文探讨了可微编程如何将深度学习与物理定律相结合,重塑科学计算范式。通过自动微分技术,它将物理方程融入可微计算图,使模型在数据驱动的同时遵守物理约束。文章以神经常微分方程为例,阐述了其在连续系统建模、科学模拟器优化等领域的应用,并分析了当前面临的挑战与最佳实践路径。

weixin_29056145的博客 134

【目标检测】目标检测算法-从OverFeat到YOLO

【目标检测】目标检测算法-从OverFeat到YOLO

星辰不问 2213

Ubuntu 24.04 下 NoMachine 极速安装与远程桌面配置全攻略

本文详细介绍了在Ubuntu 24.04系统下安装和配置NoMachine远程桌面的完整指南。从系统准备、分步安装到性能调优和常见问题解决,帮助用户快速实现低延迟的远程桌面访问。特别适合开发者和IT管理员在Linux环境下高效部署远程工作环境。

moon9的博客 945

目标检测——OverFeat算法解读

overfeat算法解读

lishanlu136的博客 2058

【中英双语】Illumina测序原理详解 | 边合成边测序/Sequencing by Synthesis

很多朋友们问我视频讲解时用的笔记可不可以分享,那当然必须是可以呐!但我当时其实没有好好记录,只是打了个草稿就开讲啦!既然大家有需求,俺就重新整理了一下,希望可以帮到大家!

weixin_43843918的博客 7872

ubuntu20.04下dsp-slam的运行配置

DSP-SLAM:具有深度形状先验的面向对象的 SLAM

baidu_38431960的博客 3159

深度学习-目标检测(一)-R-CNN

目标检测的暴力方法是从左到右、从上到下滑动窗口,利用分类识别目标。为了在不同观察距离处检测不同的目标类型,我们使用不同大小和宽高比的窗口。如下图所示: 这样就变成每张子图片输出类别以及位置,变成分类问题。但是滑动窗口需要初始设定一个固定大小的窗口,这就遇到了一个问题,有些物体适应的框不一样,所以需要提前设定K个窗口,每个窗口滑动提取M个,总共K x M 个图片,通常会直接将图像变形转换成固定大小的图像,变形图像块被输入 CNN 分类器中,提取特征后,我们使用一些分类器识别类别和该边界框的另一个线性回归器。这

m0_73426548的博客 3027

SAP 标准 CDS View 到底能不能用 CDS Extension View 扩展,我们在项目里应该这样判断

文章摘要:判断SAP标准CDS视图(如A_PRODUCT)能否扩展字段,不能仅凭命名或@Metadata.allowExtensions判断,需检查DDL源码中的@AbapCatalog.viewEnhancementCategory值。#PROJECTION_LIST允许扩展字段,#NONE则禁止。聚合视图需额外包含#GROUP_BY,UNION视图需#UNION。CDS View Extension用于新增字段,Metadata Extension仅用于添加注解。在ABAP Cloud环境中还需检查AP

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 100

目标检测算法(二)OverFeat精细分析和讲解并附源码地址

本文从多个方向全面系统地介绍了OverFeat这篇论文,包括论文的背景、创新点、实验结果等方面。通过对论文的分析,我们可以发现,OverFeat提出了一种新的物体检测思路,即将物体检测问题转化为对物体的全局特征的提取和分类,从而实现了物体检测和识别的同时进行。同时,OverFeat还提出了一个基于卷积神经网络的端到端的训练框架,以及一些特殊的卷积核设计和正则化策略,从而进一步提高了检测的准确率和召回率。

Snu77的博客 1729

vue支付项目-APP支付宝支付功能

如果用户已安装支付宝客户端,商家 App 唤起支付宝完成支付,支付完后跳回到商家 App 内,最后展示支付结果。如果用户没有安装支付宝客户端,商家 App 内会调起支付宝网页支付收银台,用户登录支付宝账号,支付完后展示支付结果。1.点击按钮开通或者续费,会验证是否选择会员商品以及对协议是否查看选中(这里根据项目需要自行验证,可忽略),验证通过打开选择支付方式弹窗页面,选择微信支付或者支付宝支付;4.可取消支付,放弃支付会返回会员页面,页面提示支付取消;1.判断支付方式,如果是2,则是支付宝支付方式。

总结前端开发中遇到的问题,分享前端知识 1万+

[特殊字符] 从零构建携程/飞猪机票价格爬虫:Python异步抓取与反爬对抗实战

在出行决策、竞品分析、价格预测模型训练等场景中,稳定获取携程(Ctrip)和飞猪(Fliggy)的实时机票价格波动数据是刚需。然而,这两大平台均部署了业界顶尖的反爬体系——包括但不限于:动态请求签名(SignToken设备指纹采集(UACanvasWebGL接口参数加密(X-Sign_abtestcookie混淆)频率限制与 IP 封禁(滑动窗口 + 行为检测)目录前言:为什么需要自建机票价格爬虫?一、技术选型与项目架构1.1 核心技术栈1.2 系统架构图(文字描述)1.3 法律与道德声明。

2201_76125261的博客 338

OverFeat:Integrated Recognition, Localization and Detection using Convolutional Networks

文章目录概主要内容 Sermanet P., Eigen D., Zhang X., Mathieu M., Fergus R., LeCun Y. OverFeat:integrated recognition, localization and detection using convolutional networks. In International Conference on Learning Representations (ICLR), 2014. 概 通常的sliding window

MTandHJ的博客 311

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

OverFeat 详解

(一)计算机视觉任务(二)分类(三)定位(四)检测

Kula的博客 7259

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【youcans动手学模型】目标检测之 OverFeat 模型

本文介绍目标检测之 OverFeat 模型,并给出 PyTorch 实现方法。 OverFeat 是一种基于卷积网络的图像特征提取器和分类器,是ILSVRC2013定位任务的第1名。

youcans的博客 2176

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

OverFeat心得

OverFeat官方:http://cilvr.nyu.edu/doku.php?id=code:start参考博客: http://blog.youkuaiyun.com/hjimce/article/details/50187881 http://blog.youkuaiyun.com/whiteinblue/article/details/43374195 摘要: 本文提出一种整合框架,通过卷积网络来

u013967613的博客 4121

[目标检测]——Overfeat模型

Overfeat模型设计主要为了解决多个物体的检测问题 一、滑动窗口 目标见发

weixin_42067873的博客 705

【计算机视觉CV:目标检测】--2.算法原理(Overfeat、R-CNN)

目标检测算法综述与实现 本文系统介绍了目标检测算法的分类、原理及典型实现。目标检测算法主要分为两类:两步走检测(如R-CNN系列)和端到端检测(如YOLO、SSD)。文章详细阐述了目标检测任务中的分类、定位原理,以及评价指标如IoU和mAP。重点分析了OverFeat和R-CNN两种经典模型:OverFeat采用滑动窗口方法将检测转化为分类问题;R-CNN则通过选择性搜索获取候选区域,结合CNN特征提取和SVM分类实现检测。文章还提供了OverFeat模型的PyTorch实现代码,并总结了R-CNN的优缺点

我是个好人呀,O(∩_∩)O 973

从OverFeat到RCNN:目标检测领域的跨越式进步

各位小伙伴们大家好!在之前的文章中,我们介绍了OverFeat模型👇点击回顾OverFeat模型原理,它是早期将深度学习应用于目标检测的开拓者之一。不过OverFeat存在一些明显局限性:它采用滑动窗口方式在图像上不同位置和尺度进行检测,这种方法类似一种暴力穷举方式,​​计算量大且效率不高​​,由于窗口大小问题,而且难以精确处理​​不同长宽比的物体​​。

qiutesting的博客 1122

Overfeat算法原理介绍

文章定义为一种特征提取器。

yannkaii的博客 1122

Overfeat论文笔记

个人博客:http://www.chenjianqu.com/ 原文链接:http://www.chenjianqu.com/show-67.html 论文《OverFeat: Integrated Recognition, Localization and Detection using Convolutional Networks》. Pierre Sermanet,etc. ...

陈建驱的博客 1119

使用sklearn-theano来做object detection目标检测 (OverFeat)

目前目标检测比较好的两种方法是Fast-RCNN和OverFeat。我更喜欢OverFeat,因为OverFeat完全使用CovNet来做Classification,Localization和detection,比Pip Line的方法好多了,简洁并且减少经验性的东西。最终也方便做到end-end的Training。尝试一下如何使用OverFeat。OverFeat的代码包是sklearn-the

taneijia的专栏 4509

【目标检测算法】R-CNN(详解)

目标检测算法之R-CNN学习目标1. 目标检测-Overfeat模型1.1 滑动窗口1.2 Overfeat模型总结2. 目标检测-R-CNN模型2.1 完整R-CNN结构2.2 候选区域(Region of Interest)得出2.3 CNN网络提取特征2.4 特征向量训练分类器SVM2.5 非最大抑制(NMS)2.6 修正候选区域3. 检测的评价指标3.1 IoU交并比3.2 平均精确率(mean average precision)map4. R-CNN总结4.1 流程总结4.2 缺点5. 总结6.

全网粉丝30W+,优快云、稀土掘金人工智能领域签约作者,人工智能、大模型、Python 爬虫,商务合作,请私信沟通。 1万+

2.3 OverFeat

目录2.3 OverFeat2.3.1 任务与评估指标2.3.2 OverFeat 模型设计2.3.3 多尺度分类2.3.4、OverFeat 视图参考文献 2.3 OverFeat OverFeat 是 ILSVRC2013 中目标定位任务的冠军,它提出了一种集成式框架,将图像分类、目标定位以及目标检测三种任务的学习过程集成到同一个 CNN 模型下。其核心原理是利用多尺度选择以及滑动窗口方式进...

weixin_37179744的博客 532

目标检测系列1——Overfeat

Overfeat1 Overfeat1.1 简介1.2 结构1.3 特点 1 Overfeat 1.1 简介 OverFeat 是早期经典的 One-Stage 目标检测的算法。这篇论文使用了很少的改动,把同一个 CNN 网络用到了三个计算机视觉的任务上(分类,定位,检测)。 论文链接: https://arxiv.org/pdf/1312.6229.pdf 1.2 结构 https://blog.youkuaiyun.com/m0_45962052/article/details/104849869 https:/

xiaotiig的博客 416

【CV 目标检测】R-CNN①——Overfeat

Overfeat方法使用滑动窗口进行目标检测,也就是使用滑动窗口和神经网络来检测目标。滑动窗口使用固定宽度和高度的矩形区域,在图像上“滑动”,并将扫描结果送入到神经网络中进行。这种方法类似一种暴力穷举的方式,会消耗大量的算力,并且由于窗口大小问题可能造成效果不准确。

2401_88868983的博客 256
上一篇: 目标检测(三):YOLO及YOLT
下一篇: 目标检测(四):Fast-RCNN
MajinWakeup
博客等级 码龄7年 2粉丝 9原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值