DeepSeek R1架构与训练流程全解析

DeepSeek R1 使用指南:架构、训练、本地部署 DeepSeek 在最新论文中详细介绍了他们通过强化学习(RL)提升大语言模型(LLM)推理能力的创新方法——DeepSeek-R1。这项研究标志着一个重要的进展,即如何通过纯强化学习提升 LLM 解决复杂问题的能力,而不依赖于大量的监督微调。 阅读详情

1. 快速概览

DeepSeek R1并非从零开始训练,而是基于DeepSeek V3-Base模型通过强化学习(RL)分阶段优化的产物。其核心目标是通过奖励机制引导模型发展出类人的推理能力,而非单纯的语言生成能力。训练流程分为两个关键阶段:

R1-Zero阶段:采用纯RL训练探索推理能力的自然涌现,生成初始版本;

R1正式阶段:引入多阶段训练管道,结合冷启动数据(Cold-Start Data)和结构化RL流程,最终形成兼具高推理性能和可读性的模型。

2. DeepSeek V3(MOE)如何思考?
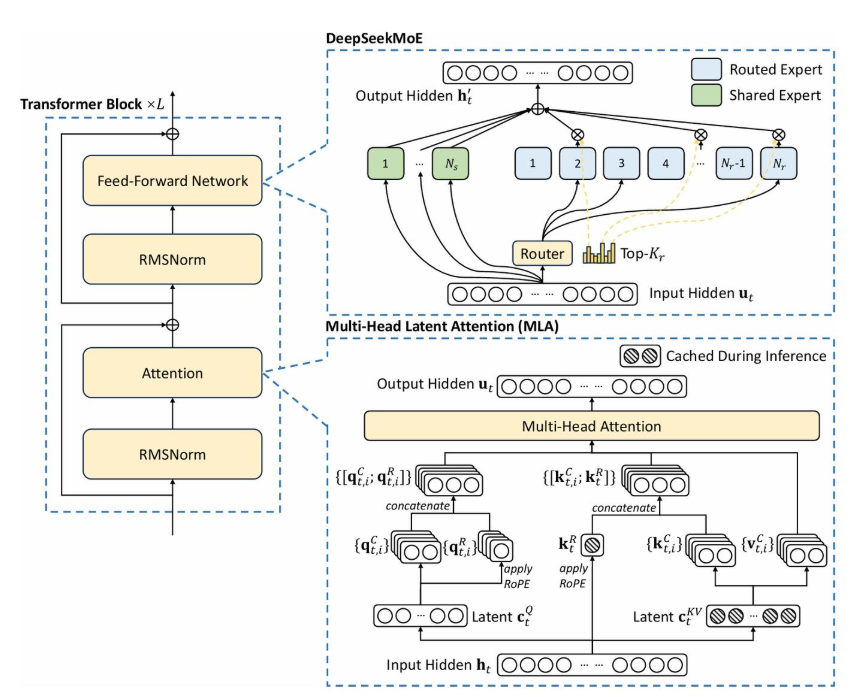
image.png

混合专家架构

DeepSeek V3采用混合专家模型(Mixture-of-Experts, MoE),总参数量达6710亿,但每个输入仅激活370亿参数。其核心由两条路径构成:

快速记忆系统:通过检索相似案例快速构建上下文(类似人类直觉反应);

智能路由决策:根据问题复杂度动态选择处理方式:

快速处理器:处理简单任务(如常识问答),响应时间<100ms;

专家系统:针对复杂问题(如数学证明)激活专业子网络进行深度分析。

动态路由机制

路由模块通过注意力机制计算专家权重,实现"按需激活"。例如处理"解方程√(a+x)=x"时,系统会优先激活数学专家模块,同时调用符号计算子网络生成分步推导。这种架构使V3在保持70B级模型推理成本的同时,达到千亿参数模型的性能。

3. DeepSeek V3作为RL中的策略模型(Actor)

RL交互框架

在RL训练中,V3扮演策略模型(Actor)的角色,其交互流程包含三个核心组件:

环境(Environment):由数学题、编程问题等推理任务构成;

动作(Action):模型生成包含推理过程的答案(如:"解:设x为...,则方程变形为...");

奖励(Reward):基于答案正确性和推理逻辑质量计算,正向奖励可达+2.7,错误推理惩罚可达-1.3。

训练动态示例

以问题"3.11和3.8哪个大?"为例:

初始响应:"3.11更大,因为小数点后第二位1>0"(奖励+0.5)

优化后响应:"比较3.11与3.8需统一小数位:3.8=3.80,故3.11<3.80"(奖励+1.8)

4. GRPO算法如何工作?
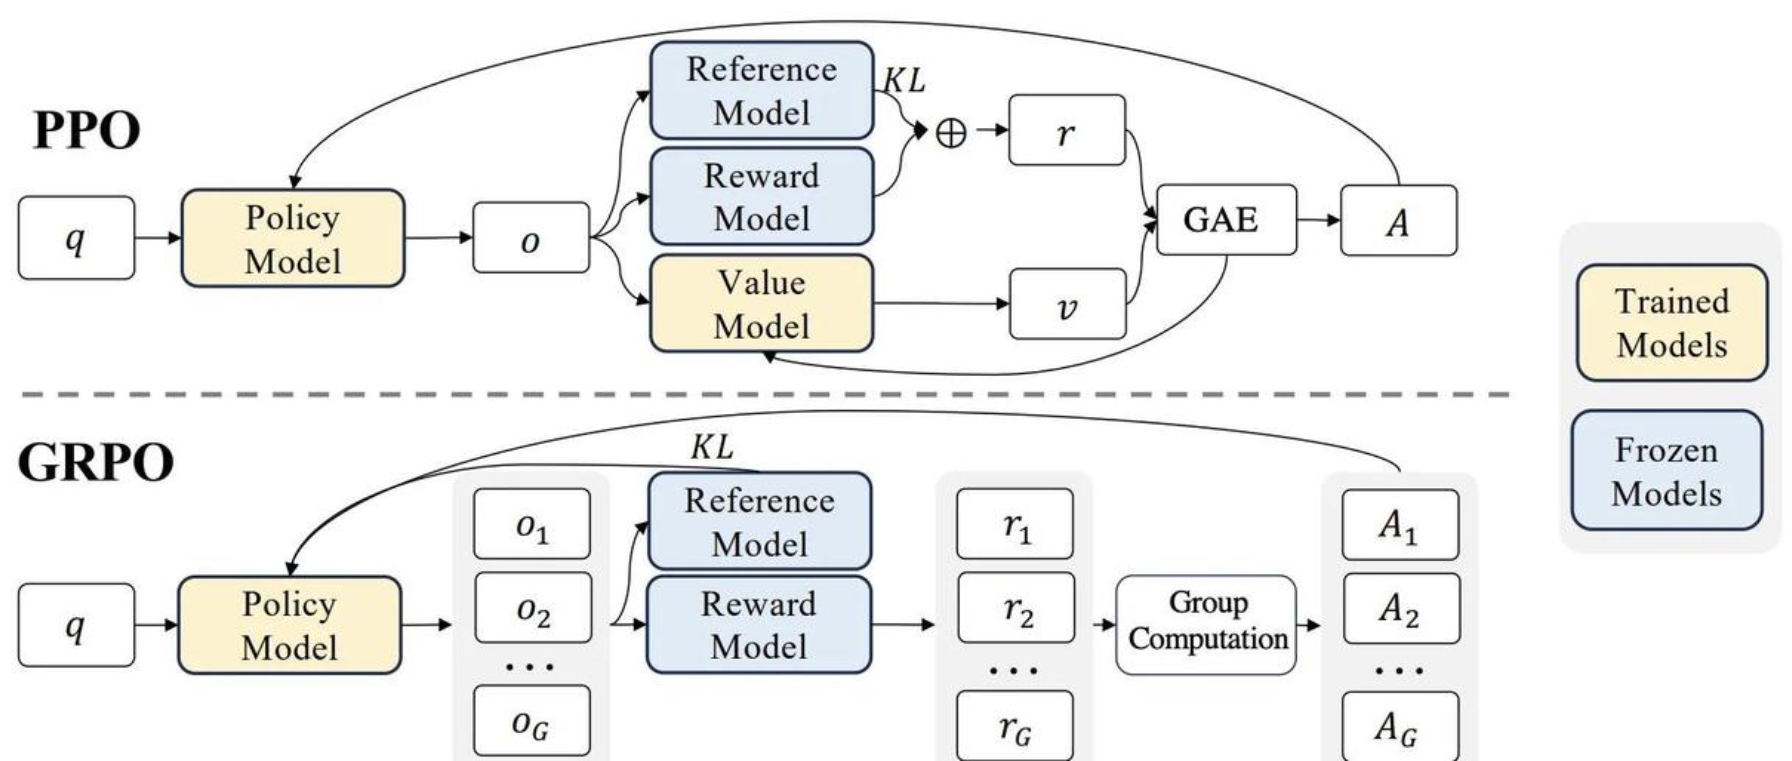
image.png

算法创新

GRPO(Group Relative Policy Optimization)针对传统PPO的缺陷进行改进:

组采样机制:每个问题生成16组响应,通过组内比较计算相对优势值;

去Critic设计:直接利用奖励分布计算基线值,节省40%显存消耗;

稳定训练策略:引入KL散度惩罚项,限制策略更新幅度(β=0.02)。

优势计算

优势值公式:

image.png

其中μG为组内平均奖励,σG为标准差。该设计使模型能识别"相对优质"的推理路径,而非依赖绝对奖励阈值。

5. GRPO目标函数解析

目标函数包含两个关键部分:

1.奖励优化项:

image.png

通过策略概率比限制更新幅度(ε=0.2),防止策略崩溃。

2.稳定性约束项:

image.png

控制新策略与旧策略的偏离程度,实验表明KL值需维持在3.5±0.8区间。

6. DeepSeek R1 Zero的奖励建模规则

三维奖励体系

规则检查(30%):验证数学符号规范性(如"√"正确使用)和公式推导连贯性;

格式奖励(20%):强制响应包含和标签,提升可解析性;

训练奖励(50%):基于问题类型动态调整权重,例如编程题侧重代码正确性(权重0.7),数学题侧重推导完整性(权重0.6)。

奖励模板示例

Python

def calculate_reward(response):    if format_check(response) and logic_validate(response):        return accuracy_score * 0.5 + format_score * 0.2 + length_bonus * 0.3    else:        return -1.0  # 格式错误直接惩罚

7. DeepSeek R1 Zero的RL训练流程

四阶段训练

初始化:加载V3-Base模型,设置初始温度参数τ=1.2;

采样阶段:每个问题生成16组响应,耗时约23秒/问题;

奖励计算:并行评估组内响应,峰值计算吞吐量达152 samples/sec;

策略更新:使用GRPO更新参数,学习率3e-6,batch_size 1024。

性能演进

训练过程中关键指标变化:
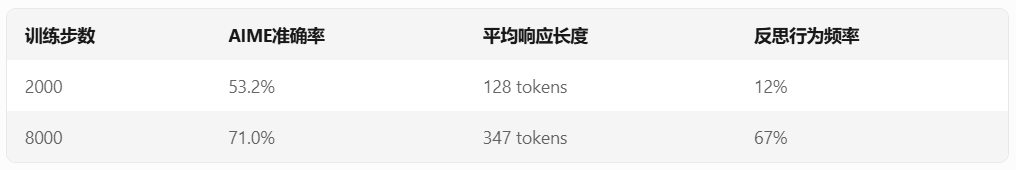
image.png

8. R1 Zero的两个主要问题

可读性缺陷

语言混合:中英文混杂(如"解:Let x=..."),发生概率达38%;

格式混乱:未闭合标签出现频率17%,影响下游解析。

自我进化副作用

过度冗长:后期响应平均长度增长270%,其中有效信息占比仅提升15%;

反思循环:约9%的响应出现"Wait, let me recheck..."类无效反思。

这些问题在后续的R1正式版本中通过冷启动数据(2000条人工标注CoT数据)和监督微调得到显著改善,最终使AIME准确率提升至79.8%,接近OpenAI-o1-1217水平。

学习书籍文档

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)
在这里插入图片描述

学习视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。
在这里插入图片描述

项目实战源码

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。
在这里插入图片描述

大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
图片

DeepSeek-R1 技术路径示意图与训练流程解析 注:完整技术路径示意图可参考提供的训练流程图。该流程通过多阶段迭代,最终使模型在保持通用能力的同时,获得顶尖的数学推理性能。 阅读详情

相关推荐

深度解析 DeepSeek R1:强化学习与知识蒸馏的协同力量

DeepSeek-R1 的问世,无疑在 AI 领域激起了千层浪。自发布仅一周,它便凭借卓越的性能和创新的技术,成为 AI 社区热议的焦点,代表着人工智能在推理和理解能力上的重大飞跃。今天我们一起深度解析一下DeepSeek-R1。

llm_way的博客 2974

DeepSeek-R1 是怎么训练的|深度拆解

昨天晚上,DeepSeek 又开源了 DeepSeek-R1 模型(后简称 R1),再次炸翻了中美互联网:R1 遵循 MIT License,允许用户通过蒸馏技术借助 R1 训练其他模型。R1 上线 API,对用户开放思维链输出R1 在数学、代码、自然语言推理等任务上,性能比肩 OpenAI o1 正式版,小模型则超越 OpenAI o1-mini最离谱的是,价格只有 OpenAI 的几十分之一下面,让我们以更加系统的方式,来看看这次的 R1,是这么炼成的。

2401_85375298的博客 8692

DeepSeek R1 简易指南架构、本地部署和硬件要求

从DeepSeek-R1-Zero到DeepSeek-R1,代表了研究中的一个重要学习历程。DeepSeek-R1-Zero 证明了纯粹的强化学习是可行的,而 DeepSeek-R1 则展示了如何将监督学习与强化学习相结合,从而创建出能力更强、更实用的模型。

wjianwei666的专栏 1346

DeepSeek R1 入门指南:架构、训练、本地部署和硬件要求

DeepSeek-R1 不是一个单一的模型,而是一系列模型,包括:DeepSeek-R1-Zero 和 DeepSeek-R1。主要区别DeepSeek-R1-Zero 代表团队使用纯强化学习而不进行任何监督微调的初步实验。他们从基础模型开始,直接应用强化学习,让模型通过试错过程发展推理能力。虽然这种方法取得了令人印象深刻的结果(在 AIME 2024 上达到 71% 的准确率),但在可读性和语言一致性方面存在一些显著的限制。

xx_nm98的博客 3万+

一文解锁DeepSeek-R1:从入门到实战

DeepSeek-R1 作为一款创新性的大模型,以其独特的强化学习训练方式、出色的推理能力和广泛的应用场景,在人工智能领域展现出了巨大的潜力。它不仅在数学、代码和自然语言推理等复杂任务上表现卓越,媲美甚至超越了一些行业领先模型,还通过开源和低成本策略,降低了 AI 技术的应用门槛,推动了 AI 技术的普及和发展。在安装和使用方面,虽然对硬件有一定要求,但通过 Ollama 和 Chatbox AI 等工具,用户能够相对便捷地完成安装并进行交互。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 3741

【人工智能】DeepSeek R1架构与训练流程全解析

正如《Nature》评审所指出的,DeepSeek R1的价值不仅在于技术突破,更在于其践行的开放、透明、可验证的科学精神,为人工智能的可持续发展树立了新标杆。

奶爸的编程之路,也就一周冷个三天 205

用PyTorch从零构建 DeepSeek R1:模型架构和分步训练详解

本文深入剖析了 DeepSeek R1 模型的构建过程,从基础模型选型到多阶段训练流程,再到关键技术如强化学习、拒绝采样和知识蒸馏的应用,进行了详尽的阐述。通过对 GRPO 算法、Prompt 模板、奖励函数以及 SFT 训练等核心环节的逐步解析,我们不仅了解了 DeepSeek R1 如何从零开始构建,更对其在推理能力、语言一致性以及安全助人等方面所做的努力有了更深刻的认识。希望本文能够帮助读者更好地理解 DeepSeek R1 的技术原理,并为相关研究和实践提供有益的参考。作者:FareedKhan。

deephub 1万+

DeepSeek-R1 的构建过程:架构与训练解析

DeepSeek-R1 的架构利用 MoE 框架,多个专家网络处理输入的不同部分,每个查询仅激活一部分专家。这一策略使模型能够在不需要大规模人工标注的情况下,提高其逻辑一致性和适应能力。DeepSeek-R1 的训练方法不同于传统的监督学习,而是专注于。DeepSeek-R1 与行业领先的 AI 模型进行评估。训练数据分布在多个 GPU 上,允许参数的同步更新。的深入理解,以及它在 AI 领域中脱颖而出的原因。架构,允许动态分配计算资源给不同的专业组件。多个专门的网络,针对不同的知识领域进行训练。

calvin189s的博客 1750

从零构建 DeepSeek R1:训练、公式与可视化全解析

随后,在正式的 DeepSeek-R1 训练中,他们对流程进行了更系统的设计,分阶段进行训练:先提供一部分初始数据,再进行 RL 训练,然后引入更多数据,再进行 RL……GRPO 的目标函数有两个核心目标,一是让模型生成高质量的输出(即获得高奖励),二是确保训练过程稳定,不会出现不受控的情况。该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

m0_48891301的博客 1936

【Telephony】APN配置及加载流程&项目实践(AOSP)

学习APN关键是学会明白apns-conf.xml文件各个参数的意思,然后熟悉TelephonyProvider是如何读取文件创建数据库的,譬如数据库表的约束、文件的读写顺序等,还有读取后的ApnSetting的二次定制以及显示(例如屏蔽xcap等)。虽然一般在项目中APN的需求很简单,就是按照客户提供的APN参数添加上配置,或者在显示屏蔽一些参数,但是项目维护的过程中APN的问题也是比较多的。

weixin_44513784的博客 5509

基于51单片机的电压表【0-20V,ADC0832,4051,自动量程】(仿真)

自动换挡式数字电压表就是一个基于单片机的能自动切换量程的数字电压表,其作用是在使用低位的AD转换实现高精度电压测量,可以测量0~20V的电压,并且具有0~0.2V(待测电玉低于0.2V时),0~2V(待测电压低于2V时)和0~20V三个量程自动匹配测量,当待测电压值发生变化时,电压表可以根据输入电压情况自动选择合适的量程进行测量,并且把测量结果显示出来。(2)实现电压表精度测试,最高精度要求0.01V;(1)实现0~20V分3档式电压表;

qq_63964231的博客 1497

DeepSeek-V3与DeepSeek-R1全面解析:从架构原理到实战应用

DeepSeek-R1是深度求索公司推出的高性能推理专用模型,代表了当前开源推理模型的顶尖水平。作为DeepSeek-R1的基础,DeepSeek-V3同样采用MoE架构,但在设计定位上更偏向通用语言任务。DeepSeek-V3和R1代表了当前开源大语言模型的顶尖水平,其创新架构和高效训练方法为AI社区提供了宝贵资源。

来了波,兄嘚 3631

生信物种注释软件Kraken2+Bracken的安装与使用

一、软件安装与数据库下载 1.Kraken2安装 Kraken2是一个基于k-mer算法的高精度宏基因组序列分类软件,能够快速的将测序reads进行物种分类。 使用conda一键安装,要先安装好anaconda或者miniconda conda install -y kraken2 输入krakek2 --help 出现如下所示帮助文档,则表示安装成功。 2.Bracken安装 bracken是一种从宏基因组数据中高度准确的计算物种丰度的统计方法。 同样使用conda一键安装 conda install -

jileiqwd的博客 1万+

DeepSeek R1 简易指南:架构、本地部署和硬件要求

DeepSeek 团队近期发布的DeepSeek-R1技术论文展示了其在增强大语言模型推理能力方面的创新实践。该研究突破性地采用强化学习(Reinforcement Learning)作为核心训练范式,在不依赖大规模监督微调的前提下显著提升了模型的复杂问题求解能力。技术架构深度解析模型体系:DeepSeek-R1系列包含两大核心成员:DeepSeek-R1-Zero参数规模:6710亿(MoE架构...

粉丝们务必加入微信粉丝群 1万+

YOLO 系列专栏(二十九)YOLO26 × StarNet 轻量化涨点方案(CVPR 2024)轻量化、主干改进篇 | 星星卷积虽小,却蕴藏着巨大的高效潜力

StarNet 出自 CVPR 2024 轻量化主干网络工作,核心创新是,依靠逐元素乘法实现高阶特征融合,在几乎不增加参数量与 FLOPs 的前提下,大幅提升特征表达能力,天然适合等多任务统一建模。本文将 StarNet 完整替换 YOLO26 原有主干,保留 YOLO26 无 NMS 检测头与轻量化结构,实现,并提供。

qq_36130719的博客 410

Serial RapidIO Gen2 IP 说明(三)

前言 继续接着上篇文章,介绍Serial RapidIO Gen2 IP 的具体端口信息。 一、端口描述 1、缓冲设计接口 2、物理层接口 参考说明 【1】Serial RapidIO Gen2 v4.1https://china.xilinx.com/content/dam/xilinx/support/documentation/ip_documentation/srio_gen2/v4_1/pg007_srio_gen2.pdf ...

记录所学,分享知识,结识挚友 1321

DeepSeek-R1 模型全方位技术解析:从架构到落地的完整指南

DeepSeek-R1 通过创新的 MoE 架构、GRPO 强化学习和高效蒸馏技术,为大模型推理能力提升提供了新范式。其 "无 SFT 直接 RL" 的探索证明了强化学习在推理任务上的巨大潜力,而蒸馏技术则让强推理能力走向普及。

xN的博客 1874

手把手教你学Simulink——基于Simulink的无感FOC(滑模观测器+PLL)实战

摘要: 本文详细介绍了基于Simulink的无感FOC(滑模观测器+PLL)实现方法。主要内容包括:1)SMO+PLL原理,通过滑模观测器估算反电动势,结合PLL抑制抖振;2)系统架构,替代编码器信号;3)Simulink建模流程,涵盖Clarke变换、SMO离散化实现、PLL设计等关键步骤;4)参数整定指南和工程实践要点,如启动策略和故障处理。该方法具有成本低、可靠性高的优势,适用于家电、电动车等场景,仿真结果显示角度误差±5°,速度动态跟随良好。文章还提供了调试建议和常见问题解决方案。

MHD0815的博客 136

DeepSeek-R1训练深度解析:内部机制与步骤全揭秘

昨天晚上,DeepSeek 又开源了 DeepSeek-R1 模型(后简称 R1),再次炸翻了中美互联网:R1 遵循 MIT License,允许用户通过蒸馏技术借助 R1 训练其他模型。R1 上线 API,对用户开放思维链输出R1 在数学、代码、自然语言推理等任务上,性能比肩 OpenAI o1 正式版,小模型则超越 OpenAI o1-mini最离谱的是,价格只有 OpenAI 的几十分之一下面,让我们以更加系统的方式,来看看这次的 R1,是这么炼成的。

2401_84204413的博客 1034

Windows 上安装 OpenCode 完全指南:从零到成功,人人能看懂!

跟着这篇教程,你应该已经成功在 Windows 上安装并运行了 OpenCode。步骤操作要点1安装 Chocolatey必须以管理员身份运行 PowerShell2安装 OpenCode3验证安装关闭并重新打开终端,输入4进入项目目录必须是 Git 仓库(git init5配置模型输入/connect,输入 API Key6开始使用输入问题测试最后的小建议如果没有 API Key,可以从 DeepSeek 或 Kimi 开始,有免费额度初次使用建议先在简单项目上测试。

专注于编程、AI、人工智能等多个领域内容研究和分析 3889

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

上一篇: 深度解析:大模型AI工具的技术演进与产业实践
下一篇: RAG技术深度解析:2024年架构演进与实战经验沉淀
AI小模型
博客等级 码龄6年 6863粉丝 487原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

AI小模型

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值