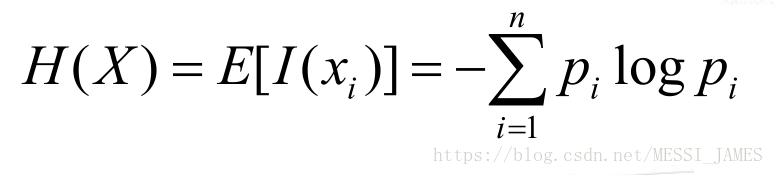决策树

决策树模型及案例(Python) 目录 1 决策树模型简介 2 Gini系数(CART决策树) 3信息熵、信息增益 4决策树模型代码实现 4.1分类决策树模型(DecisionTreeClassifier) 4.2回归决策树模型(DecisionTreeRegressor) 5案例:员工离职预测模型 5.1模型搭建 5.1.1数据读取与预处理 5.1.2提取特征变量和目标变量 5.1.3划分训练集与测试集 5.1.4模型搭建及训练 5.1.5代码汇总 5.2模型预测及评估 5.2.1直... 阅读详情

一.概念

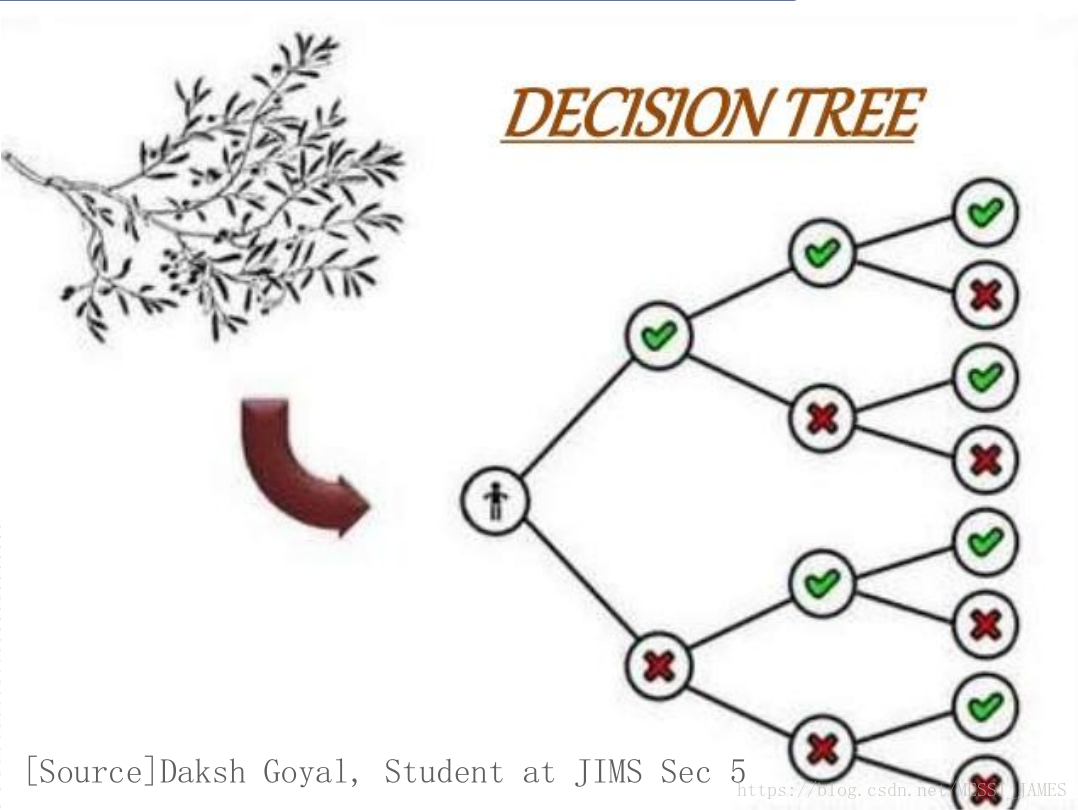
决策树是一种树形结构,其中每个内部节点表示一个属性上的判断,每个分支代表一个判断结果的输出,最后每个叶节点代表一种分类结果,本质是一颗由多个判断节点组成的树
这里写图片描述

二.划分依据

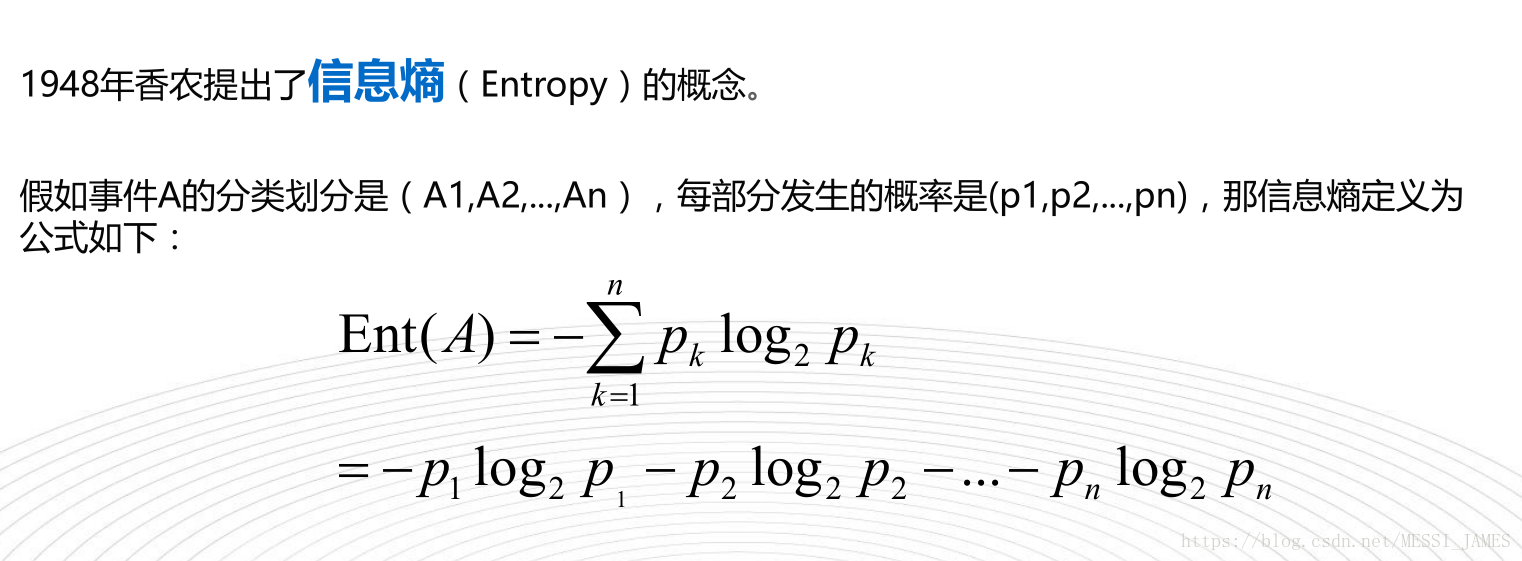
1.熵

这里写图片描述

(1)当系统的有序状态一致时,数据越集中的地方熵值越小,数据越分散的地方熵值越大。这是从信息的完整性上进行的描述。
(2)当数据量一致时,系统越有序,熵值越低;系统越混乱或者分散,熵值越高。这是从信息的有序性上进行的描述。
这里写图片描述

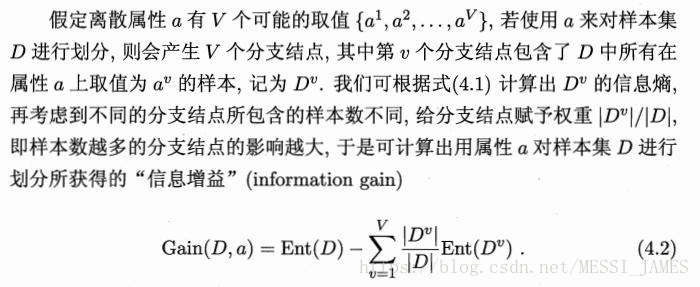
2.信息增益及增益率

信息增益值的大小是相对于训练集而言的

以某特征划分数据集前后的熵的差值。熵可以表示样本集合的不确定性,熵越大,样本的不确定性就越大。因此可以
使用划分前后集合熵的差值来衡量使用当前特征对于样本集合D划分效果的好坏。
信息增益 = entroy( 前) - entroy( 后)
这里写图片描述

信息增益=总体熵-样本熵x权重

3.基尼值和基尼指数

1.基尼值Gini(D)
从数据集D中随机抽取两个样本,起类别标记不一致的概率,Gini(D)值越小,数据集D的纯度越高。
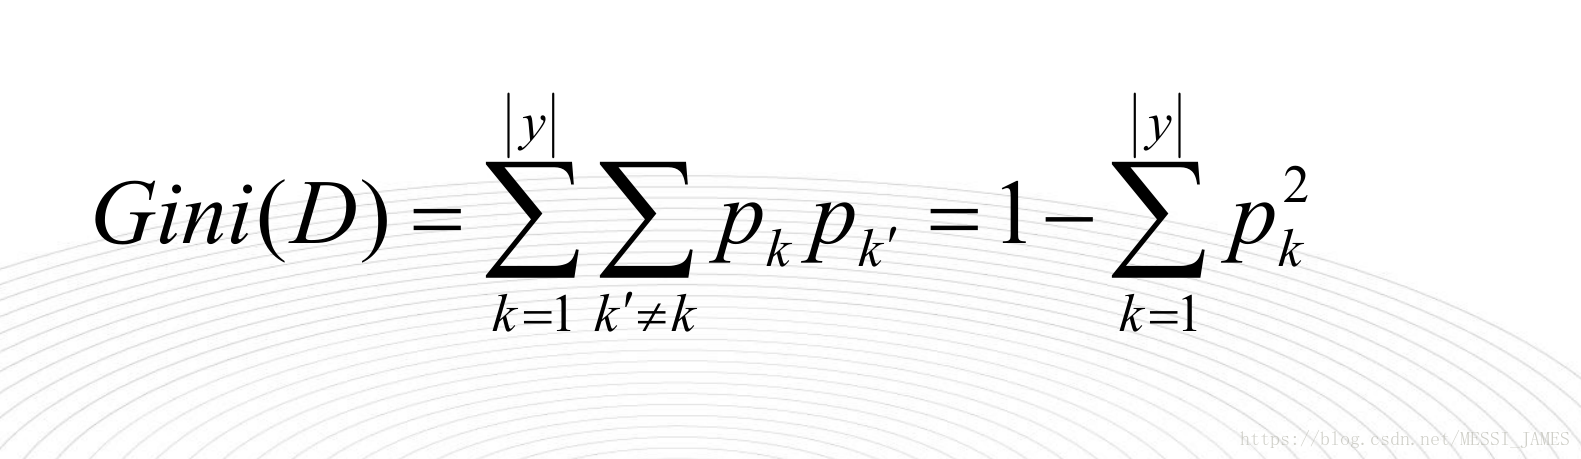
这里写图片描述
2.基尼指数Gini_index(D)
一般,选择使划分后基尼系数最小的属性作为最优化分属性
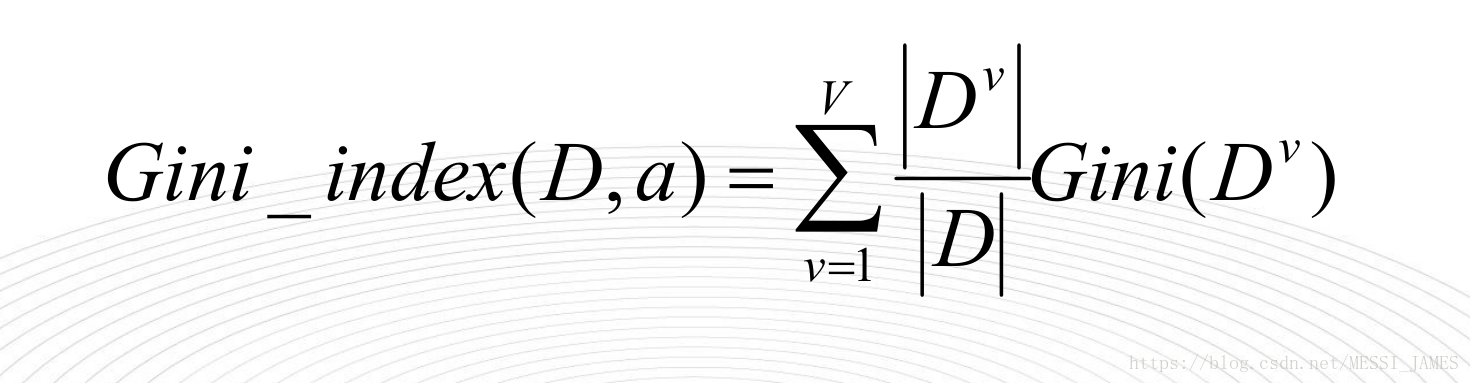
这里写图片描述

4.信息增益比

信息增益是划分训练数据集的特征,经验熵大时,信息增益会偏大,反之偏小。而信息增益比可以解决这一问题。
这里写图片描述`

三.决策树的生成算法

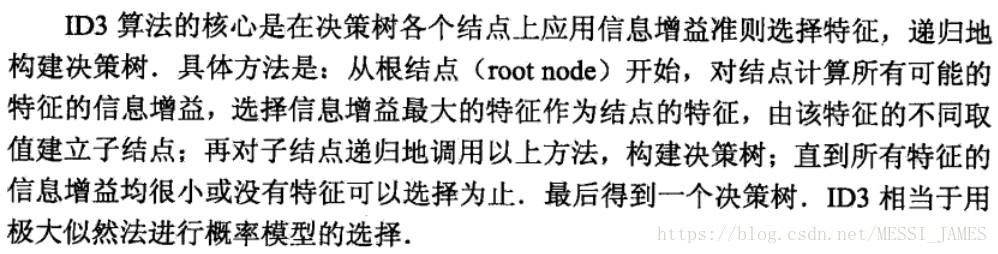
1.ID3算法

这里写图片描述
ID3算法只有树的生成。所以该算法容易产生过拟合。

2.C4.5算法

这里写图片描述

信息增益(Info Gain)用于ID3,Gini用于CART,信息增益率(Info Gain Ratio)用于C4.5。

四.基本流程

1.决策树构建的基本步骤:

1). 开始讲所有记录看作一个节点
2.) 遍历每个变量的每一种分割方式,找到最好的分割点
3.) 分割成两个节点N1和N2
4.) 对N1和N2分别继续执行2-3步,直到每个节点足够“纯”为止。

2.决策树的变量可以有两种

1) 数字型(Numeric):变量类型是整数或浮点数,如前面例子中的“年收入”。用“>=”,“>”,“<”或“<=”作为分割条件(排序后,利用已有的分割情况,可以优化分割算法的时间复杂度)。
2) 名称型(Nominal):类似编程语言中的枚举类型,变量只能重有限的选项中选取,比如前面例子中
的“婚姻情况”,只能是“单身”,“已婚”或“离婚”,使用“=”来分割。

3.如何评估分割点的好坏?

如果一个分割点可以将当前的所有节点分为两类,使得每一类都很“纯”,也就是同一类的记录较多,那
么就是一个好分割点。

四.常见决策树类型及剪枝

1.常见决策树类型比较
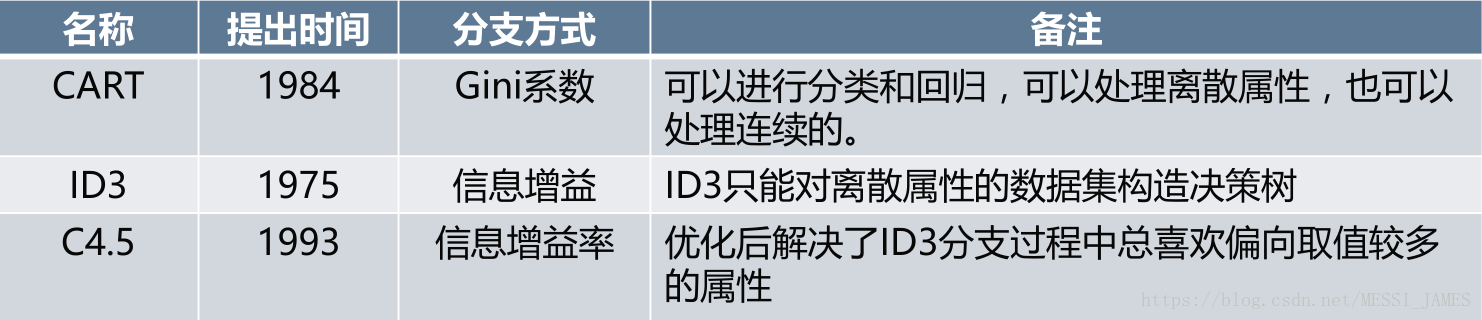
这里写图片描述

2.决策树的剪枝

(1)为什么要剪枝

这里写图片描述
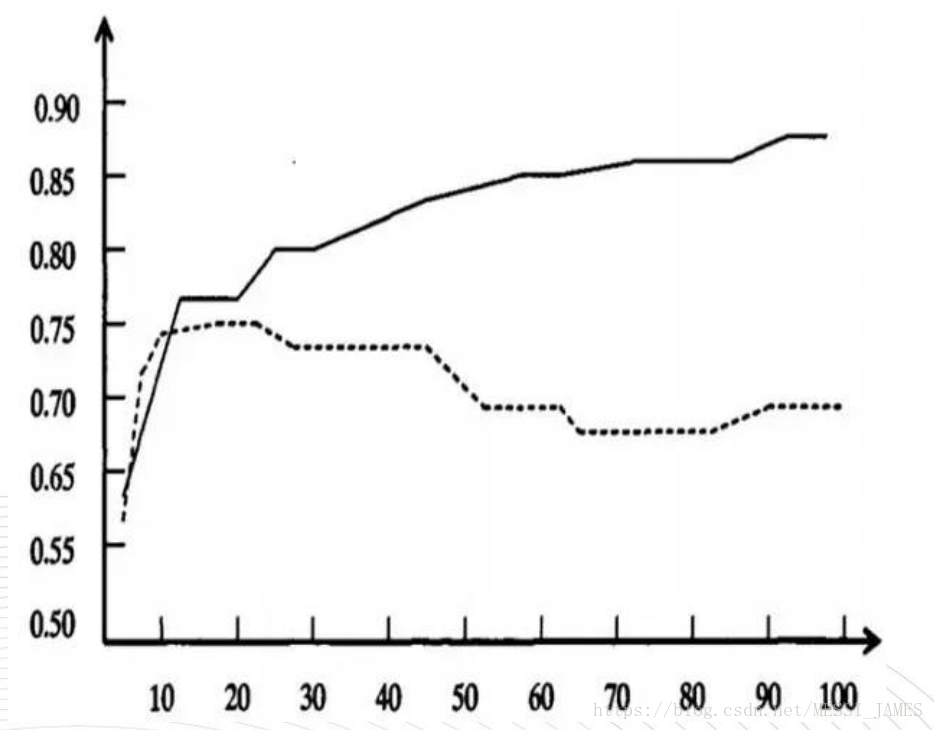
横轴表示在决策树创建过程中树的结点总数,纵轴表示决策树的预测精度。
实线显示的是决策树在训练集上的精度,虚线显示的则是在一个独立的测试集上测量出来的精度。
分析:随着树的增长, 在训练样集上的精度是单调上升的, 然而在独立的测试样例上测出的精度先上升后下降。
有以下三个原因:
•原因1:噪声、样本冲突,即错误的样本数据。
•原因2:特征即属性不能完全作为分类标准。
•原因3:巧合的规律性,数据量不够大。

(2)常用的剪枝方法

1.1 预剪枝:
(1)每一个结点所包含的最小样本数目,例如10,则该结点总样本数小于10时,则不再分;
(2)指定树的高度或者深度,例如树的最大深度为4;
(3)指定结点的熵小于某个值,不再划分。随着树的增长, 在训练样集上的精度是单调上升的, 然而在独立的测试样 例上测出的精度先上升后下降。
1.2 后剪枝:
后剪枝,在已生成过拟合决策树上进行剪枝,可以得到简化版的剪枝决策树。
(1)REP-错误率降低剪枝
(2)PEP-悲观剪枝
(3)CCP-代价复杂度剪枝
(4)MEP-最小错误剪枝

R语言——决策树模型         决策树(Tree Nodels)是一种创建树状模型的方法,它使用‘基尼不纯度’(Gini Impurity)或信息增益(Information Gain)等标准对节点进行递归分割,以创建树状模型。决策树看起来像是以树状形式排列的一系列的if-else语句,易于理解,执行速度快。并且,它能够很好地表现多个特征之间的相互作用,适用于多种数据类型。(树状模型中,随机森林性能表现卓越) ... 阅读详情

相关推荐

机器学习第五章之决策树模型

机器学习专题系列

wangyutao12345的博客 5187

机器学习之决策树

详细介绍了决策树的原理基本步骤及特征选择方法信息增益和信息增益比,决策树生成算法ID3和C4.5算法,决策树的剪枝。最终利用python实现决策树回归算法和分类算法。

m0_69435474的博客 463

机器学习——决策树模型:Python实现

机器学习——决策树模型:Python实现欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 欢迎使用Markdown编辑器 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你

qq_34357269的博客 8772

机器学习 day3 决策树算法

决策树算法1. 目的2. 优缺点3. 信息熵 entropy计算方法:导库:导数据集:首先计算原本的信息熵:计算色泽特征下的信息熵:取数据集D1 D1为色泽=青绿的数据子集取子集D2 D2 为色泽=乌黑的数据子集取子集D3 D3为色泽=浅白的数据子集计算色泽特征的信息熵:封装计算特征信息熵的函数:结果:选择纹理作为根节点(信息熵小,信息增益就大)4. sklearn 中的决策树 1. 目的 通过历史数据计算,得到一颗决策树 2. 优缺点 优点 易于理解:即使对于非分析背景的人来说,决策树输出也很容易理

qq_33489955的博客 584

决策树模型——鸢尾花分类

构建一个决策树分类模型,实现对鸢尾花的分类 1.lris数据集介绍: 鸢尾花数据集是机器学习领域中非常经典的一个分类数据集。数据集全名为:Iris Data Set,总共包含150行数据。 每一行由4个特征值及一个目标值(类别变量)组成。 其中4个特征值分别是:萼片长度、萼片宽度、花瓣长度、花瓣宽度 目标值为3种不同类别的鸢尾花:山鸢尾、变色鸢尾、维吉尼亚鸢尾 2.读取数据 Iris...

pillow的博客 2万+

Python决策树模型的基本原理和参数调优【附代码】

下图所示为一个典型的决策树模型:员工离职预测模型的简单演示。该决策树首先判断员工满意度是否小于5,答案为“是”则认为该员工会离职,答案为“否”则接着判断其收入是否小于10,000元,答案为“是”则认为该员工会离职,答案为“否”则认为该员工不会离职。这里。

weixin_60476982的博客 4925

分类算法 - 决策树(构造、推导、计算、剪枝过程)

决策树是一种基本分类和和回归方法,本篇主要讨论分类决策树,主要从决策树的构造、决策树的修剪等方面进行介绍,本文主要参考《机器学习实战》、《统计学习方法》和网上的一些帖子,进行的总结学习。 分类算法 - 决策树1.概念2. 决策树的构造2.1 特征选择2.1.1 信息增益2.1.2 信息增益率2.1.3 基尼指数2.2 决策树的生成2.2.1 ID3算法2.2.2 C4.5算法2.2.3 CART数算法2.3 剪枝3.决策树的存储4.决策树实例5. 总结6. 参考 1.概念 决策树是一种通过抓取数据中所隐含

qq602683200的博客 1922

决策树模型(R语言)

R语言中最常用于实现决策树的有两个包,分别是rpart包和party包,其区别如下: rpart包的处理方式:首先对所有自变量和所有分割点进行评估,最佳的选择是使分割后组内的数据更为“一致”(pure)。这里的“一致”是指组内数据的因变量取值变异较小。rpart包对这种“一致”性的默认度量是Gini值。确定停止划分的参数有很多(参见rpart.control),确定这些参数是非常重要而微妙的,因...

X_dmword的博客 7041

excel决策树_相关分析与决策树

pearson相关,就是分析数据的变动量之间的关系,例如数据A原来是100,B原来是10,如果A变动为110,就是A增长了10%,B现在是10.7,就是B增长了7%,也就说A和B之间是正相关。相关系数公式如下:同样,如果A变化了10%,B变化了-5%,我们就说A和B是负相关的;如果A变化了10%,B变化了-0.2%,我们就说A和B是低相关或者无关的。1.EXCEL“数据分析”模块进入“数据分析”界...

weixin_39590453的博客 1425

【机器学习】九大决策树模型总结

这篇博客深入探讨了九种不同的决策树模型,每种模型都拥有其独特的特点和应用场景。我将带您了解一些经典的模型,让你理解它们的工作原理,并在实践中灵活运用它们。

chunyang的博客 3614

决策树模型(Decision Tree)

P1P_1P1​:表一种类别的数据占总数居的比例。P01−P1P0​1−P1​:表示除了P1P_1P1​类别以外的其他数据占总数据的比例。

SoyMilk的博客 3495

决策树 Decision Tree

决策树是一个有监督的分类算法,在每次分裂中都找到最容易区分一个集合和另一个集合的特征。在寻找最优特征时,DT算法保证了局部最优,但整体上看不一定是全局最优。一、目标 target因为决策树是一个有监督的算法,所以样本已经有一个变量用来表征这个样本的target,可能是正例/反例,也可以是多个类别(比如高/中/低)二、模型输入 model input在实际应用中,无论是离散特征还是连续特征,其实都可...

shy19890510的博客 1047

Ansys Zemax实战:5步搞定多模光纤耦合效率优化(附IMAE操作数详解)

本文详细介绍了使用Ansys Zemax优化多模光纤耦合效率的5个关键步骤,包括几何图像分析设置、IMAE操作数应用及偏振效应处理。通过实战案例解析,帮助工程师快速掌握光纤耦合效率提升技巧,特别针对IMAE操作数的配置保存机制和菲涅尔损耗控制进行深度讲解。

potato的博客 691

【机器学习15】决策树模型详解

决策树算法前言一、决策树算法的概述1.树模型2.树模型基本流程二、熵的作用三、决策树构造实例四、信息增益率和gini系数五、剪枝方法六、分类、回归任务七、树模型的可视化展示八、决策边界展示分析九、决策树预剪枝常用参数十、回归树模型总结 前言 随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的决策树的详细内容。 一、决策树算法的概述 1.树模型 决策树是一种树形结构,其中每个内部节点表示一个属性上的测试,每个分支代表一个测试输出,每个叶节点代表一种类别。

lys_828的博客 4万+

【原创】Ubuntu20.04 安装 Isaac Gym 仿真器

Ubuntu20.04 安装 Isaac Gym

qq_54900679的博客 3095

Python+Seaborn可视化:双因素方差分析结果这样呈现更专业

本文详细介绍了如何利用Python中的Seaborn和statsmodels库,专业地执行并可视化双因素方差分析结果。通过模拟实验数据,演示了从模型构建、统计检验(包括交互作用分析)到诊断验证的全流程。重点展示了如何使用Seaborn绘制交互效应图、组合分布图及热图,将复杂的统计结果转化为直观、富有洞察力的可视化图表,助力科研论文与商业报告的专业呈现。

weixin_29274969的博客 137

用通俗易懂的方式讲解:决策树模型及案例(Python 代码)

基本原理是通过对一系列问题进行if/else的推导,最终实现相关决策。决策树模型的一个实例:决策树的概念并不复杂,主要是通过连续的逻辑判断得出最后的结论,其关键在于如何建立这样一棵“树”。

Python数据挖掘 2万+

EMC意义下的共模(Common Mode)和差模(Differential Mode)

在电子产品中,信号或电源通过两根导线传输。对比维度差模(DM)共模(CM)电流方向一进一出,相等相反同向、相等回流路径两根导线组成的闭合回路地或外壳EMC影响较小容易辐射干扰,重点治理类型定义有用信号干扰信号抑制方法常规滤波器、电感、电容共模电感、磁环、屏蔽、接地技术等。

weixin_43199439的博客 1250

决策树模型构建+调参Python代码——用决策树模型实现机器学习

决策树模型构建+调参Python代码——用决策树模型实现机器学习。

qq_41698317的博客 3529

Python 爬虫进阶:爬取 APP 数据(Charles 抓包 + Requests)

本文详细介绍了APP数据爬取的完整技术方案。首先通过Charles抓包工具配置HTTPS代理和证书,解析APP通信协议;然后分析请求参数、反爬机制和动态签名生成规则;接着使用Python的Requests库实现模拟请求、分页爬取和数据存储;最后针对证书问题、Token失效等常见问题提供解决方案。文章强调抓包分析、参数逆向和请求模拟三大核心技术,同时提醒开发者需遵守法律法规,合理控制爬取频率。该方案适用于移动端数据采集场景,为无法直接获取网页数据的情况提供了有效解决方案。

2503_91057718的博客 2121

PyTorch深度学习实战(36)——Pix2Pix详解与实现

Pix2Pix 是基于生成对抗网络的图像转换框架,能够将输入图像转换为与之对应的输出图像,能够广泛用于图像到图像转换的任务,如风格转换、图像修复、语义标签到图像的转换等。Pix2Pix 的核心思想是通过对抗训练将输入图像和目标输出图像进行配对,使生成网络可以学习到输入图像到输出图像的映射关系。在本节中,将学习使用 Pix2Pix 根据给定轮廓生成图像。

盼小辉丶的博客 1万+

决策树模型

今天我们来复习决策树模型,并用项目教大家快速了解决策树模型,我会将大家编写代码中常见的错误点在代码注释中指出,希望不会浪费大家的时间,高效学习以上就是今天要讲的内容,本文仅仅简单介绍了决策树模型的推导与实现,还有一些其他的优化决策树模型的方法但本文主旨是便于大家复习模型,就不再赘述以上所有代码在Github仓库。

2403_85773052的博客 1298

SpringBoot + MyBatis-Plus 高效实现数据变更记录:从注解到通用审计方案(附源码)

*** 数据变更审计插件* 拦截增删改操作,自动记录变更日志*/@Component@Resource/*** 拦截SQL执行*/@Override/*** 数据变更审计插件* 拦截增删改操作,自动记录变更日志/*** 拦截SQL执行。

2601_94871597的博客 561

Decision Tree Model|决策树模型

本文介绍了决策树模型的基本概念和应用实例。决策树通过一系列条件判断对数据进行分类或回归预测,以猫分类为例,展示了决策树从根节点到叶节点的分类过程。文章还比较了四种基于相同特征集但结构不同的决策树,分析其差异原因(数据划分、特征重要性、随机性等),并指出评估决策树优劣的标准包括准确率、泛化能力和解释性。最后建议实践中可采用集成学习方法提升模型性能。更多计算机知识欢迎访问作者博客网站rn.berlinlian.cn。

m0_74462934的博客 1936

multisim14.3无法访问数据库...如何解决?

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值 。

**My Coding Family** 4486

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【海量数据挖掘/数据分析】之 决策树模型(决策树模型、决策树构成、决策树常用算法、决策树性能要求、信息增益、信息增益计算公式、决策树信息增益计算实例)

【海量数据挖掘/数据分析】之 决策树模型(决策树模型、决策树构成、决策树常用算法、决策树性能要求、信息增益、信息增益计算公式、决策树信息增益计算实例) 一、决策树模型 1、常用算法 2、属性划分策略 3、其他算法 三、决策树算法性能要求 四、 决策树模型创建 ( 递归创建决策树 ) 1 、 决策树模型创建 2 、 决策树创建算法 ( 递归 ) 3 、 递归操作 4 、 递归停止的条件 五、 决策树 树根属性 选择 六、信息增益 说明 1、 熵 和 信息 的数据组成 2 、 信息增

仙魁XAN 1万+

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

上一篇: matplotlib扩展篇—pyecharts绘图
下一篇: 《算法图解》
messi_james
博客等级 码龄8年 91粉丝 69原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值