LLM面面观之Prefix LM vs Causal LM

【字节跳动】LLM大模型算法面试题:prefix LM 和 causal LM 区别是什么? Prefix LM与Causal LM是两种核心语言模型架构,主要区别在于注意力机制和应用场景。Causal LM(如GPT)采用严格单向注意力,仅能访问已生成内容,适合文本生成任务;而Prefix LM(如T5)允许前缀部分双向编码,后续内容自回归生成,在理解-生成类任务中表现更优。关键差异体现在:Prefix LM通过分段掩码实现前缀的双向理解与生成部分的单向预测,兼具参数效率与上下文理解能力;Causal LM则专注于纯自回归生成。典型应用上,Causal LM适用于开放生成,Prefix LM更适合 阅读详情
AI摘要

本文比较了PrefixLM(前缀语言模型)和CausalLM(因果语言模型),阐述了它们的结构差异,包括共享Transformer和自回归机制。作者还讨论了如何选择以及理论研究对两者优劣的看法。,

1. 背景

关于Prefix LM和Causal LM的区别,本qiang在网上逛了一翻,发现多数客官只给出了结论,但对于懵懵的本qiang,结果仍是懵懵...

因此,消遣了多半天,从原理及出处,交出了Prefix LM和Causal LM两者区别的更为清楚的说明。

2. Prefix LM

Prefix LM,即前缀语言模型,该结构是Google的T5模型论文起的名字,望文知义来说,这个模型的”前缀”有些内容,但继续向前追溯的话,微软的UniLM已经提及到了。

Prefix LM其实是Encoder-Decoder模型的变体,为什么这样说?解释如下:

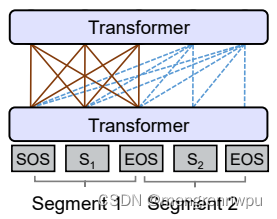
(1) 在标准的Encoder-Decoder模型中,Encoder和Decoder各自使用一个独立的Transformer

( 2) 而在Prefix LM,Encoder和Decoder则共享了同一个Transformer结构,在Transformer内部通过Attention Mask机制来实现。

继续展开下Attention Mask机制,马上主题就有解了!

与标准Encoder-Decoder类似,Prefix LM在Encoder部分采用Auto Encoding (AE-自编码)模式,即前缀序列中任意两个token都相互可见,而Decoder部分采用Auto Regressive  (AR-自回归)模式,即待生成的token可以看到Encoder侧所有token(包括上下文)和Decoder侧已经生成的token,但不能看未来尚未产生的token。

下面的图很形象地解释了Prefix LM的Attention Mask机制(左)及流转过程(右)。
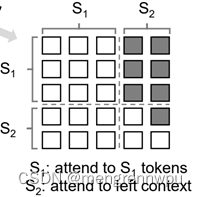
        

Prefix LM的代表模型有UniLM、T5、GLM(清华滴~)

3. Causal LM

了解了Prefix LM后,再来看Causal LM就简单的多了~

Causal LM是因果语言模型,目前流行地大多数模型都是这种结构,别无他因,因为GPT系列模型内部结构就是它,还有开源界的LLaMa也是。

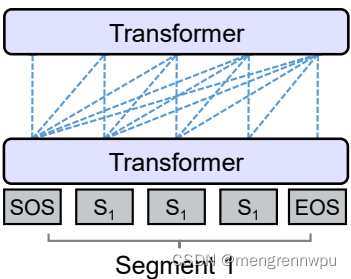
Causal LM只涉及到Encoder-Decoder中的Decoder部分,采用Auto Regressive模式,直白地说,就是根据历史的token来预测下一个token,也是在Attention Mask这里做的手脚。

参照着Prefix LM,可以看下Causal LM的Attention Mask机制(左)及流转过程(右)。
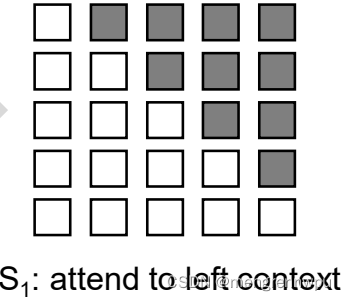
        

Ps(图真是个好东西,一图胜万字呀)

4. 如何选取

两种结构均能生成文本,应该如何选择呢?只能说仁智见仁智。本qiang也搜寻了一番,有一篇google的论文,从理论上推导了Causal LM在情境学习(In-Context Learning)中比不上Prefix LM,感兴趣地客官可以看看论文。

5. 总结

一句话足矣~

前缀语言模型可以根据给定的前缀生成后续的文本,而因果语言模型只能根据之前的文本生成后续的文本。

6. 参考

(1) google T5: https://arxiv.org/pdf/1910.10683v4.pdf

(2) 微软UniLM: https://arxiv.org/pdf/1905.03197.pdf

(3) google理论评估PLM与CLM: https://arxiv.org/pdf/2308.06912.pdf
Prefix LM与Casual LM的区别和联系 简单理解: casual LM可以理解为词语接龙,prefix LM可以理解为选词填空 Casual LM (因果语言模型) 类似于词语接龙:想象一下你和朋友玩词语接龙游戏,每个人说出一个词,而你说出的词只能基于之前所有人说过的词。因果LM就是这样工作的,它逐个生成词,每个新词都是根据之前的词序列来预测的,不能看到未来的词。 Prefix LM (前缀语言模型) 更像是选词填空或完形填空:在这种情况下,你不仅能看到句子的开始部分(前缀),还可能看到句子的一部分后置内容或者上下文。这有助于更准确地填充空白 阅读详情

相关推荐

causallm不适用于上下文学习

该文研究的背景是在上下文学习中,基于Transformer的prefixLM模型在性能上优于使用自回归注意力机制的causalLM模型。过去的方法中,主要使用的是causalLM模型,其采用自回归的注意力机制,限制了上下文样本之间的相互关注。由于这种限制,限制了模型的能力。因此,自然而然地提出了prefixLM模型,允许上下文样本之间进行全局的注意力。这种方法在直觉上是合理的,并在实证研究中取得了良好的表现。本文采用理论分析的方法,通过对prefixLM和causalLM。

具身机器人和通用AI 1377

预训练模型五大模型结构

预训练模型5大模型结构

jzwei023的博客 4186

[大模型面试]为什么causalLM叫causal因果

隐马尔可夫性(Hidden Markov Property)是隐马尔可夫模型(Hidden Markov Model, HMM)的核心概念,它结合了马尔可夫性和隐含状态的特点。因此,虽然现代语言模型确实保留了某些类似隐马尔可夫的特性,但它们的复杂性、灵活性和能力远远超出了传统HMM的范畴。您提出了一个很好的问题。排列语言建模是一种巧妙的方法,试图融合自回归模型和双向上下文模型的优点,为语言模型的发展提供了新的思路。隐马尔可夫性指的是一个系统在任何时刻的状态只依赖于其前一时刻的状态,而与更早的状态无关。

具身机器人和通用AI 1745

大模型面试问题记录

在训练过程中,模型会学习这些符号的嵌入表示。INT8提供更高的压缩比,可以显著减少模型的内存占用和带宽需求,但由于量化过程中的信息损失,可能会对模型的准确性产生一定影响。这种现象通常发生在大型模型中,原因是大型模型具有更高的表示能力和更多的参数,可以更好地捕捉数据中的模式和关联。知识蒸馏是一种模型压缩技术,其中一个大型的、表现良好的模型(教师模型)被用来训练一个小型的模型(学生模型)。微调后的模型出现能力劣化,灾难性遗忘可能是因为模型在微调过程中学习到了过多的特定任务的知识,而忽略了通用的语言知识。

hellozhxy的博客 1573

智能车八邻域图像算法_二

智能车八邻域图像算法 文章目录智能车八邻域图像算法前言一、一些想法二、生长方向的使用1.点的生长方向的表示2. 用点的生长方向来做初步判断1.引入库2.读入数据总结 前言 上一篇里面讲过用八邻域来获得赛道边界:智能车八邻域图像算法 当已经能稳定获得赛道边界时,就可以进行元素识别,获得偏差了。 这里就介绍一下我的一些思路。 早在前两年,优快云上就有一篇关于八邻域如何处理元素的文章第十五届全国大学生智能汽车竞赛-双车组三轮图像处理总结,写得很好,我当时也参考了这篇文章,但是我觉得不是很详细,所以我这里想写得

技术缝合怪的博客 1万+

箱式连续提升机

箱式连续提升机,是对具有高度差较大(>1500mm)的输送线之间进行连接,将箱式物资进行连续输送的提升(或下降)的输送设备,可根据输送线的具体输送要求作相应的参数设计。目前的箱式连续提升机种类比较多,常用的形式主要有Z型和C型,工作原理相同,只是入口和出口分别在两侧和同侧。

月生沧溟 1248

大模型LLM微调的方式:Instruction/Promt/Prefix/PET、

先从预训练模型开始,初始化多个不同的模型(图中1步骤),在有标注的少量样本上进行Prompt-Tuning,然后通过多个不同的PVP训练得到多个不同的模型(图中a步骤),每个模型在无标注数据上进行推理打标,并根据置信度筛选(图中b步骤),根据新标注的数据与原始标注数据融合后,再重新进行Prompt-Tuning(图中c步骤),重复abc三个步骤多次后,获得每个模型后,在测试时进行集成投票(图中2、3步骤)。同连续的模板一样,为了让label word也可以自适应的变化,提出连续的label word。

具身机器人和通用AI 2435

【AI黑话日日新】什么是AI云原生?

云原生赋能AI:利用容器、微服务、Serverless、DevOps等云原生技术,解决AI应用(尤其是大模型)在部署、扩展、运维、成本控制方面的痛点,让AI服务具备高可用、高性能、易运维、易扩展的特性AI赋能云原生:将AI技术(如智能调度、异常检测、自动优化)融入云基础设施管理,使云平台具备自我感知、自我优化、自我修复的能力,从"被动响应"升级为"主动适配"其本质是实现从""(AI运行在云上)到""(为AI量身打造的云)的根本性转变。

专注:太空算力、AI infra、异构调度、大模型成本工程 627

prefix LM和causal LM区别是什么?

Prefix LM:前缀语言模型是一种生成模型,他在生成每个词时都可以考虑之前的上下文信息。在生成时,前缀语言模型会根据给定的前缀预测下一个可能得词。这种模型可以用于文本生成、机器翻译等任务。Causal LM:因果语言模型是一种自回归模型,他只能根据之前的文本生成后续的文本,而不能根据后续的文本生成之前的文本。在训练时,因果语言模型的目标是预测下一个词的概率,给定之前的所有词作为上下文。这种模型可以用于文本生成、语言建模等任务。

cancer_s的博客 1261

【AI面试】 Python 的装饰器

Python装饰器是一种高阶函数,用于在不修改原函数代码的情况下增强其功能。它通过@语法糖接收目标函数作为参数,并返回一个包含额外逻辑(如日志、缓存、权限验证等)的新函数。装饰器的核心价值在于代码复用和解耦,符合开闭原则,典型应用包括性能分析、权限控制等场景。例如,@timer_decorator可自动为函数添加耗时统计功能。本质上,@decorator等价于func = decorator(func),实际调用的是装饰器返回的包装函数。进阶技巧包括使用@functools.wraps保留原函数元信息。装饰

钱多多先森 183

AI 模型优化与部署秘籍:从理论到实战

本文系统介绍了AI模型优化与部署的关键技术。模型剪枝通过去除冗余参数减小模型规模,量化技术降低计算精度以提升效率,蒸馏方法实现知识从大模型到小模型的迁移。TensorRT通过层融合和精度校准加速GPU推理,ONNX格式实现跨框架模型转换,TFLite则优化移动端部署。这些技术共同解决了AI模型在资源受限环境下的部署难题,显著提升了模型运行效率,为AI应用落地提供了重要支撑。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 246

huggingface.transformers任务简介

本部分介绍了一些常见NLP任务使用transformers包的解决方案。

诸神缄默不语的博客 1万+

基于 Simulink 的飞轮储能系统(Flywheel Energy Storage System, FESS)充放电协调控制实战教程

本教程详细介绍了基于Simulink的飞轮储能系统(FESS)建模与控制方法。系统采用永磁同步电机(PMSM)和背靠背变流器架构,包含机侧全速域矢量控制和网侧直流稳压控制。重点讲解了机电耦合建模、FOC控制算法实现、基于电压下垂的协调控制策略,以及混合储能系统设计思路。教程提供了MATLAB函数代码示例,并给出典型工况下的仿真波形分析指南,同时指出了常见问题解决方案。该模型可用于研究飞轮储能在调频、能量回收等场景的应用,为新能源消纳和微网稳定提供仿真工具。

MHD0815的博客 166

这可能是一份LLM实践面试宝典

知乎:suc16链接:https://zhuanlan.zhihu.com/p/624918286折腾大模型(small LLM)一段时间了,以下是平民版的LLM学习记录,记录了自己遇到的问题,以及给出不完美的解答。LLM基础1. 最主流的开源模型?ChatGLM-6BLLaMA-7B2. 两者结构上的区别?ChatGLM-6B是Prefix LM(PLM),LLaMA-7B是Causal LM(...

zenRRan的博客 2060

【局部规划模块曲线算法】曲线平滑介绍

本文先对轨迹平滑问题做个简单的介绍,具体内容后续再更,其他模块可以参考去我其他文章提示:以下是本篇文章正文内容(1)适合给移动机器人运动的路径【满足运动学,高阶平滑】(2)高阶的运动学不能够突变的【至少三阶的加速度不能突变,最好四阶的jerk和五阶的snap也不能突变】(3)在转弯的地方不会停下来(4)加减速均衡,节省能量(5)节省时间的。

qq_35635374的博客 5715

vue2/3 - H5 移动端网页中调用手机摄像头扫描二维码 / 条形码功能,在h5手机网页里调起相机摄像头进行二维码或条形码扫描效果详细教程(详细示例组件源码,一键复制开箱即用!)

vue扫描二维码条形码,vue网页调用摄像头扫二维码条形码,vue移动端如何实现调用相机扫描二维码,vue移动端扫一扫功能,vue怎么做移动端h5扫一扫功能,vue识别二维码和条形码,vue实现点击按钮调用摄像头扫码,vue调用本地摄像头实现拍照功能,Vue中如何进行二维码生成与扫描,如何实现vue在手机浏览器中调用摄像头实现扫描二维码功能,VUE项目移动端H5调用摄像头扫码,vue项目中实现H5调取摄像头,网页调用摄像头实现二维码扫描功能,vue调用手机摄像头,vue在调用摄像头扫码,vue自定义打开摄像

✅ 精选推荐文章 1万+

Prefix LM 和 Causal LM 区别是什么?

Causal LM是严格单向的,只能利用前面的词,适合纯生成任务(如 GPT)。Prefix LM允许前缀部分双向编码,适合需要结合上下文的任务(如 T5、BART)。虽然两者都基于前面的内容预测后续内容,但Prefix LM对前缀的处理更灵活,能够利用更多的上下文信息。希望这篇博客能帮助你更好地理解Prefix LM和Causal LM的区别!如果还有疑问,欢迎继续讨论!

weixin_63866037的博客 1805

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

2024最新AI大模型-LLm八股合集(四)

大模型的 honest原则是如何实现的?模型如何判断回答的知识是训练过的已知的知识,怎么训练这种能力?如何解决 PPO 的训练过程同时存在4个模型(2训练,2推理),对计算资源的要求较高问题?从考察问题延展到考察知识点,再到如何优雅回答一面俱全,可以说是求职面试的必备宝典,每一部分都有上百页内容,接下来具体展示,完整版可直接下方扫码领取。6.领域模型 Continue PreTrain ,如何 让模型在预训练过程中就学习到更多的知识?通过最大化模型生成训练数据中观察到的文本序列的概率来优化模型参数。

2401_85325557的博客 1228

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

什么是自回归语言模型(Causal Language Modeling)?

详细介绍了啥是自回归模型,它的特点和一些应用场景

qq_42755230的博客 3637

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

LLM主流框架:Causal Decoder、Prefix Decoder和Encoder-Decoder

前缀语言模型可以根据给定的前缀生成后续的文本,而因果语言模型只能根据之前的文本生成后续的文本。在模型架构代表LLM注意力机制是否属于Decoder-Only纯单向YESFlan-T5输入双向NO输入双向,输出单向YES。

TFATS的博客 8794

LLM训练过程中的 CAUSAL_LM 是什么?

备注:“causal”在这里指因果mask/先后约束,不是因果推断(Causal Inference)里的“因果关系”。CAUSAL_LM 指“因果语言模型”,更常见的说法是“自回归语言模型”。

先说一下,就简单地写点儿氵文,不是博客,只是我的笔记本/工具书 641

VLP: A Survey on Vision-Language Pre-training 论文总结

VLP: A Survey on Vision-Language Pre-training VLP:视觉语言预训练研究综述 论文地址: https://arxiv.org/pdf/2202.09061.pdf 摘要: 在过去几年中,训练前模型的出现将计算机视觉(CV)和自然语言处理(NLP)等单峰领域带入了一个新时代。大量工作表明,它们有利于下游单峰任务,避免从头开始训练新模型。那么,这种预先训练好的模型可以应用于多模式任务吗?研究人员已经探索了这个问题,并取得了重大进展。本文综述了视觉语言预训练(VLP)

yingdajun的博客 5102

LLM高效参数微调方法:从Prefix Tuning、Prompt Tuning、P-Tuning V1/V2到LoRA、QLoRA(含对模型量化的解释)

常规部分的正向传播由transformers所定义,而LoRA部分的正向传播则由LinearLayer_LoRA(nn.Module)的forward()所定义,即“LoRA层的两条分支结果进行加和”,如下图所示『一般用随机高斯分布初始化,当然实际代码实现时,比如微软的deepspeed chat在用到LoRA时,一开始通过0矩阵占位,然后调用搭配ReLU激活函数的kaiming均匀分布初始化。,相当于在训练期间,较小的权重矩阵(下图中的A和B)是分开的,但一旦训练完成,权重可以合并到一个新权重矩阵中。

结构之法 算法之道 2万+

面试题:prefix LM 和 causal LM、encoder-decoder 区别及各自有什么优缺点?

Prefix LM,即前缀语言模型,是一种在给定一个文本前缀的情况下,模型能够基于这个前缀生成接下来的文本内容。

zengxiaojian2的博客 1251

大模型八股文

对大模型的八股文进行汇总和总结

qq_40910191的博客 2244

开源LLM微调训练指南:如何打造属于自己的LLM模型

今天我们来聊一聊关于LLM的微调训练,LLM应该算是目前当之无愧的最有影响力的AI技术。尽管它只是一个语言模型,但它具备理解和生成人类语言的能力,非常厉害!它可以革新各个行业,包括自然语言处理、机器翻译、内容创作和客户服务等,成为未来商业环境的重要组成部分。

FrenzyTechAI的博客 7894
上一篇: Meta AI新发布的超大规模语言模型-OPT-175B
下一篇: LLM面面观之LLM复读机问题及解决方案
mengrennwpu
博客等级 码龄15年 262粉丝 87原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

mengrennwpu

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值