AdaDiff: Adaptive Step Selection for Fast Diffusion

ECCV 2024 | AdaDiff: 通过逐步自适应计算加速扩散模型 扩散模型在生成多样化和高质量图像方面取得了巨大成功,然而其广泛应用,尤其是在实时场景中,受到了生成速度缓慢的限制。生成速度慢源于多步网络推理的必要性。虽然某些预测在每次采样迭代中受益于模型的完整计算,但并非每个迭代都需要相同的计算量,这可能导致计算效率低下。与处理单步生成问题的典型自适应计算挑战不同,具有多步生成的扩散过程需要根据对每一步对最终图像输出的重要性的动态评估来调整计算资源分配,这带来了一系列独特的挑战。 阅读详情

AdaDiff: Adaptive Step Selection for Fast Diffusion

这本质是一篇加速生成的文章,优化角度在于为不同复杂程度的提示选取不同的时间步去进行去噪。

Abstract

扩散模型的生成过程涉及到几十个步骤的去噪以产生逼真的图像/视频,这在计算上是昂贵的。本文认为去噪步骤 应该根据输入样本的复杂程度来进行特定的采样。

因此提出了 AdaDiff ,一个轻量级的框架来学习 instance-specific 的步骤策略。还是和之前方法一样,使用策略梯度方法来最大化一个奖励函数。(平衡推理时间和生成质量)

作者在 3 个图像生成基准测试和 2 两个视频生成基准测试进行了实验,结果表明:可以实现和固定 50 个去噪步骤的模型实现相当的结果,但是本文提出的方法减少了 33%−40%33\% - 40\%33%−40% 的推理时间


Introduction
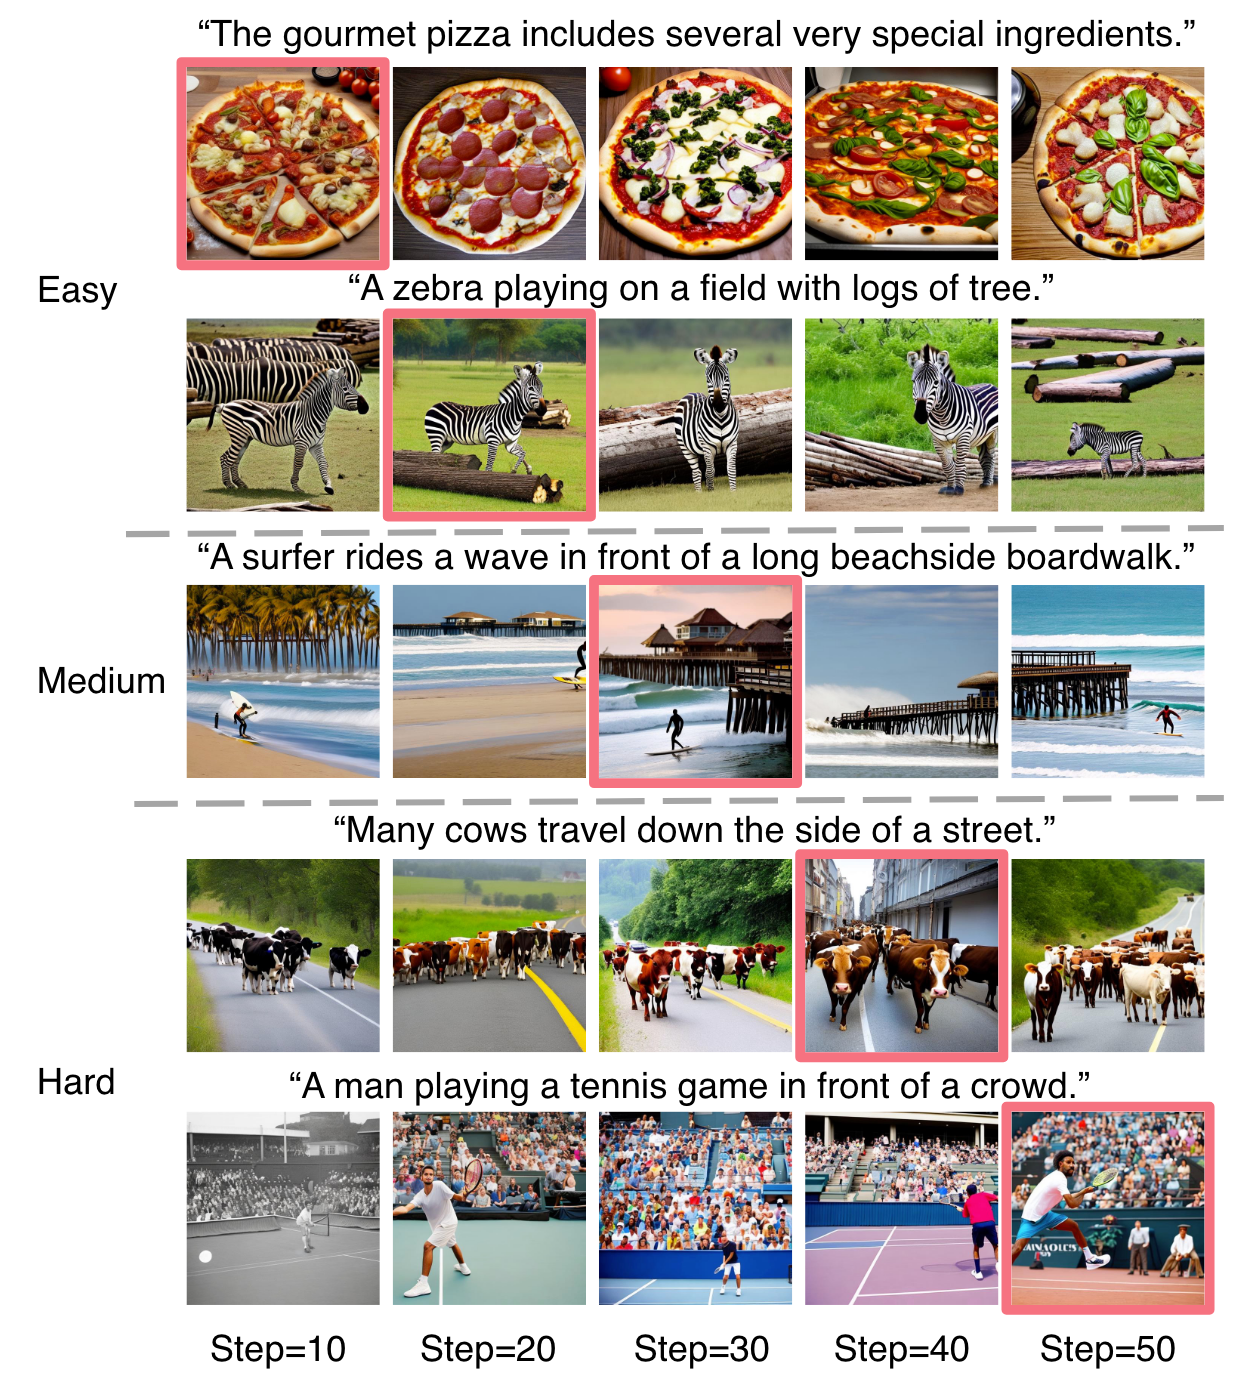
A conceptual overview of our approach.

目前考虑到生成质量和推理速度之间的权衡,大多数去噪步骤都是设置为 50。
而作者认为:

  • 文本提示的丰富性(即对象的数量以及它们彼此之间的关系)差异很大。
  • 对于某些简单且粗粒度的提示(仅涉及一个或几个对象),使用少步骤足以达到好的生成质量,而增加步骤只会有边际改善而不会有必然的生成改善。
  • 对于包含许多对象、详细描述和对象之间复杂交互的复杂文本提示,需要更多的步骤来实现期望的结果。
    因此,本文的目标是为扩散模式建立一个动态框架;

简而言之,AdaDiff 为不同丰富程度的提示分配了不同数量的生成步骤,旨在最大限度地减少推理时间,同时保持高图像质量。带有红色边框的图像是由AdaDiff生成的。

对于每个提示符的的动态生成策略:
1)决定所需要的生成步骤数目;
2)使用相对更少的步骤来确保高质量的生成;

这样的问题是:学习动态步骤选择是一项非常难的任务,因为它涉及不可微分的决策过程。
为此,AdaDiff训练一个轻量级的步长选择网络来生成步长使用策略。随后,基于此导出的策略,对预训练的扩散模型进行动态采样过程,以实现高效生成。

  • 步骤选择网络使用策略梯度方法进行优化,以最大化奖励函数。
  • 这个奖励函数的主要目标是鼓励生成高质量的视觉内容,同时最小化计算资源。
  • 同样值得指出的是,以文本输入为条件的步长选择网络是轻量级的,计算开销可以忽略不计。

Methods

这里主要关注的是 3.2 节:Adaptive step selection for image generation

Adaptive step selection for image generation

文中使用离散时间的 DDIM sample 来加速采样,设定 N=5,S={10,20,30,40,50}N = 5, S = \{10, 20, 30, 40, 50\}N=5,S={10,20,30,40,50} ;

形式上;

1)给定文本提示 p\mathbf{p}p ,经过 文本编码器 τ\boldsymbol{\tau}τ 提取特征 c=τ(p)\mathbf{c}=\boldsymbol{\tau}(\mathbf{p})c=τ(p)
2)步长选择网络 fsf_{s}fs​,参数化为 www,通过 self-attention 来学习文本提示 c\mathbf{c}c 信息量;
3)然后通过一个 MLP 投射为 s∈RNs\in \mathcal{\mathbb{R}}^{N}s∈RN

s=fs(c;w) \mathbf{s}=f_s(\mathbf{c};\mathbf{w}) s=fs​(c;w)

其中,s\mathbf{s}s 中的每一项表示选择该步骤的概率得分。然后定义了一个N维类别分布的步长选择策略 πf(u∣p)\pi^f\left(\mathbf{u}\mid\mathbf{p}\right)πf(u∣p)。

其中,u\mathbf{u}u 是一个长度为 N 的 one-hot 向量,而 uj=1\mathbf{u}_j = 1uj​=1 表示 S\mathcal{S}S 中选择下标为 jjj 的时间步骤 t\mathbf{t}t 的概率。

步长选择网络设计为由三个自关注层和一个多层感知器组成的轻量级结构。

在训练阶段,从相应的策略中抽样生成 u\mathbf{u}u,在测试阶段,采用贪心方法。
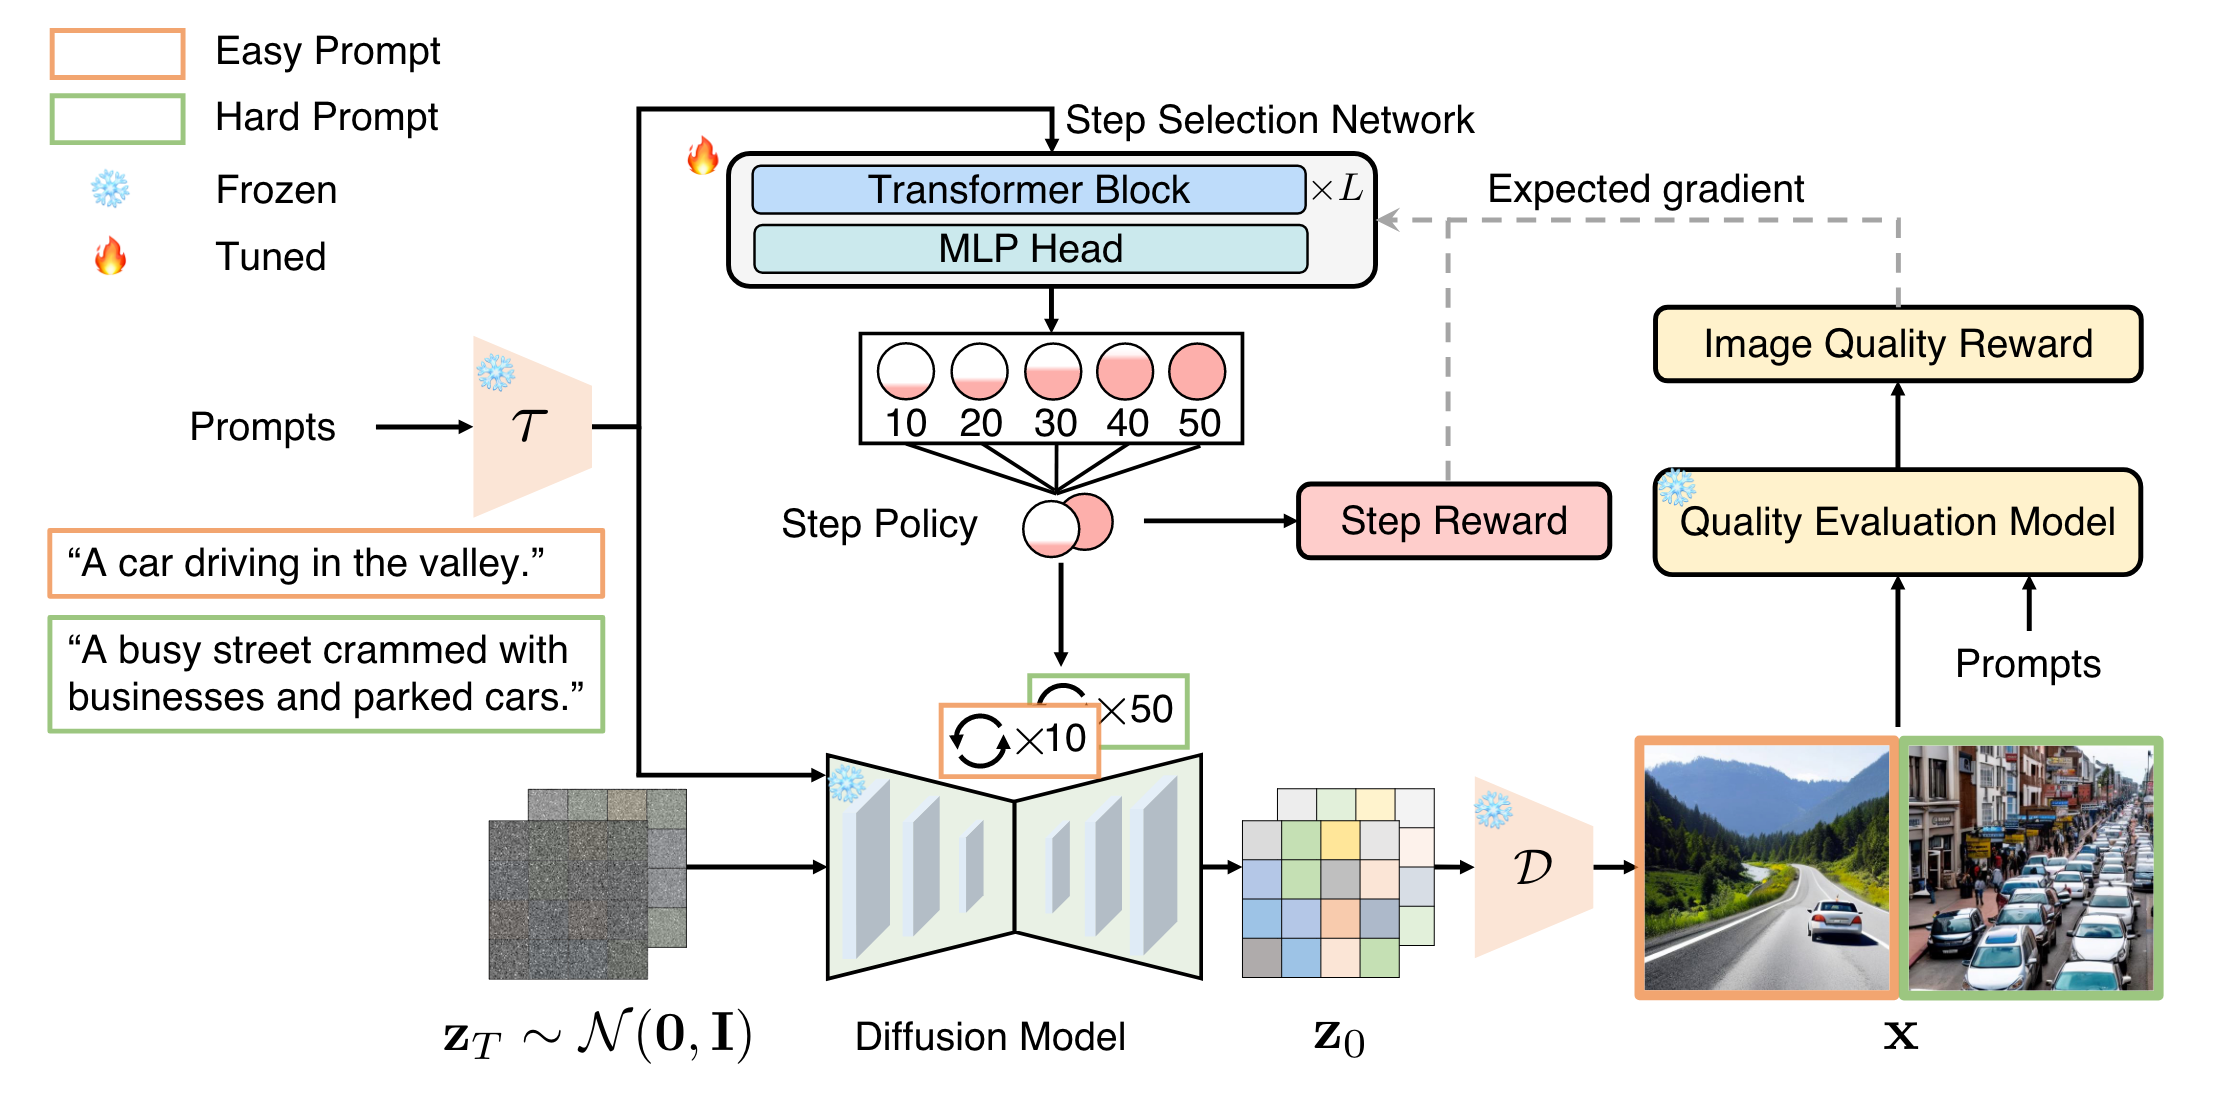
An overview of the proposed pipeline AdaDiff

Reward function

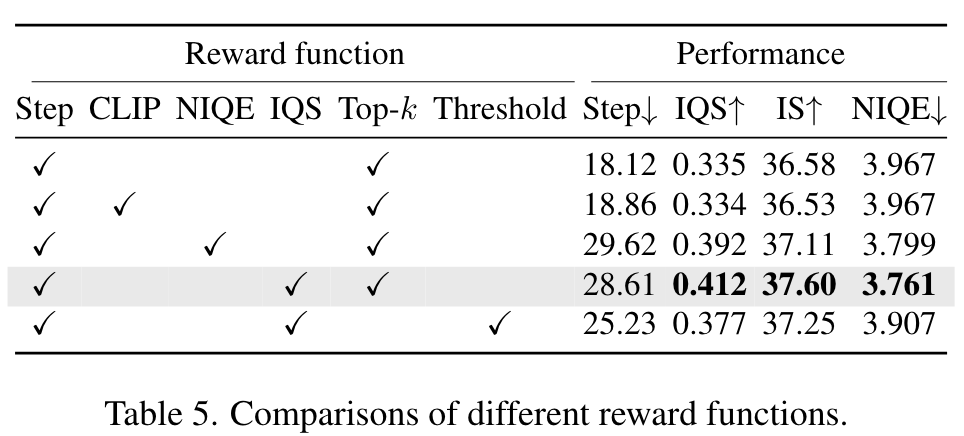
两部分:1)Image quality Reward , 2)step reward (balance quality 和 inference time)

Image quality Reward

这一部分是使用了一个图像质量评估模型 fqf_qfq​,表示为 IQS。
模型从两个维度评估图像质量:

  • image-text alignment:图文对齐来衡量生成图像和文本提示之间的一致性。
  • perceptual fidelity:生成的图像应该忠实于物体的形状和特征,而不是杂乱无章地生成。

因此,IQS score 的分数反映着图像的质量。image quality reward fomulate as: Q(u)=fq(x)\mathcal{Q}(\mathbf{u})=f_q(\mathbf{x})Q(u)=fq​(x)

Step reward

O(u)=1−tSmax\mathcal{O}(\mathbf{u})=1-\frac{\mathbf{t}}{S_{max}}O(u)=1−Smax​t​

表示为相对于 S\mathcal{S}S 中的最大时间步节省的规范化步骤。(相当于省下了多少时间)

整体的奖励函数如下所示:

R(u)={O(u)+λQ(u)for high quality image−γelse \left.R(\mathbf{u})=\left\{\begin{array}{ll}\mathcal{O}(\mathbf{u})+\lambda\mathcal{Q}(\mathbf{u})&\text{for high quality image}\\-\gamma&\text{else}\end{array}\right.\right. R(u)={O(u)+λQ(u)−γ​for high quality imageelse​

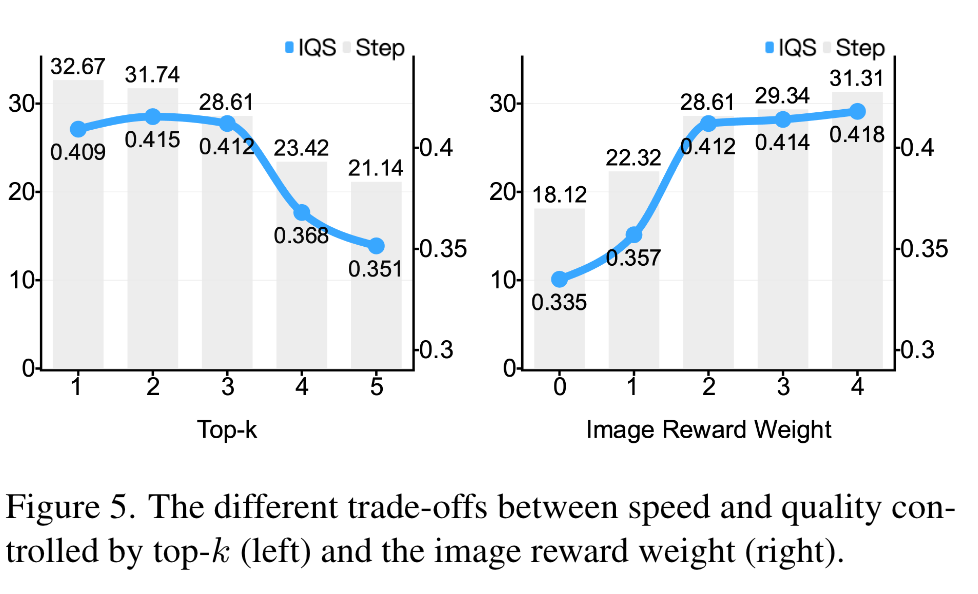
其中,λ\lambdaλ 和 γ\gammaγ 是超参数。λ\lambdaλ 用于控制图像质量,γ\gammaγ 是当生成的图像质量较低时对奖励函数施加的惩罚。

那么如何判断图像质量是低还是高呢?

这里并不是设定一个阈值,来判断好坏。
而是给定一个 prompt,然后为 steps 集合 S={10,20,30,40,50}\mathcal{S} =\{10,20,30,40,50\}S={10,20,30,40,50} 中的每一步生成一张图像;
然后看图像分数是否在这五张图像中排名前k,我们认为图像质量得分高(我们经验地将k设置为3)。

我的理解,就是看前面较小的时间 t 生成的图像是否能够排到前三,如果可以就是具有优化空间;

那么优化目标就是最大化期望奖励:
max⁡wL=Eu∼πfR(u)\max_\mathbf{w}{\mathcal{L}}=\mathbb{E}_{\mathbf{u}\sim\pi_f}R(\mathbf{u})wmax​L=Eu∼πf​​R(u)

使用策略梯度算法来学习 步长选择网络 fsf_sfs​ 的参数 www。期望的梯度推导如下:

∇wL=E[R(u)∇wlog⁡πf(u∣p)]\nabla_\mathbf{w}{\mathcal{L}}=\mathbb{E}\left[R(\mathbf{u})\nabla_\mathbf{w}\log\pi^f(\mathbf{u}\mid\mathbf{p})\right]∇w​L=E[R(u)∇w​logπf(u∣p)]

使用小批量样本,用蒙特卡罗采样进一步近似,得到:

∇wL≈1B∑i=1B[R(ui)∇wlog⁡πf(ui∣pi)]\nabla_{\mathbf{w}}\mathcal{L}\approx\frac{1}{B}\sum_{i=1}^{B}\left[R\left(\mathbf{u}_{i}\right)\nabla_{\mathbf{w}}\log\pi^{f}\left(\mathbf{u}_{i}\mid\mathbf{p}_{i}\right)\right]∇w​L≈B1​i=1∑B​[R(ui​)∇w​logπf(ui​∣pi​)]

其中,BBB 是批量大小,ui\mathbf{u}_iui​ 是从策略 πf\pi^fπf 中采样的步长选择向量,pi\mathbf{p}_ipi​ 是对应的文本提示。

Training and inference
  • 在上述训练过程之后,选择网络学习在推理时间和生成质量之间取得平衡的步长使用策略。
  • 在推理阶段,对于不同的提示,使用s中的最大概率分数来确定生成步骤的数量,从而实现动态推理。

对于视频的生成,和上述的过程类似,只是在奖励函数上有所不同,这里不再赘述。


Experiments

为了评估我们方法的有效性和通用性,我们在三个图像数据集上进行了广泛的实验:MS COCO 2017 , Laion-COCO, DiffusionDB;
以及两个视频数据集:MSR-VTT[51]和InternVid[44]。

在MS COCO 2017中,我们的训练集由118287个文本描述组成,并且使用验证集中的所有25014个文本对进行测试。对于Laion-COCO,我们随机选择200K个文本描述用于训练,20K个文本图像对用于测试。DiffusionDB的训练集和测试集的划分遵循与Laico-COCO相同的范式。

Metric

FID 、 IS、 CLIP Score,NIQE, IQS

Results
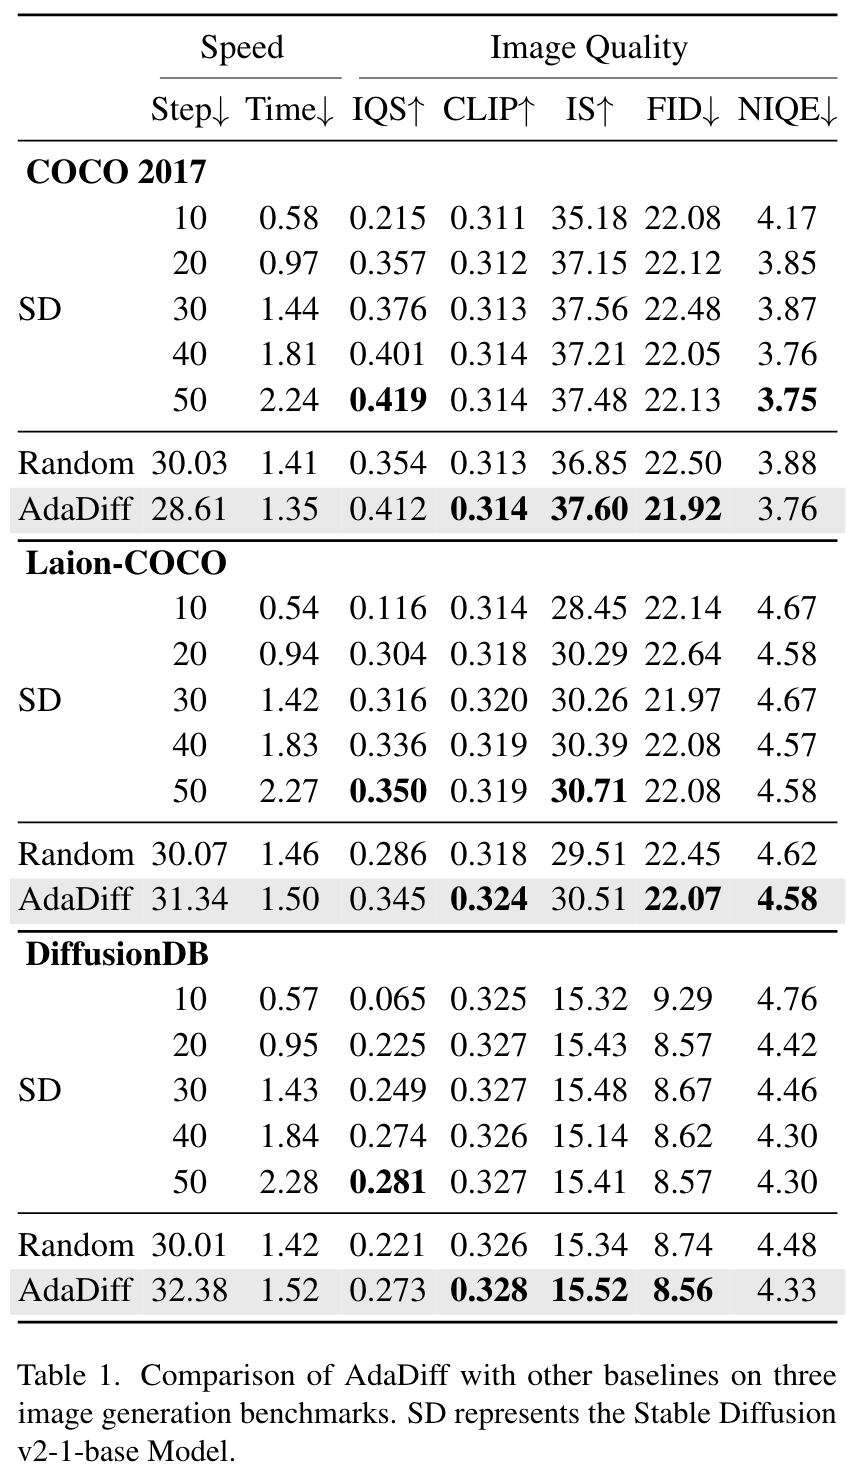
这里的 random 指的是:对不同提示使用随机步骤选择策略,我们报告5次运行使用的平均步骤。

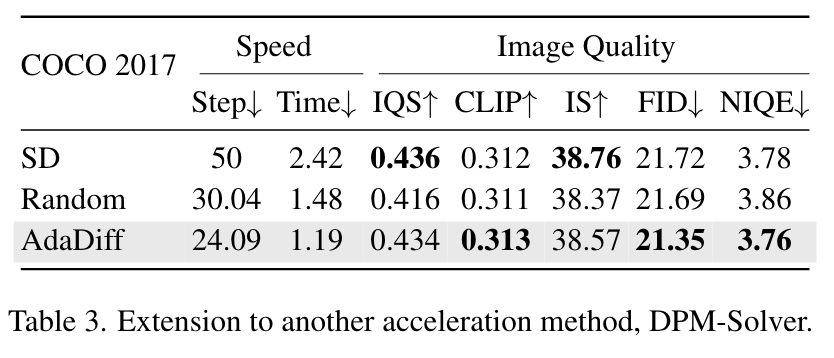
我们知道之前的扩散轨迹都是通过 ODE求解器来求解的,作者使用稳定扩散中的DPM-Solver[21]采样器来评估其在图像生成中的性能,如下表所示。与50步生成相比,AdaDiff平均为每个提示分配24.09步,进一步节省50.8% 的生成时间,同时保持相当的图像质量。
与随机策略相比,学习后的自适应策略不仅使推理时间提高了19.6%,而且在五个指标上提高了图像质量。这些结果表明,AdaDiff可以作为即插即用组件与其他加速方法相结合,用于动态生成。
实验来看,图像质量其实就是 0.0几 个点,这个说是相当。但是时间上的提升还是很明显的。
但是从这个角度来看,文本提示的丰富性难道只通过目标数量或者拥挤程度来衡量吗?从这个地方来加速,感觉有点不太合理。
AAAI 2024 | AdaDiff: 用于快速扩散模型的自适应步长选择 扩散模型作为一种生成模型,在基于文本条件生成图像和视频方面取得了令人印象深刻的成果。然而,扩散模型的生成过程涉及数十步的去噪步骤以生成逼真的图像/视频,计算成本较高。与之前设计“一刀切”加速方法不同,作者认为去噪步骤应根据输入文本的丰富程度进行样本特定的调整。为此,作者提出了AdaDiff,一个轻量级框架,旨在学习实例特定的步长使用策略,然后由扩散模型用于生成。AdaDiff通过策略梯度方法优化,以最大化精心设计的奖励函数,平衡推理时间和生成质量。 阅读详情

相关推荐

CIoU + DFL:目标检测定位精度的“双引擎”协同深度解析

在当今实时目标检测领域,YOLO系列模型凭借其卓越的速度与精度平衡,成为了工业界和学术界的事实标准之一。无论是YOLOv8、YOLO11还是未来的迭代版本,其性能的持续突破,不仅源于网络架构的创新(如C2f模块、解耦头、Anchor-Free设计),更深层次地依赖于其精巧设计的损失函数体系。其中,与的组合,被证明是提升边界框(Bounding Box)回归精度的黄金搭档。本文旨在深入剖析这对“双引擎”为何必须协同工作,而非各自为战。

浩瀚之水的专栏 41

领域论文 | DiffusionModel(扩散模型)系列论文总结

作者|eyesighting编辑| 自动驾驶之心原文链接:https://zhuanlan.zhihu.com/p/3430647040点击下方卡片,关注“自动驾驶之心”公众号戳我-> 领取自动驾驶近15个方向学习路线>>点击进入→自动驾驶之心『扩散模型』技术交流群本文只做学术分享,如有侵权,联系删文前言文总结了DiffusionModel(扩散模型)系列论文,包含:检测...

CV_Autobot的博客 2080

YOLO多任务实战,实例分割、姿态估计与目标跟踪

本文系统阐述YOLOv8多任务实战技术,涵盖实例分割、姿态估计与目标跟踪的联合实现。基于共享骨干与解耦头设计,YOLOv8通过原型掩码与关键点回归实现高效多任务推理,支持检测、分割、姿态、分类与跟踪一体化部署。文章详解网络结构、任务头设计、联合训练优化及TensorRT加速,提供可复现的完整代码流程,适用于工业视觉、智慧交通等实时多任务场景,显著降低开发与部署成本。

QQ_778132974的博客 290

ECCV 2024 超分辨率(super-resolution)方向上接收论文总结

Diffusion 和 轻量化是本届ECCV 超分辨率方向接收较多的热点方向。

yyywxk的博客 4174

<数据集>咖啡叶片病害识别<目标检测>

YOLO与VOC格式的咖啡叶片病害识别数据集,适用于YOLO系列、Faster Rcnn、SSD等模型训练,类别:Cercospora、Miner、Phoma、Rust,图片数量1744。文件中包含图片、txt标签、指定类别信息的yaml文件、xml标签,已将图片和txt标签划分为训练集、验证集和测试集,可直接用于YOLOv5、YOLOv6、YOLOv7、YOLOv8、YOLOv9、YOLOv10、YOLOv11、YOLOv12、YOLOv13、YOLOv26等YOLO系列算法的训练。

qq_53332949的博客 321

linux和mac安装+配置circos(

一定要下载完这两个包,GD才会work,要不然会报错,且-modules显示也是fail。官网的教程说的很明白,但是很多包都已经过时了需要在网上找。一般来讲,所有包的安装都不会太困难,除了GD。1.是因为官网给的链接下出来的tgz无法解压。2.我的电脑安装后GD照样是fail的。,进入这个地址下一个.tgz。第二点的原因在于,官网的情况。,进入这个地址,按部就班。GD安装困难有以下几点。搞了一天终于配置成功。

xiufan1的博客 549

高效目标检测利器:X-AnyLabeling 加载自定义 YOLO 模型自动标注实操指南

要让模型输出正确的标签,必须告诉软件你的类别是什么。这是自动标注不报错、标签不乱的核心步骤!在 X-AnyLabeling 安装目录下,找到文件夹。找到一个与你模型架构匹配的 YAML 模板(比如或复制一份并重命名(例如),用记事本打开修改关键信息:type: yolov8 # 根据你的模型填 yolov5 或 yolov8display_name: yolov8n # 你的检测模型。

Smoothly_Lu的AI博客空间 336

ARM SMMUv3设备树配置实战:从零开始为RK3588搭建IOMMU环境

本文详细介绍了在RK3588平台上配置ARM SMMUv3设备树的实战经验。从理解硬件架构、设备树节点定义,到内核驱动集成与调试,提供了完整的IOMMU环境搭建指南,并分享了解决StreamID冲突、中断配置等常见问题的技巧,帮助开发者高效完成控制器初始化。

l3m4n的博客 883

OpenCV 缩放 与 位移

【代码】OpenCV 缩放 与 位移。

ahccqw的博客 386

【电脑技巧】CPU正常运行时间过长,怎么解决?

目录 问题描述 解决方案 1、问题描述 不少同志都遇到过这样的问题:按【Ctrl + alt + delete】打开任务管理器,切到“性能”选项卡下,发现自己电脑的CPU正常运行时间竟然为好几十天!很多人担心这会不会影响电脑的寿命?于是很想知道这是怎么回事,以及如何解决这个问题。 我在此解答一下,这是由于你的电脑开启了“快速启动”这一选项的缘故,只要把这一选项关闭,问题就解决了。 2、解决方案 怎样关闭“快速启动”呢?按照如下的步骤来即可。 顺便声明一下,笔者的电脑配置: 使用电脑:联想Yoga 14

橄榄树下的孩子 3万+

AD21导出gerber文件

文件–>制造输出–>Gerber Files 文件–>制造输出–>Gerber Files 通用、光圈和高级跟第一步一样 3.文件–>制造输出–>NC Drill Files 这个默认就可以了 主要参考视频来自bilibili添加链接描述 此篇博客主要是写给自己好记的,无其他商业用途 ...

新手小杨 1万+

无人机影像落叶松林健康评估检测数据集 | 落叶松健康评估 林业病害监测 无人机航拍 密集目标检测9320期

本数据集聚焦于无人机航拍视角下的落叶松林健康状态评估与受损程度检测。 主要服务于林业病害监测、森林资源评估、火灾及风灾后的灾情定损。

qq_2529413168的博客 230

【ANSYS Workbench仿真】命令流:压力渗透pressure penetration

对与流体接触的part添加边界压力,使流体压力渗透点的接触应力与流体压力相等,以便得到真实的变形结果,就需要用到“pressure penetration”。 但是在ansys中,只能通过ADPL的形式添加,即在workbench中添加命令流的形式。此文主要介绍了**压力渗透的添加要点**和**命令流使用说明**。

路边小M's Blog 1万+

计算机视觉主要任务分类:分类、检测、分割、生成全解

计算机视觉是一个高度多样化且仍在快速扩展的领域。本文的目标是为读者提供一份关于计算机视觉四大核心任务的全面指南。我们将从定义、数学描述、评估指标、经典算法和代表应用五个维度,对每个任务进行深入剖析。全文依次讲解图像分类:计算机视觉的基石、目标检测:定位与识别、图像分割:像素级理解、图像生成:从无到有的创造、四大任务的对比与内在联系等内容。

2602_96795563的博客 366

【视频】GStreamer+WebRTC(九):使用NVIDIA硬编解码

2)下载 GStreamer-bad 插件包源码注意要下载和 GStreamer版本对应的插件包3)下载NVIDIA硬编解码SDK最新的SDK下载地址注意 GStreamer 1.24.2 中调用的 NVIDIA Video_Codec_SDK 不是最新的,先使用下面的方法,查看gst-plugins-bad-1.24.2.tar.xz 对应的NVIDIA Video_Codec_SDK 的版本是多少。

郭老二 262

基于Java+SpringBoot+微信小程序实现奶茶点单系统

再不用担心逢年过节的第一杯奶茶有没有人送了,制作一个奶茶点单系统自己当店主,开怀畅饮,一劳永逸。

商务合作 / 项目定制 / 学习交流。个人vx:lovely_wml 1万+

OpenCV 形态学处理相关知识点

整张图用一个固定阈值划分像素:大于阈值的设为一个值,小于阈值的设为另一个值。适合光照均匀、前景和背景差异明显的图像。

ahccqw的博客 266

【Burp入门第三十三篇】BurpSuite+Proxifier安装配置,实现微信小程序抓包

本文介绍Burp+Proxifier安装配置,实现微信小程序抓包

等风来 5873

智慧安防实战:电动车入梯AI识别与电梯安全联动实现

电动车入梯治理,真正考验的不是单一算法的识别能力,而是从视觉识别到业务联动的整体工程能力。从前端视频采集,到边缘端实时分析,再到语音劝阻、梯控联动和事件留痕,每个环节都需要相互配合。对于智慧安防项目而言,算法识别解决的是风险发现问题,业务联动解决的是风险干预问题。只有把两者真正连接起来,才能让原有监控设备从被动录像走向主动风险管理。

荆棘鸟智能的博客 245

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

OpenCV 图像轮廓

轮廓查找 绘制轮廓 计算面积 计算周长 approxPolyDP (多边形拟合) 作用: 用较少且平滑的直线段来近似表示一个复杂的轮廓。常用于提取物体的几何形状(如把圆角矩形简化为矩形,把五角星简化为五边形),是形状识别中非常常用的函数。参数含义: 作用: 找到能够将一个轮廓(或一堆点)完全包围住的最小凸多边形。就像是用一根橡皮筋把所有钉子(轮廓上的点)紧紧包住,橡皮筋的形状就是“凸包”。常用于检测物体的凸缺陷。参数含义: 大外接矩形 (Bounding Rectangle) 作

ahccqw的博客 144

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

tonemap算法初探

4.三边滤波(trilateral filter)通过进一步考虑梯度变化来改进边缘处行为,后续的加权最小二乘滤波、局部拉普拉斯滤波等边缘感知滤波器(EPF)沿同一思想发展,构成了局部色调映射中一条清晰的技术脉络。3.tonemap色调映射算法是未来解决HDR的图像在SDR设备上显示的问题来设计一种变换函数,其目标不是。2.HDR图像不经过任何处理,直接显示在SDR的设备上,超出显示上限的亮度被截断为纯白,低于下限。并且在压缩全局动态范围的同时,如何尽可能保留局部对比度和细节,并且抑制此过程中产生的伪影。

dong6016的博客 349

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

AI 智能美甲推荐系统技术全解析

纤长型手指修长、掌部偏窄圆形甲、椭圆甲保留修长感,避免过尖匀称型比例均衡、甲床适中杏仁甲、方圆甲适度修饰,百搭耐看圆润型手指饱满、指尖偏圆杏仁甲、梯形甲纵向延伸,显纤细宽掌型掌部偏宽、手指偏短椭圆甲、杏仁甲拉长线条,弱化宽度。

巽视达的专栏 668

INP-Former阅读笔记

Inp-Former通过从有缺陷图像中自适应提取“正常参照”(INP),利用自身正常区域构建原型,减少外部样本不一致带来的干扰。其核心流程:预训练编码器提取多尺度特征;可学习token与融合特征输入INP提取器,生成清晰的正常原型并优化一致性;解码器基于该原型重建特征,通过对比编码与重建特征生成异常距离图。最终输出上采样后的异常热力图,实现精准异常定位。

学习者的博客 188

基于 YOLOv8 的轴承缺陷检测(Web 版)

本项目是轴承表面缺陷检测模型的 Web 端实现。围绕 YOLOv8 在轴承表面缺陷数据集上完成四类缺陷的检测模型训练后,使用 FastAPI 把模型能力封装为可直接登录使用的 Web 检测平台。平台覆盖从数据准备、模型训练、指标评估,到推理服务、历史沉淀、统计分析的完整链路。除了常规的图片、批量、视频、摄像头检测,还把模型训练搬到了网页上:可以在浏览器里配置超参数发起真实训练,训练中在线调整学习率、查看实时曲线与日志,训练完成后把权重一键应用到检测服务,形成「训练 → 评估 → 检测」的闭环。

Michael_Jay的博客 250

伊蚊检测数据集 | 伊蚊检测 病媒生物 公共卫生 目标检测9304期

本数据集专注于 显微或近景视角下伊蚊及其他蚊虫的视觉检测与分类 。 主要服务于公共卫生监测、病媒生物防控及虫媒传染病预警。

qq_2529413168的博客 375

道路运输经营许可证识别技术:由计算机视觉负责“看”、自然语言处理负责“懂”,把纸质证件转化为可直接对接业务系统的高质量数据

说到底,道路运输经营许可证识别技术的价值不是"识别"本身,而是它把一张张纸质的许可证,变成了机器能读懂、系统能直接用的高质量数据。物流审核快了,监管准了,风控有底了。

智能图像识别 210
上一篇: ubuntu-docker
下一篇: DDPM(扩散模型):以自己能够理解的角度梳理一下
Toyag
博客等级 码龄8年 190粉丝 21原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
