OneDNN GEMM(AVX FP32)算法浅析

学习BLAS库 -- GEMV 函数语法: XGEMV( TRANS, M, N, ALPHA, A, LDA, X, INCX, BETA, Y, INCY)功能: matrix vector multiply BLAS level 2 functionC语言版(f2c)DGEMV源代码:/* -- translated by f2c (version 19940927). You must lin... 阅读详情

深度神经网络模型包含的计算密集型算子一般为Dense、MatMul以及Conv。对于推理引擎,其执行Dense以及MatMul算子时,一般都会调用该引擎的GEMM或者GEMV(BatchSize等于1)实现;执行Conv算子时,虽然推理引擎一般存在更好的策略,如Winograd、NCHWxC等,但大多数推理引擎也会提供GEMM策略并在一定条件下选择并执行。当卷积核各个维度的尺寸都为1时,Conv算子的执行可直接调用GEMM,当卷积核尺寸不为1时,也可以通过Im2Col将输入进行变换后,再调用GEMM获取算子的输出结果。可以认为,GEMM的执行速度将直接影响以上计算密集型算子,特别是Dense以及MatMul算子的推理效率。

OneDNN作为Intel提供的算子加速库,在x86平台上具有非常优秀的性能。一款推理引擎,如果想要在x86平台有所作为,那么OneDNN一定是其参考并且benchmark比较的对象。对于GEMM,OneDNN会根据当前运行时设备最高支持的指令集,以及算子在MNK三个维度的大小,选择不同的实现,其所设计的情况非常庞大且复杂。本文将会对OneDNN GEMM算法在FP32 AVX2指令集下的一个比较通用的分支进行描述,其代码实现详见代码文件([1])。

在以下描述中,输入A矩阵的两个维度分别为M、K,B矩阵的两个维度分别为K、N,输出C矩阵的两个维度分别为M、N。

Micro Kernel

OneDNN在AVX2指令集下采用了A(16, 8) * B(8, 6) = C(16, 6)的Micro Kernel,其计算思路如下图所示(图有点抽象):

9f4802af78e73f5c4435bae9fbe3a791.png


整个Micro Kernel的计算步骤如下:

  1. 首先通过vmovups指令将A矩阵的第一列移动到两个YMM寄存器中(这里假设为YMM0以及YMM1);

  2. 随后,对于B矩阵第一行的第一个元素,使用vbroadcastss指令进行广播并存储到一个YMM寄存器内(这里假设为YMM2),然后使用fma指令vfmadd231ps将YMM0和YMM1内的元素与YMM2内元素对应相乘,并将结果累加到C矩阵的两个YMM寄存器内,这里假设为YMM4以及YMM5;

  3. 沿着B矩阵第一行进行循环,重复步骤2,B矩阵广播当前行内其它数据时重复使用YMM2寄存器,并将计算结果依次累加到YMM6~YMM15寄存器内;

  4. A矩阵前进一列,B矩阵前进一行,并重复步骤1~3,最终完成整个C(16, 6)矩阵的计算。

总的JIT汇编循环

OneDNN总的JIT汇编代码描述了GEMM最内层的6层循环,这里将其称为汇编Kernel,其伪代码可如下所示:

// here, m_block=16, n_block=6, k_block=8
loop with m_block in M:
  loop with n_block in N:
    loop with k_block in K:
      micro_kernel()
    save_result()
  • 对于第三层对K的循环,当其完成并进行save_result时,汇编Kernel完成了一个A(16, K) * B(K, 6) = C(16, 6)的全部计算,并获得了一个分块C(16, 6)的结果;

  • 对于第二层对N的循环,当其完成时,汇编Kernel获得了一个A(16, K) * B(K, N) = C(16, N)的结果,即C矩阵的某16行;

  • 对于第一层对M的循环,当其完成时,汇编Kernel获得了一个A(M, K) * B(K, N) = C(M, N)的结果,即完成了当前全部的C矩阵计算。

由于输入M、N、K的任意性,很可能存在一些维度无法被其分块所整除的情况。这里分别进行讨论:

  • K无法被8整除的情况

对于K无法被整除的情况,OneDNN的应对策略为生成多个不同K维度的Micro Kernel,其具体效果可如下伪代码所示(省略了许多跳转和判断细节,下同):

loop with m_block in M:
  loop with n_block in N:
    loop with k_block in K:
      micro_kernel_k8()
    micro_kernel_k4()  // call one or zero times
    micro_kernel_k2()  // call one or zero times
    micro_kernel_k1()  // call one or zero times
    save_result()

当K无法被8整除时,其会依次判断剩余k值是否大于4、2、1并调用相应Micro Kernel进行最后的计算(如剩余5,将调用4、1一次,2零次)。

  • N无法被6整除的情况

对于N无法被6整除的情况,OneDNN的应对策略与K相似,继续生成对应维度循环的汇编代码,其具体效果可如下伪代码所示:

loop with m_block in M:
  loop with n_block in N:
    loop with k_block in K:
      micro_kernel_n6k8()
    micro_kernel_n6k4()  // call one or zero times
    micro_kernel_n6k2()  // call one or zero times
    micro_kernel_n6k1()  // call one or zero times
    save_result()
  // deal with remain n
  if remain_n == 5:
    loop with k_block in K:
      micro_kernel_n5k8()
    micro_kernel_n5k4()
    micro_kernel_n5k2()
    micro_kernel_n5k1()
    save_result()
  if remain_n == 4:
    loop with k_block in K:
      micro_kernel_n4k8()
    micro_kernel_n4k4()
    micro_kernel_n4k2()
    micro_kernel_n4k1()
    save_result()
  ...
  if remain_n == 1:
    loop with k_block in K:
      micro_kernel_n1k8()
    micro_kernel_n1k4()
    micro_kernel_n1k2()
    micro_kernel_n1k1()
    save_result()
  • M无法被16整除的情况

对于M无法被16整除的情况,其处理相比于K、N要更复杂一些。当剩余M不为8时,直接使用vmovups加载A矩阵数据将会造成错误加载后续数据以及数组访问越界两个问题,以上两个问题在存储C矩阵时同样存在。针对这一情况,OneDNN在加载A矩阵以及存储C矩阵时采用了mask系列指令,同时通过使用mask,当M无法被16整除时,其剩余维度的处理就可以分为三个分支了:9<=M<=15(Micro Kernel中使用一条vmovups指令以及一条vmaskmovps指令移动数据),M=8(Micro Kernel中使用一条vmovups指令移动数据)以及1<=M<=7(Micro Kernel中使用一条vmaskmovps指令移动数据)。

最终,整个汇编Kernel的伪代码将如下所示:

loop with m_block in M:
  loop with n_block in N:
    loop with k_block in K:
      micro_kernel_no_mask_m16n6k8()
    micro_kernel_no_mask_m16n6k4()  // call one or zero times
    micro_kernel_no_mask_m16n6k2()  // call one or zero times
    micro_kernel_no_mask_m16n6k1()  // call one or zero times
    save_result()
  // deal with remain n
  ...

if 9 <= remain_m <= 15:
  loop with n_block in N:
    loop with k_block in K:
      micro_kernel_with_mask_m9to15n6k8()
    micro_kernel_with_mask_m9to15n6k4()
    micro_kernel_with_mask_m9to15n6k2()
    micro_kernel_with_mask_m9to15n6k1()
    save_result()
  // deal with remain n
  ...

if remain_m == 8:
  loop with n_block in N:
    loop with k_block in K:
      micro_kernel_no_mask_m8n6k8()
    micro_kernel_no_mask_m8n6k4()
    micro_kernel_no_mask_m8n6k2()
    micro_kernel_no_mask_m8n6k1()
    save_result()
  // deal with remain n
  ...

if 1 <= remain_m <= 7:
  loop with n_block in N:
    loop with k_block in K:
      micro_kernel_with_mask_m1to7n6k8()
    micro_kernel_with_mask_m1to7n6k4()
    micro_kernel_with_mask_m1to7n6k2()
    micro_kernel_with_mask_m1to7n6k1()
    save_result()
  // deal with remain n
  ...

Pack And Copy Strategy

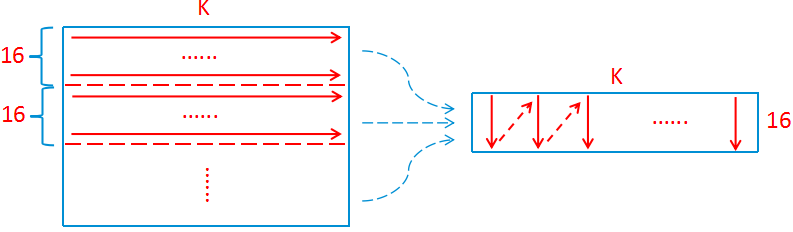
对于Micro Kernel,其要求A矩阵的元素必须按列存储在内存中。但A矩阵的元素可以按行来进行存储。OneDNN对于上述情况对A矩阵进行了Pack操作。以上操作在使A矩阵满足计算要求的同时,其最主要的贡献还是在计算过程中对于A矩阵的加载能够获得更好的局部性,并能够充分利用CPU的硬件Prefetch能力以减少访存带来的fma流水线气泡。

在对A矩阵进行Pack时,OneDNN没有直接开辟一个M*K*sizeof(float)字节的内存空间。在汇编Kernel循环中,注意到对于M的循环是在最外侧的,因此这里只需要开辟一个16*K*sizeof(float)的内存空间即可。在每一次M循环的起始,OneDNN对当前使用的A(16, K)进行一次Pack操作,随后便可以一直使用直到下一次的M循环。

以上Pack操作可如下图所示:
d5bdc087f3c92e7c74a1e0113b135a3a.png

Pack

当A矩阵已经是按列存储的情况下,还需要进行Pack操作吗?答案是需要的,因为Pack操作能够加速GEMM计算过程。OneDNN把A矩阵按列存储下的Pack称为Copy操作,其实现是非常有意思的。在计算第一个A(16, K) * B(K, 6) = C(16, 6)的block时,OneDNN每一次都在读取A矩阵数据至YMM0以及YMM1寄存器的同时,将数据又拷贝至内存空间的对应位置,这一过程可以同时使用软件Prefetch指令进行加速。随后,在计算C矩阵当前16行的剩余列时,则不再从A矩阵读取数据,而是从内存空间中读取。

这里存在一个问题,如果N的值过小,例如6,那么在计算了一个C(16, 6)之后,我们下一次计算的将会是C矩阵下一个16行的6列元素,即拷贝过程变成了完全的无用功。OneDNN在这里进行了一个判断并设置了一个阈值18,即当N的值小于等于18时,其认为拷贝A矩阵带来的开销会大于随后使用A矩阵时加载连续内存空间带来的收益,不会执行拷贝操作;当N大于18时,其才会使用上述策略。

总循环

最后再来看一下总的循环,其伪代码如下所示:

loop with k_outer_block in K:
  loop with m_outer_block in M:
    loop with n_outer_block in N:
      assembly_kernel()

总的循环非常简单,就是循环K、M、N三个维度,并调用上面我们JIT产生的汇编Kernel。这里值得注意的有两个方面,一个是外层循环的顺序,使用了K、M、N;另一个则是三个外层循环分块数的取值。

一般来说,我们希望汇编Kernel进行计算的过程中,其当前处理的A、B、C三个矩阵块都至少能够保存在L2 Cache中,以加速循环计算。因此,以上三个分块的大小与当前运行环境的L2 Cache尺寸是密切相关的,一个好的做法是通过系统调用获取当前运行环境的L2 Cache尺寸,并通过经验公式进行计算获得比较理想的分块值。OneDNN没有采用上述方法,其将分块值直接进行了固定,对于N的分块,如果A矩阵转置,其取值为96,否则为48;对于K的分块,如果B矩阵转置,其取值为96,否则为256;对于M的分块,其直接固定为4032。

总结

本文对OneDNN GEMM(AVX FP32)的算法流程进行了描述,其中省略了一些细节,如果大家感兴趣,推荐结合上文的源码链接阅读本文。同时如果大家对本文有其它想法,也希望能够积极留言,讨论交流。

欢迎加入Adlik交流群、关注Adlik仓库~
4d851d6073496e25123944a70f5aec33.png

Adlik微信交流群

8390aea0cb7828613d80eaeb07661c36.png

Adlik Github仓库

[1]https://github.com/oneapi-src/oneDNN/blob/v2.6/src/cpu/x64/gemm/f32/jit_avx_gemm_f32.cpp

AMD Ryzen本地部署LLM实战:CPU推理的内存带宽与AVX-512优化指南 大语言模型(LLM)本地推理不再依赖GPU,CPU已成为高性价比、低功耗、静音可靠的主力平台。其核心瓶颈已从单纯算力转向内存带宽吞吐、向量指令集效率(如AVX-512/BF16)及多级缓存协同能力。AMD Ryzen 7000/8000系列凭借原生AVX-512支持、双通道DDR5-6000实测近90 GB/s带宽、超大共享L3缓存(104MB)以及Ryzen AI NPU+iGPU混合卸载架构,在Qwen3.5-32B、Llama 3-70B等主流模型上实现稳定38+ tokens/s输出与极低延迟抖动。 阅读详情

相关推荐

Intel平台部署Llama 2:CPU/GPU优化实战与性能调优指南

深度学习推理部署常面临硬件资源限制的挑战,尤其是在非NVIDIA平台上。其核心原理在于通过软硬件协同优化,最大化利用现有计算单元的并行处理能力。这一技术价值在于显著降低大模型本地部署的门槛和成本,使更多开发者和企业能够在现有Intel设备上运行AI应用。具体到应用场景,无论是搭载集成显卡的轻薄本,还是配备至强处理器的工作站,通过指令集加速、异构计算和模型量化等技术,都能实现高效的大语言模型推理。本文聚焦于Llama 2模型在Intel平台上的部署,详细解析如何利用AVX-512/AMX指令集、Intel G

weixin_33906657的博客 389

BLAS之GEMM和GEMV

BLAS简介 BLAS全称是Basic Linear Algebra Subprograms是规定了一套低级的执行常见线性代数操作的规范。其实现经常针对特殊的机器进行优化,比较著名的·BLAS库有ACML, ATLAS, MKL, OpenBLAS。许多常见的数值软件均采用兼容BLAS规范的实现库来进行线性代数计算,比如Matlab, Numpy, Mathematica`。 其中,Level 1 BLAS主要提供向量操作 Level 2 BLAS提供矩阵向量操作(gemv) gemv

永远飞翔的鸟 1万+

AI推理引擎内存布局优化:突破内存墙,提升计算效率的底层实践

在计算机体系结构中,内存访问效率是决定计算性能的关键瓶颈之一,尤其在高性能计算和AI推理领域。其核心原理源于局部性原理,即通过优化数据在内存中的排布方式,使数据访问模式符合计算硬件的偏好,从而减少缓存缺失和内存访问延迟。这项技术的核心价值在于,它能在不改变算法逻辑的前提下,显著提升数据处理吞吐量和降低延迟,是释放硬件算力的重要手段。其应用场景广泛,从云端服务器到边缘设备,凡是涉及密集张量计算的AI模型推理,如计算机视觉和自然语言处理任务,都需要考虑内存布局的优化。本文聚焦于推理引擎中的内存布局优化,深入探讨

weixin_30675247的博客 338

GEMM vs GEMV

gemm gemv 比较 tensorflow的实现

qq_30006593的博客 4243

cublas_benchmarks:一些测试gemm和gemv性能的基准

cublas_benchmarks:一些测试gemm和gemv性能的基准

手把手教你用Qt和QScada框架,从零搭建一个简易的工业组态监控界面

本文详细介绍了如何使用Qt和QScada框架从零搭建工业组态监控界面,涵盖环境配置、界面设计、动态数据绑定及高级功能实现。通过实战案例演示,帮助开发者快速掌握SCADA系统开发技巧,提升工业自动化项目的开发效率。

weixin_32932149的博客 340

Nvidia CUDA Core-CUDA HGEMV优化

在深度学习模型特别是LLM(Large Language Model)的推理优化中,HGEMV(Half-precision General Matrix Vector Multiplication)半精度矩阵向量乘法的优化日趋重要。然而Cublas没有提供直接计算HGEMV的API,只能使用cublasGemmEx等相关API来间接调用Tensor Core计算HGEMV。

https://www.zhihu.com/people/mu-zi-zhi-6-28 1276

HFSS 3D Layout一键导入PCB,高效搞定微带线损耗仿真

在高速PCB设计中,信号完整性与电磁仿真是确保链路质量的关键环节。传统的HFSS手动建模流程繁琐且极易出错,尤其面对微带线、带状线等高频结构时,叠层参数、铜箔粗糙度等细节难以精准还原,导致仿真结果与实测偏差较大。HFSS 3D Layout模块提供了从EDA工具直接导入PCB文件的能力,完整保留走线、过孔、叠层及材料属性,结合精确的介质损耗模型与端口设置,大幅缩短建模时间并提升仿真精度。该技术广泛应用于DDR、SerDes等高速数字链路的设计验证,以及SI/PI工程师对PCB损耗性能的快速评估。本文从导入操

weixin_29191081的博客 254

【CUDA】Sgemm单精度矩阵乘法(上)

【CUDA】Sgemm单精度矩阵乘法(上)

周同学的博客 2352

Isaac Sim仿真平台学习(2)系统架构

isaac sim系统架构

weixin_75067193的博客 2698

AAAI 2025杰出论文解读:神经符号推理与生物多样性计算的突破性进展

本文深度解读了AAAI 2025两篇杰出论文的突破性进展。南京大学周志华团队提出“溯因反射”框架,高效解决神经符号推理中的“不一致性”核心难题,为构建可靠、可解释的AI系统提供了新路径。斯坦福大学等机构的DiVShift研究,则系统分析了公民科学数据中的复杂分布偏移,为利用海量数据精准监测生物多样性及应对AI数据偏差提供了关键方法论。

weixin_29085865的博客 501

oneDNN性能优化实战:卷积、矩阵乘法等核心算子极致性能调优

oneAPI Deep Neural Network Library (oneDNN) 是一个针对深度学习应用优化的高性能计算库,特别专注于卷积、矩阵乘法等核心算子的性能调优。本文将深入探讨如何通过内存布局优化、低精度计算、JIT编译等关键技术,充分发挥oneDNN在CPU和GPU上的计算潜力,帮助开发者实现神经网络推理与训练的极致性能。 ## 一、内存布局优化:数据访问效率的核心 内存布局是

gitblog_02399的博客 820

STM32水质检测小船设计

近年来水资源的监测与保护越来越受到政府部门的重视,抓好源头问题才能做好环境治理,因此建立完善的水环境监测系统是很有必要的。针对当前水环境参数监测中存在的各种问题,例如水质信息采集范围固定、灵活部署监测能力差、信息采集不够智能化、人机交互能力不足等,这些问题导致水环境监测设备不够灵活。 针对上述问题,本文设计了一款基于STM32的水环境监测小船,提出了一种灵活、智能的监测水环境信息的方式。本文将船体作为传感器和控制板的载体,具有可移动性,有利于灵活广泛的采集水环境信息。 本设计选用STM32F103C8T

m0_74026776的博客 1368

Intel Extension for PyTorch 完整指南:让 LLM 推理加速与训练提速跑在 Intel CPU 上

在纯 Intel CPU 上跑 PyTorch,默认行为基本只把矩阵运算当标量循环处理,AVX-512 和 AMX 这类硬件指令一条都没用上。Intel Extension for PyTorch(下称 IPEX)通过 `ipex.optimize()` 一行调用,把模型改写为能吃到 oneDNN 优化内核和半精度加速的版本;对于 LLM 场景,还有专门的 `ipex.llm.optimize()

gitblog_00330的博客 989

KEPServerEX 6 之驱动协议(UDD)实战 HTTP协议对接OpenWeatherMap天气 API全流程指南

本文分享了基于 KEPServerEX 6 的通用设备驱动(UDD)对接OpenWeatherMap天气API的实战方案。该方案针对工业物联网场景进行了深度优化,具有动态城市切换、运行时热配置、老旧JS引擎兼容等核心特性。文章详细介绍了从环境准备、脚本部署到Tag配置的全流程,重点解析了Legacy JS语法适配、Float类型安全处理等关键实现细节,并提供了完整的避坑指南和故障排查方法。该方案经过生产环境验证,可稳定实现气象数据采集与动态切换功能,适用于SCADA/MES系统集成场景。

-雲飛兄-博客 712

13. MIC配置

恒玄BES2700,支持3个MIC。

雪飞_海 925

MLIR编译器自动生成高性能矩阵乘法微内核技术解析

矩阵乘法(GEMM)是机器学习和高性能计算中的核心算子,其性能优化对计算效率至关重要。传统方法依赖手工编写硬件特定内核或专用库,存在开发复杂度高和可移植性差的问题。现代编译器技术如MLIR(Multi-Level Intermediate Representation)通过多层次IR设计,实现了从高级算子到硬件指令的自动化映射,显著提升了性能优化的效率和可维护性。MLIR支持高层优化(如算子融合)、中间层优化(如循环分块)和底层优化(如指令选择),特别适用于混合精度计算(如BF16、FP16)的数据布局转换

aebe49167的博客 388

用生成式AI自动生成测试用例的完整教程

本文旨在帮助测试工程师、开发人员快速掌握“生成式AI自动生成测试用例”的核心技术,覆盖从概念理解、工具选择到实战落地的全流程。无论是Web应用、API接口还是移动端功能测试,你都能找到可复用的方法。本文将按照“概念→原理→实战→避坑”的逻辑展开:先通过生活案例理解生成式AI如何生成测试用例,再拆解核心算法原理,接着用Python代码演示完整生成流程,最后分享实际应用中的优化技巧和未来趋势。生成式AI:能“创造内容”的AI模型(如ChatGPT、CodeLlama),像会写作文的智能笔。测试用例。

AIGC应用创新大全的博客 1580

Pytorch 学习笔记(4) : torch.backends

函数/属性说明DEFAULTVSXZ VECTORNO AVXAVX2AVX512SVE256查询硬件能力- 了解 CPU/GPU 支持特性控制计算精度- TF32、fp16/bf16 归约精度选择计算后端- cuBLAS/cuBLASLt、cuSOLVER/MAGMA 等优化注意力计算- Flash Attention、Memory Efficient Attention 等调试性能问题- MKL/oneDNN 按需详细日志!

ZhiqianXia 224

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

LNPopupUI核心概念详解:Popup栏、Popup内容与PopupItem的4大关键区别

LNPopupUI 是一个专为 SwiftUI 打造的弹窗组件库,让你轻松复刻苹果音乐、播客 App 中那种优雅的"底部 Popup 栏"交互:底部常驻一个迷你控制条,点开即是全屏内容视图。很多新手刚接触 LNPopupUI 时,最容易混淆的就是 **Popup Bar(弹窗栏)**、**Popup Content(弹窗内容)**、**PopupItem(弹窗条目)** 这几个概念。本文将用最直白

gitblog_00820的博客 293

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Intel Extension for PyTorch 实战:PyTorch CPU 推理与训练加速指南

Intel Extension for PyTorch(简称 IPEX)是一个扩展官方 PyTorch 的 Python 包,专门解决深度学习模型在 Intel CPU 上"开箱即用但跑不满硬件"的痛点。它基于 oneDNN 对算子做融合与预编译,自动利用 AVX-512、AMX 指令集和 bfloat16、INT8 低精度路径——你只需在训练或推理脚本里加几行代码,就能拿到可观的 PyTorch

gitblog_00580的博客 634

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Gemma-3n:首款原生CPU推理大模型架构解析

大语言模型推理正从GPU依赖转向CPU原生适配,其核心在于突破传统‘迁移优化’范式,转而围绕x86/AMD CPU的缓存层级、AVX-512/VNNI指令集与内存带宽等硬件特性深度重构。Gemma-3n作为该趋势的标志性实践,通过cache-aware权重布局、分块稀疏Attention、int8量化+RMSNorm查表加速等技术,显著提升L3缓存命中率与IPC效率,实现无独显、低内存(1.8GB)、低延迟(820ms)的稳定本地推理。它不仅支撑教育、开发、边缘部署等轻量级场景,更重新定义了‘CPU-fri

weixin_32767591的博客 581

CPU上的INT4量化推理:内存带宽才是真正的性能瓶颈

在大模型部署中,量化是降低推理成本的关键技术之一。当模型权重从FP16压缩到INT4时,计算强度骤降,通用CPU上的推理瓶颈便从算力悄然转移至内存带宽。算术强度分析表明,低精度GEMM算子多为访存受限,单纯依赖SIMD计算能力的提升已无法带来预期的延迟下降。通过perf stat与STREAM基准测试,可以精准定位带宽瓶颈。针对该问题,工程上常以cache分块、算子融合、软件预取、NUMA感知与内存布局优化为核心,系统性提升数据复用率并压榨DRAM带宽。此类优化在端侧及服务器端CPU推理场景中意义重大,能够

weixin_34122604的博客 381

算法优化:以加法换乘法的性能提升策略与实战

在计算机体系结构与算法设计中,乘法运算因其硬件电路复杂、时钟周期长,常成为大规模计算(如矩阵运算、卷积处理)的性能瓶颈。其核心原理在于利用数学变换重构计算过程,以成本更低的加法操作部分替代昂贵的乘法,从而在保证结果正确性的前提下,显著提升计算效率。这种‘以加换乘’的技术价值在于能从根本上降低算法复杂度,尤其适用于高性能计算、深度学习推理和嵌入式信号处理等场景。例如,通过复用中间结果(如高斯复数乘法优化)或设计分治策略(如施特拉森矩阵乘法),可将计算资源重新分配。本文聚焦于这类减少乘法次数的优化算法,深入剖析

weixin_30596165的博客 342

vLLM CPU 后端 x86 平台安装指南:预编译 Wheel、源码编译与 Docker 部署实践

本指南面向需要在 **x86 CPU(Intel / AMD)平台**上运行 vLLM 推理与在线服务的开发者,完整覆盖四条从简到繁的安装路径:直接使用官方预编译 Wheel、从源码自行编译、使用 Docker 预编译镜像、以及为特定目标 CPU 或 AMD Zen 平台自建镜像。读完本文你将掌握:如何用 `uv`/`pip` 干净地搭建 CPU 版环境、为什么必须设置 `LD_PRELOAD`

gitblog_01179的博客 386

i5-14600KF上YOLOv8推理性能实测:PyTorch、ONNX、OpenVINO三框架深度对比

目标检测模型推理性能受框架抽象层级、硬件指令集支持与运行时优化深度共同影响。ONNX作为标准化中间表示,通过ONNX Runtime等专业推理引擎可剥离Python开销、启用AVX-512加速及图融合优化;而OpenVINO虽定位为Intel硬件感知编译器,但其实际效能高度依赖对最新CPU架构(如Raptor Lake)的准确识别与FP16/AVX-512协同支持。在无GPU的纯CPU边缘部署场景下,模型格式选择本质是计算图固化程度、内存访问效率与线程调度策略的综合权衡。本文基于i5-14600KF平台,聚

weixin_33910385的博客 328
上一篇: Facebook data-efficient transformer模型介绍
下一篇: Adlik Eagle版本发布,更快、更优、更简单
Linux基金会AI&Data基金会
博客等级 码龄6年 100粉丝 47原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Linux基金会AI&Data基金会

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值