QUIK:LLM上的一种4-bit推理方法

从零构建 AI Agent:LLM 大模型应用开发实践 资源下载链接为: https://pan.quark.cn/s/5e4e66b890a4 (最新版、最全版本)从零构建 AI Agent:LLM 大模型应用开发实践 立即下载

论文概述

 论文提出了一种叫做 QUIK 的混合量化策略,QUIK 把大部分的激活和权重量化为 4-bit,通过校准数据集进行激活进行统计,把一些 outliers 激活和对应的权重用 FP16 表示。该机制的特点是计算高效,同时能保持很好的精度。通过 QUIK,端对端吞吐量能达到 FP16 的 3.4 倍。论文研究了 OPT 模型、LLaMA-2 模型和 Falcon 模型,在推理时,除了量化,还进行了 2:4 稀疏的尝试。

   同时,论文还指出对 LLaMA 类模型,如 LLaMA-2 模型,down-project 对量化更加敏感,对激活权重不进行 4-bit 量化,而改用 8-bit 量化,对保持模型的精度非常重要。

   下图是 LLaMA-2 模型使用 QUIK 量化后的效果,对 70B 模型,精度降低在 0.5 PPL 以内,70% 的线性层使用 INT4 进行计算,带来了端对端 3.4 倍的加速。
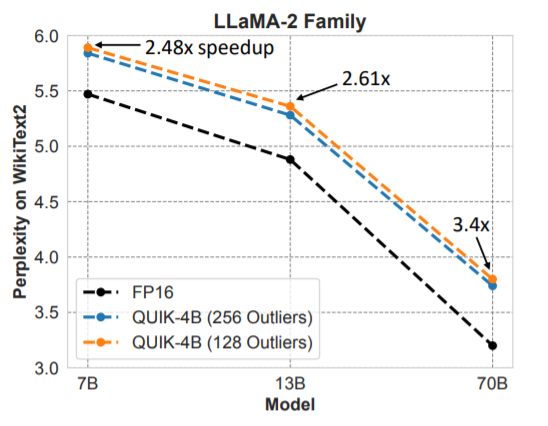
fa71f2dfa35f7c37090db5b71d7728e1.png

论文细节

动机

论文关注于计算受限的场景。

NVIDIA GPU 本来就支持 INT4,INT8 计算,下图是不同矩阵大小下不同数据类型矩阵乘法的吞吐量。从图可以看出,INT8 的吞吐量是 FP16 的 2 倍,而 INT4 是 INT8 吞吐量的 2 倍。要利用这种硬件特性,激活和权重必须量化为相同的数据类型。但是目前,把权重和激活都量化成 INT4,会带来较大的精度损失,基于此,QUIK 致力于提出一种能够把权重和激活都压缩成 INT4 数据类型的高精度的 PTQ 量化方法。
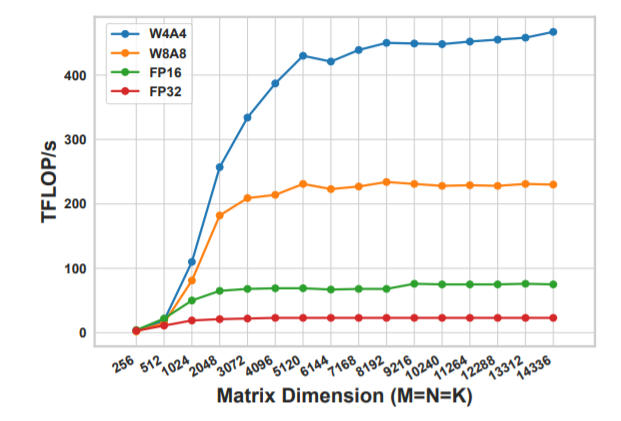
3c1364528ed52747a8d41282d4e0c952.png

QUIK量化

1. QUIK量化工作流

线性变换可以表示为:$X W^T$

QUIK 的工作流如下图,由于 outliers 总是出现在激活的固定的列,step1:可以通过校准数据集统计激活,step2:把激活的 outliers 放到最后,对应调整权重矩阵的列的分布。step3:对权重$W$进行 GPTQ INT4 量化,GPTQ 更新权重的范围是整个$W$,但是量化的范围是 outliers 之前的列,groupsize = -1。这样量化误差就补偿到了 outliers 里。

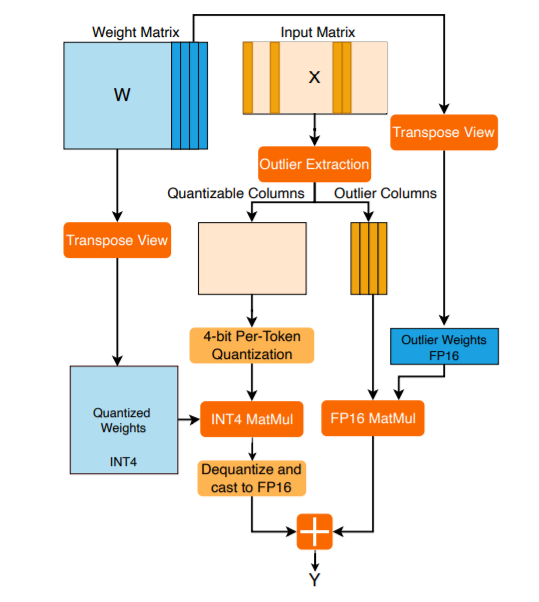
后面的步骤下图就没有显示了。后面首先对激活的正常列进行 per token 量化。量化完成后,激活权重的正常列进行 INT4 矩阵乘,再反量化为 FP16 值,outliers 进行 FP16 的乘法。最后把正常部分的结果与 outliers 的结果相加作为最后的结果矩阵。

总体而言,激活是非对称 per token 动态量化,权重是对称静态 GPTQ 量化。

通过这样的工作流,GPTQ 量化把量化误差累积到那些用 FP16 计算的列,并且避免了 INT4 量化那些量化困难的列。
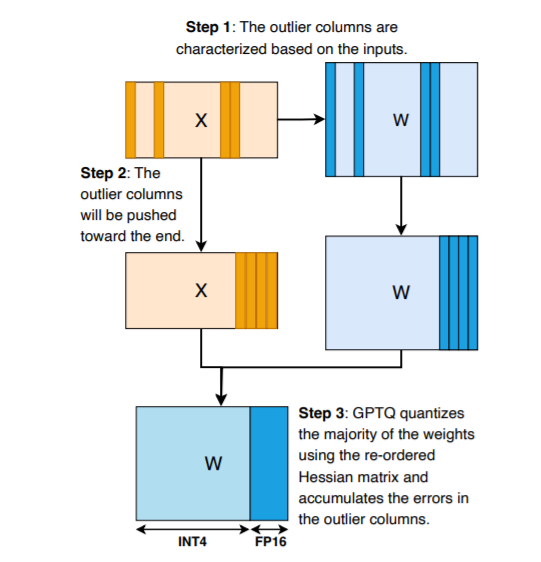
fce9ac9b11b56c08b4c63d902b9397a7.png

2. 权重裁剪

在进行 GPTQ 量化,计算量化参数前,使用 linear search 的方式来确定 weight clipping 的 threshold,这样可改善 PPL。

3. 基于敏感度的部分量化

通过列的无穷范数(元素绝对值的最大值)来选择 outliers。对 outliers 保持 FP16 不量化。outliers=256。

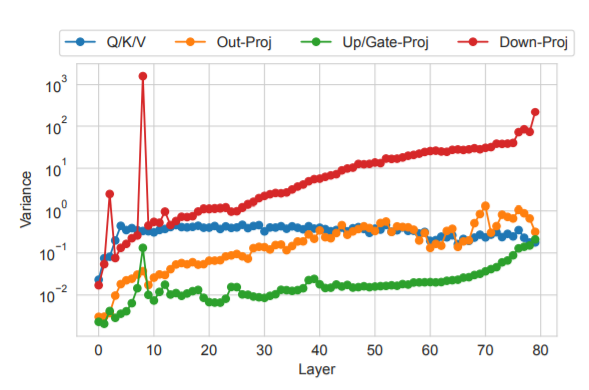
上面的做法对 OPT 模型来说,已经能保持足够的精度了,但是对 LLaMA2-70B 模型模型是不够的。这主要由于在 FeedForward 层,有 3 个线性转换,其间包含了按元素相乘和 SiLU 激活函数。下图是不同层激活的方差分析,可见 Down_proj 层对量化更敏感,为了恢复量化精度,Down_proj 使用 INT8 量化。
d1912a1a4cea869c44af270df0aa8813.png

4. 高效推理实现

推理实现的示意图见下图,该图展示了 QUIK-4B 前向推理时线性层的实现方式。
ec8e04003847de5770eb543a0052818d.png

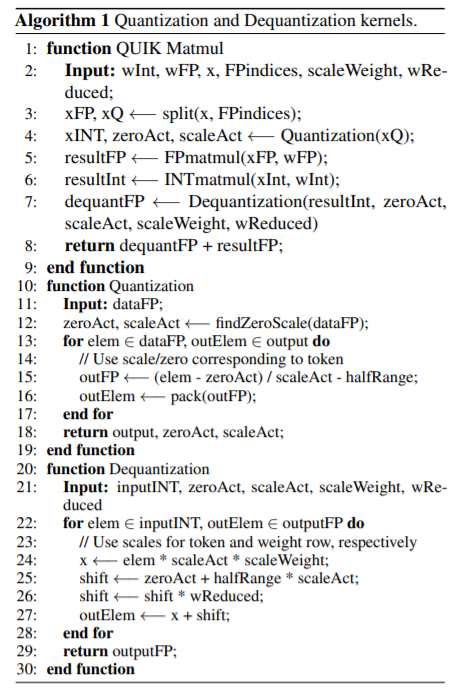
具体算法见下图。Line 6 的矩阵乘法是利用 CUTLASS 进行的,能高效的利用硬件的 INT8/INT4 tensor-cores 进行快速低精度计算,结果用 INT32 进行累加。
a1fb8047a03a87eccfda271e9a89f9d2.png

实验结果

1. 4-bit PPL 精度 与 zero-shot 任务  

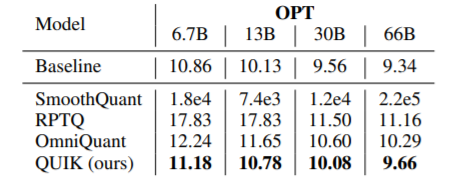
下表是 4 个 OPT 模型使用不同的量化方法在 WikiText2 任务上的效果。在 QUIK 中,每一层线性层都使用了统一的 256 个异常点,除了异常点,其他权重和对应激活都量化成 INT4。可以看出,QUIK 在精度上取得了比之前的量化方法都好的效果。
d234abf6e8b34ced3f0a12ed3a1867c5.png

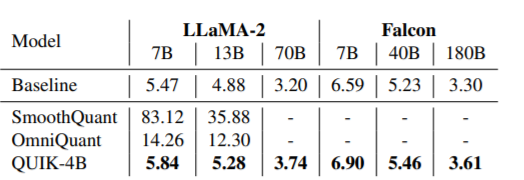
下表是把 QUIK 用在了 LLaMA-2 和 Falcon 模型上,同样是 WikiText2 任务。和 OPT 模型一样, 每个线性层都使用了 256 个异常点。不同在于,对 LLaMA-2 的 down-projection 层和 Falcon 的 FC2 层使用了 INT8 量化,并且按这些层的输入特征数成比例的增大了 outliers 数量。可以看出,QUIK 也取得了较好的效果。( QUIK-4B 表示 4-bit QUIK 量化)
47eaaa3e310b393071b7146bb9226c46.png

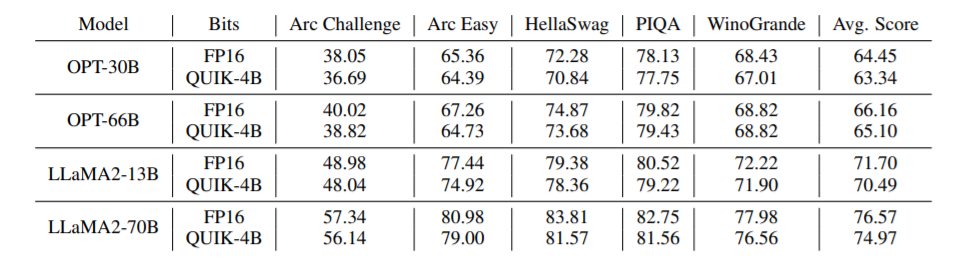
下表是 QUIK 在一些 zero-shot 任务上的效果。

28c9205aeeae4ae8e808e96d5d12e6a8.png

2. 8-bit 量化 (QUIK-8B)

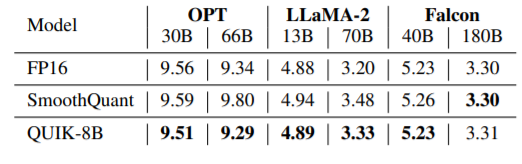
下表对比了 QUIK-8B 和 SmoothQuant 在 OPT, LLaMA-2, Falcon上的效果。  虽然两种方法都接近无损了,但是 QUIK 的效果更好点。
7bfb385a798706d6cf675adf89f7237c.png

性能分析

1.  峰值显存使用

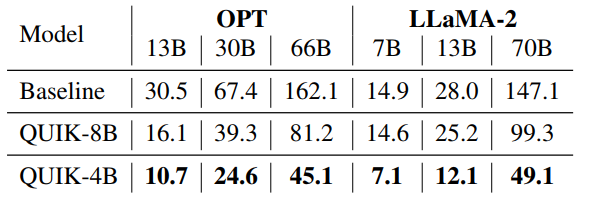
对 OPT-66B 模型,QUIK-8B 和 QUIK-4B 的模型分别降低了 47%(理想情况是 50%)和 74%(理想情况是 75%)的峰值显存使用。

对 LLaMA2-70B 模型,QUIK-8B 和 QUIK-4B 的模型分别降低了 32% 和 67% 的峰值显存使用,因为在 LLaMA2-70B 中,down-project 使用了 8-bits 并使用了额外的 outliers。具体见下表。
8c5253ba2ce3ad970496e7fb257c8a27.png

2. 层加速

理想的层加速见**动机**章节,没有考虑量化/反量化开销。

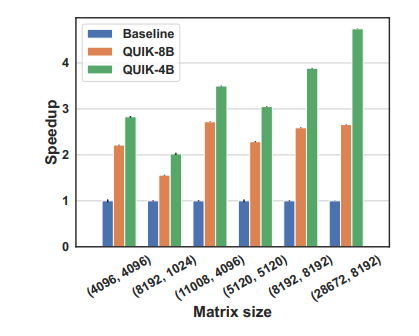
QUIK 的实际层加速见下图(QUIK-4B 每层使用 256 个 outliers, 在单个 RTX3090 上进行测试)。可见 QUIK-4B 在大的层上能达到高于 4 倍的层加速,在小的层上能有 2 倍多的层加速。
0655d60fdcb7cd0c71c7532c983d41f5.png

3. 端到端加速

QUIK-4B 使用 256 个 outliers 除了down_project 层(8-bit 量化,使用超过 600 个 outliers)。

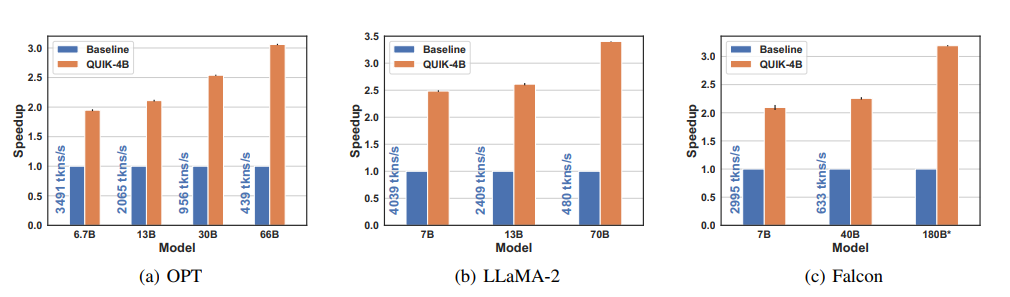
从下图可见,OPT-66B 模型除了能减少接近 4 倍的内存,吞吐量是 FP16 的3.05倍。LLaMA2-70B 模型吞吐量是 FP16 的 3.4倍。
d9bc99eb89bdab1a3708a0be289e2ae6.png

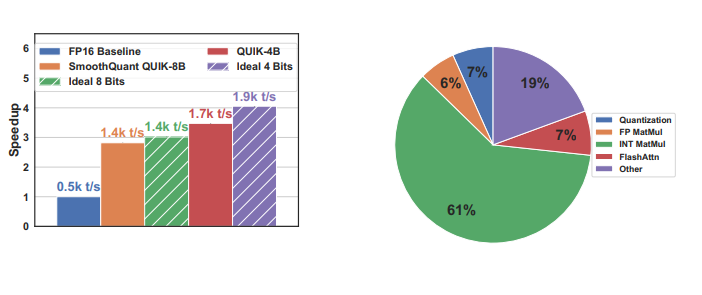
这些加速都仅仅是 QUIK 对线性层的加速带来的。从下图的右图可见,当大部分计算都是 4-bit 精度时,attention,softmax,layernorm 的开销所占的比例就比较大了(19%)。
d5a1cf35bcd16fe281691250936efdf2.png

上图左图 Ideal 8-bits 和 Ideal 4-bits 是指直接使用 8-bit 核和 4-bit 核,而不考虑保持精度(即没有 outliers)

从上图可见 8-bit 实现提供了接近理想的加速。部署时,GPU 从 FP16 的 7 个降低为 5 个。

QUIK-4B 比 QUIK-8B 吞吐量提高了 15%,部署时,GPU 数降为了 3 个,显存只需要不到 50GB。为了保持精度,使用 outliers 和 8-bit 量化 down-project,使得 QUIK-4B 的吞吐量和理想的 4-bit 相比,下降在 15% 以内。目前还不知道权重激活全部 4-bit 量化,能够恢复精度的方法。

论文存在的问题

论文源码使用模拟的方式测出的 QUIK-4B 的 PPL 不准确

笔者使用论文源码进行了一些测试。发现使用源码提供的模拟方式(--sim_eval)测出的 PPL 与使用核(--kernels_eval)测出的 PPL 不一致的,特别对 CodeLLaMA 模型在 4-bit 量化时。笔者按照论文中的描述方式自己实现了模拟量化,与 QUIK 核测试结果一致。

模型

论文源码模拟量化的 PPL

论文 QUIK kernel PPL

论文 QUIK kernel PPL

LLaMA2-7B QUIK-4B

5.831  

5.828(-0.003)

LLaMA2-13B QUIK-4B  

5.281    

5.478(+0.197)  

CodeLLaMA-34B finetune QUIK-4B

6.524

7.990(+1.466)

7.936

论文源码不能复现论文中的层加速效果

笔者使用源码提供的核在 layer_benchmark.py 上进行测试(单卡 NVIDIA A100 ),并不能复现层加速效果。具体测试结果见下表:例如 QUIK-4B 最高只提供了 2.2 倍的加速,并不能达到论文中的 4.7 倍。

matrix size

FP16(ms)

QUIK-8B(ms)

QUIK-4B(ms)

论文QUIK-8B

论文QUIK-4B

(4096,4096)

0.318(X1)

0.330(X0.96)

0.327(X0.97)

(X2.2)

(X2.8)  

(11008,4096)

0.909(X1)

0.715(X1.27)

0.575(X1.58)

(X2.7)  

(X3.5)

(8192,8192)

1.230(X1)

0.894(X1.38)

0.704(X1.75)

(X2.6)

(X3.8)

(28672,8192)

4.310(X1)

2.807(X1.54)

1.955(X2.20)

(X2.6)  

(X3.8)  

总结

虽然论文的源码存在一些问题,但是论文提出的这种通过对激活进行统计重排,而后利用矩阵的二阶信息进行量化误差补偿的思想,是值得我们学习借鉴的。

参考文献

[1]Ashkboos S, Markov I, Frantar E, et al. Towards end-to-end 4-bit inference on generative large language models[J]. arXiv preprint arXiv:2310.09259, 2023.

电脑版微信多开,最详细教程没有之一 首先桌面任意的位置右键新建文本文档输入如下代码: TASKKILL /F/IM WECHAT.EXE start " " "D:\Program Files (x86)\Tencent\WeChat\WeChat.exe" start " " "D:\Program Files (x86)\Tencent\WeChat\WeChat.exe" ... 阅读详情

相关推荐

Score Matching(得分匹配)

Score Matching(得分匹配)是一种统计学习方法,用于估计概率密度函数的梯度(即得分函数),而无需知道密度函数的归一化常数。这种方法由Hyvärinen在2005年提出,主要用于无监督学习,特别是在密度估计和生成模型中。

weixin_39699362的博客 2167

glm-4v-9b 踩坑(4-bit量化,bitsandbytes 异常)

主要解决2个问题: 1 glm-4v-9b 的4-bit加载 2 bitsandbytes 异常处理

phynikesi的博客 1914

monocle3-单细胞轨迹分析在疾病研究中的应用

本文深入探讨了monocle3在单细胞轨迹分析中的核心应用,特别是在疾病研究领域。通过实战案例,详细讲解了如何利用monocle3进行轨迹推断,构建细胞状态演变的“路线图”,并结合伪时间分析定位疾病进展阶段。文章还介绍了如何挖掘驱动疾病发展的关键基因,并分享了数据整合、根节点选择等进阶技巧与避坑指南,旨在帮助研究者利用这一强大工具揭示肿瘤异质性、免疫治疗耐药等复杂生物学过程的动态机制。

a3b4c5的博客 638

探索效率与精度的极致平衡:QUICK - 跨时代的4比特量化工具

探索效率与精度的极致平衡:QUICK - 跨时代的4比特量化工具 在人工智能领域,模型的大小和计算效率一直是研究者们追求的重点。今天,我们向您隆重介绍开源界的一颗新星 —— QUIK。这是一款致力于将大规模语言模型的权重和激活函数主要量化至4比特的后训练方法,旨在实现速度与精确度之间的完美平衡。通过这款强大的工具,开发者和研究人员可以大幅度提升AI应用的部署效率,而不失性能。 项目技术剖析 QUI...

gitblog_00305的博客 781

DEA-Malmquist指数模型实战:从理论到应用的全流程解析

本文全面解析了DEA-Malmquist指数模型从理论到应用的全流程。文章详细阐述了该模型如何动态衡量效率随时间的变化,并将其分解为技术效率变化与技术进步,从而精准定位效率变动的根源。通过实战步骤演示了数据准备、软件操作(如DEAP 2.1)及结果解读,并结合水资源环境效率等案例,展示了其在包含非期望产出时的应用价值,为研究者进行动态效率分析提供了清晰指南。

b0c1d2的博客 220

避开PFC设计大坑:从环路分析到参数整定的5个常见误区与解决方案

本文深入解析PFC电路设计中从环路分析到参数整定的5个常见误区,包括电感参数设计、小信号模型适用边界、电压环与电流环耦合效应等。通过实际案例和PSIM仿真数据,提供工程落地的解决方案,帮助工程师避开设计陷阱,提升电路性能与可靠性。

weixin_30666401的博客 325

探索 Quik:一款高效、灵活的 Markdown 编辑器

探索 Quik:一款高效、灵活的 Markdown 编辑器 是一个轻量级且强大的 Markdown 编辑器,由开发者 satya164 创作。它以速度和简洁为设计理念,旨在提供无干扰的写作环境,同时赋予用户高级编辑和预览功能。本文将深入探讨 Quik 的技术特性,应用场景及其独特优点,助您提升工作效率。 项目概述 Quik 是一个跨平台的应用程序,支持 Windows、macOS 和 Linux。...

gitblog_00085的博客 580

使用R语言中的NbClust包确定最佳聚类簇数

聚类分析是一种常用的数据分析技术,它将相似的数据点分组成不同的簇。NbClust包是R语言中一个强大的工具,它提供了多种方法来帮助我们确定最佳的聚类簇数。综上所述,使用R语言中的NbClust包可以帮助我们确定最佳的聚类簇数。通过选择适当的聚类算法和评估指标,我们可以更好地理解数据集的结构和模式,并根据需要进行进一步的分析和解释。此外,NbClust包还提供了其他函数和参数,用于执行不同的聚类算法、选择不同的评估指标等。安装完毕后,我们需要加载NbClust包,以便使用其中的函数。函数来确定最佳聚类簇数。

2301_79326559的博客 2279

【大模型解惑】如何用 Int4、4-bit 或 Q-LoRA量化模型以降低推理成本,同时保证性能?

如何使用 Int4、4-bit 或 Q-LoRA 技术量化模型以降低推理成本,同时保证性能?

人工智能(AI)技术,大模型技术,深度学习,机器学习,计算机视觉,AI工具实践应用等分享 1901

【深度学习新浪潮】ISP芯片算法技术简介及关键技术分析

ISP(Image Signal Processor)芯片作为现代影像系统的核心组件,负责对图像传感器输出的原始信号进行后期处理。ISP的主要功能包括线性纠正、噪声去除、坏点修复、色彩校正以及白平衡调整等,这些处理步骤对于提高图像质量和视觉效果至关重要。随着科技的进步,ISP芯片不仅提升了图像的清晰度和色彩准确性,还通过高效的算法增强了拍摄体验,尤其是在低光环境下的表现。

专注:太空算力、AI infra、异构调度、大模型成本工程 1223

AEJoy —— 最受欢迎的 5 个 Ae 表达方式

NOTE] 原文作者我意识到表达式可能令人生畏,有些人宁愿复制粘贴有用的代码,而不愿学习这门语言。对此我完全理解。因此,我想与您分享我的。这些是我几乎在每个项目中都会使用的表达式,我认为它们极大地提升了工作流程。

ShaderJoy 的兴趣技术杂货铺 363

设计模式(一) 工厂模式 五种写法总结

转载请标明出处: http://blog.youkuaiyun.com/zxt0601/article/details/52703280本文出自:【张旭童的博客】系列开篇瞎BB设计模式相关的文章学习与总结,一直有意为之,一直又觉得时机不到。一 是怕自己代码经验还不够,学习了也不懂,强行理解没有意义。二 是怕自己学习了以后总结出来,万一有不对的地方,误人子弟。而在现在的公司摸爬滚打半年后,感觉自己写代码遇到了

zxt0601的博客 8万+

基于 OpenCVSharp 的晶圆缺口自动检测与旋正方案

在半导体制造过程中,晶圆(Wafer)需要精确定位才能进行后续加工。每个晶圆边缘都有一个特定的缺口,这个缺口就像 "箭头" 一样,帮助机器确定晶圆的方向。我们的任务就是通过摄像头拍摄的图片,自动找到这个缺口的位置,计算出需要旋转多少角度才能让晶圆对准正确方向。简单来说,这个技术就像给晶圆 "找方向",确保它在生产线上始终保持正确的姿态。

品质生活,极致编程。 1211

Qwen3-32B效果对比展示:FP16 vs 8bit vs 4bit在RTX4090D上的生成质量实测

本文介绍了如何在星图GPU平台上自动化部署Qwen3-32B-Chat私有部署镜像(RTX4090D 24G显存CUDA12.4优化版),并对比FP16、8bit和4bit量化模式在文本生成质量上的差异。该镜像特别适用于需要高效运行大语言模型的场景,如技术文档自动生成、创意写作辅助等,帮助开发者在资源有限的情况下实现最优的模型性能与效率平衡。

weixin_32005771的博客 402

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

百川2-13B-4bits模型量化对比:4bit vs 8bit在OpenClaw任务中的差异

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像,实现高效的大语言模型应用。该量化版本显著降低显存需求至10GB左右,特别适合本地化部署场景,如自动化文档处理、智能客服对话等任务,在保证基本功能的同时提升响应速度。

weixin_35755562的博客 228

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

低显存也能跑:InternVL2-4B 8-bit量化与多GPU切分部署完整指南

InternVL2-4B 是 OpenGVLab 开源的 4B 级多模态大模型,支持图片与视频理解、OCR、文档问答等任务。本指南教你用 **8-bit 量化** 把显存占用压缩约一半,再用 **多GPU切分(device_map)** 把 32 层语言模型均匀摊到多张显卡上,让 12GB 甚至 8GB 级别的消费级显卡也能流畅部署,是新手跑开源视觉大模型的完整上手路线。 [![InternVL

gitblog_00160的博客 840

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Qwen3-32B-Chat RTX4090D镜像实测:4bit量化下显存占用仅18GB实录

本文介绍了如何在星图GPU平台上自动化部署Qwen3-32B-Chat私有部署镜像(RTX4090D 24G显存CUDA12.4优化版),实现高效的大语言模型推理。该镜像经过4bit量化优化后显存占用仅18GB,适用于企业知识库问答、代码生成等场景,显著降低大模型部署门槛。

weixin_42355400的博客 28

百川2-13B-Chat-4bits量化模型效果对比:NF4量化后性能仅降1-2%,实测响应<1秒

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像。该平台简化了部署流程,用户可快速搭建环境,体验NF4量化技术带来的高效能。该模型适用于代码生成、技术问答等场景,在消费级显卡上即可实现快速响应,是个人开发者和小团队进行AI辅助开发的理想工具。

weixin_33816734的博客 290

百川2-13B-4bits量化模型效果展示:NF4压缩下仅降1-2%性能,实测代码生成与写作质量

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像。该镜像通过NF4量化技术,在仅损失1-2%性能的前提下大幅降低显存需求,使其能在消费级显卡上高效运行,非常适合作为个人开发者的本地代码助手,辅助完成代码生成、调试等编程任务。

weixin_42571280的博客 100

百川2-13B-4bits量化模型效果展示:NF4压缩下仅降1.5%性能,实测代码生成与写作质量对比

本文介绍了在星图GPU平台上,用户可自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像,快速搭建本地AI助手。该模型在NF4量化下性能损失极小,实测在代码生成、技术文档写作等场景中表现优异,能有效辅助开发者进行编程与内容创作。

weixin_31961675的博客 305

Qwen2.5-72B-Instruct-GPTQ-Int4详细步骤:vLLM推理优化+Chainlit前端集成

本文介绍了如何在星图GPU平台上自动化部署Qwen2.5-72B-Instruct-GPTQ-Int4镜像,实现高效的大语言模型推理。该方案结合vLLM优化和Chainlit前端集成,特别适用于处理复杂指令和长文本生成任务,如编程辅助和多语言内容创作,显著提升AI应用的开发效率。

weixin_42418754的博客 578

百川2-13B-Chat-4bits效果对比实测:NF4 vs FP16在响应速度、显存占用、生成质量三维度分析

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像,实现高效的中英双语对话和文本生成任务。该镜像特别适用于显存受限的环境,如消费级GPU,通过NF4量化技术显著降低显存占用,同时保持较高的生成质量,适合技术问答、代码生成等实际应用场景。

weixin_42611310的博客 159

NF4量化仅降1-2%性能!百川2-13B-Chat 4bits版GPU算力优化部署教程

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像。该方案通过NF4量化技术,显著降低模型显存需求,使其能在消费级显卡上流畅运行。用户可基于此快速搭建一个本地AI对话助手,应用于代码生成、内容创作、学习答疑等多种场景,大幅降低了大模型的使用门槛。

weixin_42602726的博客 375

Qwen2.5-72B-GPTQ-Int4实战案例:中小企业低成本部署72B参数大模型

本文介绍了如何在星图GPU平台上自动化部署Qwen2.5-72B-Instruct-GPTQ-Int4镜像,实现中小企业低成本部署72B参数大模型。该镜像通过GPTQ 4-bit量化技术显著降低硬件需求,适用于知识问答、代码生成等多样化AI应用场景,帮助用户快速搭建高效的大语言模型服务。

weixin_34535286的博客 1101

Qwen2.5-72B-Instruct-GPTQ-Int4快速部署:无需conda环境的一键启动方案

本文介绍了如何在星图GPU平台上自动化部署Qwen2.5-72B-Instruct-GPTQ-Int4镜像,实现高效的大语言模型推理。该方案无需conda环境配置,通过vLLM引擎一键启动,适用于编程辅助、数学问题求解等专业场景,显著提升开发效率。

weixin_36303807的博客 374

百川2-13B-4bits量化版效果展示:中英双语智能对话,实测响应速度超快

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像,并展示了其核心应用。该量化模型显著降低了硬件门槛,能快速响应中英双语智能对话,非常适合用于个人学习开发、代码生成辅助以及创意写作等场景,为本地AI应用提供了高效便捷的解决方案。

weixin_42124497的博客 205
上一篇: <span class=“js_title_inner“>QLoRA :高效微调已量化的LLM</span>
Linux基金会AI&Data基金会
博客等级 码龄6年 101粉丝 47原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值