QLoRA :高效微调已量化的LLM

大模型基础知识-LoRA与QLoRA QLoRA (Quantized Low-Rank Adaptation) 是一种结合了模型量化和低秩适配的技术,旨在减少大规模预训练模型微调和部署的计算和存储成本。参数高效:通过这种方式,只需微调少量参数(即低秩矩阵的参数),而非整个模型的参数,从而大大降低了存储和计算成本。低秩适配 (LoRA):在量化后的模型上应用低秩适配技术,仅微调少量附加的低秩矩阵,从而保持微调的高效性。低秩适配:在量化后的模型基础上进行低秩适配,通过引入低秩矩阵来进行微调,从而节省参数数量和计算开销。 阅读详情

概述

      微调 LLM 是一个能高效改善模型性能的方法,通过微调能使模型多一些人们期望的行为,少一些不期望的行为。然而微调 LLM 是非常昂贵的,例如微调一个常规 16-bit 65B 的LLaMA需要至少 780GB 的 GPU 显存。

      QLoRA 是一个有效的对已量化 4-bit 模型进行微调而模型性能不降低的方法,例如通过 QLoRA 可以在一个 48GB 的 GPU 上对参数量为 65B 的 4-bit 量化模型进行微调,微调后模型的性能不比用16-bit进行微调的性能差。

QLoRA 引入了 3 个新颖的设计,能够在不牺牲性能的前提下降低内存。

  • 4-bit NormalFloat: 对正态分布的数据来说,是信息理论上最优的量化数据类型,优于 4-bit  整型和 4-bit  浮点型

  • Double Quantization:不仅量化权重,还是量化了量化常数,每个参数大概能节省平均 0.37bits

  • Paged Optimizers:使用 NVIDIA 统一内存(unified memory)技术去避免处理长序列小批量数据时,梯度检查点的内存尖峰

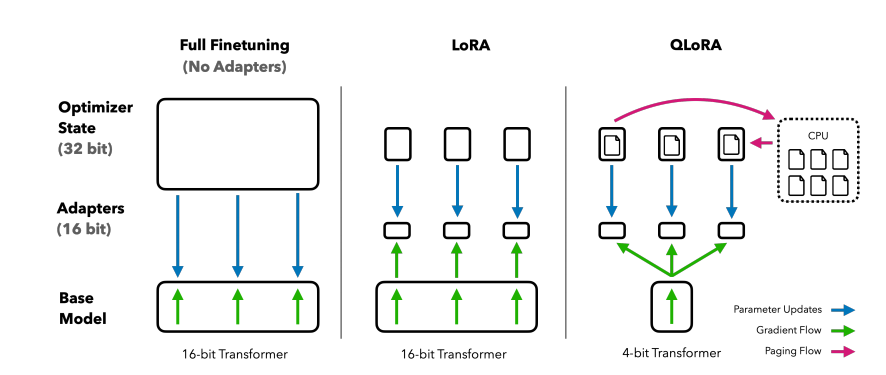
下图对比了不同微调技术和各自内存的使用情况。QLoRA 对 LoRA 的改进在于 Transformer 类模型采用了 4-bit 精度加载,使用了 paged optimizer 去处理内存尖峰。
42f467a7f4df6714fffc6fc1353e2cf1.png

QLoRA基础知识

  先介绍几个基础技术,他们是 QLoRA 构建的基石。

Block-wise k-bit 量化

      所有的量化 bins 是否被均匀的使用,从某个角度来说,决定了量化精度。例如一个 4-bit 的数据类型有 16 个 bins,但是如果只有 8 个 bins 被使用,它就等价于 3-bit 的数据类型。那么能够增加所有量化 bins 的平均使用率的方法就能增加量化的精度。使用 block-wise/group-wise 的方式把张量切成小块,每个小块独立量化,这能把异常点限制在特定的小块中,这样就能增加其他块量化 bins 的平均使用率从而增加整体的量化精度。

      group-wise[4] 量化,是把密集矩按其输出的网元进行切分,切分后的每一块是一个 group,这个 group 的大小是依赖于隐层的维度的。

block-wise 量化是把输入的张量展平成 1 维的,然后进行分块量化。

对   -bit, block-size 为    的 block-wise 量化,假设输入张量  有    个元素,展平后有    个 blocks,  是 block 的索引,取值范围   。  代表整数到浮点数的一个映射。  是第   个 block 的归一化常数,  , block-wise 量化可以按下面的公式进行定义,找出和量化映射的最小距离,此时的    就是该数据类型的整型表示。  表示块中的第 个元素。

例如对于一个  32-bit 的浮点数block, 量化成范围是 [-127, 127] 的 Int8,  是一个线性映射,遵循如下量化公式:

其中,   是量化常数(quantization constant)或量化尺度(quantization scale)。反量化是相反的过程:

Low-rank Adapters(LoRA)

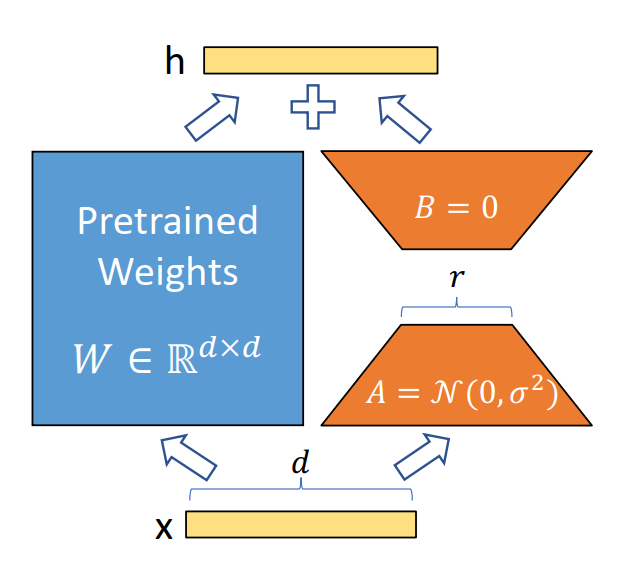
LoRA 是一个减小内存需求的微调方法,它冻结整个模型的参数,通过往模型中加入额外的网络层,并只训练这些新增的网络层参数。由于这些新增参数数量较少,使得微调的成本显著下降,还能获得和 16-bit 全模型微调类似的效果。这些新增的网络层叫做适配器(adapter)。假设模型对应    这样的映射,  ,对模型进行LoRA进行如下计算:

其中   是一个标量,是 LoRA 的缩放因子(scaling factor)。LoRA 过程的示意图见下图,蓝色部分是 LoRA 微调过程中冻结的模型权重,对应于公式(4)中的  ,橘色部分是 adapter,对应于公式(4)中  .
e1d8cc36082d93f22d882937a82e7919.png

QLoRA微调

      QLoRA 能进行高保真的 4-bit 微调,得益于 2 个技术:4-bit NormalFloat(NF4)量化和 Double Quantization。此外,通过 Paged Optimizers,可以防止梯度检查点带来内存尖峰(memory spikes)从而导致 out-of-memory 错误,这种错误常常在大模型单节点微调时出现。

      QLoRA 微调时,用到 2 种数据类型:一种是存储数据类型,即 4-bit 已压缩权重;一种是计算数据类型,通常是 BFloat16。这意味着在进行 QLoRA 时,模型权重是 4-bit 存储,并且是冻结的,不进行权重更新,推理时需要把模型权重反量化为 BFloat16,然后进行 16-bit 矩阵乘法计算。adapter 中的权重是真正需要微调的权重,本来就是 16-bit 表示。

4-bit NormalFloat Quantization

      NormalFloat(NF) 数据类型构建在分位点量化(Quantile Quantization)[1]的基础上。Quantile Quantization 是一种信息理论上最优的量化数据类型,能够确保每个quantization bin中有相同数量的输入张量。Quantile quantization 是通过经验累积概率分布函数来估计输入张量的分位点。所谓分位点就是对输入张量进行划分的点q,这样的点一共  个。这和 histogram 有  个 bins,每个 bin 里有相同数量的值分布是等效的。每个 bin 的的中点就相当于找  个不重叠的值   ,  的累积概率分布函数是  ,分位点之间有着相等的概率质量。这些值可以通过它的反函数,分位点函数获得:  。这样  个分位点之间的中点可以按如下公式计算,输入概率均匀分布,在[0, 1]之间:

      通过输入张量 T 的累积概率分布函数来找分位点,分位点之间的样本均匀分布,这样的量化就是 Quantile Quantization。

      预训练网络的权重基本都是 0 均值的正态分布,我们可以把所有权重通过方差都转为一个统一的固定分布。对于数据类型的分位点和网络权重,都需要归一化到[-1,1]的范围。那对于数据类型在[-1,1]的范围内,进行   -bit NF 量化,需要进行如下操作:

(1)为了进行   -bit 分位点量化,通过理论上的[0,1]正态分布估计分位点,获取正态分布的  -bit数据类型

(2)将该数据类型归一化到[-1,1]的范围

(3)通过绝对值最大值进行调整,把输入权重归一化到[-1,1]的范围,而后进行量化

通过这个思想获得的4-bit NF的数据类型如下:

[-1.0, -0.6961928009986877, -0.5250730514526367,
-0.39491748809814453, -0.28444138169288635, -0.18477343022823334,
-0.09105003625154495, 0.0, 0.07958029955625534, 0.16093020141124725,
0.24611230194568634, 0.33791524171829224, 0.44070982933044434,
0.5626170039176941, 0.7229568362236023, 1.0]

      NF量化在实现的时候,结合公式(1)进行 block-wise 量化,需要使用到 lookup table,硬件效率比较低,是一种非均匀量化。

Double Quantization

      双重量化(Double Quantization),是针对量化常数的一种量化,能够节省额外的内存。对于 block-wise 的 4-bit 量化,除了权重还需要存储量化常数,这也是可观的开销。例如对于大小为64的块进行量化,量化常数(scale)使用 32-bit 存储,那对于每个参数,平均需要增加 32/64 = 0.5 bit的存储开销。

      双重量化是把第一次量化的量化常数  作为第二次量化的输入。第二次量化后产生了量化后的量化常数  和与之对应的第二级量化的量化常数  。第二次量化采用 8-bit Float 量化,块大小是 256。由于   是正数,在量化前,从  减去均值,这样就会变成以0为中心的值,可以采用对称量化的方式。对于块为64的权重进行量化,本来每个参数平均需要 32/64 = 0.5 bits的内存,采用双重量化后,只需要 8/64 + 32/(64*256) = 0.127 bits,每个参数减少了0.373 bits。

Paged Optimizers

      NVIDIA的统一内存(unified memory)特性能在 GPU 偶尔 out-of-memory 的时候避免错误的发生,在 CPU 和 GPU 之间自动进行数据的分页传送。这个技术工作起来像 CPU RAM 和硬盘之间进行的常规的内存分页。QLoRA 利用这个技术为优化器的状态分配分页内存,这样当 GPU在运行时 out-of-memory 时,会自动激发 CPU RAM, 当优化器的状态需要更新时,又会自动分页切回 GPU 内存。

QloRA

      结合上文描述的 3 种技术,对一个线性层,如果使用一个 LORA adapter, QLoRA的过程可以用下面的公式表示:

其中,  定义如下:

      对于  使用NF4,对  使用FP8,对  使用的块大小是64,对  使用的块大小是256。

      由此可见, QLoRA 有一个存储数据类型(通常是 4-bit NormalFloat)和一个计算数据类型(16-bit BrainFloat)。我们把存储类型反量化为计算类型后,进行前向反向的数据传播,但是我们只使用 16-bit BrainFloat 计算 LoRA 参数的梯度。

QLoRA 与标准微调对比

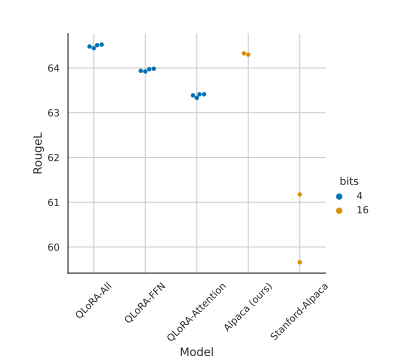
      在所有的 transformer 层上使用 LoRA 技术对于 LoRA 微调的精度是否能和标准的 16-bit 微调的精度相匹配非常重要,具体见下图。
76f425ce1aeb6a6828ebd273aa2d8222.png

      上图中是 LLaMA 7B 模型在 Alpaca 数据集上的测试结果。Stanford-Alpaca 采用 Stranford Alpaca 官方默认的 16-bit 标准微调参数,Alpaca(ours) 是作者对官方微调参数的改进,QLoRA-Attention 是只对 Attention 部分进行 QLoRA 微调,QLoRA-FFN 是只对 FFN 进行 QLoRA,QLoRA 是对所有的线性 transformer 块进行微调。从上图可见,对所有的线性  transformer 块进行微调, 对 LoRA 微调性能是否能匹配 16-bit 标准微调非常重要。在测试中,均使用了 16 个 LoRA adapter,这个超参也很重要。

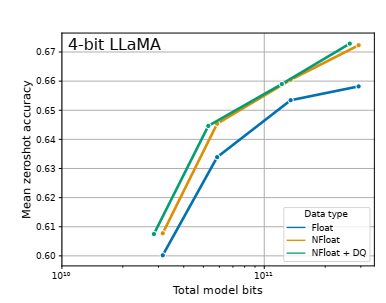
      下图表明, 4-bit NormalFloat 能比 4-bit Float 带来更好的精度。DQ 表示双重量化。
b06a6e7533b52c9b9cd563a9d389b125.png

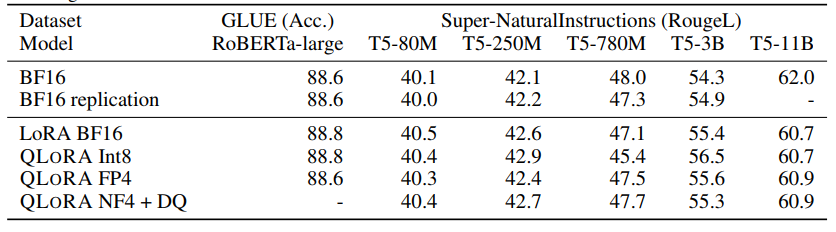
      近期研究发现,4-bit 的量化推理是可能的,但是相比 16-bit,会有一定的性能降低,这主要是由于精度降低后,量化误差增大带来的。这样的精度损失可以由量化后对 adapter 的微调来弥补。见下表。表中对比了 RoBERTA 和 T5 模型在 GLUE 和 the Super-NaturalInstructions 数据集下,BF16 的标准微调、LoRA 微调和各种精度下的 QLoRA 微调。从表中可见, 各种精度下对 adapter 的微调,都能够复现标准微调下的精度。
36609aa0ac3de224d7473de8d58e0381.png

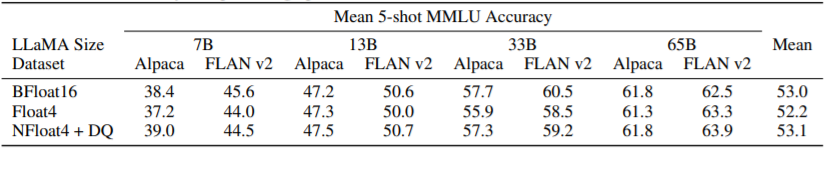
      QLoRA 技术不仅适用于上图所示的 11B 规模的模型, 也能扩展到 7B - 65B的规模,见下表。下表使用了2种数据集, Alpaca 和 FLAN v2。精度是 5 次 平均的 MMLU 精度。由表可见 NF4 配合上双重量化(DQ)能够完全媲美 16-bit LoRA 的精度。同时 FP4 的 QLoRA 比 16-bit 的 LoRA 精度平均低 1 个 百分点,这说明了 (1)NF4 + DQ 的 QLoRA 能复制 16-bit 标准微调和 16-bit LoRA 微调的性能 (2)NF4的数据类型就量化精度而言是优于 FP4 的。
f353343681c3241fe2a3027571270faa.png

总结

      QLoRA 是一种有效的微调方式,它主要由 3 种创新的技术组成。采用 QLoRA 能显著的减小微调时对内存的需求,使得一个 65B 参数量的模型能够在一个 48G 的单卡 GPU 上进行微调,同时提供和 16-bit 微调相当的模型性能。QLoRA 降低了微调时对资源的需求,使得对 LLM 的微调更加普遍通用和平民化。  

参考资料
参考文献

[1]8-BIT OPTIMIZERS VIA BLOCK-WISE QUANTIZATION8-BIT OPTIMIZERS VIA BLOCK-WISE QUANTIZATION

[2]The case for 4-bit precision: k-bit inference scaling laws

[3]8-bit approximations for parallelism in deep learning

[4]Q-BERT: Hessian Based Ultra Low Precision Quantization of BERT

大模型微调技术LoRA与QLoRA QLORA 可以使用 4 位基础模型和低秩适配器 (LoRA) 复制 16 位完全微调性能。QLORA将微调65B参数模型的平均内存需求从>780GB的GPU内存降低到 阅读详情

相关推荐

qlora原理

我们提出了QLORA,这是一种高效的微调方法,它减少了足够的内存使用,可以在单个48GB GPU上微调一个650亿参数的模型,同时保留了完整的16位微调任务性能。QLORA通过一个冻结的、4位量化的预训练语言模型向后传播梯度到低秩适配器(LoRA)。我们最好的模型系列,我们称之为Guanaco,在Vicuna基准测试中超过了所有以前公开发布的模型,达到了ChatGPT 99.3%的性能水平,而仅在单个GPU上微调了24小时。QLORA引入了一系列创新,以节省内存而不牺牲性能:(a)

XD的博客 1389

QLoRA:量化LLM的高效微调策略与实践

在大型语言模型(LLM)领域,微调是提高性能和调整行为的关键过程。然而,由于内存需求巨大,对于大型模型进行微调可能非常昂贵。最近,华盛顿大学发表了一项关于解决这一问题的创新方案——QLoRA(Quantized Low-Rank Adapter)。QLoRA是一种新的微调大型语言模型(LLM)的方法,它能够在节省内存的同时保持速度。其工作原理是首先将LLM进行4位量化,从而显著减少模型的内存占用。接着,使用低阶适配器(LoRA)方法对量化的LLM进行微调。

FrenzyTechAI的博客 1万+

QLoRA:量化 LLM 的高效微调

我们介绍了 QLoRA,这是一种有效的微调方法,可以减少内存使用量,足以在单个 48GB GPU 上微调 65B 参数模型,同时保留完整的 16 位微调任务性能。QLoRA 通过冻结的 4 位量化预训练语言模型将梯度反向传播到低阶适配器 (LoRA)。我们最好的模型系列,我们命名为 Guanaco,在 Vicuna 基准测试中优于所有以前公开发布的模型,达到 ChatGPT 性能水平的 99.3%,同时只需要在单个 GPU 上进行 24 小时的微调。

具身机器人和通用AI 2245

LLM高效参数微调方法:从Prefix Tuning、Prompt Tuning、P-Tuning V1V2到LoRA、QLoRA(含对模型量化的解释)_llm微调

如此文《LLaMA的解读与其微调:Alpaca-LoRA/Vicuna/BELLE/中文LLaMA/姜子牙/LLaMA 2》中的2.2.3节Alpaca-LoRA:通过PEFT库在消费级GPU上微调「基于LLaMA的Alpaca」所述,在神经网络模型中,模型参数通常以矩阵的形式表示。对于一个预训练好的模型,其参数矩阵已经包含了很多有用的信息。为了使模型适应特定任务,我们需要对这些参数进行微调而当预训练比较大的模型时,微调模型的所有参数不太可行。

jennycisp的博客 1221

掌握QLoRA!消费级GPU上的内存高效LLM微调

*量化低秩适应(QLoRA)**是一种高效的LLM微调技术,可将内存使用量减少到足以在单个48GB GPU上微调70B参数模型。图A.显示QLoRA、LoRA和全微调的简化内存架构的比较图。QLoRA(图A,左侧)扩展了低秩适应(LoRA)(中间),利用4位量化来托管大型基础模型,以减少内存开销。它可以通过使用可训练的LoRA适配器来保留LoRA的核心效率,这些适配器代表的参数不到全微调所需参数的1%(图A,右侧)。QLoRA有效地弥合了学术研究和生产部署之间的差距。

全网120W+关注AI拉呱,专注人工智能以及科技前沿! 114

SceneSplat

目标:训练一个网络,输入高斯参数 → 输出与自然语言空间对齐的特征。考虑到标注语义的 3DGS 数据有限,作者设计了。策略,让模型在无标签场景上学到有用表征。都有一个与自然语言对齐的语义特征。这是整个方法的第一步,目标是让。

weixin_61091146的博客 1284

<span class=“js_title_inner“>QLoRA :高效微调已量化的LLM</span>

近期研究发现,4-bit 的量化推理是可能的,但是相比 16-bit,会有一定的性能降低,这主要是由于精度降低后,量化误差增大带来的。LoRA 是一个减小内存需求的微调方法,它冻结整个模型的参数,通过往模型中加入额外的网络层,并只训练这些新增的网络层参数。QLoRA 是一个有效的对已量化 4-bit 模型进行微调而模型性能不降低的方法,例如通过 QLoRA 可以在一个 48GB 的 GPU 上对参数量为 65B 的 4-bit 量化模型进行微调,微调后模型的性能不比用16-bit进行微调的性能差。

LF_AI的博客 57

手把手教你用PlantVillage数据集搭建农作物病害识别模型(Python实战)

本文详细介绍了如何使用PlantVillage数据集和Python构建农作物病害识别模型。从环境准备、数据获取到模型构建、训练与评估,手把手教你实现一个实用的农业AI应用。特别针对PlantVillage数据集的特点,提供了处理类别不平衡、图像预处理和模型优化的实战技巧,帮助开发者快速掌握农作物病害识别技术。

weixin_29184371的博客 479

LLM高效参数微调方法:从Prefix Tuning、Prompt Tuning、P-Tuning V1/V2到LoRA、QLoRA(含对模型量化的解释)

常规部分的正向传播由transformers所定义,而LoRA部分的正向传播则由LinearLayer_LoRA(nn.Module)的forward()所定义,即“LoRA层的两条分支结果进行加和”,如下图所示『一般用随机高斯分布初始化,当然实际代码实现时,比如微软的deepspeed chat在用到LoRA时,一开始通过0矩阵占位,然后调用搭配ReLU激活函数的kaiming均匀分布初始化。,相当于在训练期间,较小的权重矩阵(下图中的A和B)是分开的,但一旦训练完成,权重可以合并到一个新权重矩阵中。

结构之法 算法之道 2万+

R语言笔记十:独立性检验函数

1.独立性检验函数        独立性检验是根据频数信息判断两类因子彼此相关或相互独立的假设检验。所谓独立性就是指变量之间是独立的,没有关系。 独立性检验算法:卡方检验、Fisher检验、Cochran-Mantel-Haenszel检验 2.假设检验 假设检验(Hypothesis Testing)是数理统计学中根据一定假设条件由样本推断总体的一种方法。 原假设——没有发生 备择假设——发生了 具体做法:根据问题的需要对所研究的总体作

weixin_44384631的博客 4111

WOFOST模型参数调优实战:从‘跑不通’到‘预测准’的避坑指南

本文详细介绍了WOFOST模型参数调优的实战技巧,帮助用户从模型报错诊断到参数敏感性分析,再到土壤-作物参数联调策略,逐步解决‘跑不通’到‘预测准’的问题。通过Python和PCSE工具,提供参数扰动测试模板和关键参数优先级矩阵,助力作物模型的高效校准与预测。

weixin_32597009的博客 622

【干货收藏】一文掌握LLM四种主流微调方法:从Full-tuning到QLoRA!

文章介绍了四种LLM微调方法:Full-tuning全量微调(效果好但资源消耗大)、Freeze-tuning冻结部分参数微调(轻量级选择)、LoRA低秩适应(通过添加小矩阵调整,高效且效果好)和QLoRA量化低秩适应(资源消耗最小,适合边缘设备)。作者详细解释了每种方法的原理、优缺点和适用场景,帮助开发者根据自身条件和需求选择最适合的微调策略,高效优化模型性能。

m0_59162248的博客 974

用FPGA控制步进电机是种什么体验?从状态机到分频器,详解Verilog驱动A4988全流程

本文详细介绍了如何使用FPGA通过Verilog语言控制步进电机,从状态机设计到A4988驱动模块的精准控制全流程。FPGA的并行处理能力和纳秒级响应速度使其在步进电机控制中展现出显著优势,特别适合工业自动化和精密仪器应用。通过实战代码示例,展示了如何实现高效的状态机设计和可编程分频器,为开发者提供了一套完整的FPGA驱动步进电机解决方案。

weixin_30983965的博客 329

【必看收藏】大模型微调四种方法详解:从Full-tuning到QLoRA,资源有限也能高效优化!

本文详细介绍了四种LLM微调方法:Full-tuning(全量微调)适合数据多、任务复杂场景;Freeze-tuning(冻结部分参数)轻量化处理,适合资源有限情况;LoRA通过添加低秩矩阵实现高效微调;QLoRA是LoRA的升级版,先压缩模型再适配,更轻量化。文章分析了各方法的优缺点和适用场景,帮助开发者根据实际需求选择最优微调策略,在有限资源下高效优化大语言模型。

Gaga246的博客 706

HFSS初学笔记(二)——75Ω带状线设计

本文利用HFSS软件设计并优化了一条75Ω的带状线结构,通过调整几何参数和介质材料,实现了精确的阻抗控制。仿真结果显示,该带状线在高频信号传输中的表现优越,具有良好的S参数、低插入损耗和极小的信号反射损耗。

2401_87464239的博客 4541

基于高斯两步移动搜寻法(2SFCA)的城市绿地可达性分析

第二步,对于每一个街道i,给定空间距离阈值d0,便形成另一个空间作用域,同样对于落在空间作用域内的每块绿地l的供给比率(Rl)利用高斯方程赋以权重,然后对这些加权后的供给比率(Rl)进行加和,便得到每个街道i的绿地可达性Ai。图3与图4是高斯两步移动搜索法的示例。在图3中,以d0为阈值,有1、2、3 三个街道中心点落在了绿地a的空间作用域内。同样在图4中,以d0为阈值,有a、c两个绿地中心点落在了街道2的空间作用域内,根据公式(3),对a、c高斯方程加权后的供需比率进行累加,便得到了街道2 的绿地可达性。

2301_77310370的博客 2404

LLM微调实战:LoRA、QLoRA、RLHF、DPO、GRPO技术全解析,代码示例助你轻松掌握!

本文系统介绍了LLM微调技术与顶级梯度提升方法。在微调技术方面,详细解析了微调的定义、适用场景及参数高效微调方法(如LoRA和QLoRA),重点阐述了低秩适配原理和量化技术优势。在梯度提升方法部分,对比分析了XGBoost、CatBoost、LightGBM和NGBoost四大框架的特点与适用场景。文章还展望了大模型发展趋势,指出2025年将是Agent技术元年,并推荐了包含提示词工程、RAG、微调、部署和AI系统五大模块的学习路线,为AI从业者提供了实用的技术指南和进阶路径。

2401_85343303的博客 610

TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate

这篇被 ICLR 2026 接收的论文提出了一种名为TurboQuant的全新在线向量量化(Vector Quantization, VQ)算法。该研究的核心目标是解决大语言模型(LLM)在长上下文推理时面临的 KV Cache 显存消耗瓶颈,以及大规模向量数据库在近似最近邻检索中的存储与延迟问题。有别于现有技术,TurboQuant 是一种无需任何校准数据、无需训练的在线算法(Data-oblivious)。

c_cpp_csharp的专栏 118

【LLM量化】人话讲解 NF4量化 & DQ双重量化(QLoRA核心技术)

NF4量化按数据分布(正态)均匀切割,在0点附近密集、两头稀疏,与LLM权重分布高度匹配,信息利用率最高。在相同的4-bit下,模型精度损失最小。 而双重量化(DQ)是对每个block的缩放常数再进行一次量化(8-bit)。

qq_43629945的博客 316

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

你真的了解大模型怎么“调”?四种主流LLM微调方法详解!

今天我们就来聊聊四种LLM微调方法,帮你高效优化模型,轻松应对各种场景。

huang9604的博客 606

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

你真的了解大模型怎么“调”?四种主流LLM微调方法详解

如果你是一个开发者,手里有一个强大的语言模型(LLM),想用它来做点厉害的事情,比如文本分类、智能问答,或者识别文本里的关键信息。

2301_81940605的博客 693

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

LLM训练与微调实战:Awesome-LLMOps工具链深度应用

Awesome-LLMOps是一个精心策划的LLM运维工具列表,为开发者提供了全面的LLM训练与微调解决方案。本文将详细介绍如何利用Awesome-LLMOps中的工具链进行LLM训练与微调,帮助新手和普通用户快速掌握相关技能。 ## 核心工具链概览 🛠️ 在开始LLM训练与微调之前,了解Awesome-LLMOps提供的核心工具至关重要。这些工具覆盖了从数据准备到模型部署的全流程,让你的L

gitblog_00874的博客 937

大语言模型(LLM)微调全指南:从数据准备到模型部署

LLM微调指的是:在已预训练的模型基础上,使用体量更小、任务/领域定制的数据集进行额外训练,让模型在特定应用上更专业、更好用。这个过程可以类比为:一个受过通识教育的大学毕业生(基础模型),通过针对性的岗位培训(微调),变成某个领域的专家。# 基础模型 vs 微调模型# 基础模型:能理解通用语言,但不擅长特定任务# 微调模型:在特定领域数据上训练,更专业LLM微调是一项系统工程,涉及数据工程、模型训练、评估优化和部署运维等多个环节。

yonggeit的博客 198

本地LLM微调与RAG知识库构建实战指南

大语言模型(LLM)微调和检索增强生成(RAG)是当前AI领域的热门技术。LLM通过海量数据预训练获得通用语言理解能力,而微调则使其适配特定任务;RAG则结合信息检索与文本生成,通过外部知识库增强模型的事实准确性。这两种技术在降低计算成本方面表现突出,尤其适合在消费级硬件上部署。本地化实施不仅能保护数据隐私,还能通过模型量化等技术显著降低资源消耗。实际应用中,开发者可在法律咨询、技术文档处理等场景构建智能问答系统,其中关键环节包括数据处理、参数优化和性能监控。本文以Llama 2-7B为例,展示了如何在RT

weixin_33994429的博客 476
上一篇: 招聘啦!寻找热爱AI的你!
下一篇: <span class=“js_title_inner“>QLoRA :高效微调已量化的LLM</span>
Linux基金会AI&Data基金会
博客等级 码龄6年 100粉丝 47原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值