别急着重做计算机专业就业,先看岗位到底在筛什么

从Excel到Power Pivot:构建你的第一个商业智能分析模型 本文详细介绍了如何从Excel升级到Power Pivot,构建你的第一个商业智能分析模型。通过激活Power Pivot功能、导入数据、建立表关系、创建智能度量值以及打造交互式仪表盘,帮助用户高效处理百万行级别的数据,实现数据自动关联和动态分析,大幅提升商业决策效率。 阅读详情

聊《别急着重做计算机专业就业,先看岗位到底在筛什么》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

最近参加了几次同学的项目评审,发现一个反复出现的问题:学生做的RAG/Agent系统,Demo都能跑通,但一旦放进团队协作环境就崩。不是因为模型不行,而是因为权限控制、日志可观测这些"不起眼"的工程细节完全没考虑。这篇文章想说的是,大模型时代的求职者,真正要补齐的不是又一个Demo,而是从Demo到生产项目的跨越能力。

---

目录

  • 一个真实的需求评审现场
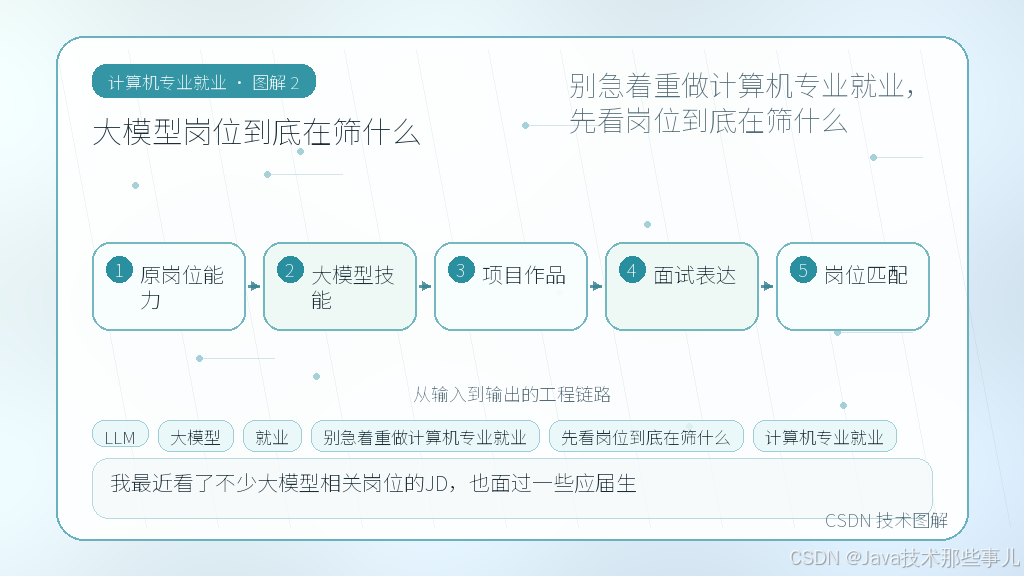
  • 大模型岗位到底在筛什么
  • 基础课的价值,被严重低估了
  • 大模型项目:从Demo到上线的三层差距
  • 代码解释
  • 实习准备:别只在本地跑起来
  • 求职路径建议
  • 总结

---

一个真实的需求评审现场

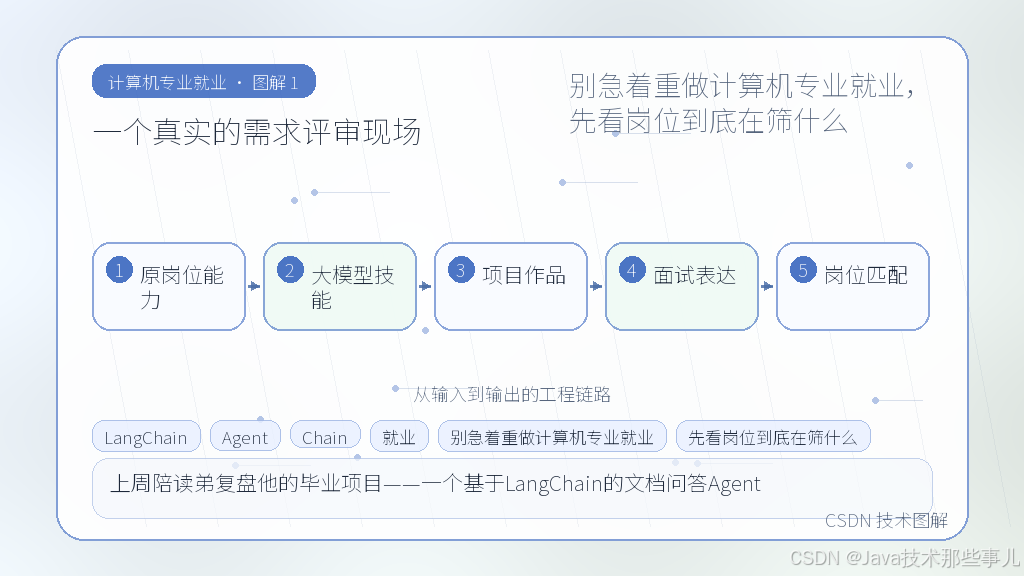
文章插图 1

上周陪读弟复盘他的毕业项目——一个基于LangChain的文档问答Agent。Demo演示很顺畅:上传PDF,输入问题,返回答案。评审会上组里一位做后端的同学提了几个问题:

  • 用户上传的文件,其他用户能不能看到?
  • 如果并发10个人同时提问,系统会不会崩?
  • 出了问题怎么查是哪个环节出错?
  • 模型返回了错误内容,有没有兜底?

他答不上来。不是因为不会写代码,而是整个项目设计阶段,这些根本没有被纳入考虑范围。

这正是当前很多计算机专业学生的现状:会调API、会搭Demo,但对"一个能上线的系统"和"一个能跑通的脚本"之间的差距,没有清晰认知。

---

大模型岗位到底在筛什么
文章插图 2

我最近看了不少大模型相关岗位的JD,也面过一些应届生。抛开JD上写的"熟悉LLM原理"这类空话,实际筛选中真正拉开差距的是以下几点:

第一,工程化意识。 面试官不问你能不能调用API,问的是:你的系统怎么处理异常情况?有没有熔断机制?日志能不能支撑问题定位?

第二,边界条件处理。 Demo里只跑一条正常数据,工作中要处理的是:用户输入为空怎么办?模型超时怎么办?返回值格式不对怎么办?

第三,可维护性。 代码能不能交给别人接手?配置参数是不是硬编码?出了问题有没有迹可循?

这三点,恰恰是课本和大多数培训班不教的东西。

---

基础课的价值,被严重低估了

很多学生觉得,都大模型时代了,还学什么数据结构、操作系统?我的建议是:基础课不仅没过时,反而是你和大模型Demo选手拉开差距的根本。

理由很简单:大模型应用本质还是软件工程。你的Agent需要调用数据库,需要处理并发,需要保证一致性——这些底层能力全部来自基础课。

举个例子,你做RAG系统,向量数据库的查询性能取决于你对索引结构的理解;你做Agent工作流,状态管理问题本质上是并发控制问题;你排查一个问题为什么偶尔出现,操作系统里的调度知识能帮你快速定位。

学习顺序建议:

  • 大二结束前,数据结构、操作系统、计算机网络这三门必须扎实
  • 大三上学期,数据库系统原理是必学项,尤其是事务和索引
  • 大三下学期,开始接触大模型,但基础课的复习不能停

---

优快云资料领取方式

大模型项目:从Demo到上线的三层差距

这里用一个真实的项目场景来说明。

真实案例

我有一个学弟做过一个内部知识库问答系统,技术栈是FastAPI + LangChain + ChromaDB。最初版本只有一个接口:

@app.post("/ask")
async def ask_question(request: QuestionRequest):
    result = qa_chain.invoke({"question": request.question})
    return {"answer": result}

Demo阶段完全没问题。但放进团队环境后,暴露了三个层面的问题:

第一层:权限缺失

任何登录用户都能访问所有文档,包括敏感文件。正确的做法应该是:

from fastapi import Depends, HTTPException
from typing import Annotated

# 依赖注入:获取当前用户
async def get_current_user(token: Annotated[str, Depends(oauth2_scheme)]):
    user = verify_token(token)
    if not user:
        raise HTTPException(status_code=401, detail="未授权")
    return user

# 权限校验:检查用户是否有文档访问权限
async def check_document_access(
    doc_id: str,
    user: Annotated[dict, Depends(get_current_user)]
):
    if not await user_has_permission(user["user_id"], doc_id):
        raise HTTPException(status_code=403, detail="无权访问该文档")
    return doc_id

这不是额外的工作量,而是项目从一开始就该设计的。很多学生是在Demo做完之后才补这些,导致重构成本极高。

第二层:日志不可观测

原项目没有任何日志,出问题只能靠猜。加日志不是简单打print,而是要有结构化的可观测体系:

import logging
import time
from contextlib import contextmanager

# 结构化日志配置
logger = logging.getLogger("rag_service")
logging.basicConfig(
    format="%(asctime)s | %(levelname)s | %(message)s",
    handlers=[logging.FileHandler("rag.log")]
)

@contextmanager
def trace_request(request_id: str):
    """请求追踪上下文管理器"""
    start_time = time.time()
    logger.info(f"[{request_id}] 请求开始 | question={request.question[:50]}...")
    try:
        yield
        elapsed = time.time() - start_time
        logger.info(f"[{request_id}] 请求完成 | 耗时={elapsed:.2f}s")
    except Exception as e:
        elapsed = time.time() - start_time
        logger.error(f"[{request_id}] 请求失败 | 耗时={elapsed:.2f}s | error={str(e)}")
        raise

这段代码的核心逻辑是:每个请求有一个唯一ID,全程追踪,异常时记录完整上下文。面试时如果被问到"你的项目如何排查问题",能说出这套思路比背十个框架概念都有用。

第三层:异常处理和降级

Demo里不会考虑模型超时、返回内容为空、向量检索结果为空等情况。实际项目中:

async def safe_qa_query(question: str, timeout: float = 10.0):
    """带超时和兜底的QA查询"""
    try:
        result = await asyncio.wait_for(
            qa_chain.ainvoke({"question": question}),
            timeout=timeout
        )
        if not result or not result.get("answer"):
            logger.warning("模型返回空答案,触发兜底")
            return {"answer": "抱歉,暂时无法回答这个问题", "fallback": True}
        return result
    except asyncio.TimeoutError:
        logger.error(f"查询超时: {question[:30]}...")
        return {"answer": "服务繁忙,请稍后重试", "fallback": True, "error": "timeout"}
    except Exception as e:
        logger.exception(f"未知错误: {e}")
        return {"answer": "系统异常,请联系管理员", "fallback": True, "error": str(e)}

这里的取舍很关键:超时时间设多少?兜底策略是什么?是否要记录错误日志给运维看?每一个选择都有业务背景,面试时要能说出你为什么这么选。

排查过程

有一次这个系统上线后,有用户反馈"有时候能回答,有时候返回空"。排查链路如下:

1. 现象确认:复现问题,发现偶发性空答案,概率约10%
2. 日志排查:查看rag.log,发现空答案对应的请求没有ERROR级别日志,说明模型调用了但返回为空
3. 链路追踪:在qa_chain.invoke处加 timing,发现空答案请求的耗时明显更长(约8秒,正常是2秒)
4. 根因定位:模型超时后返回了部分结果,LangChain默认没有丢弃部分结果,导致空答案被当成正常返回
5. 修复:在invoke后加返回值校验,空答案走兜底逻辑,同时将超时阈值从默认的10秒改为5秒并记录告警

这个排查过程展示了日志→链路追踪→根因分析→修复验证的完整闭环,是面试官非常想看的能力。

失败原因分类

学生项目翻车,通常可以归为三类:

业务错误:需求理解偏差、边界条件遗漏。比如用户问"帮我总结一下",系统不知道总结什么文档。解决方案:需求评审阶段把所有边界情况列出来。

配置错误:API Key写错、模型名拼错、向量维度不对。这类问题可以通过环境变量管理和配置校验来减少。

环境错误:本地能跑线上不行、Python版本差异、依赖冲突。解决方案:用Docker固定环境,CI/CD自动化验证。

区分这三类的方法很简单:业务错误改代码,配置错误改配置,环境错误改部署。面试时能准确分类问题,说明你有实际的排错经验。

适用边界

以上方案并不是所有场景都适用。有几个取舍需要考虑:

  • 个人Demo项目:权限和日志可以简化,但异常处理一定要有,这是最低要求
  • 团队协作项目:权限和可观测性是必须项,缺少任何一个都会被拒
  • 创业公司:可能更看重快速上线,日志和权限可以逐步补全,但不能完全不做
  • 大厂校招:即使做内部工具,也需要展示你对生产环境的理解,这是加分项

什么时候不该照搬:如果你只是做一个学习Demo,不需要上生产环境,那不需要搞完整的权限体系。但要清楚这是Demo,不是生产系统。面试时要能说出两者的区别,这本身就是考点。

---

代码解释

下面对上面提到的关键代码进行逐段解析,说明它们的输入、核心逻辑、输出和异常处理。这部分内容是实现原理层面的拆解,面试时如果能讲清楚这些细节,会比泛泛而谈"我做过RAG系统"有说服力得多。

1. 基础接口:`ask_question`

输入:HTTP POST 请求,Body 中包含 question 字段(通过 QuestionRequest 模型解析)

核心逻辑:直接调用 qa_chain.invoke(),将问题传入 RAG 链,返回原始结果

输出:JSON 响应 {"answer": result}

缺陷分析:这段代码是 Demo 阶段的典型写法——简洁但脆弱。它没有做任何前置校验(比如 question 是否为空),没有异常捕获(qa_chain 抛出任何异常都会让接口 500),也没有超时控制。放到生产环境,一次异常的模型调用就可能让整个服务崩溃。

2. 权限校验:`get_current_user` 和 `check_document_access`

输入:

  • get_current_user:接收 HTTP 请求中的 Bearer Token
  • check_document_access:接收 doc_id 和已认证的用户信息

核心逻辑:

  • get_current_user 通过 FastAPI 的依赖注入机制(Depends)自动从请求头提取 Token,调用 verify_token 验证合法性。验证失败直接返回 401,拦截后续逻辑。
  • check_document_access 同样使用依赖注入,在用户认证通过后,进一步查询数据库判断该用户是否有权访问指定文档。无权则返回 403。

输出:

  • 成功时返回用户信息字典或 doc_id
  • 失败时抛出 HTTPException,由 FastAPI 自动转换为对应 HTTP 状态码

异常处理:两个函数都将异常情况通过异常机制传递,而不是返回错误码。这种设计让调用方可以统一用 try/except 或依赖注入的异常处理机制来管理,代码更清晰。

实现原理:这里用到了 FastAPI 的依赖注入系统。Annotated[..., Depends(...)] 的写法会让 FastAPI 在请求处理前自动执行依赖函数,并将结果注入到主函数参数中。这种解耦方式比在每个接口里手动写鉴权逻辑要优雅得多。

3. 结构化日志:`trace_request` 上下文管理器

输入:request_id(唯一请求标识符,通常由 UUID 生成)

核心逻辑:

  • 使用 @contextmanager 装饰器将普通函数转为上下文管理器
  • 进入上下文时记录请求开始时间和问题摘要(截取前50字符避免日志过长)
  • yield 暂停执行,等待被包裹的代码运行
  • 正常退出时记录完成时间和耗时
  • 异常退出时记录错误信息和耗时,并通过 raise 重新抛出异常,不吞掉错误

输出:无返回值,副作用是写入结构化日志文件

异常处理:通过 try/except/finally 模式(contextmanager 内部实现),确保无论是否正常退出都会记录日志。raise 语句保证异常不会静默消失,调用方仍能感知到错误。

代码解释:这段代码的关键设计点是"日志与业务逻辑分离"。调用方只需 with trace_request(request_id): 包裹业务代码,无需关心日志记录细节。这种模式在生产环境中极易复用,也方便后续接入更多可观测组件(如分布式追踪)。

4. 安全查询:`safe_qa_query`

输入:

  • question:用户问题字符串
  • timeout:超时阈值,默认 10 秒

核心逻辑:

  • 使用 asyncio.wait_for 对 qa_chain.ainvoke 设置超时保护
  • 检查返回值是否包含有效的 answer 字段
  • 根据结果分三路返回:正常答案、空答案兜底、异常兜底

输出:统一返回格式 {"answer": str, "fallback": bool, "error": str?}

异常处理:

  • asyncio.TimeoutError:模型调用超时,返回友好提示并标记 error 类型
  • 其他 Exception:未知错误,记录完整堆栈(logger.exception 会自动包含 traceback),返回通用错误提示
  • 空答案:模型返回了结果但没有有效内容,属于业务异常,记录 warning 而非 error

关键点:这里有一个微妙的取舍——超时后是否应该重试?代码选择了一次失败后直接走兜底,因为重试可能加剧服务压力。但如果业务允许,可以考虑加上有限的重试逻辑(配合退避策略)。面试时如果被问到这个问题,能展开讨论重试策略和限流的关系会是很好的加分项。

---

实习准备:别只在本地跑起来

很多学生找实习时,简历上写"完成了XX系统开发",但系统只在自己的电脑上跑通过。面试官问一句"并发100个请求会怎样",立刻露馅。

实习准备的几个具体建议:

1. 至少部署过一次。不管是用云服务器还是内网穿透,让系统能被其他人访问到。部署过程中遇到的网络、权限、依赖问题,比写代码本身更有价值。

2. 写一份README。不只是项目介绍,要包括:如何启动、如何测试、已知问题和排查方法。这份README就是你工程能力的直接证据。

3. 做一次压测。用Locust或JMeter模拟多用户,观察系统的响应时间和错误率。这一步能暴露很多平时发现不了的问题。

4. 保留排查记录。把每次遇到问题、如何定位、如何解决的过程记录下来。面试时可以拿出来讲,比说"我学习能力很强"有力得多。

---

求职路径建议

结合当前市场情况,给不同阶段学生的建议:

大二/大三上学期:先把基础课学好,同时接触一个完整的大模型项目。重点不是做多少项目,而是把一个项目做深,做到能从Demo讲到生产级。

大三下学期:争取一段实习。实习中不要只做CRUD,主动承担有挑战的任务,比如性能优化、问题排查。把这些经历写成可讲述的故事。

大四:面试前做一次系统性复盘。把自己做过的项目,按照"需求→设计→实现→问题→解决"的链路整理一遍。面试官问任何问题,你都能从这条链路上找到答案。

---

总结

大模型时代的计算机专业求职,核心矛盾不是"会不会用模型",而是"能不能做出能上线的系统"。Demo能跑通只是起点,权限控制、日志可观测、异常处理这些工程细节才是真正拉开差距的地方。

建议每个学生至少完整经历一次"Demo→团队项目→上线"的过程,哪怕是一个简单的内部工具。这个过程里踩的坑,比刷十道LeetCode更能帮助你在面试中脱颖而出。

最后说一句实话:现在的大模型岗位,不缺会调API的人,缺的是能把模型能力变成稳定服务的人。从这个角度去准备,你的竞争力会远超平均水平。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

AI大模型资料展示 4

AI大模型资料展示 5

需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。
优快云官方大礼包

[yolov5/yolov8修改]替换yolov5/yolov8中的主干网络为EfficientNetv2 针对yolov5和yolov8的主干网络进行替换。 阅读详情

相关推荐

RagFlow 文档解析

RAGFlow 的设计哲学是“高质量输入,高质量输出”,它通过提供可解释性和可控性的生成结果,让用户能够信任并依赖于系统提供的答案。

weixin_43008312的博客 3999

计算机专业就业:把关键能力落到项目里

大模型工具普及后,求职市场出现了一个诡异现象:学生简历上Agent项目越来越多,但团队反而更谨慎了。不是因为模型能力不够,而是权限、日志、可观测这些工程化细节,成了分水岭。本文复盘真实踩坑经历,给出简历项目表达的具体改法,以及应届生该怎么补这最后一课。---很多学生觉得,大模型时代,基础课没那么重要了。这个判断太早下。数据结构、操作系统、计算机网络,这些课的价值没有变,只是表达方式变了。以前面试问"TCP三次握手",现在面试问"你的Agent调用外部API失败了,怎么设计重试和熔断"。

2601_96285276的博客 199

逆变器技术解析:DDSRF双解耦在正负序分离中的关键作用

本文深入解析了DDSRF双解耦技术在逆变器正负序分离中的关键作用。通过建立正反旋转坐标系并利用交叉反馈解耦网络,DDSRF能快速、精准地分离电网电压中的正负序分量,从而显著提升锁相环在电网不平衡条件下的精度与系统稳定性,是现代高性能并网逆变器的核心算法之一。

m3n5b7v8c9x的博客 412

计算机专业就业:把学习路径落到证据

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要:很多 CS 学生拿着 LangChain Demo 去面试,结果被问死在“权限隔离”和“全链路追踪”上。本文复盘 2026 年大模型工程化现状,指出企业筛选人才的核心已从“会调用 API”转向“具备工程边界感”。通过对比 Demo 与生产环境的差异,提供一份关于权限控制、日志可观测性及简历项目重构的实战指南,帮助同学跳出“调参侠”陷阱,真正切入大厂后端或 AI 应用开发的核心领域。---

2601_96285276的博客 363

PentAGI自动渗透测试平台搭建与使用

但是PentAGI的缺陷也比较明显,一个是自动化程度高带来过程的介入困难,整个渗透的过程都交给AI自动决策,无法进行人工调整,耗时较长;从上述过程来看PentAGI似乎是一个比较“可用”的AI自动化渗透测试平台,但是在继续等待测试的过程中,PentAGI的一些缺点也暴露了出来,一个是测试的过程非常漫长,因为PentAGI是使用配置大模型API key的方式全自动运行,支持openai、deepseek等主流LLM大模型,过程中不需要人工介入,会不断自动调整,所以比较依赖于大模型本身的响应速度。

墨痕诉清风的博客 2415

Cleo Synchronization接口任意文件读取漏洞CVE-2024-50623 附POC

微信公众号搜索:南风漏洞复现文库该文章 南风漏洞复现文库 公众号首发Cleo。

nnn2188185的博客 481

计算机专业就业到底解决了什么问题?

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要:大模型招聘风向变了。企业不再只看你会不会调API写Prompt,而是看重你是否具备处理权限隔离、日志追踪和异常恢复的工程化能力。本文复盘从学生项目到企业级Agent落地的关键断点,给出针对计算机专业学生的实战准备路线。---大模型时代,计算机专业学生的就业逻辑正在回归本质:软件工程的基本功依然是地基,AI能力是上面的建筑。别再沉迷于Demo的流畅感了。去关注那些让系统稳定运行的“脏活”:日志、权限、重试、监控。

2601_96189167的博客 274

00 — Intel xe SVM 内核实现精读系列专栏导读

本文系统介绍了Intel Xe GPU的共享虚拟内存(SVM)实现机制。第一部分通过概念地图阐述SVM的六个核心概念及其关系;第二部分通过三个测试用例解析SVM关键功能:fault生命周期验证、madvise与VRAM迁移、跨GPU一致性;第三部分深入内核实现,包括初始化/销毁流程、Page Fault处理、MMU Notifier失效路径、异步垃圾回收、VRAM迁移机制、madvise实现原理,以及与ROCm SVM的对比。文章建议按功能模块顺序学习,从基本概念到测试用例,再深入内核实现细节,最后对比不同

图形/计算GPU的驱动与虚拟化技术分享园地 1675

Demo能跑通只是门票,生产级Agent才是大模型就业的真正分水岭

面试问得最多的不是你会不会调API,而是你的项目上线后翻过几次车、怎么修的。文章开头我说了,面试问得最多的不是你会不会调API。那到底在问什么?在问:你有没有经历过从Demo到生产的完整过程,以及在这个过程中你学到了什么。Demo能跑通只是入场券,生产级Agent才是分水岭。可观测性:你能不能看到系统在生产环境里实际发生了什么边界管理:你能不能划清Agent自主性和人工干预的界限工程化能力:你能不能把一段能跑的代码变成团队能维护、运维能监控、用户能信任的系统。

2601_96285279的博客 338

CS 188 Project3(RL) Q10:Approximate Q-Learning

实现一个近似的Q-learning学习代理,它学习状态特征的权重,其中许多状态可能共享相同的特征。在qlearningAgents.py中的ApproximateQAgent类中编写实现,它是PacmanQAgent的子类。 注:近似Q-learning学习假设在状态和动作对上存在一个特征函数f(s,a),它产生一个向量f1(s,a) .. fi(s,a) .. fn(s,a)特征值。我们在fe...

大模型与Agent智能体 2657

各向同性、VTI、TTI以及双相介质波场数值模拟

各位读者,大家好!在今天的文章中,我将介绍关于波场数值模拟中的各向同性、VTI(垂直横向等参数介质)、TTI(倾斜横向等参数介质)以及双相介质的基本概念。同时,我也会提供一些基础的Fortran代码片段,供大家了解和学习。

qq_38334677的博客 1710

大模型项目从Demo到生产,面试官到底在筛什么证据?

前几天帮学弟改简历,看到他写"基于LangChain搭建RAG问答系统,支持多轮对话"。我问:权限怎么做的?日志怎么记的?失败了怎么重试?他愣了三秒。这不是他一个人的问题。我带过十几个学生做项目,90%停留在Demo阶段——功能能跑,但经不起生产环境的拷问。大模型应用从Demo转向生产,门槛不在模型调用,而在权限、日志和可观测性。面试官筛人,筛的就是这个。大模型时代的就业,门槛在提高。Demo项目不再够用,面试官要看工程能力。权限、日志、监控,不是锦上添花,而是必备技能。

LLM_9528的博客 310

AUTOSAR CP R18-10 架构总览与导航

AUTOSAR CP R18-10 架构总览 本文档系统整理了AUTOSAR CP R18-10版本的199篇技术规范,涵盖7大架构层级: 应用层(15篇):包含车身舒适、底盘控制、HMI、安全系统、动力系统等AI应用 RTE(1篇):虚拟功能总线规范 服务层(159篇):细分为系统服务(OS/ECU管理/加密)、存储服务、通信服务(CAN/LIN/Ethernet) ECU抽象层(20篇):I/O与通信硬件抽象 MCAL(41篇):微控制器驱动层 复杂驱动(14篇):CDD设计与SPAL支撑 规范模板(2

一名留德华的,康德的信徒的,专注于汽车电子领域的博客 724

Demo跑通就能投简历?大模型求职真正筛掉你的是权限和日志

我最近翻简历的时候发现一个现象:很多同学的Agent项目都差不多——调一个API,套个模板,跑个Demo,然后写进简历。看着挺热闹,但真正聊起来,一问"你的Agent怎么判断用户权限",或者"你做了哪些日志追踪",基本就卡壳了。这不是学生的问题,是方向偏了。大模型应用这两年从Demo阶段进入工程化阶段,企业招聘的筛选标准也跟着变了。以前会调API、会用LangChain就能拿到面试,现在面试问的是:你的应用能不能上线、能不能维护、能不能对接到现有系统。

资料免费分享,点击名片 193

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

大模型Demo能跑就够了?真正拦人的是权限和日志

大模型应用从Demo阶段走向生产,最容易被忽视的不是算法能力,而是权限管理、日志追踪和交付文档。这篇文章从一次真实的项目接手经历出发,分析计算机专业学生在大模型时代该如何准备,给出清晰的学习路线和实战建议。---大模型时代,计算机专业学生该怎么准备?我的答案是:别只盯着调API,先把工程化基础打好。权限、日志、文档,这些看起来不性感,但它们是项目从Demo走向上线的关键。团队接手成本,是衡量项目质量的重要标准。学习路径建议:1. 基础课别丢,它们是思维框架。

m0_62051288的博客 286

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

别慌着学 Agent 架构,先搞懂为什么你的 Demo 拿不到生产权限

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。之前我也写过几篇关于大模型应用的复盘,发现一个挺扎心的现象:很多同学在面试或者做课程设计时,手里拿着的所谓“智能体”项目,基本还停留在 Chat 层面。你能演示它回答问题,能演示它调 API 查天气,甚至能演示它根据意图路由到不同的子模块。但一旦面试官问:“如果这个服务要在生产环境跑,你怎么保证它的可观测性?怎么控制它的权限边界?出了幻觉怎么回滚?”这时候,大多数人的脑子里是空白的。

LLM_9528的博客 338

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

大模型会写代码,你为什么反而更难找工作?

我上周帮一个学弟看简历,他项目里写了三个 LangChain Agent,还能跑通 RAG 问答。我问了他一个问题:你的 Agent 调用数据库时,权限是怎么控制的?如果模型输出了恶意 prompt,日志能追踪到吗?他愣了三秒,说 Demo 没考虑这些。我让他把简历上那个最"炫"的项目划掉。不是项目不好,是面试问到这儿他会露馅。大模型把 Demo 的门槛打到了地板上。任何学生都能在周末搭出一个能跑的问答系统。但企业招的不是 Demo 工程师。他们要的是能把东西上线、维护、出问题能排查的人。

m0_62051288的博客 303

Agent Demo跑通很香,为什么上线就被权限和日志卡死?

上周参与了一个学生创业团队的需求评审,他们做了一个基于Agent的"智能客服系统",Demo演示得很流畅——用户提问,Agent调用RAG检索,然后生成回答。负责人很自信地说"下周就能上线"。我问了三个问题:用户权限怎么区分?Agent调用的API失败怎么兜底?每次请求的耗时、Token消耗、检索命中率怎么统计?对方愣了三秒,说"Demo里没考虑这些"。这就是大模型应用从Demo走向生产的第一道坎。今天这篇文章,我想把面试时真正看重的东西摊开说清楚。---

2601_96285279的博客 227

Demo 跑通不敢上线?权限与日志才是大模型工程师的护城河

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要:很多计算机专业的同学在准备大模型就业时,陷入了一种“Demo 幻觉”:能用 LangChain 或 LlamaIndex 跑通一个检索问答,就觉得拿到了 Offer。但真正的生产环境筛选逻辑完全不同。本文复盘从学生项目到企业级应用的关键跨越,重点剖析为什么“权限控制”、“日志追踪”和“可观测性”才是目前团队接手成本的硬指标,并给出具体的实战改进建议和简历优化方向。---

m0_62051288的博客 239

Demo 跑得欢,上线就崩?大模型时代求职的“权限与日志”生死线

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要:大模型招聘正在从“会调 API”转向“工程化落地”。本文复盘一次 Agent 联调翻车经历,指出 Demo 只是入场券,权限隔离、全链路日志和可观测性才是区分初级玩家与合格工程师的分水岭。通过具体代码示例和简历优化建议,帮助 CS 学生构建具备生产竞争力的项目作品集。最近和几位大厂的技术面试官聊天,发现一个非常明显的趋势:面试者的水平分层正在剧烈重构。

2601_96189255的博客 294

跑分再高也没用:Demo 到生产,权限日志才是面试硬通货

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要:很多同学在简历上堆砌 LangChain 或 LLM API 调用,却在面试中被问倒:“如果 Agent 幻觉输出敏感信息怎么办?”“如何追踪调用链路?”本文通过一次真实的联调翻车经历,揭示大厂筛选候选人的真实逻辑:不再看重你能写出多复杂的 Prompt,而是看你是否有工程化思维——权限控制、日志审计与可观测性,才是从学生项目走向企业级应用的生死线。大模型时代,入门门槛确实降低了,但工程化门槛却提高了。

2601_96120158的博客 143

26届校招流程大揭秘:求职小白的必备指南!

对于 26 届毕业生来说,校招堪称毕业前的头等大事,是迈向职场的关键一步。它不仅是众多企业集中选拔人才的重要途径,对于咱们毕业生而言,更是一次不可多得的就业契机。错过校招,后续再想进入心仪的企业,难度可能会大大增加。校招一般分为提前批、秋招和春招。提前批通常在每年的 6 - 7 月开启,这个阶段的招聘周期短、流程快,最重要的是竞争相对较小 ,对于有实力、准备充分的同学来说,是一个提前锁定优质 offer 的绝佳机会。比如一些互联网大厂,会提前开启技术岗位的提前批招聘,早早招揽技术大神。

2501_90297932的博客 1693

【数据结构】基于比较的排序算法 - 交换排序

本文介绍交换排序中的冒泡排序与快速排序。冒泡排序通过相邻元素比较交换,实现升序,时间复杂度最坏为O(N²),空间复杂度O(1),稳定且适合小规模有序数据。快速排序采用分治思想,以基准值划分区间,平均时间复杂度O(N log N),空间复杂度O(log N),但不稳定,实际应用中性能优异,可通过随机基准、小区间优化等提升效率。

careathers的博客 373

【数据结构-5】单链表的实现

单链表,具体来说是单向的、不带头的、不循环的链表。链表由一个一个节点组成,每个节点分为数据域和指针域,数据域存放数据,指针域存放下一节点的地址。这样,就可以根据指针域中的地址找到下一个节点,节点就串起来了构成了单链表。

a bit 210

C# 数据结构和特殊类型

.NET Core(现称.NET)提供丰富数据结构,优化性能与开发效率。日常开发首选List<T>和Dictionary<TKey,TValue>;高性能场景推荐Span<T>与Memory<T>减少内存分配;并发环境使用ConcurrentDictionary等线程安全集合;避免非泛型集合如ArrayList。

cccloveforever的博客 721

pandas 深度入门:从数据结构到一份真实销售报表

本文系统讲解Pandas核心应用,从三分钟安装到完整月度报表生成,涵盖数据读取、清洗、筛选、分组聚合、表连接、透视表与时间序列等13个关键环节。强调“先看数据再动手”,掌握Series/DataFrame/Index结构本质,熟练运用loc/iloc、merge校验、agg/transform区别,通过真实案例实现高效报表自动化,告别手动Excel操作。最后提供性能优化与高频报错解决方案,助力读者快速上手,真正实现“写二十行代码,跑三秒出结果”。

信息安全领域优质创作者|操作系统领域专家 310
上一篇: Demo能跑通不算完,权限日志卡住多少人?
下一篇: LangGraph工作流:能跑通Demo很容易,为什么团队接入第一天就崩?
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值