


聊《同样是LangGraph,为什么有的能上线、有的只能演示?》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
前阵子帮朋友看了他的Agent项目,代码写得挺漂亮,工具调用、状态管理、条件分支都上了,本地跑起来也顺。结果一交给我们运维同事做灰度,第一天就炸了——权限校验没走,某个工具的日志没落盘,查不出是谁的锅。他回头问我:LangGraph不是号称能控制工作流吗,怎么还是这样?
说实话,这个问题我太熟悉了。我自己踩过,带的几个后端同学也踩过。今天把这事儿摊开说,顺便把从Demo到上线之间缺的那几块补上。
目录
- 为什么需要图工作流
- State 与 Node
- Edge 与条件分支
- 人工审批节点
- 代码解释
- 排查过程
- 失败原因
- 适用边界
- 总结
为什么需要图工作流
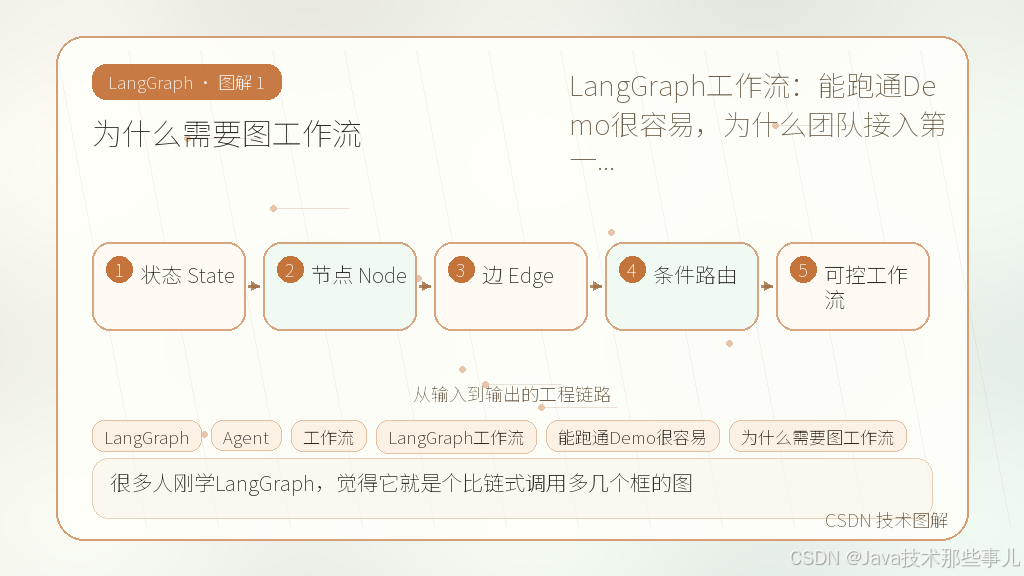
很多人刚学LangGraph,觉得它就是个比链式调用多几个框的图。但真正的问题不是"怎么用",而是"为什么不能用脚本干"。
我举个真实案例:做一个售后工单的Agent,输入是用户报障描述,要经过三个步骤——先查订单信息,再根据订单类型调用不同工具生成处理方案,最后如果方案金额超过500,走人工审批节点,否则直接输出结果。
如果用脚本写:
def process_ticket(user_input):
    order = query_order(user_input)
    if order.type == "hardware":
        plan = call_tool_hardware(order)
    else:
        plan = call_tool_software(order)
    if plan.amount > 500:
        return manual_approval(plan)
    return output_result(plan)
看起来够用。但一旦你要加日志、加权限、加重试、加并行,代码会迅速膨胀成一团意大利面条。而且你没法在中间暂停让人审批,也没法从任意节点恢复执行。
图工作流的本质,是把控制流和数据流显式化。节点是动作,边是跳转逻辑,状态是贯穿全程的上下文。这三样东西分开后,你才有空间做权限校验、日志记录、人工干预这些工程能力。
State 与 Node
State是LangGraph的核心。很多人第一步就踩坑——把状态设计成一团dict,用完就丢,导致节点之间数据耦合严重。
我们项目里定义过这样一个State:
from typing import Annotated, TypedDict
import operator
from langgraph.graph import add_messages

class TicketState(TypedDict):
    user_input: str
    order_info: dict
    plan: dict
    amount: float
    needs_approval: bool
    messages: Annotated[list, add_messages]
这里用了add_messages这个累加器,保证消息历史不会覆盖。needs_approval是后续条件分支的判断依据。
节点函数本身不复杂,关键是每个节点只负责自己的输入输出。比如查询订单的节点:
def query_order_node(state: TicketState) -> dict:
    try:
        order = order_tool.search(state["user_input"])
        return {
            "order_info": order,
            "amount": order.get("amount", 0),
            "needs_approval": order.get("amount", 0) > 500
        }
    except Exception as e:
        return {"order_info": None, "amount": 0, "needs_approval": False}
注意这里做了异常兜底。线上很多项目崩就是因为节点抛出未捕获异常,整个图直接挂掉。
我的判断标准是:每个节点的输入只依赖State里的字段,输出也只回写State,不引入外部隐式状态。这样后续加日志、加权限,只需要在节点入口和出口插一行代码,不用改业务逻辑。
Edge 与条件分支
条件边是LangGraph区分于普通链式调用的关键能力之一。
我们的案例里,查完订单后要决定走哪个生成方案的分支,这就用到了条件边:
from langgraph.graph import StateGraph, END

graph = StateGraph(TicketState)

# 添加节点
graph.add_node("query", query_order_node)
graph.add_node("generate_plan", generate_plan_node)
graph.add_node("manual_approval", manual_approval_node)
graph.add_node("output", output_result_node)

# 设置入口
graph.set_entry_point("query")

# 条件路由
graph.add_conditional_edges(
    "query",
    route_by_type,
    {
        "hardware": "generate_plan",
        "software": "generate_plan",
        "error": END
    }
)

# 普通边
graph.add_edge("generate_plan", "output")
graph.add_edge("manual_approval", "output")

app = graph.compile()
条件函数route_by_type根据订单类型返回字符串,图的执行引擎会根据返回值跳转到对应节点。如果订单查询失败,直接返回"error"走到END,整个流程终止。
这里有个容易忽略的点:条件边的返回值必须和字典的key完全一致,包括大小写。我之前在一个项目里因为返回了"Hardware"而不是"hardware",导致流程静默走到了END,排查了半小时。
另外,条件分支不只是if-else的替代品。当你的业务规则变化时,只需要改路由函数,不用动节点实现。这也是图工作流的优势之一——控制流和业务逻辑解耦。
人工审批节点
这是从Demo到上线最容易卡住的环节。
很多教程讲到条件分支就结束了,但真实项目里,超过一定阈值的操作必须有人工确认。LangGraph提供了interrupt()机制,可以在执行到某个节点时暂停,等待外部信号再恢复。
def manual_approval_node(state: TicketState) -> dict:
    approval_result = interrupt({
        "plan": state["plan"],
        "amount": state["amount"],
        "hint": "请确认是否批准此方案"
    })

    if not approval_result.get("approved", False):
        return {"plan": state["plan"], "status": "rejected"}

    return {"plan": state["plan"], "status": "approved"}
interrupt()调用后,图的执行会挂起,返回给调用方一个checkpoint。你可以把这个checkpoint存到数据库,前端展示审批界面,用户点击后通过invoke()的resume()方法恢复执行。
我见过太多项目在这里翻车。常见的问题有三个:
第一,checkpoint没有持久化。服务重启后所有待审批的流程全部丢失,用户投诉说"我的申请没了"。
第二,并发审批冲突。两个请求同时进入审批节点,checkpoint ID相同,恢复时互相覆盖。
第三,超时处理缺失。审批节点挂起超过一定时间,要么主动取消,要么告警通知。
我的建议是:审批节点一定要配持久化存储,至少用Redis或SQLite;并发问题用checkpoint ID做唯一标识;超时处理在图编译时配置timeout参数,超时时走到错误分支而不是无限挂起。
代码解释
这部分我们把前面几段关键代码拆开来,讲清楚每一步在做什么、为什么这么写。先看状态定义这块。
class TicketState(TypedDict):
    user_input: str
    order_info: dict
    plan: dict
    amount: float
    needs_approval: bool
    messages: Annotated[list, add_messages]
输入:无外部输入,这是图的初始状态定义。
核心逻辑:用TypedDict声明状态的字段类型。重点看最后一行——messages字段绑定了add_messages操作符。这意味着每次节点往这个字段写数据时,LangGraph会自动追加而不是覆盖。如果不加这个注解,后面的消息会把前面的全抹掉,对话历史就丢了。
输出:编译成图的内部状态对象,供后续节点读取。
异常处理:类型声明阶段不会抛异常,但如果后续节点往里塞错类型的值(比如给amount传了字符串),Python运行时会在赋值时报错。所以State定义其实是最先暴露问题的地方。
再看节点函数:
def query_order_node(state: TicketState) -> dict:
    try:
        order = order_tool.search(state["user_input"])
        return {
            "order_info": order,
            "amount": order.get("amount", 0),
            "needs_approval": order.get("amount", 0) > 500
        }
    except Exception as e:
        return {"order_info": None, "amount": 0, "needs_approval": False}
输入:整个TicketState,但函数只取用了state["user_input"]。这就是我之前说的"节点只读自己需要的字段"原则——其他字段即使存在也不会被访问,减少隐式依赖。
核心逻辑:调用外部工具order_tool.search查询订单。返回三个字段更新State:订单详情、金额、是否需要审批。注意amount用了.get("amount", 0),说明API可能不返回这个字段,给个默认值而不是直接崩溃。
输出:返回的dict会被LangGraph合并进State。只写需要更新的字段,不写的字段保持不变。
异常处理:这里是关键。外层try-except把一切异常都兜住,返回"空订单+零金额+不需要审批"的组合。看起来像是在隐瞒错误,但实际上这是故意设计的——让流程继续往下走而不是让整个图崩溃。真正的错误日志应该打在except块里(原文省略了logger.error那一行),后续排查靠日志而不是崩溃堆栈。
然后是图构建那段:
graph = StateGraph(TicketState)
graph.add_node("query", query_order_node)
graph.add_node("generate_plan", generate_plan_node)
graph.add_node("manual_approval", manual_approval_node)
graph.add_node("output", output_result_node)
graph.set_entry_point("query")
graph.add_conditional_edges("query", route_by_type, {
    "hardware": "generate_plan",
    "software": "generate_plan",
    "error": END
})
graph.add_edge("generate_plan", "output")
graph.add_edge("manual_approval", "output")
app = graph.compile()
输入:无,这是图的结构定义。
核心逻辑:先注册四个节点,然后设定入口是query。接下来是条件边——从query节点出发,根据route_by_type的返回值决定下一步。注意hardware和software都指向generate_plan,说明两种订单类型共用同一个生成逻辑,只是入参不同。error指向END意味着查询失败时直接终止,不再走审批流程。
输出:graph.compile()生成可执行的App对象。这一步只做一次,之后反复调用app.invoke()执行不同输入。
异常处理:compile()阶段会做结构校验——如果某个节点名没注册就被边引用了,或者循环依赖,这里就会报错。所以很多运行时的坑在compile时就提前暴露了。
最后是interrupt()那段:
def manual_approval_node(state: TicketState) -> dict:
    approval_result = interrupt({
        "plan": state["plan"],
        "amount": state["amount"],
        "hint": "请确认是否批准此方案"
    })
    if not approval_result.get("approved", False):
        return {"plan": state["plan"], "status": "rejected"}
    return {"plan": state["plan"], "status": "approved"}
输入:State中的plan和amount字段被打包传给interrupt,作为暂停时暴露给外部的上下文。
核心逻辑:interrupt()是整个图的暂停点。调用后执行流立刻停止,返回一个包含checkpoint信息的响应给调用方。调用方拿到checkpoint后可以存库、展示UI、发消息通知。等人工操作完成后,调用方拿着同一个checkpoint ID调用resume(),图的执行从interrupt()这一行继续往下走,approval_result就是人工返回的结果。
输出:根据approved字段决定写入status为"rejected"还是"approved",然后流程继续。
异常处理:这段代码本身没有显式异常处理,但interrupt()有一个隐式契约——如果对应的checkpoint不存在或者已被消费,resume()会抛异常。所以调用方在调用resume之前必须先验证checkpoint的有效性,这也是前面排查案例里踩的坑:checkpoint_id和实际挂起的checkpoint对不上,resume直接报错。
排查过程
说回开头那个案例。项目本地跑通了,线上第一天崩了,排查链路是这样的:
现象:API返回200,但工单状态一直是"处理中",用户看不到最终结果。后台日志里没有错误信息。
第一步验证:看checkpoint表,发现审批节点确实在等待,但没有收到恢复信号。说明interrupt()被调用后,没有对应的resume()触发。
第二步验证:查前端代码,审批按钮的回调确实调了resume接口,但传的checkpointid是从localStorage取的。问题是,同一个工单ID可能被多个会话访问,localStorage里的checkpointid是旧会话的,和新请求不匹配。
第三步排除:不是LangGraph本身的问题,是状态管理的设计缺陷。checkpoint_id应该由后端生成并返回给前端,前端存到sessionStorage或者干脆每次请求都从后端获取最新的checkpoint。
最终修复:把checkpoint_id的获取逻辑改成后端返回,前端不再自己维护。同时加了日志,记录每次interrupt和resume的调用时间和id。
这个case说明一个道理:Demo阶段所有状态都在内存里,重启就清空,很多隐藏问题根本暴露不了。上线后要面对的,是持久化、并发、会话隔离这些工程问题。
失败原因
我把常见的失败原因分成三类,便于定位:
业务错误:路由逻辑写错了、条件分支漏了某个case、审批阈值设置不合理。这类错误通常有明确的报错或结果不对,日志能定位到具体节点。比如前面说的返回"Hardware"而不是"hardware",流程静默走到END,用户那边没有任何提示。
配置错误:环境变量没加载、工具调用地址写错了、权限配置缺失。这类错误经常表现为"明明代码没问题但跑不通",排查时要先检查配置项是否生效。我遇到过最离谱的是——测试环境配置好了,生产环境忘拷贝,整个图能跑但所有工具调用全部返回403。
环境错误:网络不通、依赖版本冲突、checkpoint存储不可用。这类错误最麻烦,因为可能间歇性出现,而且报错信息不直观。比如Redis偶尔超时,checkpointer写不进去,下次invoke时发现checkpoint不存在,resume直接炸。
区分这三类有一个简单方法:先看日志有没有报错,有就是业务或配置问题;没报错但结果不对,大概率是配置问题;间歇性出问题,先检查环境。
我的经验是,上线前至少做一次混沌测试——随机杀掉服务、断掉依赖、模拟超时,看看系统能不能优雅降级而不是直接崩。很多团队跳过这一步,上线第一天就被真实流量打回原形。
适用边界
LangGraph不是银弹。我见过有人把简单的问答也用图工作流包了一层,结果调试起来比原来的链式调用还麻烦。
适合用图工作流的场景:流程有明确的状态转换、需要条件分支、需要人工干预、需要可观测性和可恢复性。如果你的Agent需要在执行过程中暂停等人决策,或者需要从中间某个节点断点续传,图工作流是合适的选择。
不适合的场景:线性流程、不需要中间状态、不需要暂停恢复、对延迟敏感且流程简单。这种场景用函数调用或者简单的链式调用反而更清晰。
取舍:图工作流带来的是可观测性、可恢复性、可插桩能力,代价是复杂度上升。State定义要多花心思,节点边界要划清楚,编译和执行模型要理解透。如果团队里没人愿意花这个时间成本,强行上LangGraph只会把简单问题复杂化。
学习顺序上也别贪多。我建议先掌握State和Node的基础用法,能跑通一个简单的图;然后加条件边,处理分支逻辑;再接interrupt(),做人工审批;最后才考虑持久化checkpoint、并发控制这些生产级能力。
很多人一上来就想搞全功能,结果基础没打牢,后面踩一堆坑。Demo能跑通只是及格线,权限、日志、可观测性这些工程能力,才是从Demo到上线的真正门槛。
总结
LangGraph的价值不在于"能画图",而在于把Agent的控制流、数据流、状态流显式化,为后续的工程化改造留下空间。权限校验、日志记录、人工审批、故障恢复,这些能力都可以在节点和边的层面插桩,而不需要改动业务逻辑。
从Demo到上线,最大的差距不是模型能力,而是工程细节。checkpoint持久化、并发安全、超时处理、可观测性,这些才是团队项目真正在意的东西。
如果你正在学LangGraph,别急着把所有高级特性都用上。先把基础状态管理和条件边玩熟,再逐步加上审批和持久化。每一步都跑通,再往下一层走。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


